Jetson Orin Nano Super contre Raspberry Pi 5 pour la détection d’objets avec YOLO26
Inférence YOLO26n : 4,57 ms sur un Jetson Orin Nano Super (TensorRT FP16) contre 67,03 ms sur le CPU d’un Pi 5, lors de tests distincts. Choisis en fonction du modèle, du FPS et du nombre de caméras.
 Onuralp Sezer18 min de lecture
Dois-tu exécuter la détection d’objets sur un Raspberry Pi 5 ou un NVIDIA Jetson Orin Nano ? Pour une caméra, une faible fréquence d’images cible et un petit modèle, le CPU d’un Pi 5 peut suffire : dans notre benchmark publié, Ultralytics YOLO26n exporté au format NCNN nécessite 67,03 ms d’inférence par image sur ses quatre cœurs Arm, soit environ 15 images d’inférence par seconde. Si tu as besoin de davantage de caméras, d’un modèle plus grand ou d’une fréquence d’images supérieure à ce que ton Pi peut fournir, un Jetson s’impose : sur un Jetson Orin Nano Super Developer Kit, le même modèle nécessite 4,57 ms sous forme de moteur TensorRT FP16.
Ultralytics publie cette comparaison et développe YOLO26, qui fonctionne sur les deux cartes ; nous ne fabriquons aucune des deux. Nos chiffres pour Jetson proviennent de l’Orin Nano Super Developer Kit, le kit de développement Orin d’entrée de gamme de NVIDIA, et ceux pour Pi d’un Raspberry Pi 5, lors de tests distincts. Beaucoup de gens recherchent encore « Jetson Nano », la carte originale de 2019. Elle exécute YOLO26 avec JetPack 4, mais notre guide Jetson ne comprend pas de benchmarks YOLO26 pour cette carte : elle apparaît donc ici uniquement pour ses caractéristiques.
Ci-dessous : comparaison des cartes selon la taille du modèle, la fréquence d’images cible et le nombre de flux caméra, explication de la baisse du FPS quand tu ajoutes des caméras, méthode pour mesurer toi-même les performances des deux cartes et conseils pour choisir celle qui convient à ton projet. Les étapes de configuration se trouvent dans le guide NVIDIA Jetson et le guide Raspberry Pi, tandis que notre tutoriel sur la détection d’objets sur le CPU d’un Raspberry Pi 5 détaille la partie consacrée au Pi.
Le Pi 5 exécute YOLO sur son CPU ; l’Orin Nano Super est équipé d’un GPU#
Les cartes répondent au même besoin avec des composants différents. Le Raspberry Pi 5 est un ordinateur polyvalent doté de quatre cœurs Arm Cortex-A76 et sans accélérateur d’IA dédié : nos benchmarks sur Pi exécutent donc YOLO sur le CPU. Le Jetson Orin Nano Super Developer Kit associe un module Orin Nano, construit autour d’un GPU Ampere, à une carte porteuse, et le moteur d’exécution TensorRT de NVIDIA compile les modèles pour ce GPU. C’est une plateforme d’IA en périphérie conçue pour ce type de charge de travail.
| Jetson Nano 4 Go (2019) | Jetson Orin Nano Super | Raspberry Pi 5 | |
|---|---|---|---|
| Calcul pour YOLO | GPU Maxwell à 128 cœurs | GPU Ampere à 1 024 cœurs, 32 Tensor Cores | CPU Arm Cortex-A76 à 4 cœurs |
| CPU | Cortex-A57 à 4 cœurs, 1,43 GHz | Cortex-A78AE à 6 cœurs, jusqu’à 1,7 GHz | Cortex-A76 à 4 cœurs, jusqu’à 2,4 GHz |
| Mémoire | 4 Go LPDDR4, 25,6 Go/s | 8 Go LPDDR5, 102 Go/s | Varie selon le modèle |
| Performances IA (valeur maximale indiquée par NVIDIA) | 472 GFLOPS | 67 TOPS INT8 creux | — |
| JetPack / système d’exploitation | JetPack 4 uniquement | JetPack 5 à 7 | Raspberry Pi OS |
| Parcours de déploiement Ultralytics | TensorRT, y compris DeepStream | TensorRT (le plus rapide dans notre benchmark) | NCNN (le plus rapide dans notre benchmark) |
Caractéristiques, et non mesures, vérifiées le 19 novembre 2026. Les valeurs maximales indiquées par NVIDIA utilisent des formats numériques différents et ne sont donc pas directement comparables. Les 67 TOPS de l’Orin Nano Super correspondent à une valeur INT8 creuse ; NVIDIA indique 33 TOPS en dense. Données Jetson issues des tableaux comparatifs et JetPack du guide NVIDIA Jetson et du guide DeepStream ; données du Pi 5 issues de la documentation Raspberry Pi.
La consommation électrique entre aussi en jeu. NVIDIA indique une consommation de 7 W à 25 W pour le Jetson Orin Nano Super Developer Kit. Lorsque la carte est flashée avec une configuration compatible Super, l’Orin Nano 8 Go propose les modes d’alimentation 15 W, 25 W et MAXN SUPER ; avec la configuration par défaut, il conserve ses modes d’origine de 7 W et 15 W. Quelle que soit la carte choisie, mesure la consommation de l’ensemble du système avec tes caméras connectées : c’est ce que ton alimentation et ton boîtier devront prendre en charge.
Évalue le coût de l’ensemble de la configuration, pas seulement celui de la carte : stockage, alimentation, refroidissement et caméras s’ajoutent des deux côtés. Raspberry Pi a augmenté plusieurs fois le prix du Pi 5 en 2026, à mesure que le coût de la mémoire grimpait. En novembre 2026, le Pi 5 de 2 Go est affiché à 77,50 $ et la carte de 16 Go à 385 $. Pour connaître les prix et la disponibilité actuels des Jetson, consulte la page des kits de développement de NVIDIA, et ajoute le coût de tout accélérateur nécessaire au Pi, comme le Raspberry Pi AI HAT+. Pour la production, NVIDIA vend des modules Jetson destinés à être installés sur ta propre carte porteuse ; le kit de développement que nous avons évalué est conçu pour le développement et le prototypage.
Le CPU du Pi 5 convient aux charges YOLO26n à faible FPS#
Le Pi 5 gère la détection avec une seule caméra sans matériel supplémentaire si la fréquence d’images requise est modeste. Dans le benchmark Ultralytics (export FP32, entrée de 640 pixels, COCO128, Ultralytics 8.4.108, temps d’inférence uniquement), NCNN était le format d’export le plus rapide : 67,03 ms par image pour YOLO26n, avec un mAP50-95 de 0,4784. Cela correspond à environ 15 FPS d’inférence, ce qui peut convenir à un poste de comptage, une caméra de rayon ou un prototype robotique qui n’a pas besoin de suivre des mouvements rapides. Valide l’ensemble de la chaîne de traitement de la caméra, pas seulement l’inférence. Arm publie également un moteur d’exécution open source pour YOLO26n sur le Pi 5, qu’il a mesuré comme étant plus rapide que NCNN lors de ses propres tests ; notre tutoriel sur le Raspberry Pi 5 compare les deux.
La taille du modèle est le point faible du Pi. Le modèle plus grand YOLO26s nécessite 172,88 ms avec NCNN sur le Pi 5, soit moins de 6 FPS d’inférence. La comparaison multiformat du guide Raspberry Pi (Ultralytics 8.4.108) ne porte que sur les modèles n et s. L’ancienne comparaison ONNX (Ultralytics 8.4.14) indique aussi les résultats pour m, l et x ; YOLO26m y nécessite 993,78 ms. Si la détection de petits objets ou la distinction difficile entre des classes t’oriente vers un modèle plus grand ou une résolution d’entrée supérieure, teste ce modèle sur la carte avant de t’engager.
Ajouter un AI HAT+ au Pi 5#
Il existe une troisième configuration à envisager : un Pi 5 avec l’AI HAT+ de Raspberry Pi, qui ajoute un accélérateur Hailo en version 13 TOPS ou 26 TOPS. Dans le benchmark d’intégration Hailo d’Ultralytics (Ultralytics 8.4.174, COCO128), YOLO26n exporté pour la version Hailo-8 de 26 TOPS nécessite 21,7 ms par image avec un mAP50-95 de 0,455, contre 364,6 ms pour le modèle PyTorch non exporté sur le même Pi. Ce test ne précise pas la taille d’entrée et utilise INT8 ; considère-le donc comme un benchmark distinct, et non comme une ligne du tableau comparatif ci-dessous. Les modèles Hailo nécessitent une étape de compilation : vérifie donc la précision sur tes propres images après l’export.
Sur l’Orin Nano Super, YOLO26n à YOLO26l nécessitent moins de 18 ms#
Sur un Jetson, les modèles plus grands deviennent exploitables. Les benchmarks Ultralytics réalisés sur le Jetson Orin Nano Super Developer Kit (entrée de 640 pixels, COCO128, Ultralytics 8.4.33, inférence uniquement) montrent que toutes les tailles, de n à l, nécessitent moins de 18 ms d’inférence par image sous forme de moteur FP16 TensorRT :
| Modèle YOLO26 | CPU du Raspberry Pi 5 (ms/image) | Orin Nano Super, TensorRT FP16 (ms/image) | Orin Nano Super, mAP50-95, FP16 |
|---|---|---|---|
| YOLO26n | 67,03 (NCNN FP32, 8.4.108) | 4.57 | 0.4800 |
| YOLO26s | 172,88 (NCNN FP32, 8.4.108) | 7.17 | 0.5649 |
| YOLO26m | 993,78 (ancien test ONNX, 8.4.14) | 13.59 | 0.6225 |
| YOLO26l | 1 259,46 (ancien test ONNX, 8.4.14) | 17.42 | 0.6225 |
Résultats publiés issus de tests distincts. Orin Nano Super : Ultralytics 8.4.33. Toutes les lignes : entrée de 640 pixels, temps d’inférence uniquement, hors prétraitement et post-traitement.
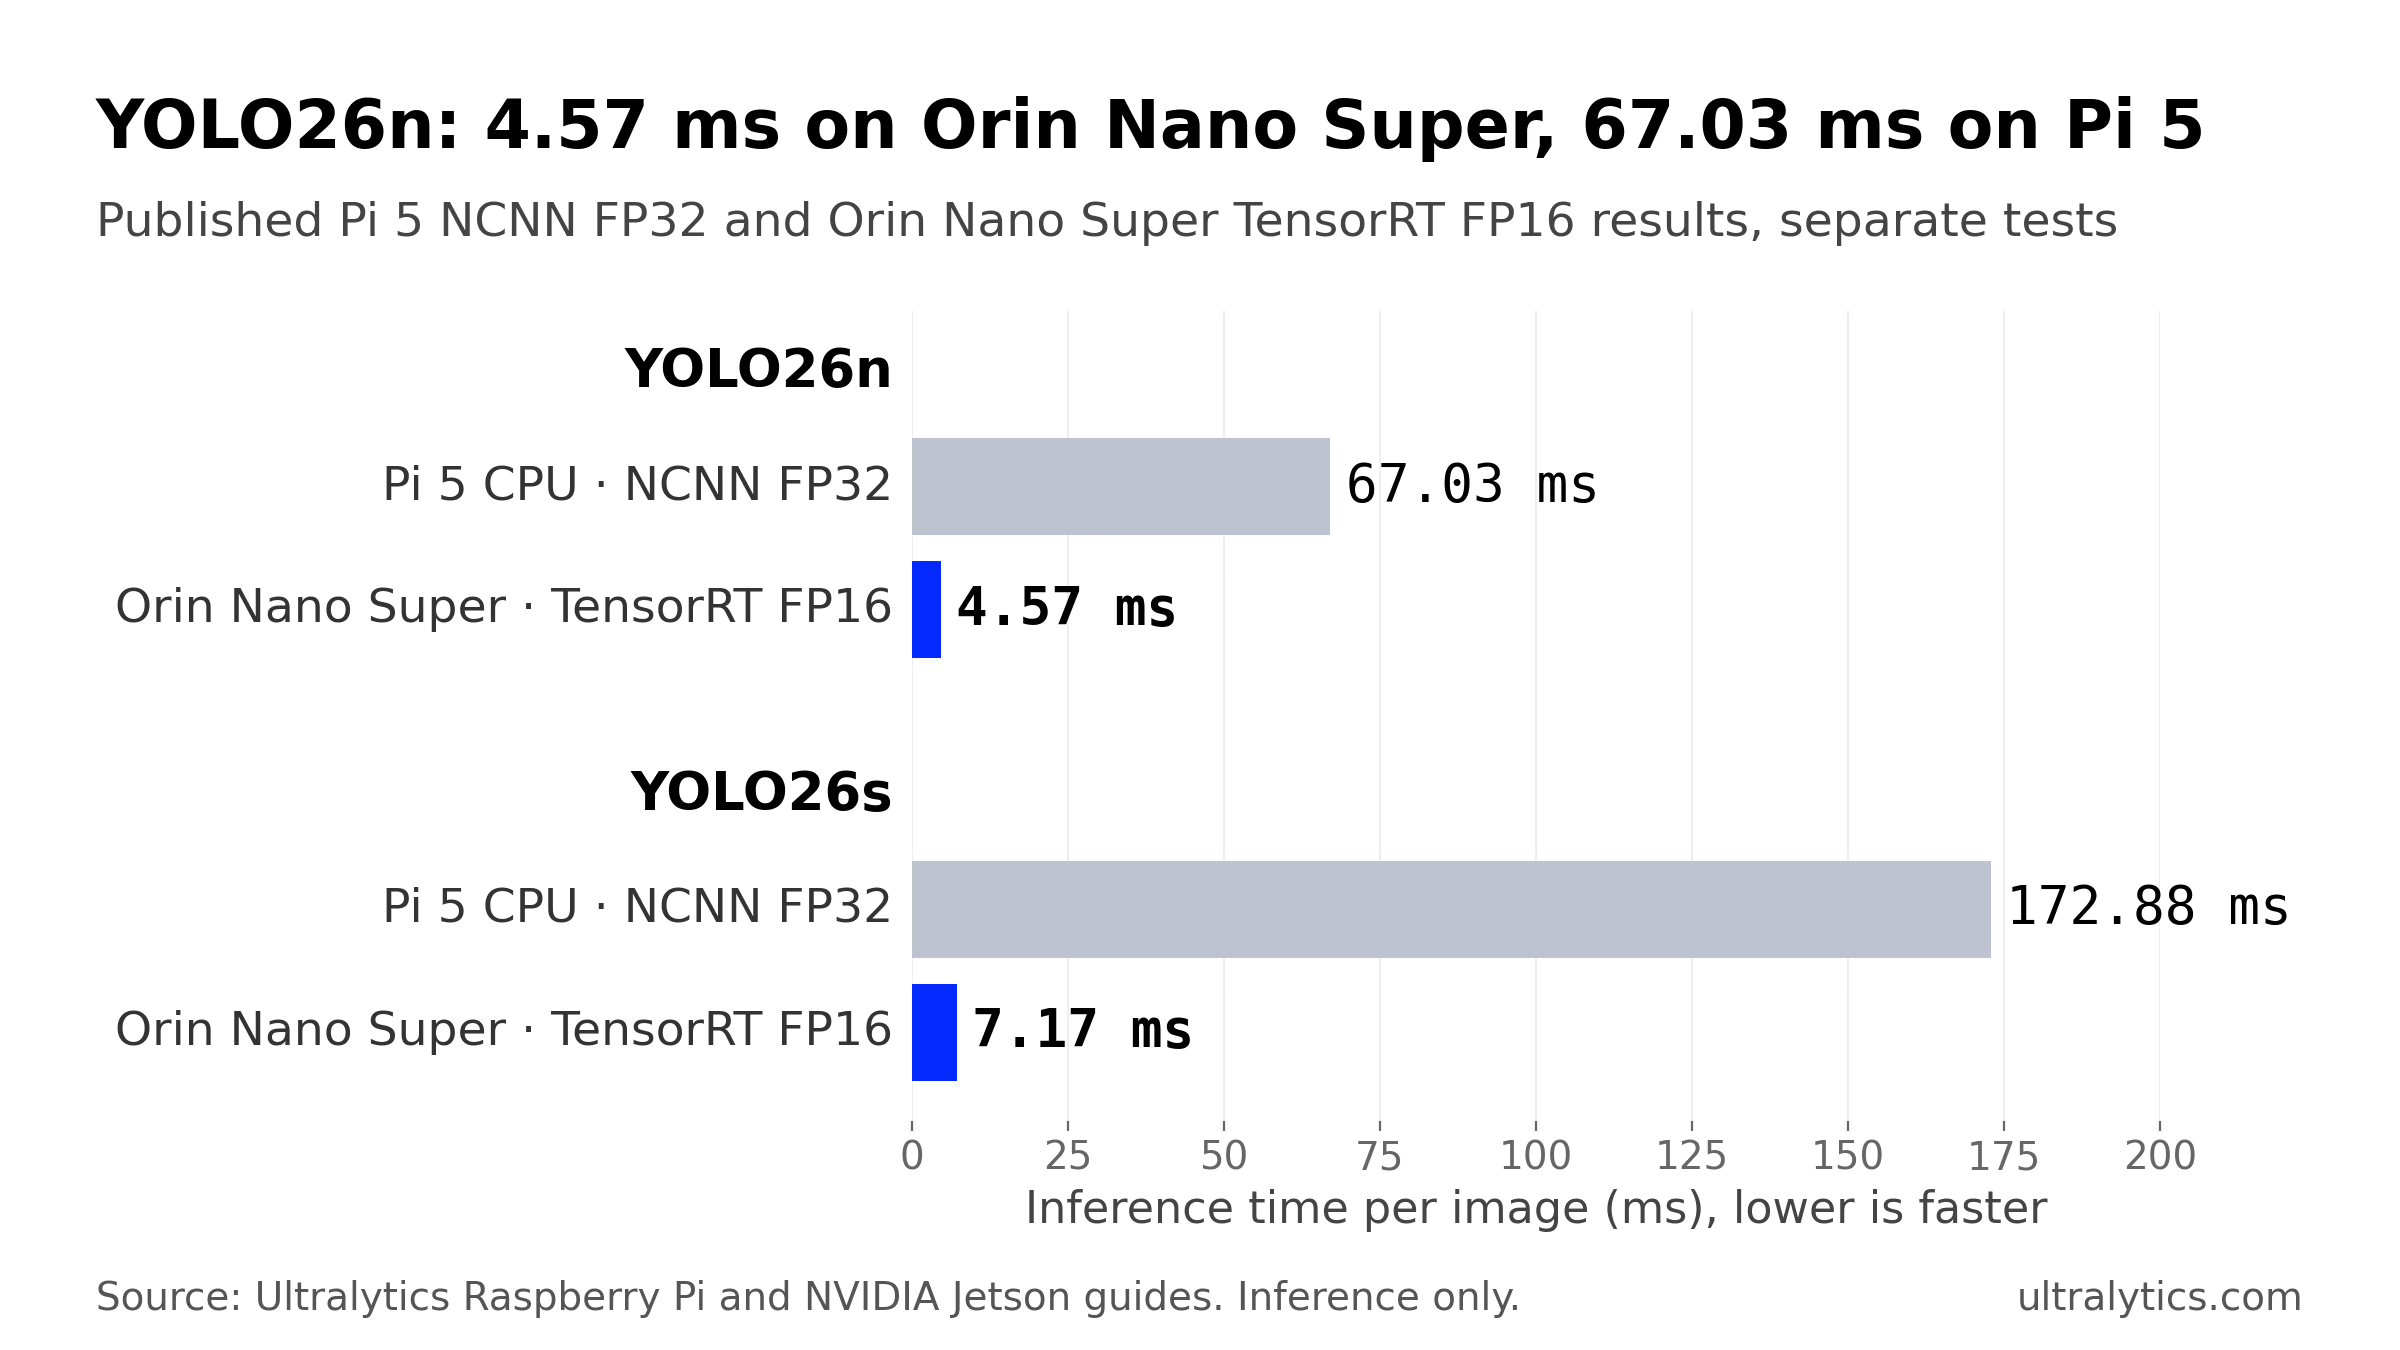
Résultats publiés en NCNN FP32 et TensorRT FP16 issus de tests distincts : Raspberry Pi 5 avec Ultralytics 8.4.108, Orin Nano Super Developer Kit avec Ultralytics 8.4.33. Inférence uniquement, hors prétraitement et post-traitement. Source : guides Ultralytics Raspberry Pi et NVIDIA Jetson.
Pour YOLO26n, cela représente environ 93 % de temps d’inférence en moins que sur le CPU du Pi 5. La précision explique en partie l’écart : compare donc aussi les exports FP32. Le moteur TensorRT FP32 de l’Orin Nano Super nécessite 7,53 ms, soit encore près de neuf fois moins que l’export NCNN FP32 du Pi, même si les moteurs d’exécution et les versions de test diffèrent. Le résultat le plus marquant concerne YOLO26m : un mAP50-95 de 0,6225 en 13,59 ms, alors que le CPU du Pi 5 exécutait ce modèle à environ une image par seconde lors de l’ancien test ONNX.
INT8 réduit encore un peu le temps. YOLO26n passe à 3,80 ms avec un moteur INT8, mais son mAP50-95 baisse de 0,4800 à 0,4490 sur COCO128. Commence donc par FP16 et passe à la quantification INT8 seulement si FP16 ne respecte pas ton budget et que tu peux effectuer l’étalonnage sur des images provenant de tes propres caméras. Notre leçon de l’Academy sur l’optimisation avec TensorRT explique comment faire ce choix.
Le FPS baisse quand tu ajoutes des caméras, car tous les flux partagent le même budget#
Un scénario courant lors du passage à l’échelle : une caméra fonctionne correctement, puis la fréquence d’images traitées diminue quand tu en ajoutes une troisième ou une quatrième. Chaque image nécessite du décodage, du prétraitement, de l’inférence et du post-traitement, et chaque caméra utilise les mêmes ressources de calcul. Sur un Pi 5, les quatre mêmes cœurs CPU décodent la vidéo et exécutent le modèle : chaque flux ajouté leur demande donc du temps pour ces deux tâches.
Ultralytics gère les opérations nécessaires. Indique une source par ligne dans un fichier .streams et transmets-le au mode Predict : chaque flux dispose de son propre thread de lecture et le chargeur regroupe dans un lot la dernière image de chaque caméra ; une source lente ou interrompue peut donc retarder le lot. Les moteurs d’exécution qui acceptent les lots le traitent en une seule passe avant ; NCNN traite les images une par une, tandis qu’un moteur TensorRT à forme fixe répartit ou complète le lot pour l’adapter à la taille d’export. Par défaut (stream_buffer=False), un modèle lent ignore les images périmées au lieu de les mettre en file d’attente, ce qui limite la longueur de la file d’attente dans ton application, même si la mise en mémoire tampon de la caméra, du décodeur ou du réseau peut toujours ajouter de la latence.
La latence sur une seule image est un point de départ, pas un indicateur du nombre de caméras. Le regroupement en lots modifie le débit, et le décodage, le suivi et le dessin ont aussi un coût. La leçon sur l’inférence mult flux de l’Ultralytics Academy présente la règle de dimensionnement : le nombre de flux par appareil correspond approximativement au débit soutenu à la taille de lot réelle, divisé par le FPS requis par flux, avec une marge de 20 à 30 % pour les pics. Mesure ce débit sur la carte avec tes caméras connectées, comme l’explique la partie pratique ci-dessous. Pour les pipelines multicaméras sur Jetson, DeepStream traite plusieurs sources avec un seul moteur TensorRT dans une application unique à vues juxtaposées.
Choisis en fonction du FPS mesuré par caméra, de la taille du modèle et de la précision#
Commence par la carte la moins chère qui pourrait convenir, mesure ses performances avec tes propres caméras et ne passe à une carte supérieure que si elle ne suffit pas :
| Si tes mesures montrent que… | Commencer par |
|---|---|
| YOLO26n atteint ton objectif de précision et le FPS requis par caméra | Un CPU de Pi 5 avec NCNN. Une tâche à faible FPS peut accepter plusieurs caméras. |
| Le Pi ne fournit pas assez d’images par seconde, mais tu veux continuer à l’utiliser | Un Pi 5 avec un accélérateur comme le Hailo-8 AI HAT+ ou le DEEPX DX-M1. Les deux exécutent des modèles quantifiés et nécessitent une étape de compilation : vérifie donc la précision après l’export. |
| Tu as besoin d’un modèle plus grand à un FPS supérieur, de davantage de flux que le Pi ne peut en gérer ou de temps CPU pour d’autres logiciels | Un Jetson Orin Nano Super avec TensorRT, puis un Orin NX ou un AGX Orin si le débit mesuré est insuffisant. |
La fréquence d’images est d’abord une exigence métier, ensuite une valeur de benchmark. Notre guide sur le FPS en vision par ordinateur explique comment la définir en fonction de la vitesse de ce que tu observes, et notre guide pour choisir le bon appareil en périphérie couvre d’autres cartes que ces deux modèles.
Mesure les performances des deux cartes avec tes propres caméras#
Les chiffres ci-dessus ont été mesurés dans des conditions fixes ; les tiens varieront selon le refroidissement, le mode d’alimentation, l’image du système d’exploitation, la version logicielle et ton propre modèle. Le paquet Ultralytics utilise la même API sur les deux cartes : tu peux donc effectuer les mêmes mesures sur chacune. Les commandes ci-dessous ont été vérifiées avec Ultralytics 8.4.215.
Étape 1 : compare les formats d’export sur chaque carte#
Exécute yolo benchmark model=yolo26n.pt data=coco128.yaml imgsz=640 sur la carte. Le mode Benchmark indique la taille, le mAP50-95 et le temps d’inférence pour chaque format d’export pris en charge par la carte ; ajoute quantize=16 ou quantize=8 pour mesurer FP16 ou INT8 lorsqu’un format le permet. Sur un Orin Nano Super Developer Kit flashé avec une configuration compatible Super, sélectionne d’abord le mode d’alimentation MAXN SUPER ; dans l’article de NVIDIA sur le mode Super pour JetPack 6.2 sur Orin Nano, il s’agit de sudo nvpmodel -m 2. Exécute ensuite sudo jetson_clocks. Surveille les températures pendant les exécutions prolongées.
Étape 2 : exporte le format le plus rapide sur chaque carte#
Sur le Raspberry Pi 5, exporte au format NCNN en suivant notre tutoriel sur le Raspberry Pi 5. Sur le Jetson, crée le moteur directement sur l’appareil, car les moteurs TensorRT dépendent du GPU et de la version de TensorRT utilisés pour les générer. Un moteur exporté sans dynamic a une forme d’entrée fixe. Tu peux, par exemple, définir batch en fonction du nombre de caméras, puis réexporter avec une valeur imgsz plus petite si tu as besoin de plus de vitesse :
from ultralytics import YOLO

# Jetson uniquement : nécessite un GPU NVIDIA. Moteur TensorRT FP16, 640 pixels, lot de quatre caméras
YOLO("yolo26n.pt").export(format="engine", quantize=16, imgsz=640, batch=4)  # writes yolo26n.engine
Étape 3 : mesure le FPS traité par caméra#
Mets une URL RTSP par ligne dans cams.streams, exécute le modèle de la carte pendant environ une minute et compare le FPS traité de chaque caméra à sa fréquence d’émission. Le chronomètre démarre après le premier lot complet, une fois les flux connectés et le modèle prêt, et s’arrête à la fin d’un lot complet :
import time
from collections import Counter

from ultralytics import YOLO

model = YOLO("yolo26n.engine")  # on the Pi 5: YOLO("yolo26n_ncnn_model")
cameras = open("cams.streams").read().split()
n_streams = len(cameras)

frames, start = Counter(), None
for i, result in enumerate(model("cams.streams", stream=True)):
    if i < n_streams:  # first batch: connection and warm-up
        if i == n_streams - 1:
            start = time.perf_counter()
        continue
    frames[i % n_streams] += 1  # results arrive in stream order within each batch
    if (i + 1) % n_streams == 0 and time.perf_counter() - start > 60:
        break

elapsed = time.perf_counter() - start
for slot, count in sorted(frames.items()):
    print(f"{cameras[slot]}: {count / elapsed:.1f} processed FPS")
Cette mesure indique le débit de résultats traités par ce pipeline. Si le FPS traité d’une caméra reste nettement inférieur à sa fréquence d’images lorsque tu ajoutes des flux, la carte ne suit pas. Vérifie-le à l’aide de compteurs explicites d’images perdues par flux dans l’exemple producteur-consommateur de la leçon mult flux de l’Academy, ajoute le suivi ou le dessin dont ton application a besoin, puis réexporte avec une valeur imgsz plus petite, passe à un modèle plus petit ou à un export plus rapide, ou choisis un matériel plus puissant, puis recommence la mesure.
Si tu préfères éviter de configurer un environnement de compilation, l’onglet Export de la plateforme Ultralytics génère des moteurs TensorRT pour les appareils Jetson, notamment pour l’Orin Nano 8 Go Super. Les configurations Orin sont compilées sur un AGX Orin et leur validation sur l’Orin Nano lui-même est toujours en attente. Vérifie donc que les versions de TensorRT et de CUDA de ton appareil sont compatibles avec le moteur, puis valide chaque moteur sur l’appareil où tu le déploieras. Pour comparer ONNX Runtime à TensorRT sur les GPU NVIDIA, consulte ONNX contre TensorRT.
Quelle carte choisir#
Choisis un Raspberry Pi 5 lorsque YOLO26n atteint ton objectif de précision et que le FPS traité mesuré sur la carte suffit pour toutes les caméras dont tu as besoin. À environ 15 FPS d’inférence, c’est une configuration simple pour les caisses de magasins, le comptage sur convoyeur, les caméras de surveillance de la faune et de la maison, ainsi que les premiers prototypes de robots. Ajoute un accélérateur si tu as besoin de davantage d’images tout en souhaitant conserver le Pi.
Choisis un Jetson Orin Nano Super si tu as besoin d’un modèle plus grand que nano à une fréquence d’images exploitable, de davantage de flux que le Pi ne peut en gérer ou de temps CPU disponible pour le suivi, la navigation et le reste de ton application. YOLO26s à YOLO26l nécessitent moins de 18 ms d’inférence par image sur cette carte, et cette marge te permet d’ajouter des caméras. Mesure l’application complète pour le confirmer.
Le rôle d’Ultralytics#
Ultralytics ne fabrique aucune de ces cartes ; nous développons les modèles et les outils qui fonctionnent sur les deux. Les mêmes poids YOLO26 s’exportent au format NCNN pour le Pi 5, au format Hailo pour un Pi équipé de l’AI HAT+, et au format TensorRT pour un Jetson. Tu peux ainsi prototyper sur un Pi puis passer à un Jetson quand la charge de travail augmente, sans réentraînement ; valide la précision après chaque export. La plateforme Ultralytics gère les étapes précédant le déploiement : annote un jeu de données, entraîne dans le cloud si ton projet nécessite davantage de ressources de calcul que celles dont tu disposes localement, puis exporte pour l’une ou l’autre carte.
Limites : nos benchmarks publiés mesurent uniquement l’inférence sur les appareils de test indiqués, et non sur tes caméras, dans ton boîtier ou sur ton module de production ; notre guide Jetson ne comprend pas non plus de résultats YOLO26 pour le Jetson Nano original. Ultralytics YOLO est disponible sous licence AGPL-3.0 ou sous licence Ultralytics Enterprise ; consulte les licences Ultralytics pour déterminer celle qu’il te faut pour ton déploiement.
Foire aux questions
Il est nettement plus rapide par image. Dans nos benchmarks publiés issus de tests distincts, YOLO26n nécessite 4,57 ms sous forme de moteur TensorRT FP16 sur un Jetson Orin Nano Super Developer Kit, contre 67,03 ms avec NCNN sur le CPU d’un Raspberry Pi 5 (entrée de 640 pixels, inférence uniquement), tandis que YOLO26m nécessite 13,59 ms sur le Jetson. Le besoin dépend de ton modèle, du nombre de caméras et de ton objectif de FPS : si le Pi 5 répond à ces besoins d’après tes propres mesures, c’est la configuration la plus simple.
Non. Le Jetson Nano original, lancé en 2019, est équipé d’un GPU Maxwell à 128 cœurs et de 4 Go de mémoire, et ne prend en charge que JetPack 4. Le Jetson Orin Nano est un module plus récent doté d’un GPU Ampere à 1 024 cœurs ; le Jetson Orin Nano Super Developer Kit que nous avons évalué possède 8 Go de mémoire et prend en charge JetPack 5 à 7. La comparaison des performances de cet article porte sur l’Orin Nano Super, et non sur le Nano original.
Oui. Le Jetson Nano de 2019 prend en charge JetPack 4, Ultralytics fournit une image Docker JetPack 4, et notre guide DeepStream pour YOLO26 avec TensorRT a été testé sur un Jetson Nano 4 Go avec JetPack 4.6.4. Notre guide Jetson ne comprend pas de benchmark YOLO26 pour cet appareil, dont le matériel est bien moins puissant que celui de l’Orin Nano Super.
Tous les flux partagent les ressources de calcul de la carte : chaque caméra ajoutée nécessite ses propres opérations de décodage, de prétraitement, d’inférence et de post-traitement. Avec un fichier
.streams, Ultralytics regroupe en lots les images de toutes les caméras et ignore les images périmées lorsque le modèle prend du retard. Le FPS traité de chaque caméra peut donc baisser dès que le pipeline partagé devient le goulot d’étranglement. Un export plus rapide, un modèle plus petit ouimgsz, ou encore un matériel plus puissant, peut l’augmenter.Oui. Entraîne une seule fois, puis exporte les mêmes poids avec
format="ncnn"pour le Pi 5 etformat="engine"pour le Jetson, en créant le moteur TensorRT sur l’appareil cible ou pour celui-ci. Valide la précision sur tes propres données après chaque export.
Écrit par
Ingénieur senior en apprentissage automatique · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









