Comparaison des plateformes d’entraînement gérées et des GPU autohébergés pour la vision par ordinateur
Compare les plateformes d’entraînement GPU gérées, les services de ML cloud, les GPU loués et ton propre matériel pour la vision par ordinateur : coûts, configuration, seuil de rentabilité et cas d’usage.
 Miles Deans12 min de lecture
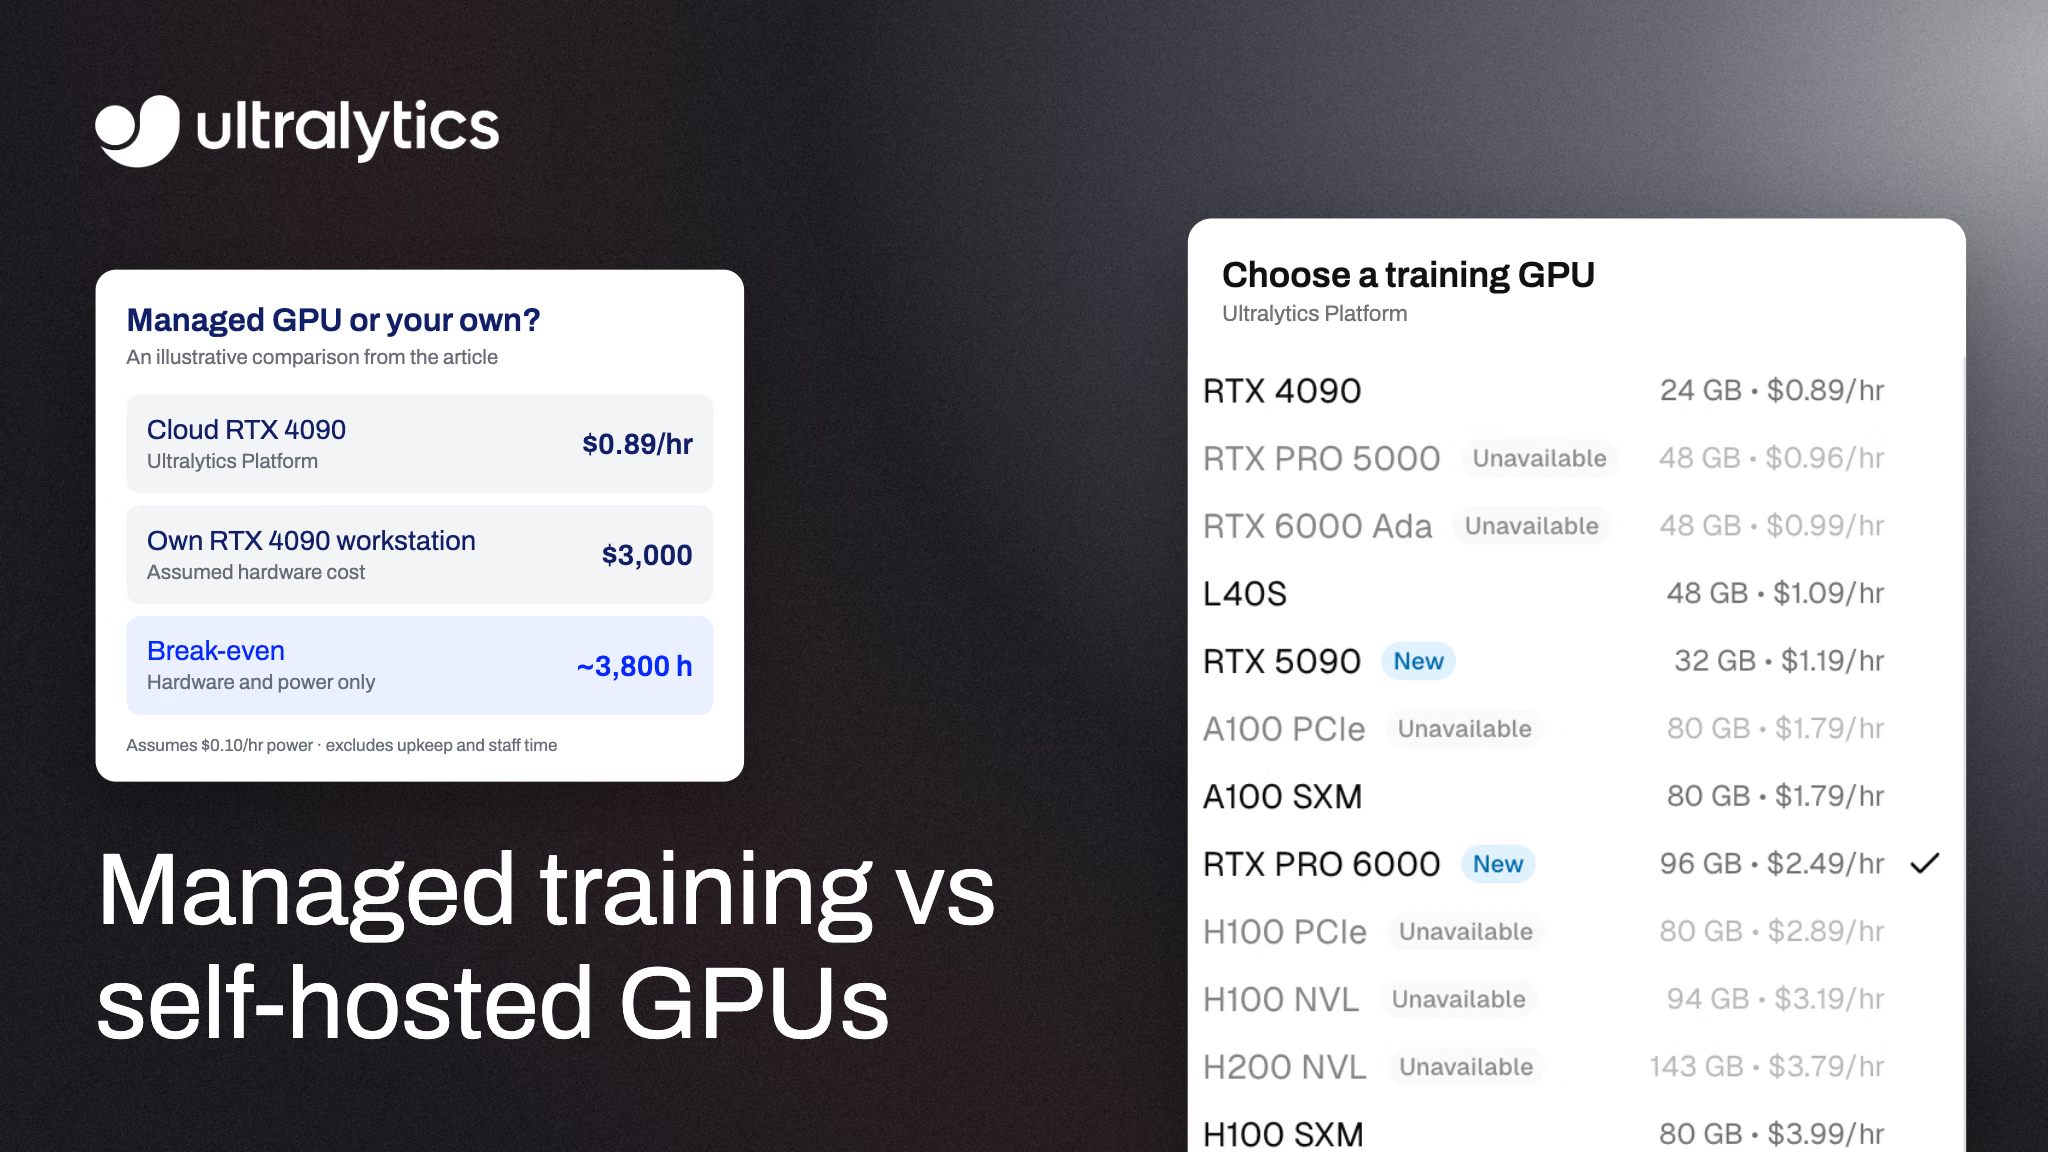
Les plateformes d’entraînement gérées prennent en charge l’infrastructure d’entraînement à ta place et facturent le temps GPU ; avec des GPU autohébergés, ton équipe est responsable du matériel et de l’environnement, que tu loues des machines ou que tu les possèdes. L’entraînement géré convient généralement aux charges de travail intermittentes et aux équipes qui veulent réduire le travail d’infrastructure. Posséder des GPU peut coûter moins cher lorsque leur utilisation est soutenue, mais le résultat dépend de leur taux d’utilisation, de leur durée de vie utile, du coût de l’électricité et du temps d’ingénierie.
Ce guide compare quatre options courantes pour entraîner des modèles de vision en 2026, montre comment calculer le seuil de rentabilité pour ta charge de travail et explique où s’inscrit Ultralytics Platform.
Les quatre options pour entraîner un modèle de vision#
L’expression « géré ou autohébergé » recouvre généralement quatre configurations différentes :
- Une plateforme gérée d’entraînement en vision. Tu importes ou connectes un jeu de données, choisis un modèle et un GPU, puis la plateforme lance l’entraînement. Ultralytics Platform fonctionne ainsi pour les modèles YOLO.
- Une plateforme de ML généraliste. Des services comme Amazon SageMaker, Google Vertex AI et Azure Machine Learning exécutent des tâches d’entraînement sur des instances cloud pour de nombreux frameworks. Tu configures la tâche d’entraînement, son environnement, les autorisations et le stockage ; le calcul et les services associés sont facturés séparément. Compare donc les tarifs indiqués sur la page officielle de chaque fournisseur, et pas seulement les tarifs GPU.
- Un GPU cloud loué. Des fournisseurs de GPU cloud comme RunPod et Lambda te louent une machine à l’usage. À moins que l’image du fournisseur inclue déjà ce dont tu as besoin, tu configures les pilotes, CUDA, les paquets Python et le code d’entraînement, puis tu arrêtes l’instance une fois terminé.
- Ton propre GPU. Une station de travail ou un serveur dans tes bureaux ou ton centre de données. Tu achètes le matériel une fois et paies l’électricité, le refroidissement, l’entretien et le temps passé à le maintenir en état de marche.
Entraînement géré ou GPU autohébergés en un coup d’œil#
| Critère de décision | Plateforme de vision gérée | Plateforme de ML généraliste | GPU cloud loué | GPU personnel |
|---|---|---|---|---|
| Achat de matériel requis | Non | Non | Non | Oui |
| Tu paies pour | Le temps GPU utilisé | Le temps d’instance et les services associés | Le temps d’instance pendant son fonctionnement | Le matériel, l’électricité et l’entretien |
| Configuration avant le premier lancement | Choisir le jeu de données, le modèle et le GPU | Configurer la tâche, l’environnement, les autorisations et le stockage | Configurer ou vérifier l’environnement, le code et les dépendances | Matériel, système d’exploitation, pilotes, paquets |
| Environnement d’entraînement | Géré par la plateforme ; tu choisis les paramètres | Partagé entre le service et ton équipe | Principalement ton équipe | Ton équipe |
| Passer à un GPU plus puissant | Sélectionner un autre GPU disponible | Sélectionner un autre type d’instance | Louer une autre machine | Acheter un autre GPU |
| Emplacement des données | Stockage de la plateforme, compartiment cloud connecté (Pro et Enterprise) ou données sur site (Enterprise) | Ton compte cloud | Là où tu les copies | Dans tes locaux |
| À envisager quand | Tu veux un entraînement en vision rapide et reproductible | Ton équipe a déjà standardisé ses outils de ML sur un cloud | Ton équipe d’ingénierie sait gérer des machines | L’entraînement est régulier et presque continu, ou les règles imposent un hébergement sur site strict |
Comment est facturé l’entraînement GPU géré#
Sur Ultralytics Platform, il est simple d’estimer la partie GPU d’un entraînement :
GPU cost = selected GPU hourly rate × billable GPU hoursQuand tu compares des fournisseurs, utilise la même charge de travail et le même objectif de précision, puis ajoute les éventuels frais d’abonnement, de stockage et de transfert de données, ainsi que le temps d’ingénierie.
Ultralytics Platform propose 26 types de GPU NVIDIA, à partir de 0,24 $/h, sans minimum ni engagement ; l’offre Free permet d’en utiliser 24, et les offres Pro et Enterprise donnent accès aux 26. Voici quelques choix courants :
| GPU | Mémoire vidéo | Prix par heure |
|---|---|---|
| RTX 4090 | 24 GB | $0.89 |
| A100 SXM | 80 GB | $1.79 |
| RTX PRO 6000 (recommandé par défaut) | 96 GB | $2.49 |
| H100 SXM | 80 GB | $3.99 |
| B200 (offres Pro et Enterprise) | 180 GB | $7.99 |
La facturation est basée sur le temps GPU réellement utilisé. Les entraînements terminés ou annulés, ainsi que ceux qui échouent après le démarrage du GPU, sont facturés selon le temps GPU écoulé ; un échec avant le démarrage du GPU ne coûte rien. La boîte de dialogue d’entraînement estime la durée et le coût avant le lancement, et chaque estimation réserve au moins 15 minutes de temps GPU sur ton solde ; cette réservation détermine le solde nécessaire au lancement, tandis que la facturation est basée sur le temps GPU réellement utilisé.
À titre de référence, les durées d’entraînement typiques indiquées par Ultralytics pour 1 000 images et 100 époques sur un RTX PRO 6000 sont d’environ 15 minutes pour YOLO26m et 30 minutes pour YOLO26x. À 2,49 $ l’heure, cela représente environ 0,62 $ et 1,25 $ de temps GPU. Les durées réelles varient selon la taille des images, l’augmentation des données et la taille des lots ; considère donc ces valeurs comme des points de départ plutôt que comme des devis.
Le coût réel des GPU autohébergés#
Un GPU que tu possèdes n’entraîne pas de facture horaire, mais chaque entraînement n’est pas gratuit pour autant. Le coût total comprend :
- Le matériel, ainsi que le reste de la station de travail ou du serveur qui héberge le GPU.
- L’électricité et le refroidissement pour chaque heure d’entraînement.
- Le temps d’ingénierie consacré aux pilotes, aux versions de CUDA, aux conflits entre paquets et aux environnements défaillants.
- Le temps d’inactivité. Un GPU qui sert à l’entraînement deux heures par jour reste inactif le reste du temps, ce qui augmente son coût par heure d’entraînement.
- Les limites de capacité. Quand un modèle nécessite plus de mémoire vidéo que tu n’en possèdes, ou que plusieurs expériences doivent s’exécuter en même temps, tu attends ou tu achètes du matériel supplémentaire.
En supposant que le GPU que tu possèdes soit aussi rapide que le GPU cloud, voici une comparaison simplifiée des coûts du matériel et de l’électricité :
Break-even hours = hardware cost ÷ (cloud hourly rate − your power cost per hour)Prenons un exemple avec des chiffres hypothétiques : une station de travail équipée d’un RTX 4090 te coûte 3 000 $, et l’électricité revient à environ 0,10 $ par heure d’entraînement. Comparé à un RTX 4090 à 0,89 $ l’heure, le seuil de rentabilité est atteint après environ 3 800 heures d’entraînement : soit environ 5,3 mois d’utilisation continue, ou 15,8 mois à raison de huit heures par jour. Ce calcul exclut le refroidissement, l’électricité consommée à l’arrêt, les réparations, le financement, la valeur de revente et ton propre temps. L’achat n’est rentable que si tu effectues autant d’entraînements pendant la durée de vie utile du matériel. Utilise le devis de ton matériel, le prix réel de l’électricité et le nombre d’heures d’entraînement prévu ; le résultat varie considérablement selon le taux d’utilisation.
Quand les GPU autohébergés sont adaptés#
Posséder le matériel est une meilleure option quand :
- Tes GPU sont très sollicités. Le réentraînement continu, les recherches de paramètres à grande échelle ou le partage d’une même machine par une équipe tout au long de la journée augmentent le taux d’utilisation jusqu’au seuil de rentabilité.
- Les données ne peuvent pas quitter tes locaux. Certains environnements réglementés ou isolés d’Internet excluent complètement l’entraînement dans le cloud.
- Tu possèdes déjà le matériel. Si un GPU suffisamment puissant est inutilisé, compare son coût de fonctionnement et son temps d’entraînement aux options cloud avant d’acheter du matériel supplémentaire.
- Tu as besoin d’un contrôle total sur les pilotes, les noyaux ou le code d’entraînement personnalisé qui n’est pas pris en charge par une plateforme gérée.
Quand l’entraînement géré est adapté#
Une plateforme gérée est une meilleure option quand :
- L’entraînement se fait par à-coups. Tu entraînes le modèle lorsque les données changent, puis tu ne l’entraînes pas du tout pendant plusieurs jours.
- Tu veux démarrer dès aujourd’hui. Pas d’installation de pilotes, d’incompatibilités de versions de CUDA ni de débogage de l’environnement avant le premier entraînement.
- La taille des modèles varie. Tu peux entraîner un modèle nano sur un petit GPU et un grand modèle sur un GPU de 80 Go ou plus sans acheter l’un ou l’autre.
- Plusieurs personnes s’occupent de l’entraînement. Les entraînements, les métriques et les points de contrôle sont regroupés au même endroit, plutôt que sur des machines individuelles.
L’option hybride : des GPU personnels et un tableau de bord géré#
Tu n’as pas à choisir l’une ou l’autre option. Ultralytics Platform prend en charge l’entraînement à distance : tu entraînes le modèle sur ton propre GPU avec le paquet ultralytics, diffuses les métriques en direct vers le même tableau de bord Platform que celui utilisé pour les entraînements cloud, puis importes les poids finaux à la fin de l’entraînement. Les entraînements à distance utilisent ton propre GPU, et non les GPU cloud d’Ultralytics ; ils ne consomment donc pas de temps GPU cloud.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(
    data="coco8.yaml",
    epochs=100,
    project="username/my-project",  # ton projet Platform
    name="local-gpu-run",
)
Configure d’abord ta clé API avec export ULTRALYTICS_API_KEY="YOUR_API_KEY". L’intégration Platform nécessite Python 3.11 ou une version ultérieure et ultralytics 8.4.120 ou une version ultérieure. Une méthode courante consiste à effectuer rapidement des expériences sur un GPU local, puis à envoyer les entraînements plus volumineux ou urgents vers un GPU cloud lorsque la machine locale est occupée.
Comment entraîner YOLO26 sur un GPU géré avec Ultralytics Platform#
- Crée un compte sur platform.ultralytics.com. Les nouveaux comptes reçoivent un crédit d’inscription de 5 $, ou de 25 $ après vérification d’une adresse e-mail professionnelle.
- Ajoute un jeu de données en important des images et des annotations, ou connecte un compartiment Amazon S3 avec une offre Pro ou Enterprise.
- Ouvre la boîte de dialogue d’entraînement, choisis un modèle YOLO26 et définis le nombre d’époques et la taille des images.
- Choisis un GPU. Le RTX PRO 6000 est le choix recommandé par défaut ; consulte comment choisir un GPU cloud pour connaître les compromis.
- Vérifie l’estimation des coûts, lance l’entraînement et suis les métriques en direct jusqu’à la fin.
L’offre Free permet d’exécuter jusqu’à 3 tâches d’entraînement cloud simultanément. L’offre Pro, à 29 $ par siège et par mois, porte cette limite à 10 et comprend 30 $ de crédit mensuel par siège.
Une fois l’entraînement terminé, tu peux exporter le modèle ou le déployer sous forme d’API. Si tu cherches également où exécuter l’inférence, notre guide sur l’IA de vision dans le cloud ou autohébergée compare les coûts, la latence et le contrôle des données pour le déploiement.
Foire aux questions
C’est possible, surtout si l’entraînement est intermittent, car tu ne paies que les heures GPU que tu utilises. Compare le coût total et le temps d’exécution pour une même charge de travail ; le calcul du seuil de rentabilité ci-dessus (coût du matériel divisé par le tarif horaire cloud moins le coût horaire de l’électricité) est un point de départ, pas une garantie.
Un GPU cloud loué te donne accès à une machine ; ton équipe configure la charge de travail d’entraînement et vérifie ou configure l’environnement. Une plateforme d’entraînement gérée prend en charge une plus grande partie du processus : sur Ultralytics Platform, tu choisis un jeu de données, un modèle et un GPU, puis la plateforme met le GPU à disposition, lance l’entraînement, diffuse les métriques et enregistre les points de contrôle.
Sur Ultralytics Platform, un entraînement qui échoue après le démarrage du GPU cloud est facturé selon le temps GPU écoulé ; un échec avant le démarrage du GPU ne coûte rien. Les entraînements annulés sont facturés selon le temps GPU écoulé jusqu’à leur annulation.
Oui. L’entraînement à distance s’exécute sur ton propre matériel, diffuse les métriques en direct vers Platform et importe les poids finaux ; il n’utilise donc pas de temps GPU cloud.
Le RTX PRO 6000 (96 Go) est le choix recommandé par défaut pour la plupart des tâches. Ultralytics recommande le RTX 4090 pour l’entraînement général, l’A100 SXM pour les grandes tailles de lots ou les modèles plus volumineux, et les GPU H100, H200, B200 et B300 pour les tâches urgentes, les besoins élevés en mémoire et les charges de travail les plus importantes.
Les nouveaux comptes Ultralytics Platform reçoivent un crédit d'inscription de 5 $, porté à 25 $ après vérification d'une adresse e-mail professionnelle. Les forfaits Pro comprennent 30 $ de crédit par siège et par mois.
Non. Kubernetes peut planifier les charges de travail GPU, mais sa documentation sur la planification des GPU nécessite des pilotes GPU et un plug-in de périphérique du fournisseur sur les nœuds. Un cluster d'entraînement autogéré nécessite toujours qu'une personne prenne en charge les environnements, les autorisations, le suivi des tâches et les points de contrôle ; prévois donc ce travail en plus des ressources de calcul.
Écrit par
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









