ONNX ou TensorRT pour l’inférence en vision par ordinateur : benchmarks et critères de choix
ONNX Runtime ou TensorRT pour l’inférence en vision par ordinateur : mesures de la vitesse et de la précision d’Ultralytics YOLO26 sur 19 GPU NVIDIA, et comment choisir.
 Miles Deans13 min de lecture
ONNX et TensorRT ne sont pas vraiment des concurrents. ONNX est un format de modèle, et TensorRT est le moteur d’inférence de NVIDIA, qui utilise généralement un fichier ONNX en entrée. Le vrai choix porte sur la façon d’exécuter ce fichier : avec ONNX Runtime, qui fonctionne sur différentes plateformes matérielles et peut même déléguer des tâches à TensorRT, ou en le compilant en un moteur TensorRT autonome, qui fonctionne uniquement sur les GPU NVIDIA. Dans les benchmarks d’Ultralytics Platform portant sur Ultralytics YOLO26 et 19 GPU NVIDIA, TensorRT FP16 était plus rapide que les résultats ONNX FP16 publiés sur chaque GPU et pour chaque taille de modèle, avec un écart de précision inférieur ou égal à 0,001 mAP50-95. Les gains de vitesse médians allaient de 1,85x à 2,55x selon la taille du modèle. La page du benchmark ne précise pas quel fournisseur d’exécution ONNX Runtime a produit les résultats ONNX ; ceux-ci ne permettent donc pas de déterminer comment ONNX Runtime se compare en général, ni avec son fournisseur d’exécution TensorRT. Pour Ultralytics YOLO26 sur les GPU NVIDIA, commence par TensorRT FP16 si la latence est importante, et utilise ONNX Runtime si un même fichier de modèle doit fonctionner sur plusieurs types de matériel. Ultralytics YOLO peut être exporté vers les deux formats avec un seul argument.
Par où commencer avec Ultralytics YOLO :
| Déploiement | Commencer par | L’exportation d’Ultralytics YOLO |
|---|---|---|
| GPU NVIDIA, latence importante | TensorRT FP16 | format="engine", quantize=16 |
| CPU, matériel non NVIDIA ou parc hétérogène | ONNX Runtime | format="onnx" |
| API d’ONNX Runtime sur un GPU NVIDIA | ONNX Runtime avec le fournisseur d’exécution TensorRT | format="onnx" |
ONNX ou TensorRT : format, environnement d’exécution et moteur#
Trois éléments différents se cachent derrière cette comparaison :
- ONNX (Échange ouvert de réseaux neuronaux) est un format de fichier qui stocke le graphe et les poids d’un modèle entraîné indépendamment du framework. Tu exportes un modèle de PyTorch vers ONNX pour que d’autres outils puissent le lire.
- ONNX Runtime exécute les modèles ONNX. Il délègue les tâches à des backends matériels appelés fournisseurs d’exécution, comme CPU, CUDA et TensorRT, afin qu’un même fichier puisse s’exécuter sur le CPU d’un ordinateur portable ou sur un GPU dans le cloud.
- TensorRT lit un modèle, généralement un fichier ONNX, à l’aide de son analyseur ONNX. Il fusionne des couches, choisit le noyau le plus rapide pour chaque opération sur le GPU ciblé, puis écrit un moteur optimisé.
La vraie comparaison porte donc sur ONNX Runtime et TensorRT. ONNX Runtime peut aussi faire appel à TensorRT via son fournisseur d’exécution TensorRT, ce qui te permet de conserver l’API d’ONNX Runtime pendant que TensorRT exécute les sous-graphes qu’il prend en charge. ONNX Runtime recommande d’enregistrer le fournisseur d’exécution CUDA après celui-ci, afin que les nœuds non pris en charge par TensorRT puissent s’exécuter sur CUDA.
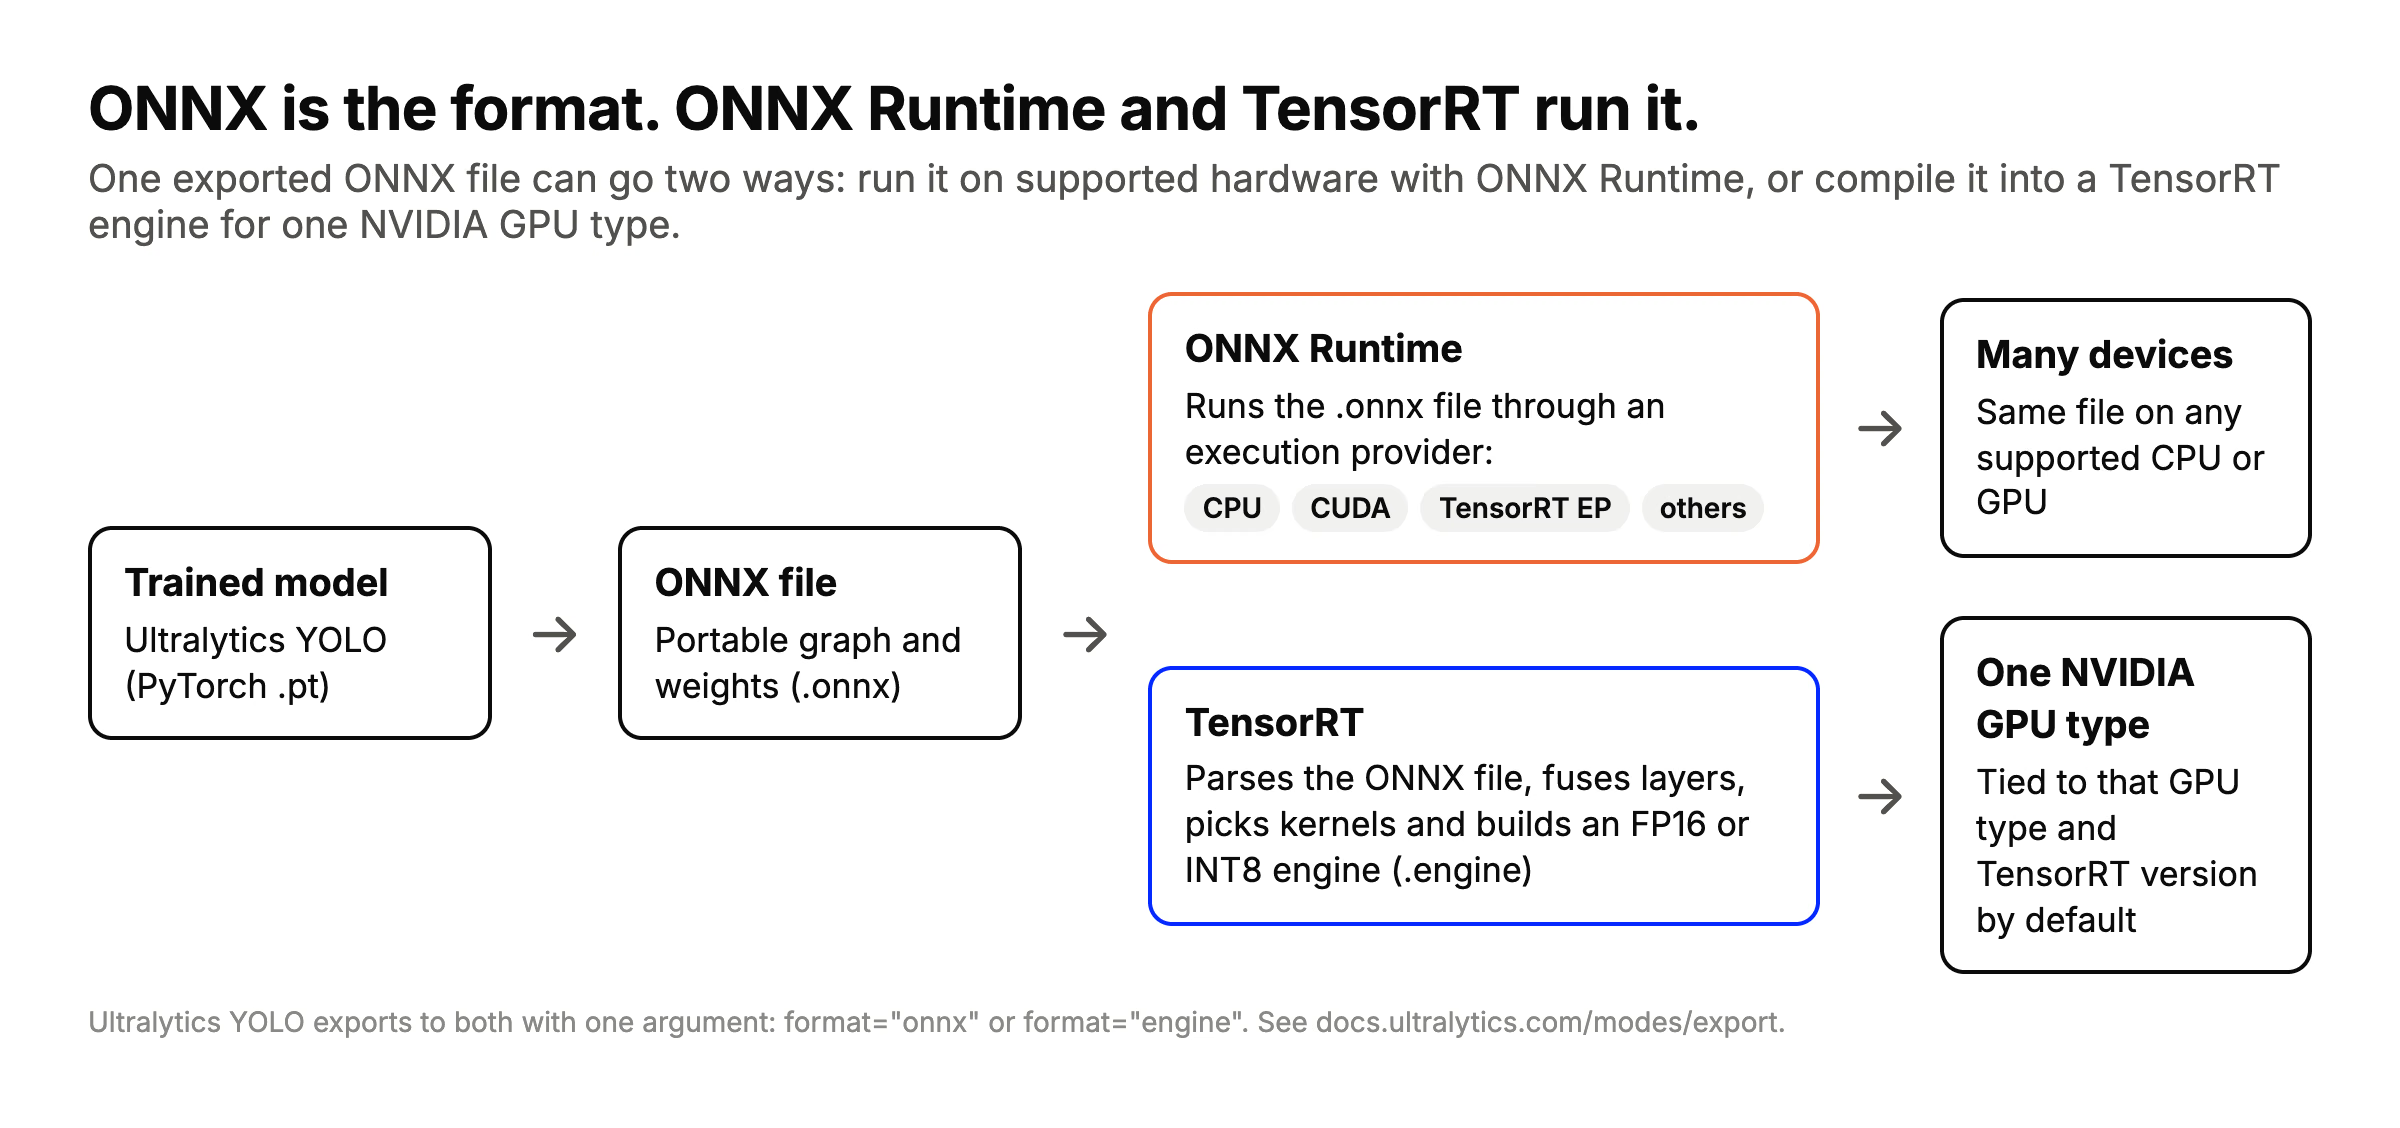
Un seul fichier ONNX, deux possibilités : ONNX Runtime l’exécute sur le matériel pris en charge, tandis que TensorRT le compile en un moteur pour un type de GPU NVIDIA. Ultralytics YOLO peut être exporté vers les deux formats.
Benchmarks : YOLO26 avec ONNX Runtime ou TensorRT#
Les chiffres ci-dessous proviennent des benchmarks d’inférence d’Ultralytics Platform. Chaque modèle de détection Ultralytics YOLO26 a été exporté au format indiqué, puis sa latence d’inférence a été mesurée sur les GPU d’Ultralytics Platform, avec une taille de lot de 1 et une résolution de 640 pixels, sur COCO val2017. La phase de préchauffage a été exclue et les temps par exécution ont été filtrés par sigma. La précision correspond à mAP50-95 sur COCO val2017, mesurée une fois par format et par précision. La comparaison porte sur les 19 GPU NVIDIA (Ampere, Ada et Hopper) pour lesquels des résultats sont disponibles dans les quatre formats.
La page du benchmark n’indique pas quel fournisseur d’exécution ONNX Runtime a produit les résultats ONNX et ne précise pas si certains résultats ont été obtenus avec le fournisseur d’exécution TensorRT d’ONNX Runtime, qui délègue à TensorRT les parties du modèle prises en charge. Ces résultats ONNX décrivent la configuration testée ; les performances peuvent varier selon le fournisseur d’exécution d’ONNX Runtime. Si tu veux utiliser l’API d’ONNX Runtime avec TensorRT en backend, mesure les performances de cette combinaison sur ton propre matériel.
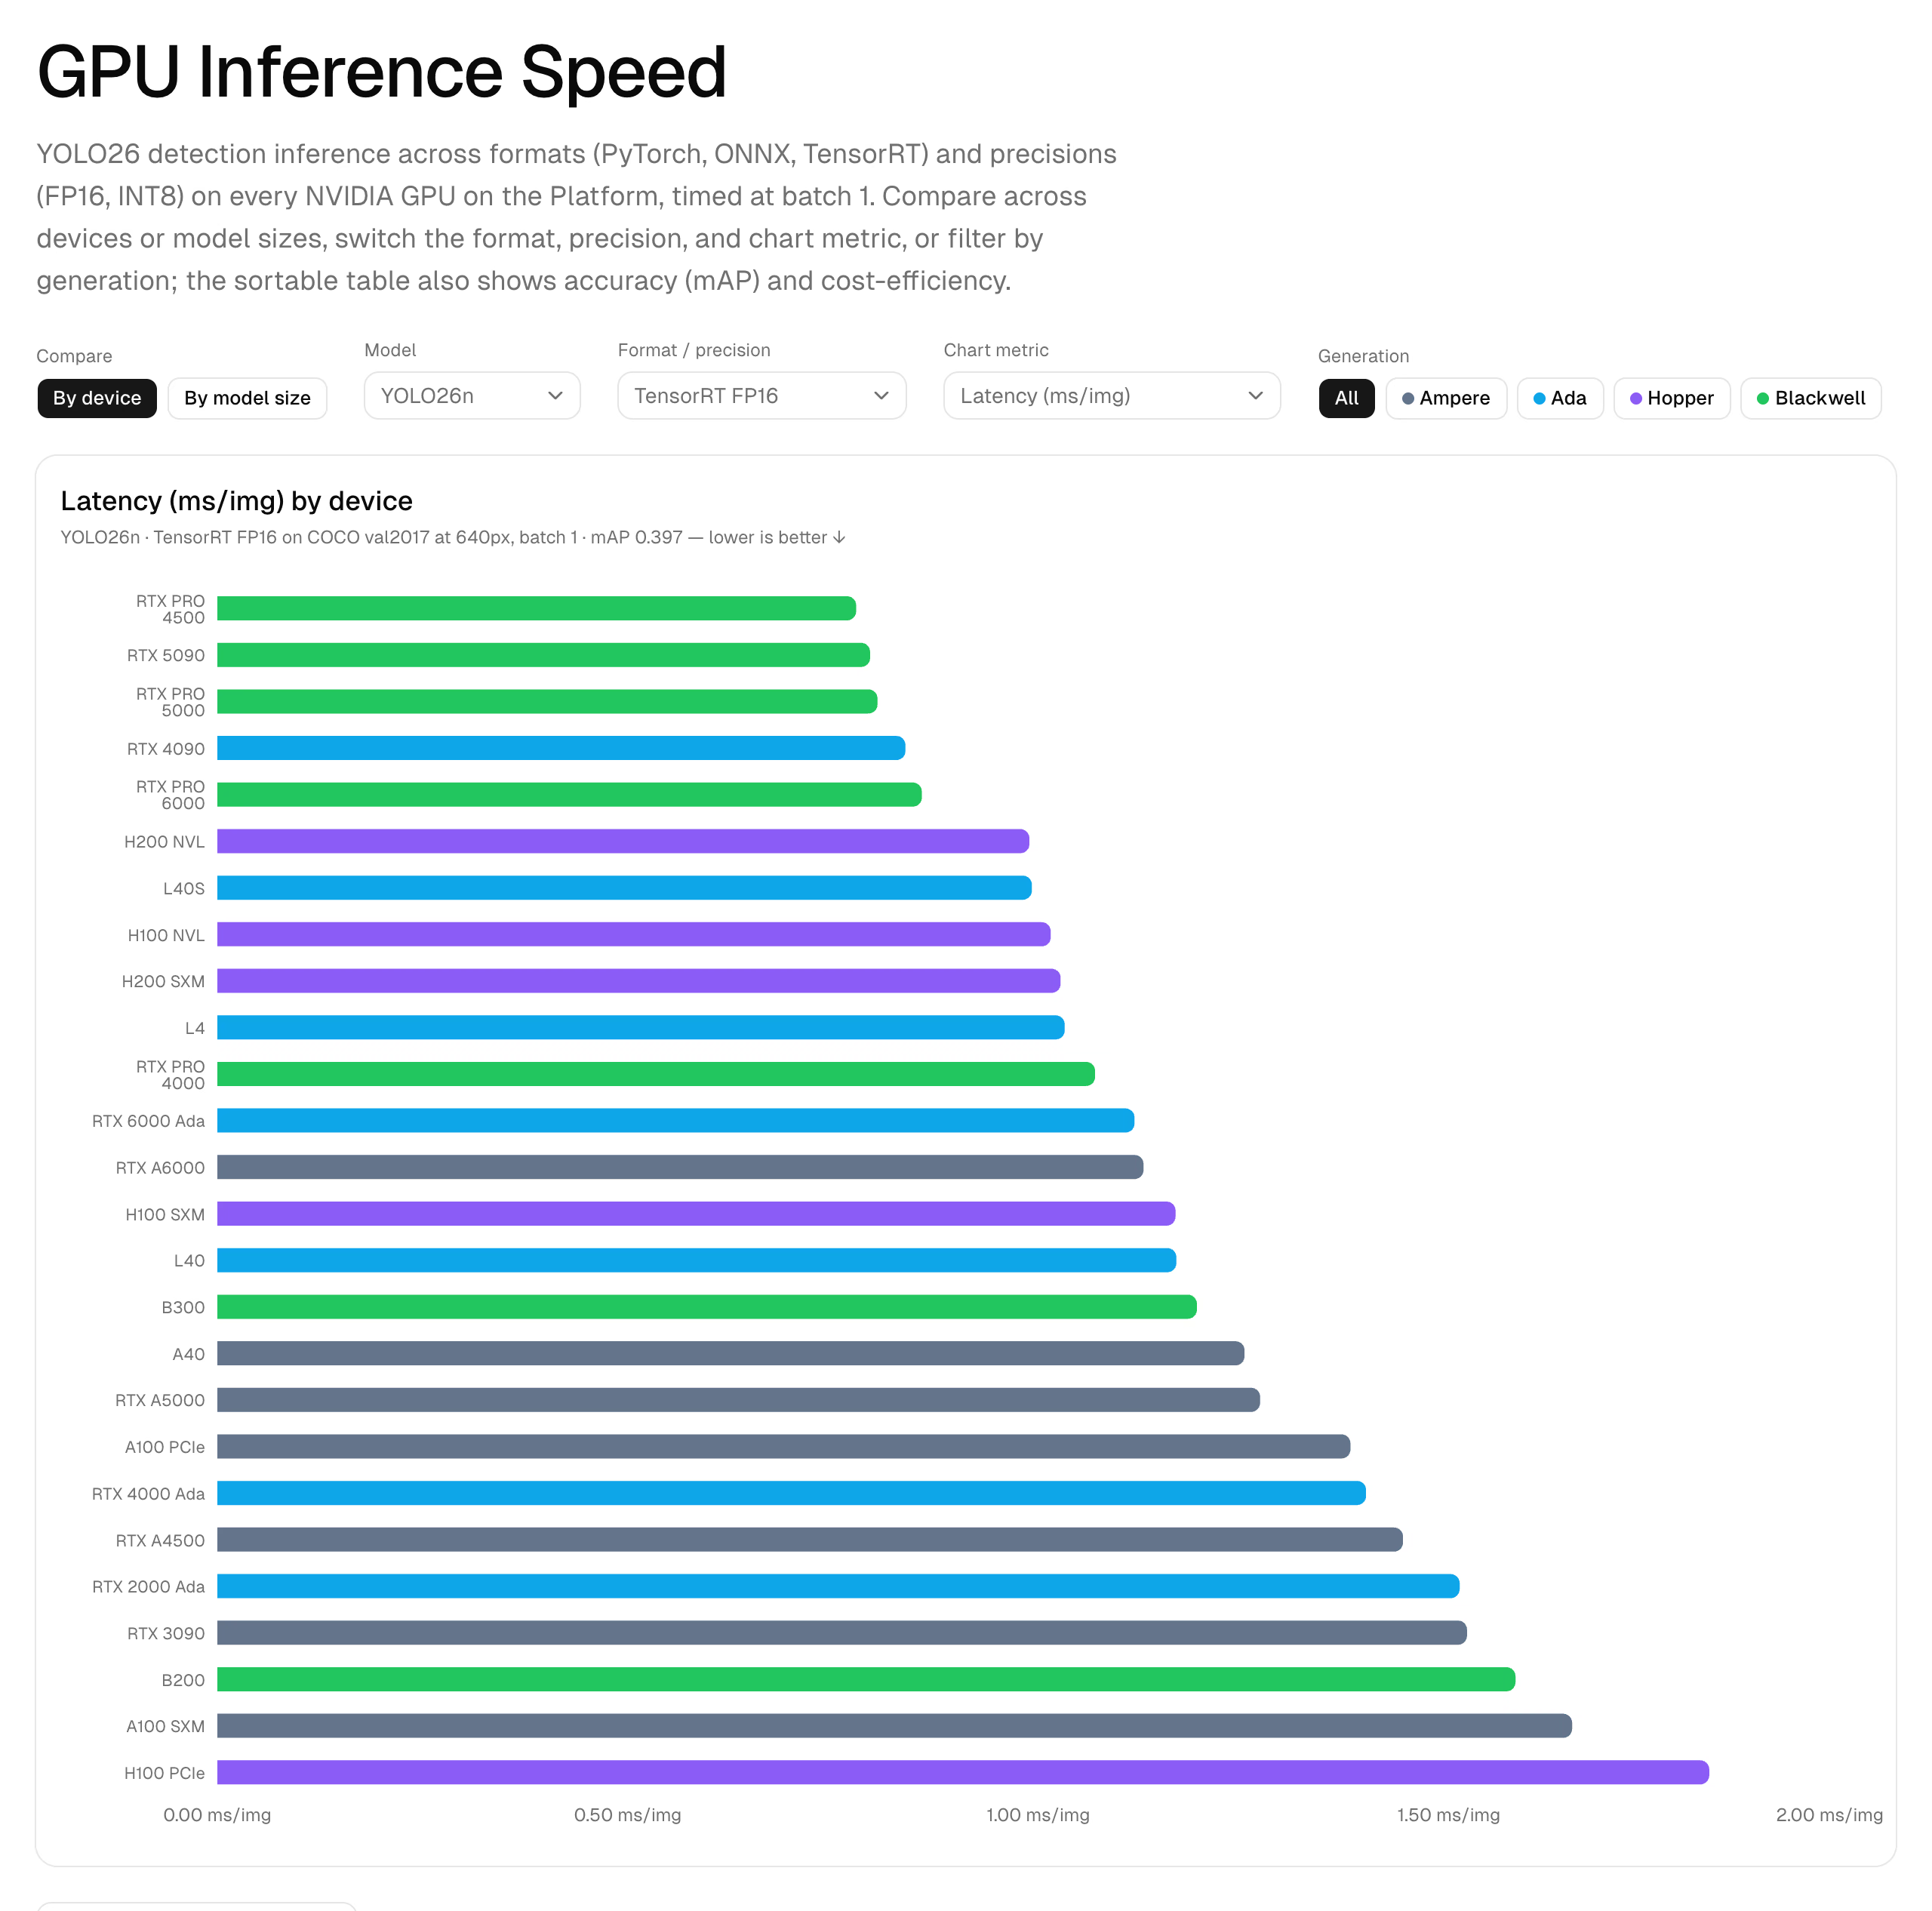
L’onglet Inference te permet de choisir la taille du modèle, le format et la précision, puis de trier les GPU par latence, précision ou coût.
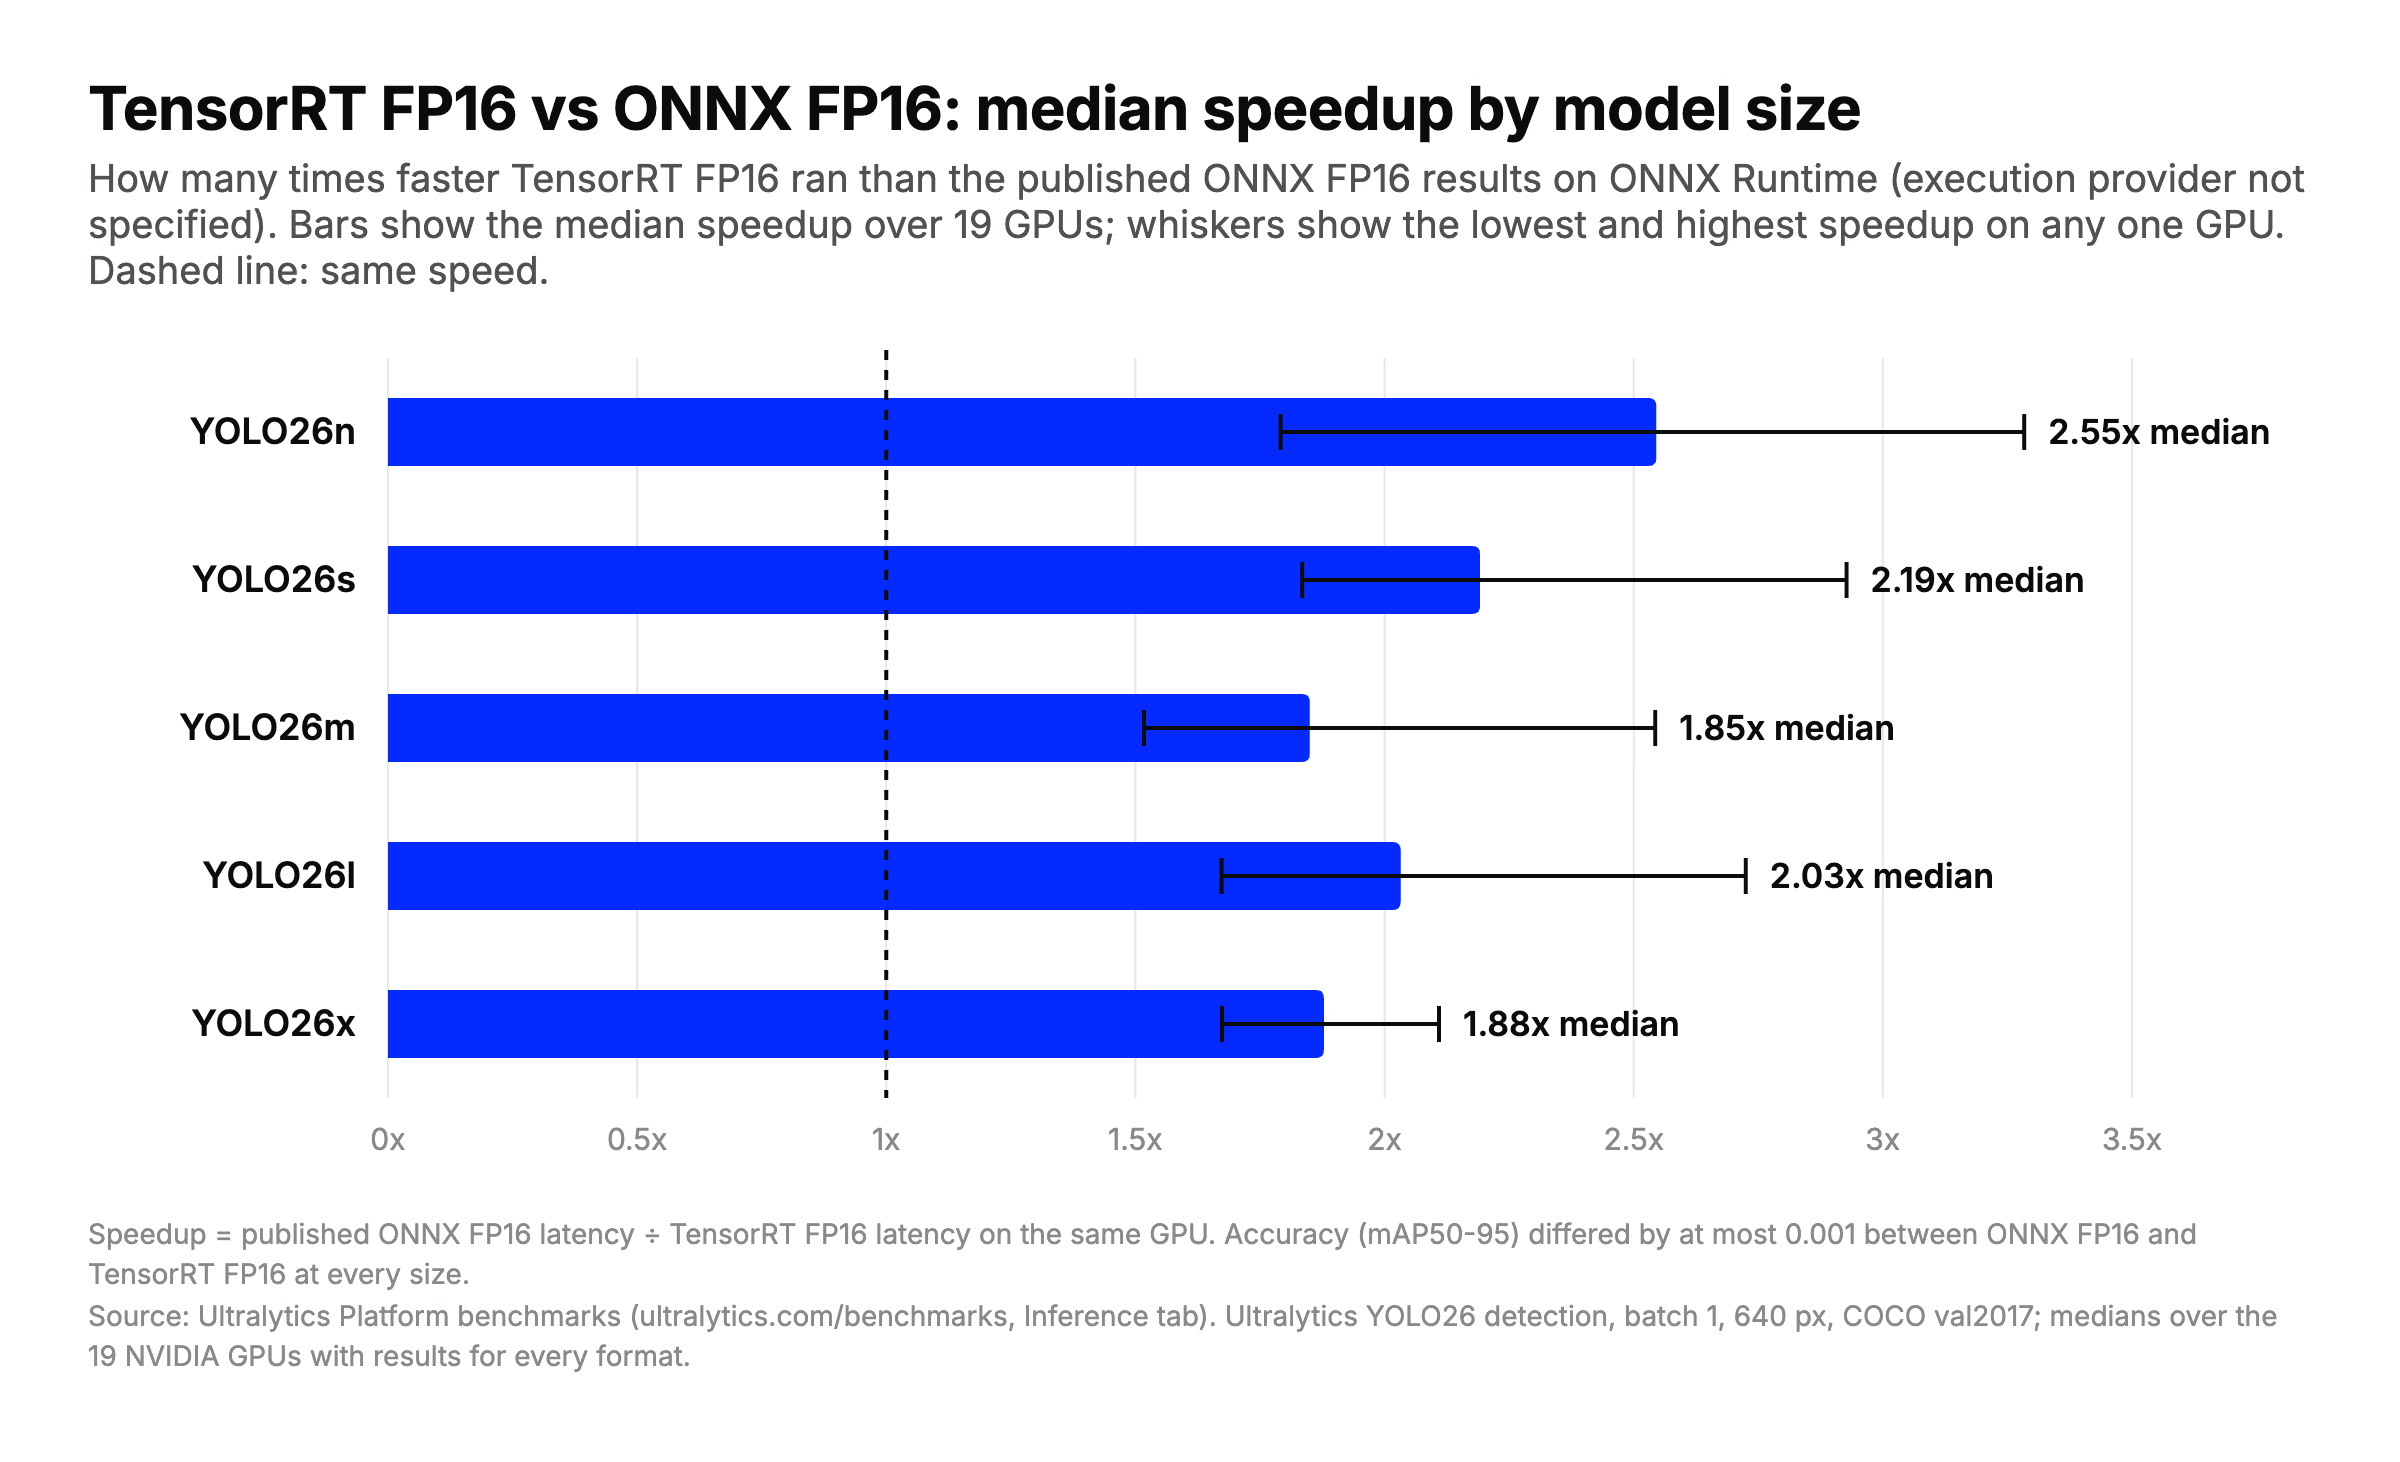
TensorRT FP16 était plus rapide que les résultats ONNX FP16 publiés sur tous les GPU et pour toutes les tailles de modèle ; la page ne précise pas quel fournisseur d’exécution ONNX Runtime les a produits. Les barres indiquent le gain de vitesse médian sur 19 GPU ; les moustaches indiquent le gain le plus faible et le plus élevé sur un GPU donné. Calculé à partir des benchmarks d’inférence d’Ultralytics Platform.
| Modèle | mAP50-95 : ONNX FP16 | mAP50-95 : TensorRT FP16 | mAP50-95 : TensorRT INT8 | Gain de vitesse de TensorRT FP16 par rapport à ONNX FP16 (médiane, plage) | Gain de vitesse de TensorRT INT8 par rapport à TensorRT FP16 (médiane, plage) |
|---|---|---|---|---|---|
| YOLO26n | 0.397 | 0.397 | 0.357 | 2.55x (1.79–3.28x) | 0.90x (0.79–1.07x) |
| YOLO26s | 0.471 | 0.471 | 0.436 | 2.19x (1.83–2.93x) | 1.04x (0.89–1.19x) |
| YOLO26m | 0.519 | 0.519 | 0.470 | 1.85x (1.52–2.54x) | 1.20x (0.90–1.38x) |
| YOLO26l | 0.536 | 0.535 | 0.501 | 2.03x (1.67–2.73x) | 1.08x (0.92–1.33x) |
| YOLO26x | 0.563 | 0.564 | 0.488 | 1.88x (1.67–2.11x) | 1.19x (0.92–1.67x) |
Calculé à partir des benchmarks d’inférence d’Ultralytics Platform. Le gain de vitesse correspond à la latence ONNX FP16 ÷ la latence TensorRT FP16, ou à la latence TensorRT FP16 ÷ la latence TensorRT INT8, sur le même GPU ; les valeurs supérieures à 1x signifient donc que TensorRT FP16 (ou INT8) était plus rapide. Les médianes sont calculées sur les 19 GPU NVIDIA disposant des quatre formats, et les plages correspondent aux ratios minimum et maximum observés sur ces GPU. La précision correspond au mAP50-95 indiqué pour chaque format et chaque niveau de précision. ONNX FP16 désigne les résultats publiés pour ONNX Runtime, dont le fournisseur d’exécution n’est pas précisé.
Latence sur quatre GPU courants, en millisecondes par image, telle que publiée sur la page des benchmarks :
| GPU | Modèle | PyTorch FP16 | ONNX FP16 | TensorRT FP16 | TensorRT INT8 |
|---|---|---|---|---|---|
| L4 | YOLO26n | 4.98 | 2.04 | 1.03 | 1.09 |
| L4 | YOLO26x | 7.76 | 9.80 | 5.73 | 3.43 |
| RTX 4090 | YOLO26n | 6.67 | 2.56 | 0.84 | 1.00 |
| RTX 4090 | YOLO26x | 10.94 | 5.20 | 2.68 | 2.25 |
| A100 SXM | YOLO26n | 8.72 | 3.98 | 1.65 | 1.79 |
| A100 SXM | YOLO26x | 15.02 | 7.25 | 3.86 | 3.91 |
| H100 SXM | YOLO26n | 6.36 | 3.09 | 1.17 | 1.48 |
| H100 SXM | YOLO26x | 10.26 | 5.53 | 2.66 | 2.62 |
Trois éléments ressortent :
- TensorRT FP16 a surpassé les résultats ONNX FP16 publiés sur tous les GPU et pour toutes les tailles de modèle, avec un écart de précision inférieur ou égal à 0,001 mAP50-95. Si tu déploies sur ces GPU NVIDIA et que tu as besoin d’une faible latence, commence par TensorRT FP16.
- INT8 n’est pas automatiquement gagnant. Sur YOLO26n, il était plus lent que TensorRT FP16 sur 17 des 19 GPU et entraînait une perte de 0,04 mAP50-95. Sur les modèles plus grands, il apportait plus souvent un gain, jusqu’à 1,67x pour YOLO26x sur un L4, mais au prix d’une perte de 0,034 à 0,076 mAP50-95.
- Aucun résultat ONNX n’est disponible pour les sept GPU Blackwell. La page du benchmark attribue cela à l’absence de noyaux Blackwell dans l’environnement de test d’ONNX Runtime. TensorRT a été exécuté sur les sept GPU.
Ces résultats correspondent à la configuration de la page des benchmarks, avec une taille de lot de 1 et une résolution de 640 pixels. Teste donc ton propre modèle sur l’appareil cible, avec tes propres données, avant de faire ton choix.
FP16 ou INT8 avec TensorRT#
La réduction de la précision est un autre levier important, et le benchmark montre pourquoi il faut la tester :
- FP16 (demi-précision) réduit de moitié la taille des poids et des activations par rapport à FP32. Dans les benchmarks d’Ultralytics Platform, TensorRT FP16 a obtenu une précision équivalente à celle d’ONNX FP16 et de PyTorch FP16, à 0,003 mAP50-95 près.
- INT8 stocke les poids et les activations sous forme d’entiers sur 8 bits, une forme de quantification de modèle. Ce format nécessite une calibration : un jeu d’images représentatif est passé dans le modèle afin de mesurer les plages d’activation. Le benchmark d’Ultralytics Platform a utilisé NVIDIA ModelOpt avec COCO128 comme données de calibration.
Comme l’indique la méthodologie du benchmark, INT8 est surtout avantageux pour les modèles plus grands, limités par la capacité de calcul. Sur les modèles les plus petits, le travail supplémentaire de quantification peut égaler, voire ralentir, FP16. Calibre le modèle avec des images de ton propre domaine, puis valide sa précision sur tes propres données avant de déployer un moteur INT8.
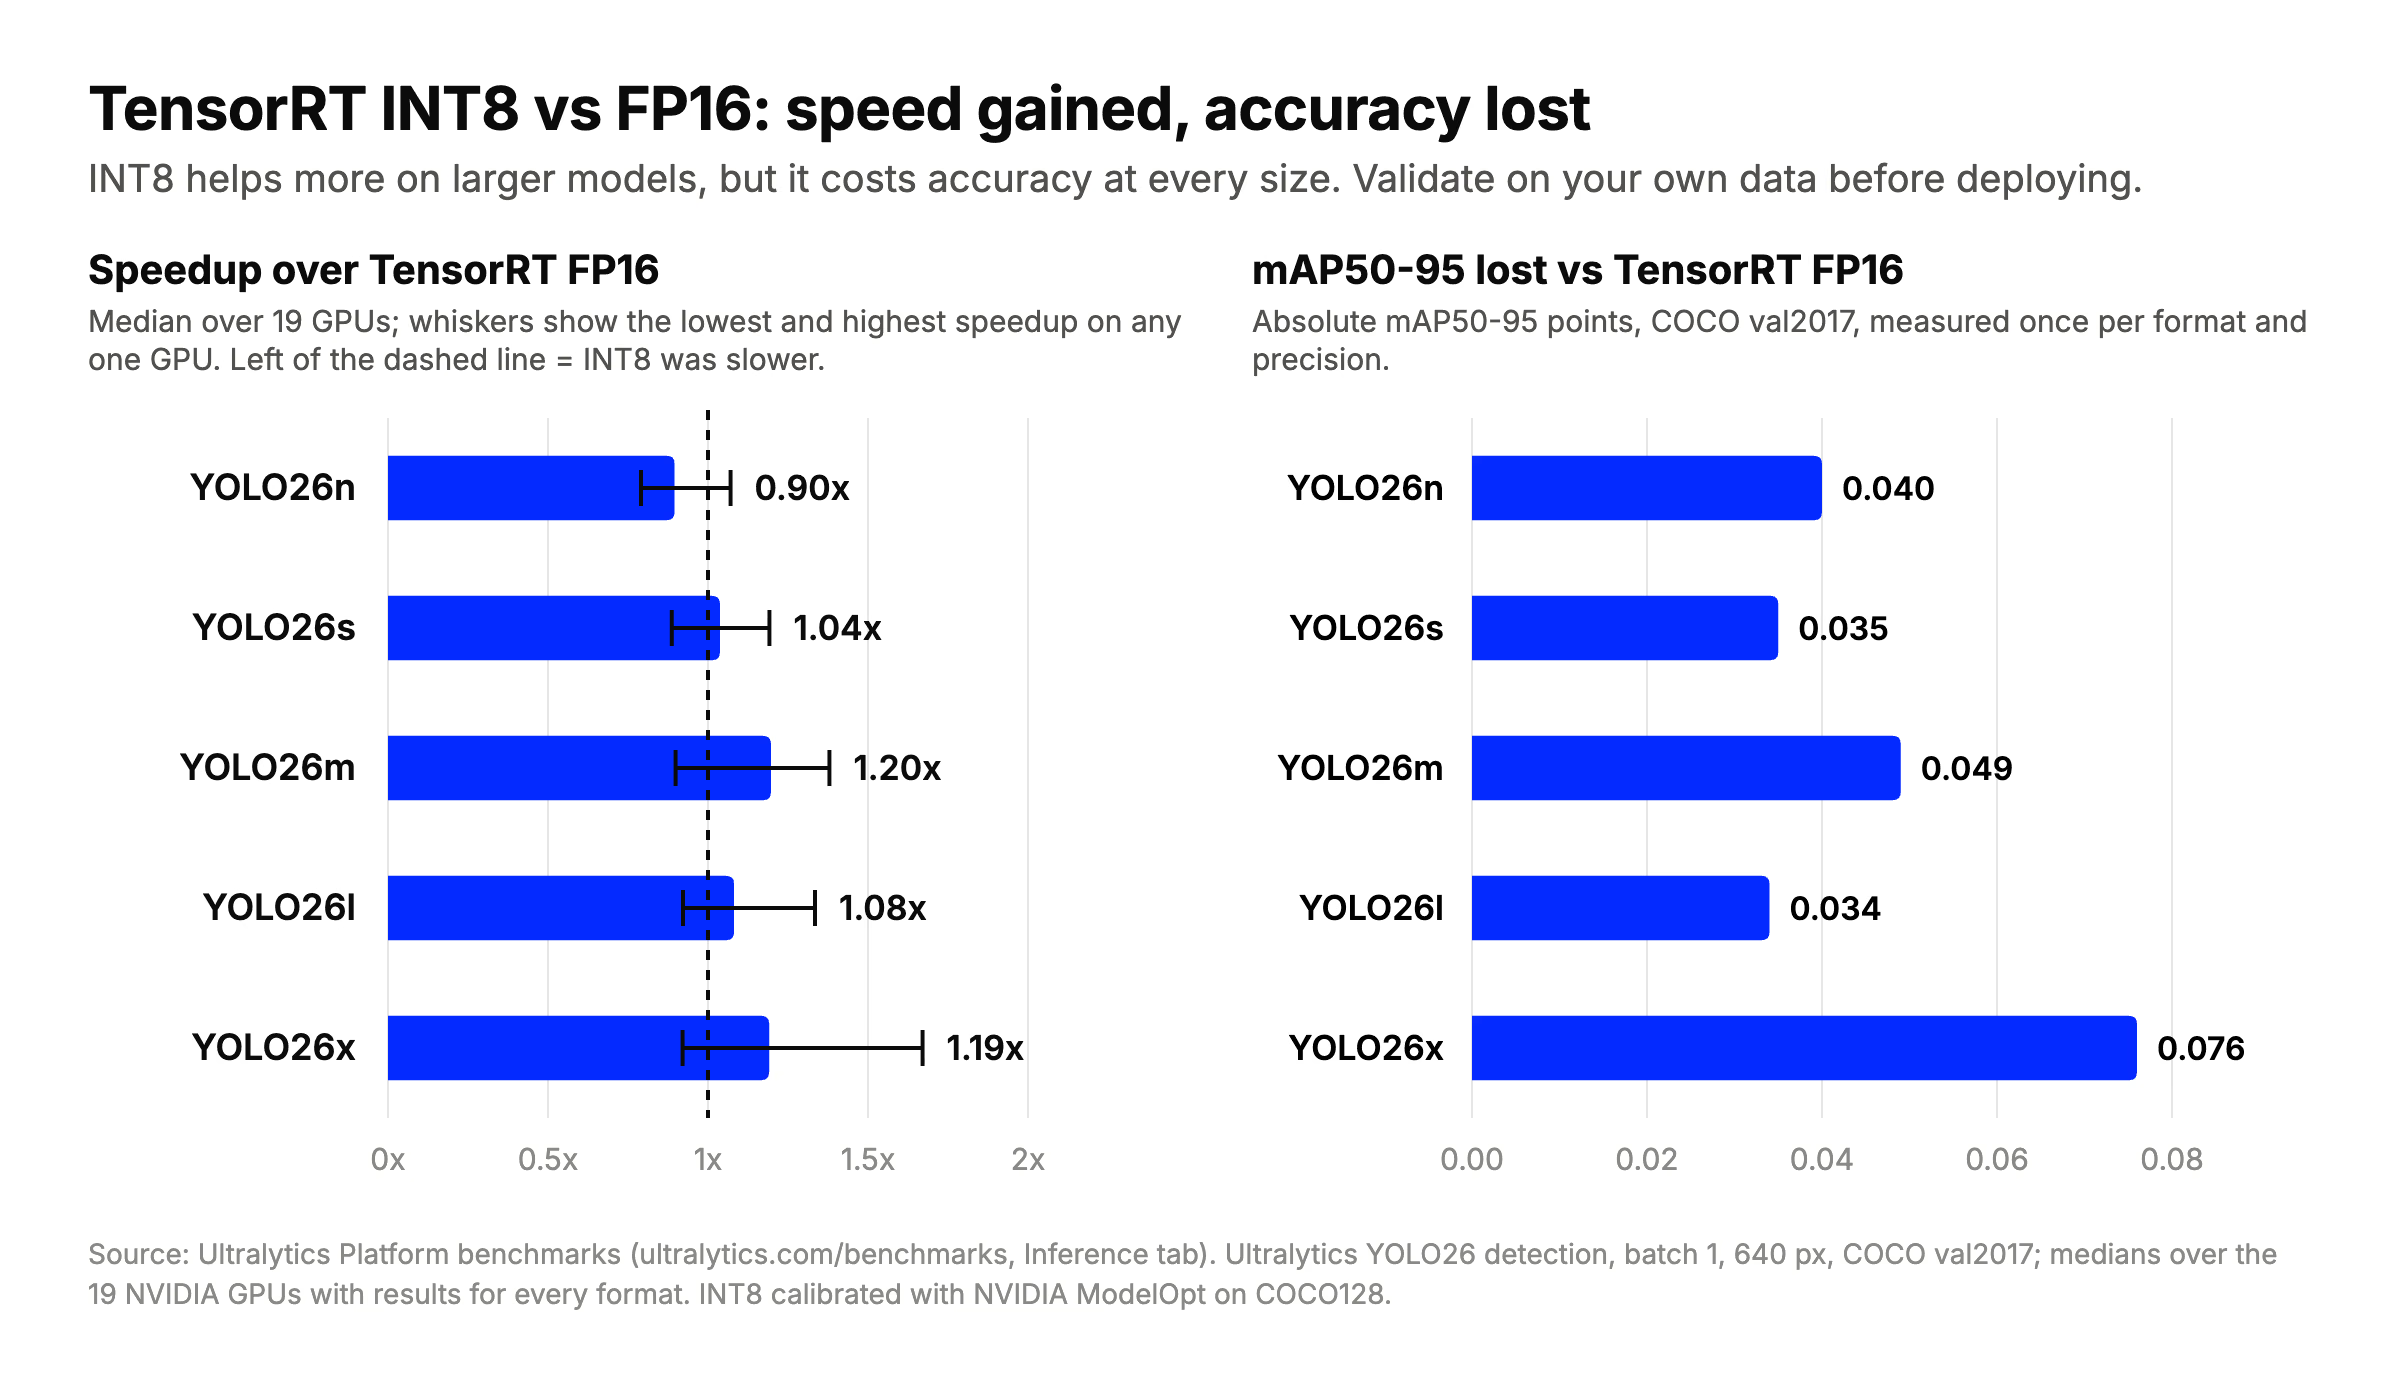
Au niveau médian, INT8 était plus lent que FP16 sur YOLO26n et jusqu’à environ 1,2x plus rapide sur les modèles plus grands, sur les 19 GPU ; la perte était de 0,034 à 0,076 mAP50-95 pour toutes les tailles. Calculé à partir des benchmarks d’inférence d’Ultralytics Platform.
Portabilité des moteurs et tailles d’entrée dynamiques#
Par défaut, un moteur TensorRT dépend du GPU sur lequel il a été construit et de la version de TensorRT utilisée ; un moteur construit sur un RTX 4090 n’est donc pas destiné à être copié sur un H100 ou un Jetson. TensorRT propose des options de compatibilité matérielle et de version qui assouplissent cette contrainte, mais l’option la plus sûre reste de construire le moteur sur l’appareil cible, ou pour celui-ci, et de le reconstruire après une mise à niveau de TensorRT. Sur Ultralytics Platform, l’onglet Export te demande de choisir un type de GPU pour les exportations TensorRT, pour cette raison. Un fichier ONNX n’a pas cette contrainte : le même fichier fonctionne partout où ONNX Runtime et un fournisseur d’exécution adapté sont disponibles.
Les deux formats prennent en charge les tailles d’entrée variables. Avec TensorRT, les formes dynamiques nécessitent un profil d’optimisation qui définit les dimensions d’entrée minimales, optimales et maximales ; les entrées fournies à l’exécution doivent respecter ces limites. Lors de l’exportation de modèles Ultralytics YOLO, dynamic=True active les formes d’entrée dynamiques pour ONNX et TensorRT. Comme l’explique le guide de NVIDIA sur les formes dynamiques, les formes fixes laissent à TensorRT davantage de possibilités d’optimisation ; utilise donc les formes dynamiques lorsque tes entrées varient réellement et compare les deux options.
Quand choisir ONNX Runtime et quand choisir TensorRT#
- GPU NVIDIA dans le cloud ou sur site, latence importante : TensorRT, en commençant par FP16. Essaie INT8 sur les modèles plus grands après l’avoir calibré et validé.
- NVIDIA Jetson en périphérie : TensorRT. Consulte le guide NVIDIA Jetson.
- CPU, matériel non NVIDIA ou parc hétérogène : ONNX avec ONNX Runtime, en utilisant le fournisseur d’exécution pris en charge par chaque machine.
- Tu ne connais pas encore le matériel cible : commence par exporter vers ONNX. Tu pourras ensuite construire un moteur TensorRT à partir du même modèle.
- CPU, GPU ou NPU Intel : envisage OpenVINO, la boîte à outils d’inférence d’Intel.
Pour consulter la liste complète des formats et leur comparaison, reporte-toi au guide des options de déploiement des modèles. La précision n’est pas le seul levier : la taille du modèle et la résolution d’entrée comptent aussi, et notre guide sur l’élagage et la quantification présente deux autres façons de réduire la taille d’un modèle.
Exporter Ultralytics YOLO vers ONNX et TensorRT#
Ultralytics YOLO s’exporte dans les deux formats avec un seul argument format, et tu peux lancer directement une prédiction ou une validation sur le modèle exporté :
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

model.export(format="onnx", quantize=16)  # ONNX FP16, pour ONNX Runtime
model.export(format="engine", quantize=16)  # Moteur TensorRT FP16, construit sur ce GPU
# Pour utiliser INT8, calibre plutôt le modèle avec un fichier YAML de jeu de données (coco8.yaml est un petit jeu de démonstration ; utilise le tien) :
# model.export(format="engine", quantize=8, data="coco8.yaml")

trt_model = YOLO("yolo26n.engine")
results = trt_model("https://ultralytics.com/images/bus.jpg")
quantize=16 sélectionne FP16 et quantize=8 sélectionne INT8. Les deux exportations de moteur écrivent yolo26n.engine ; exécute donc l’une ou l’autre. Pour INT8, indique dans data le fichier YAML de ton propre jeu de données afin que la calibration utilise des images similaires à celles de ton déploiement. Consulte les arguments d’exportation et les guides d’intégration ONNX et TensorRT pour découvrir toutes les options, ou suis nos articles détaillés sur l’exportation vers ONNX et l’optimisation avec TensorRT. Tu peux aussi exporter des modèles entraînés depuis ton navigateur sur Ultralytics Platform.
Foire aux questions
ONNX est un format de modèle, pas un moteur ; la comparaison pertinente porte donc sur ONNX Runtime et TensorRT. Dans les benchmarks d’Ultralytics Platform portant sur Ultralytics YOLO26 et 19 GPU NVIDIA, TensorRT FP16 était plus rapide que les résultats ONNX FP16 publiés avec ONNX Runtime sur chaque GPU. Les gains médians calculés allaient de 1,85x à 2,55x selon la taille du modèle, et les écarts de mAP50-95 ne dépassaient pas 0,001. Le benchmark ne précise pas quel fournisseur d’exécution ONNX Runtime a produit les résultats ONNX, et aucun n’est présenté comme utilisant son fournisseur d’exécution TensorRT ; teste donc toi-même cette combinaison si tu as besoin de l’API d’ONNX Runtime.
Oui. ONNX est généralement utilisé comme entrée par TensorRT : son analyseur ONNX lit le modèle et en construit un moteur. ONNX Runtime peut aussi faire appel à TensorRT via son fournisseur d’exécution TensorRT.
Non. Dans les benchmarks d’Ultralytics Platform, TensorRT INT8 était plus lent que TensorRT FP16 pour YOLO26n sur 17 des 19 GPU. Il était plus souvent rapide sur les modèles plus grands, avec un gain médian d’environ 1,2x pour YOLO26m et YOLO26x sur les 19 GPU ayant exécuté tous les formats. La perte était à chaque fois de 0,034 à 0,076 mAP50-95 ; valide donc d’abord un modèle INT8 sur tes propres données.
Ne pars pas du principe que c’est possible. Par défaut, un moteur TensorRT dépend du GPU et de la version de TensorRT utilisés pour le construire ; construis-le donc sur l’appareil cible, ou pour celui-ci. Conserve le fichier ONNX comme copie portable et reconstruis le moteur pour chaque cible.
TensorRT est généralement le choix à privilégier : NVIDIA JetPack inclut TensorRT, et construire le moteur sur le Jetson lui-même permet de l’optimiser pour cet appareil. Les benchmarks ci-dessus ne couvrent pas Jetson ; mesure donc les performances sur ton module avant de décider. Le guide NVIDIA Jetson explique la configuration et l’exportation d’Ultralytics YOLO.
Écrit par
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









