Qwen4-Max pour l’annotation automatique : des résultats remarquables sur certains jeux de données, des gains inégaux
Qwen4-Max se classe 13e sur 51 dans notre benchmark d’annotation automatique, premier pour les radiographies du poignet et deuxième pour les rayons de magasins. Précision, coût et mode d’emploi.
 Miles Deans14 min de lecture
Alibaba a lancé Qwen4-Max le 16 novembre 2026, le présentant comme le modèle le plus performant de la famille Qwen à ce jour, avec une vision native et une fenêtre de contexte d’un million de jetons. Le jour même, nous l’avons évalué avec UL37, notre benchmark de détection sur 36 jeux de données.
Au total, Qwen4-Max se classe 13e sur 51 modèles de notre classement VLM, avec 0.474 mAP50 pour 5,68 $ par tranche de 1 000 images. Cette moyenne masque un résultat plus remarquable. Sur les radiographies pédiatriques du poignet, il obtient le meilleur score de tous les modèles que nous avons testés, et se classe deuxième derrière Gemini 4 Carbon sur les scènes sous-marines et les rayons de magasins très chargés.
Qwen4-Max est désormais l’option Alibaba pour l’annotation automatique dans Ultralytics Platform, où il remplace Qwen3.8-Max. Voici ses points forts, ses limites, ses performances comparées aux modèles auxquels tu pourrais le comparer et le coût d’un lot d’annotations.
Qwen4-Max se classe 13e sur 51 dans UL37 et premier pour les radiographies du poignet#
UL37 mesure à quel point les boîtes d’un modèle correspondent aux annotations humaines sur 360 images : 10 provenant de chacun de 36 jeux de données réels de détection d’objets, des examens médicaux et images aériennes aux rayons de magasins, en passant par le sport et les circuits imprimés. Chaque jeu de données compte autant dans la moyenne, et chaque image passe par le même pipeline de production que celui proposé aux utilisateurs de Platform, avec les noms de classes propres au jeu de données et SAM 3.1 pour affiner chaque boîte. Les scores décrivent donc ce pipeline affiné, et non les résultats bruts du modèle. La méthodologie est publique.
| Qwen4-Max | Qwen3.8-Max | GPT-6.1 Terra | Gemini 3.8 Flash | Kimi K3.1 Pro | |
|---|---|---|---|---|---|
| Classement | #13 sur 51 | #15 sur 51 | #3 sur 51 | #11 sur 51 | #16 sur 51 |
| mAP50 | 0.474 | 0.461 | 0.560 | 0.516 | 0.444 |
| mAP50-95 | 0.301 | 0.295 | 0.345 | 0.321 | 0.281 |
| Précision | 0.595 | 0.572 | 0.646 | 0.656 | 0.560 |
| Rappel | 0.561 | 0.524 | 0.613 | 0.555 | 0.483 |
| Coût fournisseur pour 1 000 images | $5.68 | $7.74 | $4.36 | $5.86 | $22.50 |
| Temps médian par image | 12.4 s | 13.1 s | 5.1 s | 7.4 s | 22.2 s |
| Requêtes ayant échoué | 0% | 1.7% | 0% | 0% | 6.4% |
Résultats UL37 du classement VLM d’Ultralytics, mis à jour le 19 novembre 2026. Qwen3.8-Max n’est plus proposé dans Platform.
Qwen4-Max fait mieux que Qwen3.8-Max sur toutes les métriques principales, coûte moins cher par image et a répondu à toutes les requêtes du benchmark. Il reste toutefois loin derrière les leaders en moyenne : GPT-6.1 Terra obtient 0.560 pour un coût inférieur et en moins de la moitié du temps.
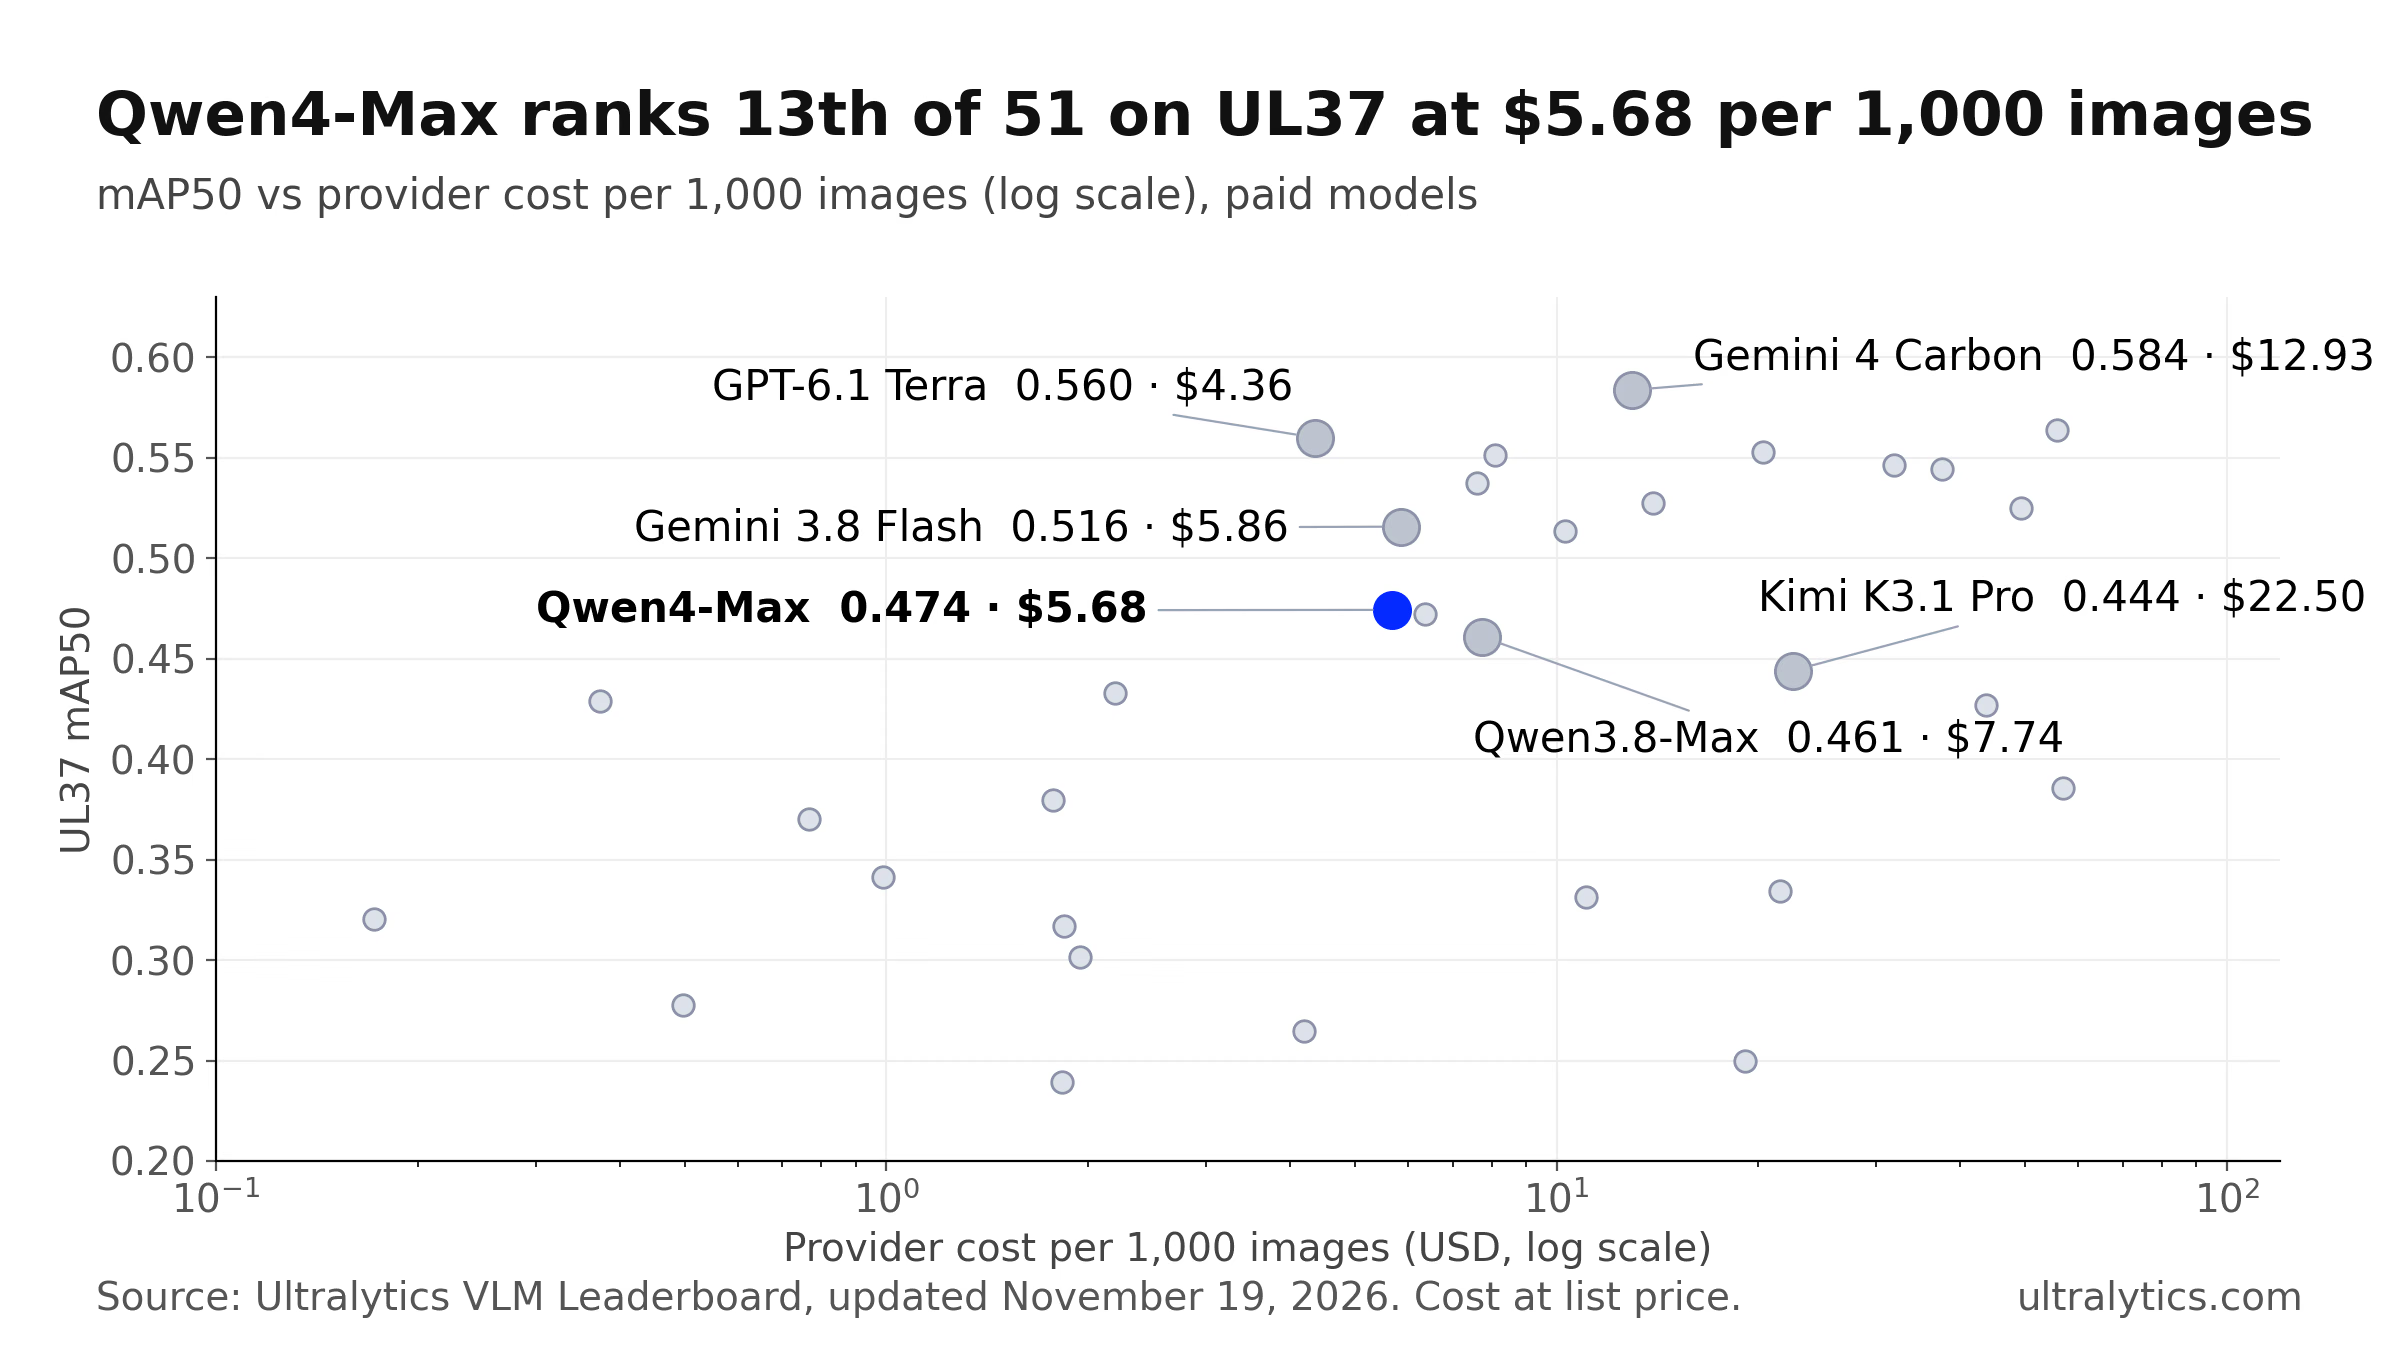
Chaque point représente un modèle payant du classement VLM d’Ultralytics.
Pour quoi Alibaba a conçu Qwen4-Max#
Dans son annonce de lancement, Alibaba présente Qwen4-Max comme un modèle à mélange d’experts parcimonieux, doté de 2,4 billions de paramètres au total, dont 71 milliards sont actifs par jeton, ainsi que d’une vision native. Alibaba met en avant le codage, les tâches agentiques et le raisonnement visuel, et indique que, sur son propre benchmark Work360, Qwen4-Max surpasse Qwen3.8-Max tout en réduisant d’environ 60 % le coût moyen par tâche.
Les notes de version de Model Studio d’Alibaba Cloud le décrivent comme « le modèle multimodal phare de nouvelle génération de la famille Qwen, alliant génération de texte, compréhension des images et des vidéos et raisonnement approfondi ». Son tarif international est de 1,50 $ par million de jetons en entrée et de 4,50 $ par million de jetons en sortie, contre 2 $ et 6 $ pour Qwen3.8-Max. Le modèle est accessible via l’API d’Alibaba ; Alibaba indique que des modèles Qwen4 de plus petite taille à poids ouverts suivront.
Ni l’annonce ni les notes de version ne présentent de résultats de détection d’objets : c’est donc ce que nous avons mesuré.
Qwen4-Max face à Qwen3.8-Max : moins cher, avec des gains inégaux#
Qwen4-Max surpasse son prédécesseur sur 19 jeux de données, obtient des résultats inférieurs sur 16 et fait jeu égal sur un. Son gain moyen de 0.013 mAP50 s’explique par de fortes améliorations sur certains jeux de données, qui compensent des baisses nettes sur d’autres.
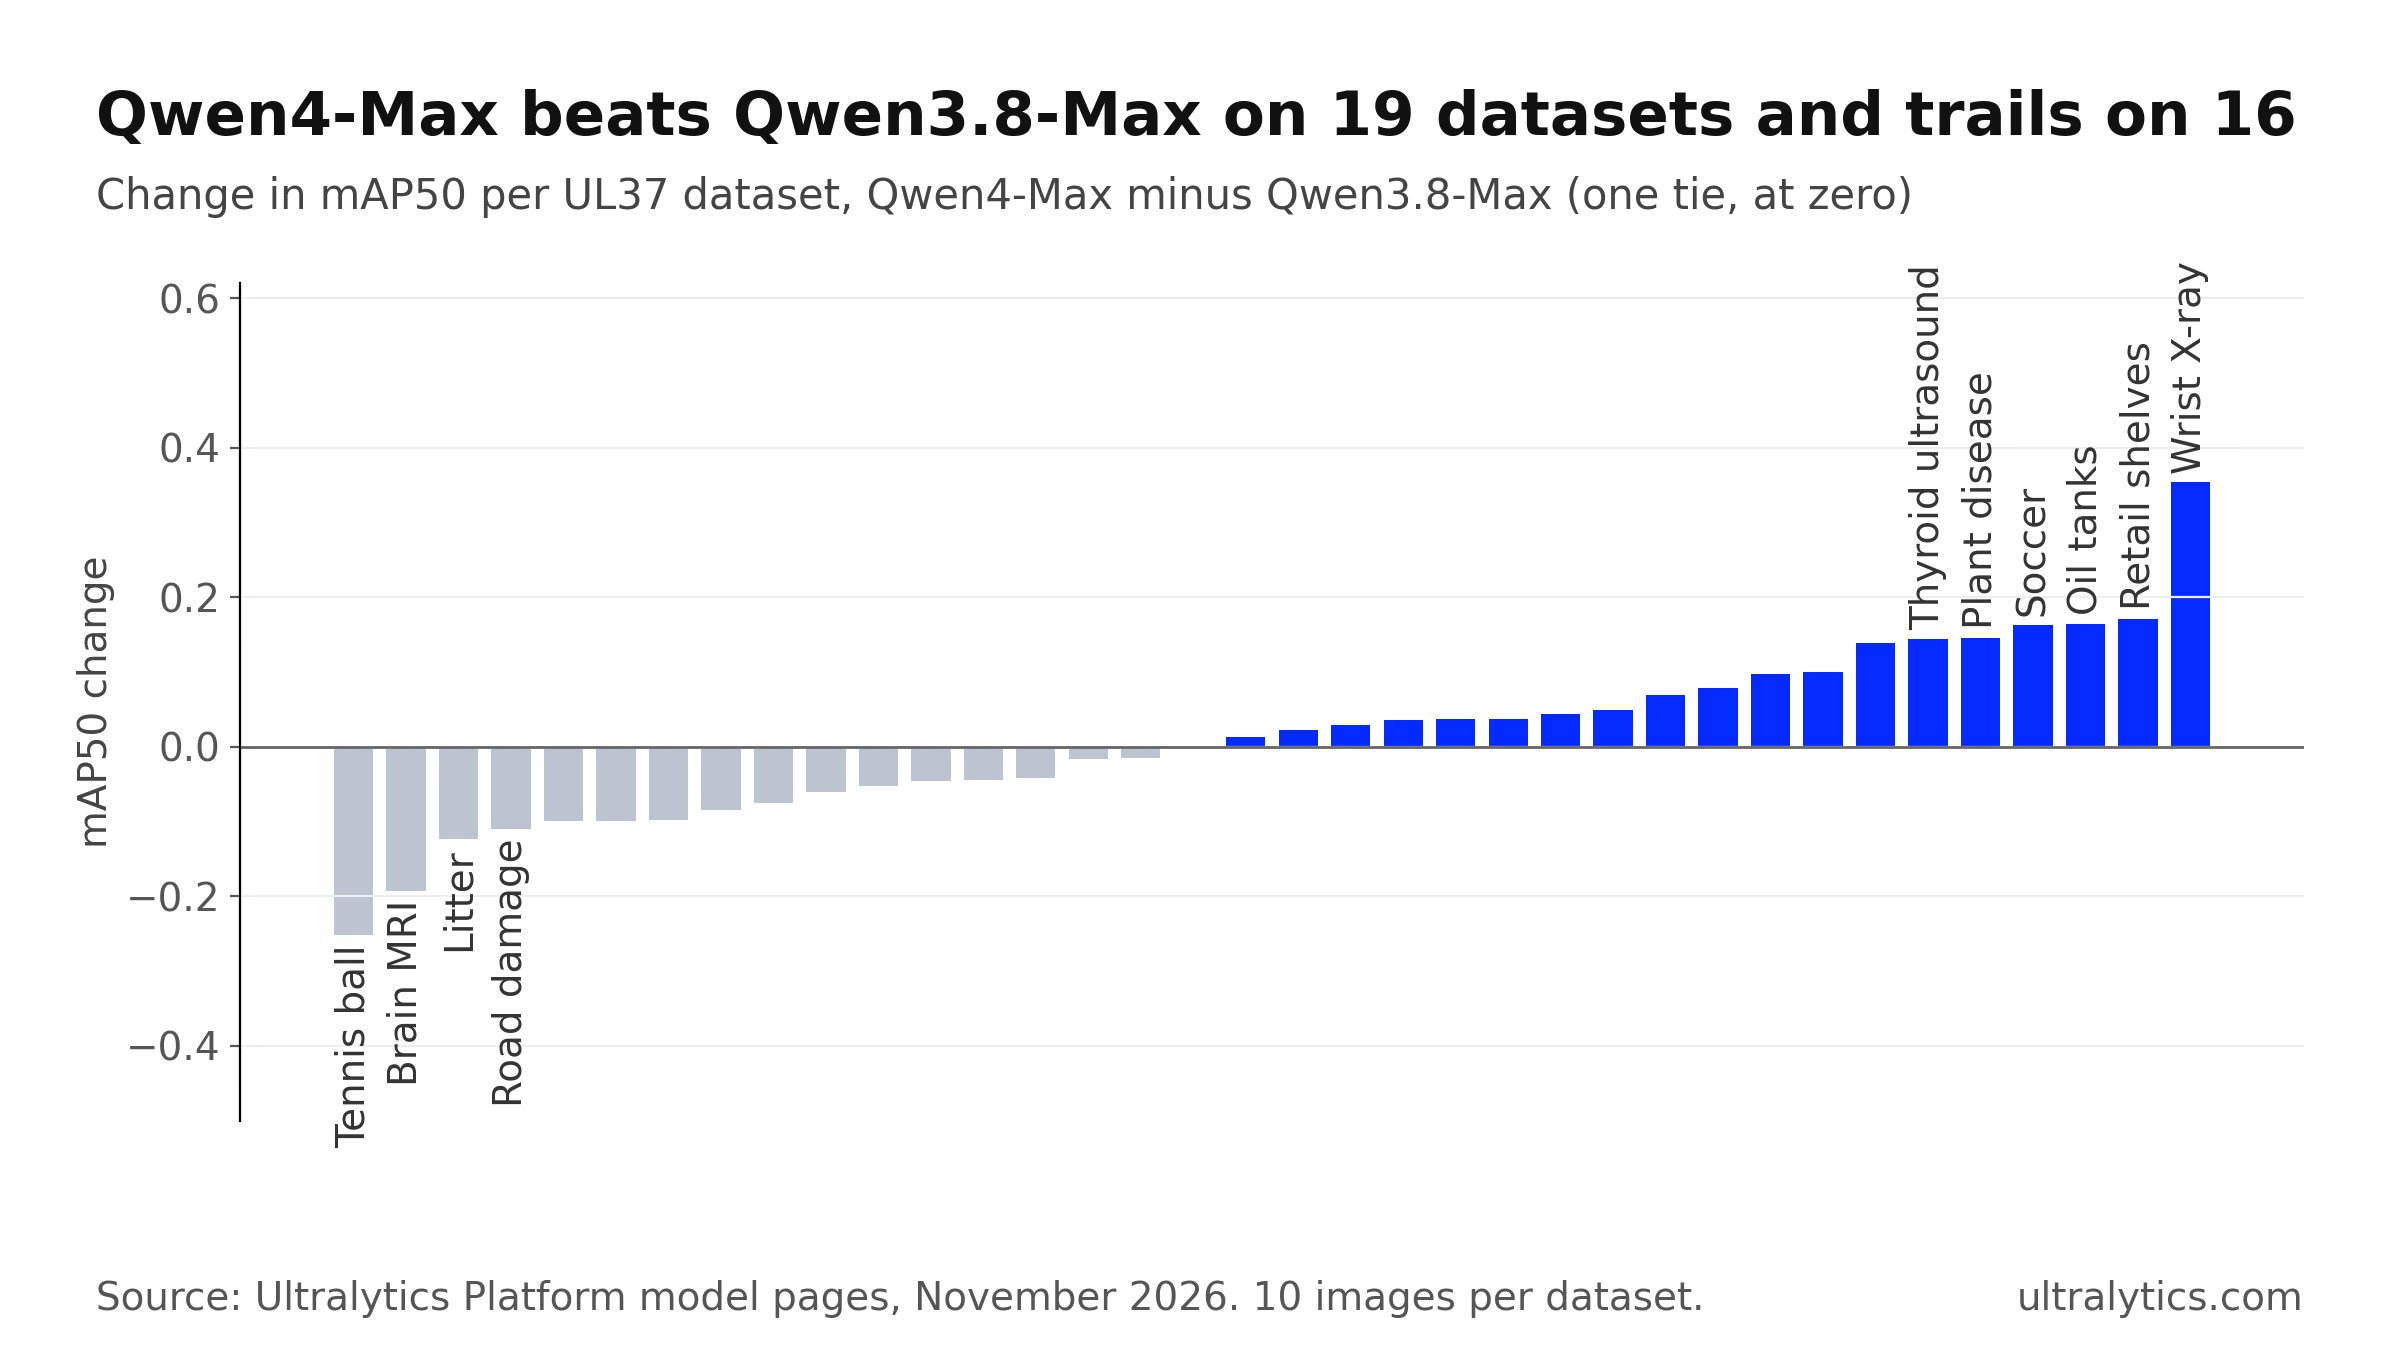
Chaque barre représente un jeu de données UL37, trié de la plus forte baisse au plus grand gain.
| Jeu de données | Qwen4-Max | Qwen3.8-Max | Variation |
|---|---|---|---|
| GRAZPEDWRI-DX radiographies pédiatriques du poignet | 0.4975 | 0.1437 | +0.3538 |
| SKU110K rayons de magasins très chargés | 0.6230 | 0.4516 | +0.1714 |
| Airbus réservoirs de stockage de pétrole | 0.3005 | 0.1363 | +0.1642 |
| SoccerDB soccer | 0.8345 | 0.6715 | +0.1630 |
| RacketVision balle de tennis | 0.3775 | 0.6299 | −0.2524 |
| Cheng IRM de tumeur cérébrale | 0.4421 | 0.6350 | −0.1929 |
mAP50 sur UL37 par jeu de données, 10 images chacun, avec quatre décimales afin que chaque variation corresponde aux deux scores.
La baisse du coût est plus nette. À 5,68 $ contre 7,74 $ par tranche de 1 000 images, Qwen4-Max coûte environ 27 % de moins par image lors de notre test. Le chiffre d’environ 60 % annoncé par Alibaba provient d’un autre benchmark réalisé avec des paramètres différents ; les deux chiffres ne sont donc pas directement comparables.
Les points forts de Qwen4-Max#
Trois résultats placent Qwen4-Max parmi les meilleurs du classement général, et pas seulement de la famille Qwen.
| Jeu de données | Qwen4-Max | Rang sur 51 | Leader |
|---|---|---|---|
| Radiographies pédiatriques du poignet GRAZPEDWRI-DX | 0.4975 | 1st | Qwen4-Max (suivi de Muse Ember 1.0, 0.378) |
| RUOD objets sous-marins | 0.774 | 2nd | Gemini 4 Carbon, 0.788 |
| SKU110K rayons de magasins très chargés | 0.623 | 2nd | Gemini 4 Carbon, 0.671 |
mAP50 sur UL37 par jeu de données. Rang parmi les 51 modèles du classement VLM d’Ultralytics.
Radiographies du poignet. Sur les radiographies de traumatismes pédiatriques du poignet, Qwen4-Max obtient 0.4975, devant tous les autres modèles que nous avons testés et avec un score plus de trois fois supérieur à celui de Qwen3.8-Max. Chaque jeu de données ne comprend que 10 images : considère donc ce résultat comme un signal fort justifiant des tests, et non comme une conclusion définitive. Il ne s’agit pas non plus d’un diagnostic ni d’une validation clinique : pour l’annotation de recherche en analyse d’images médicales, Qwen4-Max peut proposer des boîtes que des spécialistes cliniques pourront vérifier et corriger.
Rayons de magasins. En calculant la moyenne des deux jeux de données de vente au détail d’UL37, Qwen4-Max obtient 0.752, devant GPT-6.1 Terra à 0.724. Sur SKU110K, où les rayons sont remplis de produits jusqu’aux bords et ceux-ci relèvent d’une seule classe, il se classe deuxième derrière Gemini 4 Carbon.
Scènes sous-marines. Pour les objets sous-marins de RUOD, son score de 0.774 le place deuxième sur 51, devant les 0.658 de GPT-6.1 Terra.
Les limites de Qwen4-Max#
Ses lacunes sont aussi nettes que ses réussites. Qwen4-Max obtient 0.000 sur DeepPCB, pour les défauts de circuits nus, et 0.05 sur IEDXray, pour les contrôles de sécurité par rayons X, tandis que les modèles Gemini 4 atteignent environ 0.30. Son score est de 0.037 pour les radiographies thoraciques visant à détecter la tuberculose et, sur le jeu de données d’IRM de tumeurs cérébrales, il est distancé par GPT-6.1 Terra, avec 0.442 contre 0.904.
En moyenne par domaine, il obtient aussi des résultats inférieurs à GPT-6.1 Terra pour les documents, les interfaces utilisateur et les dessins CAO (0.357 contre 0.494), les routes et la circulation (0.396 contre 0.572), ainsi que l’imagerie médicale dans son ensemble (0.325 contre 0.505). Avant d’étiqueter un grand jeu de données dans l’un de ces domaines, consulte la page du modèle Qwen4-Max, qui affiche ses boîtes enregistrées sur chaque jeu de données du benchmark à côté des annotations attendues.
Qwen4-Max face à GPT-6.1 Terra, Gemini 3.8 Flash et Kimi K3.1 Pro#
| Comparaison directe sur 36 jeux de données UL37 | Victoires de Qwen4-Max | Défaites | Égalités |
|---|---|---|---|
| face à GPT-6.1 Terra | 11 | 23 | 2 |
| face à Gemini 3.8 Flash | 17 | 18 | 1 |
| face à Kimi K3.1 Pro | 21 | 14 | 1 |
| face à Qwen3.8-Max | 19 | 16 | 1 |
GPT-6.1 Terra est le meilleur choix général : il remporte 23 jeux de données contre 11 pour Qwen4-Max, coûte moins cher et son temps de réponse médian est inférieur de plus de moitié. Gemini 3.8 Flash fait presque jeu égal sur les jeux de données, à un prix similaire, avec un score moyen supérieur. Face à Kimi K3.1 Pro, Qwen4-Max remporte 21 jeux de données contre 14, pour un coût par image environ quatre fois inférieur.
Comment Ultralytics Platform exécute Qwen4-Max#
Deux paramètres influencent les résultats de Qwen4-Max dans Platform. Premièrement, le modèle utilise le niveau de raisonnement « low » d’Alibaba plutôt que le niveau par défaut « high ». Lors des tests d’Ultralytics sur les 370 images du benchmark (les 360 images évaluées et 10 images de référence COCO), le niveau par défaut a dépassé la limite de requête de 115 secondes de Platform sur 11 images, contre 3 avec « low », pour le même mAP50. Deuxièmement, Platform demande aux modèles Qwen de renvoyer une sortie JSON compacte, car leurs résultats baissent d’environ 0.02 mAP50 sans cette option.
Tu n’as rien à faire pour ces deux paramètres : sélectionne Qwen4-Max dans la liste des modèles et Platform applique les deux automatiquement.
Coût d’un lot d’annotations avec Qwen4-Max#
Le coût fournisseur correspond à l’utilisation de jetons déclarée par Alibaba, calculée aux tarifs de Platform pour ce modèle, par tranche de 1 000 images annotées avec succès. Tes propres images peuvent consommer plus ou moins de jetons. Batch Annotation ajoute des frais de traitement Platform de 1,00 $ par tranche de 1 000 images, avec un minimum de 0,01 $ par exécution.
| Par tranche de 1 000 images | Qwen4-Max |
|---|---|
| Facturation par Alibaba | $5.68 |
| Traitement par Ultralytics Platform | $1.00 |
| Total | $6.68 |
Tu paies directement Alibaba avec ta propre clé API, y compris pour les prédictions de test que tu exécutes au préalable, et Ultralytics n’applique aucune majoration sur les jetons. Si tu préfères éviter complètement une clé payante, Qwen3.8 27B est hébergé sur Qwen3.8 27B et fonctionne dans Platform sans clé, avec 0.351 mAP50 sur UL37.
Comment exécuter l’annotation automatique avec Qwen4-Max dans Ultralytics Platform#
Qwen4-Max est un modèle guidé par les classes pour les jeux de données de détection contenant de 1 à 200 classes. Il renvoie des boîtes englobantes pour les noms de classes propres à ton jeu de données, que tu peux ensuite vérifier et corriger.
- Crée une clé API dans Model Studio d’Alibaba Cloud pour la région internationale (Singapour), qui correspond au point de terminaison utilisé par Platform.
- Demande au propriétaire de l’espace de travail d’ajouter la clé sous Alibaba dans Paramètres > Clés API de l’espace de travail qui contient ton jeu de données. La documentation sur les clés fournisseur donne tous les détails.
- Dans l’éditeur d’annotations, passe en mode Smart, puis sélectionne Qwen4-Max sous Alibaba dans la liste des modèles.
- Clique sur Prédire, ou sur
P, pour quelques images représentatives de tes données. - Quand le résultat te convient, ouvre la page du jeu de données et choisis More actions > Batch Annotation pour annoter chaque image non annotée. Batch Annotation fonctionne avec les jeux de données hébergés sur Platform qui comportent jusqu’à trois canaux d’image. Platform enregistre d’abord une version du jeu de données, ce qui te permet de revenir en arrière.
- Vérifie les boîtes, enregistre-les et entraîne un modèle Ultralytics YOLO26 sur le résultat dans le même espace de travail.
La documentation sur les annotations explique en détail le mode Smart et Batch Annotation, et notre guide pour choisir un VLM selon la précision et le rappel t’aide à adapter le modèle à ton processus de vérification.
À qui s’adresse Qwen4-Max#
| Si tu as besoin de… | Commencer par |
|---|---|
| Un outil d’annotation payant généraliste | GPT-6.1 Terra : score UL37 supérieur, coût inférieur et plus rapide que Qwen4-Max |
| Des ébauches d’annotations de radiographies pédiatriques du poignet à vérifier par des spécialistes | Qwen4-Max : meilleur score UL37 parmi 51 modèles sur ce jeu de données |
| Rayons de magasins très chargés ou scènes sous-marines | Qwen4-Max, à comparer avec Gemini 4 Carbon sur tes images |
| Un modèle Alibaba ou une évolution depuis Qwen3.8-Max | Qwen4-Max : scores supérieurs, coût par image inférieur, aucune requête échouée lors de notre test |
| Aucune clé API payante | Qwen3.8 27B hébergé, Gemma 4 26B ou SAM 3.1 Text dans Platform |
Pour la plupart des tâches d’annotation, GPT-6.1 Terra reste le meilleur choix par défaut. Qwen4-Max est intéressant lorsque tes données ressemblent à celles de ses jeux de données les plus réussis ; teste-le donc d’abord sur un échantillon de tes propres images.
Foire aux questions
Il se classe 13e sur 51 dans notre benchmark, avec quelques résultats remarquables. Sur notre benchmark UL37, il obtient 0.474 mAP50, soit la 13e place sur 51 modèles, sans aucune requête échouée. Il se classe premier sur 51 pour les radiographies pédiatriques du poignet et deuxième pour les objets sous-marins et les rayons de magasins très chargés, mais obtient de faibles scores pour les défauts de circuits imprimés et les radiographies de sécurité.
En moyenne, oui. Qwen4-Max obtient 0.474 mAP50 contre 0.461, coûte 5,68 $ contre 7,74 $ par tranche de 1 000 images et a répondu à toutes les requêtes, alors que Qwen3.8-Max en a échoué 1,7 %. Les gains sont inégaux : Qwen4-Max surpasse Qwen3.8-Max sur 19 jeux de données et obtient des résultats inférieurs sur 16, avec de fortes baisses pour la détection de balles de tennis et d’IRM cérébrales.
Pour l’annotation générale, GPT-6.1 Terra obtient un score de 0,560 mAP50, l’emporte sur Qwen4-Max pour 23 des 36 jeux de données, coûte 4,36 $ pour 1 000 images et affiche un temps de réponse médian de 5,1 secondes. Choisis Qwen4-Max lorsque tes données ressemblent à celles de ses jeux de données les plus performants, comme les radiographies de poignets, les rayons de supermarché très chargés ou les scènes sous-marines, et vérifie ses performances sur tes propres images.
Il peut proposer des boîtes pour l’annotation de recherche, que des experts doivent vérifier ; il ne pose pas de diagnostic. Il obtient le meilleur score UL37 parmi 51 modèles sur les radiographies de poignets d’enfants, avec 0,4975 mAP50, mais sa moyenne est de 0,325 sur nos huit jeux de données médicales, contre 0,505 pour GPT-6.1 Terra, et ses résultats sont faibles sur les radiographies thoraciques.
Environ 5,68 $ de frais Alibaba : les jetons utilisés, tels que déclarés par Alibaba, sont facturés aux tarifs de la plateforme pour le modèle, pour 1 000 images annotées avec succès. Le tarif international affiché par Alibaba est de 1,50 $ par million de jetons en entrée et de 4,50 $ par million de jetons en sortie. Ultralytics Platform ajoute des frais d’annotation par lots de 1,00 $ pour 1 000 images, soit un total d’environ 6,68 $.
Crée une clé API Alibaba Cloud Model Studio internationale, demande au propriétaire de ton espace de travail de l’ajouter sous Alibaba dans Paramètres > Clés API, puis sélectionne Qwen4-Max en mode Smart dans l’éditeur d’annotations. Teste quelques images, lance l’annotation par lots, vérifie les boîtes et entraîne un modèle Ultralytics YOLO26 dans le même espace de travail.
Écrit par
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









