OCR in Python con Ultralytics YOLO26: leggi documenti, foto e PDF da qualsiasi angolazione
Leggi il testo nelle immagini e nelle pagine PDF con qualsiasi rotazione usando Ultralytics YOLO26-Text e PP-OCRv6 in poche righe di Python, su CPU o GPU, con TensorRT opzionale.
 Jing Qiu14 min di lettura
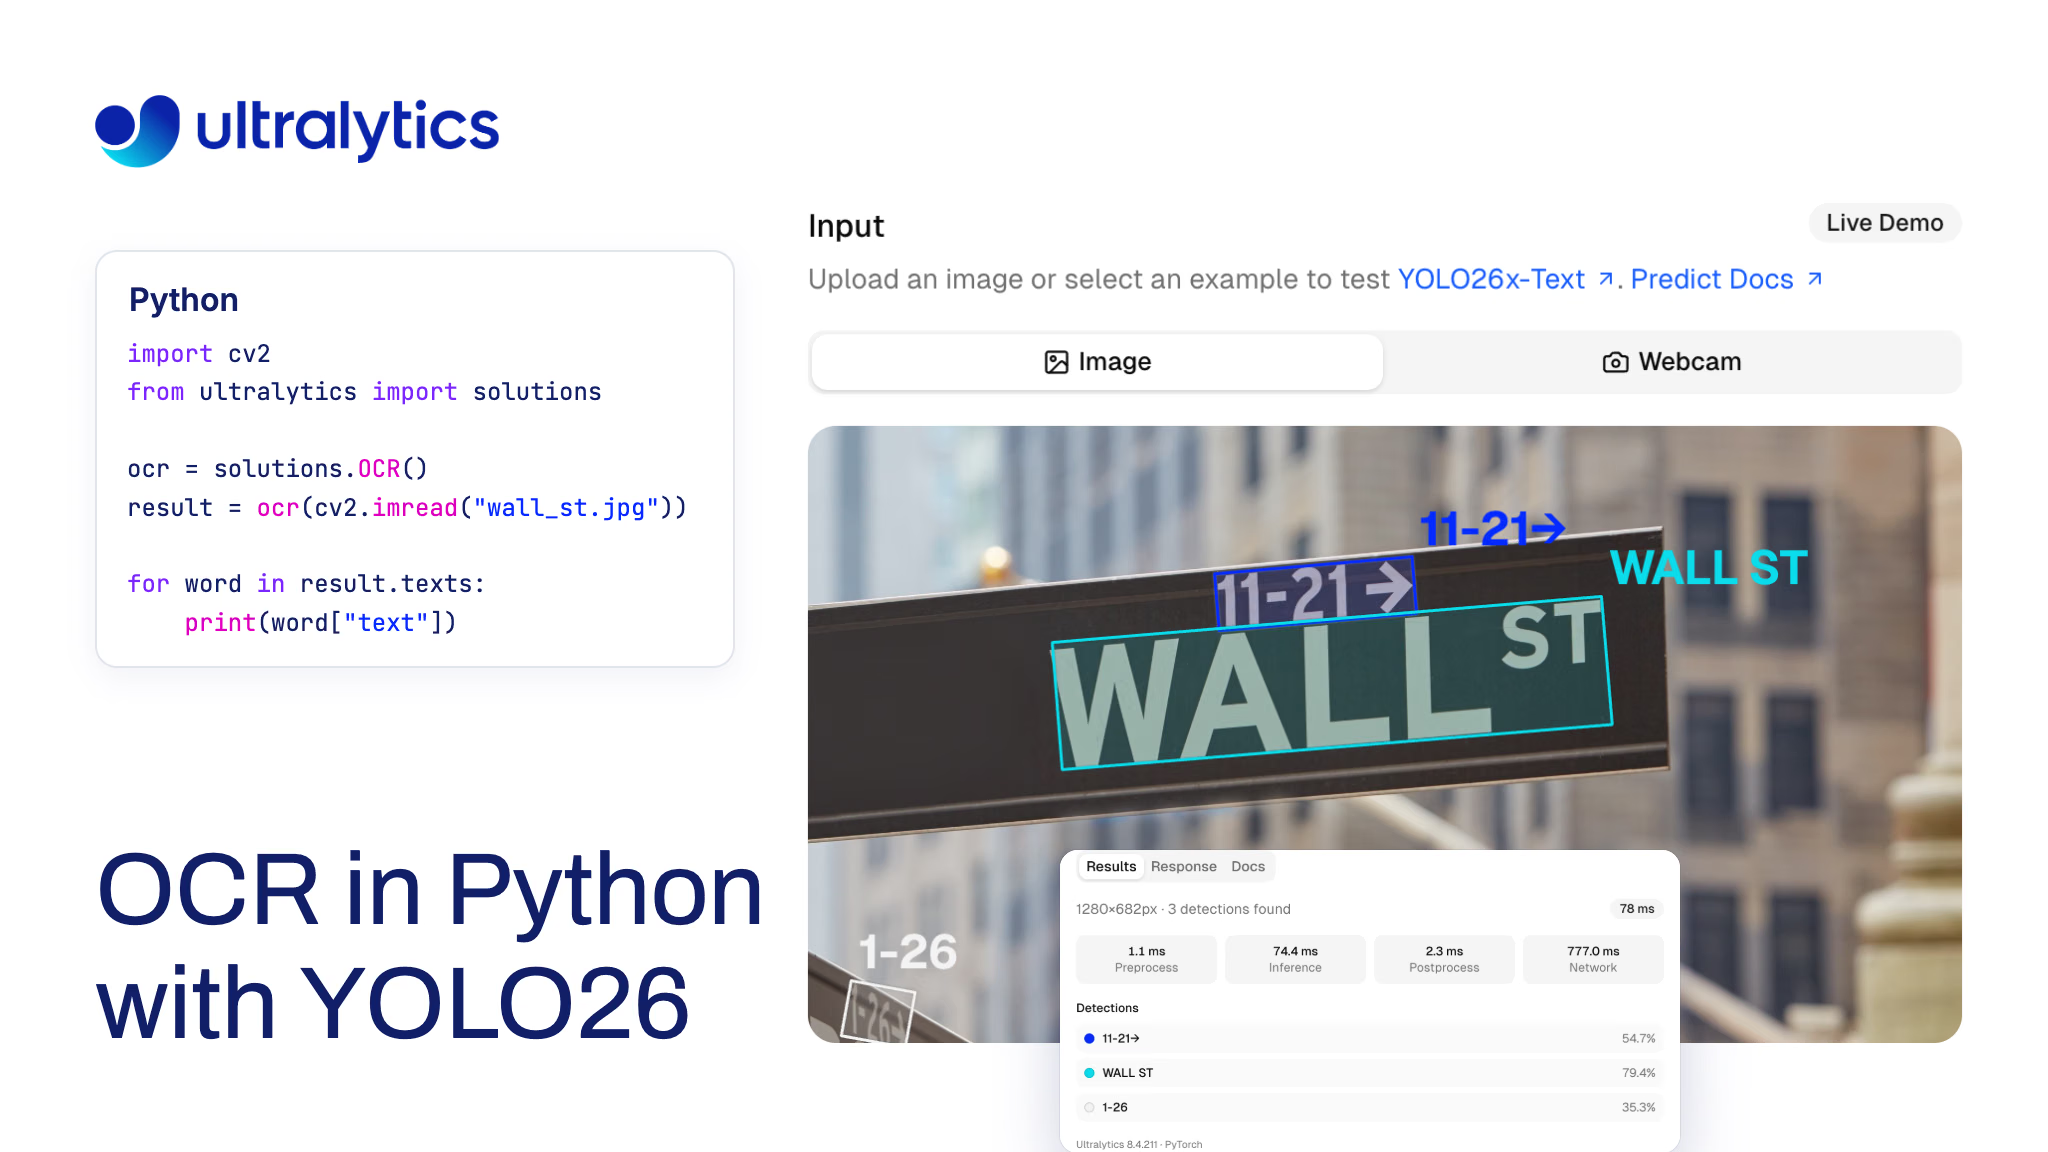
Come si esegue l'OCR in Python su una scansione ruotata, una foto di un cartello scattata con il telefono o una pagina PDF, ottenendo le parole nell'ordine in cui le leggerebbe una persona? Con il pacchetto Ultralytics basta una classe: solutions.OCR() rileva il testo con un modello Ultralytics YOLO26-Text, legge ogni parola con il riconoscitore PP-OCRv6 di PaddleOCR e restituisce le parole riconosciute riga per riga, con qualsiasi rotazione della pagina, su CPU o GPU.
Questa pipeline è nuova. Ultralytics 8.4.210 ha ricostruito la soluzione OCR attorno a PP-OCRv6 su ONNX Runtime, aggiungendo la gestione della rotazione e dell'ordine di lettura, mentre 8.4.211 ha aggiunto un riconoscitore TensorRT opzionale. Nel nostro benchmark con dimensione immagine 1280, la configurazione predefinita ha ottenuto un F1 delle parole pari a 0.931 su sei pagine PDF e 0.722 su 80 foto HierText. Su una RTX PRO 6000, un motore TensorRT FP16 precaricato ha letto in 82 ms le 251 parole rilevate in una foto, contro i 249 ms di ONNX Runtime su CUDA.
Questa guida spiega come funziona la pipeline, come eseguirla su immagini e PDF, quanto è veloce e quali lingue legge al momento. Ultralytics sviluppa una delle opzioni OCR confrontate di seguito, quindi il confronto si attiene alle funzionalità documentate di ciascun progetto.
YOLO26 OCR legge una pagina in due passaggi, poi ordina le parole#
Il riconoscimento ottico dei caratteri (OCR) ha due compiti: trovare il testo e poi leggerlo. La soluzione OCR di Ultralytics li separa nettamente:
- Rilevamento: un modello YOLO26-Text, un rilevatore di riquadri orientati, disegna riquadri ruotati attorno al testo. È disponibile nelle dimensioni n, s, m, l e x; il modello x è quello predefinito.
- Riconoscimento: PP-OCRv6 medium legge ogni ritaglio. Viene eseguito con ONNX Runtime dagli asset di Ultralytics, quindi non devi installare PaddlePaddle. I ritagli per cui non viene riconosciuto alcun testo vengono scartati.
- Ordinamento: le parole vengono raggruppate in righe e restituite dall'alto verso il basso e da sinistra a destra, ciascuna contrassegnata dal numero della riga.
Ogni parola viene restituita come record con il testo, la confidenza del riconoscimento, la confidenza del rilevatore, un numero di riga e un poligono nelle coordinate dell'immagine originale. Poiché le due confidenze restano separate, puoi inviare a una revisione umana una parola rilevata con sicurezza ma letta con incertezza, invece di fidarti del risultato.
Le due fasi restano indipendenti. Puoi sostituire il rilevatore con uno più piccolo, con un tuo modello di rilevamento o segmentazione oppure con un altro riconoscitore: la gestione della rotazione e l'ordine di lettura continueranno a funzionare. Puoi provare lo stesso flusso di codice nel browser, alla nostra pagina di elaborazione dei documenti, prima di installare qualsiasi cosa.
Le pagine ruotate e capovolte vengono lette nell'ordine corretto#
La soluzione determina la rotazione della pagina in base al testo rilevato, quindi non devi raddrizzare o ruotare le pagine in anticipo:
- Trova la direzione del testo. Calcola la media dell'angolo del lato lungo dei riquadri rilevati, ponderandola in base all'allungamento di ciascun riquadro. I riquadri con un rapporto di allungamento inferiore a 2:1, ad esempio quelli contenenti una sola cifra, non contribuiscono alla stima.
- Ruota la pagina. La ruota in modo che il testo proceda da sinistra a destra, raddrizza ogni parola ritagliata e raggruppa le parole in righe.
- Determina se la rotazione è 0° o 180°. Un riquadro non permette di capire da che parte sia orientato il testo, quindi la soluzione legge in entrambi i versi le 8 parole più larghe e mantiene la rotazione con la confidenza di lettura maggiore. Il testo capovolto viene letto come rumore a bassa confidenza, facendo risaltare la risposta corretta.
Quando abbiamo ruotato di 90°, 180° e 270° otto documenti e schermate e 12 foto, l'F1 delle parole è stato 0.925 sui documenti e 0.654 sulle foto. Su un modulo IRS 8802 vuoto, la soluzione ha letto 404, 401 e 399 parole rispettivamente a 0°, 180° e 90°, con righe iniziali identiche. La versione precedente presupponeva che tutte le pagine fossero dritte.
I valori predefiniti derivano da un benchmark, non da supposizioni#
Abbiamo impostato i valori predefiniti principali misurandoli. Il benchmark è stato eseguito su una RTX PRO 6000 con l'immagine Platform di produzione, inviando i file come JPEG con lato lungo non superiore a 1280 pixel. Ha usato 80 foto di convalida dal dataset HierText di Google con le trascrizioni delle parole leggibili, 6 pagine PDF confrontate con i rispettivi livelli di testo (4 da un articolo arXiv più i moduli IRS 1040 e 8802 vuoti), una schermata sintetica e un'immagine sintetica. La metrica è il punteggio F1 a livello di parola, che bilancia precisione e richiamo, contando le parole in minuscolo composte da almeno 2 caratteri alfanumerici.
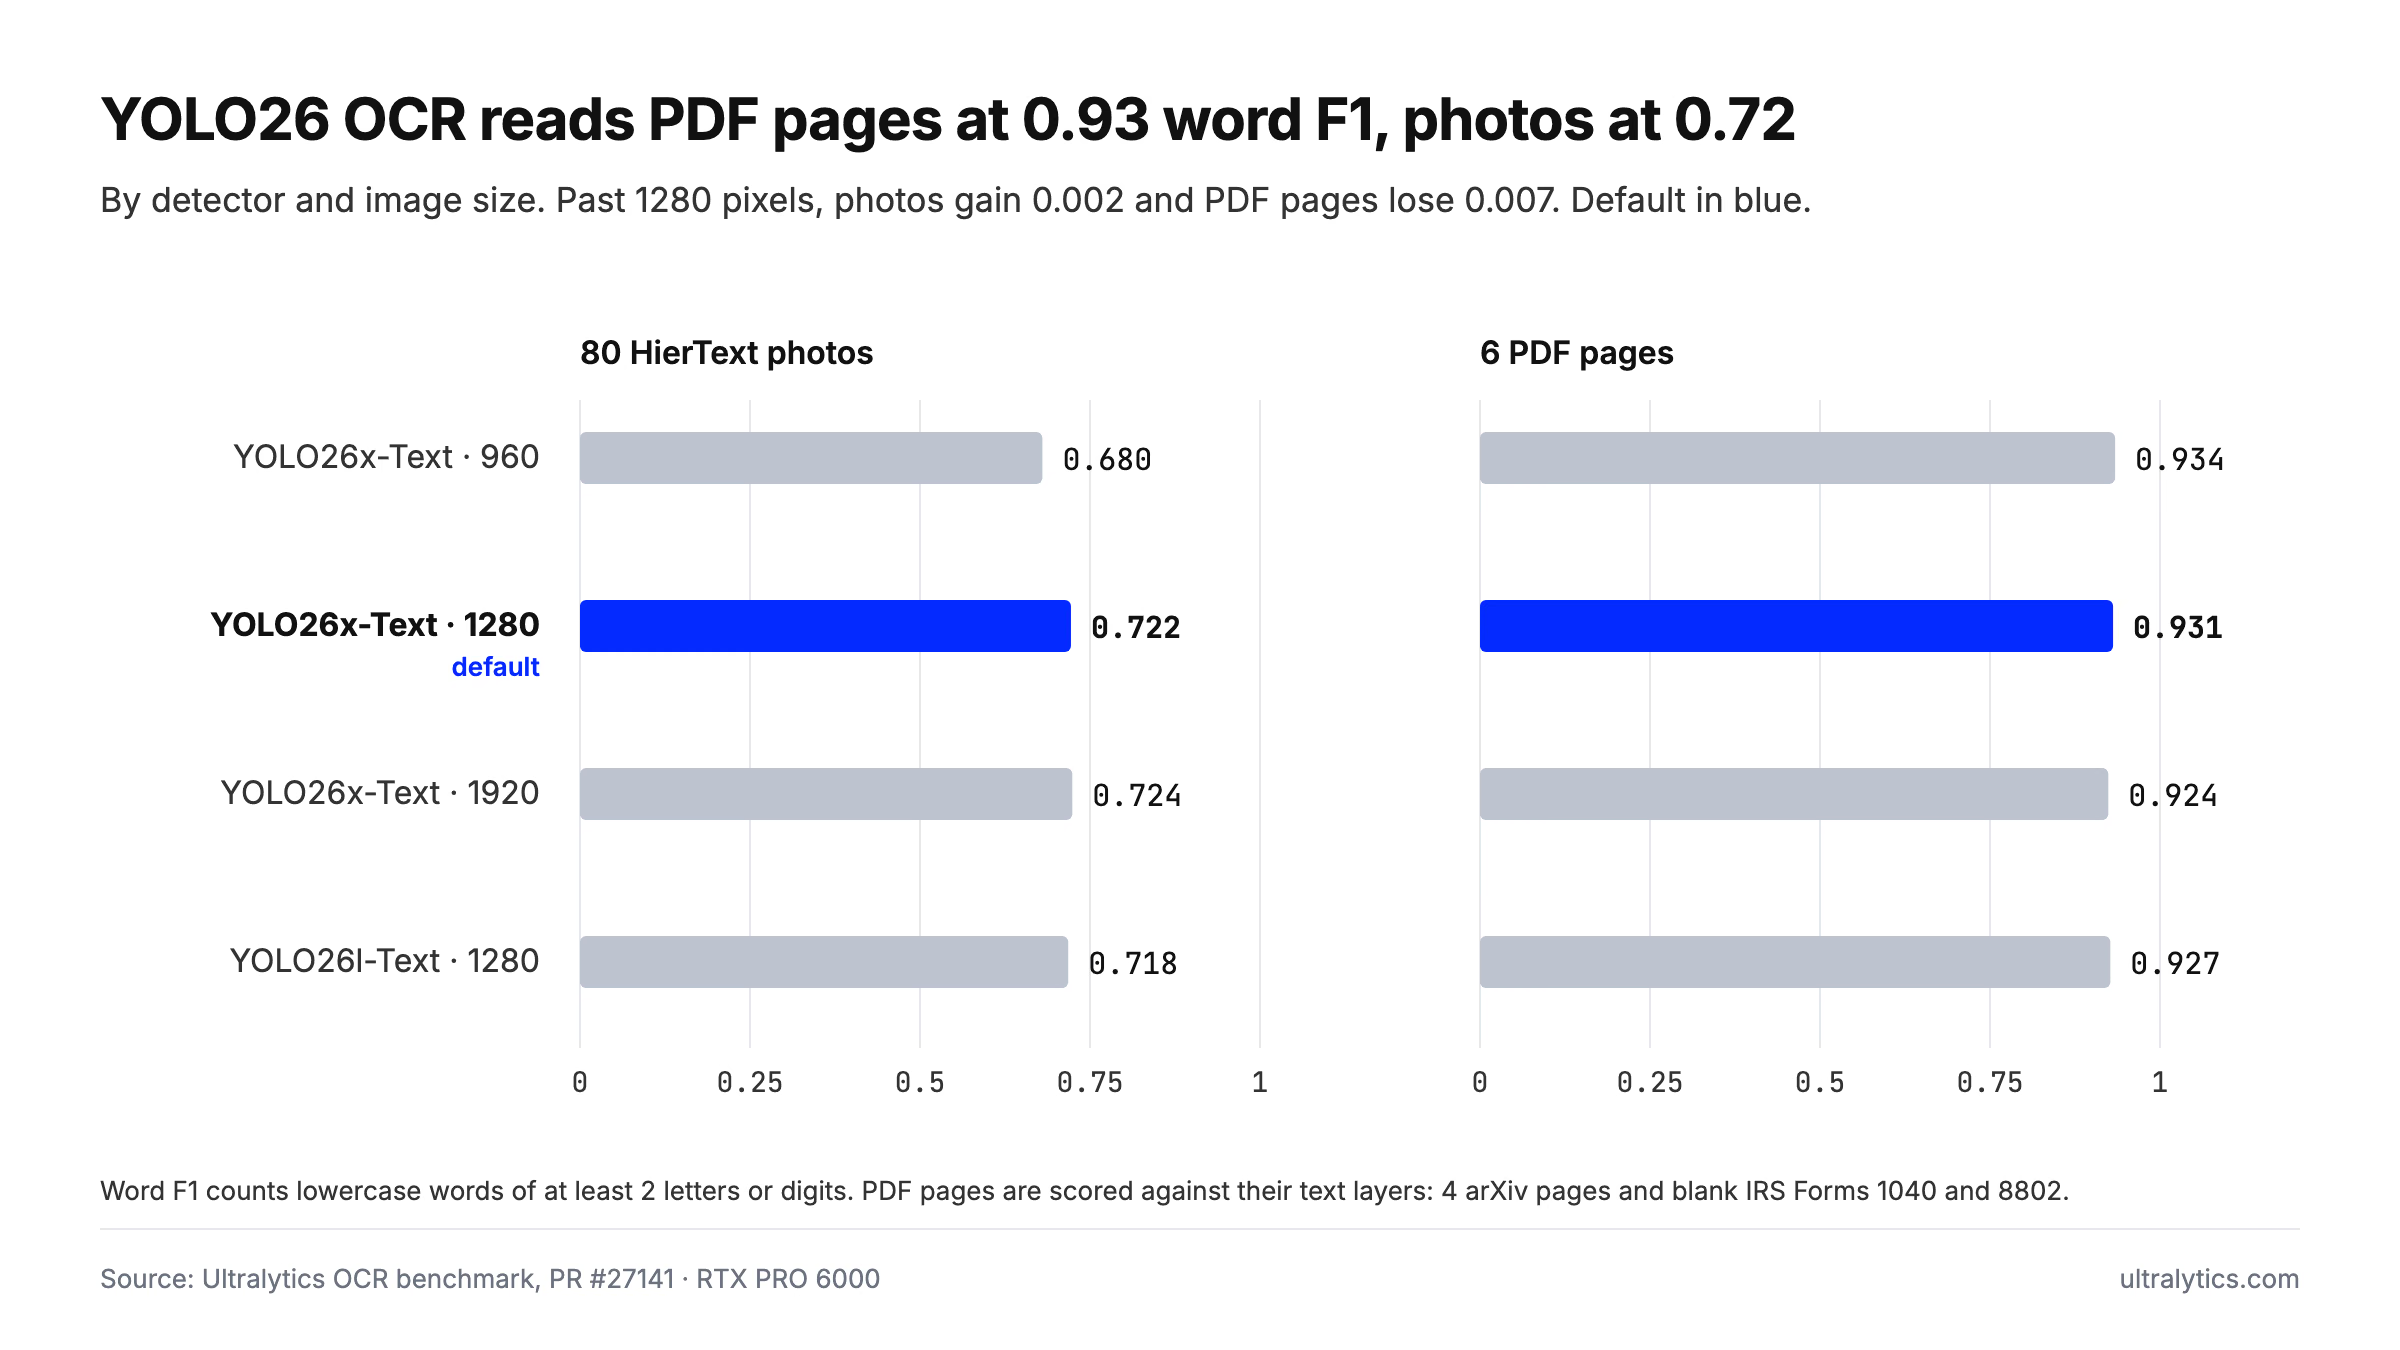
F1 delle parole di YOLO26-Text con PP-OCRv6 su 80 foto HierText e 6 pagine PDF, in base al rilevatore e alla dimensione immagine, su una RTX PRO 6000.
Le pagine PDF nitide vengono lette molto meglio delle foto di testo ambientale con ogni configurazione, e dai risultati emergono tre impostazioni predefinite:
yolo26x-textaimgsz=1280. Scendere a 960 ha ridotto di 0.042 l'F1 delle foto, mentre salire a 1920 lo ha aumentato di 0.002 sulle foto e diminuito di 0.007 sulle pagine PDF. Le immagini più piccole non vengono ingrandite a 1280: vengono elaborate alla loro dimensione, arrotondata per eccesso al passo di 32 pixel del modello.- Lettura parola per parola. Leggere le singole parole ha superato la lettura di righe intere di 4 punti F1 sulle foto.
max_det=1000. Una pagina di documento densa contiene più delle consuete 300 rilevazioni.
Se ti serve un rilevatore più leggero, YOLO26l-Text ha mantenuto uno scarto inferiore a mezzo punto rispetto al modello x su entrambi i set.
Come eseguire l'OCR in Python con YOLO26#
Installa o aggiorna con pip install -U "ultralytics>=8.4.211". Alla prima chiamata OCR vengono scaricati YOLO26x-Text e PP-OCRv6 e viene installato ONNX Runtime; se CUDA è disponibile, viene usato onnxruntime-gpu. Il riconoscitore ONNX Runtime predefinito richiede Python 3.11+ e ONNX Runtime 1.26+.
Leggere un'immagine#
import cv2

from ultralytics import solutions

ocr = solutions.OCR()  # YOLO26x-Text a imgsz=1280 con PP-OCRv6
im0 = cv2.imread("receipt.jpg")
assert im0 is not None, "Image not found"
result = ocr(im0)
cv2.imwrite("receipt_ocr.jpg", result.plot_im)  # immagine annotata

for word in result.texts:
    print(word["line"], word["text"], round(word["confidence"], 2))
Dalla riga di comando, yolo solutions ocr source="path/to/video.mp4" esegue la stessa operazione su ogni fotogramma. Ogni fotogramma viene letto indipendentemente, senza tracciamento.
Leggere un PDF#
La soluzione accetta immagini, quindi prima devi convertire ogni pagina PDF in un'immagine. PyMuPDF è un modo per farlo:
import cv2
import numpy as np
import pymupdf  # pip install pymupdf

from ultralytics import solutions

ocr = solutions.OCR()
for page in pymupdf.open("document.pdf"):
    pix = page.get_pixmap(dpi=200)
    rgb = np.frombuffer(pix.samples, np.uint8).reshape(pix.height, pix.width, pix.n)
    result = ocr(cv2.cvtColor(rgb, cv2.COLOR_RGB2BGR))

    lines = {}
    for word in result.texts:  # già nell'ordine di lettura
        lines.setdefault(word["line"], []).append(word["text"])
    print("\n".join(" ".join(words) for words in lines.values()))
Poiché result.texts è già ordinato, ricostruire il testo semplice richiede solo un dizionario e un'operazione di join. I poligoni ti permettono di andare oltre, ad esempio verificando che un importo si trovi accanto alla parola "Totale".
Scegliere modello, dispositivo e riconoscitore#
- Rilevatore più piccolo:
solutions.OCR(model="yolo26s-text.pt")carica un rilevatore più piccolo e veloce; verifica la sua accuratezza sulle tue pagine. Tutte e cinque le dimensioni vengono scaricate automaticamente. - CPU o GPU: il riconoscitore viene eseguito su CUDA quando selezioni una GPU CUDA e il provider di esecuzione CUDA di ONNX Runtime è disponibile; altrimenti viene eseguito su CPU. Lo stesso script funziona quindi su un portatile o su un server.
- Un tuo riconoscitore: passa una funzione come
recognizer. Riceve ogni ritaglio di parola BGR e restituisce(text, confidence); la soluzione continua a occuparsi del rilevamento, della rotazione e dell'ordinamento.
def recognize(crop):
    # Esegui qualsiasi modello di riconoscimento sul ritaglio di parola BGR
    return "example", 0.95


ocr = solutions.OCR(recognizer=recognize)
TensorRT legge le parole da 2,5 a 3 volte più velocemente nelle foto dense#
Nei nostri test GPU su pagine dense, il riconoscimento richiedeva più tempo del rilevamento. Una precedente ottimizzazione ha misurato circa 11 ms per il rilevamento, su una richiesta da 250 ms; la pull request TensorRT ha ricondotto gran parte del tempo rimanente per il riconoscimento a 33 piccoli batch, limitati soprattutto dall'overhead di avvio anziché dal calcolo. Ultralytics 8.4.211 aggiunge un argomento per questo:
ocr = solutions.OCR(recognizer="tensorrt") # Motore TensorRT FP16 su GPU NVIDIALa prima esecuzione crea in circa 30 secondi un motore TensorRT FP16 e lo memorizza nella cache accanto al modello PP-OCRv6, una volta per ogni versione di TensorRT e architettura GPU. I caricamenti successivi richiedono da 0,05 a 0,2 secondi. La versione dichiara che è circa 2,5 volte più veloce di ONNX Runtime sulle pagine dense.
Abbiamo cronometrato read_words, il passaggio successivo al rilevamento che ritaglia, ruota, riconosce e ordina le parole, su quattro foto di testo ambientale. Nelle tre foto con 195-263 parole, il motore FP16 è stato da 2,5 a 3 volte più veloce di ONNX Runtime su CUDA; in una foto con 48 parole è stato 1,4 volte più veloce:
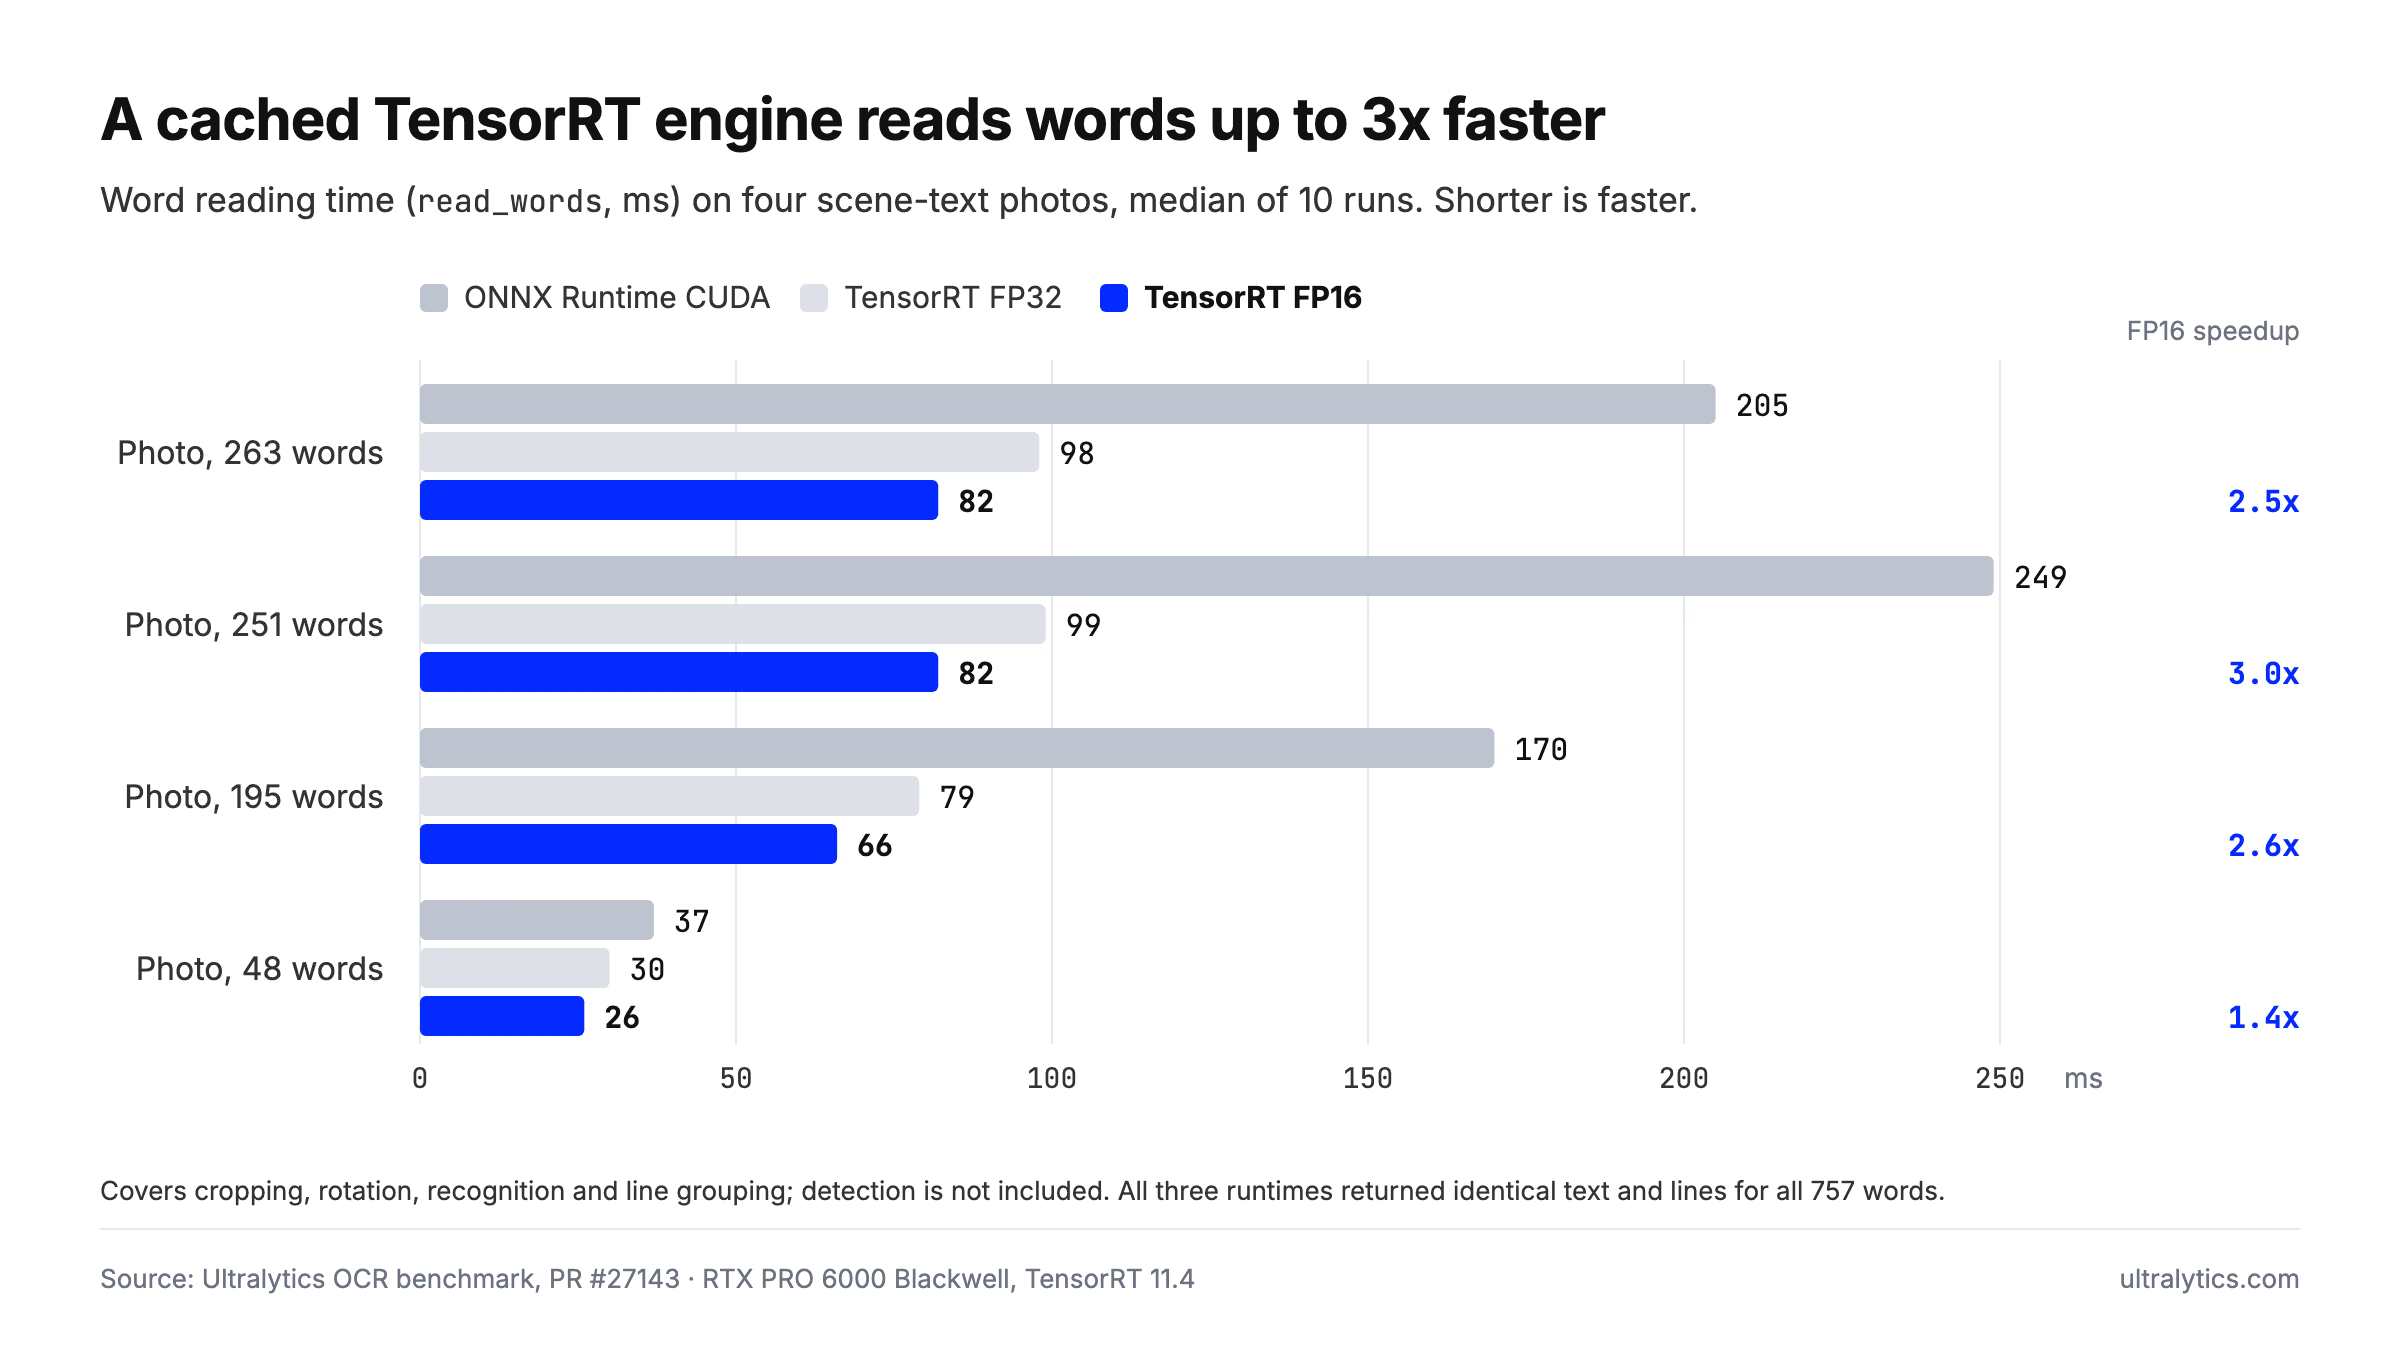
Tempo di lettura delle parole su quattro foto di testo ambientale con ONNX Runtime CUDA e motori TensorRT FP32 e FP16, mediana di 10 esecuzioni su una RTX PRO 6000 Blackwell con TensorRT 11.4.
Su una pagina densa, una chiamata OCR completa è passata da 182 ms a 94 ms. In queste quattro foto, l'aumento di velocità non ha modificato il risultato: per tutte le 757 parole, ONNX Runtime e i due motori hanno restituito testo e raggruppamento delle righe identici.
Mantieni il valore predefinito recognizer="paddleocr" se non puoi aspettare la prima compilazione o non usi hardware NVIDIA. Non compila nulla e si avvia in circa un secondo. Il nostro confronto tra ONNX e TensorRT analizza lo stesso compromesso per i modelli di rilevamento, mentre la guida all'integrazione TensorRT spiega la configurazione.
Al momento sono supportati gli alfabeti cinese, giapponese e latino#
PP-OCRv6 può restituire solo caratteri appartenenti al suo insieme integrato di 18.708 caratteri. Il rilevatore YOLO26-Text non dipende da tale insieme e continua a trovare parole scritte con altri alfabeti, ma restituisce caratteri simili per le parole che ne sono prive. Per esempio, il testo russo ТЕКСТ viene letto come "TEKCT", spesso con alta confidenza.
- Supportati: cinese semplificato e tradizionale (circa 15.600 caratteri CJK), giapponese (hiragana, katakana e kanji) e lingue che usano l'alfabeto latino, tra cui inglese, francese, tedesco, spagnolo, portoghese, italiano, olandese, svedese, finlandese, danese, norvegese, polacco, ceco, ungherese, rumeno, turco, croato, indonesiano e malese. Sono coperti tutte le lettere e i caratteri accentati, tranne la ẞ maiuscola tedesca e ¡ spagnolo.
- Parzialmente supportati: vietnamita, per cui mancano la maggior parte delle vocali con segni tonali, e greco, per cui sono coperte solo le lettere base.
- Non ancora supportati: cirillico, coreano (Hangul), arabo, ebraico, devanagari e thai.
Per un alfabeto non supportato, mantieni il rilevatore YOLO26-Text e passa come recognizer un riconoscitore addestrato per quell'alfabeto. La tabella completa delle lingue supportate si trova nella relativa sezione della guida OCR.
Confronto tra librerie OCR Python in base alle funzionalità documentate#
Non esiste un unico modello OCR migliore: quello giusto dipende dalle tue pagine, dalle tue lingue e dall'ambiente in cui viene eseguito il codice. La tabella confronta le funzionalità documentate, non i risultati misurati, in base alle pagine pubbliche di ciascun progetto, consultate il 12 novembre 2026. Le opzioni sono elencate in ordine alfabetico.
| Opzione | Ambiente di esecuzione | Testo ruotato | Lingue documentate | Output |
|---|---|---|---|---|
| EasyOCR | PyTorch | rotation_info prova 90°, 180° e 270° per ogni riquadro di testo | Oltre 80, tra cui cirillico, arabo, devanagari, coreano e thai | Riquadri, testo e confidenza |
| PaddleOCR | PaddlePaddle | Classificazione facoltativa dell'orientamento | Oltre 100 (PP-OCRv6 ne copre 50 con un solo modello) | Riquadri, testo e confidenza |
| Tesseract (pytesseract) | Binario nativo, CPU | Rilevamento dell'orientamento e dell'alfabeto (image_to_osd); ruota l'immagine prima della lettura | 100+ | Testo, con dati delle parole opzionali |
| OCR Ultralytics YOLO26 | Rilevatore PyTorch; riconoscitore su ONNX Runtime o TensorRT su GPU NVIDIA | Rotazione della pagina stimata dal testo rilevato; la distinzione tra 0° e 180° viene risolta automaticamente | Cinese, giapponese e alfabeti latini; altri tramite un riconoscitore personalizzato | Parole nell'ordine di lettura con numeri di riga, poligoni e confidenze di rilevamento e riconoscimento separate |
Consulta la documentazione di EasyOCR, il repository PaddleOCR, la documentazione di Tesseract e pytesseract per verificare le opzioni attualmente disponibili. Per approfondire il funzionamento di questi motori, consulta la nostra panoramica dei modelli OCR open source più diffusi.
Il ruolo di Ultralytics#
L'OCR Ultralytics YOLO26 è pensato per gli sviluppatori Python che devono estrarre testo da input eterogenei, come moduli scansionati, pagine PDF, schermate e foto di etichette e cartelli, mantenendo le parole nell'ordine di lettura e le relative coordinate verificabili. È una buona scelta quando le pagine arrivano con angolazioni imprevedibili, quando vuoi eseguire l'OCR sui tuoi computer oppure quando usi già modelli Ultralytics YOLO26 e vuoi integrare l'OCR nello stesso pacchetto. Aggiungi recognizer="tensorrt" per elaborare volumi elevati su GPU NVIDIA.
Il rilevatore è un normale modello Ultralytics, quindi puoi addestrarlo, convalidarlo ed esportarlo come qualsiasi altro modello. Il progetto YOLO26-Text su Ultralytics Platform include tutte e cinque le dimensioni, da n a x, e ti permette di confrontare le curve di addestramento e clonare il progetto per partire da quei modelli.
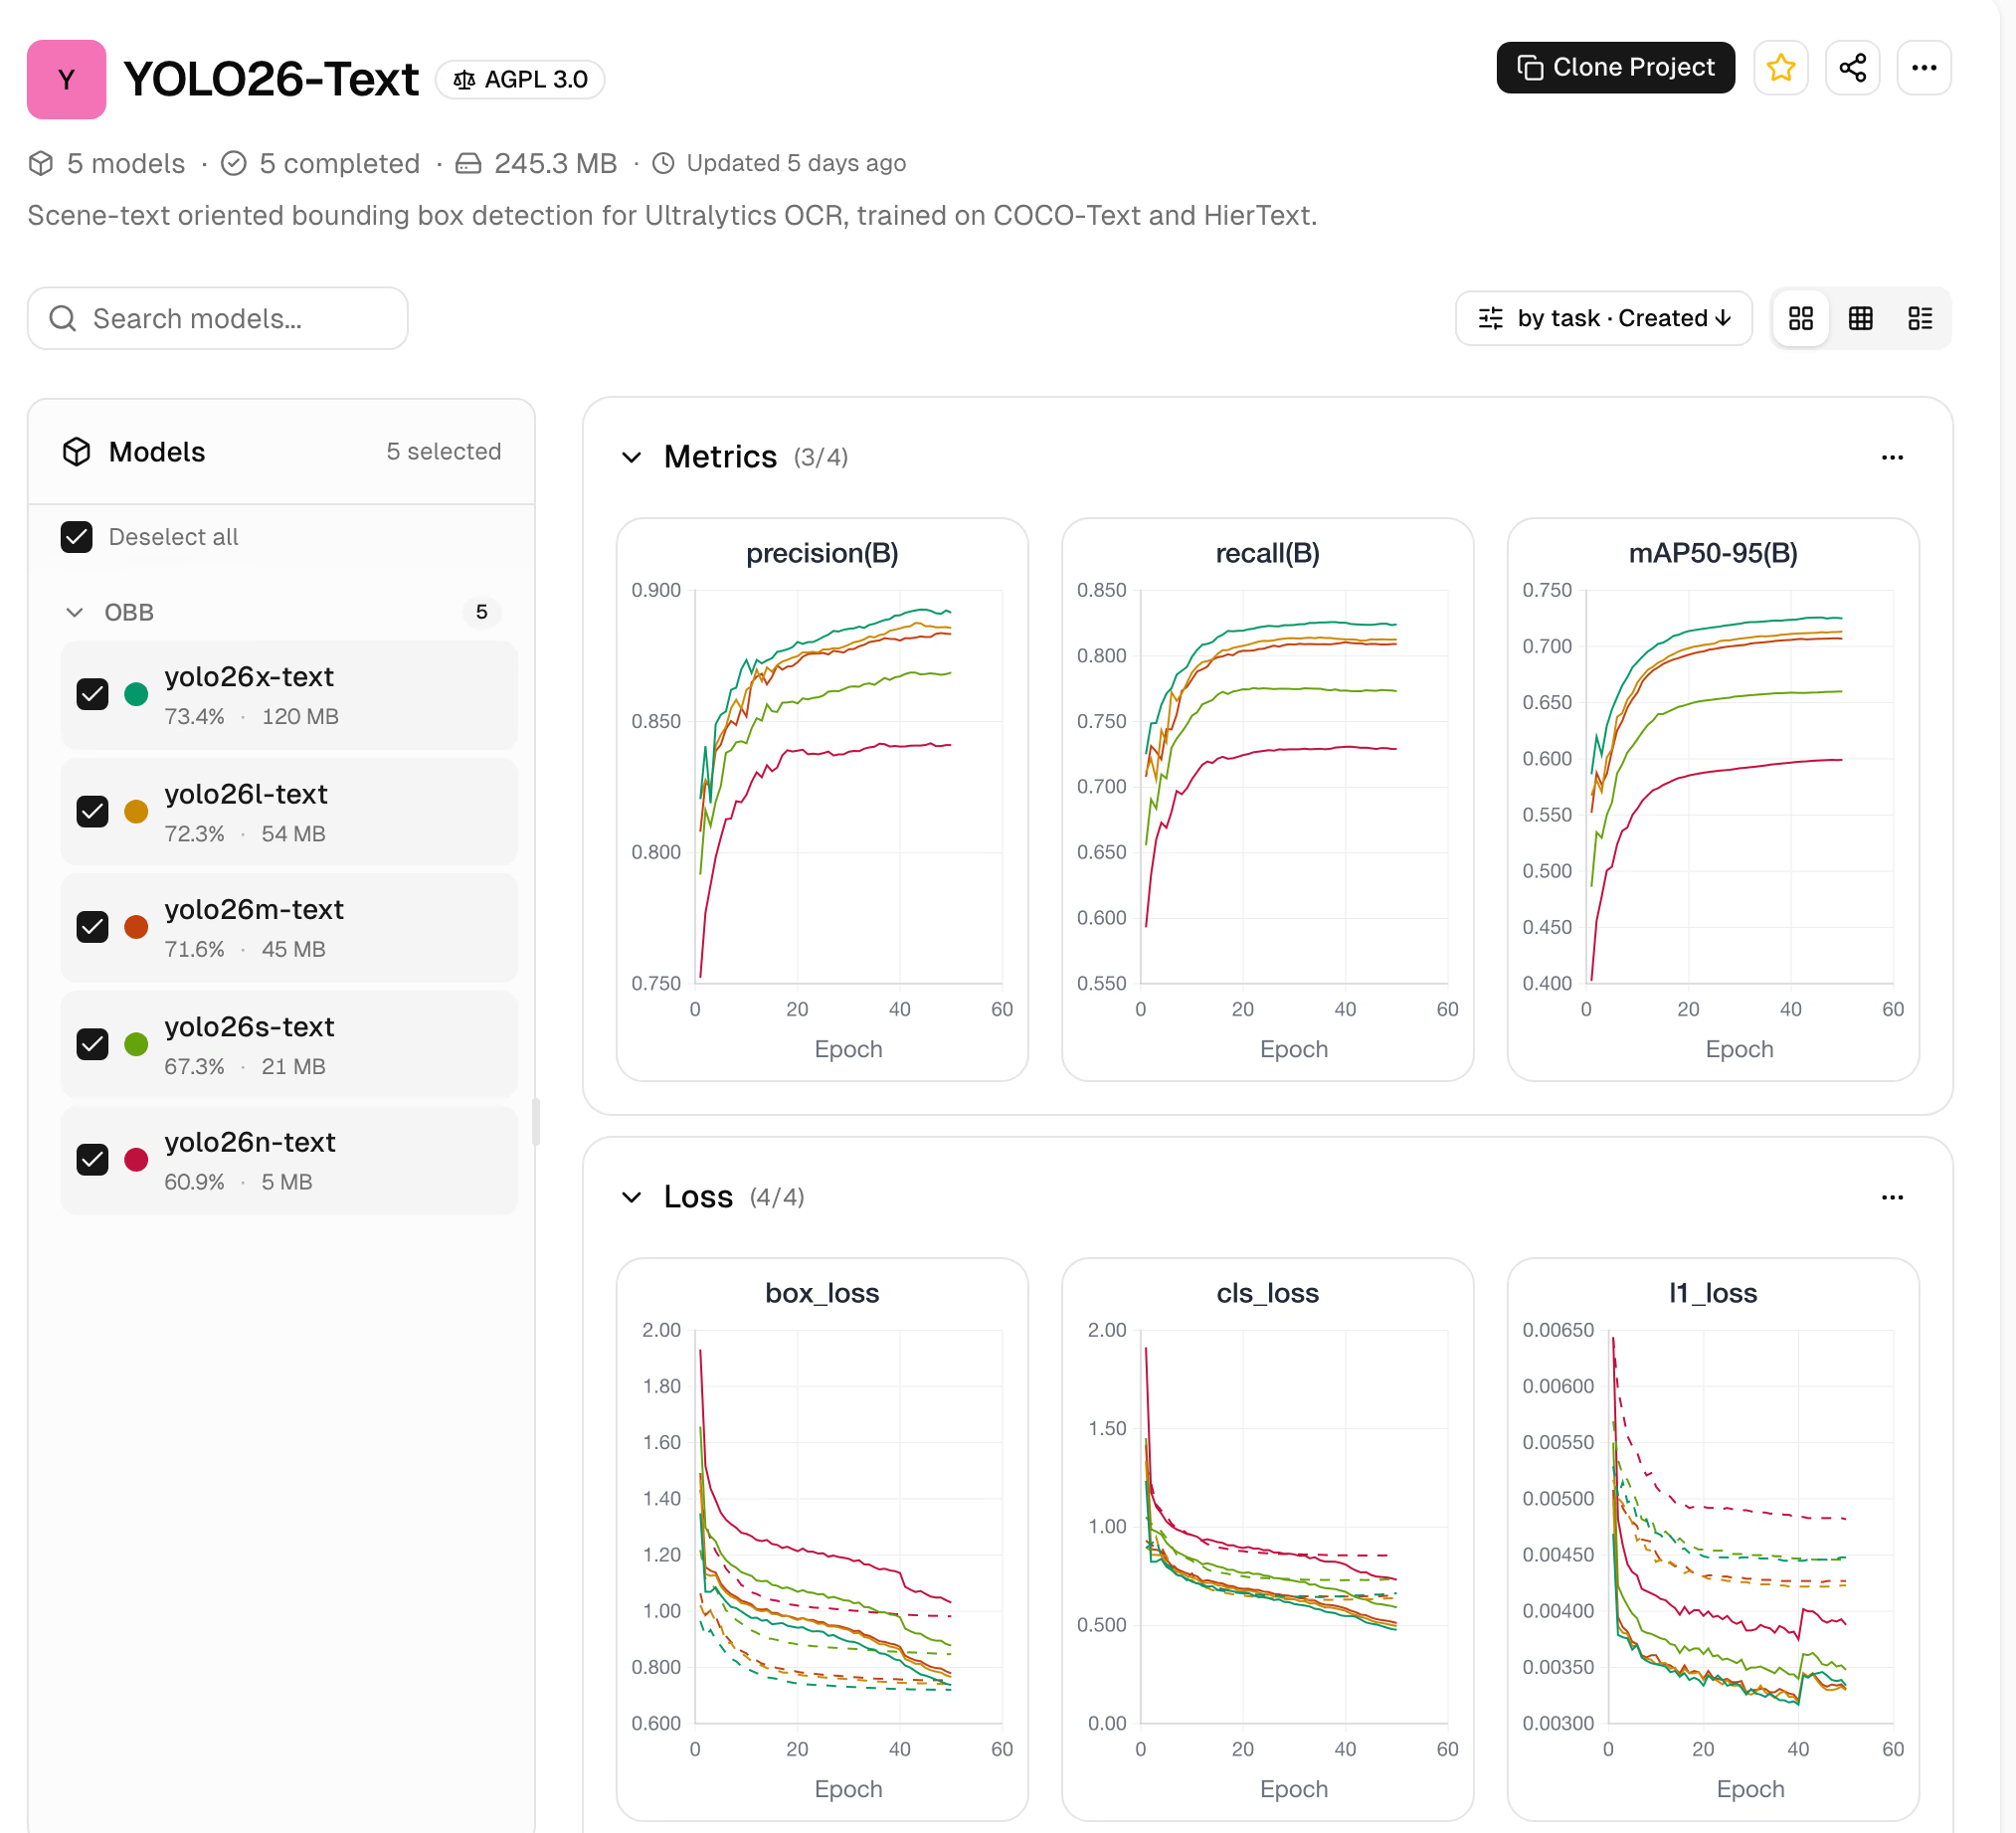
Il progetto YOLO26-Text su Ultralytics Platform: tutte e cinque le dimensioni del rilevatore con le rispettive curve di precisione, richiamo, mAP50-95 e perdita durante l'addestramento.
Per adattarlo ai tuoi documenti, parti dal dataset Scene Text OBB, che combina COCO-Text e HierText in 65.325 immagini con circa 1,29 milioni di poligoni di parole.
I suoi limiti sono specifici:
- Alfabeti. Il riconoscitore predefinito non legge ancora il cirillico, il coreano, l'arabo, l'ebraico, il devanagari o il thai. Abbina il rilevatore a un tuo riconoscitore oppure scegli un motore che li supporti.
- Direzioni miste. La soluzione ruota l'intera pagina in base alla direzione dominante del testo; di conseguenza, il testo orientato in più direzioni sulla stessa pagina, come una nota verticale a margine, potrebbe essere letto con minore accuratezza.
- Esportazione. Il riconoscitore non è incorporato nel file esportato del rilevatore: distribuisci quindi il rilevatore e l'ambiente di esecuzione del riconoscimento affiancati oppure usa la soluzione Python come componente di raccordo.
- Rust. Ultralytics Inference legge il testo ambientale in Rust con lo stesso riconoscitore PP-OCRv6 tramite
ultralytics-inference predict --ocr, ma gestisce l'orientamento con un classificatore anziché con la fase di rotazione della pagina usata dalla soluzione Python. - Privacy. La soluzione Python viene eseguita sul tuo hardware, quindi le pagine non devono lasciare i tuoi computer; la demo nel browser carica le pagine per l'inferenza. Per i campi che non devono essere letti, copri le regioni note con una maschera opaca prima di eseguire l'OCR.
Per moduli e contratti, un modello YOLO personalizzato può individuare prima campi, tabelle, firme e timbri, così leggi solo le regioni che ti servono. Il dataset Signature su Ultralytics Platform e la nostra guida all'analisi intelligente dei documenti sono ottimi punti di partenza, mentre Ultralytics Platform ti permette di etichettare le pagine e addestrare il modello in un unico posto. Per provare prima l'OCR su una tua pagina, trascina un'immagine o un PDF nella demo OCR live.
Domande frequenti
Installa il pacchetto Ultralytics con
pip install -U "ultralytics>=8.4.211", poi chiamasolutions.OCR()su un'immagine caricata con OpenCV. Restituisce le parole riconosciute con testo, confidenza, numero di riga e poligono, nell'ordine di lettura. La prima esecuzione scarica automaticamente il rilevatore YOLO26-Text e il riconoscitore PP-OCRv6.Dipende dai tuoi documenti, dalle lingue e dall'hardware; la nostra panoramica dei modelli OCR open source più diffusi confronta le opzioni principali. Nel nostro benchmark, con dimensione immagine 1280 su una RTX PRO 6000, YOLO26x-Text con PP-OCRv6 ha ottenuto un F1 delle parole pari a 0.931 su sei pagine PDF e 0.722 su 80 foto HierText, e legge le pagine con qualsiasi rotazione. Per gli alfabeti non ancora supportati, come il cirillico o il coreano, usa un riconoscitore addestrato per quell'alfabeto.
Un modello YOLO rileva il testo, ma non lo legge. Ultralytics YOLO26-Text rileva il testo sotto forma di riquadri orientati e la soluzione OCR passa ogni ritaglio al riconoscitore PP-OCRv6: insieme eseguono quindi l'OCR completo con una sola chiamata.
Sì. Converti ogni pagina del PDF in un'immagine, ad esempio con
get_pixmapdi PyMuPDF, convertila in BGR e passala asolutions.OCR(). Nel browser, la demo e la scheda Platform Predict accettano un PDF e ne leggono la prima pagina.Sì. PP-OCRv6 funziona con ONNX Runtime su CPU o su GPU CUDA e lo stesso script funziona su entrambi. Il riconoscitore TensorRT opzionale richiede una GPU NVIDIA.
Non ancora con il riconoscitore predefinito. PP-OCRv6 supporta il cinese, il giapponese e le lingue con alfabeto latino, ma non il cirillico, l'hangul, l'arabo, l'ebraico, il devanagari o il thai. Puoi mantenere il rilevatore YOLO26-Text e passargli un riconoscitore addestrato per quello specifico sistema di scrittura.
Scritto da
Senior Machine Learning Engineer · Ultralytics
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









