Claude Fable 5.2 ya está aquí y se niega a mirar radiografías de seguridad
Claude Fable 5.2 ya está disponible y se niega a etiquetar el conjunto de datos de rayos X de seguridad IEDXray en Ultralytics Platform: bloqueó las 10 imágenes, mientras que los modelos abiertos respondieron.
 Glenn Jocher17 min de lectura
Anthropic lanzó Claude Fable 5.2 el 9 de noviembre de 2026 y afirmó que es «un paso por delante de Opus 5.5 en casi todas las capacidades que evaluamos». Ese mismo día lo probamos con UL37, nuestro benchmark de detección con 36 conjuntos de datos. En uno de ellos, se negó a mirar una sola imagen.
La primera imagen muestra un portátil metido en una bolsa, con la placa de circuitos visible a través de la carcasa y dos baterías encajadas a su lado. Le pedimos a Claude Fable 5.2 que dibujara cuadros delimitadores alrededor. En menos de dos segundos, la API de Anthropic respondió con un bloqueo: «Esta solicitud activó restricciones sobre contenido relacionado con el desarrollo de explosivos de alto rendimiento y se bloqueó conforme a la Política de uso de Anthropic».
Hizo lo mismo con las 10 radiografías de seguridad del conjunto de datos, incluidas cinco que solo muestran un teléfono, un portátil, un buscapersonas o un walkie-talkie corriente. Ningún otro modelo que hayamos probado se negó a analizar una sola imagen: ni GPT-6.1, Gemini o Grok, ni ningún modelo de pesos abiertos o chino, ni siquiera los modelos Claude Opus 5.5, Sonnet 5.5 y Haiku 5.5 de la propia Anthropic.
En todo lo demás, el autoetiquetado de Claude Fable 5.2 es excelente. Obtuvo 0.544 mAP50 y quedó segundo entre 44 modelos en nuestra clasificación de VLM, por detrás de GPT-6.1 Terra; además, sus cuadros son los más ajustados que hemos medido. Ya está disponible en Ultralytics Platform. A continuación explicamos qué tareas rechaza, cuáles resuelve de maravilla y si encaja en tu flujo de etiquetado.
El filtro de Anthropic bloqueó todas las radiografías de seguridad de UL37#
UL37 mide cuánto se aproximan los cuadros de un modelo a las etiquetas humanas en 360 imágenes: 10 de cada uno de 36 conjuntos de datos reales de detección de objetos. Uno de ellos es IEDXray, un conjunto de radiografías de escáneres de equipaje creado para entrenar detectores de amenazas en aeropuertos, fronteras y eventos. Sus 11 clases abarcan dispositivos electrónicos cotidianos (portátiles, teléfonos, buscapersonas, walkie-talkies y baterías), versiones modificadas de cada uno y explosivos.
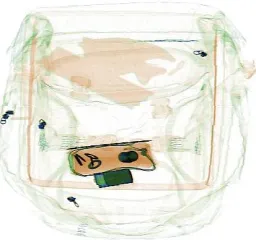 Vista previa 1 de IEDXray Improvised Device X-rayLa superposición de anotaciones muestra 2 etiquetas
 Vista previa 2 de IEDXray Improvised Device X-rayLa superposición de anotaciones muestra 1 etiqueta
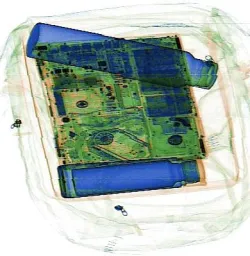 Vista previa 3 de IEDXray Improvised Device X-rayLa superposición de anotaciones muestra 1 etiqueta
 Vista previa 4 de IEDXray Improvised Device X-rayLa superposición de anotaciones muestra 1 etiqueta
Security X-ray scans of bags concealing improvised explosive device components and modified electronics, from the IEDXray benchmark (2026). Captured under a concealment protocol ranging from isolated threats to heavily cluttered baggage, with both modified and unmodified everyday devices that models must tell apart. Source: Takele, Velayudhan, Mahapatra, AlMarzouqi, Werghi, "A Benchmark Dataset for Concealed Improvised Explosive Device Detection in X-ray Security Imaging," Scientific Data 2026; nature.com/articles/s41597-026-07263-7.
Fable 5.2 rechazó las 10 imágenes. Cada solicitud tardó entre 1,0 y 4,7 segundos y devolvió el motivo de detención de Anthropic refusal, sin ningún cuadro. Platform muestra al usuario el mensaje «se detuvo antes de terminar las detecciones (rechazo). Prueba con otro modelo».
Para averiguar exactamente por qué, el 10 de noviembre volvimos a enviar directamente a la API de Anthropic la solicitud de producción de Platform para las diez imágenes. Las diez respuestas fueron iguales: motivo de detención refusal, categoría general_harms, cero tokens de salida y el mensaje sobre «explosivos de alto rendimiento» citado antes. El mensaje sugiere solicitar «una exención según el uso que hagas de Claude» a través del centro de ayuda de Anthropic. A quienes integren la API, les remite a la documentación sobre rechazos de Anthropic, que recomienda configurar un modelo alternativo.
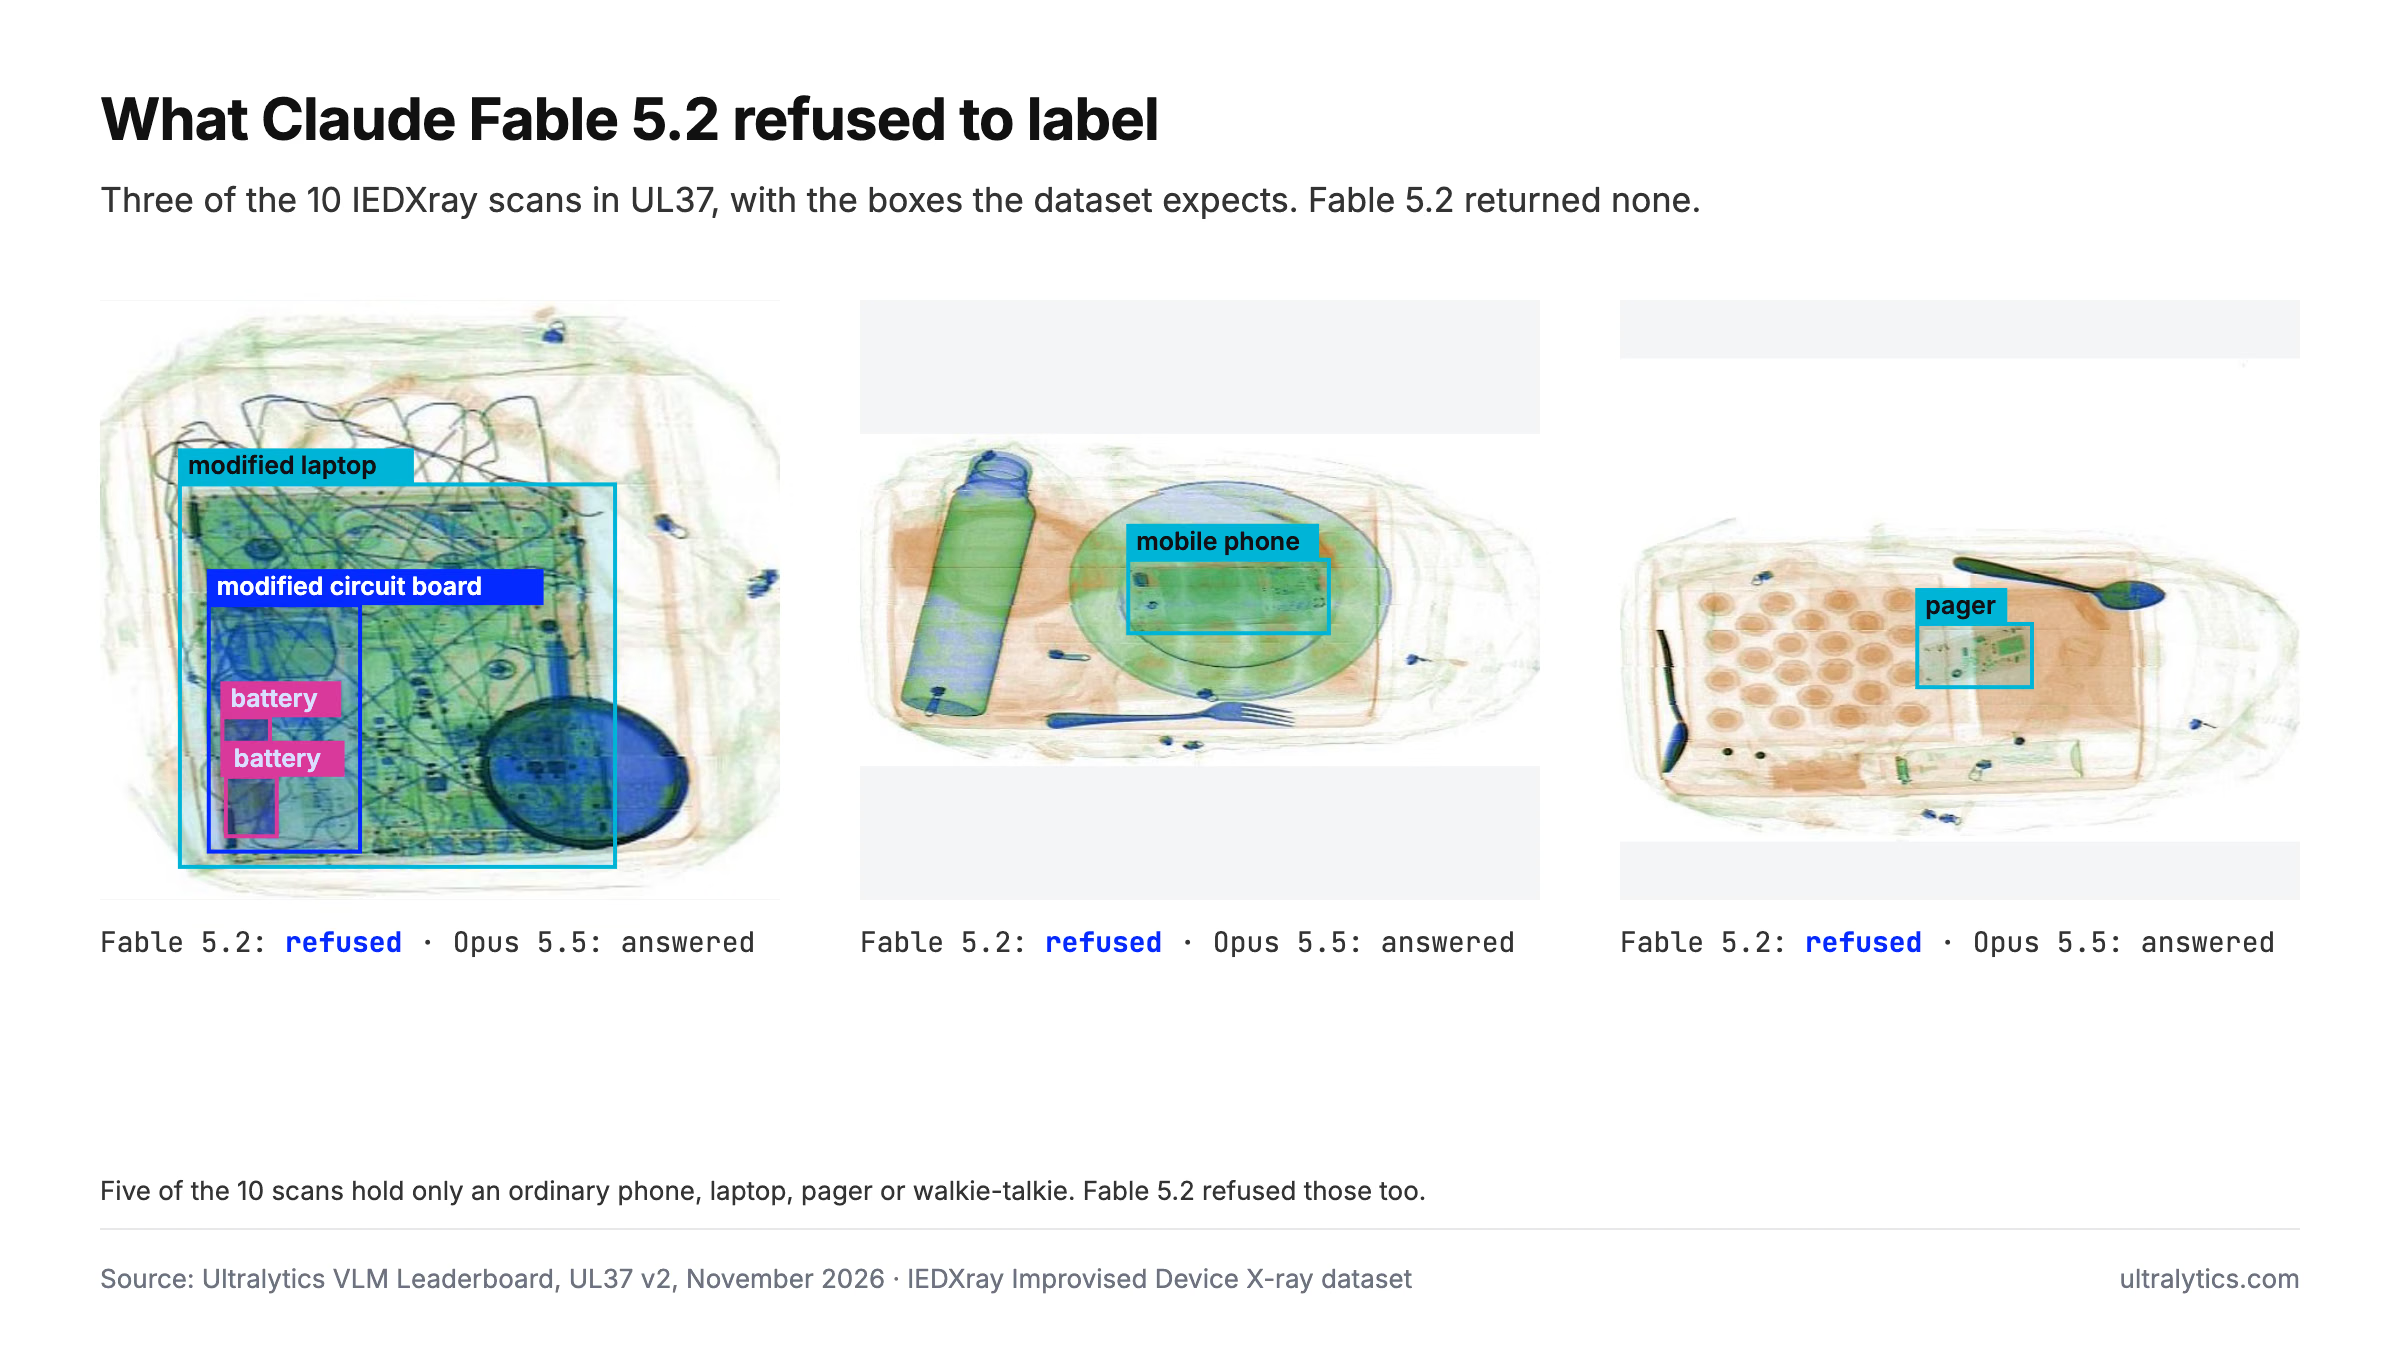
Tres de las 10 radiografías de IEDXray con los cuadros esperados. Claude Fable 5.2 rechazó las tres; Claude Opus 5.5 respondió a las diez imágenes en la misma ejecución.
El bloqueo no depende de lo que aparece en la imagen. El teléfono móvil del centro es solo un teléfono móvil. Cinco de las diez imágenes no contienen ningún dispositivo modificado ni explosivo, y Fable 5.2 las rechazó todas. Parece que el filtro reacciona a la tarea en sí: un conjunto de datos de seguridad cuya lista de clases menciona explosivos.
Fable 5.2 rechaza más imágenes que Fable 5.1, no menos#
El anuncio de lanzamiento de Anthropic afirma que las protecciones de Fable 5.2 contra riesgos cibernéticos y biológicos «generan menos bloqueos innecesarios» que las de Fable 5.1, alrededor de un 55 % menos en las primeras pruebas. En las radiografías de seguridad vimos lo contrario: Fable 5.1 rechazó una de cada diez imágenes y Fable 5.2 las rechazó todas.
Anthropic también afirma que Fable 5.2 y Claude Mythos 5.2 son el mismo modelo subyacente. Mythos 5.2 se distribuye sin ciertas protecciones contra riesgos cibernéticos y biológicos, y solo está disponible para organizaciones verificadas por Anthropic. En otras palabras, las protecciones son una capa que decide el proveedor, independiente de la capacidad del modelo para interpretar imágenes. Fable 5.1 respondió a nueve de las mismas imágenes y obtuvo 0.15.
Para un equipo que desarrolla un detector para inspeccionar equipaje, el resultado práctico es sencillo. El modelo Claude más caro no sirve para etiquetar los datos y la política cambió de una versión a otra.
Todos los modelos de pesos abiertos etiquetaron las imágenes que Fable rechazó#
De los 44 modelos de nuestra clasificación, solo dos rechazaron alguna imagen de IEDXray, y ambos son Claude Fable: la versión 5.1 rechazó una y la 5.2, diez. Ningún otro modelo rechazó ninguna, ya fuera de OpenAI, Google, xAI, Meta, un laboratorio chino o las líneas Opus, Sonnet y Haiku de la propia Anthropic.
Esto incluye los 19 modelos que alojamos en los propios servidores de Platform y modelos de pesos abiertos como Qwen3.8 27B, Gemma 4 26B, Nemotron 3 Nano Omni, SAM 3.1 Text y Moondream 3.1. Ninguno rechazó una sola imagen. Moondream 3.1, un modelo de pesos abiertos que no necesita clave de API en Platform, obtuvo 0.27 mAP50 en IEDXray; solo lo superó Gemini 4 Argon, con 0.30, y quedó por delante de todos los modelos Claude.
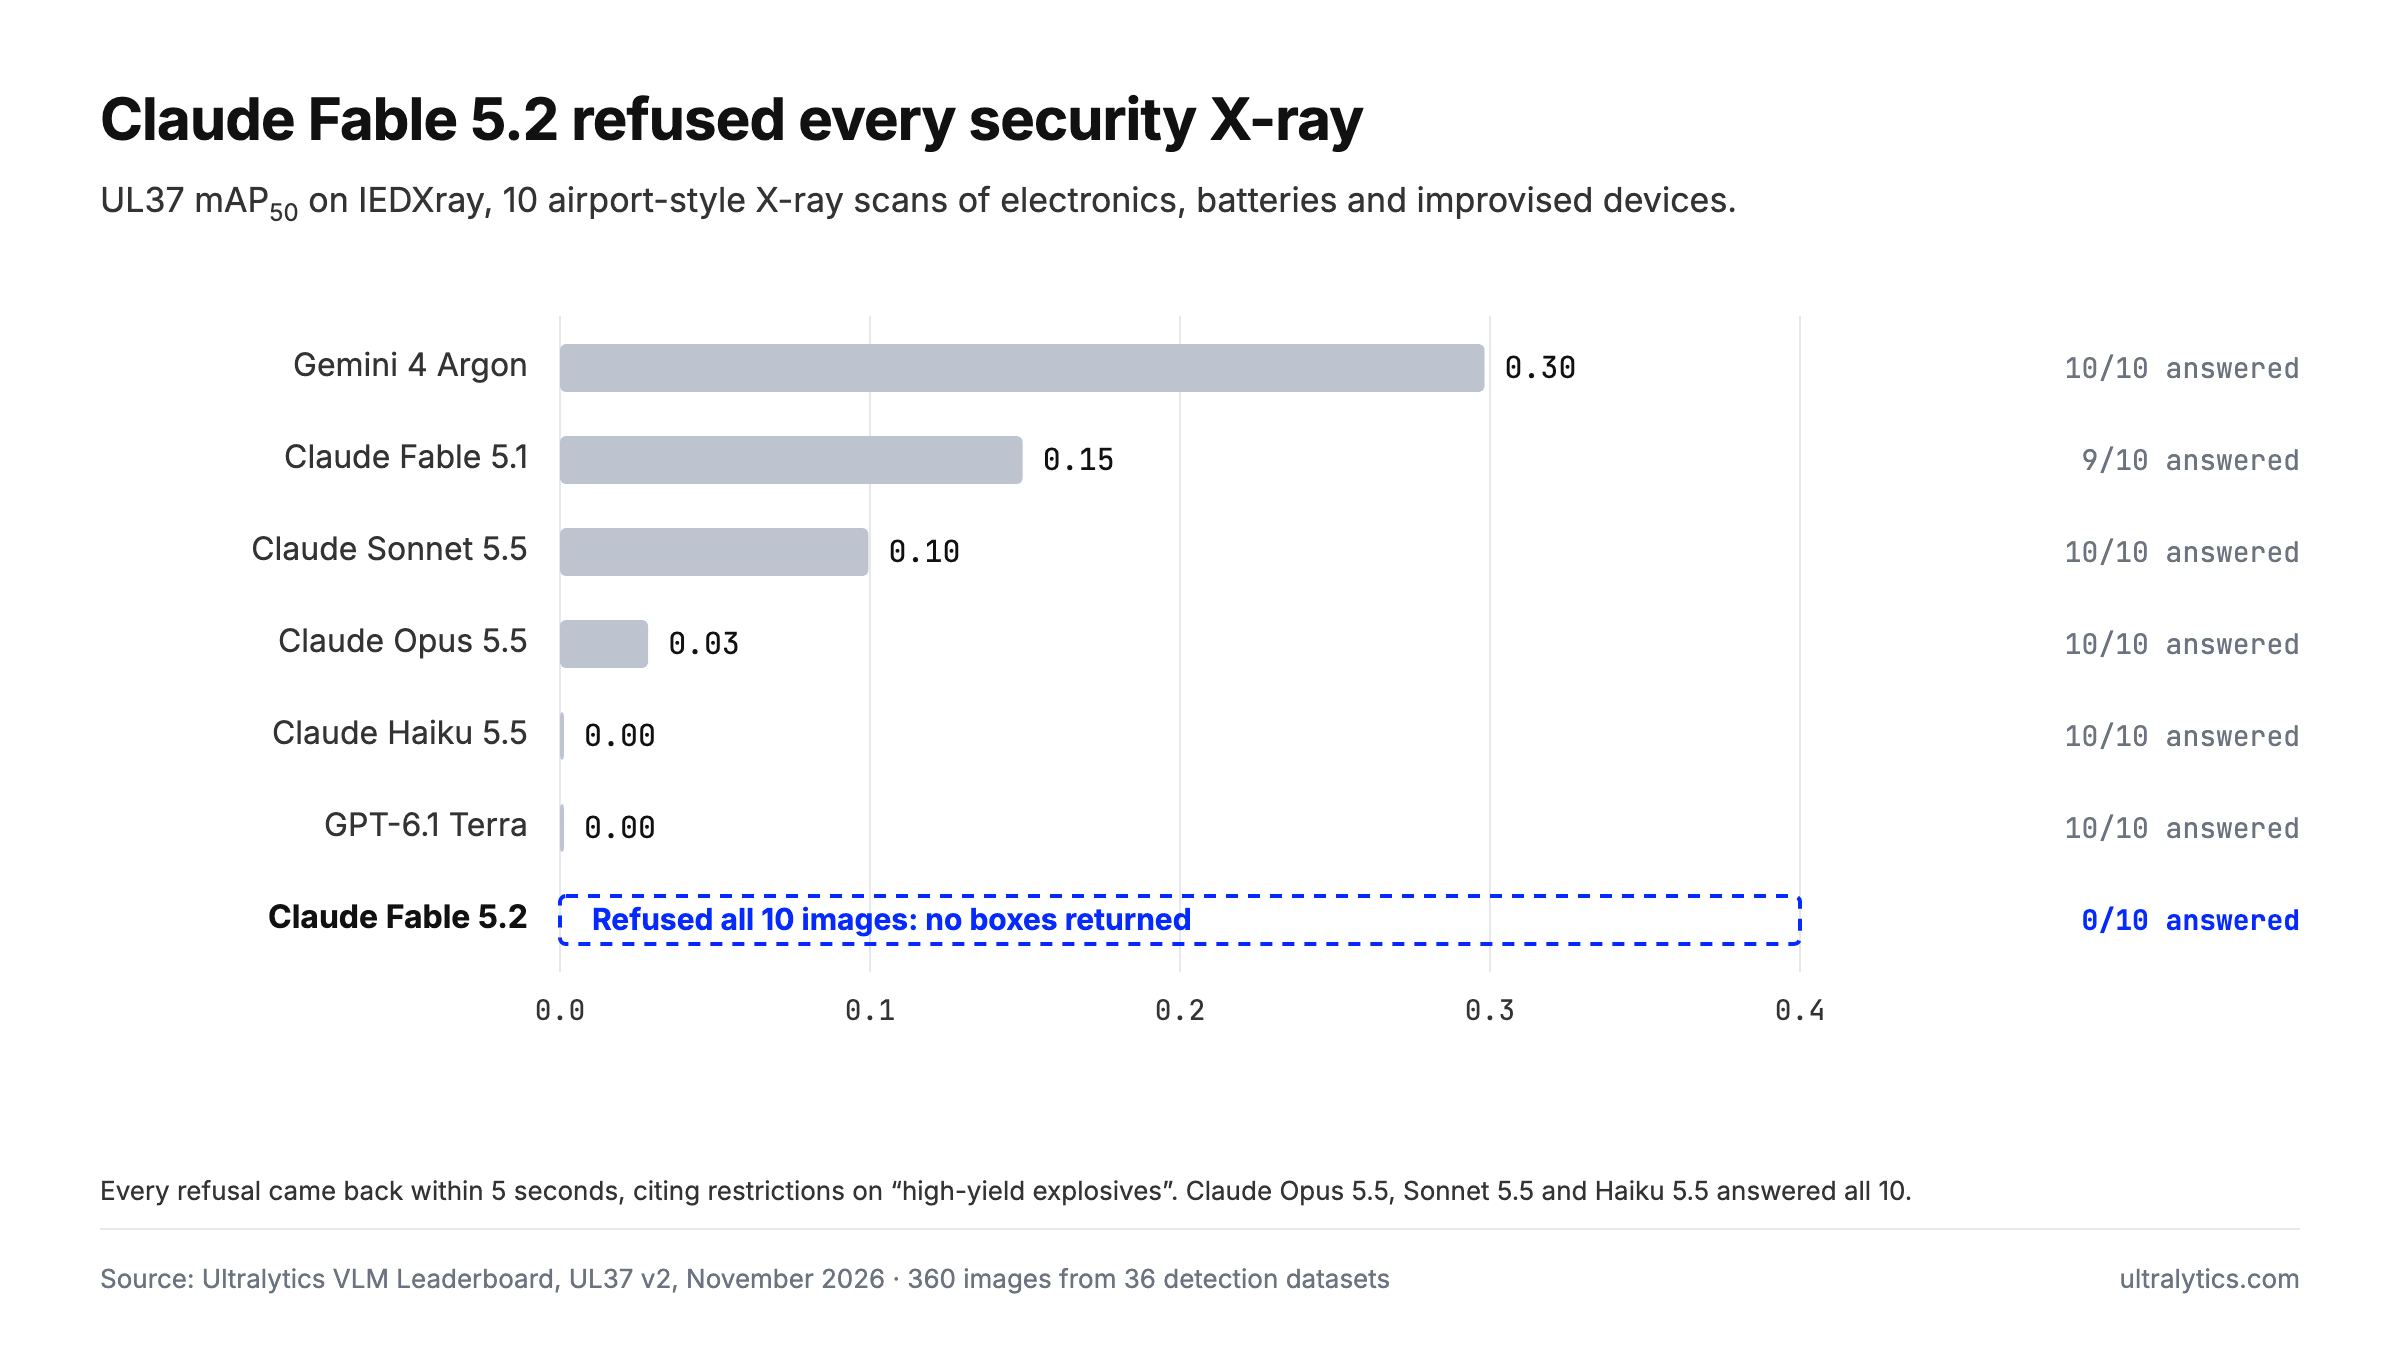
mAP50 en IEDXray para la línea de Anthropic y los dos modelos líderes de la clasificación, UL37 v2, esfuerzo de razonamiento predeterminado. Fable 5.2 no respondió a ninguna de las 10 imágenes.
Los modelos chinos suelen acaparar titulares por lo que no dicen. Esta vez ocurrió lo contrario: un laboratorio estadounidense líder censuró los resultados, mientras que todos los modelos chinos que probamos respondieron sin problemas. Qwen de Alibaba, Kimi de Moonshot, DeepSeek, GLM de Zhipu, MiMo de Xiaomi, MiniMax y HY4 de Tencent no rechazaron ninguna de las diez imágenes, y los modelos Qwen de pesos abiertos que alojamos respondieron a todas. El modelo insignia de Anthropic, a 8 $ por millón de tokens de entrada, se negó a mirar.
Las radiografías de seguridad son difíciles para todos los modelos. La mayoría obtiene menos de 0.15 en IEDXray, así que los cuadros de cualquier modelo son solo un primer borrador. Pero puedes corregir un borrador en el editor de anotaciones. Si el modelo se niega, tendrás que dibujar todos los cuadros a mano. Además, con los pesos abiertos, el modelo que validas hoy se comportará igual mañana, porque no hay ninguna política del proveedor que se interponga entre tú y su resultado. Una vez etiquetados los datos, entrenar tu propio detector Ultralytics YOLO26 también deja el modelo desplegado completamente bajo tu control.
Fuera de las radiografías de seguridad, Claude Fable 5.2 es el segundo mejor anotador que hemos probado#
Todas las imágenes de UL37 pasan por la misma canalización de producción que utilizan quienes usan Platform, con los nombres de clase del propio conjunto de datos; después, SAM 3.1 ajusta todos los cuadros. La metodología es pública. Esta es la ficha de resultados de Fable 5.2:
- mAP50: 0.544, n.º 2 de 44
- mAP50-95: 0.347, n.º 1 de 44, justo por delante de 0.345 de GPT-6.1 Terra
- Precisión y exhaustividad: 0.602 y 0.620
- Coste del proveedor: 37,55 $ por cada 1.000 imágenes
- Tiempo mediano por imagen: 4,6 s
- Solicitudes fallidas: 11 de 360: los 10 rechazos y una solicitud que superó el límite de 115 segundos de Platform
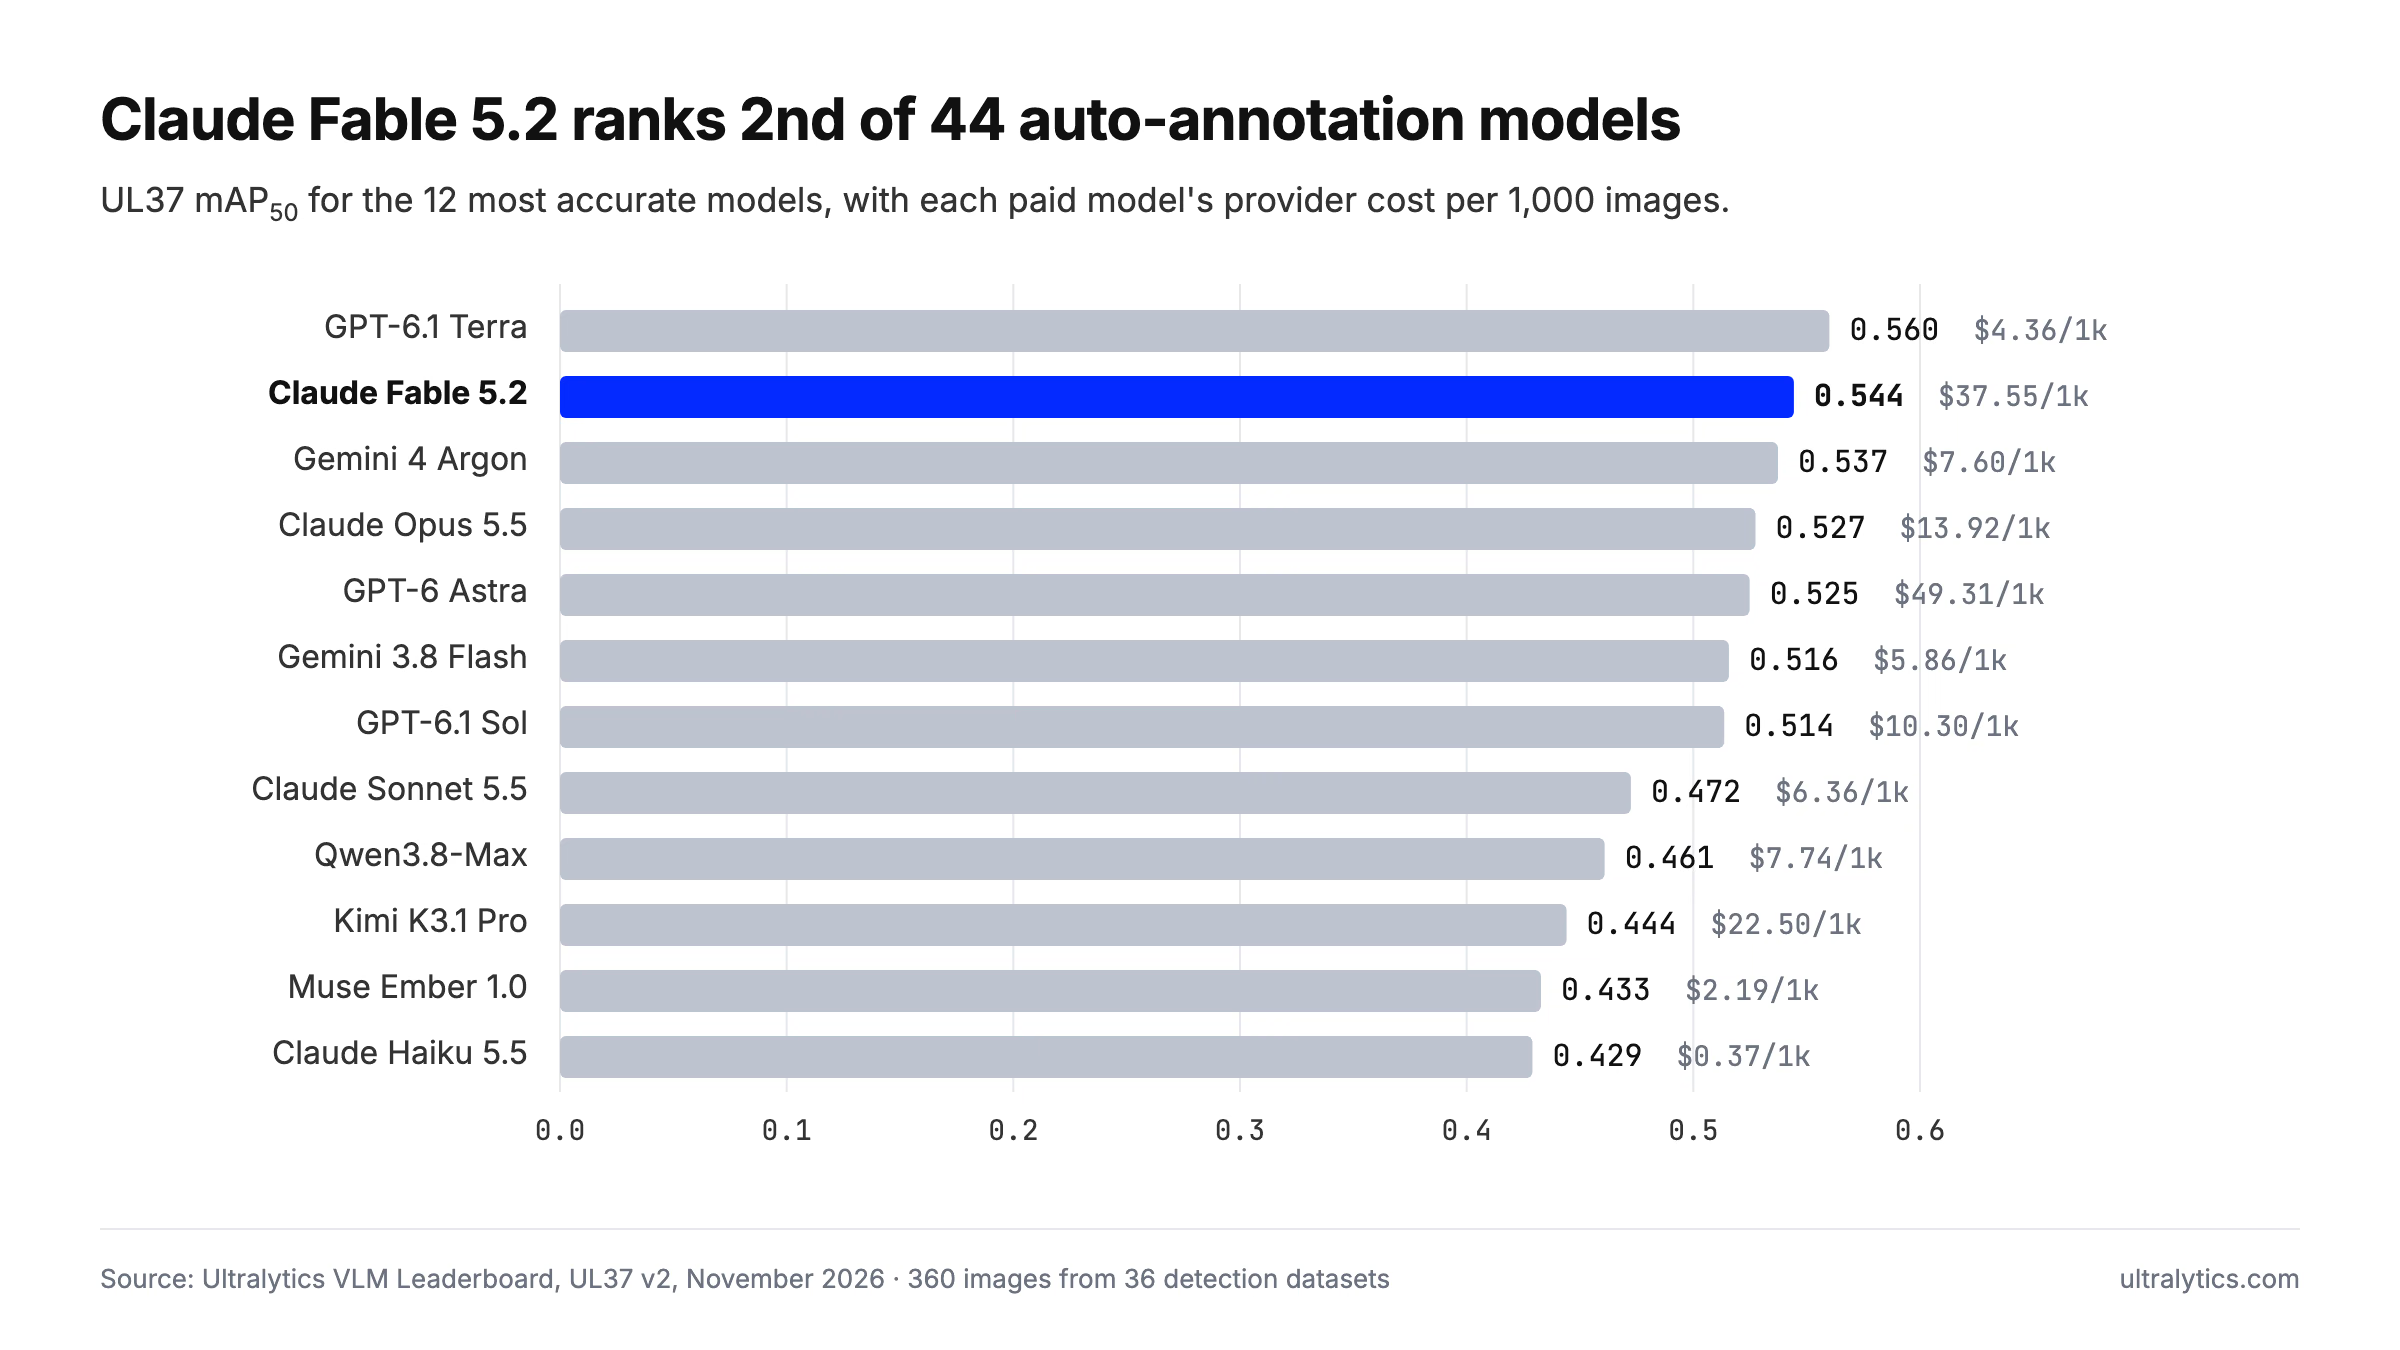
mAP50 en UL37 para los 12 modelos más precisos de un total de 44, con el coste del proveedor por cada 1.000 imágenes, 10 de noviembre de 2026.
Importa que ocupe el primer puesto en mAP50-95. Esta métrica más estricta promedia los umbrales de solapamiento de los cuadros entre el 50 % y el 95 %, por lo que premia los cuadros que se ajustan a cada objeto en lugar de cubrirlo aproximadamente. Los cuadros sin refinar de Fable 5.2 ya obtienen 0.538 mAP50 antes del refinamiento de SAM 3.1, que los eleva a 0.544.
Queda entre los cinco primeros en 22 de los 36 conjuntos de datos y ocupa el primer puesto en tres: bandejas de almuerzo escolar de UEC (0.96), detección de balones y canastas de baloncesto (0.85) y enfermedades de hojas de PlantDoc (0.52). Por ámbito, ocupa el primer puesto en comercio minorista y, por un margen mínimo frente a Claude Opus 5.5, en naturaleza y agricultura. En las 10 imágenes de referencia de COCO 2017, evaluadas por separado, alcanza 0.686, la mejor puntuación de cualquier modelo de lenguaje, por detrás únicamente de los modelos de segmentación SAM 3 y SAM 3.1 Text.
Los rechazos le costaron a Fable 5.2 un cero absoluto en un conjunto de datos, pero no el primer puesto. Si excluimos IEDXray, Fable 5.2 obtiene una media de 0.560, mientras que Terra, que también obtuvo cero allí sin rechazar las imágenes, alcanza una media de 0.576.
Un gran salto con respecto a Claude Fable 5.1#
Fable 5.2 supera a Claude Fable 5.1 en 31 de 36 conjuntos de datos y cuesta menos por imagen.
| Resultado de UL37 | Claude Fable 5.2 | Claude Fable 5.1 |
|---|---|---|
| mAP50 | 0.544 | 0.427 |
| mAP50-95 | 0.347 | 0.262 |
| Precisión / exhaustividad | 0.602 / 0.620 | 0.506 / 0.485 |
| Puesto en la clasificación | 2.º de 44 | 13.º de 44 |
| Coste del proveedor por cada 1.000 imágenes | $37.55 | $43.75 |
| Tiempo mediano por imagen | 4.6 s | 2,6 s |
| Imágenes de IEDXray rechazadas | 10 | 1 |
La precisión y la exhaustividad aumentaron a la vez: hay menos cuadros falsos que borrar y menos objetos omitidos que dibujar. Las mayores mejoras son espectaculares. En las espigas de trigo de GWHD, Fable 5.1 obtuvo 0.24 y Fable 5.2 obtiene 0.77. Los productos de cajas de pago de RPC pasaron de 0.57 a 0.90, las imágenes térmicas de drones de HIT-UAV, de 0.17 a 0.48, y las ecografías de tiroides de TN5000, de 0.03 a 0.44.
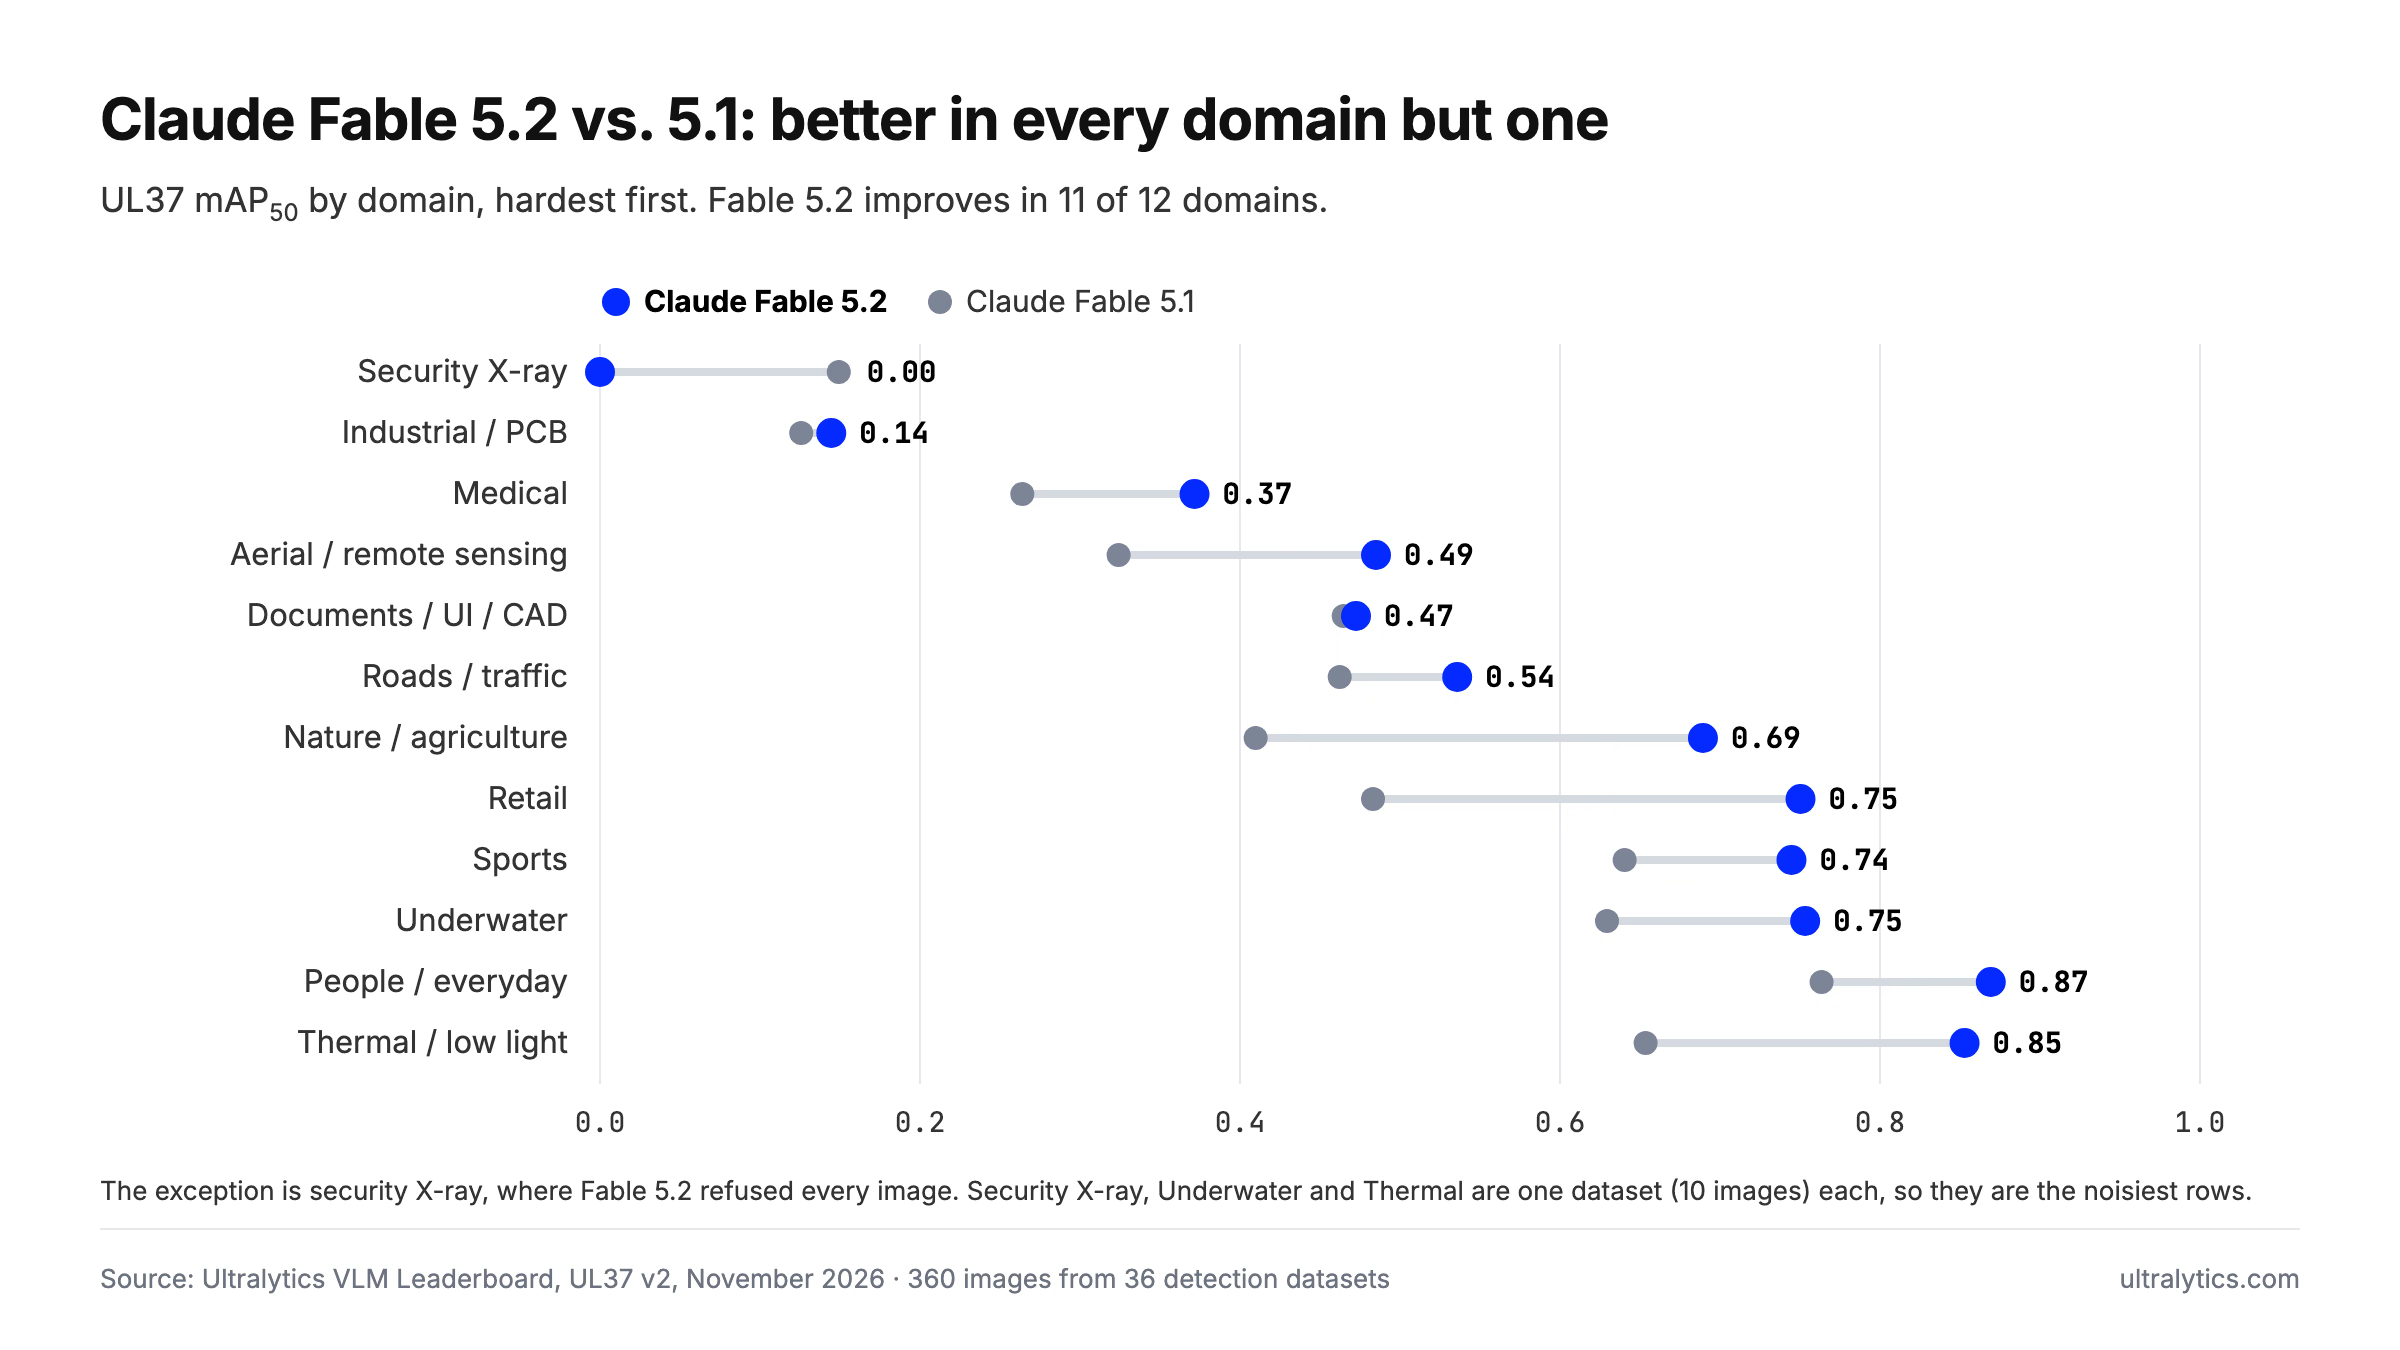
mAP50 en UL37 por ámbito, de más difícil a más fácil; Claude Fable 5.2 frente a Claude Fable 5.1 con el esfuerzo predeterminado de Anthropic.
Once de los doce ámbitos mejoraron. El único que empeoró fue el de las radiografías de seguridad, que pasó de 0.15 a cero; la causa fue el rechazo, no la capacidad visual del modelo. Las marcas viales de CeyMo también bajaron, de 0.85 a 0.74.
Claude Fable 5.2 frente a GPT-6.1 Terra, Gemini 4 Argon y Claude Opus 5.5#
| Modelo | mAP50 de UL37 | mAP50-95 | Precisión | Exhaustividad | Coste por cada 1.000 imágenes | Tiempo mediano por imagen |
|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 0.560 | 0.345 | 0.646 | 0.613 | $4.36 | 5.1 s |
| Claude Fable 5.2 | 0.544 | 0.347 | 0.602 | 0.620 | $37.55 | 4.6 s |
| Gemini 4 Argon | 0.537 | 0.343 | 0.667 | 0.585 | $7.60 | 4.6 s |
| Claude Opus 5.5 | 0.527 | 0.333 | 0.656 | 0.595 | $13.92 | 2,7 s |
En la comparación directa, Fable 5.2 supera a Terra en 18 conjuntos de datos y queda por detrás en 16, con dos empates. Supera a Argon por 21 a 15 y a Opus 5.5 por 22 a 14. De los cuatro, tiene la mayor exhaustividad, por lo que omite menos objetos, pero su precisión es la más baja, así que tendrás que borrar algunos cuadros más. Nuestra guía para elegir un VLM según la precisión y la exhaustividad explica cómo sopesar esa disyuntiva para tus datos.
Además de las radiografías, Fable 5.2 flojea en las imágenes médicas, donde obtiene una media de 0.372 en ocho conjuntos de datos, frente a 0.505 de Terra, y en las placas de circuitos, donde logra 0.00 en DeepPCB. Cada conjunto de datos solo tiene 10 imágenes, así que considera las puntuaciones de cada conjunto indicios, no conclusiones definitivas.
La propia Anthropic recomienda empezar la mayoría de las tareas con Claude Opus 5.5, su «mejor opción para el uso diario», y pasar a Fable solo si la tarea lo exige. Para las anotaciones, el consejo sigue siendo válido. Opus 5.5 alcanza el 97 % del mAP50 de Fable 5.2 por el 37 % del coste, responde en 2,7 s y no rechazó ninguna radiografía.
Cuánto cuesta un lote de Claude Fable 5.2#
Los 37,55 $ por cada 1.000 imágenes corresponden a la factura del proveedor, calculada a partir del uso de tokens que declara Anthropic y sus precios de lista: 8 $ por millón de tokens de entrada y 40 $ por millón de tokens de salida, según la página de precios de Anthropic. Fable 5.2 funciona con el nivel alto de esfuerzo de razonamiento predeterminado de Anthropic. Batch Annotation añade una tarifa de procesamiento de Platform de 1,00 $ por cada 1.000 imágenes, así que procesar 1.000 imágenes cuesta unos 38,55 $.
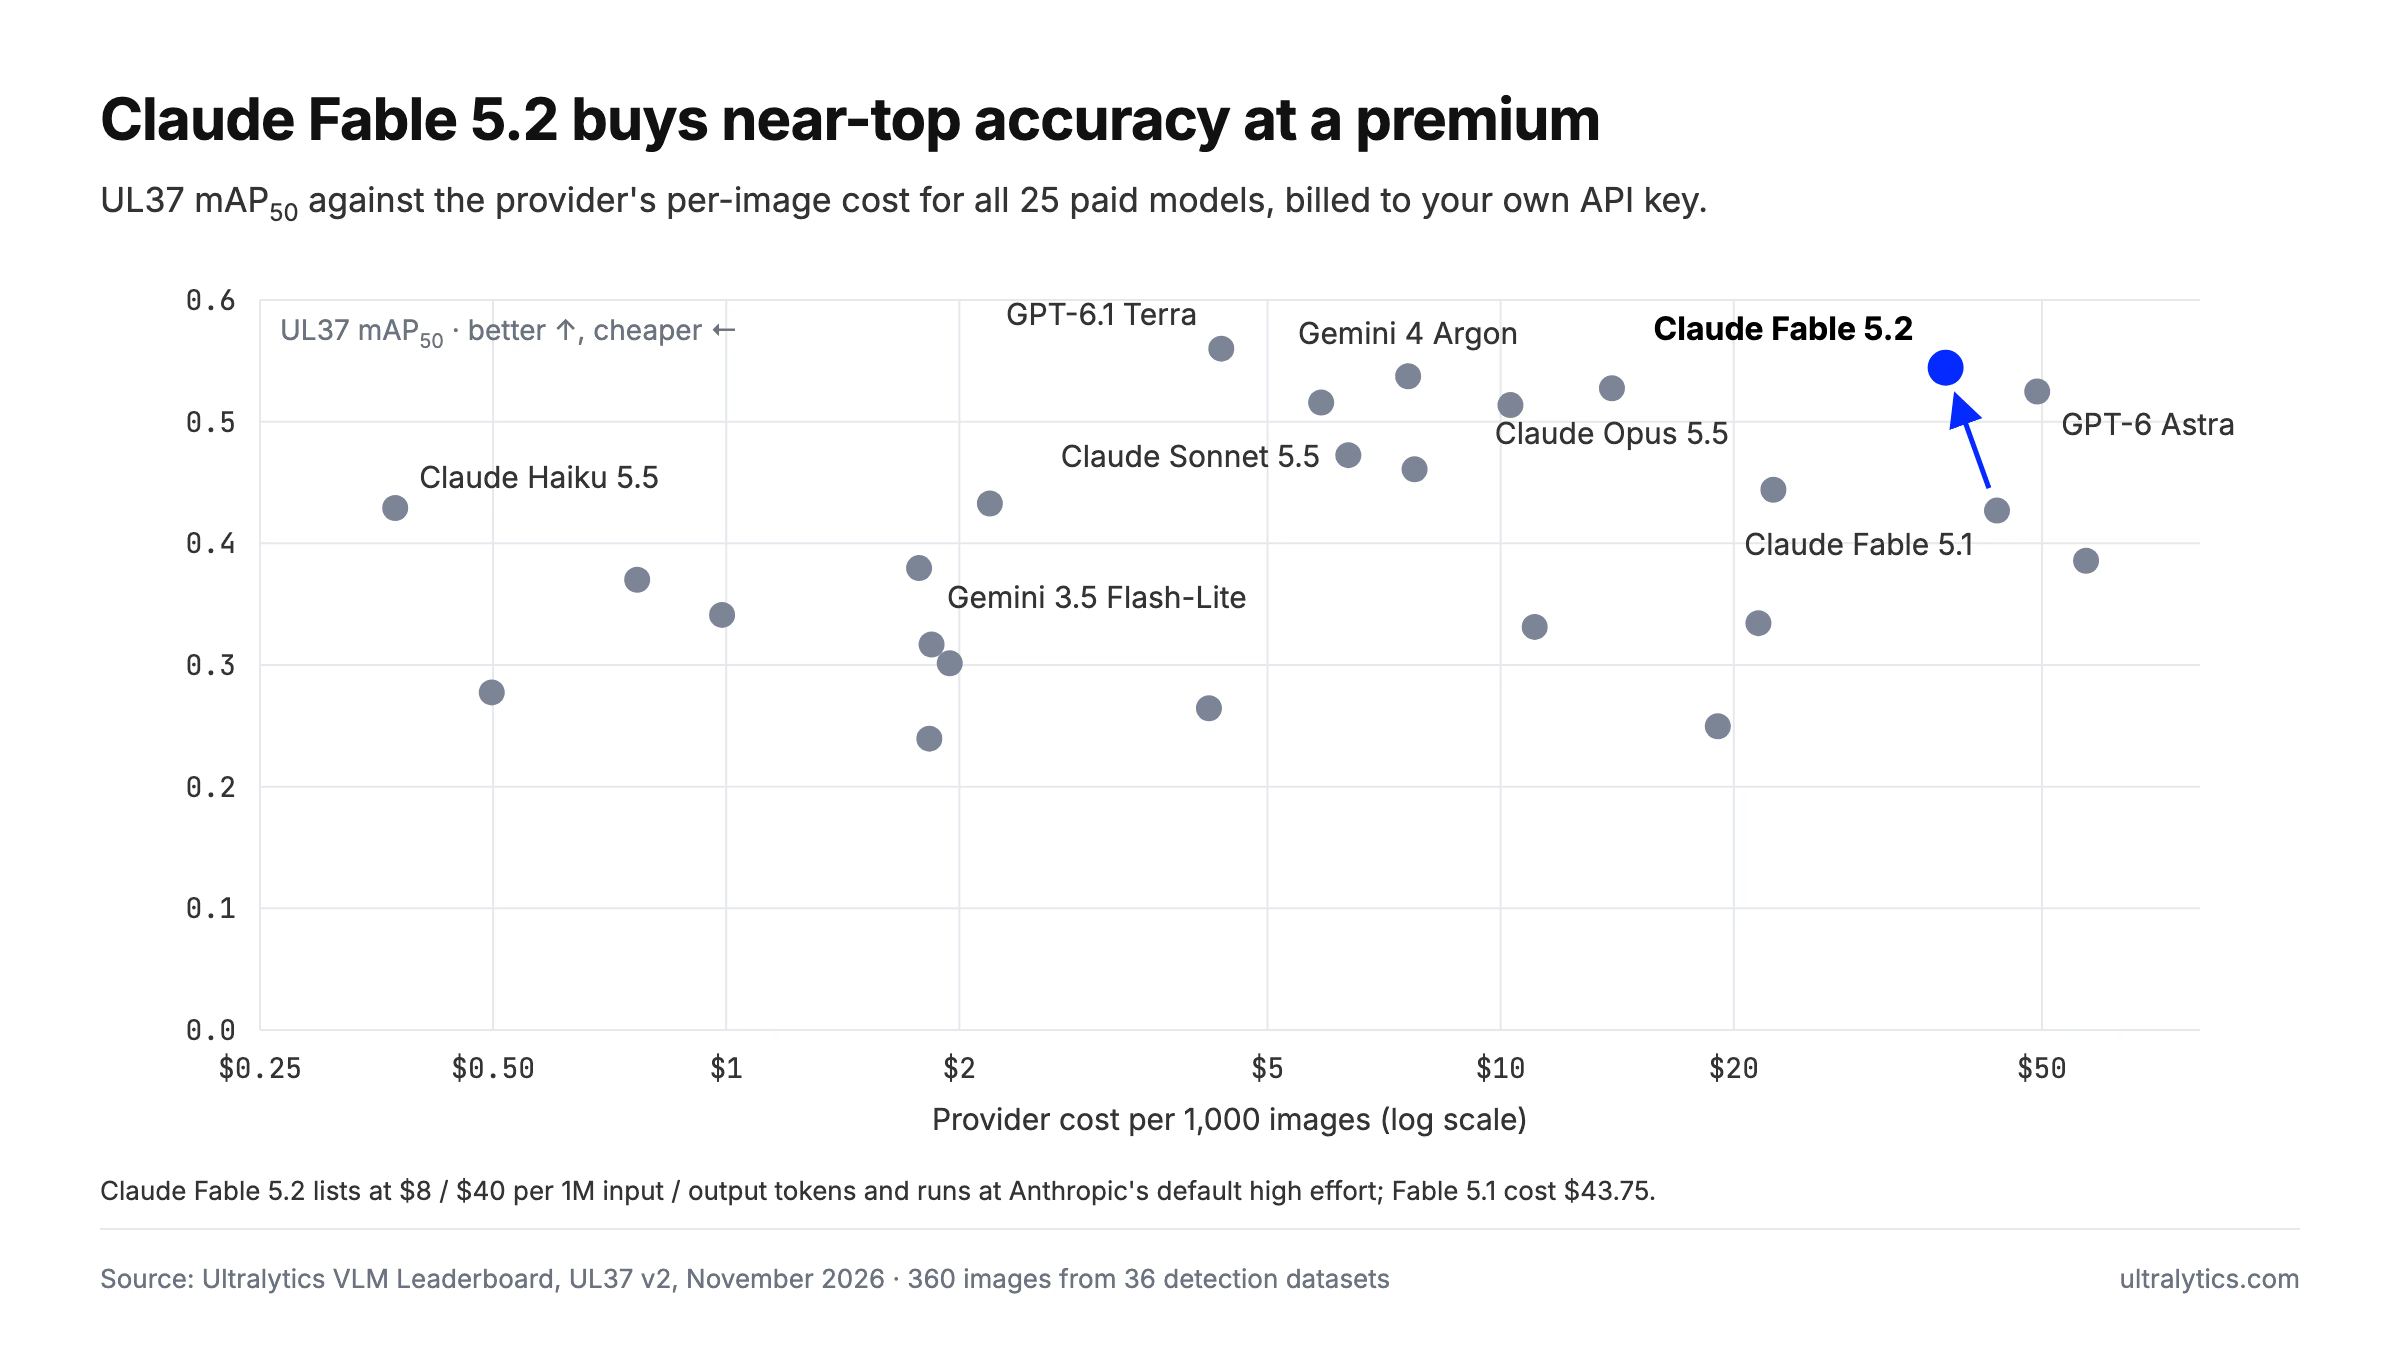
mAP50 en UL37 frente al coste del proveedor por cada 1.000 imágenes para los 25 modelos de pago, precios de lista, 10 de noviembre de 2026.
Es más de ocho veces el coste de Terra, que cuesta 4,36 $ y obtiene solo 0.016 menos de mAP50. Fable 5.2 solo compensa su precio cuando la precisión de sus cuadros importa más que el presupuesto. Si te preocupa el coste, Claude Haiku 5.5 obtiene 0.429 por 0,37 $, y los modelos alojados de pesos abiertos no necesitan clave de API.
Cómo ejecutar el autoetiquetado de Claude Fable 5.2 en tu conjunto de datos#
Fable 5.2 es un modelo guiado por clases para conjuntos de datos de detección con entre 1 y 200 clases. Devuelve cuadros para los nombres de clase de tu propio conjunto de datos y puedes revisarlos antes de guardarlos.
- Crea una clave en la página de claves de API de Claude.
- Añádela en Settings > API Keys, dentro del espacio de trabajo de Platform que contiene tu conjunto de datos. Anthropic te factura directamente y Ultralytics no aplica ningún recargo a los tokens. Consulta los detalles en la documentación de claves del proveedor.
- En el editor de anotaciones, cambia al modo Smart y elige Claude Fable 5.2 en Anthropic. Pulsa Predict o
Ppara etiquetar la imagen actual. - Para etiquetar todas las imágenes sin etiquetar, elige More actions > Batch Annotation en la página del conjunto de datos. Platform guarda primero una versión del conjunto de datos para que puedas revertir los cambios.
- Si se rechaza alguna imagen, vuelve a ejecutar Batch Annotation con otro modelo, como Gemini 4 Argon o un modelo alojado de pesos abiertos. Solo etiquetará las imágenes que sigan sin etiquetar.
- Revisa los cuadros, guárdalos y entrena un modelo YOLO26 con el resultado en el mismo espacio de trabajo.
Antes de confirmar un conjunto de datos grande, abre la página del modelo. Reproduce los cuadros guardados de Fable 5.2 en todos los conjuntos de datos de referencia, junto a los cuadros esperados, y muestra su puntuación en cada uno.
Página del modelo Claude Fable 5.2
Para saber más sobre cómo encajan estos modelos en el editor, consulta cómo utiliza Ultralytics Platform la IA para automatizar las anotaciones y por qué la revisión con intervención humana sigue siendo esencial.
Quién debería usar Claude Fable 5.2#
Elige Claude Fable 5.2 cuando la precisión de los cuadros sea lo más importante y el presupuesto, lo menos: en deportes, comercio minorista, agricultura y escenas cotidianas, está a la cabeza o cerca de ella entre todos los modelos que hemos probado. Su ventaja en mAP50-95 lo convierte en un excelente primer borrador para conjuntos de datos con los que quieras entrenar usando umbrales de IoU estrictos.
No lo uses con datos de seguridad, defensa e inspección. El filtro de Anthropic rechazó todas las imágenes de nuestro conjunto de datos de radiografías de seguridad, incluso las que solo mostraban un teléfono, y nada en Platform puede evitar ese bloqueo. Para esos proyectos, usa Gemini 4 Argon o un modelo de pesos abiertos que controles. Para la mayoría de las demás tareas de etiquetado, GPT-6.1 Terra o Claude Opus 5.5 te darán cuadros prácticamente iguales por una fracción del precio.
Preguntas frecuentes
La API de Anthropic bloquea las solicitudes de anotación de radiografías de seguridad que incluyen clases de explosivos. En las 10 imágenes de IEDXray de nuestra evaluación, devolvió un motivo de detención
refusalcon la categoríageneral_harmsy citó «restricciones sobre contenido relacionado con el desarrollo de explosivos de alto rendimiento», incluso en imágenes que solo mostraban un teléfono o un portátil corrientes. Volver a pulsar Predict no sirve; usa otro modelo para esas imágenes.Ningún otro modelo de nuestra clasificación rechazó imágenes de IEDXray; esto incluye los 19 modelos que alojamos, todos los modelos de laboratorios chinos y los propios Claude Opus 5.5, Sonnet 5.5 y Haiku 5.5 de Anthropic. Gemini 4 Argon obtuvo la puntuación más alta, con 0.30 mAP50, seguido del modelo de pesos abiertos Moondream 3.1, con 0.27. La precisión en radiografías de seguridad es baja en todos los modelos, así que revisa cada cuadro.
Sí. Obtiene 0.544 mAP50 en 36 conjuntos de datos de detección reales, queda segundo entre 44 modelos y ocupa el primer puesto en la métrica más estricta mAP50-95, con 0.347. Destaca en comercio minorista, deportes, agricultura y escenas cotidianas, y flojea en radiografías de seguridad, imágenes médicas y defectos en placas de circuitos.
Obtiene 0.544 mAP50, frente a los 0.427 de Fable 5.1, y gana en 31 de 36 conjuntos de datos, aunque cuesta 37,55 $ por cada 1.000 imágenes en lugar de 43,75 $. Es más lento: tarda 4,6 s por imagen frente a 2,6 s; además, rechazó las 10 radiografías de seguridad, mientras que Fable 5.1 rechazó una.
Unos 37,55 $ en cargos de Anthropic, según el uso de tokens declarado por el proveedor y las tarifas de 8 $ por millón de tokens de entrada y 40 $ por millón de tokens de salida. Batch Annotation de Ultralytics Platform añade una tarifa de procesamiento de 1,00 $ por cada 1.000 imágenes. Pagas directamente a Anthropic con tu propia clave de API.
Terra obtiene una puntuación más alta en mAP50, 0.560 frente a 0.544, y cuesta aproximadamente una octava parte. Fable 5.2 genera cuadros ligeramente más ajustados: alcanza 0.347 mAP50-95, frente a 0.345 de Terra, y gana en 18 conjuntos de datos, frente a los 16 de Terra. Para la mayoría de los equipos, Terra es la mejor opción predeterminada; Fable 5.2 tiene sentido cuando la precisión de los cuadros importa más que el coste.
Escrito por
Fundador y director ejecutivo · Ultralytics
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









