GPT-6.1 Terra se coloca en el n.º 1 en anotación automática y supera a los modelos insignia de la propia OpenAI
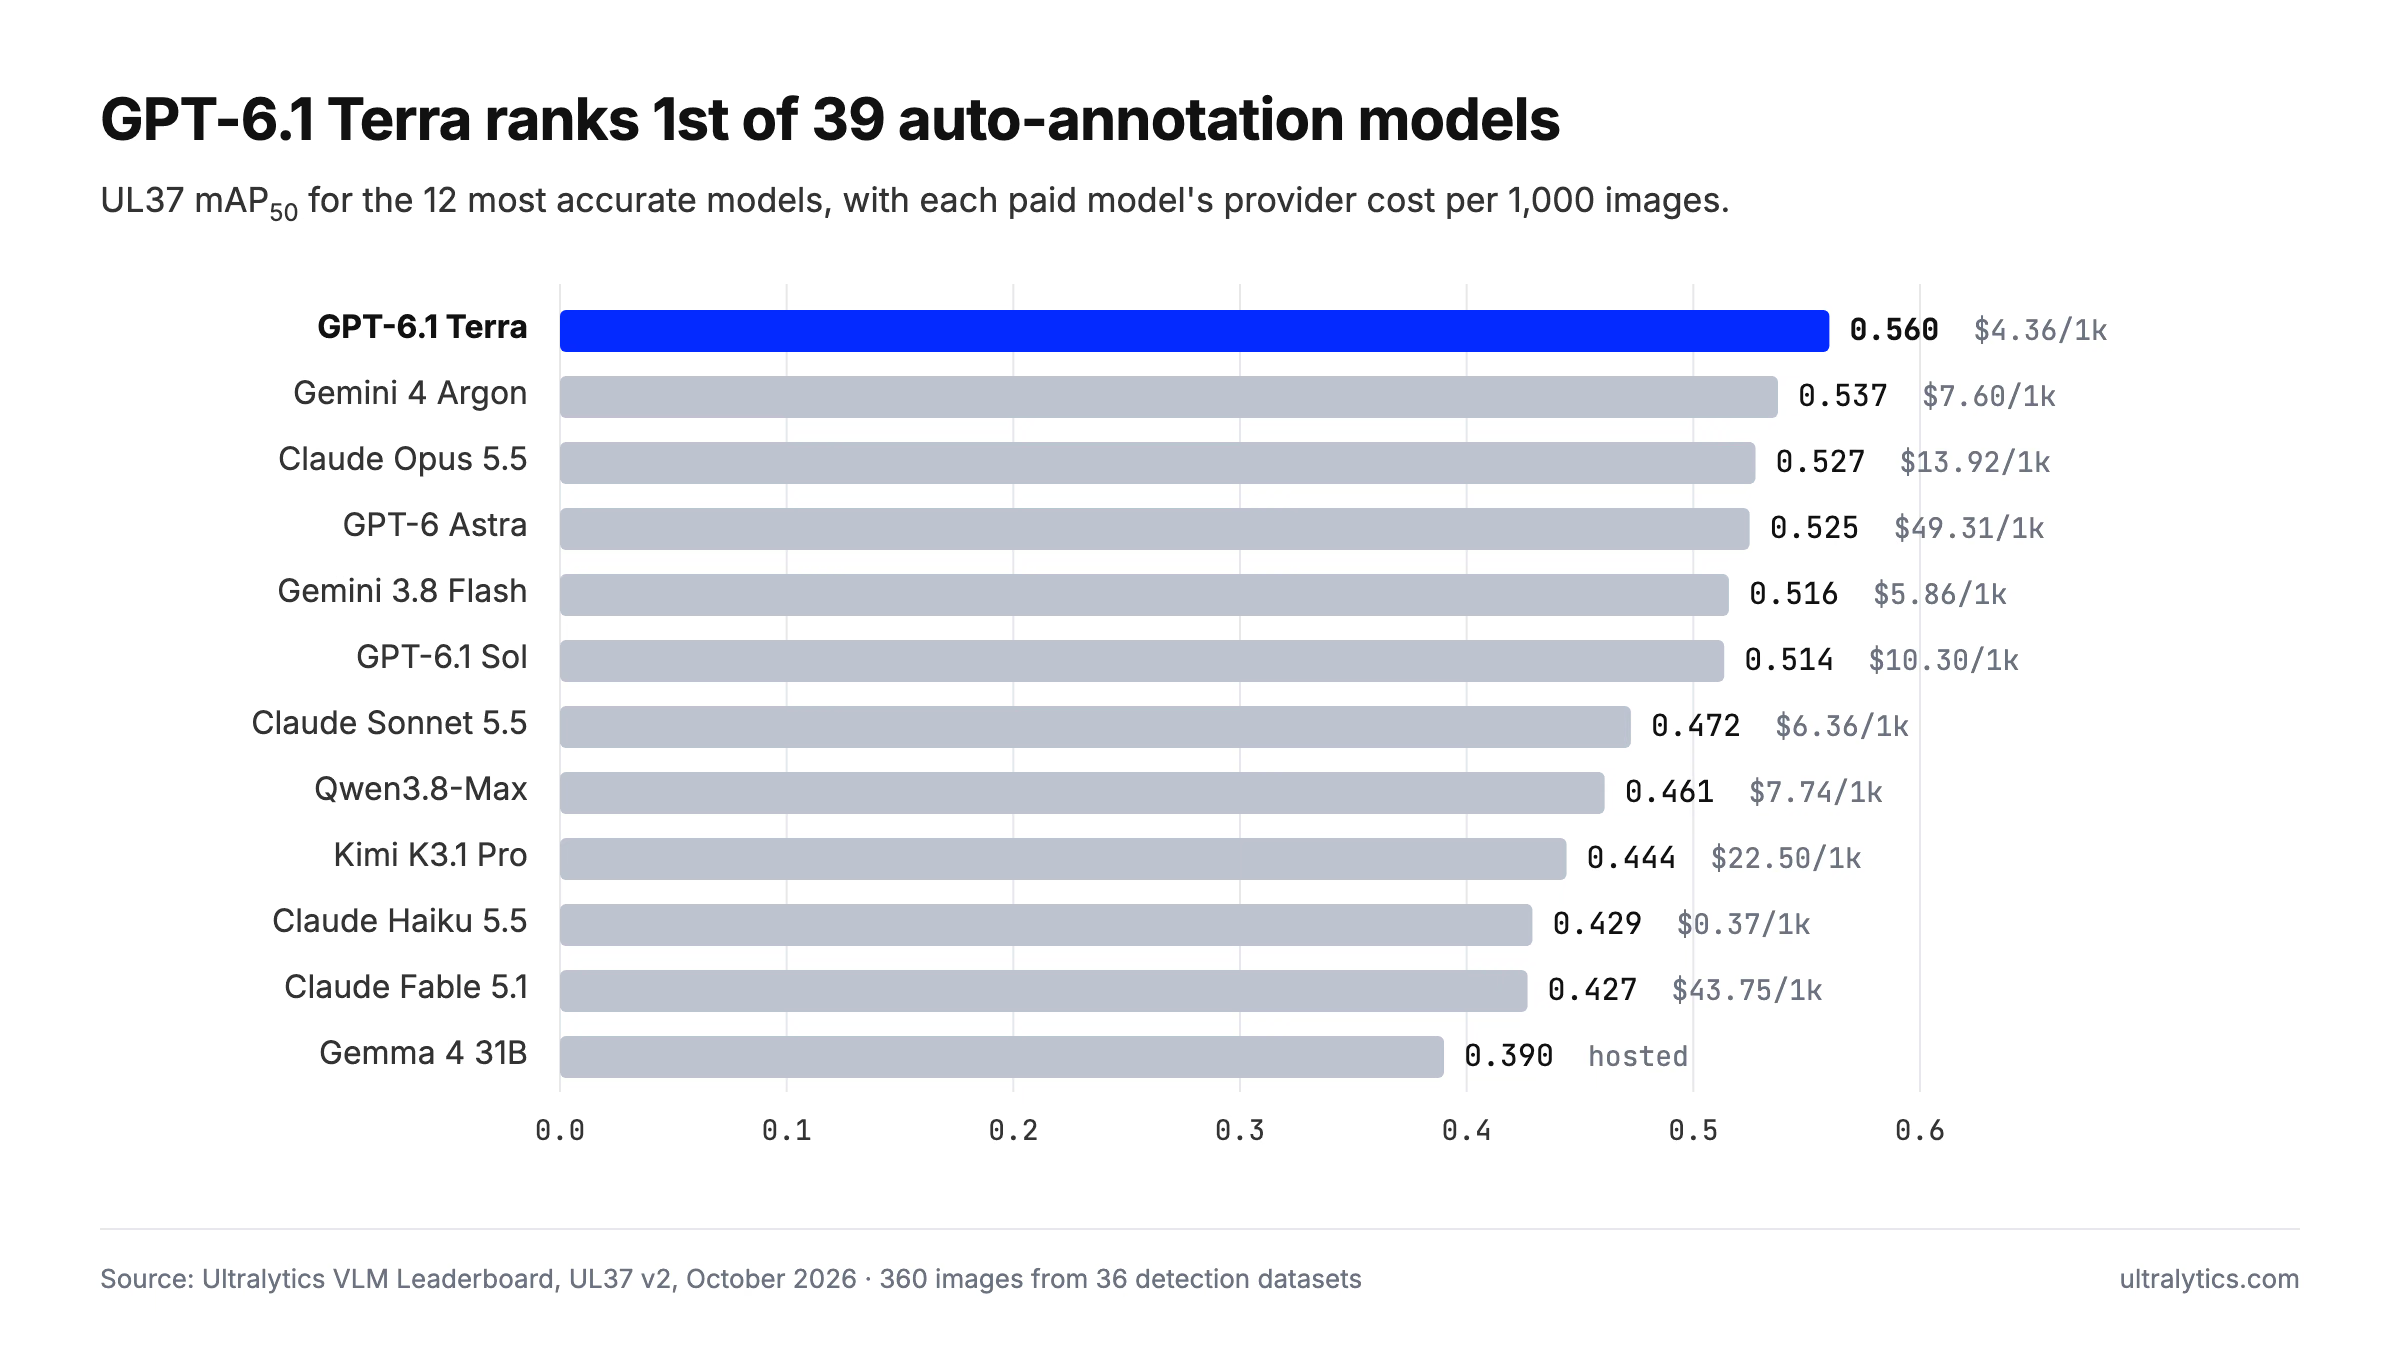
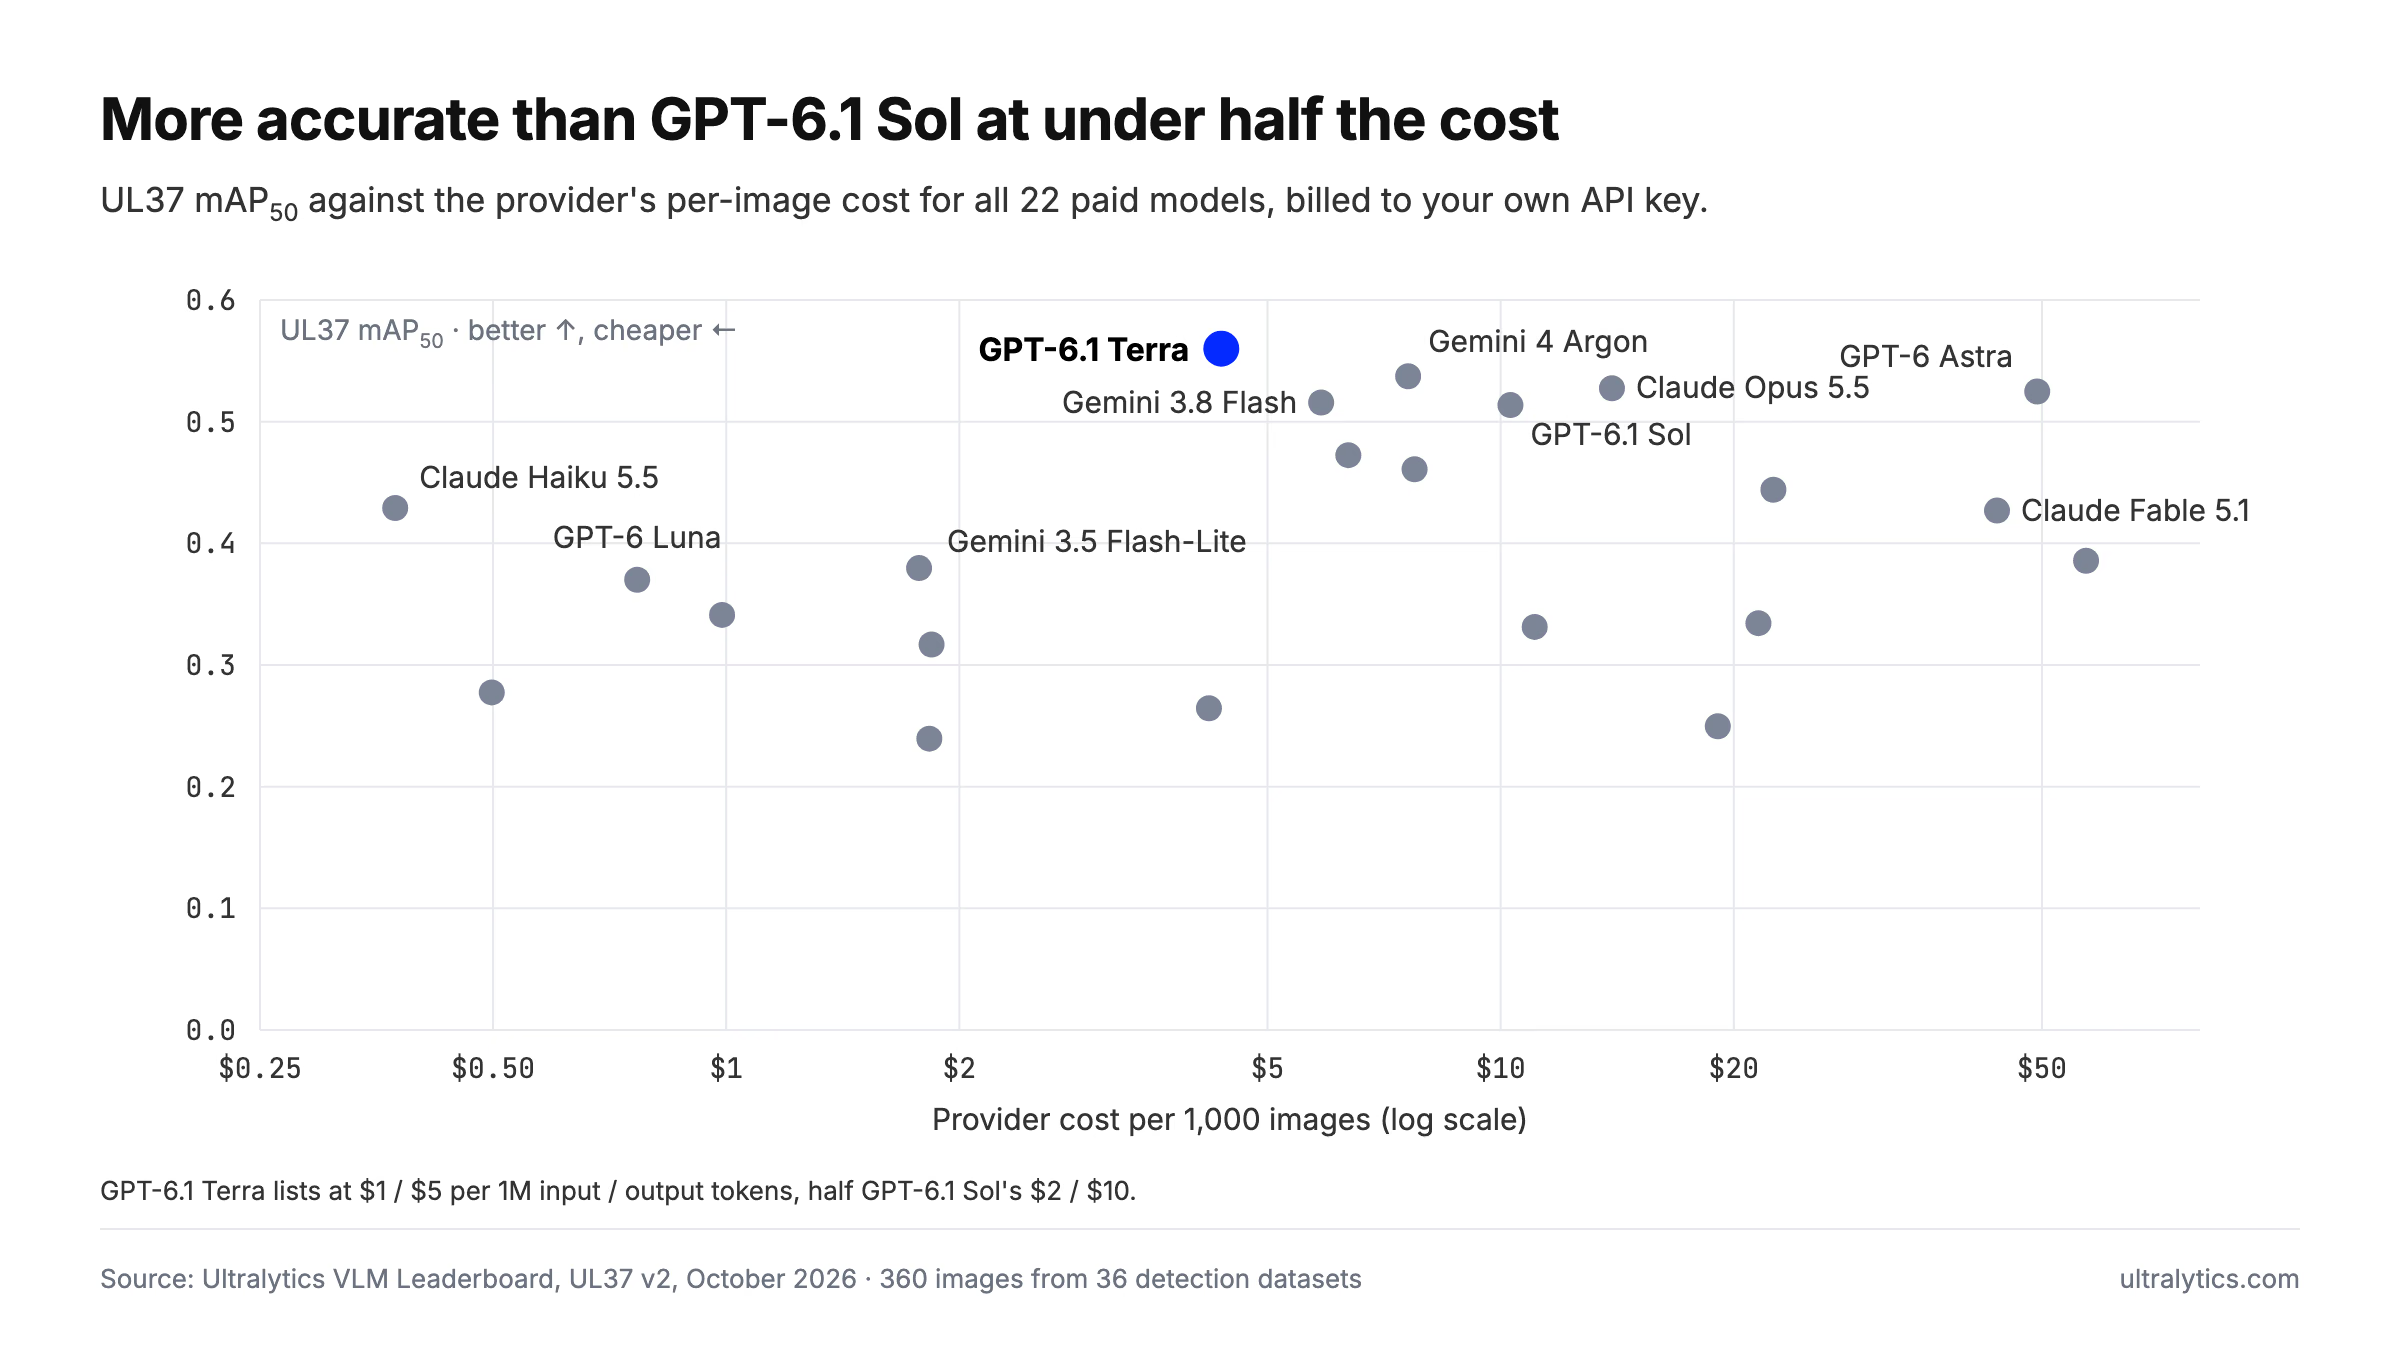
La anotación automática con GPT-6.1 Terra supera a 39 modelos en nuestra clasificación VLM: 0.560 mAP50 por 4,36 $ por cada 1.000 imágenes, por delante de GPT-6.1 Sol y Gemini 4 Argon.
Los materiales de lanzamiento de OpenAI afirman que GPT-6.1 Terra casi iguala a sus hermanos mayores en razonamiento visual. Cuando le pedimos que dibujara cajas delimitadoras, «casi» resultó ser la palabra equivocada.
El 26 de octubre de 2026, el día que OpenAI lo lanzó, probamos la anotación automática con GPT-6.1 Terra en UL37, nuestro benchmark de detección con 36 conjuntos de datos. Obtuvo 0.560 mAP50, el mejor resultado de los 39 modelos de nuestra clasificación VLM. El modelo de precio medio de OpenAI quedó por delante de GPT-6.1 Sol, del modelo insignia GPT-6 Astra y de Gemini 4 Argon, que había ocupado el primer puesto hasta esta semana.
Lo consiguió por 4,36 $ por cada 1.000 imágenes, a 5,1 segundos por imagen y sin una sola solicitud fallida. Ya puedes usarlo en Ultralytics Platform. A continuación te contamos en qué destaca, dónde tropieza y cómo decidir si encaja en tu flujo de trabajo de etiquetado.
GPT-6.1 Terra ocupa el primer puesto en UL37#
UL37 mide hasta qué punto coinciden las cajas de un modelo con las etiquetas humanas en 360 imágenes: 10 de cada uno de 36 conjuntos de datos reales de detección de objetos que abarcan escáneres médicos, imágenes aéreas, estanterías de comercios, deportes, documentos, placas de circuitos y mucho más. Cada imagen pasa por el mismo flujo de producción que usan los usuarios de Platform, con los nombres de clase propios del conjunto de datos y SAM 3.1 ajustando cada caja. La metodología es pública.
Este es el resumen de resultados de Terra:
- mAP50: 0.560, n.º 1 de 39
- mAP50-95: 0.345, también n.º 1, lo que significa que sus cajas se ajustan con precisión y no solo de forma aproximada
- Precisión y exhaustividad: 0.646 y 0.613
- Coste del proveedor: 4,36 $ por cada 1.000 imágenes
- Tiempo mediano por imagen: 5,1 s
- Solicitudes fallidas: ninguna
Seis modelos superan 0.51 en UL37, entre ellos Claude Opus 5.5, que ocupa el tercer puesto. Terra es el más preciso de los seis y también el más barato.
El resultado no se debió a ningún ajuste complicado. Terra funciona con el nivel de razonamiento predeterminado de OpenAI, que su documentación del modelo indica como medio. Recibe la misma solicitud que cualquier otro modelo de OpenAI en Platform, con coordenadas de las cajas en una cuadrícula de 0–1000. Lo integramos y se colocó directamente en cabeza.
Un modelo de precio medio que supera a los modelos insignia de OpenAI#
OpenAI presenta GPT-6.1 Terra como el modelo rápido y eficiente de gama media de su catálogo. Según la cobertura del lanzamiento de The Decoder y BleepingComputer, sucede a GPT-5.6 Terra y está pensado para usar el ordenador, el razonamiento visual, la programación y las tareas cotidianas. Está disponible en la API como gpt-6.1-terra y en ChatGPT Work y Codex para usuarios Plus, Pro, Enterprise y Edu. OpenAI lo describe en su documentación como «un modelo rápido y eficiente para el razonamiento visual, el uso preciso del ordenador y una redacción clara y natural», con entrada de texto e imágenes y una ventana de contexto de 1.050.000 tokens.
El precio es de 1 $ por millón de tokens de entrada y 5 $ por millón de tokens de salida, con entrada en caché a 0,05 $. Esto es la mitad de los 2 $ y 10 $ de GPT-6.1 Sol, y una décima parte de los 10 $ y 50 $ de GPT-6 Astra, según las páginas de OpenAI sobre GPT-6.1 Sol y GPT-6 Astra.
Los benchmarks de lanzamiento de OpenAI presentan Terra como un modelo cercano a sus hermanos mayores, no superior a ellos. En MMMU-Pro, una prueba de razonamiento visual, OpenAI informa de que Terra casi iguala a Astra y Sol. En Terminal-Bench 4.0, informa de un 50,3 %, frente al 21,5 % de GPT-5.6 Terra. Y sigue recomendando Sol o Astra para las tareas de programación más difíciles.
Sobre el papel, Terra es la opción intermedia. En nuestro benchmark, es el mejor detector de OpenAI.
| Modelo de OpenAI | mAP50 de UL37 | Coste por cada 1.000 imágenes | Tiempo mediano por imagen |
|---|---|---|---|
| GPT-6 Luna | 0.370 | $0.77 | 11.9 s |
| GPT-6.1 Terra | 0.560 | $4.36 | 5,1 s |
| GPT-6.1 Sol | 0.514 | $10.30 | 10.5 s |
| GPT-6 Astra | 0.525 | $49.31 | 11.6 s |
Terra cuesta menos de la mitad por imagen que GPT-6.1 Sol y menos de una décima parte que GPT-6 Astra. También responde aproximadamente el doble de rápido que cualquiera de los dos. En una comparación directa, supera a Sol en 22 de los 36 conjuntos de datos.
OpenAI afirma que Terra completa las tareas más de tres veces más rápido que Sol y Astra, una afirmación referida a cargas de trabajo de agentes. La anotación es una tarea distinta y, en ella, medimos una velocidad aproximadamente 2 veces mayor que la de Sol, lo que se nota cuando etiquetas miles de imágenes.
La ventaja de Terra sobre Sol está en la precisión#
Los dos modelos detectan una proporción similar de los objetos etiquetados. La exhaustividad de Terra es de 0.613 y la de Sol, de 0.618. La diferencia aparece en la precisión: 0.646 para Terra frente a 0.551 para Sol. Una proporción mucho mayor de las cajas de Terra señala un objeto real con la etiqueta correcta.
SKU110K permite ver claramente la diferencia. Sus imágenes muestran estanterías de supermercado abarrotadas de productos de un extremo a otro, todos de una sola clase. Ambos modelos alcanzan una exhaustividad similar, 0.73 para Terra y 0.77 para Sol. Sin embargo, la precisión de Sol en esas estanterías es de 0.49, mientras que la de Terra es de 0.79. Aproximadamente la mitad de las cajas de Sol son falsas alarmas, frente a una de cada cinco en el caso de Terra. El 0.62 mAP50 de Terra en SKU110K es la puntuación más alta que ha conseguido cualquier modelo.
Esto es importante para el etiquetado de datos, porque los errores no cuestan todos lo mismo. Si se pasa por alto un producto, hay que dibujar una caja. Una caja falsa obliga a localizarla entre decenas de cajas correctas y eliminarla. Con menos falsas alarmas, los revisores reciben un primer borrador más limpio.
La imagen médica es el punto fuerte más destacado de GPT-6.1 Terra#
El patrón más distintivo de los resultados de Terra es el médico. UL37 incluye ocho conjuntos de datos médicos y Terra promedia 0.505 mAP50 en ellos, el n.º 1 de 39. Los siguientes mejores son Gemini 3.8 Flash con 0.387 y Gemini 4 Argon con 0.379. Ningún otro modelo de la clasificación aventaja tanto a los demás en ningún otro ámbito.
Así puntúa en los ocho conjuntos de datos, frente al mejor de los otros 38 modelos en cada uno:
| Conjunto de datos | GPT-6.1 Terra | Mejor otro modelo |
|---|---|---|
| Ecografía de tiroides (TN5000) | 0.94 | Gemini 3.8 Flash, 0.88 |
| Resonancia magnética de tumores cerebrales (Cheng) | 0.90 | Gemma 4 31B, 0.80 |
| Microscopía de células sanguíneas (TXL-PBC) | 0.89 | Gemini 4 Argon, 0.78 |
| Endoscopia de pólipos de colon (Kvasir-SEG) | 0.71 | Empate entre siete modelos, incluido Gemini 4 Argon, 0.81 |
| Radiografía de muñeca pediátrica (GRAZPEDWRI-DX) | 0.27 | GPT-6 Astra, 0.35 |
| Radiografía de tórax para detectar tuberculosis (TBX11K) | 0.14 | GPT-6 Astra, 0.33 |
| Lesiones de retina (DDR) | 0.13 | Claude Opus 5.5, 0.13 |
| Radiografía dental (DENTEX) | 0.06 | Gemini 4 Argon, 0.21 |
Los tres primeros resultados explican la ventaja, y ninguno consiste simplemente en encontrar el punto adecuado. En TN5000, cada caja también incluye la etiqueta del conjunto de datos para indicar si el nódulo es benigno o maligno, exactamente el tipo de evaluación que debe confirmar un profesional clínico. Gemini 4 Argon obtiene 0.29 y GPT-6.1 Sol, 0.53. Las clases de la resonancia magnética cerebral son meningioma, glioma y tumor hipofisario; Sol obtiene 0.52. El conjunto de células sanguíneas pide a Terra que clasifique glóbulos blancos, glóbulos rojos y plaquetas.
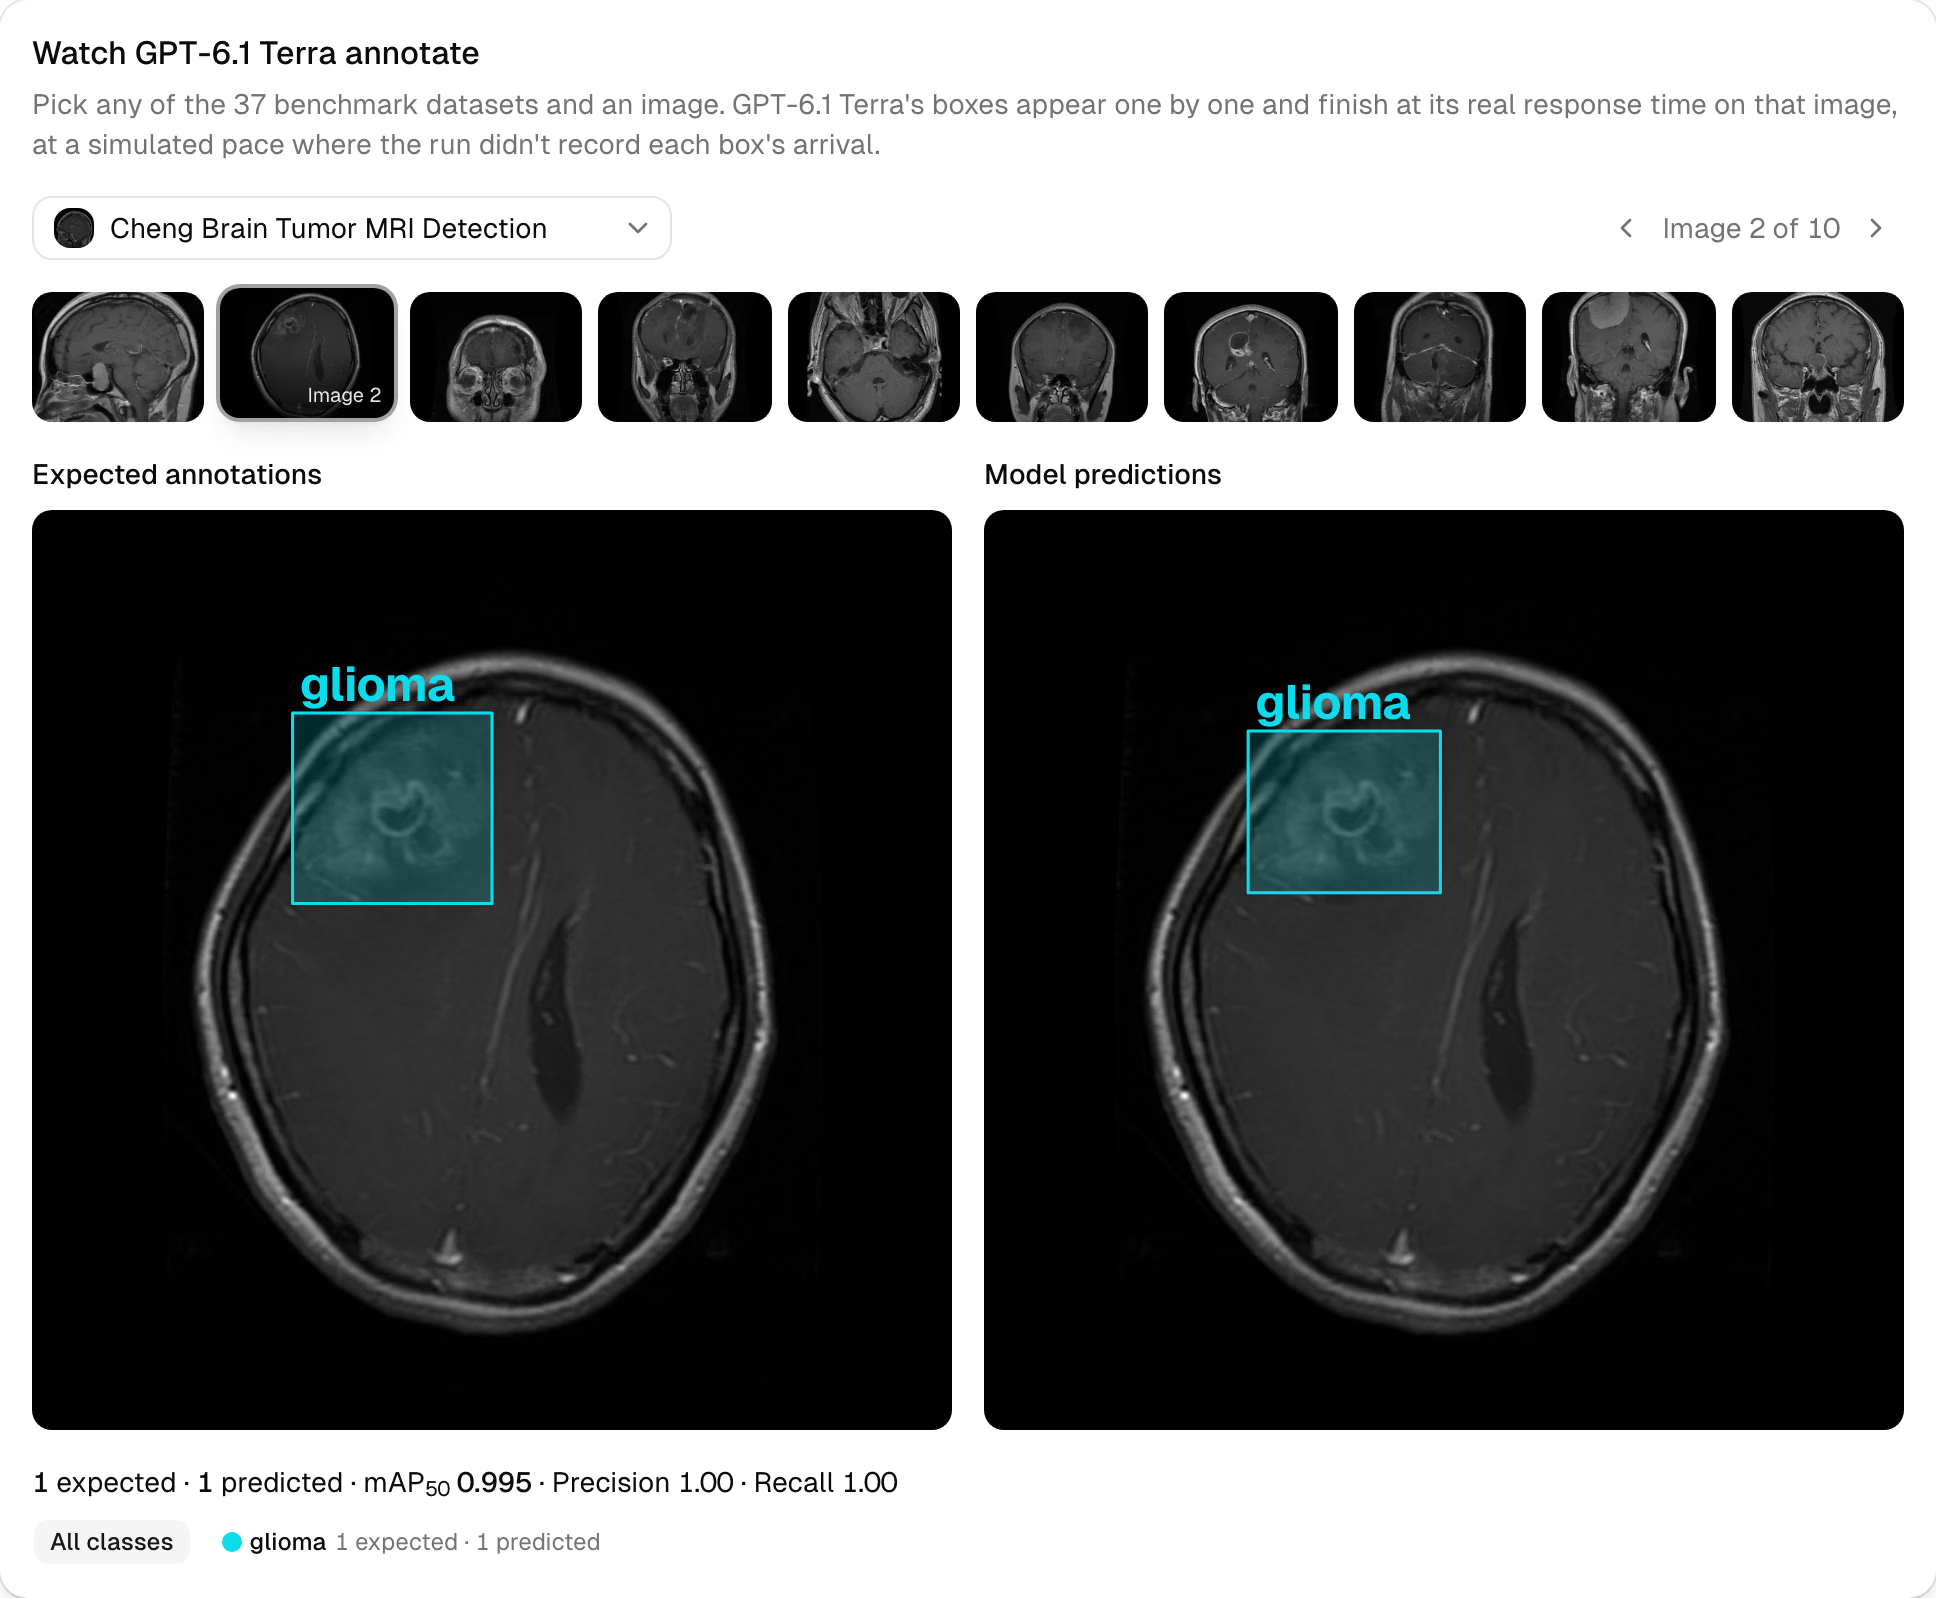
La reproducción anterior, tomada de la página del modelo de Terra, muestra un acierto típico: un glioma en una resonancia magnética cerebral y una caja de Terra colocada y etiquetada para coincidir con la anotación esperada.
Conviene tener presentes dos salvedades al interpretar estas cifras. En primer lugar, cada conjunto de datos aporta 10 imágenes, así que la puntuación de un solo conjunto es un indicio que investigar, no una conclusión definitiva. En segundo lugar, nada de esto sirve para diagnosticar. Para un equipo de análisis de imágenes médicas, Terra es una forma rápida de preparar borradores de cajas en ecografías, resonancias magnéticas e imágenes de microscopía para que después los expertos clínicos las revisen, corrijan y aprueben. Esa revisión con intervención humana es el objetivo del flujo de trabajo, no un extra opcional.
En qué se queda corto GPT-6.1 Terra: radiografías y placas de circuitos#
La parte inferior de esa tabla presenta un patrón claro. En todos los conjuntos de datos de radiografías de UL37, sean médicos o no, otro modelo obtiene mejores resultados. Terra queda por detrás del líder en radiografías pediátricas de muñeca, de tórax y dentales, y en las radiografías de seguridad el resultado es aún peor: 0.00 en IEDXray, donde Gemini 4 Argon alcanza 0.30.
IEDXray es el fallo más llamativo. Sus escaneos muestran portátiles, teléfonos, buscapersonas, baterías y dispositivos improvisados, y Terra no produjo ninguna caja correcta en ninguna de esas imágenes.
Las placas de circuitos son el otro punto ciego. Terra promedia 0.13 en nuestros conjuntos de datos de PCB industriales, mientras que GPT-6.1 Sol llega a 0.39. En DeepPCB, que incluye defectos de placas sin componentes, como circuitos abiertos, cortocircuitos, mordeduras de ratón y rebabas, Terra obtiene 0.03 frente al 0.39 de Sol. Para inspeccionar datos de PCB, Sol es la mejor opción de OpenAI.
Antes de etiquetar un conjunto de datos grande en cualquiera de estos ámbitos, abre la página del modelo GPT-6.1 Terra. Reproduce las cajas registradas por Terra en los 36 conjuntos de datos del benchmark y en COCO, junto a las cajas esperadas, y muestra la puntuación del modelo en cada uno.
GPT-6.1 Terra frente a Gemini 4 Argon: una competición más reñida de lo que indica la clasificación#
Gemini 4 Argon encabezaba la clasificación hasta la llegada de Terra, y ambos están muy igualados. Terra obtiene mejores resultados en 19 conjuntos de datos, Argon en 16 y empatan en uno.
Gran parte de la ventaja de 0.023 de Terra procede de un solo conjunto de datos. En la ecografía de tiroides TN5000, Terra obtiene 0.94 y Argon, 0.29. Si excluimos ese conjunto, las medias son 0.549 para Terra y 0.544 para Argon: prácticamente igualadas. El primer puesto de Terra es real y se debe en gran medida a la imagen médica.
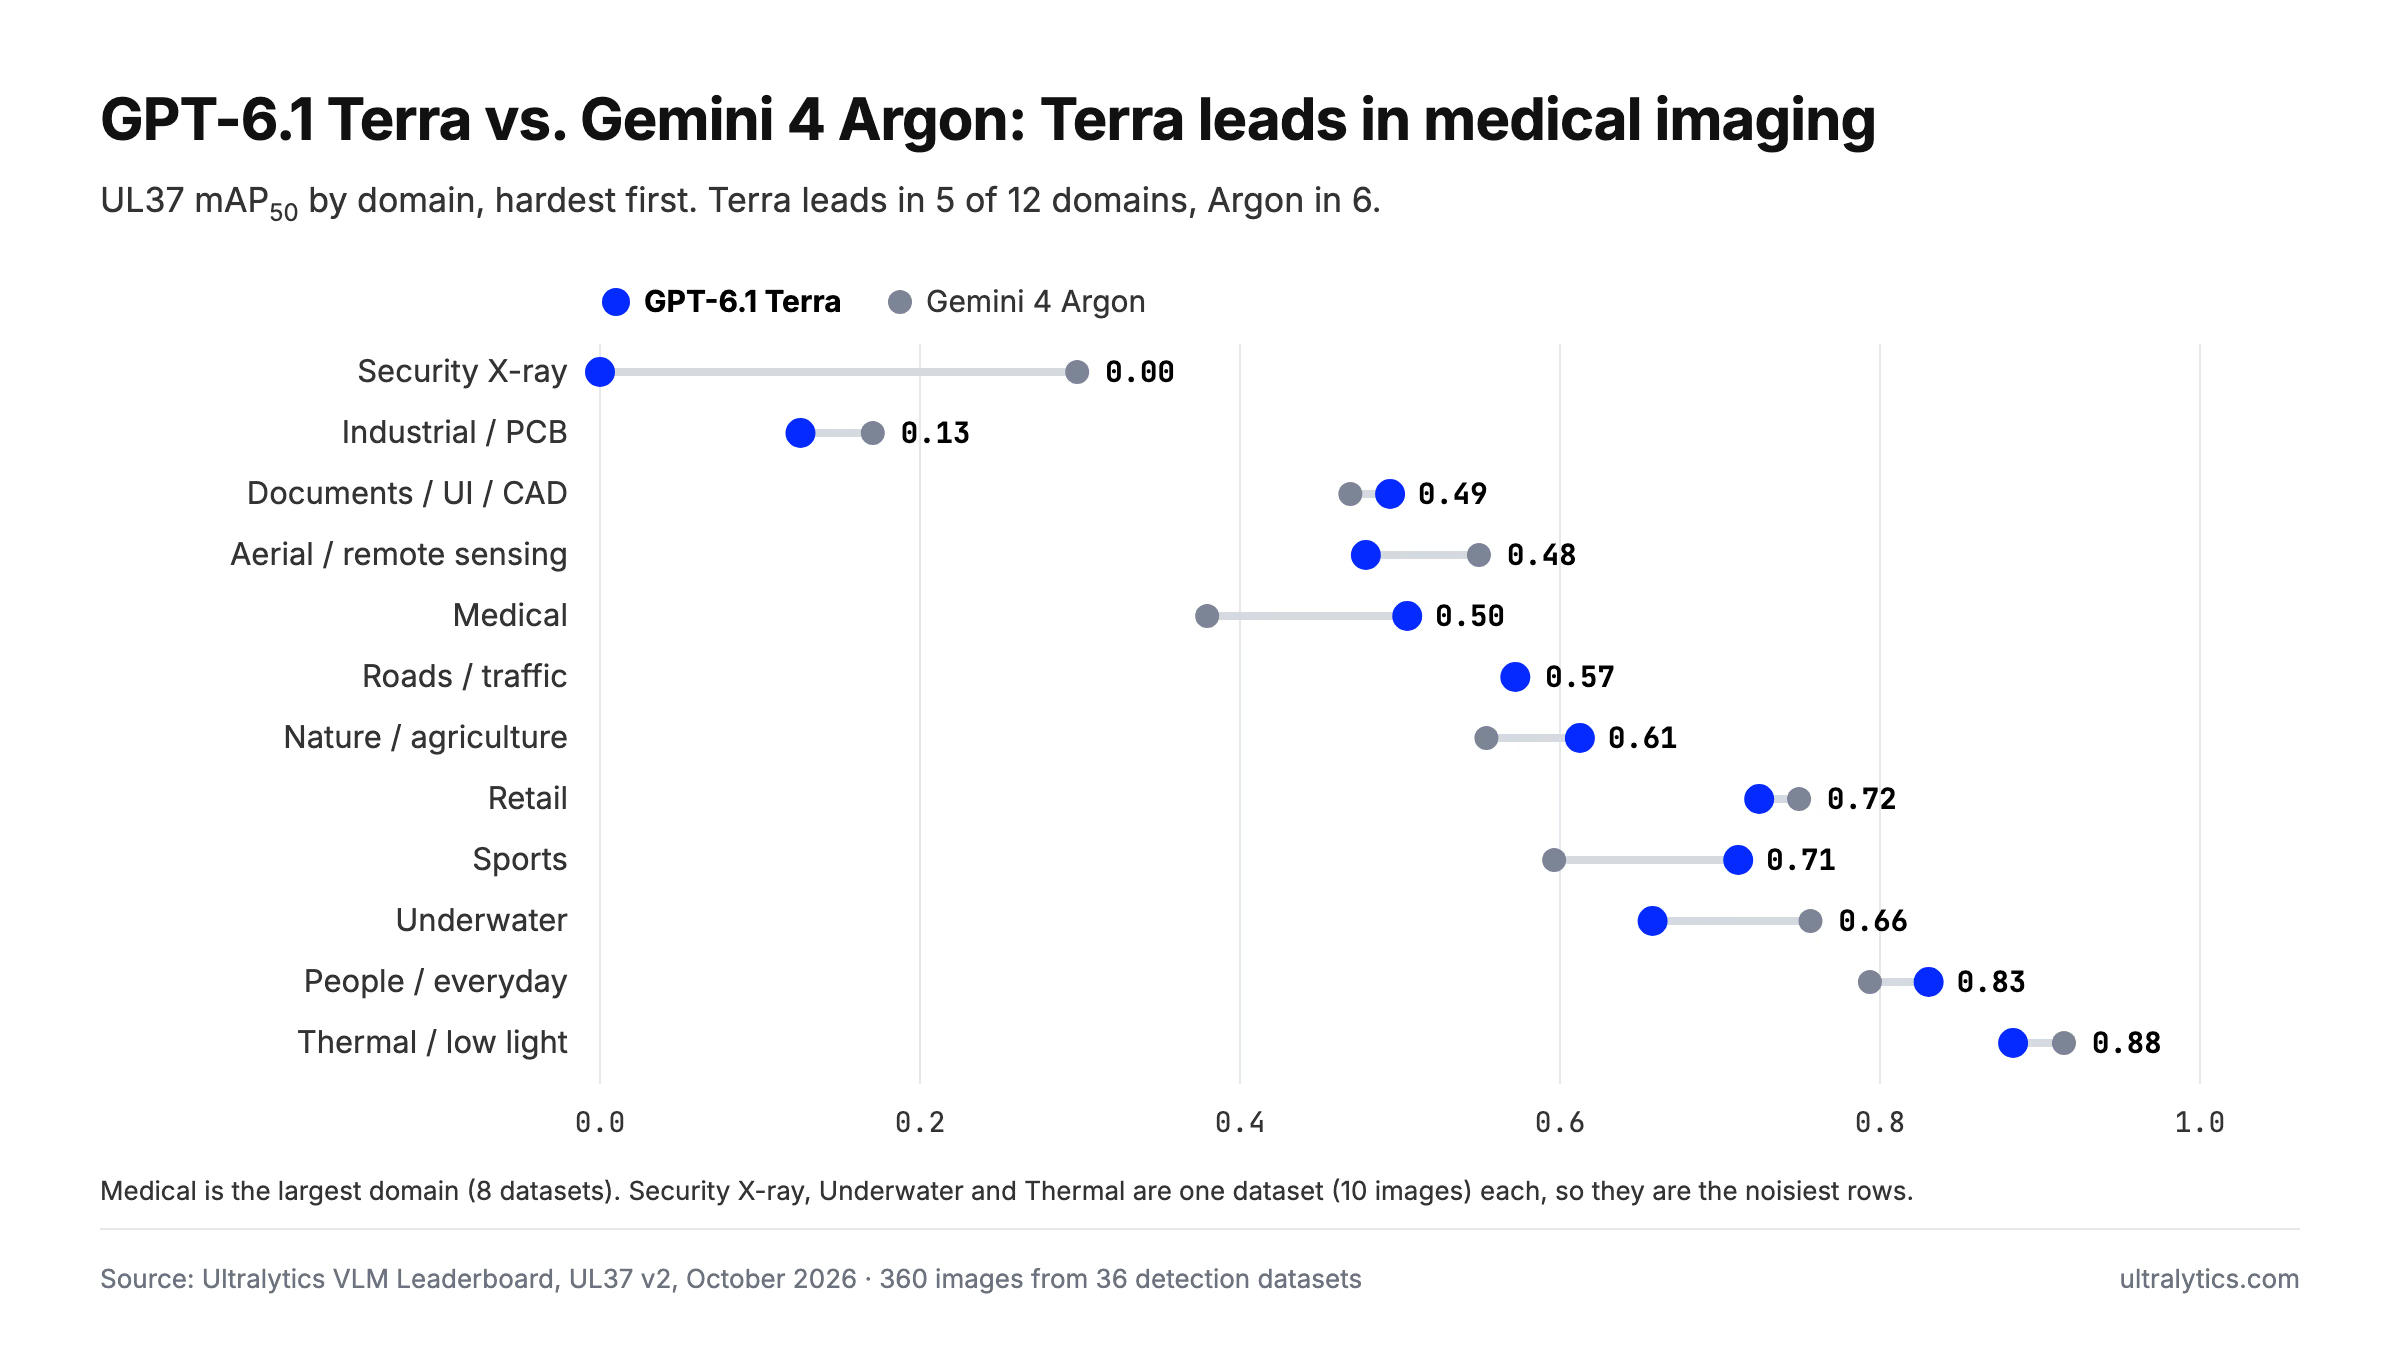
Por ámbitos, Terra lidera en cinco y ocupa el primer puesto entre los 39 modelos en dos: medicina y documentos, interfaz de usuario y CAD. Argon lidera en seis y conserva el primer puesto en las categorías de imágenes aéreas, submarinas y térmicas. En carreteras y tráfico hay empate.
Además, los dos cometen errores de distinto tipo. Argon es ligeramente más preciso, con 0.667 frente a 0.646, mientras que Terra detecta más objetos, con una exhaustividad de 0.613 frente a 0.585. Terra cuesta 4,36 $ por cada 1.000 imágenes, frente a los 7,60 $ de Argon con los precios de lanzamiento de Google. Argon es algo más rápido: 4,6 s por imagen.
La división práctica es sencilla: elige Terra para imágenes médicas, documentos y deportes. Elige Argon para imágenes aéreas, submarinas, térmicas y de seguridad. Nuestros resultados de anotación automática con Gemini 4 Argon cuentan su parte de la historia.
Cuánto cuesta un lote de GPT-6.1 Terra#
Los 4,36 $ por cada 1.000 imágenes corresponden al coste del proveedor, calculado a partir del uso de tokens declarado por OpenAI y de sus precios de tarifa. Una imagen mediana utilizó unos 1.300 tokens de entrada y 370 de salida. Batch Annotation añade una tarifa de procesamiento de Platform de 1,00 $ por cada 1.000 imágenes, así que procesar 1.000 imágenes cuesta unos 5,36 $ en total.
Otros tres detalles de la prueba:
- Ninguna solicitud fallida. Todas las solicitudes de Terra para el benchmark se completaron dentro del límite de 115 segundos de Platform. GPT-6.1 Sol falló en 2 imágenes y GPT-6 Astra, en 4.
- Las cajas sin procesar ya son buenas. Antes del ajuste de SAM 3.1, las cajas de Terra obtienen 0.559 mAP50. El ajuste lo eleva a 0.560, así que el propio modelo hace casi todo el trabajo.
- No hay nada que configurar. Solo necesitó el nivel de razonamiento predeterminado y la solicitud estándar de OpenAI.
Si el presupuesto te importa más que esos últimos puntos de precisión, hay opciones más baratas. Claude Haiku 5.5 obtiene 0.429 por 0,37 $ por cada 1.000 imágenes, y Gemini 3.5 Flash-Lite obtiene 0.380 por 1,77 $. Los modelos alojados, como Qwen3.8 27B, Gemma 4 26B y SAM 3.1 Text, no necesitan ninguna clave de API; tampoco la necesitan tus propios modelos Ultralytics YOLO.
De la clave de OpenAI al conjunto de datos etiquetado#
GPT-6.1 Terra es un modelo guiado por clases para conjuntos de datos de detección con entre 1 y 200 clases. Devuelve cajas delimitadoras con los nombres de clase propios de tu conjunto de datos y tú las revisas antes de guardarlas. Para configurarlo:
- Crea una clave en la página de claves de API de OpenAI.
- Añádela en Settings > API Keys, en el espacio de trabajo de Platform que contiene tu conjunto de datos. OpenAI te factura directamente y Ultralytics no añade ningún recargo a los tokens. Consulta los documentos sobre claves de proveedores para ver los detalles.
- En el editor de anotaciones, cambia al modo Smart y selecciona GPT-6.1 Terra en OpenAI, dentro del selector de modelos.
- Pulsa Predict o
Ppara etiquetar la imagen actual. Prueba con algunas imágenes representativas de tus datos antes de ampliar el proceso. - Cuando te convenza el resultado, ve a la página del conjunto de datos y selecciona More actions > Batch Annotation para etiquetar de una vez todas las imágenes sin etiquetar. Platform guarda primero una versión del conjunto de datos para que puedas volver atrás.
- Revisa las cajas, guárdalas y entrena un modelo Ultralytics YOLO26 con el resultado en el mismo espacio de trabajo. La documentación de entrenamiento explica cómo hacerlo.
Para conocer mejor cómo encajan estos modelos en el editor, consulta cómo usa Ultralytics Platform la IA para automatizar la anotación y nuestra introducción a los modelos de lenguaje y visión.
Quién debería pasarse a GPT-6.1 Terra#
Usa GPT-6.1 Terra como modelo de pago predeterminado para el etiquetado general de detección de objetos. Es el modelo más preciso que hemos evaluado, el más barato de los seis primeros y no falló ninguna solicitud en nuestra prueba.
Es especialmente bueno para preparar primeros borradores de anotación de ecografías, resonancias magnéticas e imágenes de microscopía que después revisarán expertos, así como de estanterías de comercios abarrotadas, donde las cajas falsas se acumulan rápidamente. Para radiografías de cualquier tipo y defectos de PCB, busca otra opción: Gemini 4 Argon, GPT-6 Astra o GPT-6.1 Sol obtienen mejores resultados.
Si ahora pagas por Sol o Astra solo para etiquetar imágenes, cambiarte es sencillo: Terra te ofrece mejores cajas por menos de la mitad del coste de Sol.
Preguntas frecuentes
Sí. En nuestro benchmark UL37, GPT-6.1 Terra obtiene 0.560 mAP50 de media en 36 conjuntos de datos de detección reales, la puntuación más alta de los 39 modelos de la clasificación VLM de Ultralytics. También ocupa el primer puesto con la métrica más exigente mAP50-95, con 0.345. Sus puntos más débiles son las imágenes de rayos X y los defectos de placas de circuitos.
En nuestro benchmark, sí. Terra obtiene 0.560 mAP50 frente al 0.514 de Sol, gana en 22 de los 36 conjuntos de datos y cuesta 4,36 $ por cada 1.000 imágenes frente a 10,30 $, además de funcionar aproximadamente el doble de rápido. Sol sigue siendo la mejor opción de OpenAI para detectar defectos de PCB.
Terra lidera con 0.560 frente a 0.537 mAP50 y cuesta menos por imagen, pero la competición está reñida: Terra gana en 19 conjuntos de datos, Argon en 16 y hay un empate. Sin el conjunto de datos de ecografías de tiroides TN5000, los dos están prácticamente igualados. Elige Terra para imágenes médicas y documentos, y Argon para imágenes aéreas, submarinas, térmicas y radiografías de seguridad.
Unos 4,36 $ en cargos de OpenAI, según el uso de tokens declarado por el proveedor y el precio de lista de 1 $ por millón de tokens de entrada y 5 $ por millón de tokens de salida. La Anotación por lotes en Ultralytics Platform añade una tarifa de procesamiento de 1,00 $ por cada 1.000 imágenes. Pagas directamente a OpenAI con tu propia clave de API.
Es el modelo más potente en nuestros ocho conjuntos de datos médicos, con una media de 0,505 mAP50 y las puntuaciones más altas en ecografías de tiroides, resonancias magnéticas de tumores cerebrales y microscopía de células sanguíneas. Es mucho menos eficaz con radiografías y queda por detrás en endoscopias de pólipos de colon. Úsalo para generar cajas que revisen expertos, nunca como herramienta de diagnóstico.
No. Platform lo ejecuta con el nivel de razonamiento predeterminado de OpenAI, medio, y usa la misma solicitud de cajas que para todos los modelos de OpenAI; después, SAM 3.1 refina cada caja. La solicitud mediana de nuestra evaluación comparativa tardó 5,1 segundos y no hubo ningún fallo.









