Jetson Orin Nano Super frente a Raspberry Pi 5 para la detección de objetos con YOLO26
Inferencia de YOLO26n: 4,57 ms en un Jetson Orin Nano Super (TensorRT FP16) frente a 67,03 ms en la CPU de una Pi 5, en pruebas distintas. Elige según el modelo, los FPS y las cámaras.
 Onuralp Sezer18 min de lectura
¿Deberías ejecutar la detección de objetos en una Raspberry Pi 5 o en una NVIDIA Jetson Orin Nano? Para una cámara, un objetivo de baja frecuencia de fotogramas y un modelo pequeño, la CPU de una Pi 5 puede bastar: en nuestra prueba comparativa publicada, Ultralytics YOLO26n exportado a NCNN tarda 67,03 ms en inferir cada imagen en sus cuatro núcleos Arm, es decir, unos 15 FPS de inferencia. Si necesitas más cámaras, un modelo más grande o más margen de frecuencia de fotogramas del que ofrece tu Pi, una Jetson merece la pena: en una Jetson Orin Nano Super Developer Kit, el mismo modelo tarda 4,57 ms como motor TensorRT FP16.
Ultralytics publica esta comparación y desarrolla YOLO26, que funciona en ambas placas; no fabricamos ninguna de ellas. Las cifras de Jetson proceden de la Orin Nano Super Developer Kit, el kit de desarrollo Orin básico de NVIDIA, y las de Pi, de una Raspberry Pi 5; son pruebas distintas. Mucha gente sigue buscando «Jetson Nano», la placa original de 2019. Ejecuta YOLO26 con JetPack 4, pero nuestra guía de Jetson no incluye pruebas comparativas de YOLO26 para esa placa, así que aquí solo aparece en las especificaciones.
A continuación: cómo se comparan las placas según el tamaño del modelo, la frecuencia de fotogramas objetivo y el número de flujos de cámara; por qué bajan los FPS al añadir cámaras; cómo medir ambas placas por tu cuenta; y cuál encaja con tu proyecto. Encontrarás los pasos de configuración en la guía de NVIDIA Jetson y la guía de Raspberry Pi; además, nuestro tutorial sobre la detección de objetos en la CPU de una Raspberry Pi 5 explica en profundidad la parte de Pi.
La Pi 5 ejecuta YOLO en la CPU; la Orin Nano Super incorpora una GPU#
Las placas resuelven el mismo problema con distintos chips. La Raspberry Pi 5 es un ordenador de propósito general con cuatro núcleos Arm Cortex-A76 y sin acelerador de IA dedicado, por lo que nuestras pruebas de Pi ejecutan YOLO en la CPU. La Jetson Orin Nano Super Developer Kit combina un módulo Orin Nano, basado en una GPU Ampere, con una placa portadora, y el entorno de ejecución TensorRT de NVIDIA compila los modelos para esa GPU. Es una plataforma de IA en el edge diseñada para este tipo de carga de trabajo.
| Jetson Nano de 4 GB (2019) | Jetson Orin Nano Super | Raspberry Pi 5 | |
|---|---|---|---|
| Cómputo para YOLO | GPU Maxwell de 128 núcleos | GPU Ampere de 1024 núcleos, 32 Tensor Cores | CPU Arm Cortex-A76 de 4 núcleos |
| CPU | Cortex-A57 de 4 núcleos, 1,43 GHz | Cortex-A78AE de 6 núcleos, hasta 1,7 GHz | Cortex-A76 de 4 núcleos, hasta 2,4 GHz |
| Memoria | 4 GB LPDDR4, 25,6 GB/s | 8 GB LPDDR5, 102 GB/s | Varía según el modelo |
| Rendimiento de IA (cifra máxima de NVIDIA) | 472 GFLOPS | 67 TOPS INT8 dispersos | — |
| JetPack / SO | Solo JetPack 4 | JetPack 5 a 7 | Raspberry Pi OS |
| Ruta de despliegue de Ultralytics | TensorRT, incluido DeepStream | TensorRT (el más rápido en nuestra prueba) | NCNN (el más rápido en nuestra prueba) |
Especificaciones, no mediciones, verificadas el 19 de noviembre de 2026. NVIDIA usa distintos formatos numéricos para sus cifras máximas, por lo que no son directamente comparables. Los 67 TOPS de la Orin Nano Super son una cifra INT8 dispersa; NVIDIA indica 33 TOPS densos. Los datos de Jetson proceden de las tablas comparativas y de JetPack de la guía de NVIDIA Jetson y de la guía de DeepStream; los datos de Pi 5, de la documentación de Raspberry Pi.
El consumo también influye en la elección. NVIDIA indica un consumo de 7 W a 25 W para la Orin Nano Super Developer Kit. Cuando se instala en la placa una configuración habilitada para Super, la Orin Nano de 8 GB ofrece modos de consumo de 15 W, 25 W y MAXN SUPER; con la configuración predeterminada conserva sus modos originales de 7 W y 15 W. Elijas la placa que elijas, mide el consumo de todo el sistema con las cámaras conectadas, porque eso es lo que deben soportar la fuente de alimentación y la carcasa.
Calcula el coste del equipo completo, no solo el de la placa: el almacenamiento, la alimentación, la refrigeración y las cámaras suman en ambos casos. Raspberry Pi ha subido los precios de la Pi 5 varias veces en 2026 debido al aumento del coste de la memoria. En noviembre de 2026, la Pi 5 de 2 GB cuesta 77,50 $ y la placa de 16 GB, 385 $. Para consultar los precios y la disponibilidad actuales de Jetson, visita la página de kits de desarrollo de NVIDIA y añade el coste de cualquier acelerador que necesite una Pi, como la Raspberry Pi AI HAT+. Para producción, NVIDIA vende módulos Jetson para que uses tu propia placa portadora; el kit de desarrollo que evaluamos está pensado para desarrollo y creación de prototipos.
La CPU de una Pi 5 es adecuada para cargas de trabajo de YOLO26n con pocos FPS#
La Pi 5 permite detectar objetos con una sola cámara sin hardware adicional si necesitas una frecuencia de fotogramas moderada. En la prueba comparativa de Ultralytics (exportación FP32, entrada de 640 píxeles, COCO128, Ultralytics 8.4.108, solo tiempo de inferencia), NCNN fue el formato de exportación más rápido: 67,03 ms por imagen para YOLO26n con 0,4784 mAP50-95. Eso equivale a unos 15 FPS de inferencia, lo que puede ser suficiente para un puesto de recuento, una cámara de estantería o un prototipo de robótica que no necesite captar movimientos rápidos. Valida toda la cadena de procesamiento de la cámara, no solo la inferencia. Arm también publica un entorno de ejecución de código abierto para YOLO26n en la Pi 5 que, según sus propias mediciones, es más rápido que NCNN; nuestro tutorial sobre Raspberry Pi 5 compara ambos.
El tamaño del modelo es el punto débil de la Pi. El modelo más grande YOLO26s tarda 172,88 ms con NCNN en la Pi 5, menos de 6 FPS de inferencia. La comparación de varios formatos de la guía de Raspberry Pi (Ultralytics 8.4.108) solo incluye n y s. La comparación anterior con ONNX (Ultralytics 8.4.14) también presenta m, l y x; en ella, YOLO26m tarda 993,78 ms. Si los objetos pequeños o las clases difíciles de distinguir te llevan a elegir un modelo más grande o una resolución de entrada superior, prueba ese modelo en la placa antes de decidirte.
Añadir una AI HAT+ a la Pi 5#
Hay una tercera configuración que debes tener en cuenta: una Pi 5 con la AI HAT+ de Raspberry Pi, que incorpora un acelerador Hailo en versiones de 13 TOPS o 26 TOPS. En la prueba de integración de Hailo de Ultralytics (Ultralytics 8.4.174, COCO128), YOLO26n exportado para la versión Hailo-8 de 26 TOPS tarda 21,7 ms por imagen con 0,455 mAP50-95, frente a los 364,6 ms del modelo PyTorch sin exportar en la misma Pi. La prueba no especifica el tamaño de entrada y ejecuta INT8, así que considérala una prueba independiente, no una fila de la comparación de abajo. Los modelos Hailo requieren un paso de compilación, así que comprueba la precisión con tus propias imágenes después de exportarlos.
En la Orin Nano Super, YOLO26n a YOLO26l tardan menos de 18 ms#
En una Jetson, los modelos más grandes resultan prácticos. Las pruebas de Ultralytics en la Orin Nano Super Developer Kit (entrada de 640 píxeles, COCO128, Ultralytics 8.4.33, solo inferencia) sitúan todos los tamaños, de n a l, por debajo de 18 ms de inferencia por imagen como motor TensorRT FP16:
| Modelo YOLO26 | CPU de Raspberry Pi 5 (ms/imagen) | Orin Nano Super, TensorRT FP16 (ms/imagen) | Orin Nano Super mAP50-95, FP16 |
|---|---|---|---|
| YOLO26n | 67,03 (NCNN FP32, 8.4.108) | 4.57 | 0.4800 |
| YOLO26s | 172,88 (NCNN FP32, 8.4.108) | 7.17 | 0.5649 |
| YOLO26m | 993,78 (prueba anterior con ONNX, 8.4.14) | 13.59 | 0.6225 |
| YOLO26l | 1259,46 (prueba anterior con ONNX, 8.4.14) | 17.42 | 0.6225 |
Resultados publicados de pruebas distintas. Orin Nano Super: Ultralytics 8.4.33. Todas las filas usan una entrada de 640 píxeles; solo se mide el tiempo de inferencia, sin preprocesamiento ni posprocesamiento.
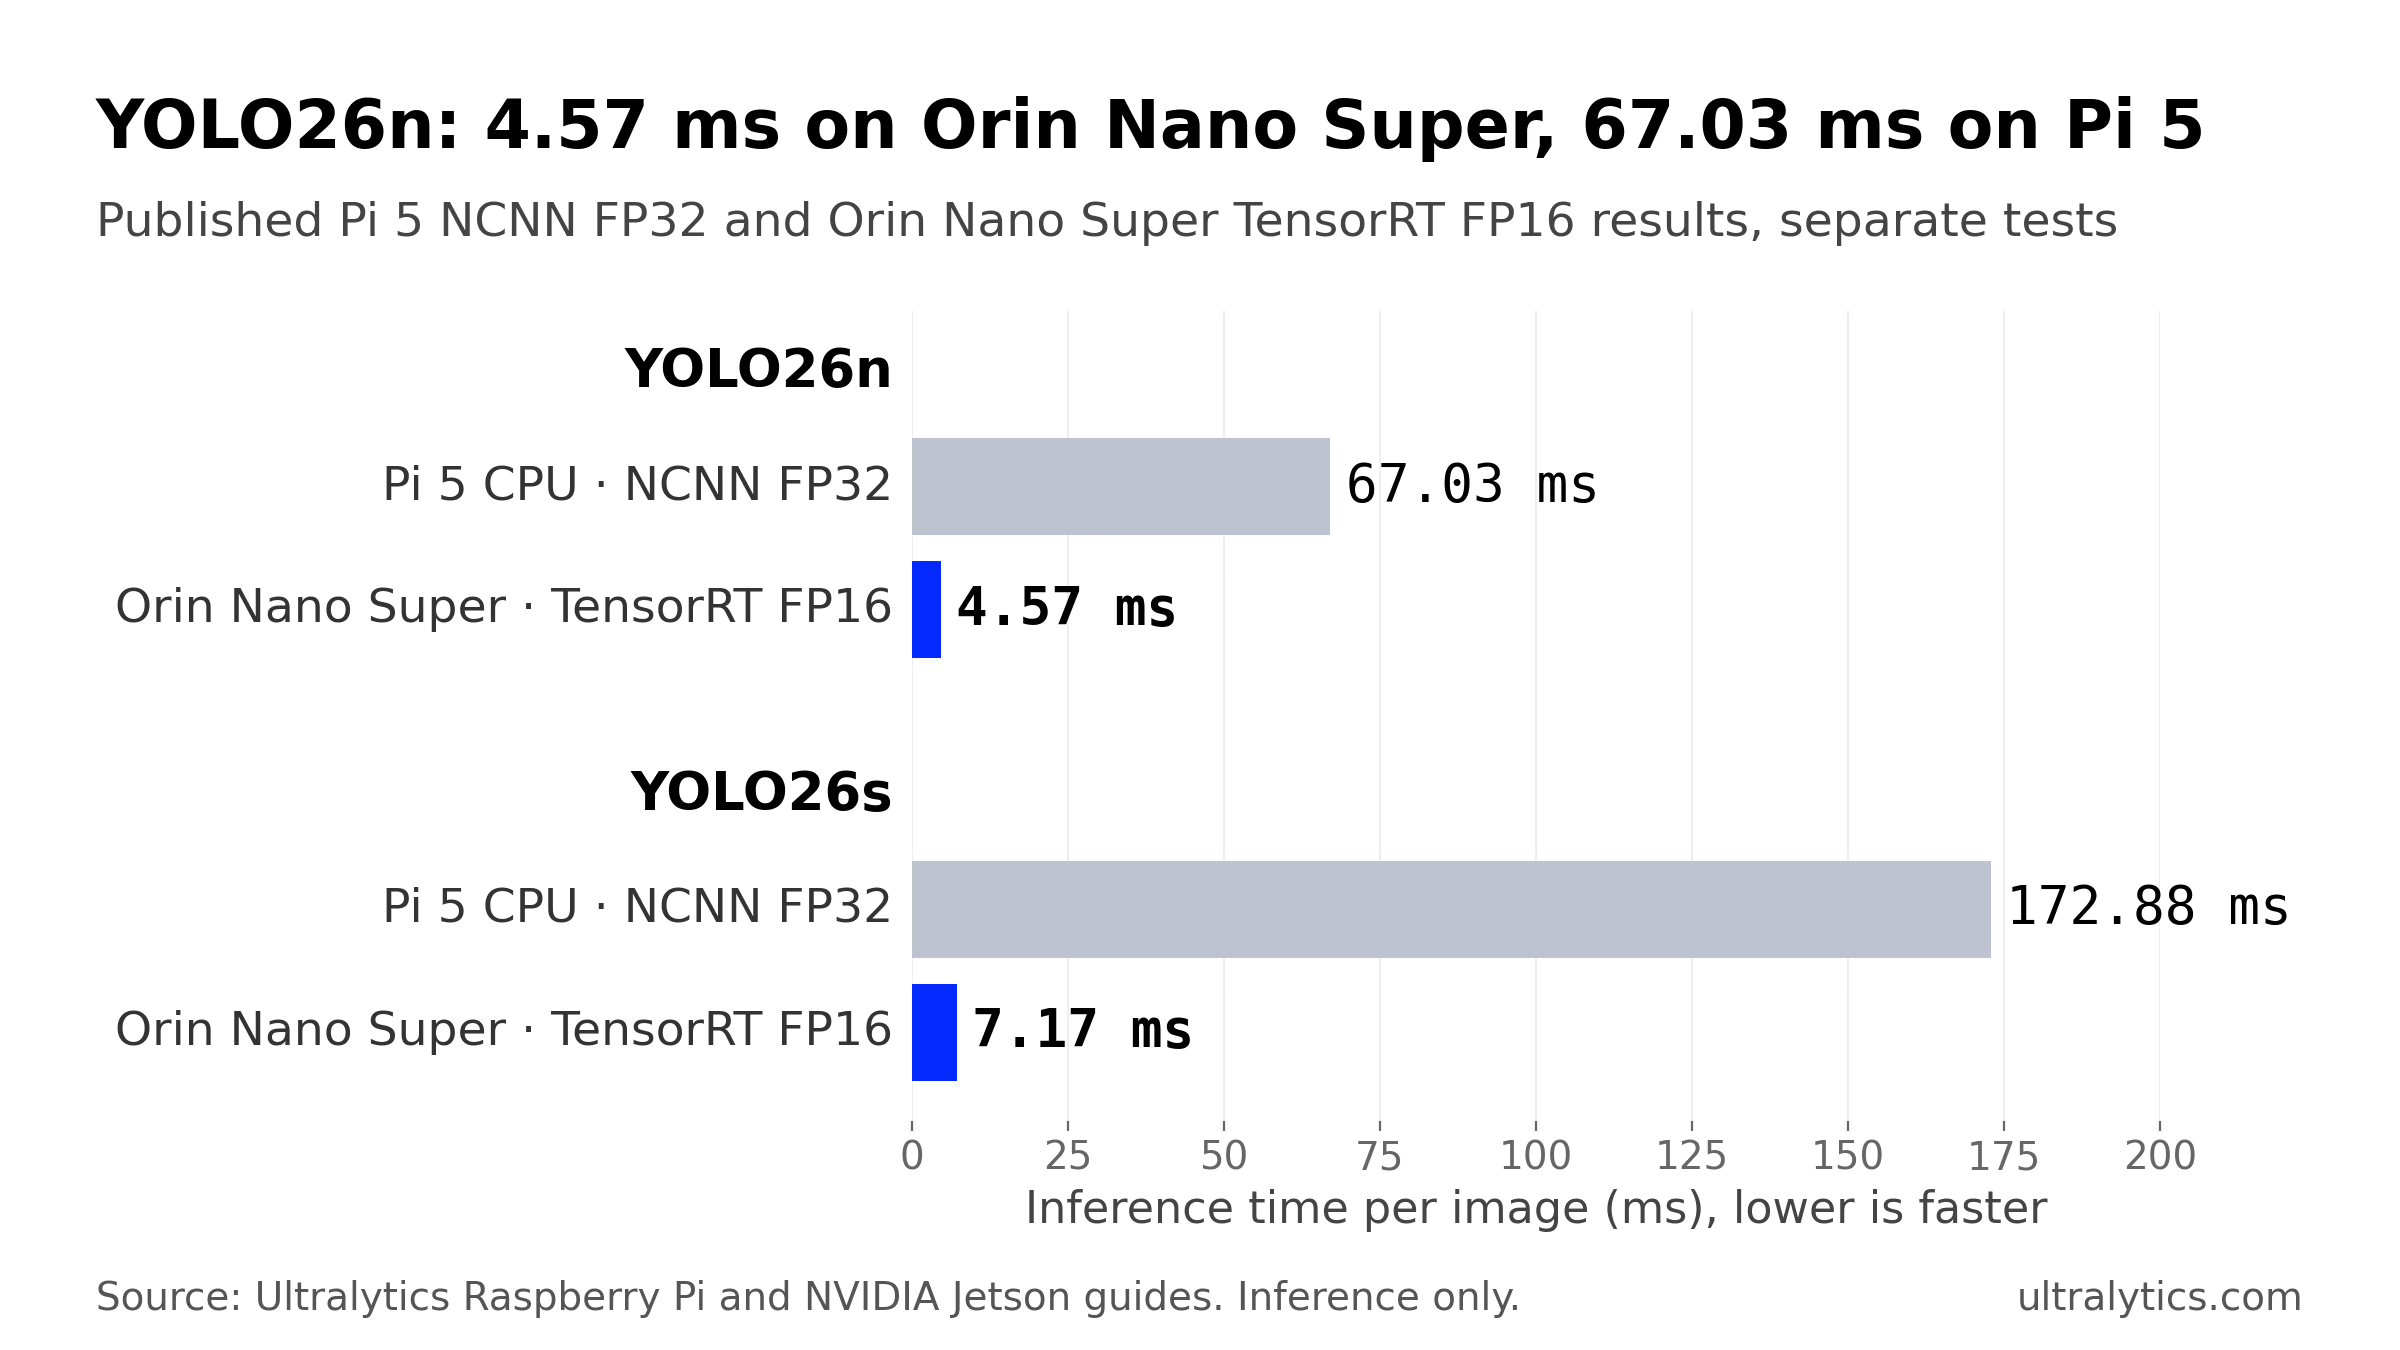
Resultados publicados de NCNN FP32 y TensorRT FP16 de pruebas distintas: Raspberry Pi 5 con Ultralytics 8.4.108 y Orin Nano Super Developer Kit con Ultralytics 8.4.33. Solo inferencia, sin preprocesamiento ni posprocesamiento. Fuente: las guías de Raspberry Pi y NVIDIA Jetson de Ultralytics.
Para YOLO26n, eso supone aproximadamente un 93 % menos de tiempo de inferencia que en la CPU de la Pi 5. Parte de la diferencia se debe a la precisión, así que compara también las exportaciones FP32: el motor TensorRT FP32 de la Orin Nano Super tarda 7,53 ms, casi nueve veces menos que la exportación NCNN FP32 de la Pi, aunque los entornos de ejecución y las versiones de prueba sean distintos. La diferencia más importante está en YOLO26m: 0,6225 mAP50-95 en 13,59 ms, un modelo que la CPU de la Pi 5 ejecutó a aproximadamente un fotograma por segundo en la prueba anterior con ONNX.
INT8 reduce un poco más el tiempo. YOLO26n baja a 3,80 ms como motor INT8, pero su mAP50-95 cae de 0,4800 a 0,4490 con COCO128, así que empieza con FP16 y pasa a la cuantización INT8 solo si FP16 no cumple tu presupuesto de rendimiento y puedes calibrar el modelo con imágenes de tus propias cámaras. Nuestra lección de la Academy sobre optimización con TensorRT explica este proceso.
Los FPS bajan al añadir cámaras porque todos los flujos comparten el mismo presupuesto de recursos#
Es habitual que, al ampliar el sistema, una cámara funcione sin problemas y la frecuencia de fotogramas procesados disminuya al añadir una tercera o una cuarta. Cada fotograma requiere decodificación, preprocesamiento, inferencia y posprocesamiento, y todas las cámaras comparten los mismos recursos de cómputo. En una Pi 5, los mismos cuatro núcleos de la CPU decodifican el vídeo y ejecutan el modelo, así que cada flujo añadido consume tiempo de ambas tareas.
Ultralytics se encarga de la lógica de procesamiento. Incluye una fuente por línea en un archivo .streams y pásalo al modo Predict: cada flujo tiene su propio hilo lector y el cargador agrupa en un lote el último fotograma de cada cámara, por lo que una fuente lenta o que pierda fotogramas puede retrasar el lote. Los backends que admiten lotes los procesan en una sola pasada hacia delante; NCNN procesa los fotogramas de uno en uno, y el lote de un motor TensorRT de forma fija se divide o rellena para ajustarse al tamaño de exportación. De forma predeterminada (stream_buffer=False), un modelo lento omite los fotogramas obsoletos en lugar de ponerlos en cola, lo que mantiene corta la cola de espera dentro de la aplicación, aunque el almacenamiento en búfer de la cámara, el decodificador o la red aún puede añadir latencia.
La latencia de una sola imagen es un punto de partida, no sirve para calcular el número de cámaras. El uso de lotes modifica el rendimiento, y la decodificación, el seguimiento y el dibujo también tienen un coste. La lección sobre inferencia con varios flujos de Ultralytics Academy ofrece esta regla de dimensionamiento: el número de flujos por dispositivo es aproximadamente el rendimiento sostenido con el tamaño de lote real dividido por los FPS que necesita cada flujo, con un margen del 20 al 30 % para los picos. Mide ese rendimiento en la placa con las cámaras conectadas, como se explica en la sección práctica de abajo. Para gestionar varios flujos de cámara en Jetson, DeepStream procesa varias fuentes con un único motor TensorRT dentro de una sola aplicación con mosaico.
Elige según los FPS medidos por cámara, el tamaño del modelo y la precisión#
Empieza por la placa más barata que pueda servir, mídela con tus propias cámaras y pasa a una superior solo si se queda corta:
| Si tus mediciones muestran que… | Empieza con |
|---|---|
| YOLO26n cumple tu objetivo de precisión y los FPS necesarios por cámara | Una CPU de Pi 5 con NCNN. Una tarea de pocos FPS puede admitir más de una cámara. |
| La Pi se queda corta de frecuencia de fotogramas, pero quieres seguir usándola | Una Pi 5 con un acelerador como Hailo-8 AI HAT+ o DEEPX DX-M1. Ambos ejecutan modelos cuantizados y requieren un paso de compilación, así que comprueba la precisión después de exportarlos. |
| Necesitas un modelo más grande con más FPS, más flujos de los que la Pi puede mantener o recursos de CPU para otro software | Una Jetson Orin Nano Super con TensorRT; pasa a la Orin NX o AGX Orin si el rendimiento medido se queda corto. |
La frecuencia de fotogramas es un requisito del negocio antes que una cifra de una prueba comparativa. Nuestra guía sobre FPS en visión artificial explica cómo fijar un objetivo según la velocidad de lo que observas, y la guía para elegir el dispositivo edge adecuado cubre otras placas además de estas dos.
Mide ambas placas con tus propias cámaras#
Las cifras anteriores se midieron en condiciones controladas; las tuyas variarán según la refrigeración, el modo de alimentación, la imagen del SO, la versión del software y tu modelo. El paquete Ultralytics usa la misma API en ambas placas, así que puedes hacer la misma medición en cada una. Los comandos de abajo se verificaron con Ultralytics 8.4.215.
Paso 1: compara los formatos de exportación en cada placa#
Ejecuta yolo benchmark model=yolo26n.pt data=coco128.yaml imgsz=640 en la placa. El modo Benchmark indica el tamaño, mAP50-95 y el tiempo de inferencia de cada formato de exportación compatible con la placa; añade quantize=16 o quantize=8 para medir FP16 o INT8 cuando el formato lo permita. En una Orin Nano Super Developer Kit con una configuración habilitada para Super, selecciona primero el modo de alimentación MAXN SUPER; en la publicación de NVIDIA sobre Super Mode para JetPack 6.2 en Orin Nano, el comando es sudo nvpmodel -m 2. Después, ejecuta sudo jetson_clocks. Vigila las temperaturas durante las ejecuciones largas.
Paso 2: exporta el formato más rápido en cada placa#
En la Raspberry Pi 5, exporta a NCNN como se muestra en nuestro tutorial sobre Raspberry Pi 5. En Jetson, crea el motor en el propio dispositivo, porque los motores TensorRT dependen de la GPU y de la versión de TensorRT con las que se hayan creado. Un motor exportado sin dynamic tiene una forma de entrada fija. Una opción es establecer batch en el número de cámaras y volver a exportar con un imgsz más pequeño si necesitas más velocidad:
from ultralytics import YOLO

# Solo Jetson: requiere una GPU NVIDIA. Motor TensorRT FP16, 640 píxeles, lote de cuatro cámaras
YOLO("yolo26n.pt").export(format="engine", quantize=16, imgsz=640, batch=4)  # writes yolo26n.engine
Paso 3: mide los FPS procesados por cámara#
Pon una URL RTSP por línea en cams.streams, ejecuta el modelo de la placa durante aproximadamente un minuto y compara los FPS procesados de cada cámara con la frecuencia a la que envía fotogramas. El temporizador empieza después del primer lote completo, una vez conectados los flujos y calentado el modelo, y se detiene al completarse un lote:
import time
from collections import Counter

from ultralytics import YOLO

model = YOLO("yolo26n.engine")  # on the Pi 5: YOLO("yolo26n_ncnn_model")
cameras = open("cams.streams").read().split()
n_streams = len(cameras)

frames, start = Counter(), None
for i, result in enumerate(model("cams.streams", stream=True)):
    if i < n_streams:  # first batch: connection and warm-up
        if i == n_streams - 1:
            start = time.perf_counter()
        continue
    frames[i % n_streams] += 1  # results arrive in stream order within each batch
    if (i + 1) % n_streams == 0 and time.perf_counter() - start > 60:
        break

elapsed = time.perf_counter() - start
for slot, count in sorted(frames.items()):
    print(f"{cameras[slot]}: {count / elapsed:.1f} processed FPS")
Esto mide el rendimiento de resultados procesados de esta cadena de procesamiento. Si los FPS procesados de una cámara quedan muy por debajo de su frecuencia de fotogramas al añadir flujos, la placa no da abasto. Confírmalo con contadores explícitos de fotogramas perdidos por flujo del ejemplo productor-consumidor de la lección sobre varios flujos de la Academy; añade el seguimiento o el dibujo que necesite tu aplicación y, después, vuelve a exportar con un imgsz más pequeño, pasa a un modelo más pequeño o a una exportación más rápida, o mejora el hardware; a continuación, repite la medición.
Si prefieres no configurar un entorno de compilación, la pestaña Export de Ultralytics Platform crea motores TensorRT para dispositivos Jetson, incluida la Orin Nano 8GB Super. Las opciones para Orin se crean en una AGX Orin y aún está pendiente su validación en la propia Orin Nano, así que comprueba que el entorno de ejecución TensorRT y CUDA de tu dispositivo sea compatible con el motor y valida cada motor en el dispositivo donde vayas a desplegarlo. Para comparar ONNX Runtime con TensorRT en GPU NVIDIA, consulta ONNX frente a TensorRT.
Qué placa elegir#
Elige una Raspberry Pi 5 cuando YOLO26n cumpla tu objetivo de precisión y los FPS procesados que midas en la placa cubran todas las cámaras que necesitas. Con unos 15 FPS de inferencia, es una solución sencilla para cajas de tiendas, recuento en cintas transportadoras, cámaras de fauna y del hogar, y primeros prototipos de robots. Añade un acelerador si necesitas procesar más fotogramas y quieres seguir usando la Pi.
Elige una Jetson Orin Nano Super si necesitas un modelo mayor que nano con una frecuencia de fotogramas útil, más flujos de los que una Pi puede mantener o recursos de CPU para el seguimiento, la navegación y el resto de tu aplicación. Allí, YOLO26s a YOLO26l tardan menos de 18 ms en inferir cada imagen; ese margen es el que aprovechas al añadir cámaras. Mide la aplicación completa para confirmarlo.
Dónde encaja Ultralytics#
Ultralytics no fabrica ninguna de las dos placas; desarrollamos los modelos y las herramientas que funcionan en ambas. Los mismos pesos de YOLO26 se exportan a NCNN para la Pi 5, a Hailo para una Pi con AI HAT+ y a TensorRT para una Jetson, así que puedes crear un prototipo en una Pi y pasar a una Jetson cuando aumente la carga de trabajo, sin volver a entrenar; valida la precisión después de cada exportación. Ultralytics Platform se encarga de los pasos previos al despliegue: anota un conjunto de datos, entrena en la nube cuando tu proyecto necesite más recursos de entrenamiento de los que tienes en local y exporta para cualquiera de las dos placas.
Limitaciones: nuestras pruebas comparativas publicadas solo miden la inferencia y se hicieron en los dispositivos de prueba indicados, no con tus cámaras, carcasa ni módulo de producción; además, nuestra guía de Jetson no incluye resultados de YOLO26 para la Jetson Nano original. Ultralytics YOLO está disponible con AGPL-3.0 o una licencia Ultralytics Enterprise; consulta las licencias de Ultralytics para saber qué necesita tu despliegue.
Preguntas frecuentes
Es mucho más rápida por imagen. En nuestras pruebas comparativas publicadas, realizadas por separado, YOLO26n tarda 4,57 ms como motor TensorRT FP16 en una Jetson Orin Nano Super Developer Kit, frente a 67,03 ms con NCNN en la CPU de una Raspberry Pi 5 (entrada de 640 píxeles, solo inferencia), y YOLO26m tarda 13,59 ms en la Jetson. Que necesites esa velocidad depende del modelo, del número de cámaras y de los FPS objetivo: si la Pi 5 cumple tus requisitos según tus propias mediciones, es la solución más sencilla.
No. La Jetson Nano original salió en 2019 con una GPU Maxwell de 128 núcleos y 4 GB de memoria, y solo admite JetPack 4. La Jetson Orin Nano es un módulo más reciente con una GPU Ampere de 1024 núcleos; la Orin Nano Super Developer Kit que evaluamos tiene 8 GB de memoria y admite JetPack 5 a 7. La comparación de rendimiento de este artículo corresponde a la Orin Nano Super, no a la Nano original.
Sí. La Jetson Nano de 2019 admite JetPack 4, Ultralytics ofrece una imagen Docker de JetPack 4 y nuestra guía de DeepStream para YOLO26 con TensorRT se probó en una Jetson Nano 4GB con JetPack 4.6.4. Nuestra guía de Jetson no incluye una prueba comparativa de YOLO26 para esta placa, cuyo hardware está muy por debajo del de la Orin Nano Super.
Todos los flujos comparten los recursos de cómputo de la placa: cada cámara añadida requiere su propia decodificación, preprocesamiento, inferencia y posprocesamiento. Con un archivo
.streams, Ultralytics agrupa en lotes los fotogramas de todas las cámaras y omite los obsoletos cuando el modelo no da abasto, por lo que pueden bajar los FPS procesados de cada cámara cuando la cadena compartida se convierte en el cuello de botella. Una exportación más rápida, un modelo más pequeño oimgsz, o un hardware más potente pueden aumentarlos.Sí. Entrena una sola vez y después exporta los mismos pesos con
format="ncnn"para la Pi 5 yformat="engine"para la Jetson; crea el motor TensorRT en el dispositivo de destino o para él. Valida la precisión con tus propios datos después de cada exportación.
Escrito por
Ingeniero sénior de aprendizaje automático · Ultralytics
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









