Comparativa de plataformas gestionadas de entrenamiento frente a GPU autogestionadas para visión artificial
Compara plataformas gestionadas de entrenamiento con GPU, servicios de ML en la nube, GPU alquiladas y hardware propio para visión artificial: costes, configuración, punto de equilibrio y cuándo conviene cada opción.
 Miles Deans12 min de lectura
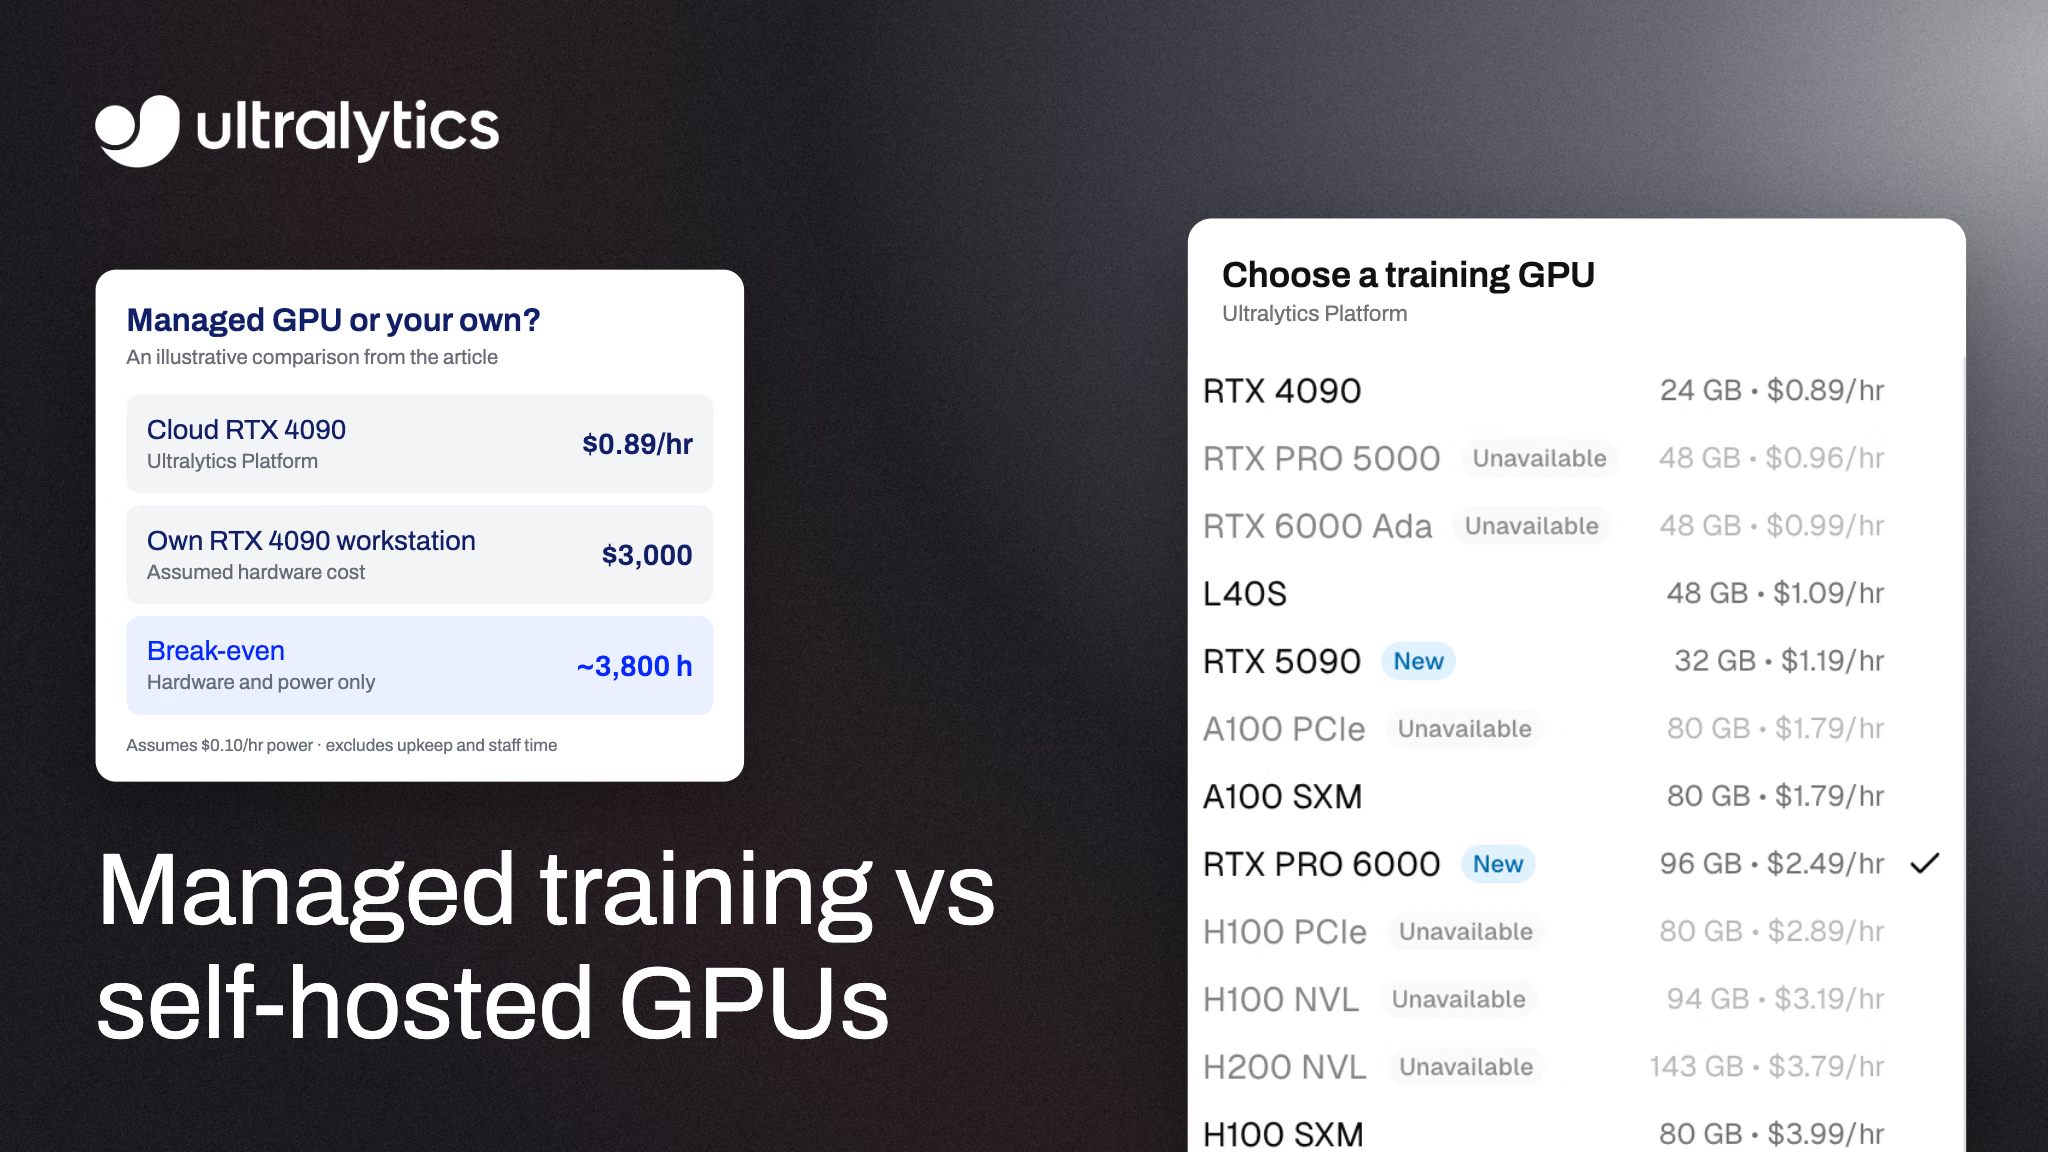
Las plataformas de entrenamiento gestionado se encargan de la infraestructura de entrenamiento y te cobran por el tiempo de uso de la GPU; con las GPU autogestionadas, tu equipo se responsabiliza del hardware y el entorno, tanto si alquila máquinas como si son propias. El entrenamiento gestionado suele ser adecuado para cargas de trabajo intermitentes y equipos que quieren reducir el trabajo de infraestructura. Tener GPU propias puede costar menos si se usan de forma sostenida, pero el resultado depende de cuánto se utilice el hardware, de su vida útil, del coste de la electricidad y del tiempo de ingeniería.
Esta guía compara cuatro opciones habituales para entrenar modelos de visión en 2026, muestra cómo calcular el punto de equilibrio para tu carga de trabajo y explica dónde encaja Ultralytics Platform.
Las cuatro opciones para entrenar un modelo de visión#
La expresión «gestionado frente a autogestionado» suele ocultar cuatro configuraciones distintas:
- Una plataforma gestionada de entrenamiento de visión. Subes o conectas un conjunto de datos, eliges un modelo y una GPU, y la plataforma ejecuta el entrenamiento. Ultralytics Platform funciona así con los modelos YOLO.
- Una plataforma de ML de propósito general. Servicios como Amazon SageMaker, Google Vertex AI y Azure Machine Learning ejecutan trabajos de entrenamiento en instancias en la nube para muchos frameworks. Configuras el trabajo de entrenamiento, su entorno, los permisos y el almacenamiento; los recursos de computación y los servicios relacionados se facturan por separado, así que compara las páginas oficiales de precios de cada proveedor en lugar de fijarte solo en las tarifas de GPU.
- Una GPU alquilada en la nube. Las plataformas de GPU en la nube, como RunPod y Lambda, te alquilan una máquina por tiempo de uso. A menos que la imagen del proveedor ya incluya lo que necesitas, tendrás que configurar los controladores, CUDA, los paquetes de Python y el código de entrenamiento, y detener la instancia cuando termines.
- Tu propia GPU. Una estación de trabajo o un servidor en tu oficina o centro de datos. Compras el hardware una vez y pagas la electricidad, la refrigeración, el mantenimiento y el tiempo que dedicas a mantenerlo en funcionamiento.
Entrenamiento gestionado frente a GPU autogestionadas de un vistazo#
| Factor de decisión | Plataforma gestionada de visión | Plataforma de ML de propósito general | GPU alquilada en la nube | GPU propia |
|---|---|---|---|---|
| ¿Es necesario comprar hardware? | No | No | No | Sí |
| Pagas por | El tiempo de uso de la GPU | El tiempo de uso de la instancia y los servicios relacionados | El tiempo que la instancia está en funcionamiento | El hardware, la electricidad y el mantenimiento |
| Configuración antes de la primera ejecución | Elegir el conjunto de datos, el modelo y la GPU | Configurar el trabajo, el entorno, los permisos y el almacenamiento | Configurar o verificar el entorno, el código y las dependencias | Hardware, sistema operativo, controladores y paquetes |
| Entorno de entrenamiento | La plataforma lo ejecuta; tú eliges la configuración | Compartido entre el servicio y tu equipo | Principalmente tu equipo | Tu equipo |
| Cómo conseguir una GPU más potente | Elegir otra GPU disponible | Elegir otro tipo de instancia | Alquilar otra máquina | Comprar otra GPU |
| Ubicación de los datos | Almacenamiento de la plataforma, un bucket de nube conectado (Pro y Enterprise) o datos locales (Enterprise) | Tu cuenta de nube | Dondequiera que los copies | En tus instalaciones |
| Cuándo conviene | Entrenamiento de visión rápido y reproducible | Equipos que ya han estandarizado las herramientas de ML de una plataforma en la nube | Ingenieros con experiencia en la gestión de máquinas | Entrenamiento continuo y estable o requisitos estrictos para trabajar en local |
Cómo se factura el entrenamiento gestionado con GPU#
En Ultralytics Platform, es sencillo calcular el coste de la GPU de una ejecución de entrenamiento:
GPU cost = selected GPU hourly rate × billable GPU hoursAl comparar proveedores, usa la misma carga de trabajo y el mismo objetivo de precisión, y añade los costes de suscripción, almacenamiento, transferencia de datos y tiempo de ingeniería.
Ultralytics Platform ofrece 26 tipos de GPU NVIDIA desde 0,24 $/h, sin mínimos ni compromiso; el plan Free permite usar 24 de ellas, y Pro y Enterprise, las 26. Algunas opciones habituales:
| GPU | Memoria de vídeo (VRAM) | Precio por hora |
|---|---|---|
| RTX 4090 | 24 GB | $0.89 |
| A100 SXM | 80 GB | $1.79 |
| RTX PRO 6000 (opción predeterminada recomendada) | 96 GB | $2.49 |
| H100 SXM | 80 GB | $3.99 |
| B200 (planes Pro y Enterprise) | 180 GB | $7.99 |
La facturación se basa en el tiempo real de uso de la GPU. Se cobran las ejecuciones completadas, canceladas y fallidas después de que se inicie la GPU, según el tiempo de uso transcurrido; los fallos anteriores al inicio de la GPU no tienen coste. El cuadro de diálogo de entrenamiento calcula la duración y el coste antes de empezar, y cada estimación reserva al menos 15 minutos de tiempo de uso de la GPU de tu saldo; esa reserva determina el saldo que necesitas para empezar, mientras que la facturación se basa en el tiempo real de uso de la GPU.
Como referencia, los tiempos de entrenamiento habituales de Ultralytics para 1.000 imágenes y 100 épocas con una RTX PRO 6000 son de unos 15 minutos para YOLO26m y unos 30 minutos para YOLO26x. A 2,49 $ por hora, eso equivale aproximadamente a 0,62 $ y 1,25 $ de tiempo de uso de la GPU. Las ejecuciones reales varían según el tamaño de imagen, el aumento de datos y el tamaño del lote, así que tómalos como valores orientativos, no como presupuestos.
El coste real de las GPU autogestionadas#
Una GPU propia no tiene una tarifa por hora, pero tampoco sale gratis cada vez que la usas. El coste total incluye:
- El hardware, además del resto de la estación de trabajo o el servidor que acompaña a la GPU.
- La electricidad y la refrigeración por cada hora de entrenamiento.
- El tiempo de ingeniería dedicado a controladores, versiones de CUDA, conflictos entre paquetes y entornos averiados.
- El tiempo de inactividad. Una GPU que entrena dos horas al día permanece inactiva el resto del tiempo, por lo que aumenta el coste por hora de entrenamiento.
- Los límites de capacidad. Si un modelo necesita más memoria de vídeo (VRAM) de la que tienes, o hay que ejecutar varios experimentos a la vez, tendrás que esperar o comprar más hardware.
Una comparación simplificada del coste del hardware y la electricidad, suponiendo que la GPU propia entrena a la misma velocidad que la GPU en la nube, sería:
Break-even hours = hardware cost ÷ (cloud hourly rate − your power cost per hour)Como ejemplo con cifras hipotéticas, supongamos que una estación de trabajo con una RTX 4090 te cuesta 3.000 $ y que la electricidad cuesta unos 0,10 $ por hora de entrenamiento. Frente a una RTX 4090 a 0,89 $ por hora, llegarías al punto de equilibrio tras unas 3.800 horas de entrenamiento: unos 5,3 meses de uso ininterrumpido o 15,8 meses si la usas ocho horas al día. El cálculo no incluye la refrigeración, el consumo eléctrico en inactividad, las reparaciones, la financiación, el valor de reventa ni tu propio tiempo; además, la compra solo compensa si acumulas tantas horas de entrenamiento durante la vida útil del hardware. Usa el presupuesto real de tu hardware, el precio de la electricidad y las horas de entrenamiento previstas; el resultado varía mucho según el nivel de utilización.
Cuándo conviene tener GPU autogestionadas#
Tener hardware propio es mejor opción cuando:
- Tus GPU están siempre ocupadas. El reentrenamiento continuo, las búsquedas extensas de hiperparámetros o un equipo que comparte una máquina todo el día aumentan la utilización hasta acercarla al punto de equilibrio.
- Los datos no pueden salir de tus instalaciones. Algunos entornos regulados o aislados de la red descartan por completo el entrenamiento en la nube.
- Ya tienes el hardware. Si tienes una GPU capaz sin usar, compara sus costes de funcionamiento y sus tiempos de entrenamiento con las opciones en la nube antes de pagar por más hardware.
- Necesitas tener el control total de los controladores, los kernels o el código de entrenamiento personalizado que una plataforma gestionada no admite.
Cuándo conviene el entrenamiento gestionado#
Una plataforma gestionada es mejor opción cuando:
- El entrenamiento es intermitente. Entrenas cuando cambian los datos y luego pasas días sin entrenar.
- Quieres empezar hoy mismo. No tienes que instalar controladores, resolver incompatibilidades de CUDA ni depurar el entorno antes de la primera ejecución.
- Varía el tamaño de los modelos. Puedes entrenar un modelo nano en una GPU pequeña y un modelo grande en una GPU de 80 GB o más sin tener que comprar ninguna.
- Entrenan varias personas. Las ejecuciones, las métricas y los puntos de control se guardan en un mismo lugar, en vez de en máquinas individuales.
La opción híbrida: GPU propias y un panel de control gestionado#
No tienes por qué elegir una opción u otra. Ultralytics Platform admite el entrenamiento remoto: entrenas en tu propia GPU con el paquete ultralytics, transmites métricas en tiempo real al mismo panel de Platform que se usa para las ejecuciones en la nube y subes los pesos finales cuando termina el entrenamiento. Las ejecuciones remotas usan tu propia GPU, no las GPU en la nube de Ultralytics, así que no consumen tiempo de uso de las GPU en la nube.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(
    data="coco8.yaml",
    epochs=100,
    project="username/my-project",  # tu proyecto de Platform
    name="local-gpu-run",
)
Configura primero tu clave de API con export ULTRALYTICS_API_KEY="YOUR_API_KEY". La integración con Platform requiere Python 3.11 o posterior y ultralytics 8.4.120 o posterior. Una estrategia habitual consiste en ejecutar experimentos rápidos en una GPU local y enviar después las ejecuciones más grandes o urgentes a una GPU en la nube cuando la máquina local esté ocupada.
Cómo entrenar YOLO26 en una GPU gestionada con Ultralytics Platform#
- Crea una cuenta en platform.ultralytics.com. Las cuentas nuevas reciben un crédito de 5 $ al registrarse, o de 25 $ tras verificar un correo electrónico del trabajo.
- Añade un conjunto de datos subiendo imágenes y etiquetas, o conecta un bucket de Amazon S3 con un plan Pro o Enterprise.
- Abre el cuadro de diálogo de entrenamiento, elige un modelo YOLO26 y establece las épocas y el tamaño de imagen.
- Elige una GPU. RTX PRO 6000 es la opción predeterminada recomendada; consulta cómo elegir una GPU en la nube para conocer las ventajas e inconvenientes.
- Comprueba la estimación de costes, inicia el entrenamiento y sigue las métricas en tiempo real hasta que termine la ejecución.
El plan Free permite ejecutar hasta 3 trabajos de entrenamiento en la nube a la vez. Pro, que cuesta 29 $ al mes por usuario, aumenta ese límite a 10 e incluye 30 $ de crédito mensual por usuario.
Cuando termine el entrenamiento, puedes exportar el modelo o desplegarlo como API. Si también estás decidiendo dónde ejecutar la inferencia, nuestra guía sobre IA de visión en la nube frente a soluciones autogestionadas compara el coste, la latencia y el control de los datos durante el despliegue.
Preguntas frecuentes
Puede serlo, sobre todo si el entrenamiento es intermitente, porque solo pagas por las horas de GPU que usas. Compara el coste total y el tiempo de finalización de la misma carga de trabajo; el cálculo del punto de equilibrio anterior (coste del hardware dividido entre la tarifa por hora de la nube menos el coste de la electricidad por hora) es un punto de partida, no una garantía.
Una GPU alquilada en la nube te proporciona una máquina, y tu equipo configura la carga de trabajo de entrenamiento y comprueba o prepara el entorno. Una plataforma de entrenamiento gestionado se encarga de una mayor parte del flujo de trabajo: en Ultralytics Platform eliges un conjunto de datos, un modelo y una GPU, y la plataforma asigna la GPU, ejecuta el entrenamiento, transmite las métricas y guarda los puntos de control.
En Ultralytics Platform, las ejecuciones que fallan después de que se haya iniciado la GPU en la nube se cobran según el tiempo de uso transcurrido, y los fallos anteriores al inicio de la GPU no tienen coste. Las ejecuciones canceladas se cobran por el tiempo de uso de la GPU hasta la cancelación.
Sí. El entrenamiento remoto se ejecuta en tu propio hardware, transmite métricas en tiempo real a Platform y sube los pesos finales, así que no utiliza tiempo de uso de las GPU en la nube.
La RTX PRO 6000 (96 GB) es la opción predeterminada recomendada para la mayoría de los trabajos. Ultralytics recomienda la RTX 4090 para entrenamiento general, la A100 SXM para tamaños de lote grandes o modelos más grandes, y las GPU H100, H200, B200 y B300 para trabajos urgentes, con mucha memoria o de mayor tamaño.
Las nuevas cuentas de Ultralytics Platform reciben un crédito de 5 $ al registrarse, que aumenta a 25 $ tras verificar un correo electrónico profesional. Los planes Pro incluyen 30 $ de crédito por puesto cada mes.
No. Kubernetes puede programar cargas de trabajo de GPU, pero su documentación sobre la programación de GPU requiere controladores de GPU y un complemento de dispositivo del fabricante en los nodos. Un clúster de entrenamiento autogestionado sigue necesitando que alguien se encargue de los entornos, los permisos, la supervisión de los trabajos y los puntos de control, así que reserva presupuesto para ese trabajo además del cómputo.
Escrito por
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









