ONNX frente a TensorRT para la inferencia en visión artificial: comparativas y cómo elegir
ONNX Runtime frente a TensorRT para la inferencia en visión artificial: velocidad y precisión medidas de Ultralytics YOLO26 en 19 GPU NVIDIA, y cómo elegir.
 Miles Deans13 min de lectura
ONNX y TensorRT no son realmente rivales. ONNX es un formato de modelo y TensorRT es el motor de inferencia de NVIDIA, que normalmente recibe un archivo ONNX como entrada. La verdadera elección está en cómo ejecutar ese archivo: con ONNX Runtime, que funciona en distintos tipos de hardware y puede incluso delegar tareas en TensorRT, o compilándolo en un motor TensorRT independiente, que solo funciona en GPU NVIDIA. En las comparativas de Ultralytics Platform de Ultralytics YOLO26 en 19 GPU NVIDIA, TensorRT FP16 fue más rápido que los resultados publicados de ONNX FP16 en todas las GPU y tamaños de modelo, con una precisión que se mantuvo dentro de 0.001 mAP50-95. Las mejoras de velocidad medianas oscilaron entre 1.85x y 2.55x según el tamaño del modelo. La comparativa no indica qué proveedor de ejecución de ONNX Runtime generó los resultados de ONNX, así que no permite determinar cómo se compara ONNX Runtime en general ni con su proveedor de ejecución TensorRT. Para Ultralytics YOLO26 en GPU NVIDIA, empieza con TensorRT FP16 si la latencia es importante y usa ONNX Runtime cuando un mismo archivo de modelo tenga que funcionar en más de un tipo de hardware. Ultralytics YOLO exporta a ambos formatos con un único argumento.
Por dónde empezar con Ultralytics YOLO:
| Despliegue | Empieza con | Exportación de Ultralytics YOLO |
|---|---|---|
| GPU NVIDIA, la latencia es importante | TensorRT FP16 | format="engine", quantize=16 |
| CPU, hardware que no sea NVIDIA o flotas mixtas | ONNX Runtime | format="onnx" |
| API de ONNX Runtime en una GPU NVIDIA | ONNX Runtime con el proveedor de ejecución TensorRT | format="onnx" |
ONNX frente a TensorRT: formato, entorno de ejecución y motor#
La comparación engloba tres cosas distintas:
- ONNX (Intercambio abierto de redes neuronales) es un formato de archivo que almacena el grafo y los pesos de un modelo entrenado de forma independiente del entorno de trabajo. Exporta de PyTorch a ONNX para que otras herramientas puedan leer el modelo.
- ONNX Runtime ejecuta modelos ONNX. Delega tareas en backends de hardware llamados proveedores de ejecución, como CPU, CUDA y TensorRT, para que el mismo archivo pueda funcionar en la CPU de un portátil o en una GPU en la nube.
- TensorRT lee un modelo, normalmente un archivo ONNX, mediante su analizador ONNX. Combina capas, elige el kernel más rápido para cada operación en la GPU de destino y escribe un motor optimizado.
Así que la verdadera pregunta es ONNX Runtime frente a TensorRT. ONNX Runtime también puede llamar a TensorRT a través de su proveedor de ejecución TensorRT, lo que te permite mantener la API de ONNX Runtime mientras TensorRT ejecuta los subgrafos compatibles. ONNX Runtime recomienda registrar después el proveedor de ejecución CUDA para que los nodos que TensorRT no admita puedan ejecutarse en CUDA.
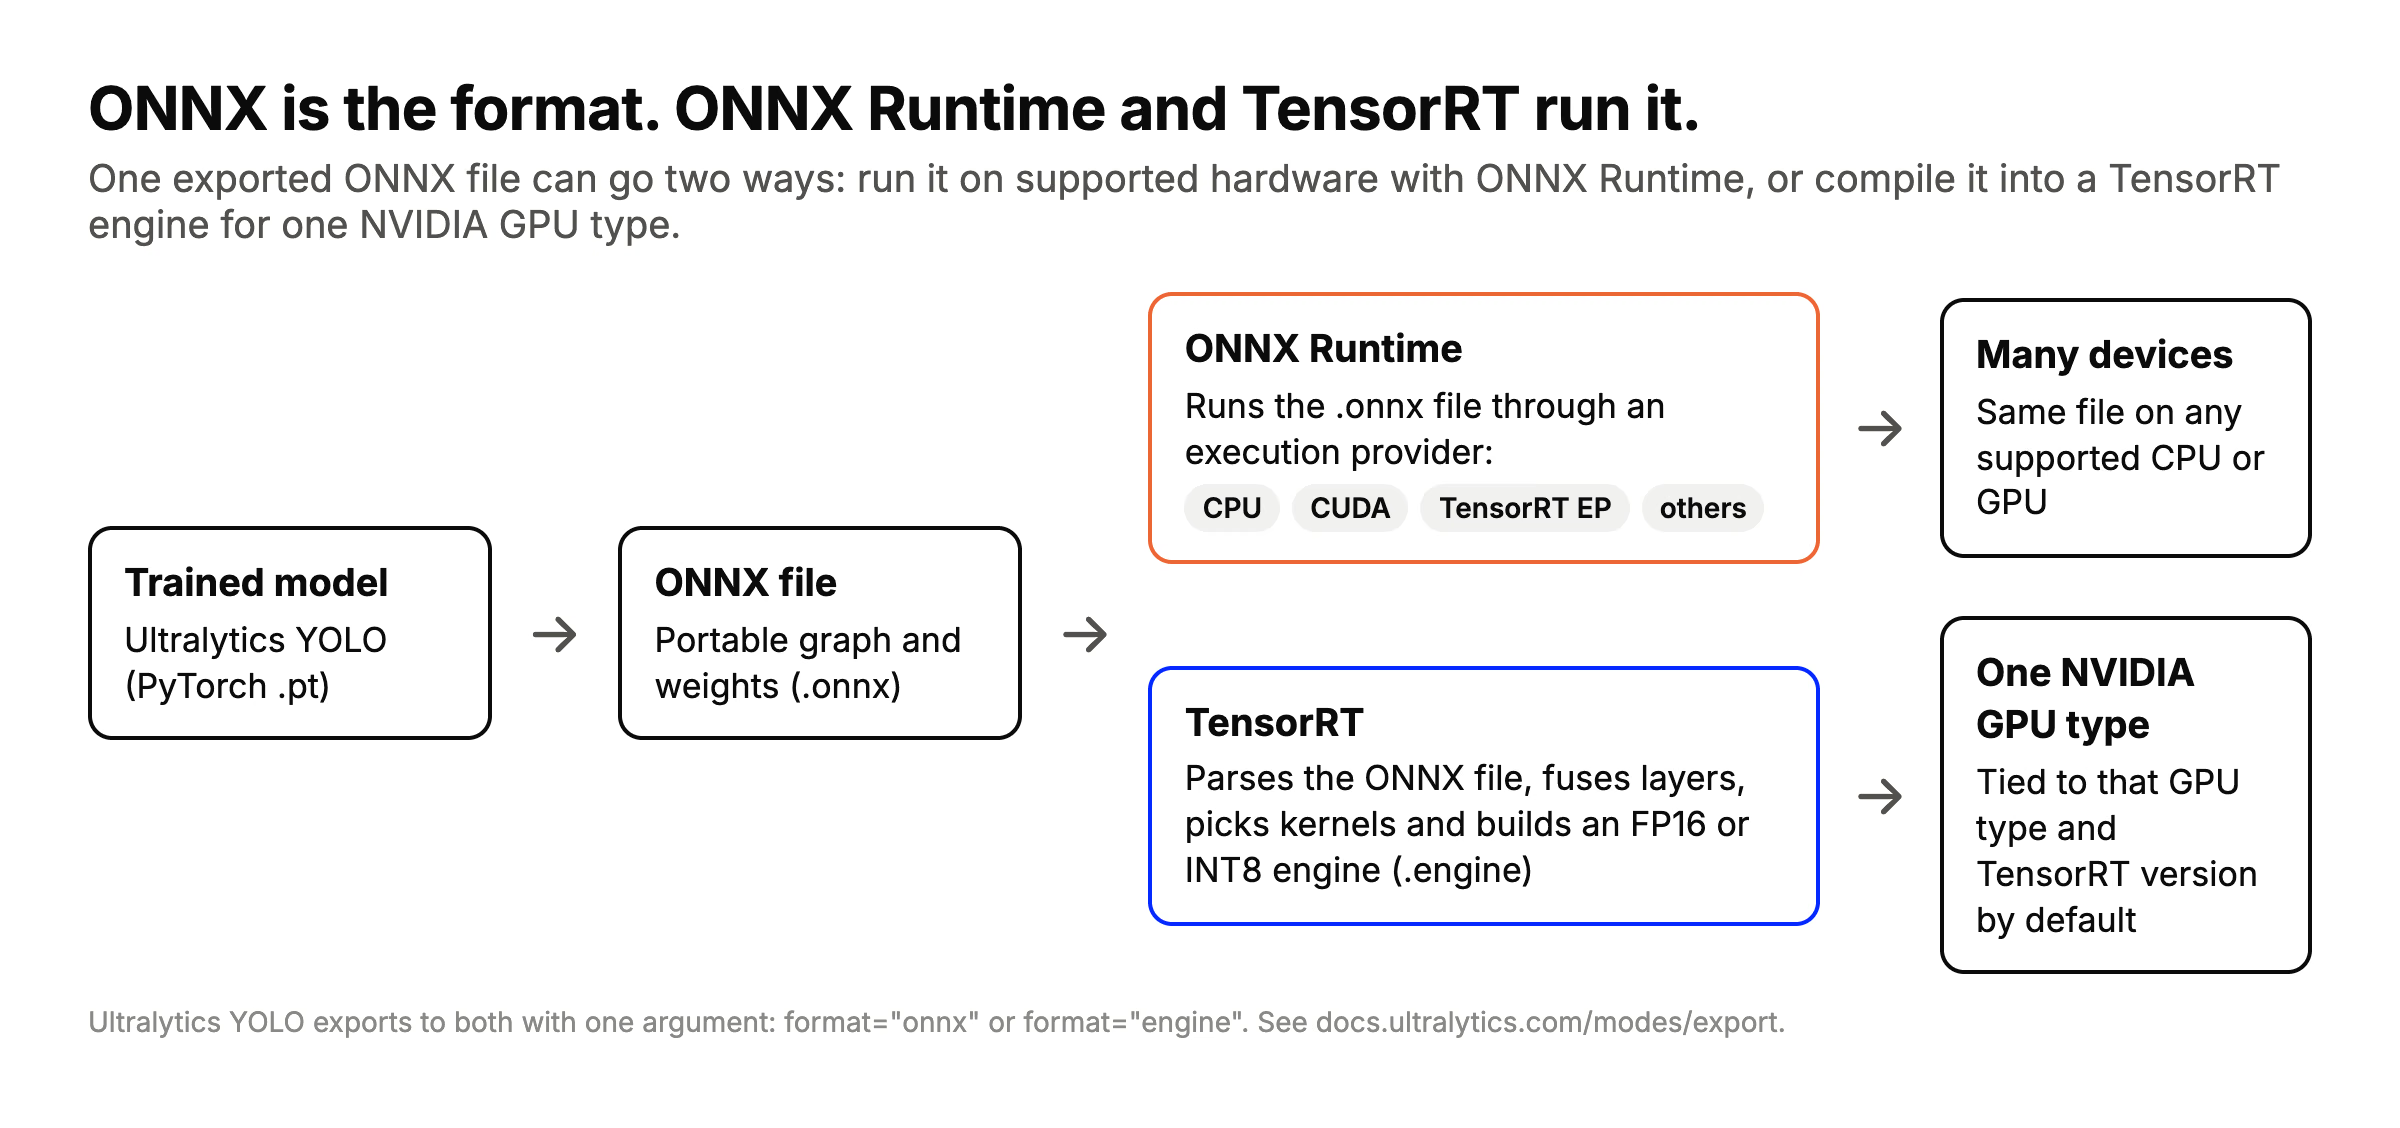
Un archivo ONNX, dos opciones: ONNX Runtime lo ejecuta en el hardware compatible, mientras que TensorRT lo compila en un motor para un tipo concreto de GPU NVIDIA. Ultralytics YOLO exporta a ambos formatos.
Comparativas: YOLO26 con ONNX Runtime frente a TensorRT#
Los datos que aparecen a continuación proceden de las comparativas de inferencia de Ultralytics Platform. Cada modelo de detección Ultralytics YOLO26 se exportó al formato indicado y, después, se midió su latencia de inferencia en GPU de Ultralytics Platform con un lote de 1 y 640 píxeles en COCO val2017; se excluyó el calentamiento y los tiempos de cada ejecución se filtraron mediante sigma clipping. La precisión es mAP50-95 en COCO val2017, medida una vez para cada formato y precisión. La comparación incluye las 19 GPU NVIDIA (Ampere, Ada y Hopper) que tienen resultados para los cuatro formatos.
La página de comparativas no especifica qué proveedor de ejecución de ONNX Runtime generó los resultados de ONNX ni identifica ningún resultado como obtenido con el proveedor de ejecución TensorRT de ONNX Runtime, que delega en TensorRT las partes compatibles del modelo. Estos resultados de ONNX describen la configuración evaluada; el rendimiento puede variar según el proveedor de ejecución de ONNX Runtime. Si quieres usar la API de ONNX Runtime con TensorRT por debajo, compara esa combinación en tu propio hardware.
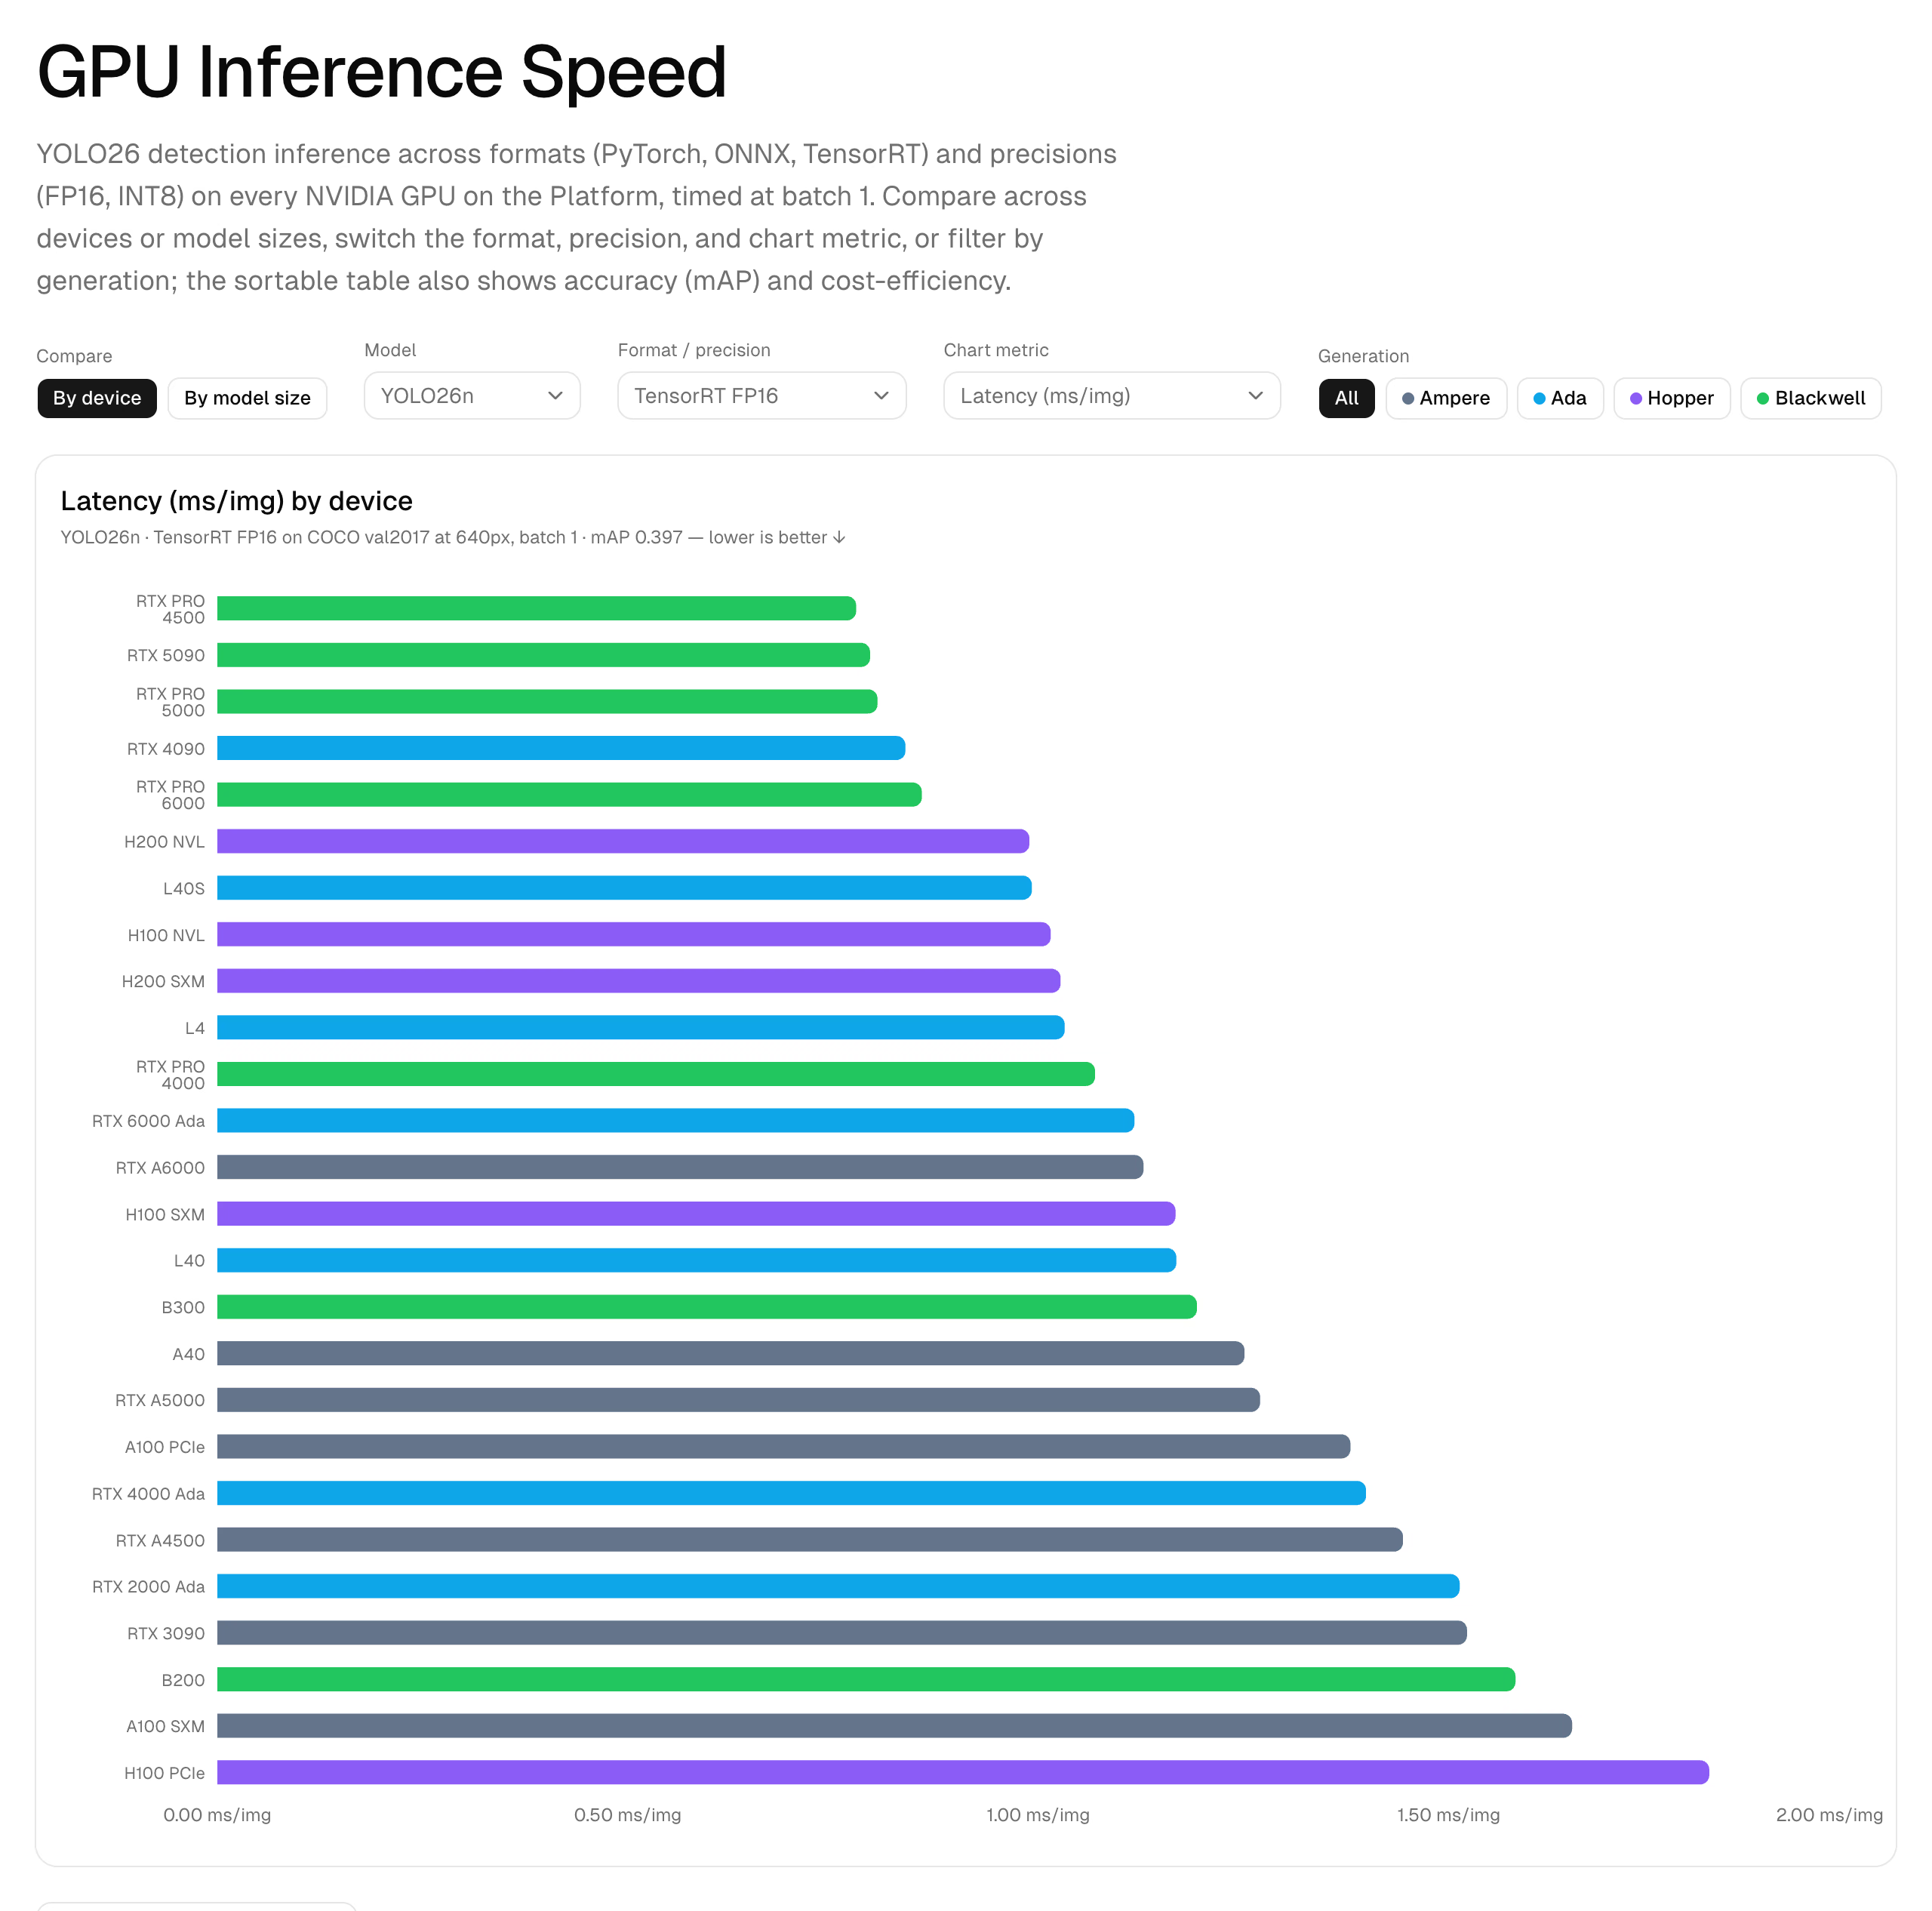
La pestaña Inferencia te permite cambiar el tamaño del modelo, el formato y la precisión, y ordenar las GPU por latencia, precisión o coste.
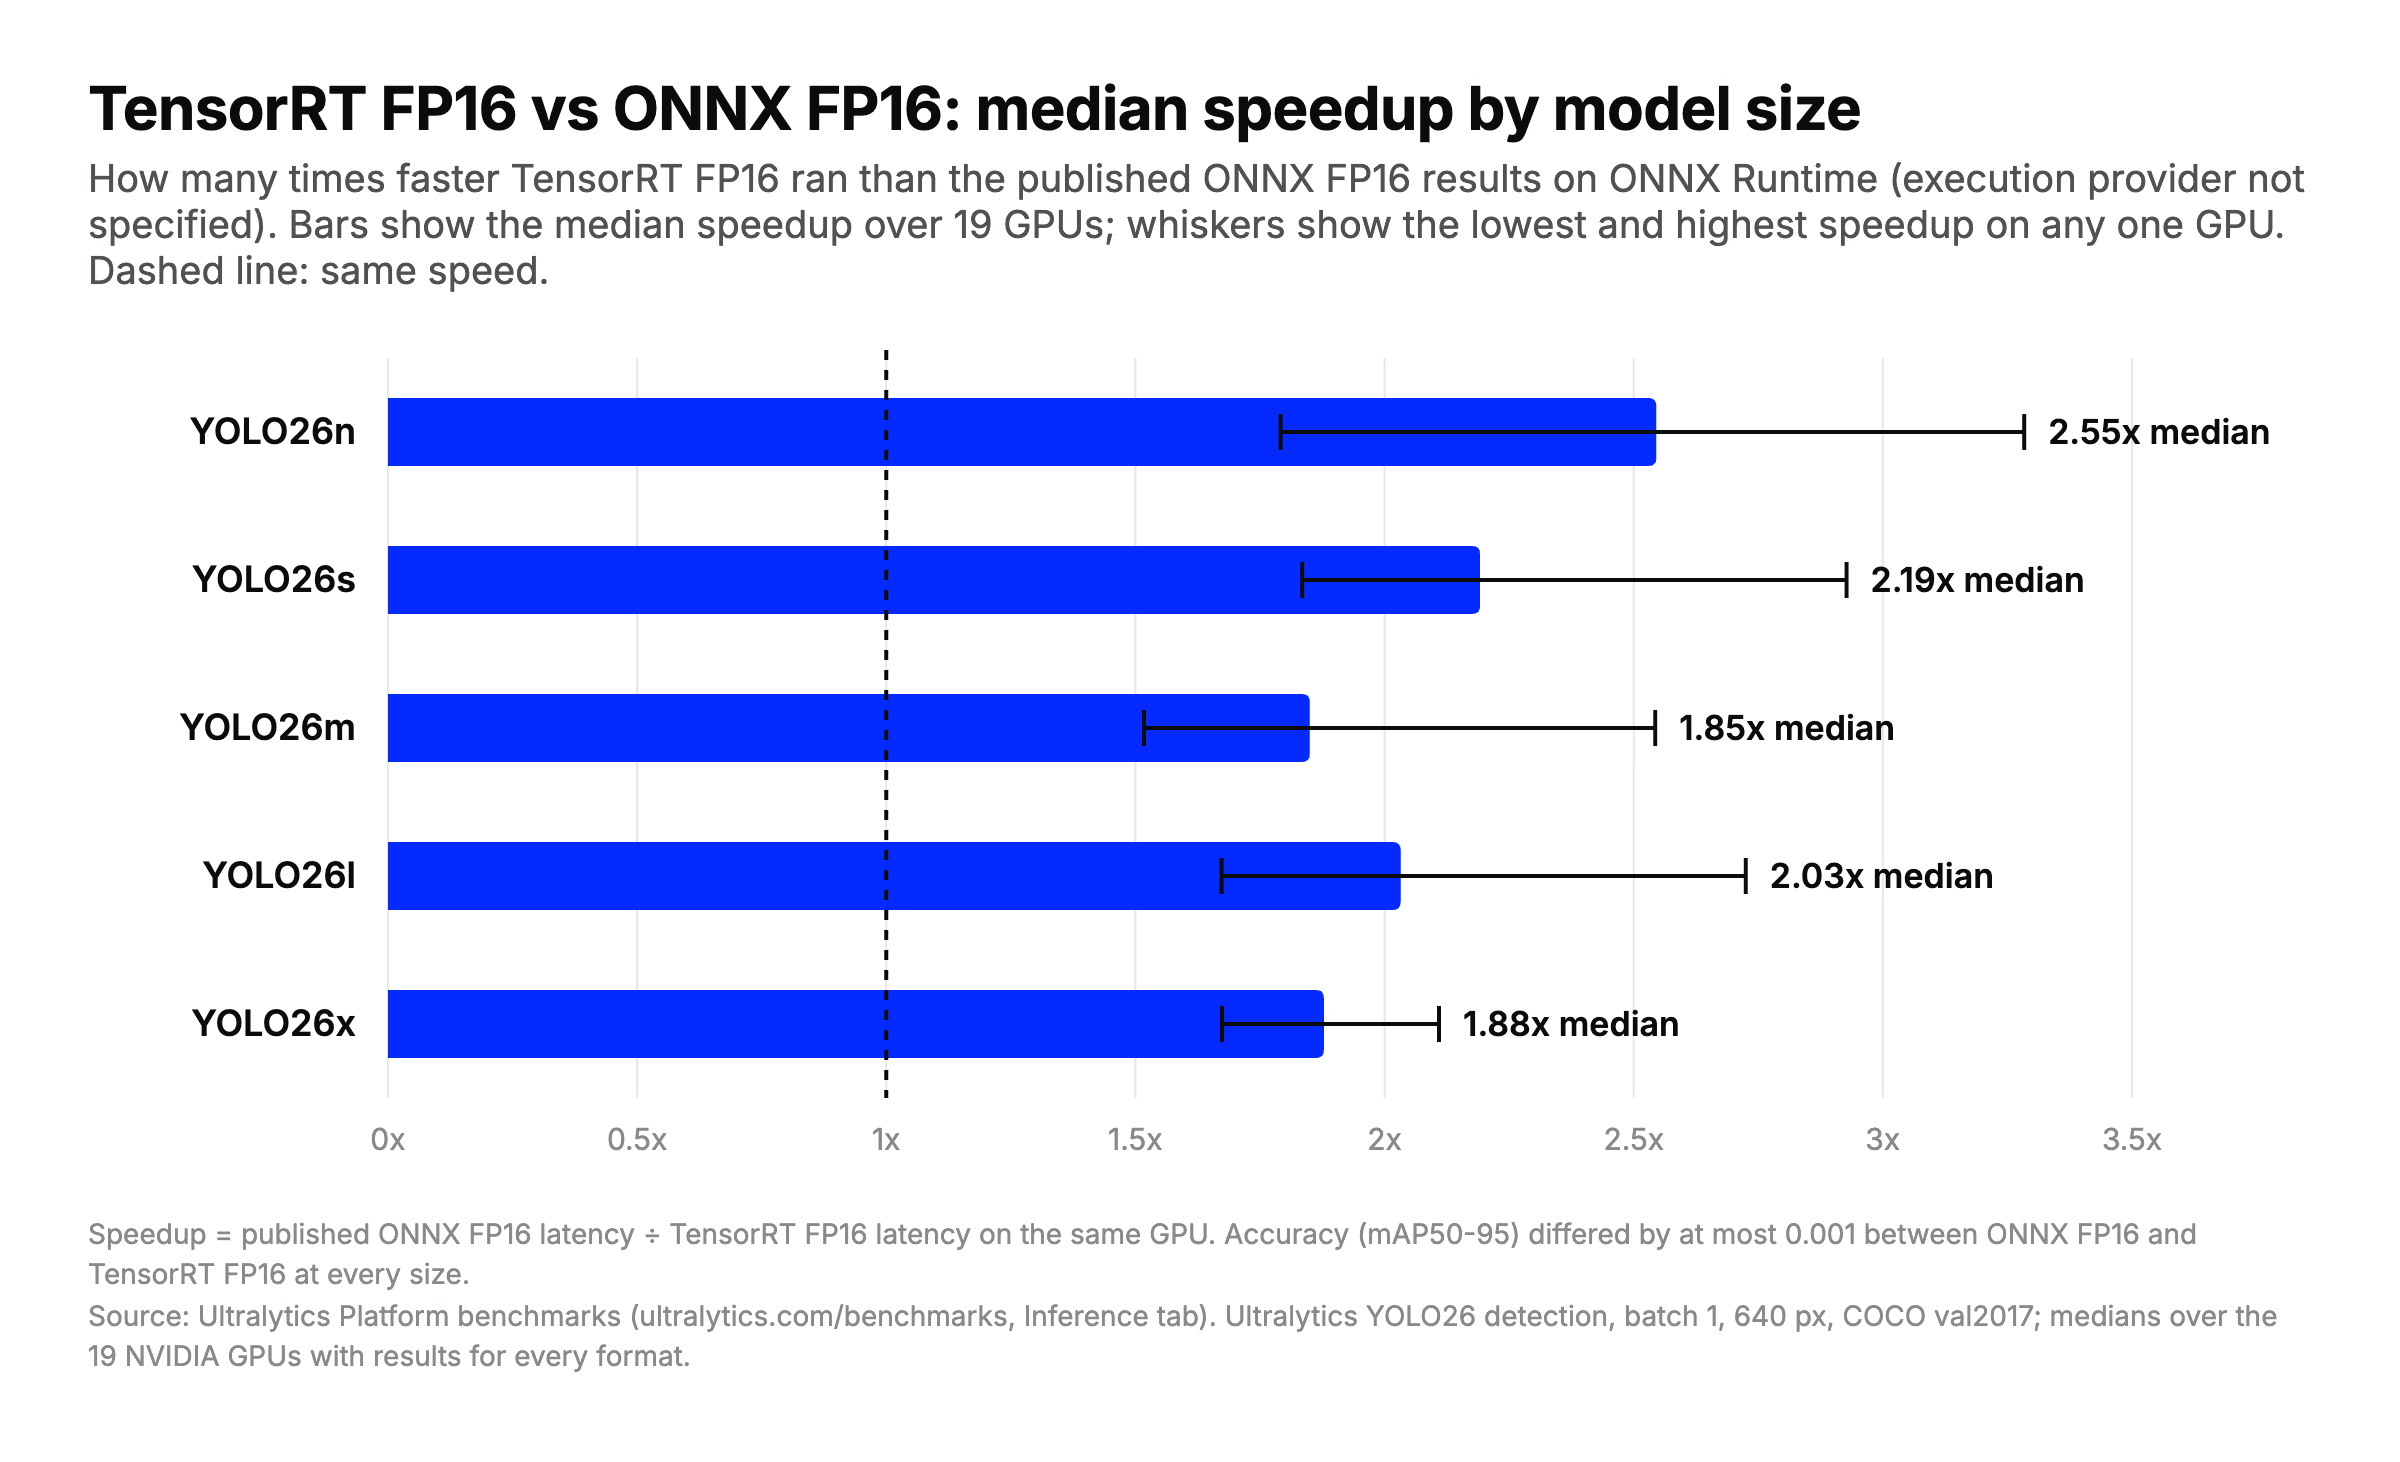
TensorRT FP16 fue más rápido que los resultados publicados de ONNX FP16 en todas las GPU y para todos los tamaños de modelo; la página no especifica qué proveedor de ejecución de ONNX Runtime los generó. Las barras muestran la mejora de velocidad mediana en 19 GPU; los bigotes indican la mejora mínima y máxima en una misma GPU. Cálculos realizados a partir de las comparativas de inferencia de Ultralytics Platform.
| Modelo | mAP50-95: ONNX FP16 | mAP50-95: TensorRT FP16 | mAP50-95: TensorRT INT8 | Mejora de velocidad de TensorRT FP16 frente a ONNX FP16 (mediana, intervalo) | Mejora de velocidad de TensorRT INT8 frente a TensorRT FP16 (mediana, intervalo) |
|---|---|---|---|---|---|
| YOLO26n | 0.397 | 0.397 | 0.357 | 2.55x (1.79–3.28x) | 0.90x (0.79–1.07x) |
| YOLO26s | 0.471 | 0.471 | 0.436 | 2.19x (1.83–2.93x) | 1.04x (0.89–1.19x) |
| YOLO26m | 0.519 | 0.519 | 0.470 | 1.85x (1.52–2.54x) | 1.20x (0.90–1.38x) |
| YOLO26l | 0.536 | 0.535 | 0.501 | 2.03x (1.67–2.73x) | 1.08x (0.92–1.33x) |
| YOLO26x | 0.563 | 0.564 | 0.488 | 1.88x (1.67–2.11x) | 1.19x (0.92–1.67x) |
Cálculos realizados a partir de las comparativas de inferencia de Ultralytics Platform. La mejora de velocidad es la latencia de ONNX FP16 ÷ la latencia de TensorRT FP16, o la latencia de TensorRT FP16 ÷ la latencia de TensorRT INT8, en la misma GPU; por tanto, los valores superiores a 1x indican que TensorRT FP16 (o INT8) fue más rápido. Las medianas se calculan con las 19 GPU NVIDIA que tienen resultados para los cuatro formatos; los intervalos corresponden a los cocientes mínimo y máximo de esas GPU. La precisión es el valor mAP50-95 publicado para cada formato y precisión. ONNX FP16 se refiere a los resultados publicados de ONNX Runtime, cuyo proveedor de ejecución no se especifica.
Latencia en cuatro GPU habituales, en milisegundos por imagen, según los datos publicados en la página de comparativas:
| GPU | Modelo | PyTorch FP16 | ONNX FP16 | TensorRT FP16 | TensorRT INT8 |
|---|---|---|---|---|---|
| L4 | YOLO26n | 4.98 | 2.04 | 1.03 | 1.09 |
| L4 | YOLO26x | 7.76 | 9.80 | 5.73 | 3.43 |
| RTX 4090 | YOLO26n | 6.67 | 2.56 | 0.84 | 1.00 |
| RTX 4090 | YOLO26x | 10.94 | 5.20 | 2.68 | 2.25 |
| A100 SXM | YOLO26n | 8.72 | 3.98 | 1.65 | 1.79 |
| A100 SXM | YOLO26x | 15.02 | 7.25 | 3.86 | 3.91 |
| H100 SXM | YOLO26n | 6.36 | 3.09 | 1.17 | 1.48 |
| H100 SXM | YOLO26x | 10.26 | 5.53 | 2.66 | 2.62 |
Hay tres aspectos destacados:
- TensorRT FP16 superó los resultados publicados de ONNX FP16 en todas las GPU y para todos los tamaños de modelo, con una precisión que se mantuvo dentro de 0.001 mAP50-95. Si vas a desplegar en estas GPU NVIDIA y necesitas baja latencia, empieza con TensorRT FP16.
- INT8 no siempre es mejor. En YOLO26n fue más lento que TensorRT FP16 en 17 de las 19 GPU y redujo la precisión en 0.04 mAP50-95. En los modelos más grandes aportó mejoras con más frecuencia, de hasta 1.67x en YOLO26x en una L4, pero redujo la precisión entre 0.034 y 0.076 mAP50-95.
- No hay resultados de ONNX para las siete GPU Blackwell. La página de comparativas lo atribuye a que ONNX Runtime no tenía kernels Blackwell en el entorno de prueba. TensorRT se ejecutó en las siete.
Estos resultados corresponden a la configuración de la página de comparativas, con un lote de 1 y 640 píxeles; por eso, compara tu propio modelo en el dispositivo de despliegue y con tus propios datos antes de elegir.
FP16 frente a INT8 con TensorRT#
La otra gran palanca es reducir la precisión, y la comparativa muestra por qué hay que probarlo:
- FP16 (precisión media) reduce a la mitad el tamaño de los pesos y las activaciones en comparación con FP32. En las comparativas de Ultralytics Platform, TensorRT FP16 igualó la precisión de ONNX FP16 y PyTorch FP16 con una diferencia máxima de 0.003 mAP50-95.
- INT8 almacena los pesos y las activaciones como enteros de 8 bits, una forma de cuantización de modelos. Requiere calibración: se procesan con el modelo un conjunto representativo de imágenes para medir los rangos de activación. La comparativa de Ultralytics Platform utilizó NVIDIA ModelOpt con COCO128 como datos de calibración.
Como indica la metodología de la comparativa, INT8 ofrece mejores resultados con modelos más grandes y limitados por la capacidad de cálculo. En los modelos más pequeños, el trabajo adicional de cuantización puede igualar o incluso ralentizar FP16. Calibra con imágenes de tu propio ámbito y valida la precisión con tus propios datos antes de desplegar un motor INT8.
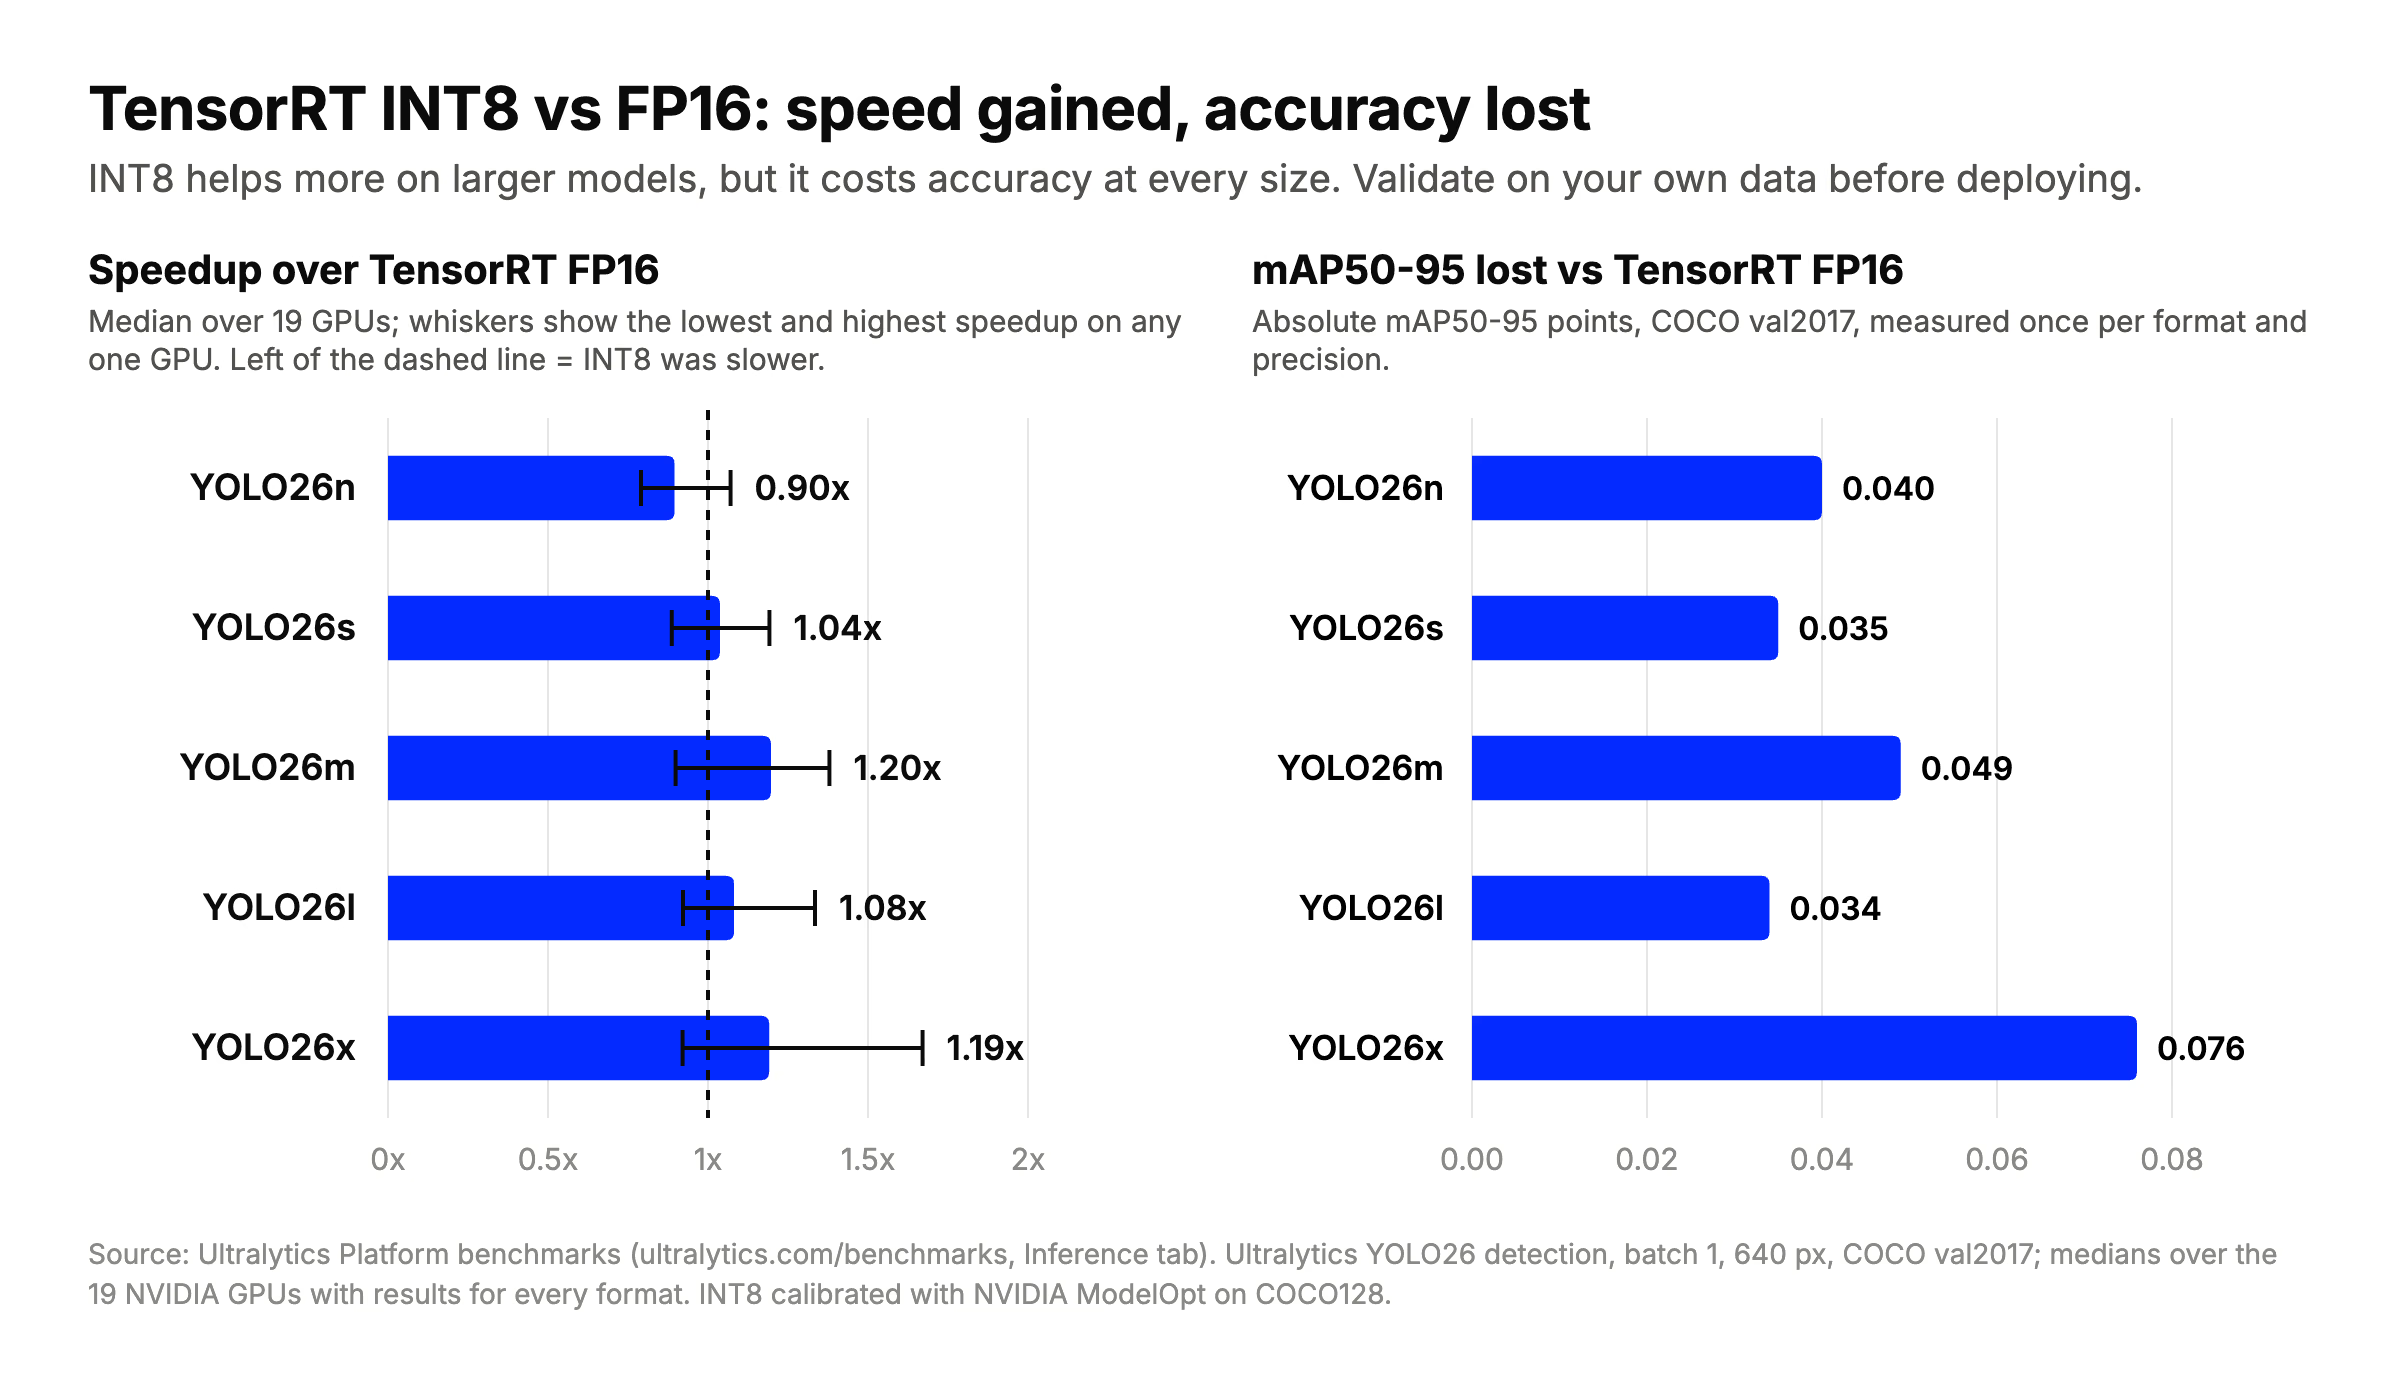
En la mediana, INT8 fue más lento que FP16 en YOLO26n y hasta aproximadamente 1.2x más rápido en los modelos más grandes, en las 19 GPU; en todos los tamaños, redujo la precisión entre 0.034 y 0.076 mAP50-95. Cálculos realizados a partir de las comparativas de inferencia de Ultralytics Platform.
Portabilidad de motores y tamaños de entrada dinámicos#
Por defecto, un motor TensorRT está vinculado a la GPU en la que se compila y a la versión de TensorRT utilizada, así que no está previsto copiar un motor compilado en una RTX 4090 a una H100 o una Jetson. TensorRT ofrece opciones de compatibilidad de hardware y versiones que relajan esta limitación, pero lo más seguro es compilarlo en el dispositivo de destino o para él, y volver a compilarlo después de actualizar TensorRT. Por este motivo, en la pestaña Exportar de Ultralytics Platform tienes que elegir un tipo de GPU para las exportaciones a TensorRT. Un archivo ONNX no tiene esa limitación: el mismo archivo funciona donde estén disponibles ONNX Runtime y un proveedor de ejecución adecuado.
Ambos formatos admiten tamaños de entrada variables. En TensorRT, las formas dinámicas necesitan un perfil de optimización que defina las dimensiones de entrada mínima, óptima y máxima, y las entradas en tiempo de ejecución deben ajustarse a ese perfil. Al exportar modelos Ultralytics YOLO, dynamic=True activa las formas de entrada dinámicas para ONNX y TensorRT. Las formas fijas dan a TensorRT más margen para optimizar, como explica la guía de NVIDIA sobre formas dinámicas; usa formas dinámicas si tus entradas varían realmente y compara ambas opciones.
Cuándo elegir ONNX Runtime y cuándo elegir TensorRT#
- GPU NVIDIA en la nube o en tus instalaciones, si la latencia es importante: TensorRT, empezando por FP16. Prueba INT8 con modelos más grandes después de calibrarlo y validar su precisión.
- NVIDIA Jetson en el edge: TensorRT. Consulta la guía de NVIDIA Jetson.
- CPU, hardware que no sea NVIDIA o flotas mixtas: ONNX con ONNX Runtime, usando el proveedor de ejecución compatible con cada máquina.
- Aún no sabes cuál será el hardware de despliegue: exporta primero a ONNX. Más adelante puedes crear un motor TensorRT a partir del mismo modelo.
- CPU, GPU o NPU Intel: plantéate usar OpenVINO, el kit de herramientas de inferencia de Intel.
Para ver la lista completa de formatos y compararlos, consulta la guía de opciones de despliegue de modelos. La precisión no es el único factor: también importan el tamaño del modelo y la resolución de entrada; nuestra guía sobre poda y cuantización explica otras dos formas de reducir el tamaño de un modelo.
Exportar Ultralytics YOLO a ONNX y TensorRT#
Ultralytics YOLO exporta a ambos formatos con un único argumento format, y puedes ejecutar predicciones o validar directamente el modelo exportado:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

model.export(format="onnx", quantize=16)  # ONNX FP16, para ONNX Runtime
model.export(format="engine", quantize=16)  # Motor TensorRT FP16, compilado en esta GPU
# Para usar INT8, calibra con un YAML de conjunto de datos (coco8.yaml es un conjunto pequeño de demostración; usa el tuyo):
# model.export(format="engine", quantize=8, data="coco8.yaml")

trt_model = YOLO("yolo26n.engine")
results = trt_model("https://ultralytics.com/images/bus.jpg")
quantize=16 selecciona FP16 y quantize=8 selecciona INT8. Ambas exportaciones a motor generan yolo26n.engine, así que ejecuta una u otra. Para INT8, indica tu propio YAML de conjunto de datos en data para que la calibración use imágenes similares a las de tu despliegue. Consulta los argumentos de exportación y las guías de integración de ONNX y TensorRT para ver todas las opciones, o sigue nuestras publicaciones paso a paso sobre cómo exportar a ONNX y optimizar con TensorRT. También puedes exportar modelos entrenados desde el navegador en Ultralytics Platform.
Preguntas frecuentes
ONNX es un formato de modelo, no un motor, así que la comparación más justa es ONNX Runtime frente a TensorRT. En las comparativas de Ultralytics Platform de Ultralytics YOLO26 en 19 GPU NVIDIA, TensorRT FP16 fue más rápido que los resultados publicados de ONNX FP16 en ONNX Runtime en todas las GPU, con mejoras medianas calculadas de entre 1.85x y 2.55x según el tamaño del modelo, y diferencias de mAP50-95 de 0.001 como máximo. La comparativa no indica qué proveedor de ejecución de ONNX Runtime generó los resultados de ONNX, y ninguno figura como obtenido con su proveedor de ejecución TensorRT; por tanto, prueba esa combinación por tu cuenta si necesitas la API de ONNX Runtime.
Sí. ONNX suele ser la entrada de TensorRT: su analizador ONNX lee el modelo y crea un motor a partir de él. ONNX Runtime también puede llamar a TensorRT mediante su proveedor de ejecución TensorRT.
No. En las comparativas de Ultralytics Platform, TensorRT INT8 fue más lento que TensorRT FP16 para YOLO26n en 17 de las 19 GPU. Fue más rápido con mayor frecuencia en los modelos más grandes, con una mediana de aproximadamente 1.2x en YOLO26m y YOLO26x en las 19 GPU que ejecutaron todos los formatos. En cada caso, redujo la precisión entre 0.034 y 0.076 mAP50-95, así que valida primero el modelo INT8 con tus propios datos.
No cuentes con ello. Por defecto, un motor TensorRT está vinculado a la GPU y a la versión de TensorRT con las que se compiló; por tanto, compílalo en el dispositivo de destino o para él. Guarda el archivo ONNX como copia portátil y vuelve a compilar el motor para cada dispositivo de destino.
Lo habitual es elegir TensorRT: JetPack de NVIDIA incluye TensorRT, y compilar el motor en la propia Jetson lo optimiza para ese dispositivo. Las comparativas anteriores no incluyen Jetson, así que mide el rendimiento en tu módulo antes de decidir. La guía de NVIDIA Jetson explica paso a paso la configuración y la exportación para Ultralytics YOLO.
Escrito por
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









