Qwen4-Max para anotación automática: conjuntos de datos destacados y mejoras desiguales
Qwen4-Max ocupa el puesto 13 de 51 en nuestro benchmark de anotación automática, el primero en radiografías de muñeca y el segundo en estanterías comerciales. Precisión, coste y cómo ejecutarlo.
 Miles Deans14 min de lectura
Alibaba lanzó Qwen4-Max el 16 de noviembre de 2026 y lo describió como el modelo más capaz de la familia Qwen hasta la fecha, con visión nativa y una ventana de contexto de un millón de tokens. Ese mismo día, lo probamos con UL37, nuestro benchmark de detección con 36 conjuntos de datos.
En general, Qwen4-Max ocupa el puesto 13 de 51 modelos en nuestra clasificación de VLM, con 0.474 mAP50 por 5,68 $ cada 1000 imágenes. Ese promedio oculta un resultado más notable. En radiografías pediátricas de muñeca, obtiene la puntuación más alta de todos los modelos que hemos probado y solo queda por detrás de Gemini 4 Carbon en escenas submarinas y estanterías comerciales muy abarrotadas.
Qwen4-Max ya es la opción de Alibaba para la anotación automática en Ultralytics Platform, donde sustituye a Qwen3.8-Max. A continuación, explicamos en qué destaca, dónde se queda corto, cómo se compara con los modelos que tendrías en cuenta y cuánto cuesta una tanda de etiquetado.
Qwen4-Max ocupa el puesto 13 de 51 en UL37 y el primero en radiografías de muñeca#
UL37 mide hasta qué punto coinciden las cajas de un modelo con las etiquetas humanas en 360 imágenes: 10 de cada uno de los 36 conjuntos de datos reales de detección de objetos, desde exploraciones médicas e imágenes aéreas hasta estanterías comerciales, deportes y placas de circuitos. Cada conjunto de datos tiene el mismo peso en el promedio, y todas las imágenes pasan por la misma cadena de producción que utilizan los usuarios de Platform, con los nombres de clase propios del conjunto de datos y SAM 3.1 para perfeccionar cada caja; por eso, las puntuaciones describen esa cadena ya refinada, no los resultados sin procesar del modelo. La metodología es pública.
| Qwen4-Max | Qwen3.8-Max | GPT-6.1 Terra | Gemini 3.8 Flash | Kimi K3.1 Pro | |
|---|---|---|---|---|---|
| Puesto en la clasificación | #13 de 51 | #15 de 51 | #3 de 51 | #11 de 51 | #16 de 51 |
| mAP50 | 0.474 | 0.461 | 0.560 | 0.516 | 0.444 |
| mAP50-95 | 0.301 | 0.295 | 0.345 | 0.321 | 0.281 |
| Precisión | 0.595 | 0.572 | 0.646 | 0.656 | 0.560 |
| Exhaustividad | 0.561 | 0.524 | 0.613 | 0.555 | 0.483 |
| Coste del proveedor por cada 1.000 imágenes | $5.68 | $7.74 | $4.36 | $5.86 | $22.50 |
| Tiempo mediano por imagen | 12.4 s | 13.1 s | 5.1 s | 7.4 s | 22.2 s |
| Solicitudes fallidas | 0% | 1.7% | 0% | 0% | 6.4% |
Resultados de UL37 de la clasificación de VLM de Ultralytics, actualizada el 19 de noviembre de 2026. Qwen3.8-Max ya no se ofrece en Platform.
Qwen4-Max mejora todas las métricas principales de Qwen3.8-Max, cuesta menos por imagen y completó todas las solicitudes del benchmark. Aun así, queda muy por detrás de los líderes en promedio: GPT-6.1 Terra obtiene 0.560 por menos dinero y en menos de la mitad de tiempo.
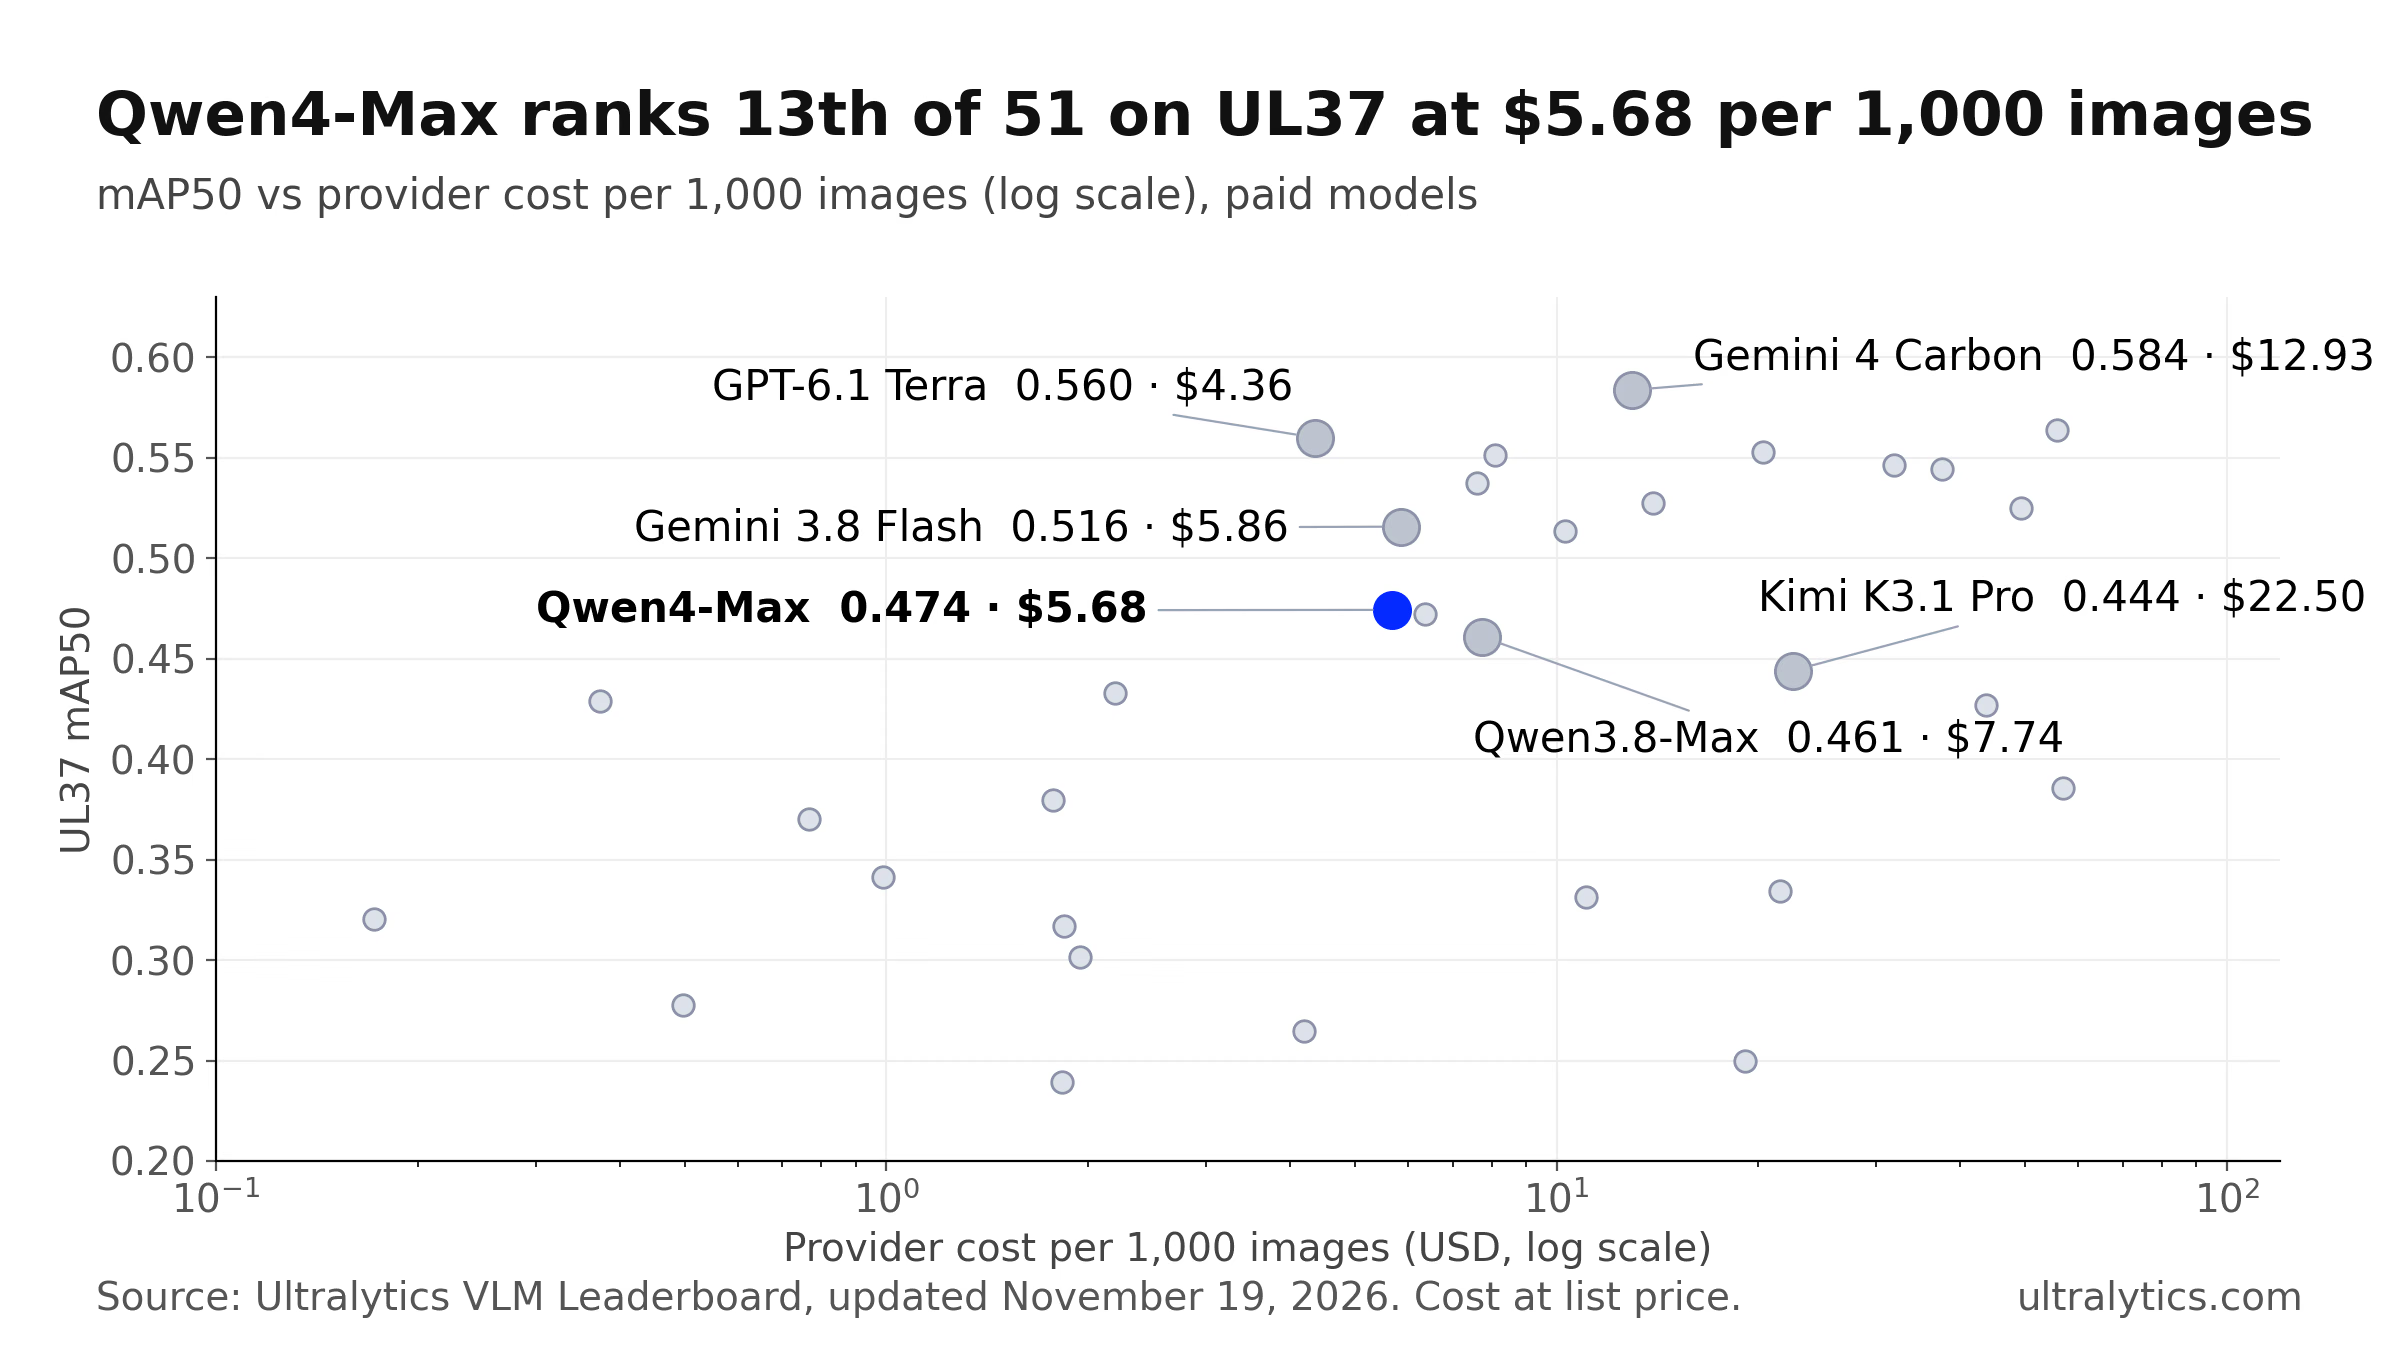
Cada punto representa un modelo de pago de la clasificación de VLM de Ultralytics.
Para qué creó Alibaba Qwen4-Max#
En su anuncio de lanzamiento, Alibaba describe Qwen4-Max como un modelo disperso de mezcla de expertos, con 2,4 billones de parámetros en total, de los que 71 000 millones están activos por token, y con visión nativa. Destaca sus capacidades de programación, tareas con agentes y razonamiento visual, y afirma que, en su propio benchmark Work360, Qwen4-Max supera a Qwen3.8-Max y reduce alrededor de un 60 % el coste medio por tarea.
Las notas de la versión de Model Studio de Alibaba Cloud lo describen como «el modelo multimodal insignia de nueva generación de la familia Qwen, que combina generación de texto, comprensión de imágenes y vídeos, y razonamiento profundo». Su precio internacional es de 1,50 $ por millón de tokens de entrada y 4,50 $ por millón de tokens de salida, frente a los 2 $ y 6 $ de Qwen3.8-Max. El modelo está disponible a través de la API de Alibaba; Alibaba afirma que pronto llegarán modelos Qwen4 más pequeños con pesos abiertos.
Ni el anuncio ni las notas de la versión incluyen resultados de detección de objetos, así que eso es lo que medimos.
Qwen4-Max frente a Qwen3.8-Max: más barato, con mejoras desiguales#
Qwen4-Max supera a su predecesor en 19 conjuntos de datos, queda por detrás en 16 y empata en uno. Su mejora media de 0.013 mAP50 se debe a grandes avances en algunos conjuntos de datos que compensan claros retrocesos en otros.
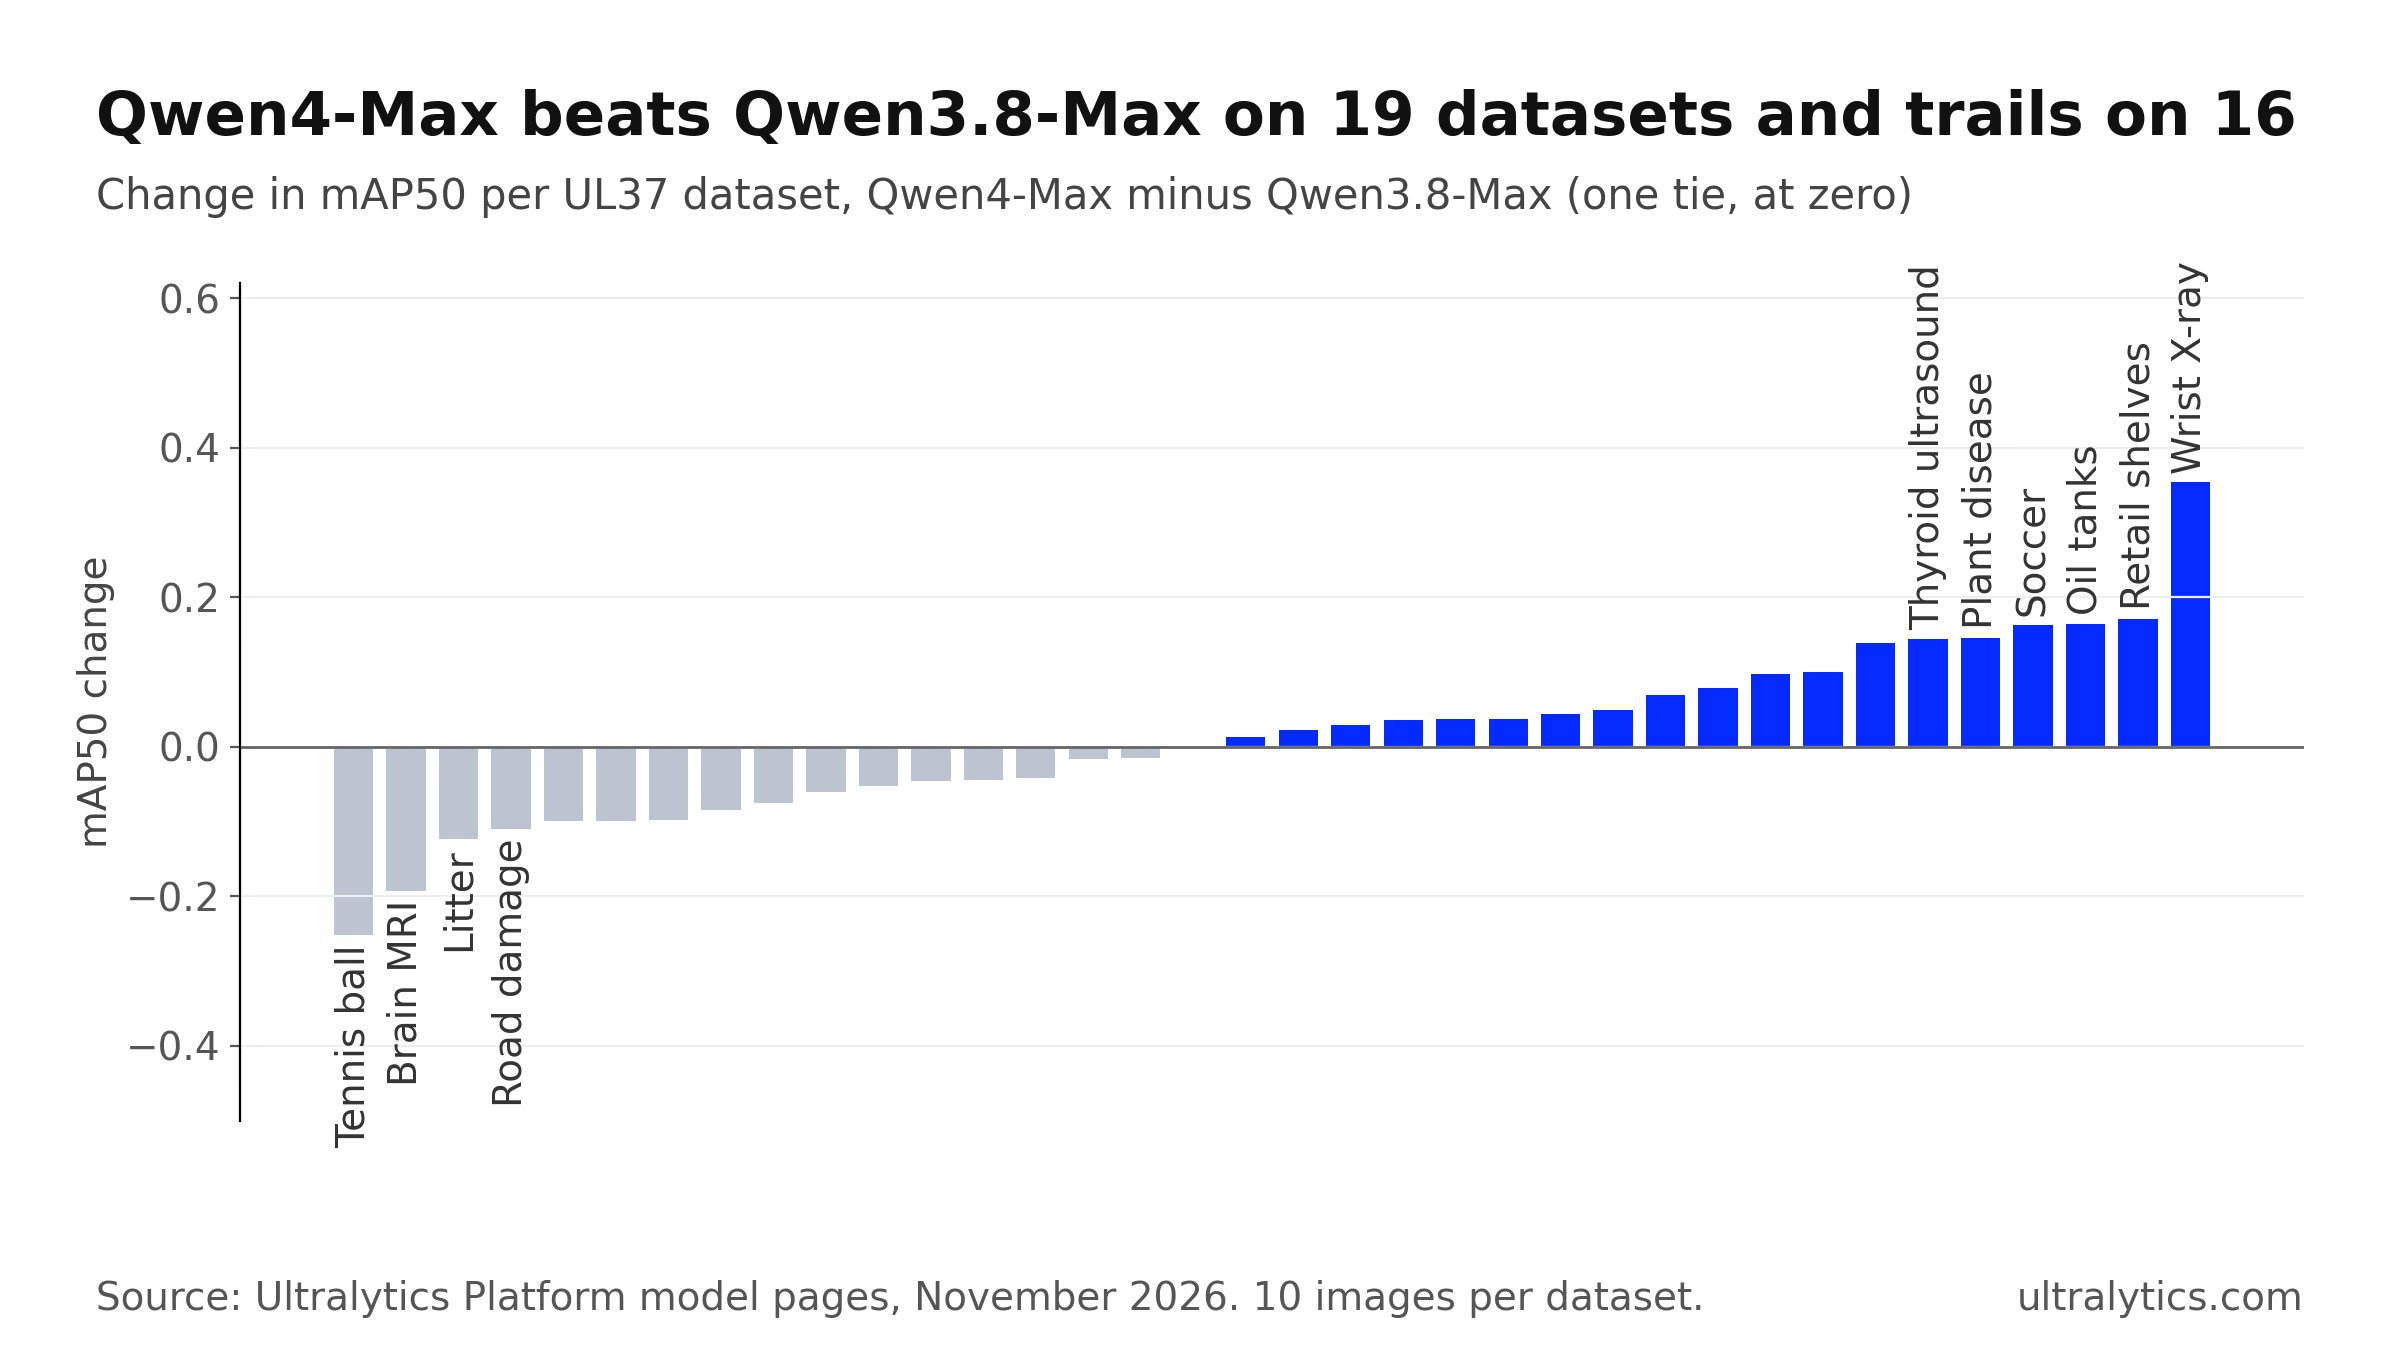
Cada barra representa un conjunto de datos de UL37, ordenados desde el mayor retroceso hasta la mayor mejora.
| Conjunto de datos | Qwen4-Max | Qwen3.8-Max | Cambio |
|---|---|---|---|
| Radiografía pediátrica de muñeca de GRAZPEDWRI-DX | 0.4975 | 0.1437 | +0.3538 |
| Estanterías comerciales abarrotadas de SKU110K | 0.6230 | 0.4516 | +0.1714 |
| Depósitos de almacenamiento de petróleo de Airbus | 0.3005 | 0.1363 | +0.1642 |
| Fútbol de SoccerDB | 0.8345 | 0.6715 | +0.1630 |
| Pelota de tenis de RacketVision | 0.3775 | 0.6299 | −0.2524 |
| Resonancia magnética de tumor cerebral de Cheng | 0.4421 | 0.6350 | −0.1929 |
mAP50 de UL37 por conjunto de datos, 10 imágenes por conjunto, con cuatro decimales para que cada cambio coincida con sus dos puntuaciones.
La reducción del coste es más clara. A 5,68 $ por cada 1000 imágenes, frente a 7,74 $, Qwen4-Max cuesta alrededor de un 27 % menos por imagen en nuestra prueba. La cifra de aproximadamente el 60 % de Alibaba procede de otro benchmark con parámetros distintos, así que no son directamente comparables.
En qué destaca Qwen4-Max#
Tres resultados sitúan a Qwen4-Max entre los mejores de toda la clasificación, no solo de la familia Qwen.
| Conjunto de datos | Qwen4-Max | Puesto entre 51 | Líder |
|---|---|---|---|
| Radiografía pediátrica de muñeca de GRAZPEDWRI-DX | 0.4975 | 1st | Qwen4-Max (siguiente: Muse Ember 1.0, 0.378) |
| Objetos submarinos de RUOD | 0.774 | 2nd | Gemini 4 Carbon, 0.788 |
| Estanterías comerciales abarrotadas de SKU110K | 0.623 | 2nd | Gemini 4 Carbon, 0.671 |
mAP50 de UL37 por conjunto de datos. Puesto entre los 51 modelos de la clasificación de VLM de Ultralytics.
Radiografías de muñeca. En radiografías pediátricas de muñecas con traumatismos, Qwen4-Max obtiene 0.4975, por delante de todos los demás modelos que hemos probado y más del triple que Qwen3.8-Max. Cada conjunto de datos aporta 10 imágenes, así que considéralo un indicio sólido para hacer pruebas, no una conclusión definitiva. Tampoco constituye un diagnóstico ni una validación clínica: para la anotación de investigación en análisis de imágenes médicas, Qwen4-Max puede proponer cajas para que los expertos clínicos las revisen y corrijan.
Estanterías comerciales. Si se promedian los dos conjuntos de datos comerciales de UL37, Qwen4-Max obtiene 0.752, por delante del 0.724 de GPT-6.1 Terra. En SKU110K, donde las estanterías están repletas de productos de una sola clase, solo queda por detrás de Gemini 4 Carbon.
Escenas submarinas. En los objetos submarinos de RUOD, obtiene 0.774, el segundo mejor resultado de 51, por delante del 0.658 de GPT-6.1 Terra.
En qué se queda corto Qwen4-Max#
Las carencias son tan claras como los aciertos. Qwen4-Max obtiene 0.000 en los defectos de placas sin componentes de DeepPCB y 0.05 en las inspecciones de seguridad con rayos X de IEDXray, donde los modelos Gemini 4 rondan el 0.30. En las radiografías de tórax para detectar tuberculosis obtiene 0.037 y, en el conjunto de datos de resonancias magnéticas de tumores cerebrales, queda por detrás de GPT-6.1 Terra, con 0.442 frente a 0.904.
Al promediar los resultados por ámbito, también queda por detrás de GPT-6.1 Terra en documentos, interfaces de usuario y dibujos CAD (0.357 frente a 0.494), carreteras y tráfico (0.396 frente a 0.572) e imágenes médicas en general (0.325 frente a 0.505). Antes de etiquetar un conjunto de datos grande de cualquiera de estos ámbitos, abre la página del modelo Qwen4-Max, que muestra las cajas registradas para cada conjunto de datos del benchmark junto a las etiquetas esperadas.
Qwen4-Max frente a GPT-6.1 Terra, Gemini 3.8 Flash y Kimi K3.1 Pro#
| Cara a cara en los 36 conjuntos de datos de UL37 | Qwen4-Max gana | Pierde | Empata |
|---|---|---|---|
| frente a GPT-6.1 Terra | 11 | 23 | 2 |
| frente a Gemini 3.8 Flash | 17 | 18 | 1 |
| frente a Kimi K3.1 Pro | 21 | 14 | 1 |
| frente a Qwen3.8-Max | 19 | 16 | 1 |
GPT-6.1 Terra es la mejor opción general: gana en 23 conjuntos de datos, frente a los 11 de Qwen4-Max, cuesta menos y su tiempo de respuesta mediano es menos de la mitad. Gemini 3.8 Flash ofrece resultados casi igualados en los conjuntos de datos, con un precio similar y una puntuación media superior. Frente a Kimi K3.1 Pro, Qwen4-Max gana en 21 conjuntos de datos, frente a los 14 de Kimi, y cuesta aproximadamente una cuarta parte por imagen.
Cómo ejecuta Qwen4-Max Ultralytics Platform#
Dos ajustes influyen en los resultados de Qwen4-Max en Platform. En primer lugar, se ejecuta con el nivel de razonamiento «low» de Alibaba, no con el valor predeterminado «high». En las pruebas de Ultralytics con las 370 imágenes del benchmark (las 360 imágenes puntuadas más 10 imágenes de referencia de COCO), el valor predeterminado superó el límite de solicitud de 115 segundos de Platform en 11 imágenes, mientras que «low» lo superó en 3, con el mismo mAP50. En segundo lugar, Platform solicita a los modelos Qwen resultados JSON compactos, porque sin ellos pierden alrededor de 0.02 mAP50.
No tienes que hacer nada con ninguno de los dos ajustes: selecciona Qwen4-Max en el selector de modelos y Platform los aplica.
Cuánto cuesta una tanda de anotación con Qwen4-Max#
El coste del proveedor corresponde al uso de tokens declarado por Alibaba, calculado con las tarifas del modelo en Platform por cada 1000 imágenes anotadas correctamente; tus propias imágenes pueden consumir más o menos tokens. Batch Annotation añade una tarifa de procesamiento de Platform de 1,00 $ por cada 1000 imágenes, con un mínimo de 0,01 $ por ejecución.
| Por cada 1.000 imágenes | Qwen4-Max |
|---|---|
| Cargos de Alibaba | $5.68 |
| Procesamiento de Ultralytics Platform | $1.00 |
| Total | $6.68 |
Pagas directamente a Alibaba con tu propia clave de API, también por las predicciones de prueba que ejecutes primero, y Ultralytics no aplica ningún recargo a los tokens. Si prefieres no usar ninguna clave de pago, el modelo Qwen3.8 27B, alojado en Platform, funciona sin necesidad de una y alcanza un mAP50 de 0.351 en UL37.
Cómo ejecutar la anotación automática con Qwen4-Max en Ultralytics Platform#
Qwen4-Max es un modelo guiado por clases para conjuntos de datos de detección con entre 1 y 200 clases. Devuelve cajas delimitadoras para los nombres de clase propios de tu conjunto de datos, que después puedes revisar y corregir.
- Crea una clave de API en Model Studio de Alibaba Cloud para la región internacional (Singapur), que es el endpoint que utiliza Platform.
- Pide al propietario del espacio de trabajo que la añada en Alibaba, en Configuración > Claves de API, dentro del espacio de trabajo que contiene tu conjunto de datos. La documentación sobre claves del proveedor explica los detalles.
- En el editor de anotaciones, cambia al modo Smart y elige Qwen4-Max en Alibaba, dentro del selector de modelos.
- Pulsa Predict o
Pen unas cuantas imágenes representativas de tus datos. - Cuando estés conforme, abre la página del conjunto de datos y elige Más acciones > Anotación por lotes para etiquetar todas las imágenes sin etiquetar. Batch Annotation funciona con conjuntos de datos alojados en Platform que tengan hasta tres canales de imagen. Platform guarda primero una versión del conjunto de datos para que puedas volver atrás.
- Revisa los cuadros, guárdalos y entrena un modelo Ultralytics YOLO26 con el resultado en el mismo espacio de trabajo.
La documentación de anotación explica en detalle el modo Smart y Batch Annotation, y nuestra guía para elegir un VLM según su precisión y exhaustividad te ayudará a encontrar el modelo adecuado para tu flujo de revisión.
Quién debería usar Qwen4-Max#
| Si necesitas… | Empieza con |
|---|---|
| Un anotador de pago de propósito general | GPT-6.1 Terra: mayor puntuación en UL37, menor coste y más rápido que Qwen4-Max |
| Borradores de radiografías pediátricas de muñeca para que los revise un experto | Qwen4-Max: la puntuación más alta de los 51 modelos en este conjunto de datos de UL37 |
| Estanterías comerciales abarrotadas o escenas submarinas | Qwen4-Max y comparación con Gemini 4 Carbon usando tus imágenes |
| Un modelo de Alibaba o una alternativa a Qwen3.8-Max | Qwen4-Max: puntuaciones más altas, menor coste por imagen y ninguna solicitud fallida en nuestra prueba |
| Sin una clave de API de pago | Qwen3.8 27B, Gemma 4 26B o SAM 3.1 Text, alojados en Platform |
Para la mayoría de las tareas de etiquetado, GPT-6.1 Terra sigue siendo la mejor opción predeterminada. Qwen4-Max merece la pena cuando tus datos se parecen a los conjuntos de datos en los que destaca, así que pruébalo primero con una muestra de tus propias imágenes.
Preguntas frecuentes
Ocupa el puesto 13 de 51 en nuestro benchmark y obtiene algunos resultados destacados. En nuestro benchmark UL37 alcanza 0.474 mAP50, ocupa el puesto 13 de 51 modelos y no registra ninguna solicitud fallida. Queda primero de 51 en radiografías pediátricas de muñeca y segundo en objetos submarinos y estanterías comerciales abarrotadas, pero obtiene malos resultados en defectos de placas de circuitos y radiografías de seguridad.
De media, sí. Qwen4-Max obtiene 0.474 mAP50, frente a 0.461, cuesta 5,68 $ por cada 1000 imágenes, frente a 7,74 $, y completó todas las solicitudes, mientras que Qwen3.8-Max falló en el 1,7 %. Las mejoras son desiguales: supera a Qwen3.8-Max en 19 conjuntos de datos y queda por detrás en 16, con grandes retrocesos en la detección de pelotas de tenis y en resonancias magnéticas cerebrales.
Para el etiquetado general, GPT-6.1 Terra: obtiene 0,560 mAP50, gana en 23 de 36 conjuntos de datos frente a Qwen4-Max, cuesta 4,36 $ por cada 1.000 imágenes y tiene un tiempo de respuesta mediano de 5,1 segundos. Elige Qwen4-Max cuando tus datos se parezcan a los de sus conjuntos de datos más destacados, como radiografías de muñecas, estanterías comerciales abarrotadas o escenas submarinas, y comprueba el rendimiento con tus propias imágenes.
Puede proponer cuadros para anotaciones de investigación que revisen expertos; no realiza diagnósticos. Obtiene la puntuación UL37 más alta de 51 modelos en radiografías pediátricas de muñecas, con 0,4975 mAP50, pero alcanza una media de 0,325 en nuestros ocho conjuntos de datos médicos, por debajo del 0,505 de GPT-6.1 Terra, y obtiene malos resultados en radiografías de tórax.
Unos 5,68 $ en cargos de Alibaba: uso de tokens declarado por Alibaba, calculado con las tarifas de Platform para el modelo por cada 1.000 imágenes anotadas correctamente. El precio de lista internacional de Alibaba es de 1,50 $ por millón de tokens de entrada y 4,50 $ por millón de tokens de salida. Ultralytics Platform añade una tarifa de Anotación por lotes de 1,00 $ por cada 1.000 imágenes, lo que da un total aproximado de 6,68 $.
Crea una clave de API internacional de Alibaba Cloud Model Studio, pide al propietario de tu espacio de trabajo que la añada en Alibaba, dentro de Configuración > Claves de API, y elige Qwen4-Max en el modo inteligente del editor de anotaciones. Prueba con unas cuantas imágenes, ejecuta la Anotación por lotes, revisa los cuadros y entrena un modelo Ultralytics YOLO26 en el mismo espacio de trabajo.
Escrito por
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









