Meilleurs modèles d’estimation de profondeur : comment choisir
Compare les modèles de profondeur monoculaire tels que Depth Anything, Depth Pro, Metric3D, UniDepth et Ultralytics YOLO26 pour la profondeur métrique, les appareils en périphérie et la robotique.
Le choix d’un modèle d’estimation de profondeur dépend de trois facteurs : as-tu besoin de distances en mètres ou seulement d’une profondeur relative, où le modèle sera-t-il exécuté et sa licence autorise-t-elle l’utilisation que tu en prévois ? Pour la profondeur relative et la recherche, Depth Anything et Marigold sont de bons modèles à évaluer en premier. Pour obtenir une profondeur métrique avec une caméra inconnue, regarde Depth Pro et UniDepth ; si tu connais la distance focale de ta caméra, Metric3D v2 et Depth Anything 3 Metric sont également des options. Pour le matériel en périphérie, présélectionne Depth Anything V2 Small ainsi que les modèles MiDaS v3.1 Swin2-Tiny et LeViT, puis mesure la latence sur ton appareil. Pour une estimation de profondeur à faible latence sur des GPU NVIDIA, en complément d’autres tâches Ultralytics YOLO, évalue également Ultralytics YOLO26 depth. Ce guide compare neuf modèles de profondeur monoculaire et propose une démarche pour en choisir un.
Si cette tâche est nouvelle pour toi, commence par découvrir ce qu’est l’estimation de profondeur monoculaire. Cette page porte sur le choix d’un modèle.
Profondeur relative ou métrique : commence par trancher#
- La profondeur relative indique quels pixels sont plus proches ou plus éloignés, sans échelle connue. Elle suffit à la compréhension de scènes, aux effets d’arrière-plan et au classement des objets selon leur distance.
- La profondeur métrique donne les distances en mètres. Tu en as besoin pour effectuer des mesures, planifier les déplacements d’un robot ou fusionner la profondeur avec d’autres capteurs.
Les modèles métriques atteignent une échelle réelle de différentes façons. Certains estiment eux-mêmes la distance focale de la caméra, d’autres te demandent de la fournir, et d’autres encore utilisent une échelle fixe que tu calibres pour ta caméra. En pratique, la façon dont un modèle obtient son échelle peut compter davantage que quelques points de précision au benchmark. Pour en savoir plus sur ces deux types, consulte l’entrée du glossaire sur l’estimation de profondeur.
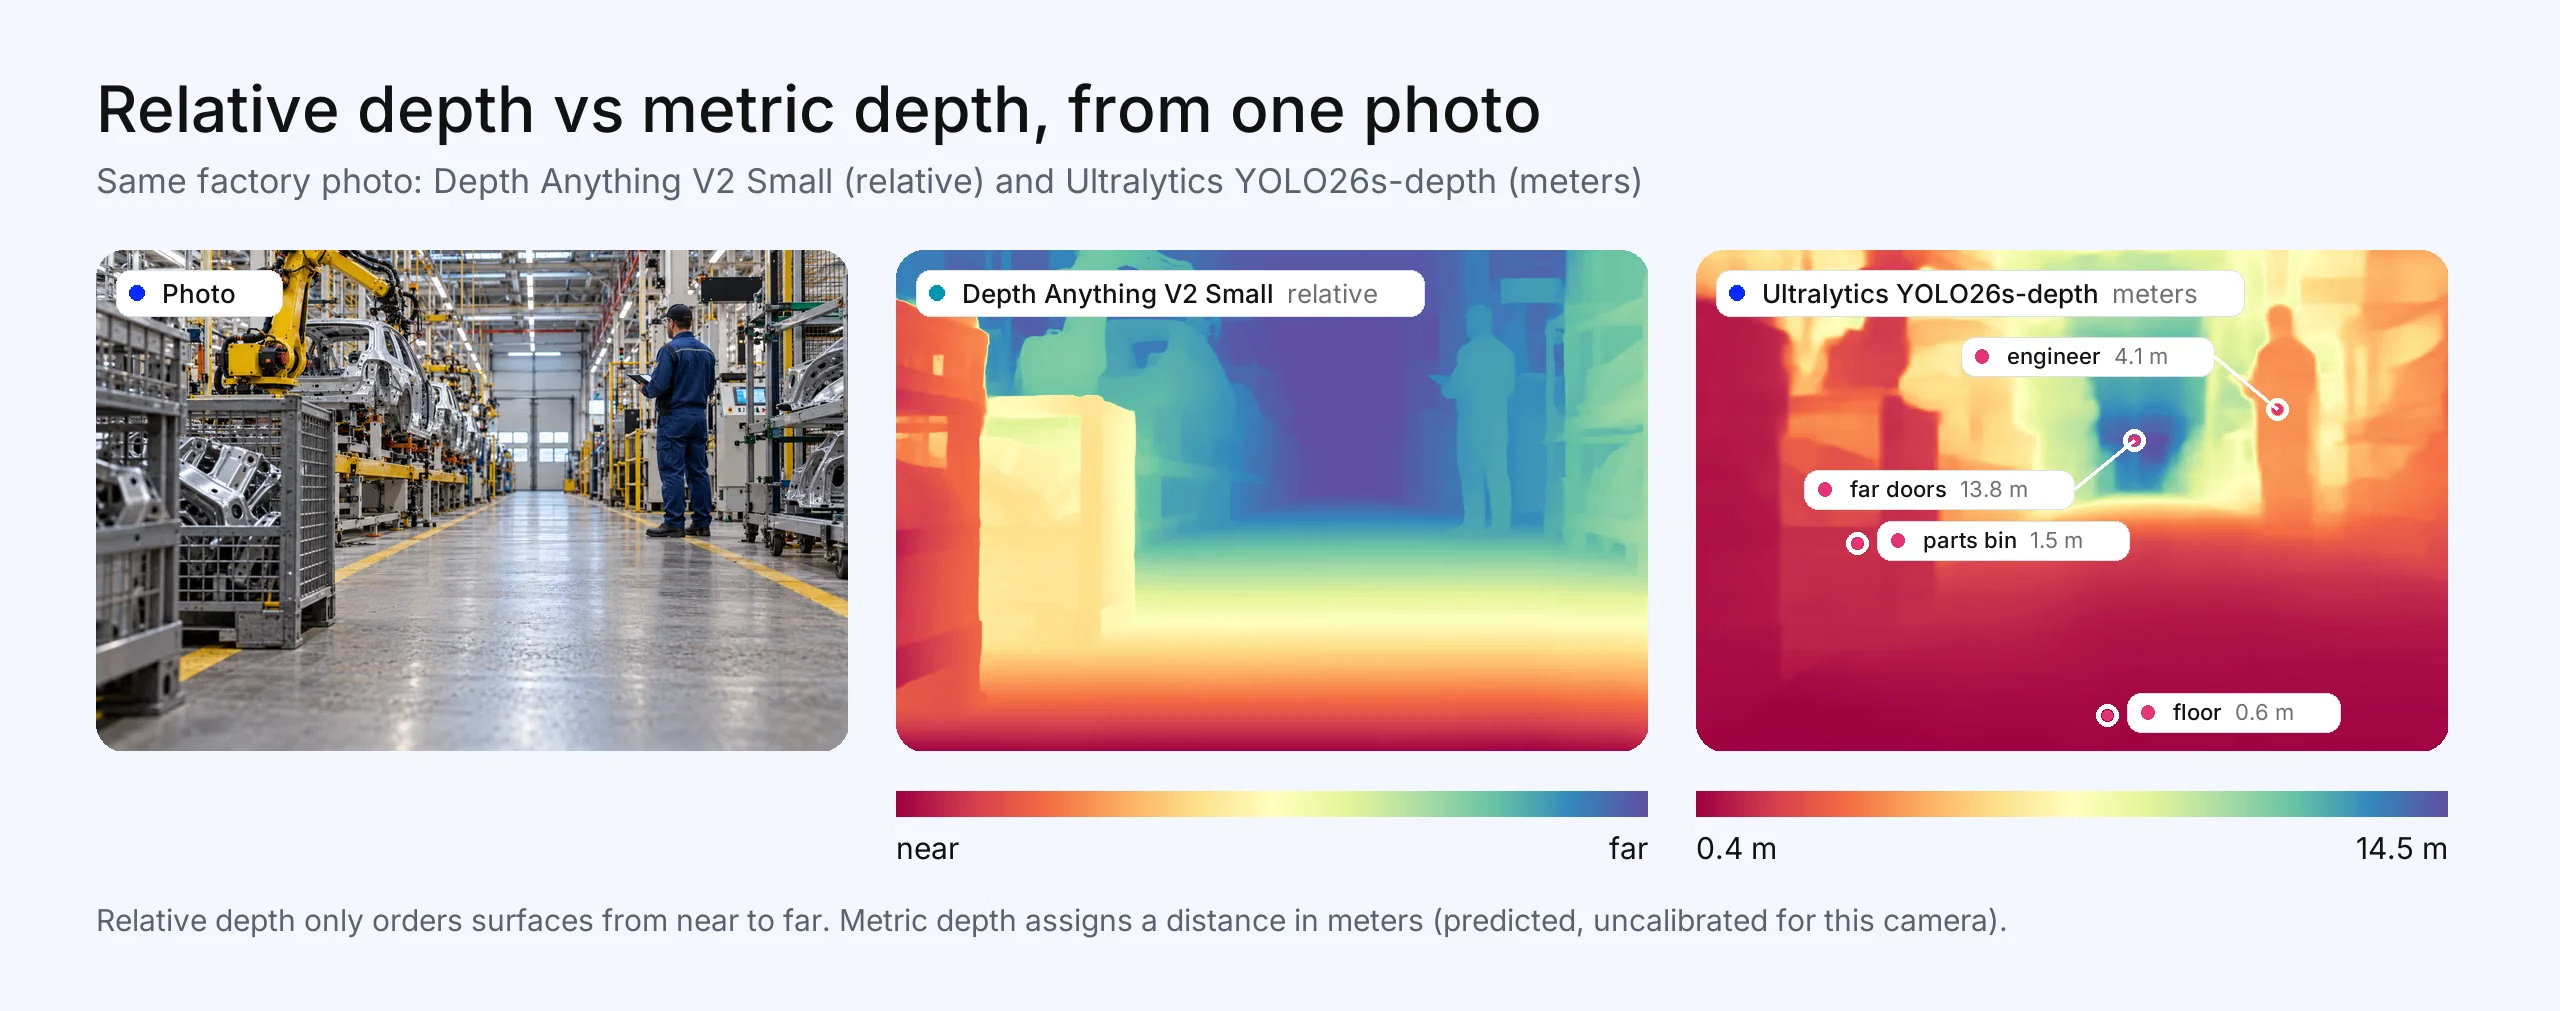
Fig. 1. La même photo d’usine traitée par Depth Anything V2 Small, qui prédit une profondeur relative (plus proche ou plus éloignée, sans unité), et par Ultralytics YOLO26s-depth, qui prédit des mètres : environ 1,5 m jusqu’au bac à pièces, 4,1 m jusqu’à l’ingénieur et 13,8 m jusqu’aux portes du fond. La photo a été générée pour cet article ; les deux cartes de profondeur sont de véritables sorties de modèles. Les distances sont des prédictions issues du point de contrôle publié, non calibrées pour cette caméra, et non des mesures.
Comparaison des modèles d’estimation de profondeur#
Les modèles sont classés par ordre alphabétique et non par rang. Nous ne présentons pas de chiffres de précision comparant les modèles, car chaque article applique son propre protocole de benchmark et les résultats ne sont donc pas directement comparables. Les licences ont été vérifiées en octobre 2026 et s’appliquent à chaque point de contrôle.
| Modèle | Sortie | Tailles | Licence | Idéal pour | Principal compromis |
|---|---|---|---|---|---|
| Depth Anything 3 | Relative ; métrique avec une distance focale connue (DA3Metric) | De Small (0,08B) à Giant (1,15B), ainsi qu’un modèle Nested de 1,40B (selon les indications du projet) | Small, Base, Metric-Large et Mono-Large : Apache 2.0. Large, Giant et Nested : CC BY-NC 4.0 | Géométrie multi-vues et pose de la caméra, en plus de la profondeur | Les modèles plus grands sont non commerciaux ; DA3Metric-Large nécessite la distance focale de ta caméra (le modèle Nested non commercial fournit directement des mètres) |
| Depth Anything V2 | Relative ; points de contrôle métriques distincts pour l’intérieur et l’extérieur | Small 24,8M, Base 97,5M, Large 335,3M | Small : Apache 2.0. Base et Large : CC-BY-NC-4.0 | Profondeur relative polyvalente et robuste | Seul Small est sous licence pour un usage commercial ; les points de contrôle métriques sont limités à 20 m (intérieur) ou 80 m (extérieur) |
| Depth Pro (Apple) | Métrique, sans paramètres intrinsèques de la caméra | Un seul modèle | Licence propre à Apple pour le code et les poids | Profondeur métrique précise à partir de photos prises avec des caméras inconnues | Plus lourd que les modèles pour appareils en périphérie ; vérifie les conditions de licence applicables à ton usage |
| Marigold | Relative (invariante par transformation affine) | Basé sur un modèle de diffusion latente | Code : Apache 2.0. Modèles : RAIL++-M | Détails fins lorsque la vitesse n'est pas importante | Plus lent que les modèles à passe unique, surtout avec l'assemblage |
| Metric3D v2 | Profondeur métrique et normales de surface | ViT-Small, ViT-Large, ViT-giant2 | Code : BSD-2-Clause ; vérifie les conditions de la version des poids | Profondeur métrique et normales pour la reconstruction 3D | Nécessite une longueur focale correcte pour obtenir la bonne échelle |
| MiDaS | Relative | v3.1, de BEiT-Large 512 à Swin2-Tiny 256 et LeViT 224 | MIT | Une référence bien connue, avec une licence permissive et des variantes intégrées | Plus ancien que les nouveaux modèles de fondation ; le dépôt est archivé et n'est plus maintenu |
| Profondeur Ultralytics YOLO26 | Métrique (mètres), avec une échelle globale unique que tu peux calibrer | n 6.3M à x 57.0M | AGPL-3.0 ou une licence Ultralytics Enterprise | Estimation de profondeur à faible latence sur les GPU NVIDIA, en parallèle d'autres tâches YOLO | L'échelle absolue nécessite un calibrage pour ta caméra ; les modèles ne sont pas comparés selon un protocole de précision commun |
| UniDepth V2 | Profondeur métrique et paramètres intrinsèques de la caméra à partir d'une seule image | Backbones ViT-S, ViT-B et ViT-L | CC BY-NC 4.0 | Profondeur métrique lorsque la caméra est inconnue | Licence non commerciale |
| ZoeDepth | Métrique (têtes indoor, outdoor ou combinées), basée sur un préentraînement en profondeur relative | Basé sur ViT | MIT | Profondeur métrique sous licence permissive pour des domaines indoor ou outdoor connus | Entraîné pour des domaines indoor et outdoor spécifiques ; le dépôt est archivé et n'est plus maintenu |
Comment choisir un modèle d'estimation de la profondeur#
Passe ces questions en revue dans l'ordre :
- As-tu besoin de mètres ? Sinon, commence avec Depth Anything V2 ou Depth Anything 3, ou avec MiDaS si tu veux une licence MIT.
- Connais-tu les paramètres intrinsèques de ta caméra ? Si ce n'est pas le cas, choisis un modèle qui les estime : Depth Pro ou UniDepth. Si tu les connais, Metric3D v2 et Depth Anything 3 Metric peuvent les utiliser.
- Où le modèle sera-t-il exécuté ? Si la latence côté serveur n'est pas une contrainte, les grands modèles de fondation conviennent bien. Pour une estimation de profondeur à faible latence sur les GPU NVIDIA, en parallèle d'autres tâches YOLO, envisage la profondeur Ultralytics YOLO26 et mesure les performances sur ton appareil edge, par exemple NVIDIA Jetson. Parmi les autres options, citons Depth Anything V2 Small et les modèles MiDaS v3.1 Swin2-Tiny et LeViT. La latence sur CPU dépend du processeur, de l'environnement d'exécution, de la résolution d'entrée et du modèle. Évalue ta configuration exacte ; la Fig 3 présente un exemple avec les petits modèles de profondeur Ultralytics YOLO26. Consulte la section sur l'edge ci-dessous.
- Peux-tu utiliser la licence ? Vérifie la licence exacte de la version des poids. Plusieurs familles proposent de petits modèles sous Apache 2.0 et de grands modèles non commerciaux.
- Peux-tu calibrer ou affiner le modèle ? Si tu peux recueillir environ 50 à 150 images annotées avec ta propre caméra, avec quelques points mesurés par image, compare un modèle calibré ou affiné à un modèle zero-shot sur tes propres scènes. Lors des tests d'Ultralytics avec YOLO26s-depth (150 images par caméra, 5 points mesurés par image), ce calibrage a ramené l'échelle à environ 1 % d'un ajustement complet à la vérité terrain, contre un écart de 4 % à 46 % avant calibrage. Cette valeur mesure la précision de la récupération de l'échelle, et non la précision globale de la profondeur.
Teste ensuite deux ou trois modèles candidats sur des images prises avec ta propre caméra, à la résolution de déploiement.
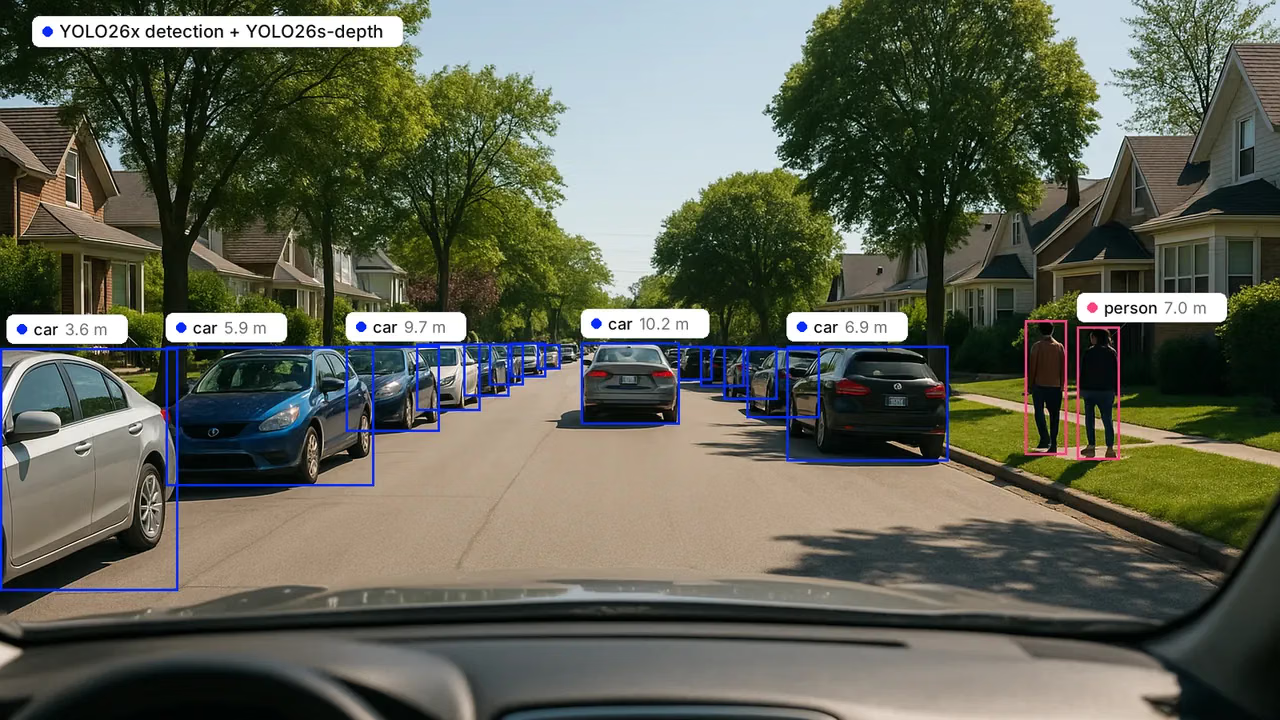
Fig 2. Distances prédites pour certaines voitures et personnes détectées, en combinant la détection Ultralytics YOLO26x et YOLO26s-depth : 3.6 m jusqu'à la voiture garée la plus proche, 6.9 m jusqu'à la voiture à droite et 7.0 m jusqu'à la personne annotée à droite. La photo a été générée pour cet article ; les boîtes et les distances sont des sorties réelles du modèle, non calibrées pour cette caméra. Ce sont des prédictions, pas des distances mesurées.
Présentation détaillée des modèles#
Par ordre alphabétique.
Depth Anything 3#
Depth Anything 3 de ByteDance Seed étend Depth Anything des images uniques à un nombre quelconque de vues. Ses principaux modèles estiment conjointement la profondeur et la pose de la caméra ; des variantes dédiées gèrent la profondeur relative monoculaire (DA3Mono-Large) et la profondeur métrique monoculaire (DA3Metric-Large). Sortie : profondeur relative avec les modèles principaux et Mono ; profondeur métrique avec une longueur focale fournie pour DA3Metric-Large, ou directement avec le modèle Nested non commercial. Tailles : de 0.08B (Small) à 1.15B (Giant), ainsi que le modèle Nested de 1.40B, selon les fiches des modèles du projet. Licence : Small, Base, Metric-Large et Mono-Large sont sous Apache 2.0 ; Large, Giant et Nested sont sous CC BY-NC 4.0. Idéal pour : les scènes multivues et la reconstruction 3D. Compromis : les versions des poids les plus performantes sont non commerciales.
Depth Anything V2#
Depth Anything V2 est un modèle ouvert largement disponible pour la profondeur relative, offrant des résultats robustes dans des scènes d'intérieur, d'extérieur et inhabituelles. Le projet publie aussi des versions des poids métriques affinées pour les scènes d'intérieur (jusqu'à 20 m) et d'extérieur (jusqu'à 80 m). Tailles : Small 24.8M, Base 97.5M, Large 335.3M. Licence : Small est sous Apache 2.0 ; Base et Large sont sous CC-BY-NC-4.0. Idéal pour : l'estimation de profondeur relative à usage général. Compromis : pour une utilisation commerciale, tu es limité au modèle Small, et les versions des poids métriques ne peuvent pas prédire au-delà de leur profondeur maximale fixe.
Depth Pro#
Depth Pro d'Apple prédit la profondeur métrique à partir d'une seule image sans paramètres intrinsèques de la caméra, et estime lui-même la longueur focale. Apple annonce une carte de profondeur de 2.25 mégapixels en 0.3 seconde sur un GPU standard, avec des contours nets autour des structures fines. Licence : la licence propre à Apple couvre le code et les poids. Idéal pour : estimer la profondeur métrique de photos lorsque tu ne contrôles pas la caméra. Compromis : c'est un modèle de classe serveur, pas un modèle edge, et tu dois lire sa licence avant toute utilisation commerciale.
Marigold#
Marigold réutilise un modèle de diffusion d'images préentraîné pour estimer la profondeur ; il a été entraîné uniquement sur des données synthétiques. Il produit une profondeur relative très détaillée. Licence : code sous Apache 2.0, modèles sous RAIL++-M. Idéal pour : les tâches hors ligne où le niveau de détail compte davantage que la vitesse, comme la création de contenu et la génération de jeux de données. Compromis : il prend en charge l'inférence en une seule étape ; l'assemblage pour améliorer la précision multiplie le coût, alors vérifie s'il respecte tes contraintes de latence.
Metric3D v2#
Metric3D v2 prédit la profondeur métrique et les normales de surface à partir d'une seule image, avec des versions des poids ViT-Small, ViT-Large et ViT-giant2, y compris des exportations ONNX. Licence : le code est sous BSD-2-Clause ; vérifie les conditions de la version des poids que tu utilises. Idéal pour : les pipelines de reconstruction 3D et de robotique qui ont aussi besoin des normales de surface. Compromis : le modèle projette les images dans une caméra canonique ; tu as donc besoin d'une longueur focale correcte pour obtenir la bonne échelle.
MiDaS#
MiDaS d'ISL d'Intel a rendu l'estimation robuste de la profondeur relative pratique grâce à un entraînement sur un mélange de jeux de données. La version 3.1 va d'un modèle BEiT-Large privilégiant la qualité aux modèles Swin2-Tiny et LeViT conçus pour les appareils embarqués. Elle comprend aussi un ancien petit modèle MiDaS v2.1 au format OpenVINO pour les CPU Intel, ainsi que des exemples mobiles pour iOS et Android. Licence : MIT. Idéal pour : une référence permissive et bien documentée. Compromis : il est antérieur aux nouveaux modèles de fondation, et Intel a archivé le dépôt, qui ne reçoit donc plus de correctifs. Compare-le à un modèle plus récent sur tes propres images.
Profondeur Ultralytics YOLO26#
Ultralytics YOLO26 prend en charge l'estimation de la profondeur (annoncée en juillet 2026) en cinq tailles, de 6.3M (n) à 57.0M (x) paramètres, à 768 pixels. Ces modèles prédisent la profondeur en mètres à l'aide d'une tête de profondeur logarithmique couvrant environ 0.02 à 150 mètres ; un seul modèle peut donc traiter des pièces intérieures et des scènes extérieures. Les poids publiés utilisent une échelle globale unique ; pour obtenir une profondeur absolue précise avec une caméra spécifique, model.calibrate() ajuste l'échelle à partir d'environ 50 à 150 images annotées, quelques points mesurés par image suffisant, sans réentraînement. Dans notre benchmark TensorRT FP16 avec un lot de taille 1 sur un NVIDIA T4, à environ 768 pixels en entrée, la latence d'inférence seule (hors prétraitement et post-traitement) va de 2.7 ms (n) à 13.6 ms (x), et les cinq tailles ont une latence inférieure à celle de Depth Anything V2 Small. Il s'agit d'une comparaison de latence, et non d'une évaluation de précision selon un protocole commun. Les modèles s'exportent vers ONNX, TensorRT, CoreML, OpenVINO et d'autres formats, et s'entraînent avec la même API Python et le même CLI que la détection, la segmentation et l'estimation de pose. Licence : AGPL-3.0 ou une licence Ultralytics Enterprise pour une utilisation commerciale en code source fermé. Idéal pour : l'estimation de profondeur à faible latence sur les GPU NVIDIA, en parallèle d'autres tâches YOLO ; mesure les performances sur ton appareil edge. Compromis : l'échelle absolue dépend du calibrage de ta caméra, et sa précision n'est pas comparée ici à celle des modèles de fondation selon un protocole commun ; teste donc le modèle sur tes propres données.
UniDepth V2#
UniDepth prédit la profondeur métrique et les paramètres intrinsèques de la caméra à partir d'une seule image RGB, et peut utiliser les paramètres intrinsèques connus si tu les as. Licence : CC BY-NC 4.0. Idéal pour : la recherche et les prototypes qui nécessitent une profondeur métrique avec des caméras inconnues. Compromis : la licence exclut toute utilisation commerciale.
ZoeDepth#
ZoeDepth combine le préentraînement en profondeur relative avec des têtes métriques pour les scènes d'intérieur (NYU) et d'extérieur (KITTI). Licence : MIT. Idéal pour : un modèle métrique sous licence permissive lorsque tes scènes ressemblent à ses domaines d'entraînement intérieurs ou extérieurs. Compromis : il a été entraîné pour des domaines intérieurs et extérieurs spécifiques, tandis que des modèles métriques plus récents comme UniDepth et Metric3D v2 ont été conçus pour des caméras variées. Intel a archivé le dépôt, qui ne reçoit donc plus de correctifs.
Estimation de la profondeur sur les appareils edge#
Sur le matériel edge, la question passe de « le plus précis » à « suffisamment précis à ma fréquence d'images ». Trois catégories de modèles conviennent :
- Petites versions de grandes familles. Depth Anything V2 Small (24.8M paramètres, Apache 2.0) est une option sous licence permissive. Les modèles MiDaS v3.1 Swin2-Tiny et LeViT sont conçus pour les appareils embarqués.
- Modèles de tâches en temps réel. La profondeur Ultralytics YOLO26 offre une latence d'inférence seule de 2.7 ms (n) à 13.6 ms (x), avec un lot de taille 1 et hors prétraitement et post-traitement, sur une Tesla T4 avec TensorRT FP16. Le modèle s'exporte vers TensorRT pour NVIDIA Jetson, CoreML pour les appareils Apple et OpenVINO pour les CPU Intel ; la prise en charge de l'exportation ne constitue pas un benchmark sur appareil edge.
- Modèles de recherche légers. FastDepth (MIT) a été conçu pour les systèmes embarqués et présenté sur un NVIDIA Jetson TX2. Lite-Mono (MIT) compte de 2.2M à 8.7M paramètres et a été entraîné sur des données de conduite de KITTI.
Mesure la latence d'inférence sur ton appareil cible après exportation, à la résolution prévue pour le déploiement. Pour choisir le matériel, consulte notre guide pour choisir le bon appareil edge. Pour connaître les options d'exportation, consulte notre guide sur les options de déploiement de modèles.
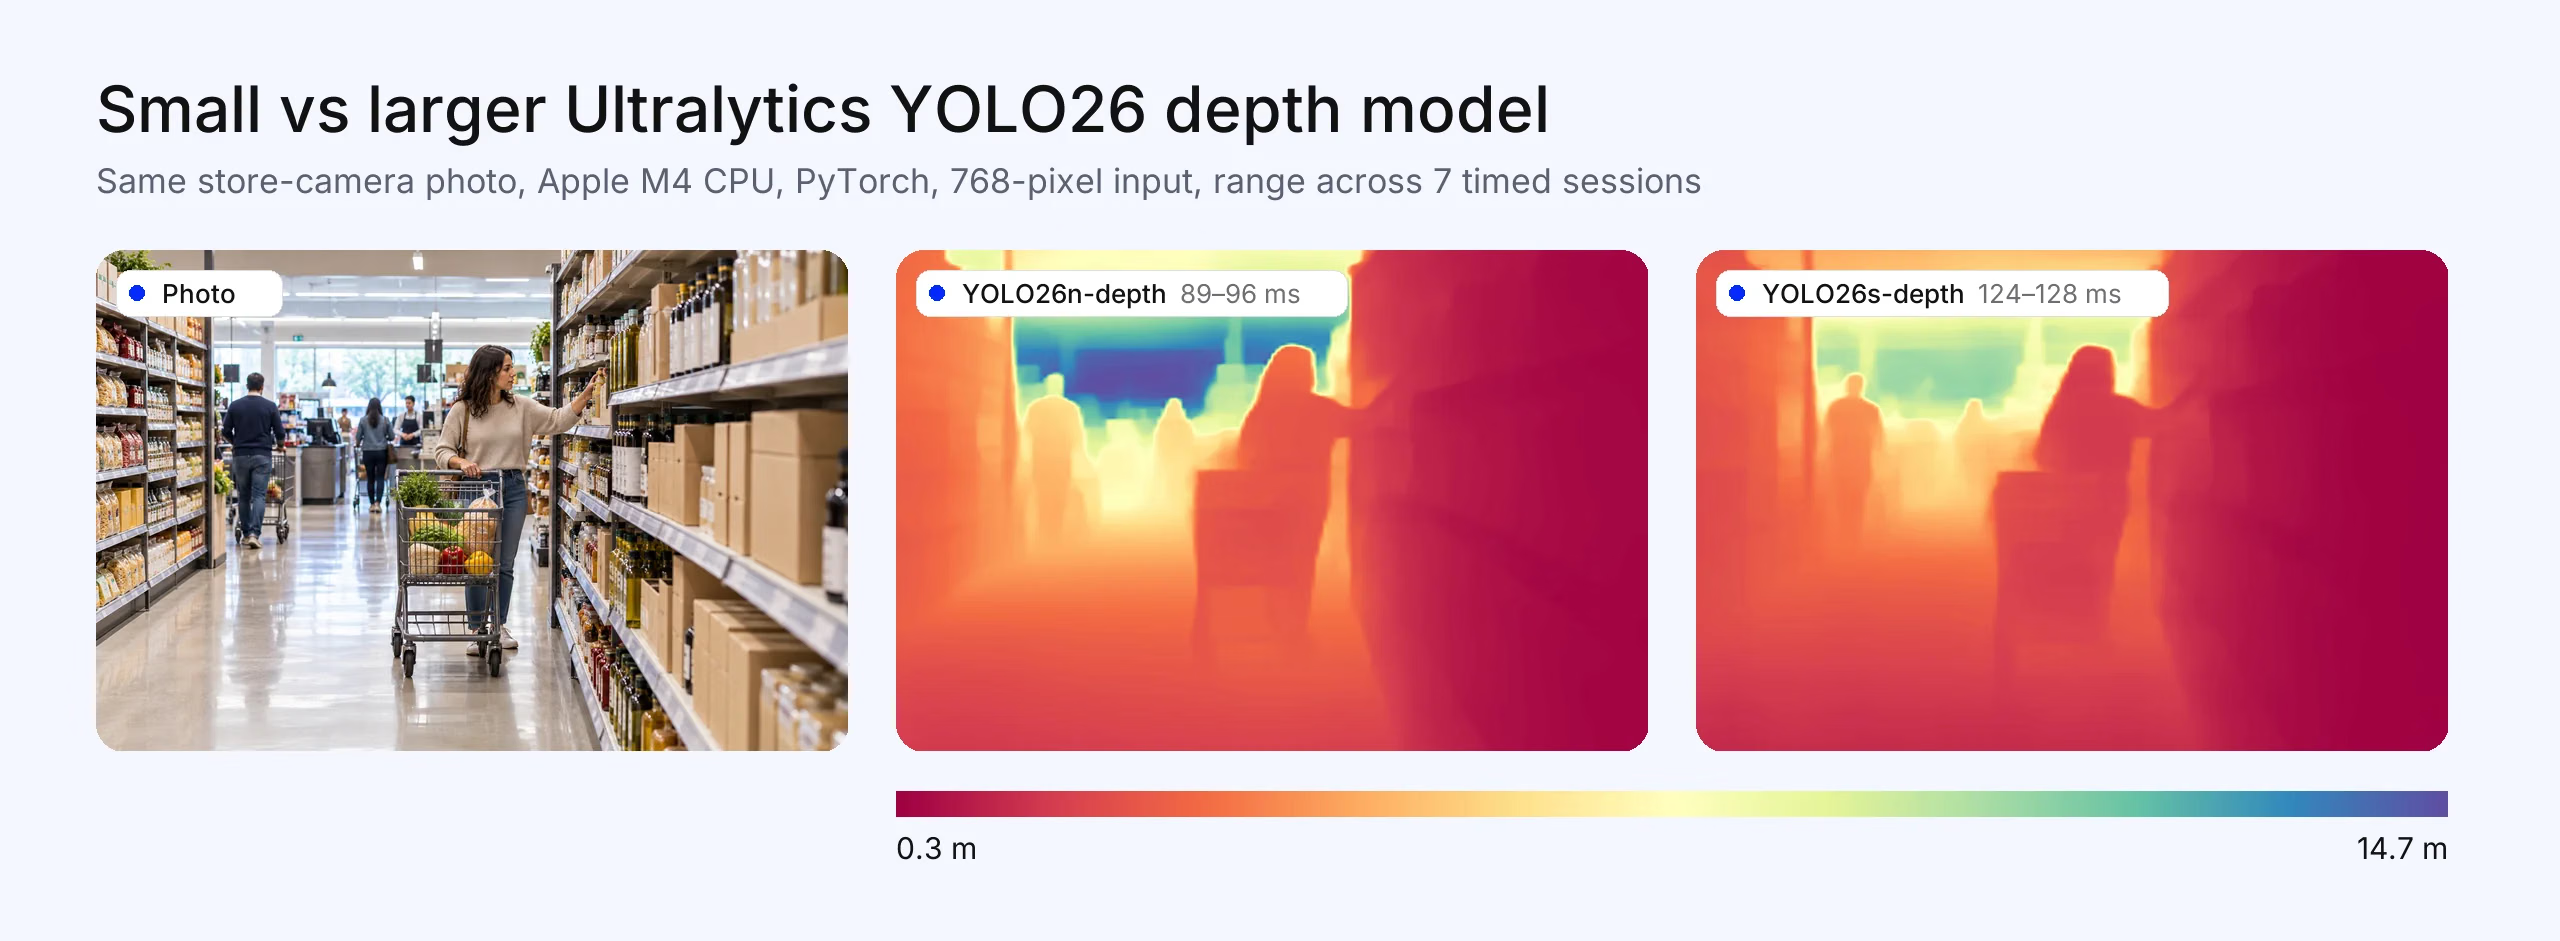
Fig 3. Ultralytics YOLO26n-depth (89 à 96 ms) et YOLO26s-depth (124 à 128 ms) sur la même photo de magasin, sur un CPU Apple M4 (PyTorch, entrée de 768 pixels, de l'image à la carte de profondeur finale). Les temps mesurés sur un ordinateur portable varient selon la charge en arrière-plan ; considère-les donc comme des fourchettes. La photo a été générée pour cet article ; les cartes de profondeur et les temps mesurés sont réels.
Estimation de la profondeur pour la robotique#
Les robots ont généralement besoin d'une profondeur métrique stable d'une image à l'autre, à la fréquence de contrôle du robot. Trois approches pratiques :
- Les modèles métriques monoculaires conviennent aux robots équipés d'une seule caméra RGB. Utilise un modèle adapté à ta caméra : Metric3D v2 ou Depth Anything 3 Metric avec des paramètres intrinsèques connus, ou un modèle de profondeur Ultralytics YOLO26 calibré lorsque tu as besoin d'une inférence embarquée à faible latence sur un GPU NVIDIA, en parallèle d'autres tâches YOLO ; mesure les performances sur l'ordinateur de ton robot.
- Les modèles stéréo, comme FoundationStereo de NVIDIA, calculent la profondeur métrique à partir d'une paire de caméras calibrée. La version de recherche est réservée à un usage non commercial ; NVIDIA propose une version TAO pour un usage commercial. Consulte la page sur la vision stéréo pour comparer la stéréo à la profondeur monoculaire.
- Les capteurs de profondeur (caméras stéréo de profondeur, lumière structurée ou LiDAR) mesurent directement la profondeur.
Quand un modèle monoculaire n'est pas le bon choix : pour les décisions critiques pour la sécurité, comme éviter une collision à proximité de personnes, utilise un capteur de profondeur ou une paire stéréo et considère la profondeur monoculaire comme un complément, par exemple pour combler les zones où le capteur ne renvoie aucune donnée.
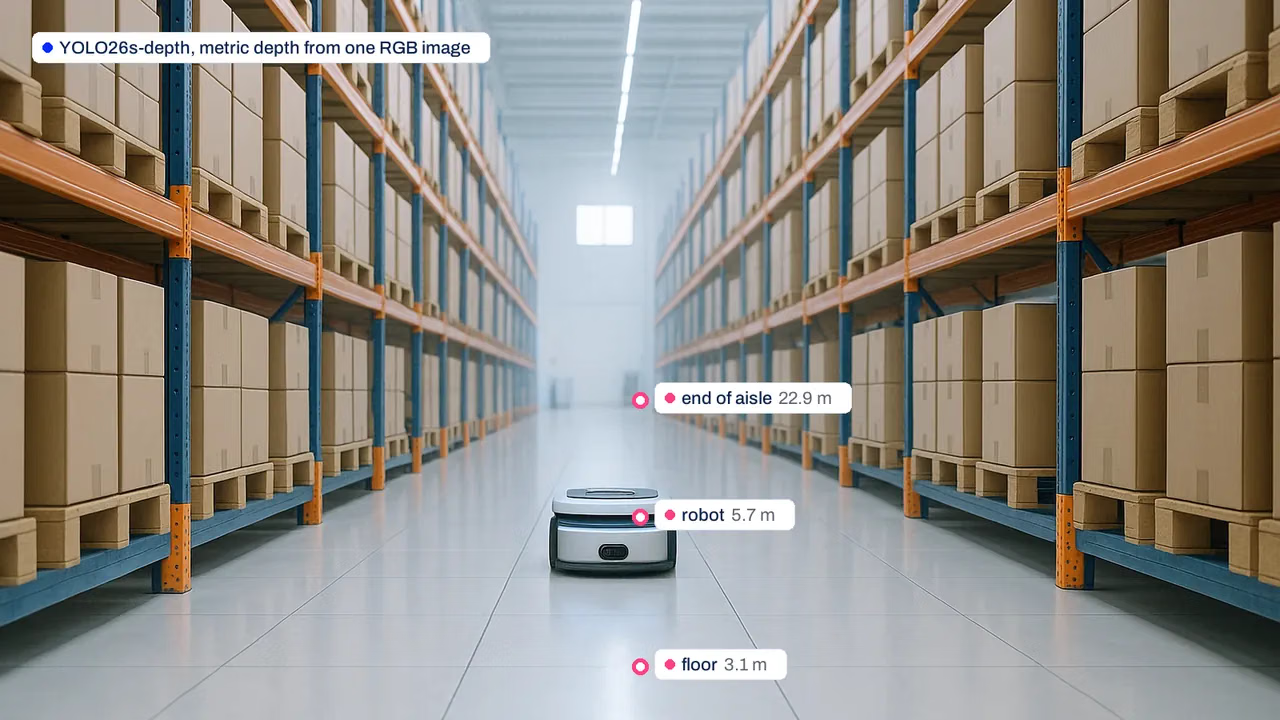
Fig 4. Distances prédites à partir d'une carte Ultralytics YOLO26s-depth : 3.1 m jusqu'à un point au sol, 5.7 m jusqu'au robot et environ 23 m jusqu'au bout de l'allée. La photo a été générée pour cet article ; les mesures sont des sorties réelles du modèle, non calibrées pour cette caméra : ce sont donc des prédictions, pas des mesures réelles.
Comment tester des modèles de profondeur avec ta propre caméra#
- Recueille environ 50 à 150 images annotées avec la caméra utilisée pour le déploiement, à la résolution et avec les réglages d'objectif prévus pour le déploiement, et ajoute quelques points mesurés par image. Les benchmarks publics comme NYU Depth V2 (intérieur) et KITTI (conduite) sont utiles pour une première comparaison, mais ce sont les résultats avec ta propre caméra qui comptent.
- Un télémètre mesure une distance en ligne droite, alors que le calibrage nécessite la profondeur le long de l'axe de la caméra : mesure des points près du centre de l'image, convertis les mesures hors centre en profondeur sur l'axe de la caméra à l'aide des paramètres intrinsèques de la caméra, ou recueille la profondeur avec un capteur de profondeur.
- Compare les modèles candidats à l'aide de δ1 et de l'erreur relative absolue par rapport à ces mesures, et chronomètre chacun sur l'appareil cible. Pour les modèles métriques, évalue les sorties brutes sans redimensionner chaque image pour qu'elle corresponde à la vérité terrain ; l'alignement image par image masque précisément les erreurs d'échelle que tu dois repérer.
- Pour un modèle métrique à échelle fixe, calibre-le sur une partie des données et teste-le sur le reste. La profondeur Ultralytics YOLO26 inclut cette fonctionnalité sous la forme
model.calibrate().
Foire aux questions
Il n'existe pas de meilleur modèle pour tous les cas. Depth Anything V2 et Depth Anything 3 sont de bonnes options à évaluer en premier pour la profondeur relative. Depth Pro, UniDepth et Metric3D v2 fournissent une profondeur métrique à partir d'une seule image. Pour une estimation de profondeur à faible latence sur les GPU NVIDIA, en parallèle d'autres tâches YOLO, évalue la profondeur Ultralytics YOLO26 et mesure les performances sur ton appareil edge. Depth Anything V2 Small et les modèles MiDaS v3.1 Swin2-Tiny et LeViT sont aussi des options plus légères à tester.
Présélectionne des modèles compacts qui s'exportent vers ton environnement d'exécution : profondeur Ultralytics YOLO26 (de 6.3M à 57.0M paramètres, exportation TensorRT, CoreML et OpenVINO), Depth Anything V2 Small (24.8M paramètres) et les modèles MiDaS v3.1 Swin2-Tiny ou LeViT. Mesure ensuite la latence sur ton propre appareil ; la prise en charge de l'exportation ne garantit pas les performances sur appareil edge.
Les robots ont généralement besoin d'une profondeur métrique. Metric3D v2 et Depth Anything 3 Metric prédisent des distances en mètres à partir d'une image, à l'aide des paramètres intrinsèques connus de la caméra ; UniDepth peut estimer lui-même ces paramètres. Selon la documentation, la profondeur Ultralytics YOLO26 offre une latence d'inférence seule de 2.7 à 13.6 ms avec un lot de taille 1, hors prétraitement et post-traitement, sur une T4 avec TensorRT FP16 et une entrée d'environ 768 pixels ; mesure les performances sur l'ordinateur de ton robot. Pour la navigation critique pour la sécurité, utilise une caméra stéréo ou un capteur de profondeur et considère la profondeur monoculaire comme un complément ; FoundationStereo est un modèle stéréo à évaluer.
Les principaux modèles Depth Anything V2 prédisent une profondeur relative. Le projet publie aussi des versions des poids métriques affinées pour des scènes intérieures jusqu'à 20 mètres et des scènes extérieures jusqu'à 80 mètres.
Vérifie la licence de chaque version des poids. MiDaS et ZoeDepth sont sous MIT (les deux dépôts sont désormais archivés), le code de Metric3D est sous BSD-2-Clause (vérifie les conditions de la version des poids), Depth Anything V2 Small et plusieurs modèles Depth Anything 3 sont sous Apache 2.0, et les modèles Marigold utilisent RAIL++-M. Depth Anything V2 Base et Large, les modèles Depth Anything 3 de grande taille et UniDepth sont réservés à un usage non commercial. La profondeur Ultralytics YOLO26 est sous AGPL-3.0, avec une licence Enterprise pour une utilisation commerciale en code source fermé. Depth Pro utilise la licence propre à Apple, qui autorise l'utilisation et la redistribution, mais n'accorde aucun droit de brevet ; consulte-la avant le déploiement.









