Come addestrare YOLO sui dati Amazon S3 e distribuire un'API ospitata con Ultralytics Platform
Addestra Ultralytics YOLO26 sulle immagini nel tuo bucket Amazon S3 e distribuiscilo come API ospitata con Ultralytics Platform, passo dopo passo, con un confronto con SageMaker.
 Miles Deans14 min di lettura
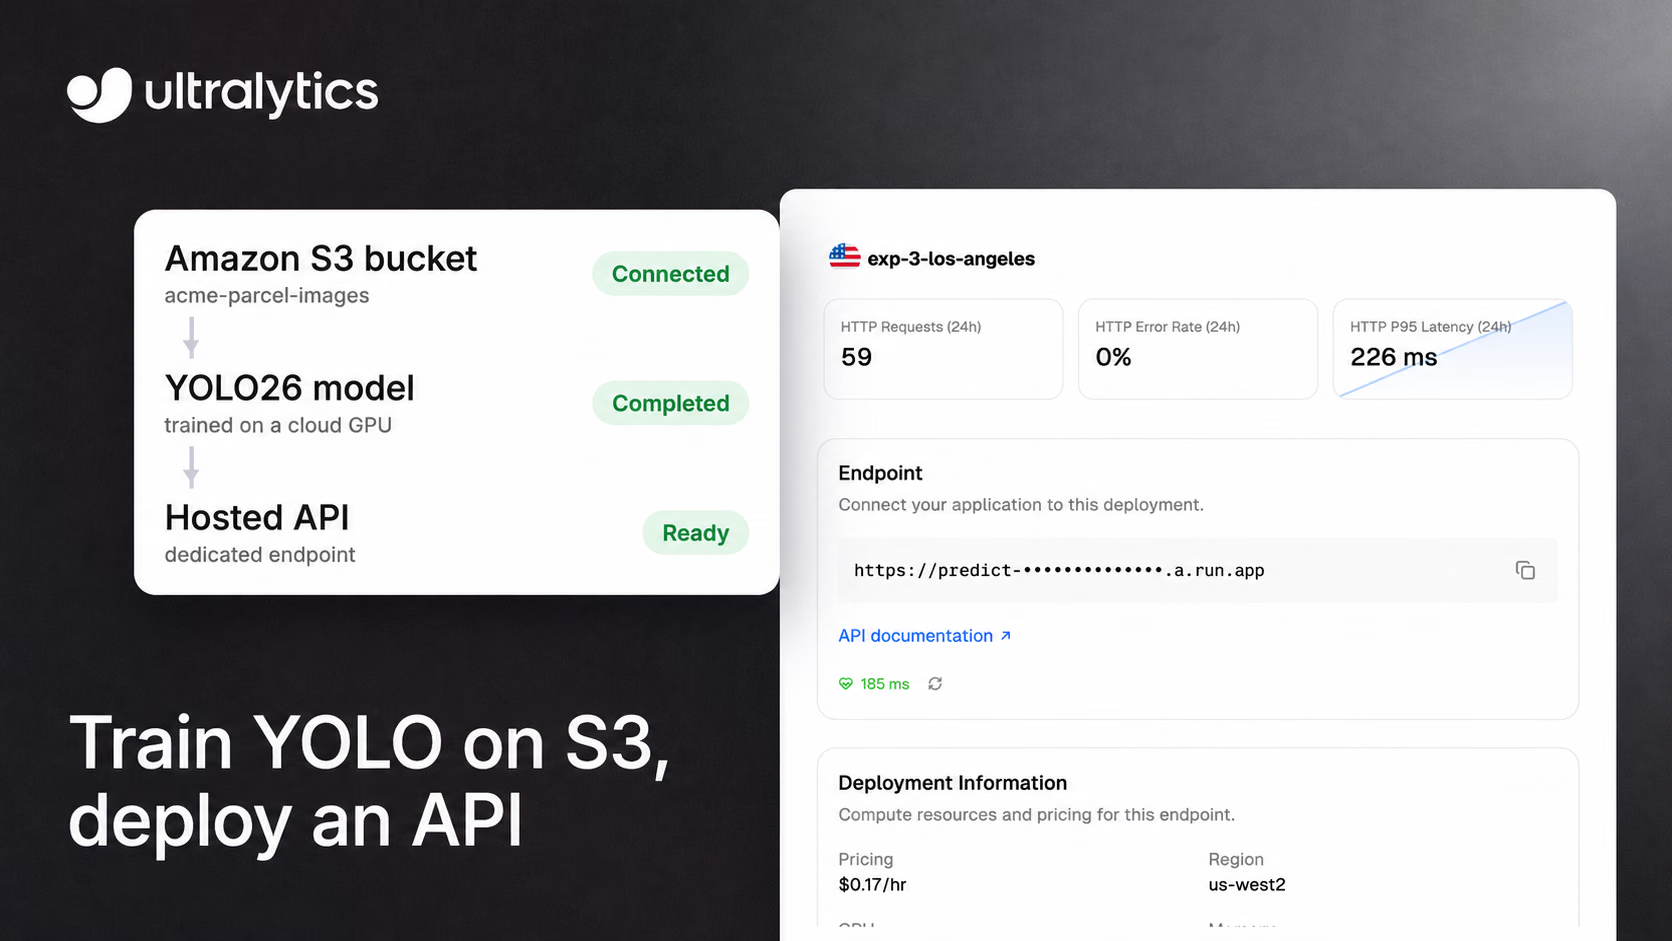
Se le tue immagini sono già in un bucket Amazon S3, puoi addestrare un modello Ultralytics YOLO su di esse e distribuirlo come API ospitata senza caricare una seconda copia del dataset. Ultralytics Platform indicizza il bucket sul posto, ti permette di etichettare e addestrare YOLO26 su una GPU cloud e distribuisce il modello addestrato a un endpoint dedicato che puoi chiamare tramite HTTPS. Questa guida illustra ogni passaggio, dalla policy IAM alla prima predizione, e confronta il flusso di lavoro con Amazon SageMaker, Google Vertex AI e Azure Machine Learning.
Lo stesso flusso funziona con Google Cloud Storage e Azure Blob Storage, usando una chiave JSON dell'account di servizio o una stringa di connessione con chiave di accesso dell'account al posto della chiave di accesso AWS.
Come si articola il flusso di lavoro#
La pipeline si compone di cinque fasi. Le immagini originali restano nel tuo bucket e l'addestramento cloud usa copie temporanee per tutta la durata di un'esecuzione:
- Connetti un bucket S3 con un utente IAM di sola lettura.
- Indicizza una cartella come dataset di Platform. Platform legge le dimensioni delle immagini e le eventuali etichette YOLO presenti, senza conservare una seconda copia delle immagini.
- Etichetta le immagini nel browser oppure conserva le etichette YOLO già presenti nel bucket.
- Addestra un modello YOLO26 su una GPU cloud. L'addestramento usa copie temporanee delle immagini per tutta la durata dell'esecuzione.
- Distribuisci il modello su un endpoint dedicato in una delle 42 regioni e inviagli immagini usando una chiave API.
I dataset di rilevamento, segmentazione, posa e riquadro delimitatore orientato (OBB) vengono riconosciuti dalla struttura delle loro etichette, quindi gli stessi passaggi si applicano a ogni attività di visione artificiale.
Prima di iniziare: piani, autorizzazioni e limiti dei dati#
Ti servono tre cose:
- Uno spazio di lavoro Pro o Enterprise. I dataset di Amazon S3, Google Cloud Storage e Azure Blob Storage richiedono un piano Pro o Enterprise. Pro costa 29 $ al mese per postazione e include 30 $ di credito mensile per postazione per il calcolo a consumo, come l'addestramento cloud.
- Il ruolo di amministratore o proprietario dello spazio di lavoro, necessario per connettere lo spazio di archiviazione cloud.
- Un utente AWS IAM che possa elencare e leggere il bucket.
Prima di connetterti, è utile sapere quali dati escono dal bucket. Platform trasmette gli originali su richiesta per la consultazione e l'annotazione, e le immagini indicizzate non vengono conteggiate nella quota di archiviazione di Platform. Ogni connessione dispone dell'interruttore Funzionalità AI, attivo per impostazione predefinita. Quando è attivo, le GPU di Ultralytics possono leggere le immagini per l'annotazione, la ricerca di immagini simili e l'addestramento cloud. Anche i fornitori esterni di AI possono elaborare le immagini per i modelli di annotazione a pagamento usando la chiave del fornitore del tuo spazio di lavoro e per la generazione di immagini quando è abilitato l'accesso in scrittura. Durante un'esecuzione, l'addestramento cloud usa copie temporanee; la ricerca di immagini simili conserva gli embedding finché le immagini restano in Platform. Disattivalo per impedire l'avvio di nuove operazioni AI (quelle già in corso vengono completate), mentre l'annotazione manuale e l'addestramento locale continuano a funzionare. Platform non modifica né elimina mai i tuoi oggetti.
Passaggio 1: crea un utente IAM di sola lettura#
Nella console AWS, vai a IAM > Users, crea un utente senza accesso alla console e associa una policy che conceda l'accesso di elencazione e lettura al bucket:
{
    "Version": "2012-10-17",
    "Statement": [
        { "Effect": "Allow", "Action": "s3:ListAllMyBuckets", "Resource": "*" },
        {
            "Effect": "Allow",
            "Action": ["s3:ListBucket", "s3:GetObject"],
            "Resource": ["arn:aws:s3:::my-bucket", "arn:aws:s3:::my-bucket/*"]
        }
    ]
}
s3:ListAllMyBuckets è facoltativo. Consente a Platform di individuare i tuoi bucket, così non devi digitarne i nomi.
Apri quindi la scheda Security credentials dell'utente e crea una chiave di accesso. Platform richiede una chiave utente IAM a lunga durata: rifiuta le credenziali temporanee AWS STS, comprese le credenziali di sessione di ruolo e le chiavi IAM Identity Center, perché scadrebbero mentre il dataset è ancora connesso. A questo scopo usa un utente dedicato, mai le credenziali root. Platform cifra la chiave a riposo con AES-256-GCM e non la espone mai ai carichi di lavoro di addestramento; puoi revocare l'accesso in qualsiasi momento disattivando la chiave in IAM.
Passaggio 2: connetti il bucket a Ultralytics Platform#
- In Platform, vai a Settings > Integrations e seleziona Amazon S3.
- Inserisci l'ID della chiave di accesso, la chiave di accesso segreta e la regione del bucket, ad esempio
us-east-1. - Fai clic su Find available buckets e seleziona i bucket da connettere, oppure digita il nome di un bucket se la policy non consente di individuarli.
- Fai clic su Connect. Prima di salvare, Platform verifica di poter elencare e leggere ogni bucket.
Una connessione legge i bucket di una sola regione, quindi, se i tuoi dati sono distribuiti in più regioni, crea una connessione per ciascuna. La guida all'integrazione di Amazon S3 illustra l'autorizzazione facoltativa di scrittura usata per la generazione di immagini.
Passaggio 3: crea un dataset dal bucket#
Fai clic su New Dataset, apri la scheda Cloud, scegli il bucket, individua la cartella contenente i tuoi dati e crea il dataset. Platform elenca una volta la cartella e indicizza ciò che trova:
- Immagini: oggetti
.jpg,.jpeg,.png,.webpe.avif. - Etichette: file YOLO
.txt, abbinati secondo la struttura standardimages/-labels/oppure come file accanto a ogni immagine. - Classi: un file
data.yamlfornisce i nomi delle classi, come in un normale dataset YOLO. - Suddivisioni: i nomi delle cartelle
train,valetestassegnano automaticamente le suddivisioni.
Una singola importazione indicizza fino a 500.000 oggetti, quindi suddividi i bucket più grandi in più dataset. Considera immutabili gli oggetti indicizzati: ogni immagine è associata all'ETag del relativo oggetto S3 e Platform smette di servirla se viene sovrascritta. Per aggiungere dati in seguito, carica nuovi oggetti e crea un nuovo dataset, perché l'indice viene creato una sola volta, al momento della creazione del dataset.
Passaggio 4: etichetta o verifica le immagini#
Apri il dataset per controllare le etichette importate nell'editor di annotazione. Se il bucket non contiene ancora etichette, puoi disegnare manualmente riquadri e maschere oppure, con le funzionalità AI attive, usare l'annotazione intelligente (SAM per rilevamento, segmentazione e OBB, YOLO per la posa) e l'annotazione automatica per velocizzare il lavoro. Le etichette vengono archiviate in Platform e gli oggetti nel tuo bucket restano invariati.
Passaggio 5: addestra YOLO26 su una GPU cloud#
Fai clic su New Model nel dataset o in un progetto, scegli un modello di base e avvia un'esecuzione cloud:
- Modello di base: scegli un modello ufficiale Ultralytics (YOLO26 è consigliato) oppure un tuo modello da perfezionare. Sono elencati solo i modelli compatibili con l'attività del dataset.
- Parametri: imposta epoche, dimensione delle immagini e dimensione del batch, oppure mantieni i valori predefiniti.
- GPU: scegli una GPU da Ultralytics Cloud. Prima dell'avvio, la finestra di dialogo mostra la tariffa oraria e stima la durata e il costo totale dell'esecuzione. La nostra guida alla scelta di una GPU cloud ti aiuta a valutare i compromessi.
Le metriche, l'output della console e i grafici di sistema vengono trasmessi al browser durante l'esecuzione e i checkpoint vengono salvati automaticamente. Al termine dell'addestramento, la pagina del modello mostra le metriche e, quando sono disponibili i risultati di convalida, un'analisi dettagliata, ad esempio una matrice di confusione.
Passaggio 6: distribuisci il modello come API ospitata#
Apri la scheda Deploy del modello. Una mappa e una tabella elencano 42 regioni, ordinate in base alla latenza misurata dalla tua posizione. Fai clic su Deploy nella regione desiderata, verifica CPU, memoria e prezzo, quindi fai clic su Create Deployment.
La dimensione scelta determina il metodo di fatturazione:
- Dimensione predefinita (1 vCPU, 2 GiB): gratuita e con scalabilità fino a zero quando è inattiva.
- Dimensioni personalizzate (fino a 8 vCPU e 32 GiB): mantengono attiva un'istanza e vengono fatturate alla tariffa oraria regionale visualizzata dal momento in cui sono pronte fino all'arresto dell'endpoint, anche durante i periodi di inattività.
Ogni endpoint dedicato è un servizio con tenant singolo, un URL e un monitoraggio propri, ed è associato a una chiave API del tuo spazio di lavoro. Gli spazi di lavoro gratuiti possono eseguire 3 distribuzioni, gli spazi Pro 10 e gli spazi Enterprise un numero illimitato. Per sapere quando un endpoint dedicato è preferibile all'inferenza condivisa, consulta la nostra guida all'inferenza dedicata e condivisa.
Passaggio 7: chiama l'endpoint#
Installa Requests con python -m pip install requests e salva un'immagine come image.jpg. Sostituisci l'URL di esempio con l'URL copiato della tua distribuzione seguito da /predict e sostituisci YOUR_API_KEY con la chiave associata a quella distribuzione:
import requests

url = "https://YOUR_DEPLOYMENT_URL.run.app/predict"
headers = {"Authorization": "Bearer YOUR_API_KEY"}
data = {"conf": 0.25, "iou": 0.5, "imgsz": 640}

with open("image.jpg", "rb") as f:
    response = requests.post(url, headers=headers, data=data, files={"file": f})

print(response.json())
La stessa richiesta con cURL:
curl -X POST "https://YOUR_DEPLOYMENT_URL.run.app/predict" \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -F "file=@image.jpg" \
  -F "conf=0.25" \
  -F "iou=0.5" \
  -F "imgsz=640"
Ogni endpoint offre anche una documentazione API interattiva all'indirizzo /docs e un controllo /health. Le richieste dirette non sono soggette al limite di frequenza dell'API di Platform, ma ogni endpoint usa una sola istanza: le richieste che non possono essere servite rapidamente ricevono un 429 con un'intestazione Retry-After e il corpo delle richieste è limitato a 32 MB. Quando l'endpoint è attivo, puoi monitorare le richieste, gli errori e la latenza dalla pagina della distribuzione.
Costi, limiti e sicurezza in breve#
| Voce | Cosa aspettarsi |
|---|---|
| Piano | Pro (29 $ al mese per postazione) o Enterprise per i dataset S3, Google Cloud Storage e Azure Blob |
| Archiviazione | Le immagini indicizzate restano nel tuo bucket e non incidono sulla quota di archiviazione di Platform |
| Addestramento | Fatturato in base al tempo GPU e coperto dai crediti; la finestra di dialogo stima il costo prima dell'avvio |
| Endpoint | Dimensione predefinita gratuita con scalabilità fino a zero; dimensioni personalizzate fatturate a ore durante il funzionamento |
| Dimensione dell'importazione | Fino a 500.000 oggetti per importazione |
| Credenziali | Chiave utente IAM a lunga durata, cifrata a riposo e mai esposta ai carichi di lavoro di addestramento |
| Non disponibile nei dataset S3 | Clonazione dei dataset, istantanee delle versioni, sfocatura dei volti, incolla immagini da altri dataset |
Ultralytics Platform a confronto con SageMaker, Vertex AI e Azure ML#
Le piattaforme ML cloud di uso generale possono addestrare modelli anche sui dati archiviati nei propri sistemi e distribuire i modelli. Le colonne relative ad archiviazione e distribuzione qui sotto si basano sulla documentazione di ciascuna piattaforma; l'ultima colonna è una nostra valutazione.
| Piattaforma | Dove si trovano i dati di addestramento | Opzioni di distribuzione | Utilizzo consigliato (nostra valutazione) |
|---|---|---|---|
| Ultralytics Platform con Ultralytics YOLO | Indicizzati sul posto da S3, Google Cloud Storage o Azure Blob | Endpoint dedicati a istanza singola in 42 regioni; scalabilità fino a zero con la dimensione predefinita | Team che vogliono passare dal bucket all'API per il rilevamento, la segmentazione, la posa o l'OBB con YOLO senza scrivere codice di addestramento o distribuzione |
| Amazon SageMaker AI | I processi di addestramento leggono da Amazon S3, Amazon EFS o Amazon FSx for Lustre | Endpoint in tempo reale con scalabilità automatica, modalità serverless e inferenza asincrona | Team che già eseguono pipeline ML su AWS e vogliono scegliere i propri container e le opzioni di distribuzione |
| Google Vertex AI | I processi di addestramento serverless montano i bucket Cloud Storage accessibili in /gcs/ | Endpoint gestiti per l'inferenza online | Team che hanno standardizzato dati e strumenti su Google Cloud |
| Azure Machine Learning | Gli archivi dati fanno riferimento ad archivi Azure esistenti, come Blob Storage | Endpoint online gestiti per l'inferenza in tempo reale | Team che hanno standardizzato l'uso di Azure |
La documentazione sui dati di addestramento di SageMaker elenca S3, EFS e FSx for Lustre come origini con modalità di input streaming e download. L'inferenza serverless gestisce la scalabilità per te ed è adatta al traffico con periodi di inattività in cui sono tollerabili avvii a freddo; puoi usare un container fornito da SageMaker o portarne uno tuo. Vertex AI esegue l'addestramento personalizzato da un'applicazione Python su un container predefinito o su un container personalizzato, mentre Azure Machine Learning si connette agli archivi Azure esistenti tramite archivi dati e distribuisce i modelli con endpoint online gestiti. Questa ampiezza è il punto di forza di una piattaforma di uso generale. A nostro avviso, un flusso di lavoro YOLO personalizzato richiede più configurazione; i requisiti dei container dipendono dalle opzioni di addestramento e distribuzione selezionate. Se vuoi restare su AWS, la nostra guida alla distribuzione su SageMaker mostra come distribuire lì un modello YOLO.
Ultralytics Platform ha un ambito più ristretto per scelta. È progettata intorno ai modelli Ultralytics YOLO, quindi i passaggi precedenti sostituiscono lo script di addestramento e il container di distribuzione. È meno adatta se la tua organizzazione richiede credenziali STS temporanee per ogni integrazione o se un endpoint deve scalare su molte istanze con un carico elevato di richieste simultanee. Se stai ancora decidendo dove eseguire l'inferenza, la nostra guida al cloud e all'hosting autonomo confronta costi, latenza e controllo dei dati.
Domande frequenti
Ultralytics Platform connette un bucket S3, indicizza le immagini sul posto, addestra YOLO26 su una GPU cloud e distribuisce il modello a un endpoint HTTPS dedicato. Anche Amazon SageMaker AI addestra da S3 e offre inferenza in tempo reale, serverless e asincrona; a seconda dell'opzione di distribuzione, usa container forniti da SageMaker o personalizzati. Google Vertex AI e Azure Machine Learning offrono flussi di lavoro simili basati sui rispettivi sistemi di archiviazione, Cloud Storage e archivi Azure, anziché su un bucket S3 esistente.
Platform non conserva una seconda copia del tuo dataset: indicizza le immagini e trasmette gli originali su richiesta. Con le funzionalità AI attive, durante un'esecuzione l'addestramento cloud usa copie temporanee al di fuori del tuo bucket e la ricerca di immagini simili conserva un embedding di ciascuna immagine. Platform non modifica né elimina mai i tuoi oggetti.
Al momento no. Platform richiede una chiave di accesso a lunga durata di un utente IAM dedicato e rifiuta le credenziali STS, perché scadono mentre il dataset è connesso. Limita l'utente ai permessi di elencazione e lettura e disattiva la chiave in IAM per revocare l'accesso.
I dataset S3 richiedono un piano Pro (29 $ al mese per postazione, con 30 $ di credito mensile per postazione) o Enterprise. L'addestramento viene fatturato in base al tempo GPU e la finestra di dialogo di addestramento stima il costo prima dell'avvio. La dimensione predefinita dell'endpoint è gratuita e ha scalabilità fino a zero; le dimensioni personalizzate vengono fatturate a ore durante il funzionamento.
Sì. Google Cloud Storage si connette tramite una chiave JSON di un account di servizio e il ruolo Storage Object Viewer, mentre Azure Blob Storage si connette tramite una stringa di connessione HTTPS con chiave di accesso dell'account (le stringhe con token SAS non sono accettate). I passaggi per il dataset, l'addestramento e la distribuzione sono gli stessi.
Un dataset viene indicizzato una sola volta al momento della creazione, quindi i nuovi oggetti non vengono acquisiti automaticamente. Aggiungi nuovi oggetti invece di sovrascrivere quelli esistenti, quindi crea un nuovo dataset che li includa e addestra di nuovo il modello oppure esegui un nuovo fine-tuning.
Sì. Scarica i pesi oppure esporta il modello in formati come ONNX, TensorRT e CoreML dalla pagina del modello, quindi eseguilo sui tuoi server o dispositivi edge con il pacchetto Python di Ultralytics.
Scritto da
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









