Ultralytics YOLOとNVIDIA Cosmos Data Factory:欠陥検出のための合成データ
NVIDIAのNVIDIA Cosmos Data Factoryと自動化されたエージェント型データ拡張トレーニングループによる合成データを活用することで、Ultralytics YOLOはラベルの一部だけで全データセットと同等の精度を実現できます。
UltralyticsとNVIDIAは、ターゲットを絞ったトレーニングデータの効果をUltralytics YOLOで示すために提携しました。NVIDIAのエージェント型データ拡張トレーニングループがモデルに必要な画像を特定し、NVIDIA Cosmos Data Factoryがまだ存在しない画像を生成し、その結果を使ってUltralytics YOLOをトレーニングします。機械学習(ML)チームは、この組み合わせを19件の公開産業検査ベンチマークで評価し、NVIDIAのエージェント型パイプラインとCosmos Data Factoryの合成データでトレーニングしたUltralytics YOLO26を、従来の方法でトレーニングした同じモデルと比較しました。この記事では、その結果を紹介します。
データを増やすだけでは解決しません。必要なのは適切なデータです。#
検査チームなら誰もが経験するパターンがあります。欠陥検出モデルは、何度も見た欠陥では高い性能を発揮しますが、生産ラインで最も重要なまれな傷、特殊な照明条件、または奇妙なカメラアングルを見逃します。一般的な対処法は、あらゆる種類の画像をさらに収集してラベル付けすることですが、時間と費用がかかるうえ、その大半はモデルがすでに適切に処理できる画像です。
NVIDIAを活用した自動エージェント型トレーニングは、異なるアプローチを取ります。データセットの具体的な弱点を見つけ、すでに存在する実画像、または実例がない場合はCosmos Data Factoryで生成した合成画像で補います。Ultralytics YOLOと組み合わせることで、モデルに不足しているデータだけを使ってトレーニングできます。
NVIDIAのデータ拡張トレーニングループはどのように機能しますか?#
Ultralytics YOLO向けのNVIDIAのエージェント型データ拡張トレーニングループは、トレーニングループをラップし、モデルが次に必要とするデータを判断するモデル改善パイプラインです。
• 実データを発掘します。既存の画像プールを検索し、トレーニングセットの具体的な不足を補う実例を見つけます。
• 合成データを生成します。実例が存在しない場合は、Cosmos Data Factoryでエッジケースの画像を生成します。
• 自動でラベルを付けます。AnomalyGenというコンポーネントが合成画像にラベルを付けるため、再トレーニング前の手動アノテーションは不要です。
このアプローチの基本方針は、データ効率よりもターゲットを絞ったデータの活用です。目標は、単に少ないデータでトレーニングすることではありません。データを発掘または生成し、拡充したデータセットで再トレーニングすることで、モデルの弱点となるデータセットの不足を正確に補うことです。以下の結果が示すように、これをうまく行った結果として、使用する画像が少なくなることもよくあります。
このパイプラインはUltralytics YOLOを用いて詳細にベンチマークされており、この記事のすべての結果にはUltralytics YOLO26を使用しています。
NVIDIA Cosmos Data Factoryの役割#
Cosmos Data Factoryは、NVIDIAのCosmos世界モデルを基盤とするデータキュレーション、処理、生成のプラットフォームです。エージェント型トレーニングループでは、製造業における特定の欠陥タイプや、輸送映像における魚眼レンズの歪みなど、実データセットで十分にカバーできないシナリオの画像を生成します。
引き継ぎはシンプルです。Cosmosがエッジケースの画像を生成し、AnomalyGenがラベルを付け、Ultralytics YOLOは標準のUltralyticsトレーニングパイプラインを使って、実データと合成データを組み合わせたセットで再トレーニングされます。
19件の公開データセットでCosmos Data Factoryを検証#
Cosmos Data FactoryとUltralytics YOLOの可能性を確かめるため、MLチームは19件の公開産業検査データセットでエージェント型データ拡張ファインチューニングパイプラインを実行しました。対象は鋼材、PCB、布地、金属表面、消費者向け製品で、トレーニング画像は合計約91,000枚です。すべての実行で8基のGPUを搭載したホストを1台使用しました。
比較条件は意図的に厳密に設定しました。ベースラインとCosmos Data Factoryモデルは、同一の設定、つまりUltralytics YOLO26x、100エポック、同じオプティマイザー、学習率、シードでトレーニングし、同じホールドアウトテストセットで評価しました。異なるのは、各モデルがトレーニングに使用した画像だけです。ベースラインでは、ラベル付き画像をすべて使用します(合成データのテストでは、実画像のみを使用します)。
1. ラベルの一部だけで同等の精度を実現#
19件のデータセットのうち11件で、エージェント型パイプラインを使ってトレーニングしたUltralytics YOLO26xは、全データセットでトレーニングした同じモデルと同等の性能を達成しました。この11件では、ラベル付き画像の53%が不要でした。
| データセット | ラベル付き | 使用済み | 不要 | 全データのmAP@0.5 | キュレーション後のmAP@0.5 |
|---|---|---|---|---|---|
| dagmクラス1 | 1,035 | 90 | 91% | 0.9923 | 0.9998 |
| dagmクラス2 | 1,035 | 90 | 91% | 1.0000 | 0.9999 |
| dagmクラス3 | 1,035 | 90 | 91% | 1.0000 | 0.9987 |
| dagmクラス4 | 1,035 | 90 | 91% | 1.0000 | 0.9991 |
| dagmクラス7 | 2,070 | 180 | 91% | 1.0000 | 0.9995 |
| dagmクラス8 | 2,070 | 178 | 91% | 0.9991 | 1.0000 |
| dagmクラス9 | 2,070 | 180 | 91% | 1.0000 | 0.9992 |
| dagmクラス10 | 2,070 | 180 | 91% | 1.0000 | 1.0000 |
| pcb-defect | 20,924 | 13,903 | 34% | 0.9900 | 0.9893 |
| hripcb | 559 | 414 | 26% | 0.9891 | 0.9754 |
| deeppcb | 1,000 | 900 | 10% | 0.9887 | 0.9885 |
表1. Cosmos Data Factoryが全データモデルと同等の性能を達成したデータセット。同じホールドアウトセットでのmAP@0.5。
DAGMデータセットでは、エージェント型パイプラインはラベル数を10分の1にしても同じmAP@0.5を達成し、2つのクラスでは全データモデルをわずかに上回りました。pcb-defectでは、20,924枚のうち7,000枚を削減しながら、実行間のばらつきの4分の1という精度差に抑えました。
アノテーションに費用をかけているチームにとって、重要なポイントは次のとおりです。このデータセットでは、ラベリング予算の大半が結果を変えない画像に費やされていました。
2. トレーニングを最大74%高速化#
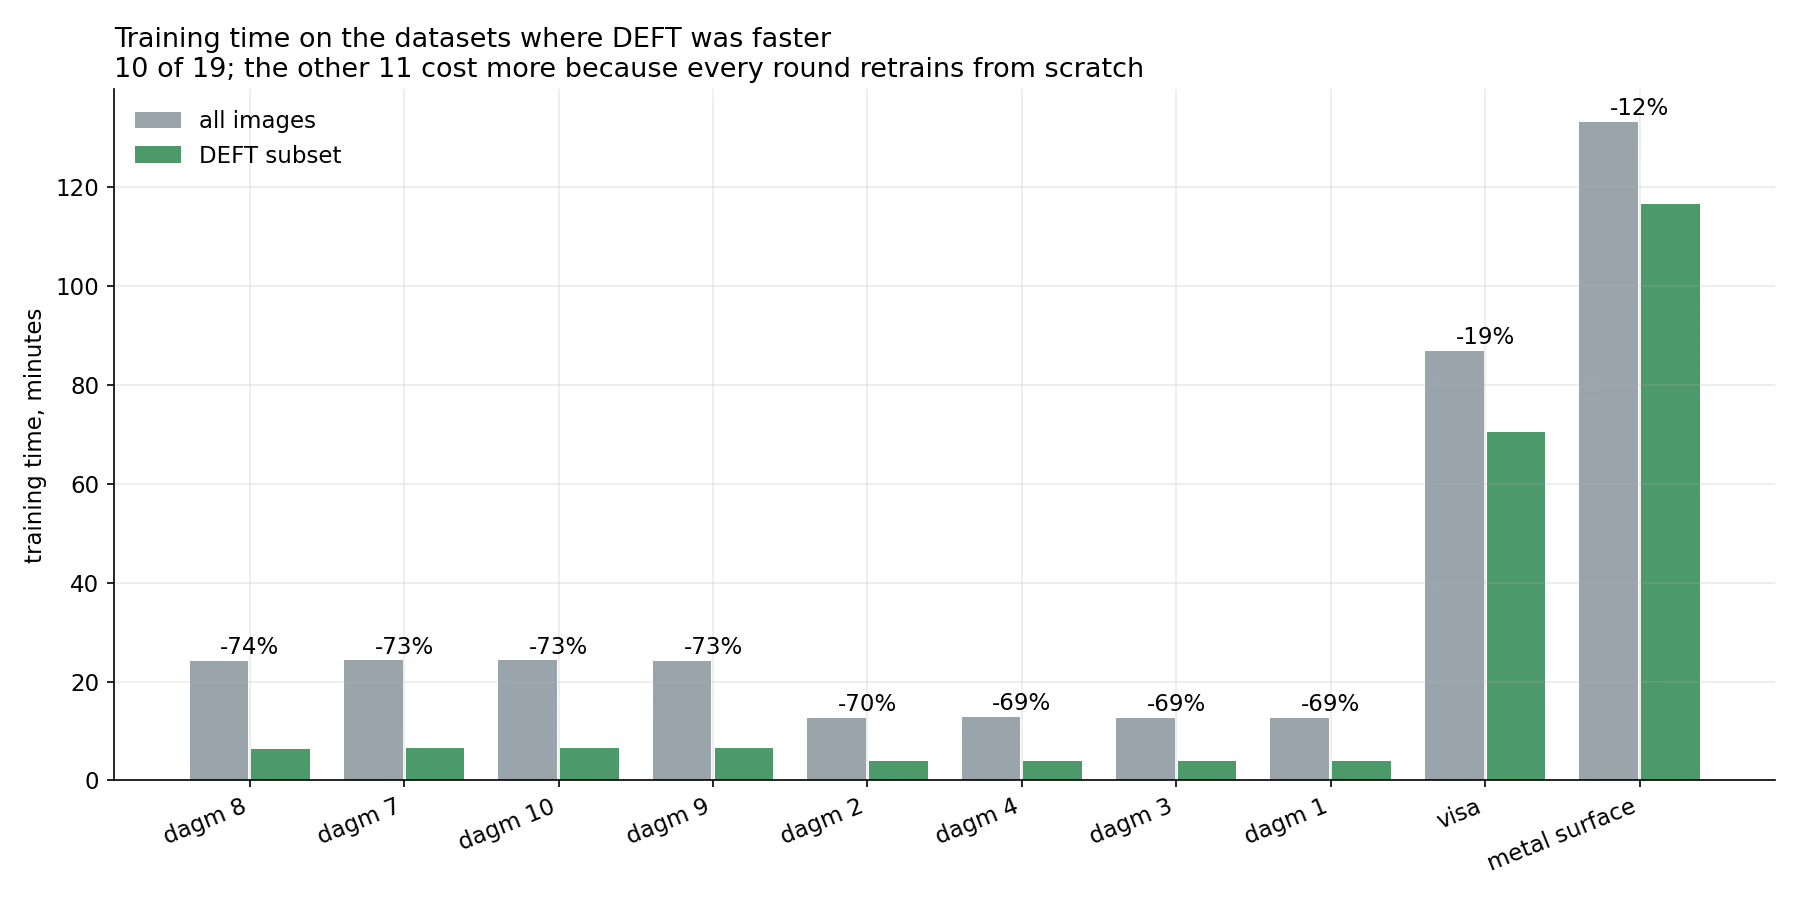
図1. Cosmos Data Factoryのサブセットを使用した場合に高速化したデータセットにおける、全データセットとCosmos Data Factoryサブセットのトレーニング時間。
Ultralytics YOLOのトレーニングに、より小規模でターゲットを絞ったセットを使うと、計算量も削減できます。19件中10件のデータセットで、エージェント型パイプラインによるトレーニングが高速化しました。DAGMでは、トレーニング時間が13~24分から4~7分に短縮され、69~74%削減されました。大規模なデータセットでも、VisAで19%、metal-surface-defectで12%と、規模は小さいながら実質的な削減が見られました。
削減効果はすべてのケースで得られるわけではありません。残る9件のデータセットでは、キュレーションの各ラウンドで最初から再トレーニングするため、エージェント型パイプラインの所要時間が全データで1回実行する場合を上回りました。キュレーション後のサブセットが元データとあまり変わらない場合、追加のラウンドにかかる時間が削減分を上回ります。
3. 生成した欠陥でバウンディングボックスの精度を向上#
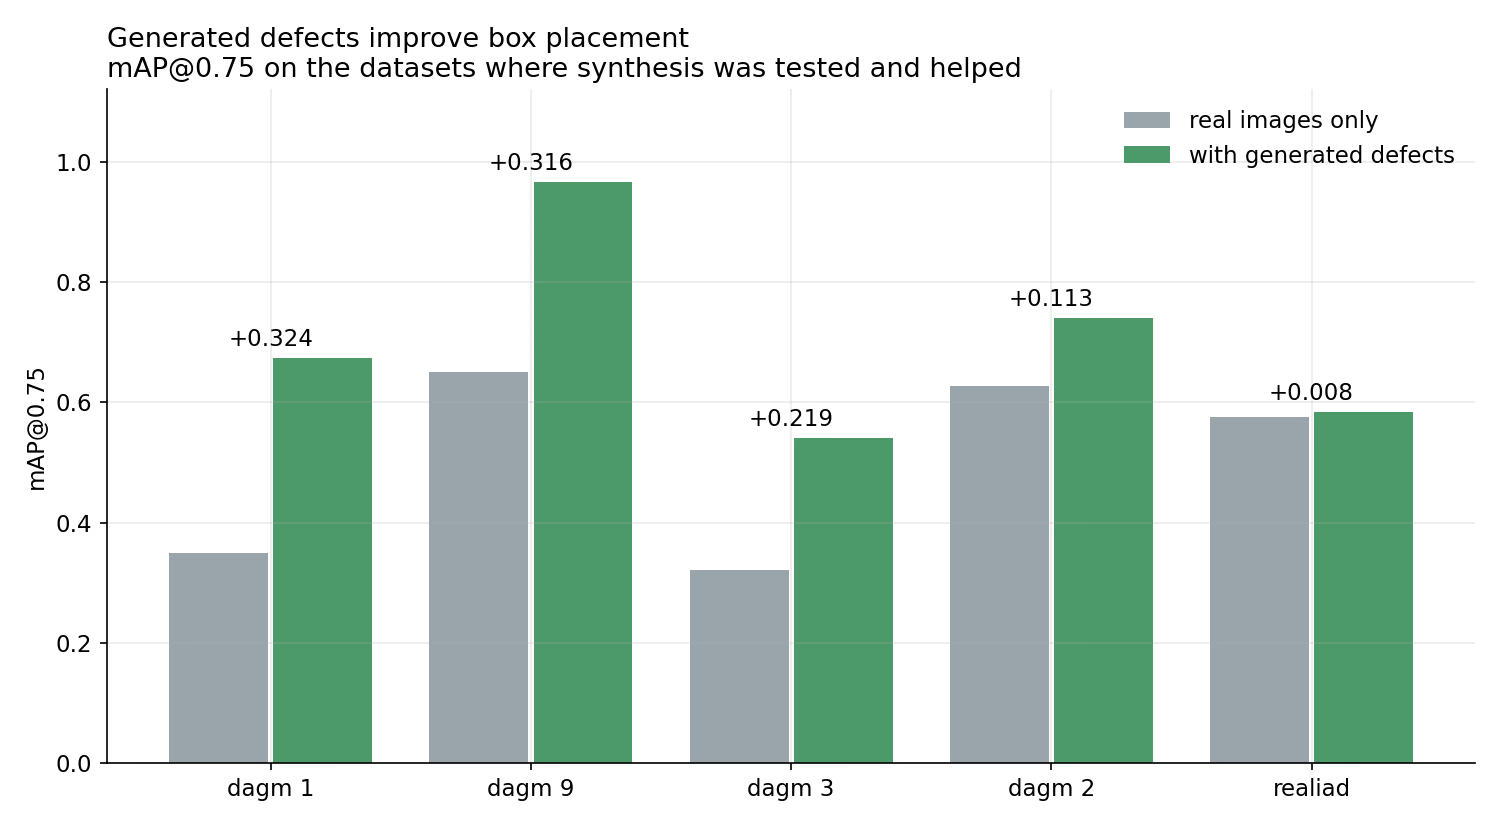
図2. 合成データをテストし、効果が確認されたデータセットにおける、実画像のみの場合と生成した欠陥を加えた場合のmAP@0.75。
3つ目のテストでは、合成データの効果を切り分けて評価しました。ポリゴンアノテーションのあるデータセットに、Cosmos Data Factoryで生成し、AnomalyGenでラベルを付けた欠陥を追加し、その結果得られたUltralytics YOLOモデルを実画像のみでトレーニングしたモデルと比較しました。
mAP@0.5より厳格な指標であるmAP@0.75を報告します。予測ボックスが正解の欠陥と75%以上重なる場合にのみ、予測が正しいと判定されます。この指標は、欠陥を見つけたかどうかだけでなく、モデルがどれだけ正確に位置を特定できるかを測定します。生成した欠陥を追加すると、DAGMの各クラスでmAP@0.75が0.11~0.32向上し、テストしたすべてのデータセットで再現率が改善しました。最大の向上はDAGMクラス9で、0.650から0.966になりました。Real-IADでの向上はわずかでした(+0.008)。
欠陥はもともとまれなため、特定の欠陥タイプの実例は常に不足しています。ラベル付け済みの欠陥を生成すれば、誰もポリゴンを描くことなく、Ultralytics YOLOに欠陥の正確な形状と範囲を学習させられます。
使用した合成データの量#
生成処理は3つのステップで行われます。まずCosmos Data Factoryが実画像上で妥当な欠陥位置を特定し(配置)、次に生成器がその位置に欠陥画像を描画し(生成)、最後に設定した上限までの画像をトレーニングセットに追加します(採用)。2つの上限をテストしました。合成画像をトレーニングセットの実画像の25%または100%とする設定です。
18回の生成ラウンド(ベースライン9回、合成データ9回)で、パイプラインは11,448枚の画像を生成しました。そのうち採用されたのは1,481枚、約8枚に1枚だけでした。つまり、各Ultralytics YOLOモデルが見る合成データの量を決めたのは上限であり、生成器の出力ではありません。上限を100%にすると、各トレーニングセットには実画像1枚につき合成画像が1枚含まれ、25%では実画像4枚につきおよそ1枚含まれます。絶対数で見ると、量は少なく、DAGMでは実画像90~180枚に、最大でも同数の合成画像を追加しました。
| データセット | 上限 | 配置 | 生成 | 除外 | 採用 | 実データ | 比率 |
|---|---|---|---|---|---|---|---|
| dagmクラス1 | 25% | 870 | 440 | 0 | 22 | 90 | 1 : 0.24 |
| dagmクラス1 | 100% | 870 | 400 | 0 | 90 | 90 | 1 : 1.00 |
| dagmクラス2 | 25% | 606 | 254 | 0 | 22 | 90 | 1 : 0.24 |
| dagmクラス2 | 100% | 606 | 304 | 0 | 90 | 90 | 1 : 1.00 |
| dagmクラス3 | 25% | 900 | 370 | 0 | 22 | 90 | 1 : 0.24 |
| dagmクラス3 | 100% | 900 | 370 | 0 | 90 | 90 | 1 : 1.00 |
| dagmクラス9 | 100% | 1,800 | 620 | 0 | 180 | 180 | 1 : 1.00 |
| realiad | 25% | 9,534 | 4,440 | 0 | 193 | 772 | 1 : 0.25 |
| realiad | 100% | 9,534 | 4,250 | 0 | 772 | 772 | 1 : 1.00 |
| 合計 | 11,448 | 0 | 1,481 |
表2. 各実行の生成記録と採用記録に基づく、生成画像の枚数と実データ対合成データの比率。
検査モデルを構築するチームにとっての意味#
すでにUltralytics YOLOをトレーニングしているチームにとって、Cosmos Data FactoryとNVIDIAを活用した自動エージェント型トレーニングは、既存のワークフローにそのまま組み込めます。モデルとトレーニング設定はそのままに、より適切なデータを投入できます。
• 収集できないエッジケースをカバーします。自動ラベル付きの合成欠陥により、実例が少ない場合でもUltralytics YOLOが欠陥の位置を特定できます。
• ラベリング予算を効果のある箇所に使います。テストしたデータセットの半数以上では、ラベルの大半が重複していました。ターゲットを絞った選定により、重要な画像を見つけられます。
• 反復を高速化します。キュレーションした小規模なトレーニングセットにより、多くのデータセットでUltralytics YOLOのトレーニング時間が短縮し、実験をより迅速に行えます。
提供状況#
Cosmosをベースにした合成画像生成ステップは、現在サンプルおよびデモとして利用できますが、製品に組み込まれた機能としてはまだ提供されていません。
Cosmos Data Factoryを独自のUltralytics YOLOモデルで試すには、Ultralyticsチームにお問い合わせください。合成画像生成ステップの完全な統合に向けて、今後もNVIDIAとの協力を続けます。
付録:テスト設定とデータセット#
すべての実行で、Ultralytics YOLO26x、100エポック、ベースラインとCosmos Data Factoryで同一のオプティマイザー、学習率、シードを使用しました。8基のGPUを搭載したホストを1台使用し、データセットごとに同じホールドアウトテストセットで評価しました。ポリゴンアノテーションがある11件のデータセットでは、生成した欠陥を使用できます。
| データセット | トレーニング画像 | アノテーション | ソース |
|---|---|---|---|
| dagmクラス1、2、3、4 | 各1,035枚 | ポリゴン | DAGM 2007 |
| dagmクラス7、8、9、10 | 各2,070枚 | ポリゴン | DAGM 2007 |
| pcb-defect | 20,924 | ボックス | PCB defect |
| dspcbsd | 6,575 | ボックス | DsPCBSD+ |
| deeppcb | 1,000 | ボックス | DeepPCB |
| hripcb | 559 | ボックス | HRIPCB |
| metal-surface-defect | 11,845 | ボックス | NEU surface defect |
| tianchifabric | 10,332 | ボックス | Tianchi fabric |
| severstal | 10,061 | ポリゴン | Severstal steel |
| mvtec-ad | 4,637 | ボックス | MVTec AD |
| visa | 7,794 | ポリゴン | VisA |
| realiad-bottle-cap | 3,581 | ポリゴン | Real-IAD |
| crack | 1,290 | ボックス | crack segmentation |
表3. 19個のデータセット(DAGMはクラスごとに1つとして、8つに数えます)。









