En İyi Görüntü Sınıflandırma Modelleri: Nasıl Seçim Yapılır?
ConvNeXt V2 ve DINOv3'ten EfficientNetV2, ViT ve Ultralytics YOLO26-cls'ye kadar önde gelen görüntü sınıflandırma modellerini karşılaştır ve nasıl seçim yapacağını öğren.
Görüntü sınıflandırmada herkese uyan tek bir en iyi model yoktur. Doğru seçim; etiketli verinin miktarına, modelin nerede çalıştırılacağına ve lisansının kullanımına izin verip vermediğine bağlıdır. 2026'da en yüksek doğruluğu hedefleyen çalışmalar DINOv3 ve EVA-02 gibi büyük Transformer ve öz denetimli omurga ağlarına odaklanıyor. Sınırlı donanımlarda dağıtım için ConvNeXt V2, EfficientNetV2, MobileNetV4 ve Ultralytics YOLO26-cls gibi daha küçük, çoğunlukla evrişimli modeller; kontrol noktası boyutuna, eğitim kurulumuna ve hedef donanıma bağlı olarak genellikle daha uygundur. Kendi iş yükünde doğruluklarını ve gecikme sürelerini karşılaştır. Bu kılavuz dört model ailesini açıklar, yaygın olarak kullanılan on modeli karşılaştırır ve seçim yapman için bir yol sunar.
Görevin kendisi hakkında bilgi edinmeye yeni başladıysan, görüntü sınıflandırmanın ne olduğuyla başla. Bu sayfa model seçimiyle ilgilidir.
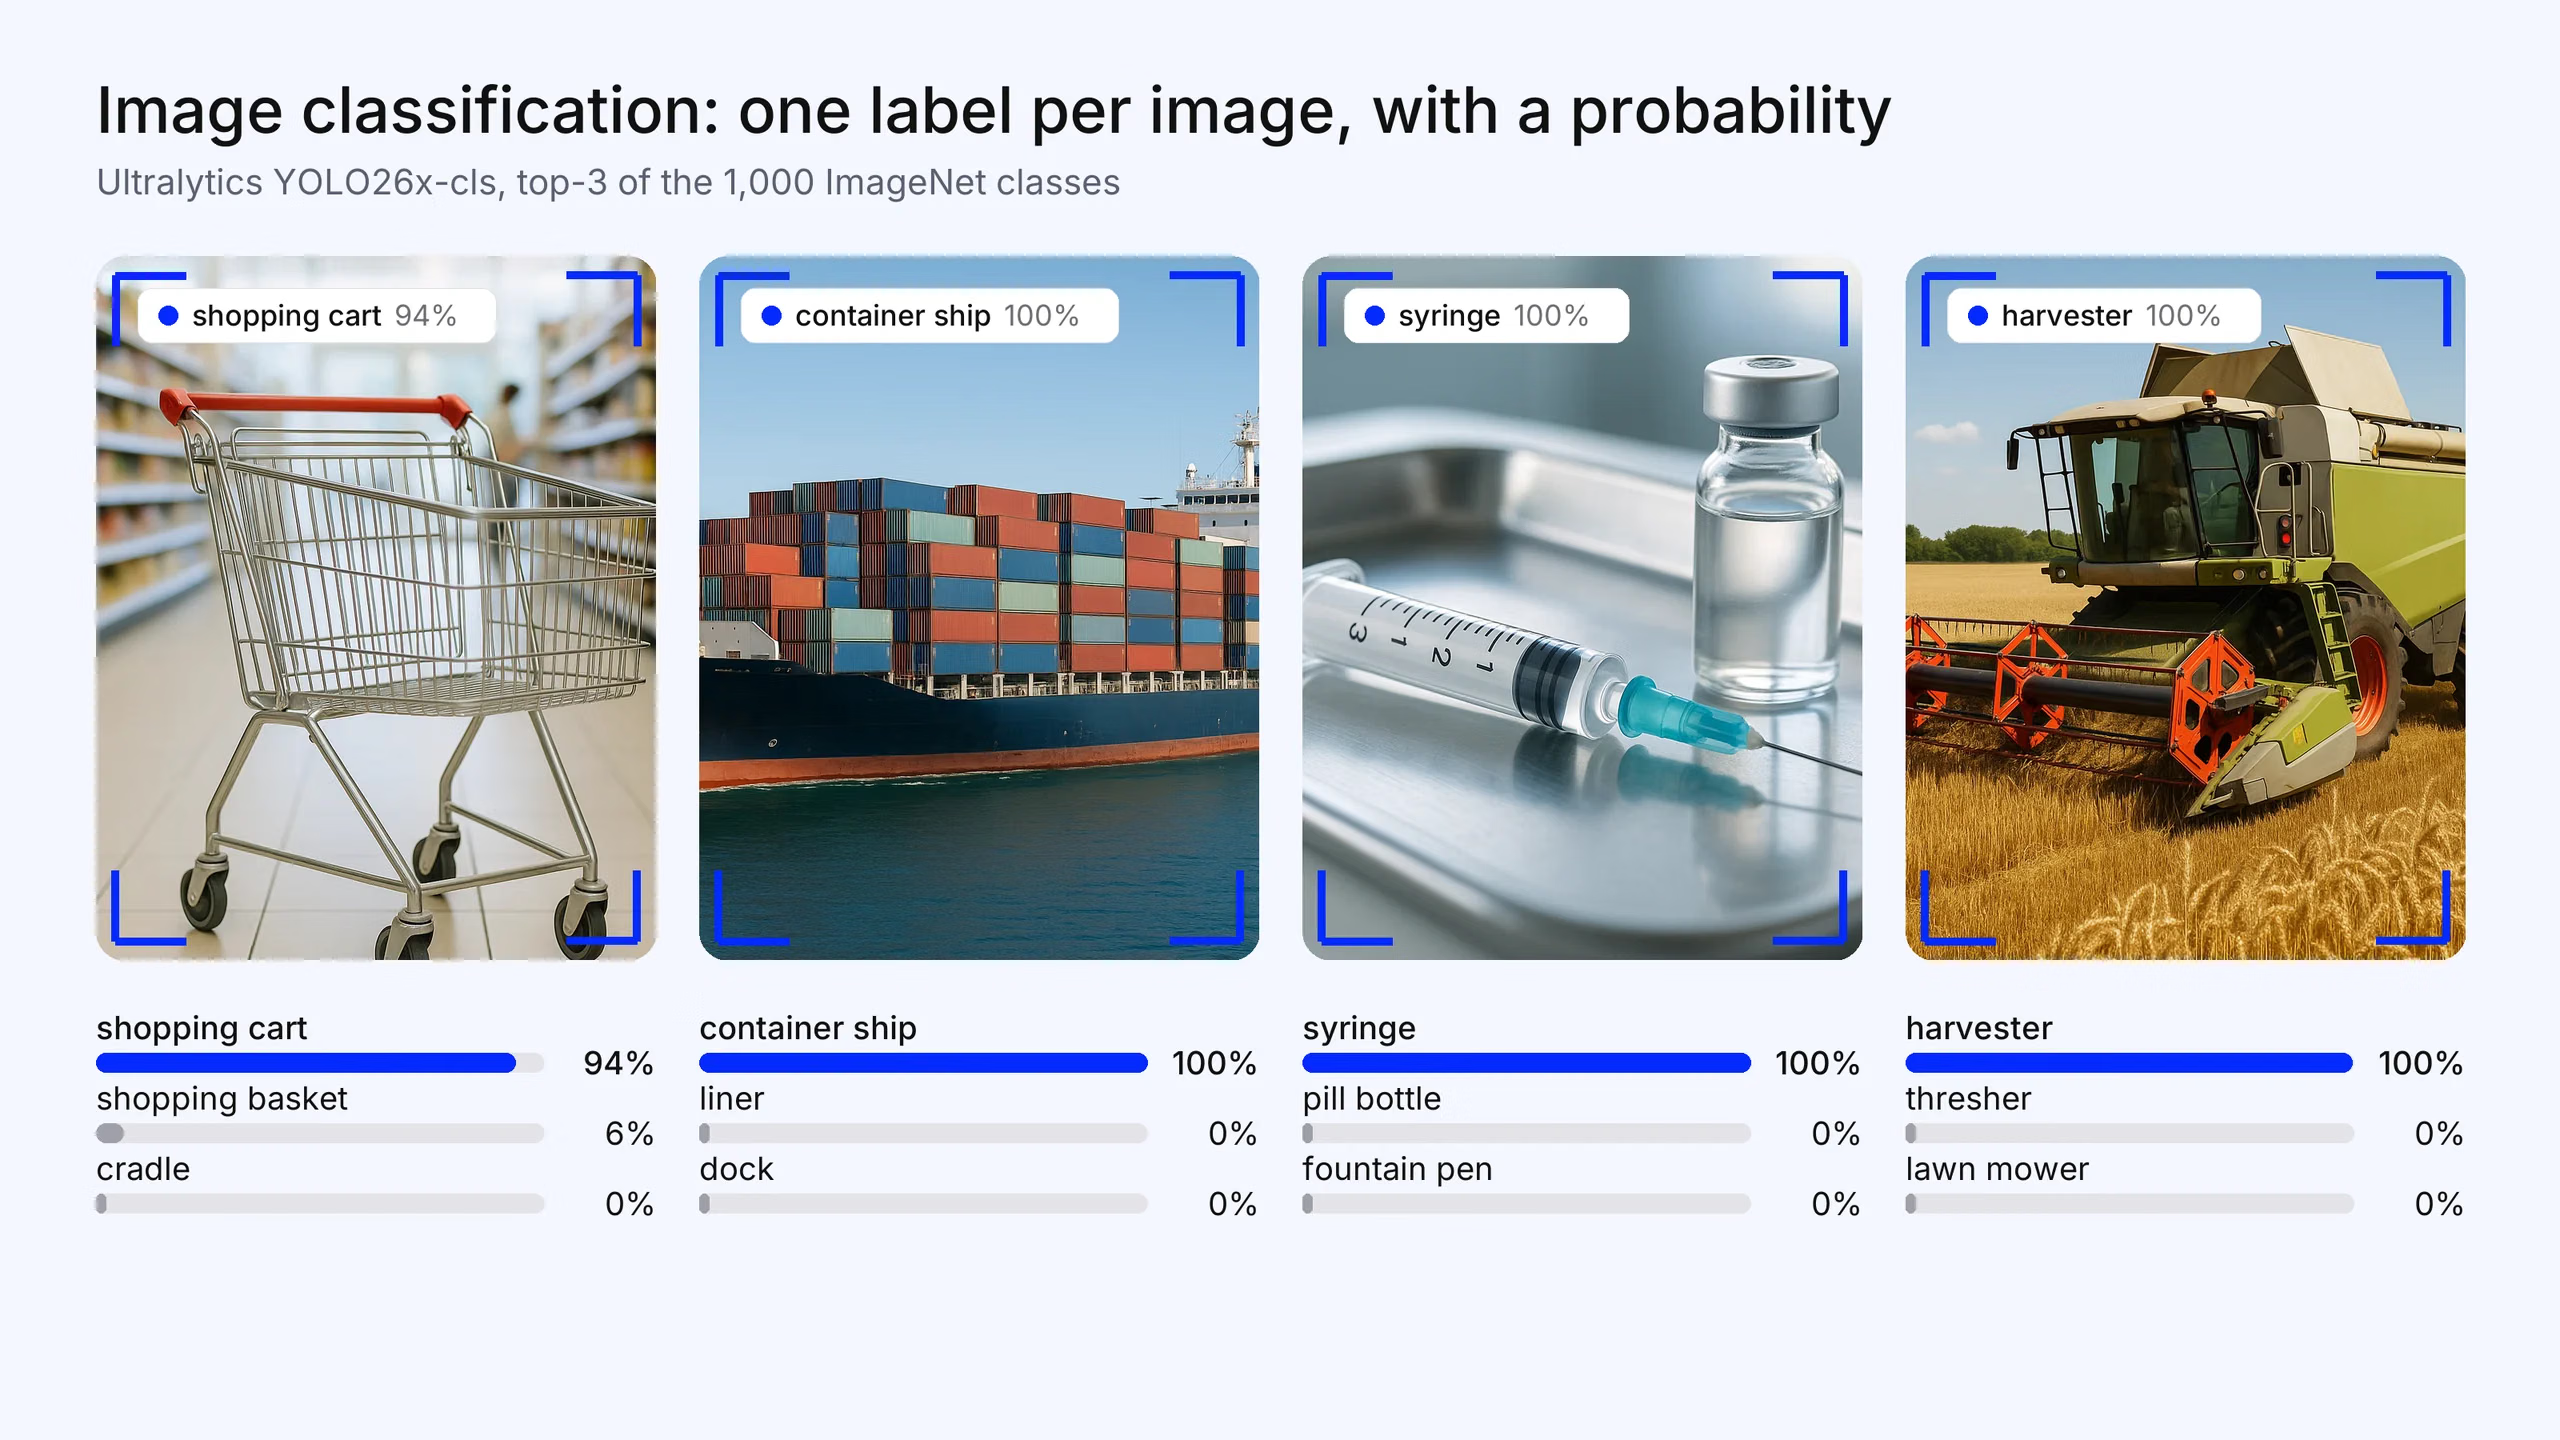
Şekil 1. Görüntü sınıflandırma, her sınıf için bir olasılık değeriyle birlikte tüm görüntüye tek bir etiket atar: perakende, lojistik, sağlık ve tarım örnekleri. 1.000 ImageNet sınıfında önceden eğitilmiş Ultralytics YOLO26x-cls modelinin ilk 3 tahmini. Fotoğraflar bu makale için üretildi; tahminler gerçek model çıktılarıdır.
Görüntü sınıflandırma modelinde "en iyi" ne anlama gelir?#
Sıralama tabloları modelleri ImageNet doğrulama kümesindeki top-1 doğruluğuna göre sıralar. Bu sayı yararlıdır, ancak sabit bir çözünürlükte, tek bir veri kümesinde ve çoğunlukla çok büyük ölçekli ön eğitim kullanılarak ölçülür. Gerçek bir projede kararı genellikle dört başka etken belirler:
- Veri. Her sınıf için kaç etiketli görüntün olduğu ve bu görüntülerin ön eğitim verilerine ne kadar benzediği.
- Hesaplama gücü ve gecikme. Çıkarımın veri merkezi GPU'sunda, CPU'da ya da telefon veya kamera NPU'sunda çalışıp çalışmayacağı.
- Dağıtım yolu. Modelin ONNX, TensorRT, Core ML veya TFLite gibi ihtiyaç duyduğun çalışma ortamına sorunsuz aktarılıp aktarılamayacağı.
- Lisans. Kodun ve ayrıca önceden eğitilmiş ağırlıkların kullanımına izin verilip verilmediği.
ImageNet'te birkaç puan daha düşük olup görüntülerinde iyi ince ayar yapılan ve donanımında gerçek zamanlı çalışan bir model genellikle daha iyi seçimdir.
Görüntü sınıflandırma modellerinin dört ailesi#
Evrişimli sinir ağları (CNNs)#
CNNs, öğrenilmiş filtreleri görüntü boyunca kaydırır ve böylece yakın piksellerin birbiriyle ilişkili olduğunu varsayar. Yerleşik bu varsayım (bir endüktif önyargı), küçük ve orta büyüklükteki veri kümelerinden iyi öğrenmelerini ve mütevazı donanımlarda verimli çalıştırılmalarını sağlar. Klasik örnekler ResNet ve EfficientNet modelleridir.
- Güçlü yönleri: Verimli veri kullanımı, yüksek hız, kolay nicemleme ve dağıtım.
- Ödünleşimler: Her katmanda daha az küresel bağlam; ölçeklendirmeden elde edilen kazanımlar Transformer modellerine kıyasla daha erken düzleşme eğilimindedir.
Görü transformer'ları (ViT'ler)#
Bir görüntü Transformer'ı, görüntüyü parçalara böler ve her parçanın diğer tüm parçalarla ilişki kurabilmesi için bu parçaları öz dikkat mekanizmasıyla bir dizi olarak işler. ViT'ler, büyük miktarda veriyle önceden eğitilip ardından başka görevlere aktarıldıklarında en iyi performansı gösterir.
- Güçlü yönleri: Veri ve model boyutuyla iyi ölçeklenir; aktarım performansı güçlüdür; öz denetimli ve çok modlu eğitim için doğal bir temel oluşturur.
- Ödünleşimler: Büyük ölçekli ön eğitim veya yoğun düzenlileştirme gerektirir; çıkarımda benzer doğruluğa sahip bir CNN'den genellikle daha yavaş ve daha ağırdır.
CNN-Transformer hibrit modelleri#
Hibrit modeller, yerel ayrıntılar için ilk aşamalarda evrişim, küresel bağlam için sonraki aşamalarda dikkat mekanizmaları kullanır. CoAtNet örnek tasarımdır: tasarımcıları, evrişim ve dikkat katmanlarını ilkeli bir sırayla üst üste koymanın genelleme kabiliyetini, kapasiteyi ve verimliliği artırdığını buldu.
- Güçlü yönleri: Orta büyüklükteki veri kümelerinde iyi bir denge sunar.
- Ödünleşimler: Tamamen evrişimli veya tamamen dikkat temelli tasarımlara kıyasla uygulaması, ayarlanması ve dışa aktarılması daha karmaşıktır.
Öz denetimli ve görsel-dil omurga ağları#
En yeni aileyi mimari değil, eğitim yöntemi tanımlar. DINOv2 ve DINOv3 gibi öz denetimli modeller etiketsiz görüntülerden öğrenir. SigLIP 2 gibi görsel-dil kodlayıcıları, görüntü-metin çiftlerinden öğrenir. Her ikisi de küçük bir doğrusal başlıkla sınıflandırabileceğin genel amaçlı özellikler üretir; görsel-dil modelleri ise metin istemleriyle ve hiç eğitim yapmadan da kullanılabilir (sıfır örnekli öğrenme). Meta, DINOv3'ü 1,7 milyar görüntü üzerinde 7 milyar parametreyle eğitti; DINOv2 ise 1,1 milyar parametreye ve 142 milyon görüntüye sahipti.
- Güçlü yönleri: Az etiketli veriyle güçlü özellikler sunar; tek bir omurga ağı birçok göreve hizmet eder.
- Ödünleşimler: En büyük kontrol noktaları uç cihazlar için fazlasıyla ağırdır; lisanslar değişkenlik gösterir ve kontrol edilmeleri gerekir.
Görüntü sınıflandırma modelleri karşılaştırması#
Modeller sıralamaya göre değil, alfabetik olarak listelenmiştir. Doğruluk değerlerini eklemedik: yayımlanan ImageNet sonuçları çözünürlüğe, ön eğitim verilerine ve değerlendirme yöntemine göre değişir; bu nedenle bu satırlar arasında karşılaştırılamaz. Aşağıda bağlantısı verilen her modelin makalesinde veya belgelerinde o modele ait değerler yer alır.
| Model | Aile | Geliştirici | Ön eğitim | En uygun olduğu durum | Temel ödünleşim |
|---|---|---|---|---|---|
| ConvNeXt V2 | CNN | Meta | Öz denetimli maskeli otomatik kodlama (FCMAE), ardından denetimli ince ayar | Birçok boyutta doğru ve dağıtıma uygun CNN | ImageNet ağırlıkları CC-BY-NC lisanslıdır (ticari olmayan kullanım) |
| DINOv3 | Öz denetimli (ViT ve ConvNeXt) | Meta | 1,7 milyar görüntü üzerinde öz denetimli eğitim | Dondurulmuş özelliklerle güçlü performans, az etiketli veri | Özel DINOv3 Lisansı; en büyük model 7B parametreye sahiptir |
| EfficientNetV2 | CNN | Denetimli | Hızlı eğitim, verimli ince ayar | Eski tasarım; yeni omurga ağları doğrulukta öne geçiyor | |
| EVA-02 | ViT | BAAI | CLIP özellikleri üzerinde maskeli görüntü modelleme | Doğruluk odaklı araştırma ve ince ayar | Büyük sürümler çıkarım sırasında ağırdır |
| MobileNetV4 | CNN ve hibrit (mobil) | Denetimli | Telefonlar, NPU'lar ve uç hızlandırıcılar | Sunucu sınıfı modellere kıyasla daha düşük doğruluk tavanı | |
| ResNet | CNN | Microsoft Research | Denetimli | Temel karşılaştırmalar, öğretim, eski işlem hatları | FLOP başına doğrulukta artık rekabetçi değil |
| SigLIP 2 | Görsel-dil (ViT) | Görüntü-metin çiftleri, çok dilli | Sıfır örnekli ve açık kelime dağarcıklı sınıflandırma | Sıfır örnekli sonuçlara güvenmeden önce, hedeflediğin sınıflarda doğrula | |
| Swin Transformer | ViT (hiyerarşik) | Microsoft Research | Denetimli | Daha yüksek çözünürlüklü girdiler, omurga ağının yeniden kullanımı | Benzer doğruluktaki CNN'lerden daha ağır |
| Ultralytics YOLO26-cls | CNN | Ultralytics | ImageNet üzerinde denetimli eğitim | Hızlı özel sınıflandırıcılar, uç cihazlara dışa aktarım, tespit ile ortak API | Büyük, önceden eğitilmiş Transformer modellerine kıyasla daha düşük doğruluk tavanı |
| ViT | ViT | Denetimli, genellikle büyük veri kümeleri üzerinde | Büyük ölçekte aktarım öğrenmesi | Büyük ölçekli ön eğitim olmadan çok veri gerektirir |
Modelleri daha ayrıntılı inceleyelim#
Alfabetik olarak listelenmiştir.
ConvNeXt V2#
ConvNeXt V2, tamamen evrişimli bir maskeli otomatik kodlayıcıyı (FCMAE) Global Response Normalization katmanıyla birleştirir. Atto (3,7M parametre) ile Huge (660M) arasında sekiz boyutta sunulur; böylece tek bir aile uç cihazlardan sunuculara kadar kullanılabilir. CNN dağıtım kolaylığını Transformer dönemi doğruluğuyla bir arada arıyorsan güçlü bir varsayılan seçimdir. Ödünleşim: Kod MIT lisanslıdır; ancak ImageNet için önceden eğitilmiş ve ince ayar yapılmış ağırlıklar CC-BY-NC lisanslıdır; bu da söz konusu ağırlıkların ticari kullanımını engeller.
DINOv3#
DINOv3, Meta'nın öz denetimli görsel omurga ağıdır. ViT-S/16'dan ViT-7B/16'ya kadar ViT modellerinin yanı sıra cihaz üzerinde kullanım için damıtılmış ConvNeXt modelleriyle yayımlanmıştır. Meta, omurga ağını dondurarak değerlendirir ve depoda 7B model için bir ImageNet sınıflandırma başlığı bulunur. Az sayıda etiketin varsa ve başka görevlere aktarılabilen özellikler istiyorsan denemen gereken model budur. Ödünleşim: Standart bir açık kaynak lisansı yerine kendi DINOv3 Lisansı kapsamında yayımlanır ve öne çıkan sonuçlar en büyük modelden elde edilmiştir.
EfficientNetV2#
Google'ın EfficientNetV2 modeli aşamalı öğrenme kullanır: eğitim sırasında görüntü boyutunu artırır ve düzenlileştirmeyi buna göre ayarlar. Böylece önceki modellere göre daha hızlı eğitilir ve daha az parametre kullanır. Küçük ve orta büyüklükteki veri kümelerinde ince ayar yapmak için hâlâ güvenilir bir seçenektir. Ödünleşim: 2023–2025 omurga ağlarından önce geliştirilmiştir ve artık doğrulukta lider değildir. İlk tasarım hakkında bilgi için EfficientNet genel bakışımıza göz at.
EVA-02#
EVA-02, büyük bir CLIP görsel kodlayıcısının özelliklerini yeniden oluşturmak için maskeli görüntü modellemeyle önceden eğitilmiş standart bir Transformer'dır. 6M ile 304M parametre arasında değişen dört boyutta sunulur. İnce ayar için timm'de kullanılabilir. Ödünleşim: Büyük sürümlerin ince ayarı ve hizmete alınması pahalıdır; basit alan sınıflandırıcıları için gereğinden güçlüdür.
MobileNetV4#
MobileNetV4, Google'ın mobil CPU'larda, DSP'lerde, GPU'larda, Apple Neural Engine'de ve Google Pixel EdgeTPU'da verimli çalışacak şekilde tasarlanmış en yeni mobil model ailesidir. Telefon veya düşük güçlü hızlandırıcılar için doğal bir seçimdir. Ödünleşim: En yüksek doğruluktan ödün vererek gecikmeyi azaltır.
ResNet#
ResNet artık bağlantıları tanıttı ve her çerçeve tarafından desteklenen standart temel model olmaya devam ediyor. Ödünleşim: Yeni CNN'ler aynı hesaplama gücüyle daha yüksek doğruluk sunar. Mimariyi öğrenmek için ResNet-50'nin ne olduğuna göz at.
SigLIP 2#
SigLIP 2 (bkz. SigLIP sözlük maddemiz), Google'ın çok dilli görsel-dil kodlayıcıları ailesidir. Görüntüleri eğitim yapmadan metin etiketleri listesine göre sınıflandırabilir (yaklaşım olarak CLIP'e benzer) ve NaFlex sürümü girdinin doğal en-boy oranını korur. Etiket kümen sık değişiyorsa veya henüz etiketli verin yoksa en uygun seçimdir. Ödünleşim: Sıfır örnekli performans alana göre değişir; bu nedenle sonuçlara güvenmeden önce hedeflediğin sınıflarda (örneğin kusur türlerinde) doğrulama yap. Performans yetersiz kalırsa bir sınıflandırma başlığı eğit veya ince ayar yap.
Swin Transformer#
Swin Transformer, görüntü boyutuyla doğrusal olarak artan hesaplama maliyetini koruyan ve yüksek çözünürlüklü girdilere uygun olan kaydırılmış yerel pencereler içinde dikkat hesaplar. Ödünleşim: Benzer doğruluğa sahip bir CNN'den daha ağırdır; ConvNeXt, standart evrişimlerle onunla rekabet etmek üzere tasarlanmıştır.
Ultralytics YOLO26-cls#
Ultralytics YOLO26-cls, Ultralytics YOLO26'nın sınıflandırma sürümüdür. Beş boyutta (n, s, m, l, x) ve 2,8M ile 29,6M parametre arasında (birleştirilmiş) sunulur; 224 piksel giriş alır ve ImageNet üzerinde önceden eğitilmiştir. Belgeler, ImageNet doğrulama kümesindeki top-1 ve top-5 doğruluk değerlerini ve her boyut için CPU ve GPU gecikme sürelerini bildirir. Aynı Python API'si ve CLI; sınıflandırma, tespit, segmentasyon ve poz modellerini eğitir, doğrular ve dışa aktarır; sınıflandırıcılar ONNX, TensorRT, Core ML, OpenVINO ve LiteRT dâhil çeşitli biçimlere aktarılabilir. Önceki YOLO11-cls modelleri aynı beş boyutu ve giriş boyutunu kullanır. Ödünleşimler:
- Doğruluk tavanı. x modeli bile EVA-02 veya DINOv3 gibi büyük, önceden eğitilmiş Transformer'ların yanında küçüktür; bu nedenle doğruluk odaklı araştırmalar için uygun seçim değildir.
- Varsayılan olarak kare kırpmalar. Eğitimde rastgele boyutlandırılmış kırpma, doğrulamada ise merkez kırpma kullanılır; bu, en-boy oranı aşırı olan görüntülerin bazı kısımlarını kesebilir. Belgelerde standart yeniden boyutlandırmanın nasıl kullanılacağı gösterilir.
- Lisans. Ultralytics modelleri AGPL-3.0 lisanslıdır. Kapalı kaynaklı ticari kullanım için Ultralytics Enterprise lisansı gerekir.
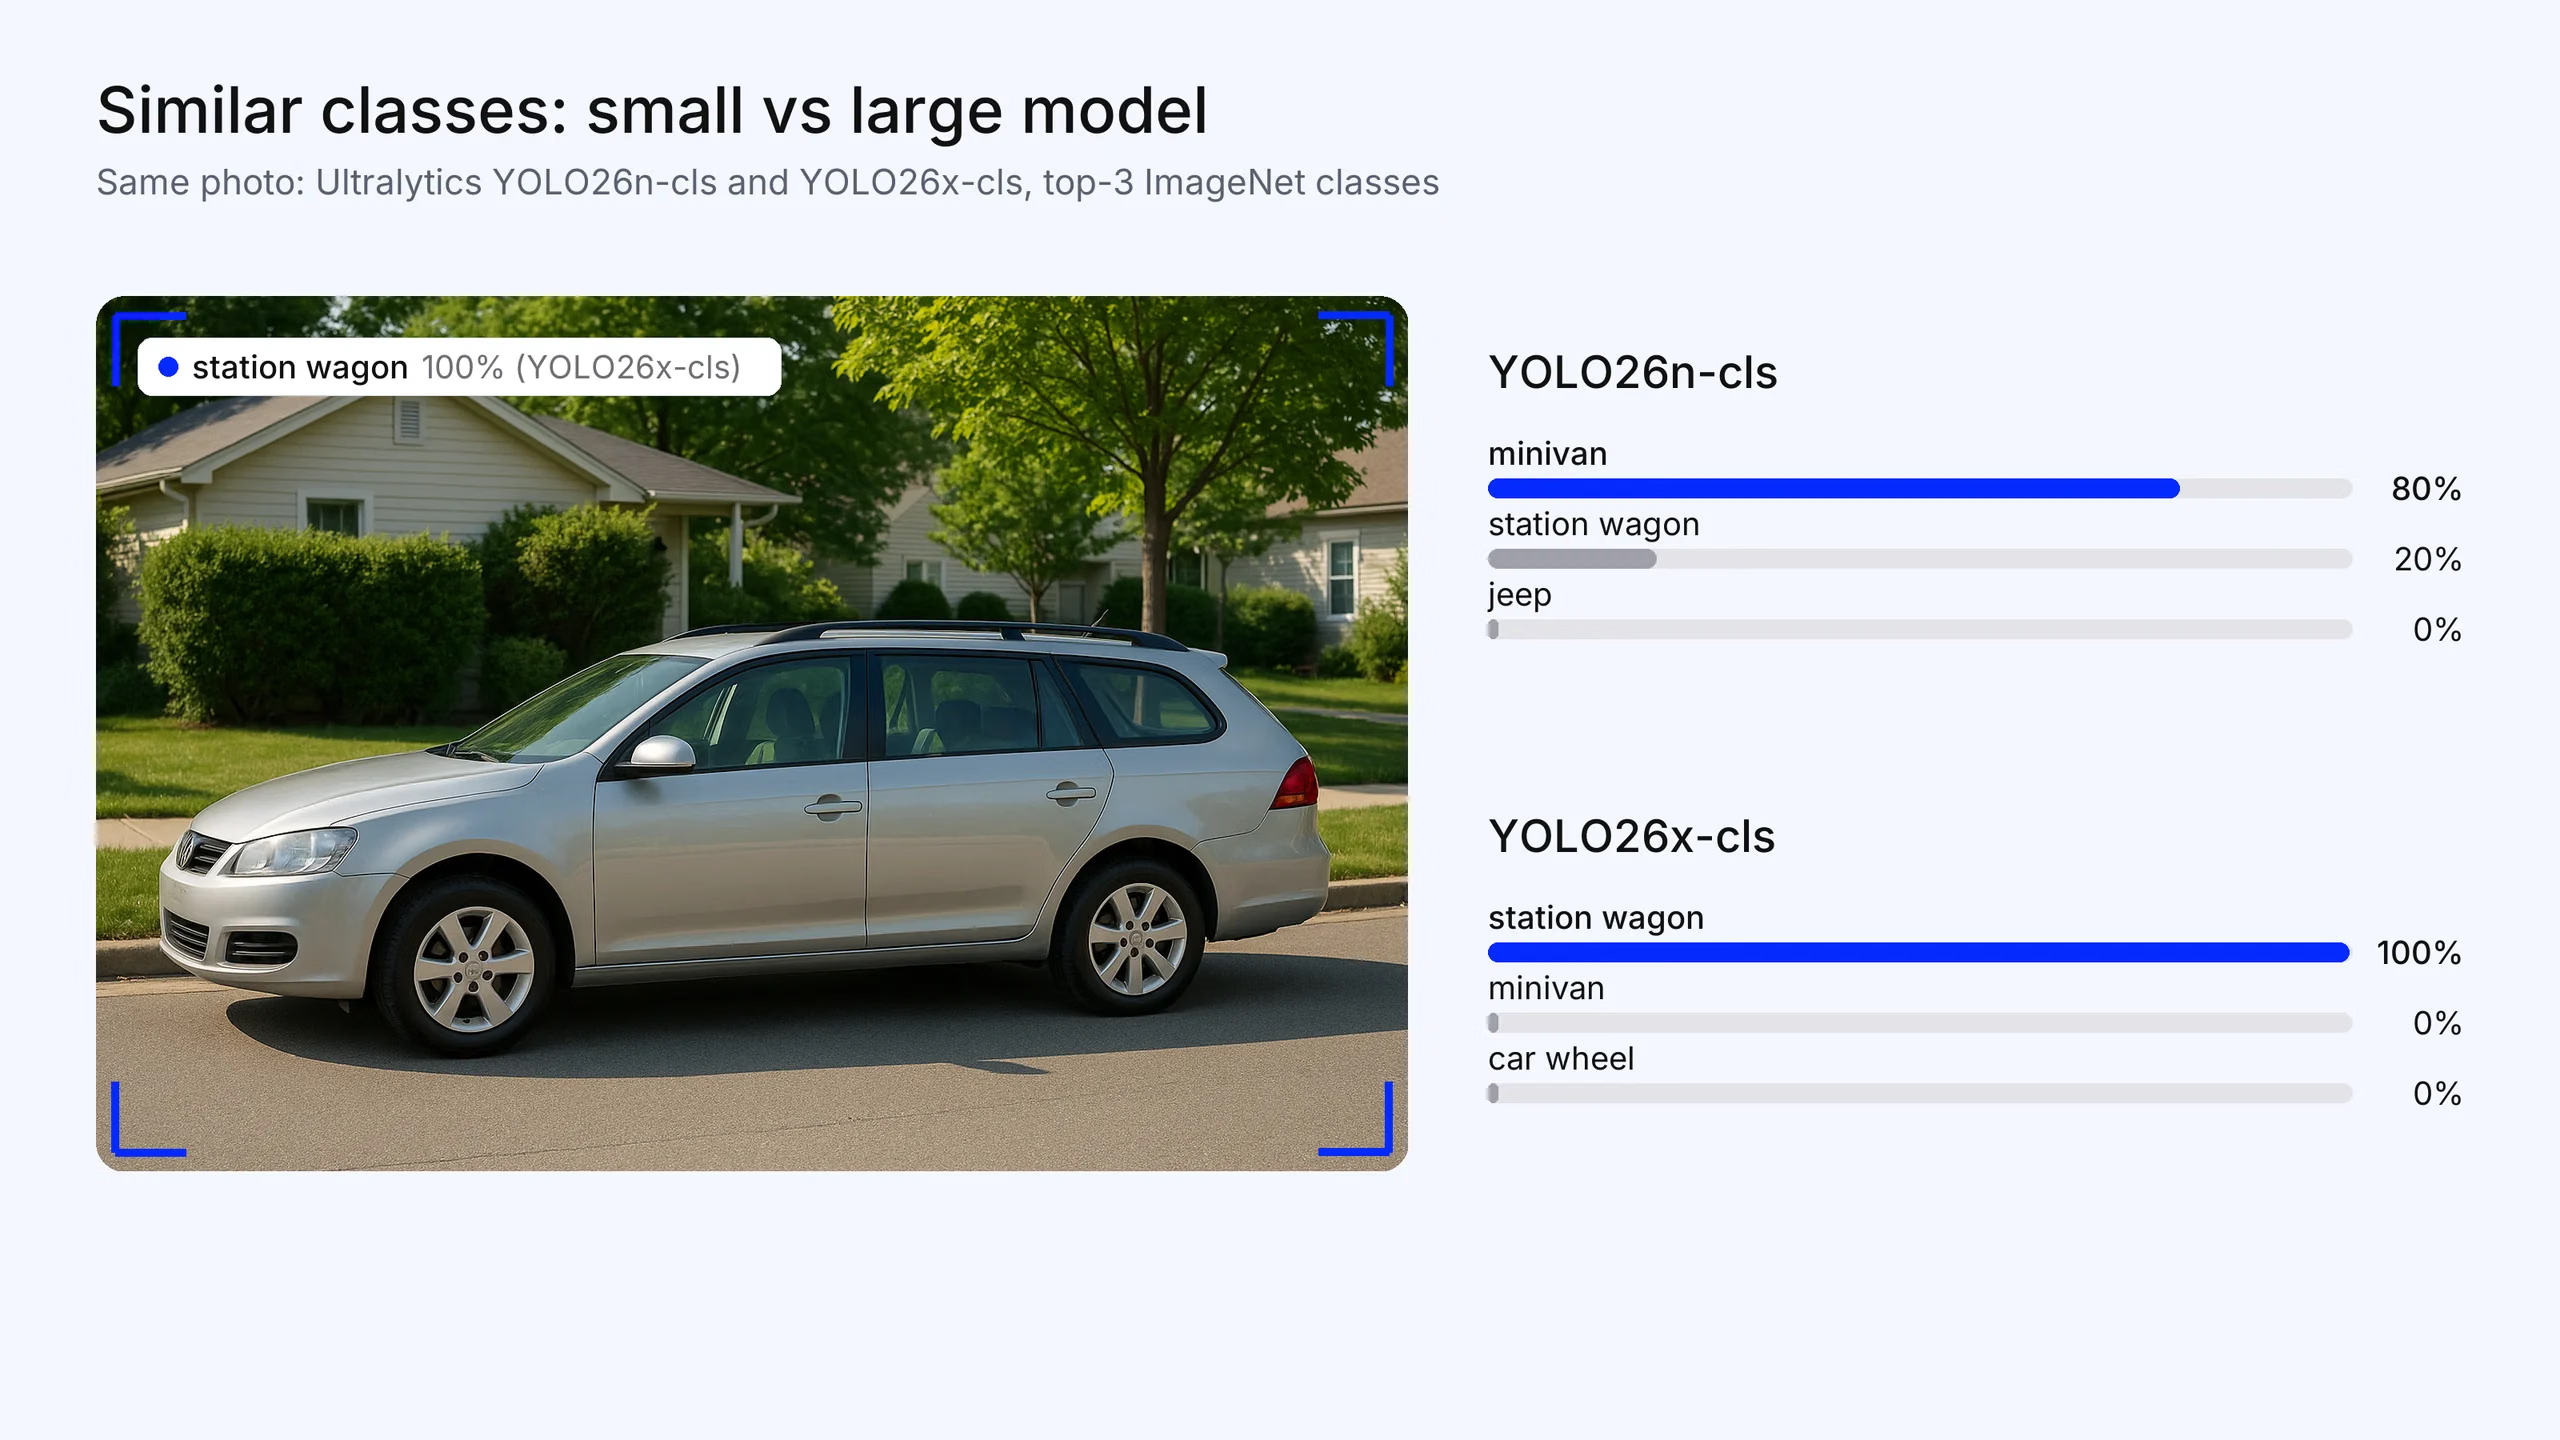
Şekil 2. Model boyutunun fark yarattığı yer, benzer sınıflardır. Bir station wagon fotoğrafında Ultralytics YOLO26n-cls ilk sırada "minivan"ı (%80) sınıflandırırken YOLO26x-cls ilk sırada station wagon'ı (%100; ImageNet'in "beach wagon, station wagon" sınıfı olarak gösteriliyor) sınıflandırıyor. Bunlar gibi ince ayrımlı sınıfları kendi doğrulama kümenizde kontrol edin. Fotoğraf bu makale için oluşturuldu; tahminler gerçek model çıktılarıdır.
ViT#
Google'ın özgün Vision Transformer modeli, büyük miktarda veriyle önceden eğitildiğinde görüntü parçaları üzerinde çalışan saf bir Transformer'ın CNN'lerle aynı düzeyde sonuç verebildiğini veya onları geçebildiğini gösterdi. Ödünleşim: büyük ölçekli ön eğitim olmadan küçük veri kümelerinde CNN'lerden daha kötü performans gösterir ve çıkarım sırasında daha fazla hesaplama gücüne ihtiyaç duyar.
Görüntü sınıflandırma modeli nasıl seçilir#
Şu soruları sırayla yanıtla:
- Etiketli verin var mı? Etiketli örneğin yoksa sıfır atışlı sınıflandırma için SigLIP 2 gibi bir görsel-dil modeliyle başla. Küçük bir etiketli veri kümen varsa, eğitilmiş doğrusal başlıklı dondurulmuş bir DINOv3 omurgasını da değerlendir.
- Model nerede çalışacak? Telefon veya NPU üzerinde çalışacaksa MobileNetV4'ü ya da YOLO26n-cls gibi küçük bir CNN'i veya küçük bir ConvNeXt V2'yi kısa listeye al. Uç GPU'da veya CPU'da gerçek zamanlı çalışacaksa YOLO26-cls, EfficientNetV2 ya da ConvNeXt V2'ye bak. Sıkı bir gecikme bütçesi olmayan sunucularda EVA-02, Swin veya DINOv3 ViT'yi değerlendir.
- Sınıf başına ne kadar etiketli verin var? Yüzlerce ila birkaç bin görüntü varsa, önceden eğitilmiş bir CNN'den veya dondurulmuş, kendi kendini denetleyen bir omurgadan aktarım öğrenmesi en güvenli yoldur. On binlerce veya daha fazla görüntü varsa, tamamen ince ayar yapılmış Transformer'lar avantaj sağlamaya başlar.
- Lisansı kullanabilir misin? Yalnızca kodu değil, ağırlıkları da kontrol et: ConvNeXt V2'nin ImageNet ağırlıkları ticari kullanıma açık değil, DINOv3'ün kendine ait bir lisansı var ve Enterprise lisansın yoksa Ultralytics modelleri AGPL-3.0 lisanslıdır.
- Model çalışma ortamına aktarılabiliyor mu? Karar vermeden önce ONNX, TensorRT, Core ML veya TFLite için desteklenen bir aktarım yolunun bulunduğunu doğrula.
Ardından kısa listeye aldığın iki veya üç modeli ince ayardan geçir ve kendi doğrulama ayrımında karşılaştır.
YOLO yerine başka bir modelin işine daha çok yarayacağı durumlar#
YOLO26-cls, hızlı ve kolayca dağıtılabilir özel sınıflandırıcılar için tasarlandı. Bazı işler için farklı bir model daha iyi bir seçimdir:
- Önceliği doğruluk olan araştırma veya kıyaslama çalışmaları: ImageNet düzeyinde sonuçları yeniden üretmek için gerekli tariflerin ve ağırlıkların bulunduğu timm üzerinden EVA-02, ConvNeXt V2 veya bir ViT kullan.
- Çok az etiketin varsa veya tek bir omurgadan birçok alt görev için yararlanacaksan: doğrusal başlıklı DINOv3 özelliklerini kullan.
- Açık veya sık değişen etiket kümeleri: sıfır atışlı sınıflandırma için SigLIP 2 kullan.
- Apple Neural Engine veya EdgeTPU gibi telefon NPU'ları: MobileNetV4 tam da bu hedefler için tasarlandı ve bu hedeflerde test edildi.
Nesnelerin yalnızca ne olduğunu değil, nerede bulunduğunu da bulman gerekiyorsa bir algılayıcıya ihtiyacın var. Nesne algılama modelleri karşılaştırmamıza göz at.
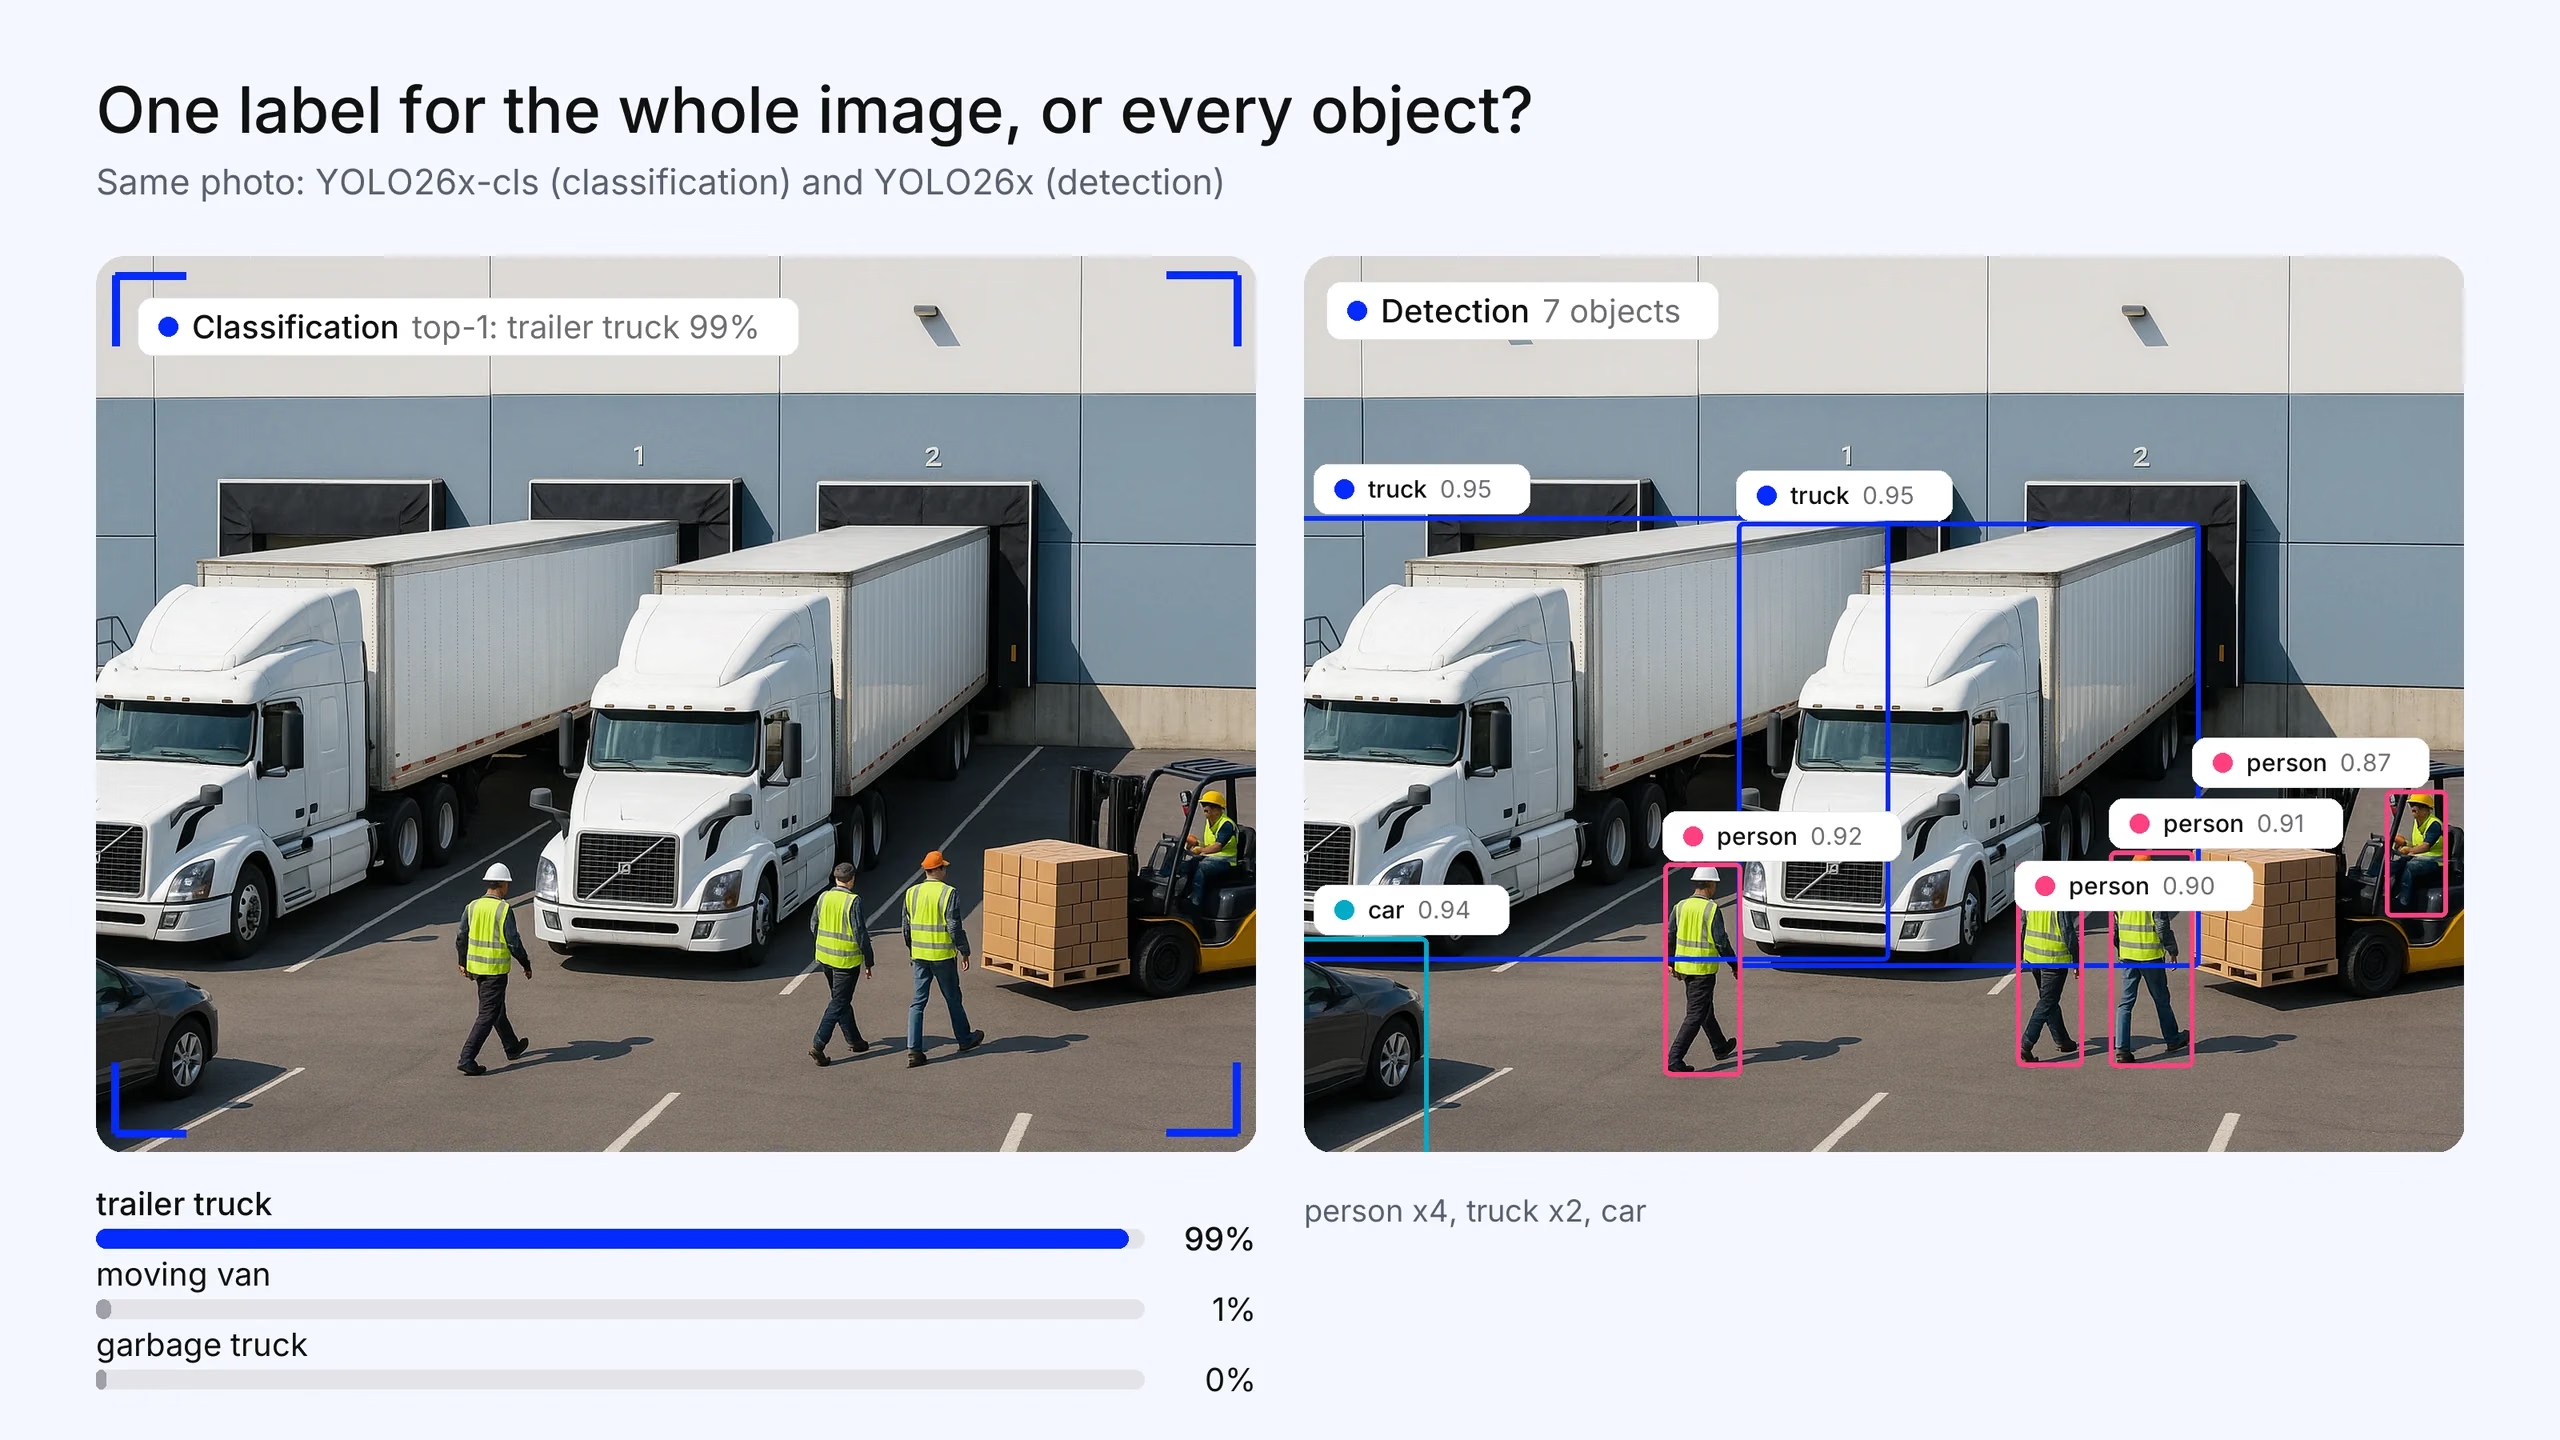
Şekil 3. Çok sayıda nesne içeren bir sahnede sınıflandırıcı yine de tek bir etiket döndürür: Ultralytics YOLO26x-cls bu dağıtım sahasını %99 güvenle "trailer truck" olarak etiketliyor. Ultralytics YOLO26x algılama modeli, her biri kendine ait bir kutuyla 7 nesne buluyor: 4 kişi, 2 kamyon ve bir araba (güven değeri 0,5 veya üzeri). Fotoğraf bu makale için oluşturuldu; çıktılar gerçektir.
Önceden eğitilmiş modelleri nereden bulabilir ve kendi modelini nasıl eğitebilirsin?#
- timm (PyTorch Image Models), ViT ve ConvNeXt'ten MobileNetV4, EVA ve DINOv3'e kadar yukarıdaki omurgaların çoğunu, eğitim ve değerlendirme betikleriyle birlikte sunar. Kod Apache 2.0 lisanslıdır; ağırlıkların lisansları değişiklik gösterir.
- Hugging Face, SigLIP 2 ve DINOv3 dâhil çoğu Transformer sınıflandırıcısını, kullanıma hazır sıfır atışlı ve görüntü sınıflandırma işlem hatlarıyla birlikte barındırır.
- Ultralytics Python paketi, sınıflara göre sıralanmış bir görüntü klasörü üzerinde YOLO26-cls modelini eğitir. Sınıflandırma veri kümesi biçimine ve sınıflandırma görev kılavuzuna göz at.
- Ultralytics Platform, aynı modeller için açıklama ekleme ve bulut eğitimi özellikleri sunar. Platform 2026'da kullanıma açıldı; bu nedenle köklü barındırılan eğitim hizmetlerinden daha yenidir. Eğitimden sonra modelleri sunmak için bilgisayarlı görü çıkarım platformları karşılaştırmamıza göz at.
Sık sorulan sorular
Her durum için en iyisi olan tek bir model yok. Yüksek doğruluk hedefleyen ve yeterli hesaplama gücüne sahip çalışmalar için EVA-02 ve DINOv3 gibi büyük Transformer ve kendi kendini denetleyen omurgalar ilk değerlendirilecek seçeneklerdir. Kısıtlı donanımlarda üretim ortamında kullanım için ConvNeXt V2, EfficientNetV2, MobileNetV4 ve Ultralytics YOLO26-cls gibi CNN'ler daha pratiktir. Etiketli veri olmadan sınıflandırma için SigLIP 2 sıfır atışlı sınıflandırmayı destekler.
Transformer'lar çok büyük veri kümelerinde önceden eğitildiklerinde ve hesaplama gücü kısıtlı olmadığında genellikle daha iyi sonuç verir. CNN'ler ise yerel yapıya ilişkin yerleşik varsayımları sayesinde veriyi daha verimli kullanıp hızlı çalıştıklarından küçük ve orta boyutlu veri kümelerinde ve uç donanımlarda genellikle öne çıkar. ConvNeXt gibi modern CNN'ler doğruluk farkını azalttı; CoAtNet gibi hibritler ise ikisini bir araya getiriyor.
Evet. DINOv3 genel amaçlı bir omurgadır. Dondurulmuş modelle özellikleri çıkarıp üzerine küçük bir doğrusal sınıflandırıcı eğitebilirsin; Meta'nın deposunda en büyük modeli için bir ImageNet sınıflandırma başlığı da bulunur. Ticari kullanımdan önce DINOv3 Lisansını kontrol et.
Genellikle ImageNet doğrulama kümesinde top-1 doğruluğuyla (en üst sıradaki tahminin doğru olması) ve top-5 doğruluğuyla (doğru sınıfın en yüksek puanlı beş tahmin arasında yer alması) ölçülür. Dengesiz özel veri kümelerinde sınıf başına kesinlik, duyarlılık veya F1 değeri genel doğruluktan daha fazla bilgi verir.









