Anlamsal Segmentasyon ve Örnek Segmentasyonu: Doğru Görev Nasıl Seçilir?
Anlamsal segmentasyon her piksele sınıf etiketi atar; örnek segmentasyonu ise her nesneyi birbirinden ayırır. Bilgisayarlı görü projen için hangisinin gerektiğini ve nedenini öğren.
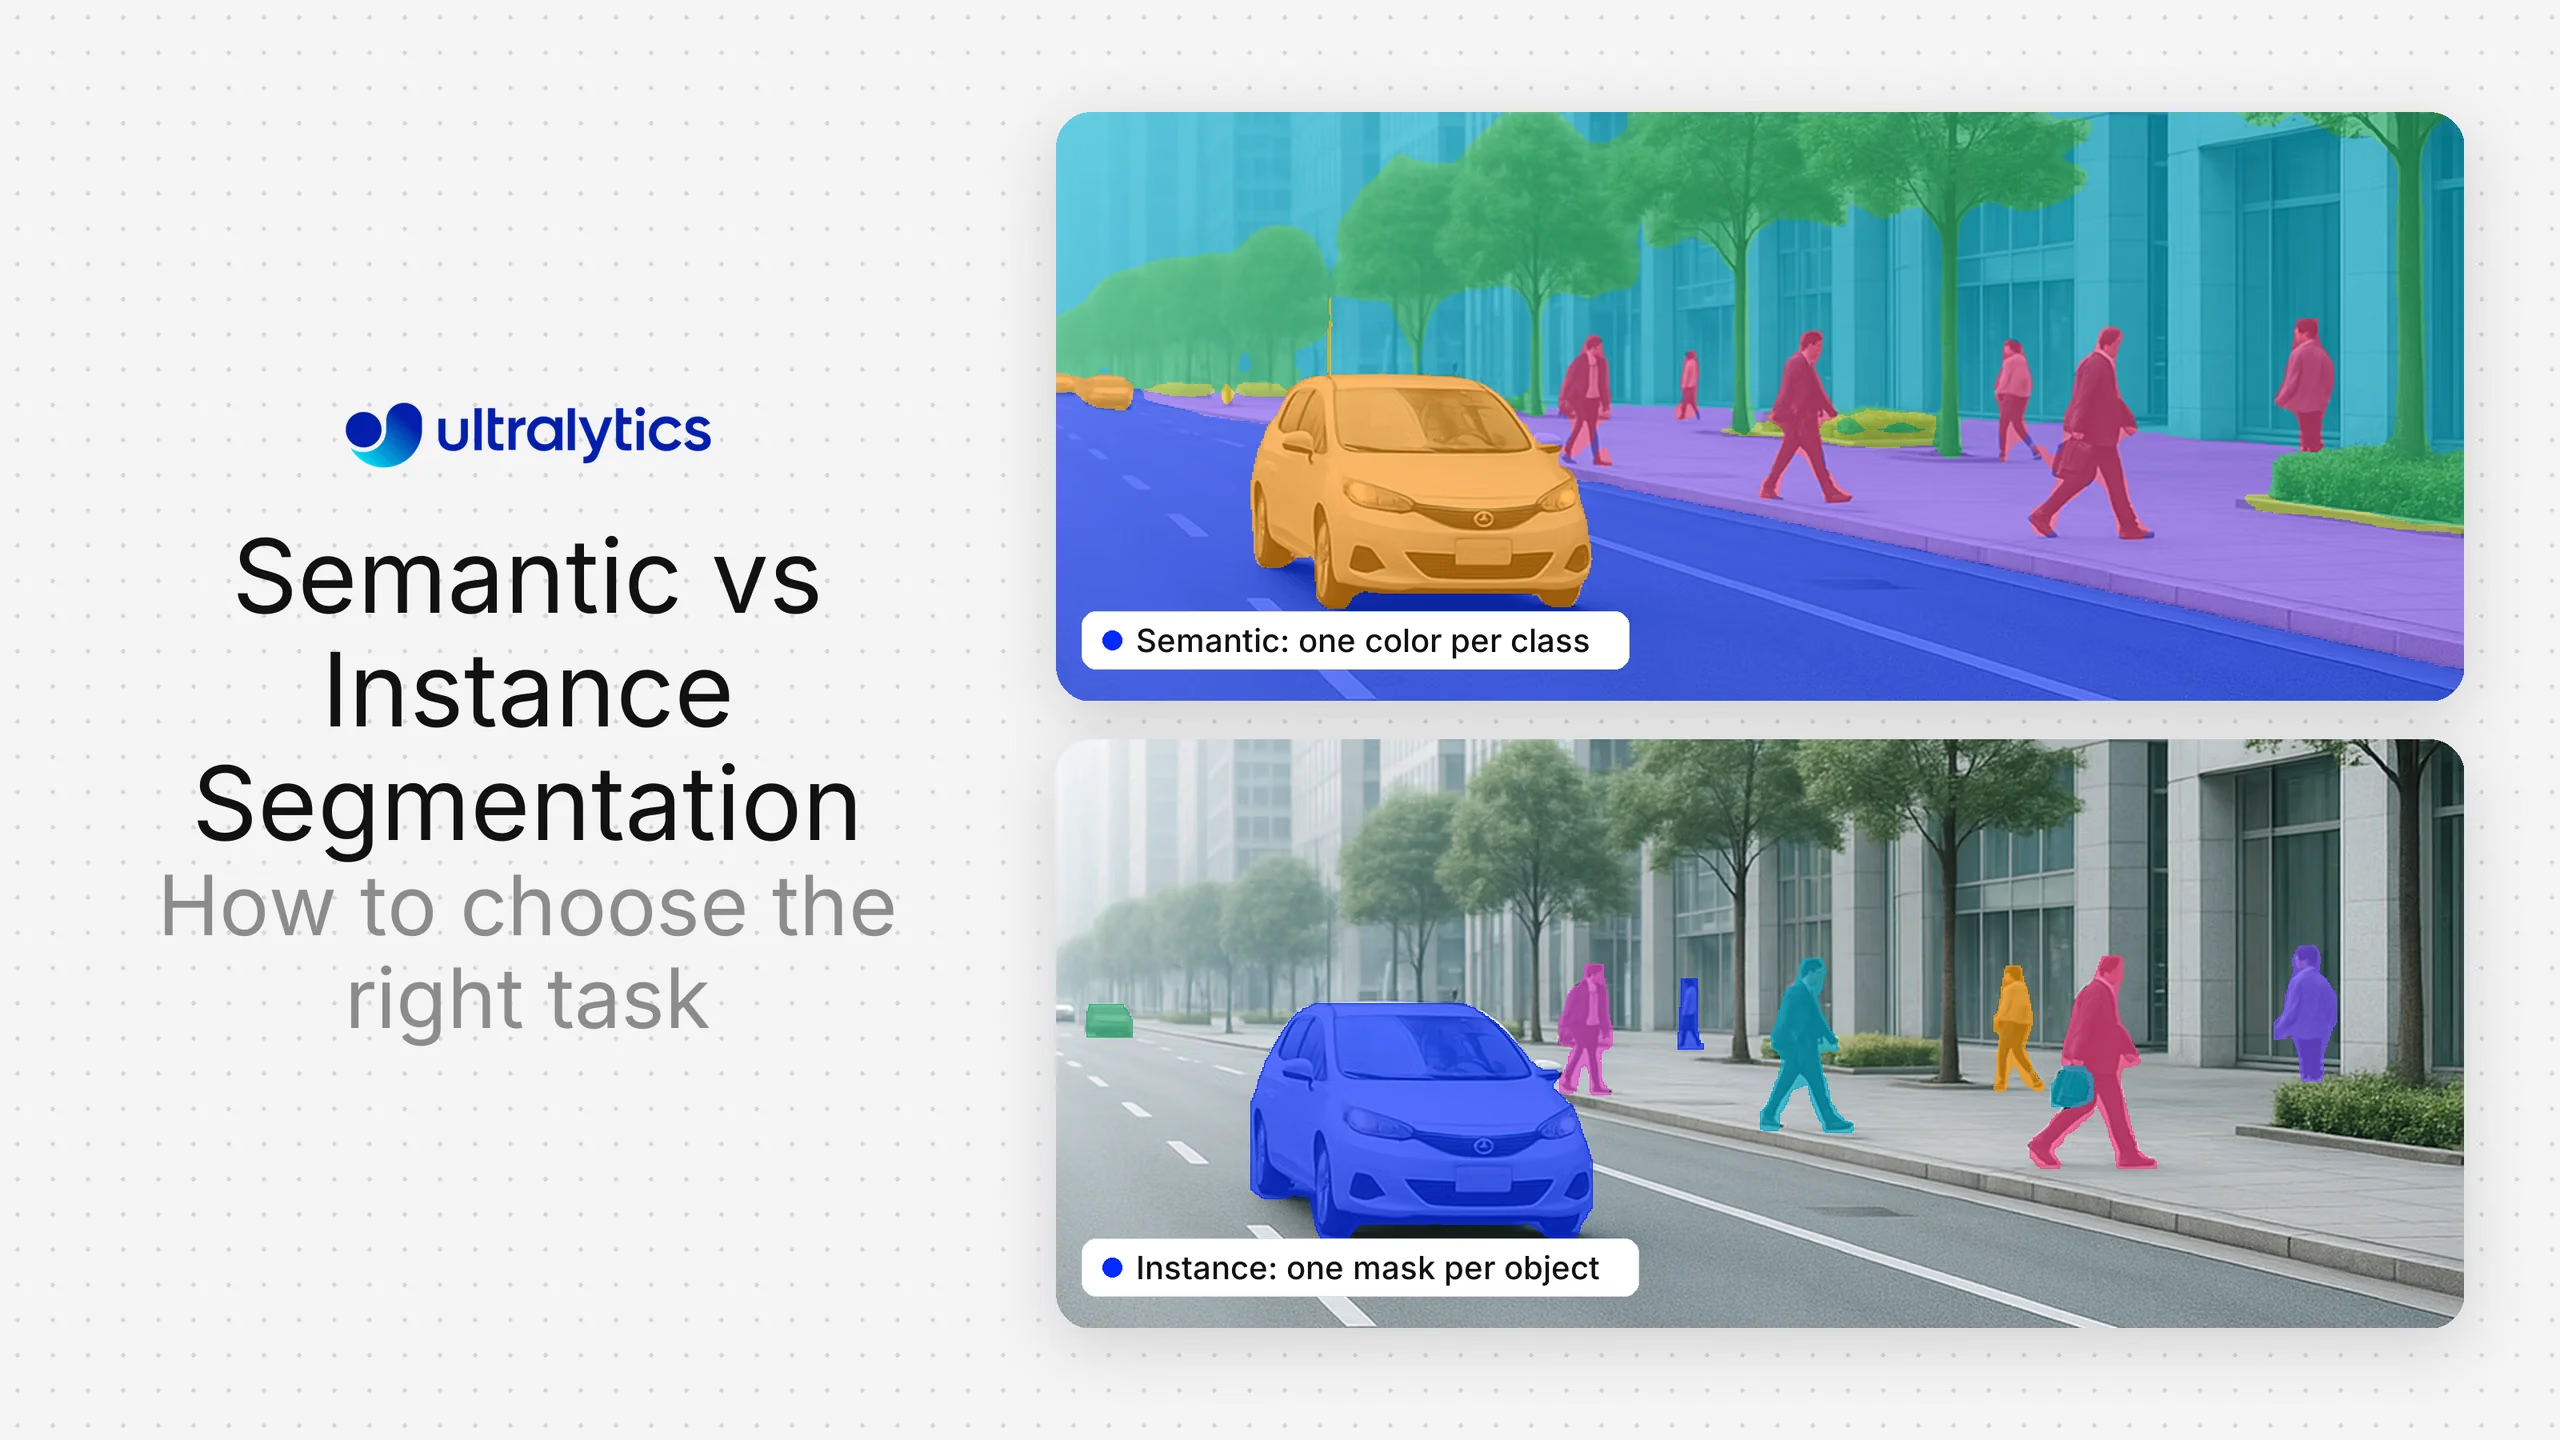
Anlamsal segmentasyon ve örnek segmentasyonu görüntüleri piksel düzeyinde etiketler, ancak farklı soruları yanıtlar. Anlamsal segmentasyon her piksele bir sınıf atar; böylece sahnedeki tüm arabalar tek bir "araba" bölgesi olur. Örnek segmentasyonu her nesneyi ayrı ayrı belirler ve her arabaya kendi maskesini verir. Aralarında seçim yaparken şu soruyu yanıtlaman yeterli: Her pikselde ne olduğunu mu, yoksa her pikselin hangi nesneye ait olduğunu mu bilmen gerekiyor? Bu kılavuz, seçim yapmana yardımcı olur. Ayrıca her görevin etiketleme maliyetini ve nasıl değerlendirildiğini de ele alır. Ultralytics YOLO her iki görevi de aynı çerçevede destekler.
Farkı tek cümlede#
- Anlamsal segmentasyon her pikseli yol, gökyüzü, kişi veya araba gibi bir kategoriye ayırır. Aynı sınıftaki nesneler tek bir bölgede birleşir. Sözlükteki anlamsal segmentasyon maddesine göz at.
- Örnek segmentasyonu her bir nesneyi bulur ve ona kendine ait bir maske ve kimlik verir. Genellikle sayılabilir nesneleri kapsar; gökyüzü veya çimen gibi arka planı göz ardı eder. Sözlükteki örnek segmentasyonu maddesine göz at.
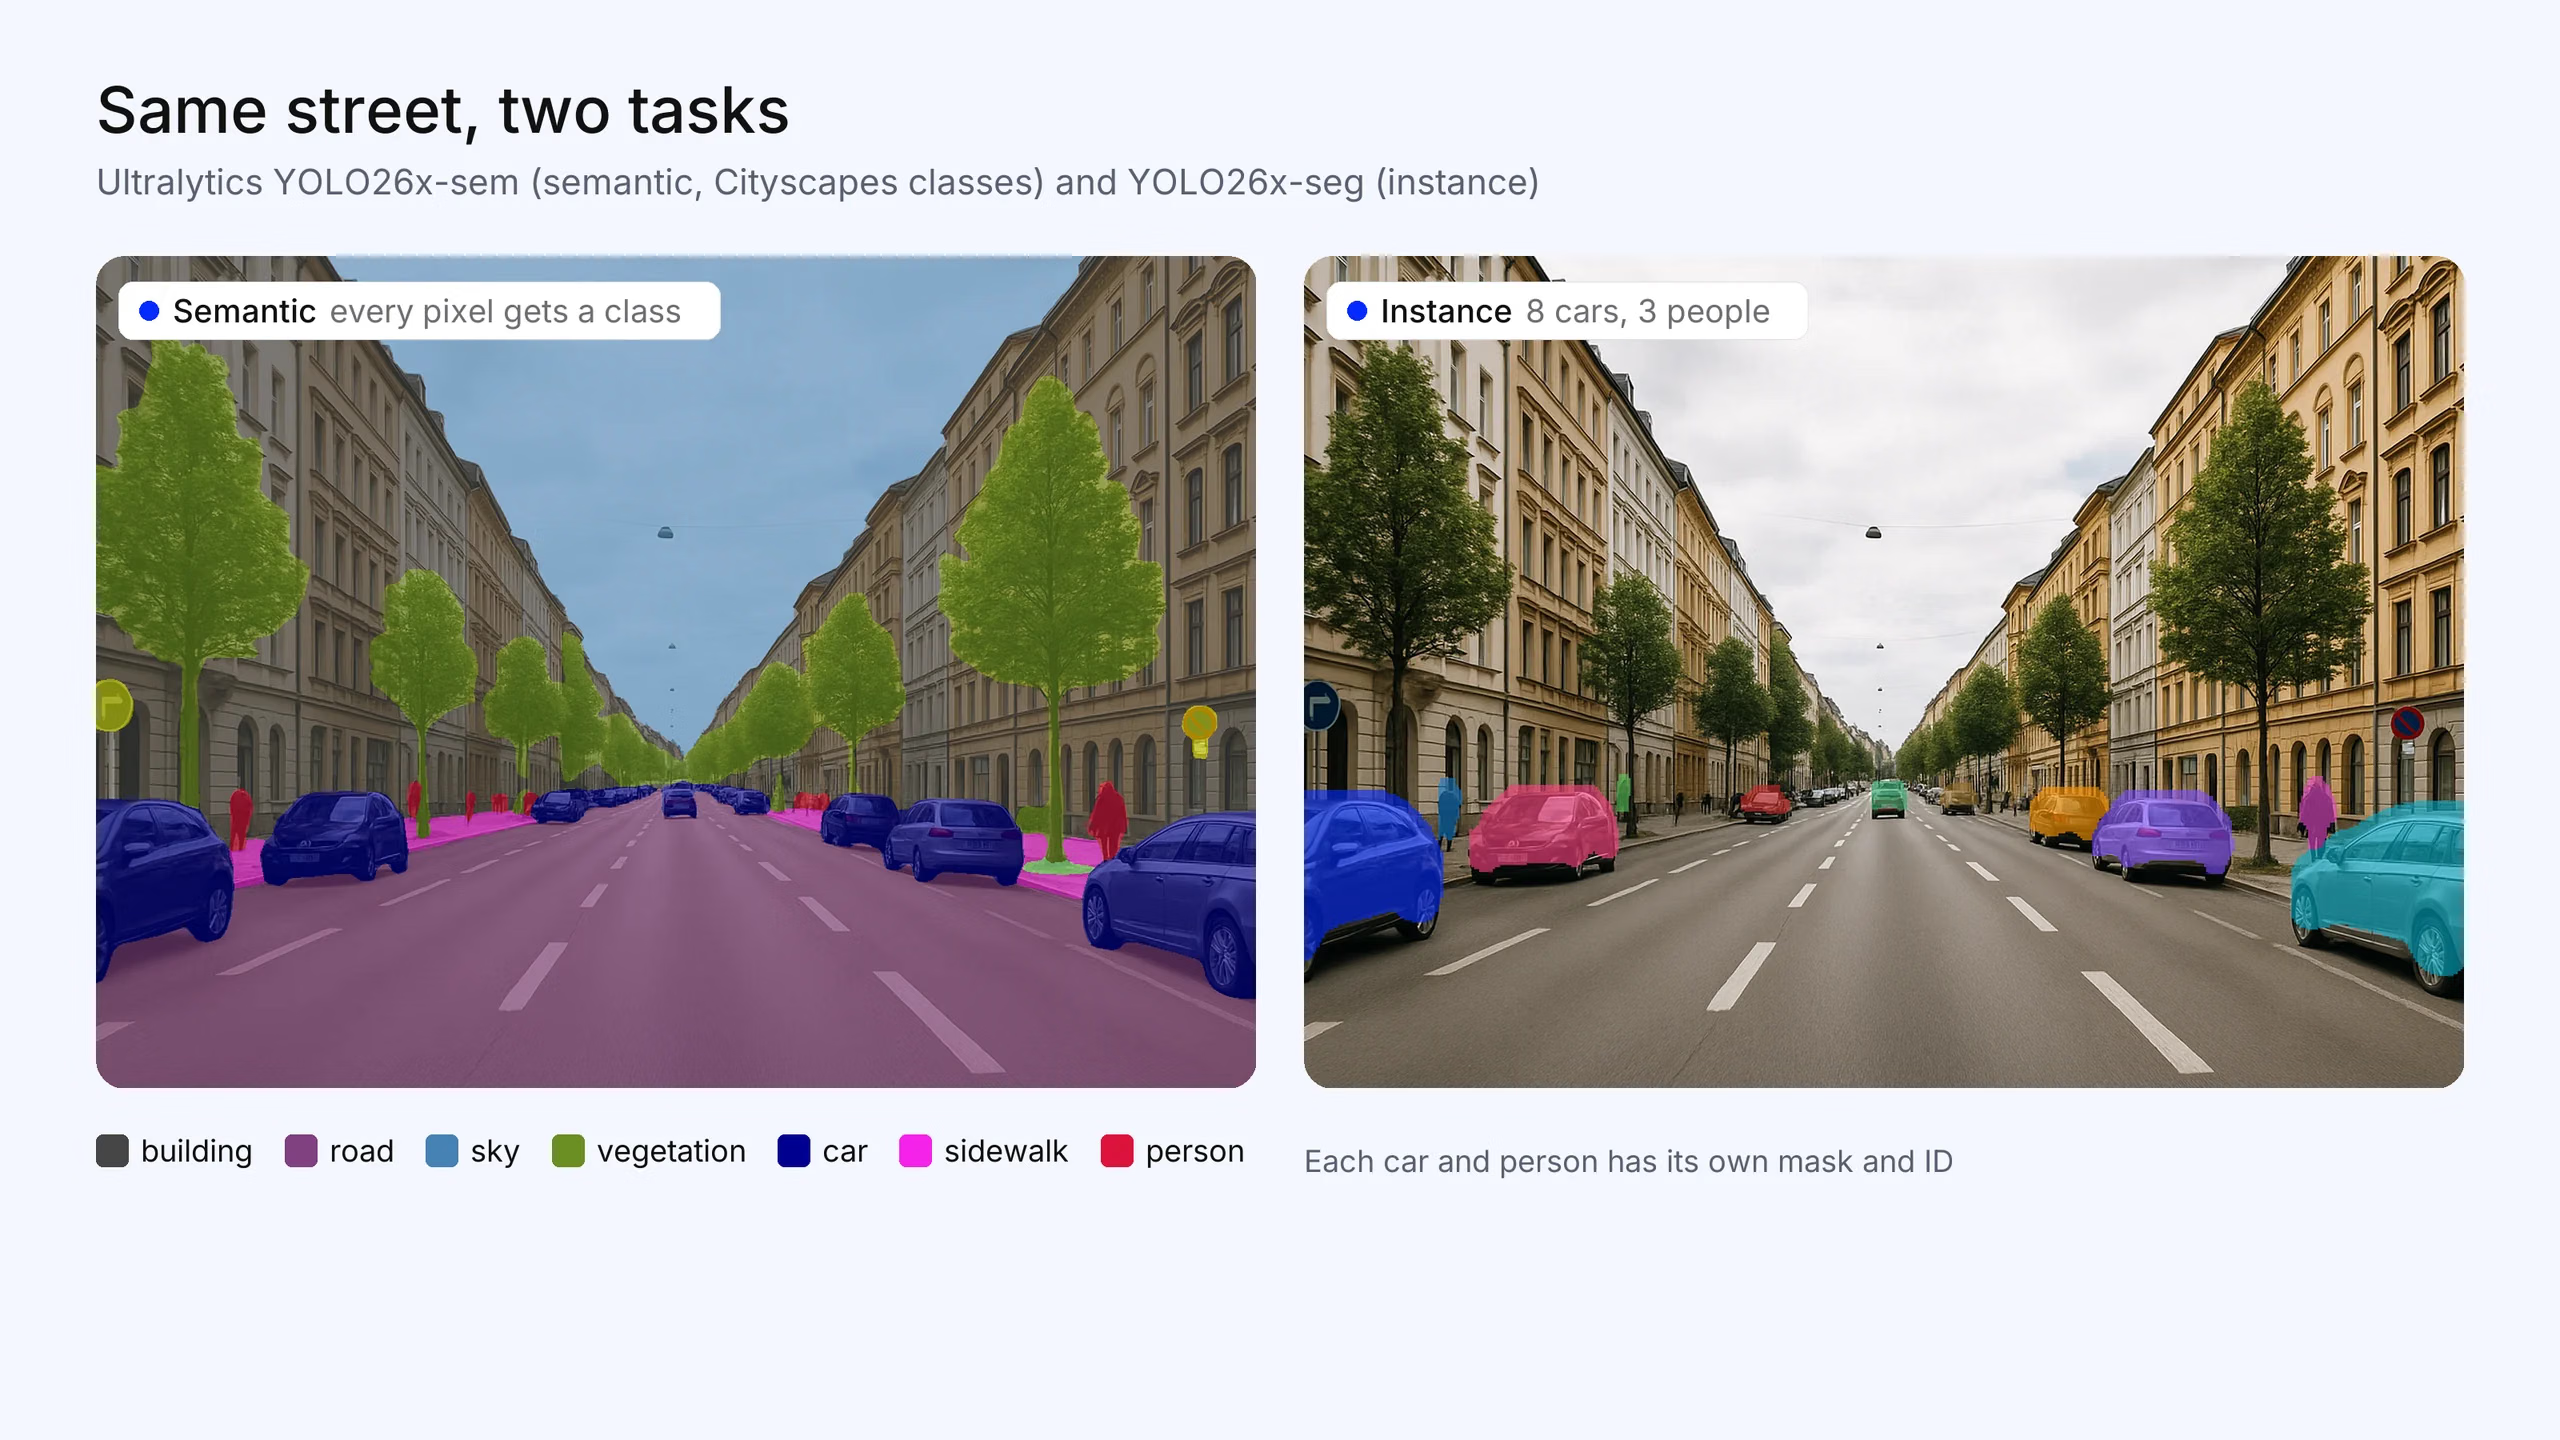
Şekil 1. Her iki görevle de işlenmiş aynı cadde. Ultralytics YOLO26x-sem (Cityscapes sınıfları) her pikseli etiketlediğinden tüm arabalar aynı "araba" sınıfını paylaşır. Ultralytics YOLO26x-seg bulduğu 8 arabanın ve 3 kişinin her birine kendi maskesini verir (güven değeri 0,5 veya üzeri). Fotoğraf bu makale için oluşturuldu; maskeler gerçek model çıktılarıdır.
Projen hangi göreve ihtiyaç duyuyor?#
Uygulamanın yanıtlaması gereken sorudan başla:
| Uygulamanın şunları yapması gerekiyorsa… | Şunu kullan | Örnek |
|---|---|---|
| Sahnenin ne kadarının belirli bir sınıfa ait olduğunu bilmek | Anlamsal | Sürüşe uygun yol alanı, ürünün ota kıyasla kapladığı alan, arazi örtüsü |
| Arka plan bölgelerini nesneler kadar dikkatli etiketlemek | Anlamsal | Gökyüzü, su, bitki örtüsü, taramadaki doku türleri |
| Nesneleri saymak | Örnek | Ağaçtaki meyveler, sıradaki insanlar |
| Nesneleri video kareleri boyunca izlemek | Örnek segmentasyonu ve bir takipçi | Sahnede hareket eden insanlar veya araçlar |
| Her seferinde tek bir nesneyi ölçmek veya onun üzerinde işlem yapmak | Örnek | Yığından tek bir parçayı alan robot, her kusurun boyutunu ölçme |
| İkisini de yapmak: tüm sahneyi kapsamak ve nesneleri ayrı ayrı belirlemek | Panoptik | Otonom sürüş için sokak sahneleri |
Emin değilsen, aynı sınıftan birbirine dokunan iki nesnenin birbirinden ayırt edilmesi gerekip gerekmediğini sor. Gerekiyorsa örnek segmentasyonuna (veya panoptik segmentasyona) ihtiyacın var. Gerekmiyorsa anlamsal segmentasyon daha basittir ve genellikle daha düşük çalıştırma maliyetine sahiptir.
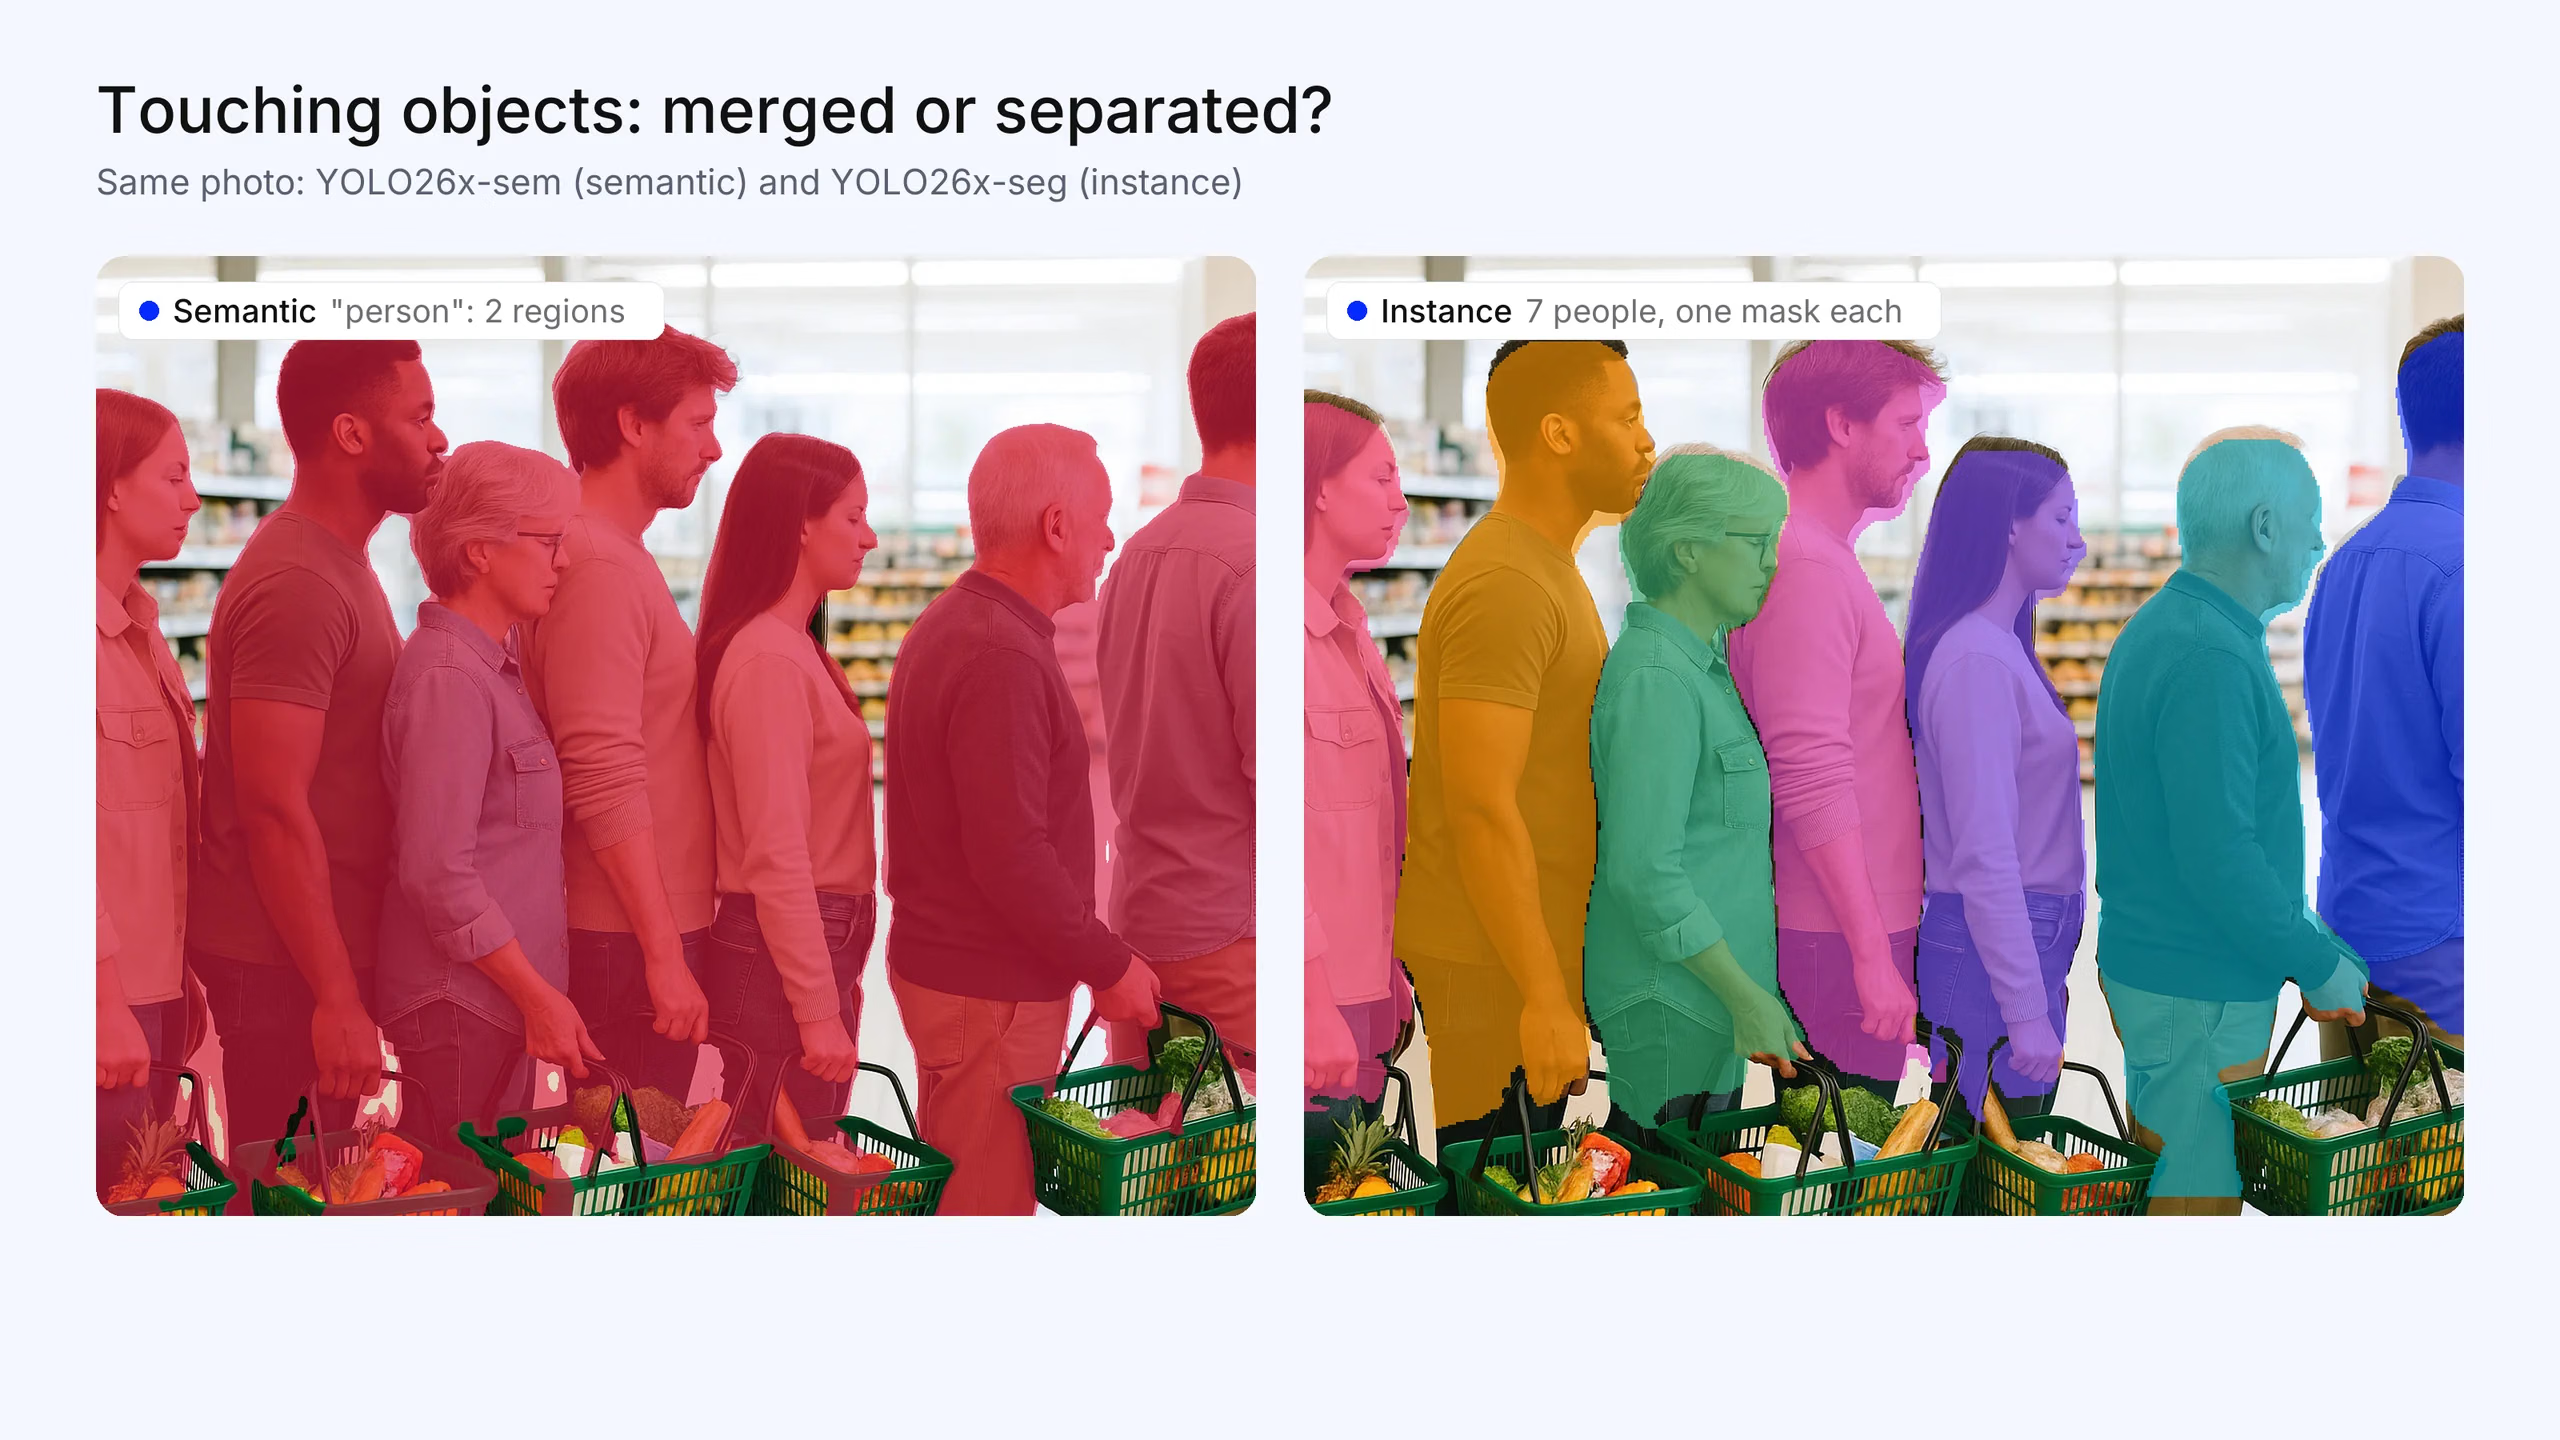
Şekil 2. Kasa kuyruğunda birbirine yakın duran yedi müşteri. Anlamsal çıktıda (Ultralytics YOLO26x-sem) bu kişiler birleşerek bağlantılı iki "kişi" bölgesi oluşturuyor; bu nedenle bu çıktıdan kişi sayısını belirleyemezsin. Örnek segmentasyonu çıktısı (Ultralytics YOLO26x-seg) 7 kişinin tümünü birbirinden ayırıyor. Fotoğraf bu makale için oluşturuldu; maskeler gerçek model çıktılarıdır.
Temel farklara genel bakış#
| Ölçüt | Anlamsal segmentasyon | Örnek segmentasyonu |
|---|---|---|
| Yanıtlanan soru | Her piksel hangi sınıfta? | Her piksel hangi nesneye ait? |
| Aynı sınıftaki nesneler | Tek bir bölgede birleşir | Ayrı tutulur; her birinin kendi maskesi ve kimliği vardır |
| Kapsama | Arka plan dâhil her piksel | Genellikle yalnızca ilgilenilen nesneler |
| Çıktı | Görüntü boyutunda tek bir sınıf haritası | Her biri bir sınıf ve güven değeri içeren maske listesi |
| Nesneleri sayabilir misin? | Doğrudan sayamazsın | Evet |
| Temel metrik | Ortalama Kesişim-Birleşim (mIoU) | Maske Ortalama Kesinliği (mask mAP) |
| Göreli karmaşıklık | Daha düşük: piksel başına sınıflandırma | Daha yüksek: algılama ve nesne başına maske |
Her görevin etiketleme maliyeti#
Pratikte seçimi çoğu zaman etiketleme çabası belirler.
- Anlamsal veri kümelerinde arka plan da dâhil olmak üzere her görüntünün her pikseline bir sınıf atanır. Bu veri kümeleri genellikle tek kanallı maske görüntüleri olarak saklanır. Her görüntü bütünüyle etiketlenir; açıkça "ignore" olarak işaretlenmediği sürece hiçbir piksel atlanamaz.
- Örnek segmentasyonu veri kümelerinde ilgilenilen her nesnenin dış sınırı ayrı ayrı, çokgen veya maske biçiminde çizilir. Arka plan etiketsiz bırakılabilir; ancak her nesnenin kendine ait bir sınırı olmalıdır ve nesnelerin yoğun olduğu sahnelerde iş yükü katlanır.
Her iki görev de yoğun emek gerektirir. Bir tıklamayı veya kutuyu maskeye dönüştüren destekli etiketleme, iki görev için de gereken çabayı azaltır. Yalnızca bölge düzeyinde yanıtlar gerekiyorsa örnek etiketleri için fazladan maliyete katlanma.
Her görev nasıl değerlendirilir?#
- Anlamsal segmentasyon temel olarak mIoU ile ölçülür: tahmin edilen ve gerçek bölgelerin örtüşme oranının sınıflar arasında ortalaması. Piksel doğruluğu da raporlanır. IoU, algılamada kullanılan aynı örtüşme ölçütüdür.
- Örnek segmentasyonu, algılamada kullanılan ancak maske örtüşmesi üzerinden hesaplanan Ortalama Kesinlik Ortalaması olan mask mAP ile ölçülür. Bu metrik, yalnızca doğru pikselleri kaplamayı değil, her nesneyi bulmayı ödüllendirir.
Bu metrikler birbiriyle karşılaştırılamaz. Yüksek bir mIoU, tek tek nesnelerin birbirinden ayrılıp ayrılmadığı konusunda hiçbir şey söylemez.
Panoptik segmentasyon: ikisine de ihtiyaç duyduğunda#
Panoptik segmentasyon, her piksele bir sınıf ve sayılabilir nesnelere bir örnek kimliği atar. Yol ve gökyüzü gibi arka plandaki "şeyler" anlamsal olarak etiketlenir. Araba ve insan gibi ön plandaki "nesneler" ise tek tek ayrılır. Panoptik Kalite (PQ) ile ölçülür. Sahnenin tamamını kapsaman ve aynı anda nesneleri ayrı ayrı belirlemen gerektiğinde bu yöntemi seç. Panoptik segmentasyona göz at.
Her biri kısaca nasıl çalışır?#
Anlamsal segmentasyon modelleri genellikle her piksel için bir sınıf tahmin eden kodlayıcı-kod çözücü ağlardır. U-Net, DeepLab ve SegFormer bilinen örneklerdir. Örnek segmentasyonu modelleri genellikle nesne algılama üzerine kurulur. Mask R-CNN, algılanan her kutunun içinde bir maske tahmin ederken YOLACT ve Ultralytics YOLO segmentasyon modelleri gibi tek aşamalı modeller gerçek zamanlı kullanım için kutuları ve maskeleri tek geçişte tahmin eder. Mask2Former gibi evrensel mimariler anlamsal, örnek ve panoptik segmentasyonu tek bir modelde ele alır. Örnek segmentasyonu hakkında daha fazla bilgi için örnek segmentasyonu nedir yazısına göz at.
Ultralytics YOLO'da her iki görev de#
Ultralytics YOLO, her iki görevi de aynı Python API'si ve CLI ile gerçekleştirir:
- Örnek segmentasyonu,
segmentgörevini kullanır. - Anlamsal segmentasyon,
semanticgörevini kullanır. YOLO26 anlamsal modellerinin son eki-semolur ve modeller Cityscapes ile ADE20K üzerinde önceden eğitilmiş olarak gelir. Görev sayfasında, iki görevin çıktılarının kodda tam olarak nasıl farklılaştığını gösteren bir tablo bulunur.
Her iki model de yerel ortamda veya bulutta Ultralytics Platform üzerinde eğitilebilir.
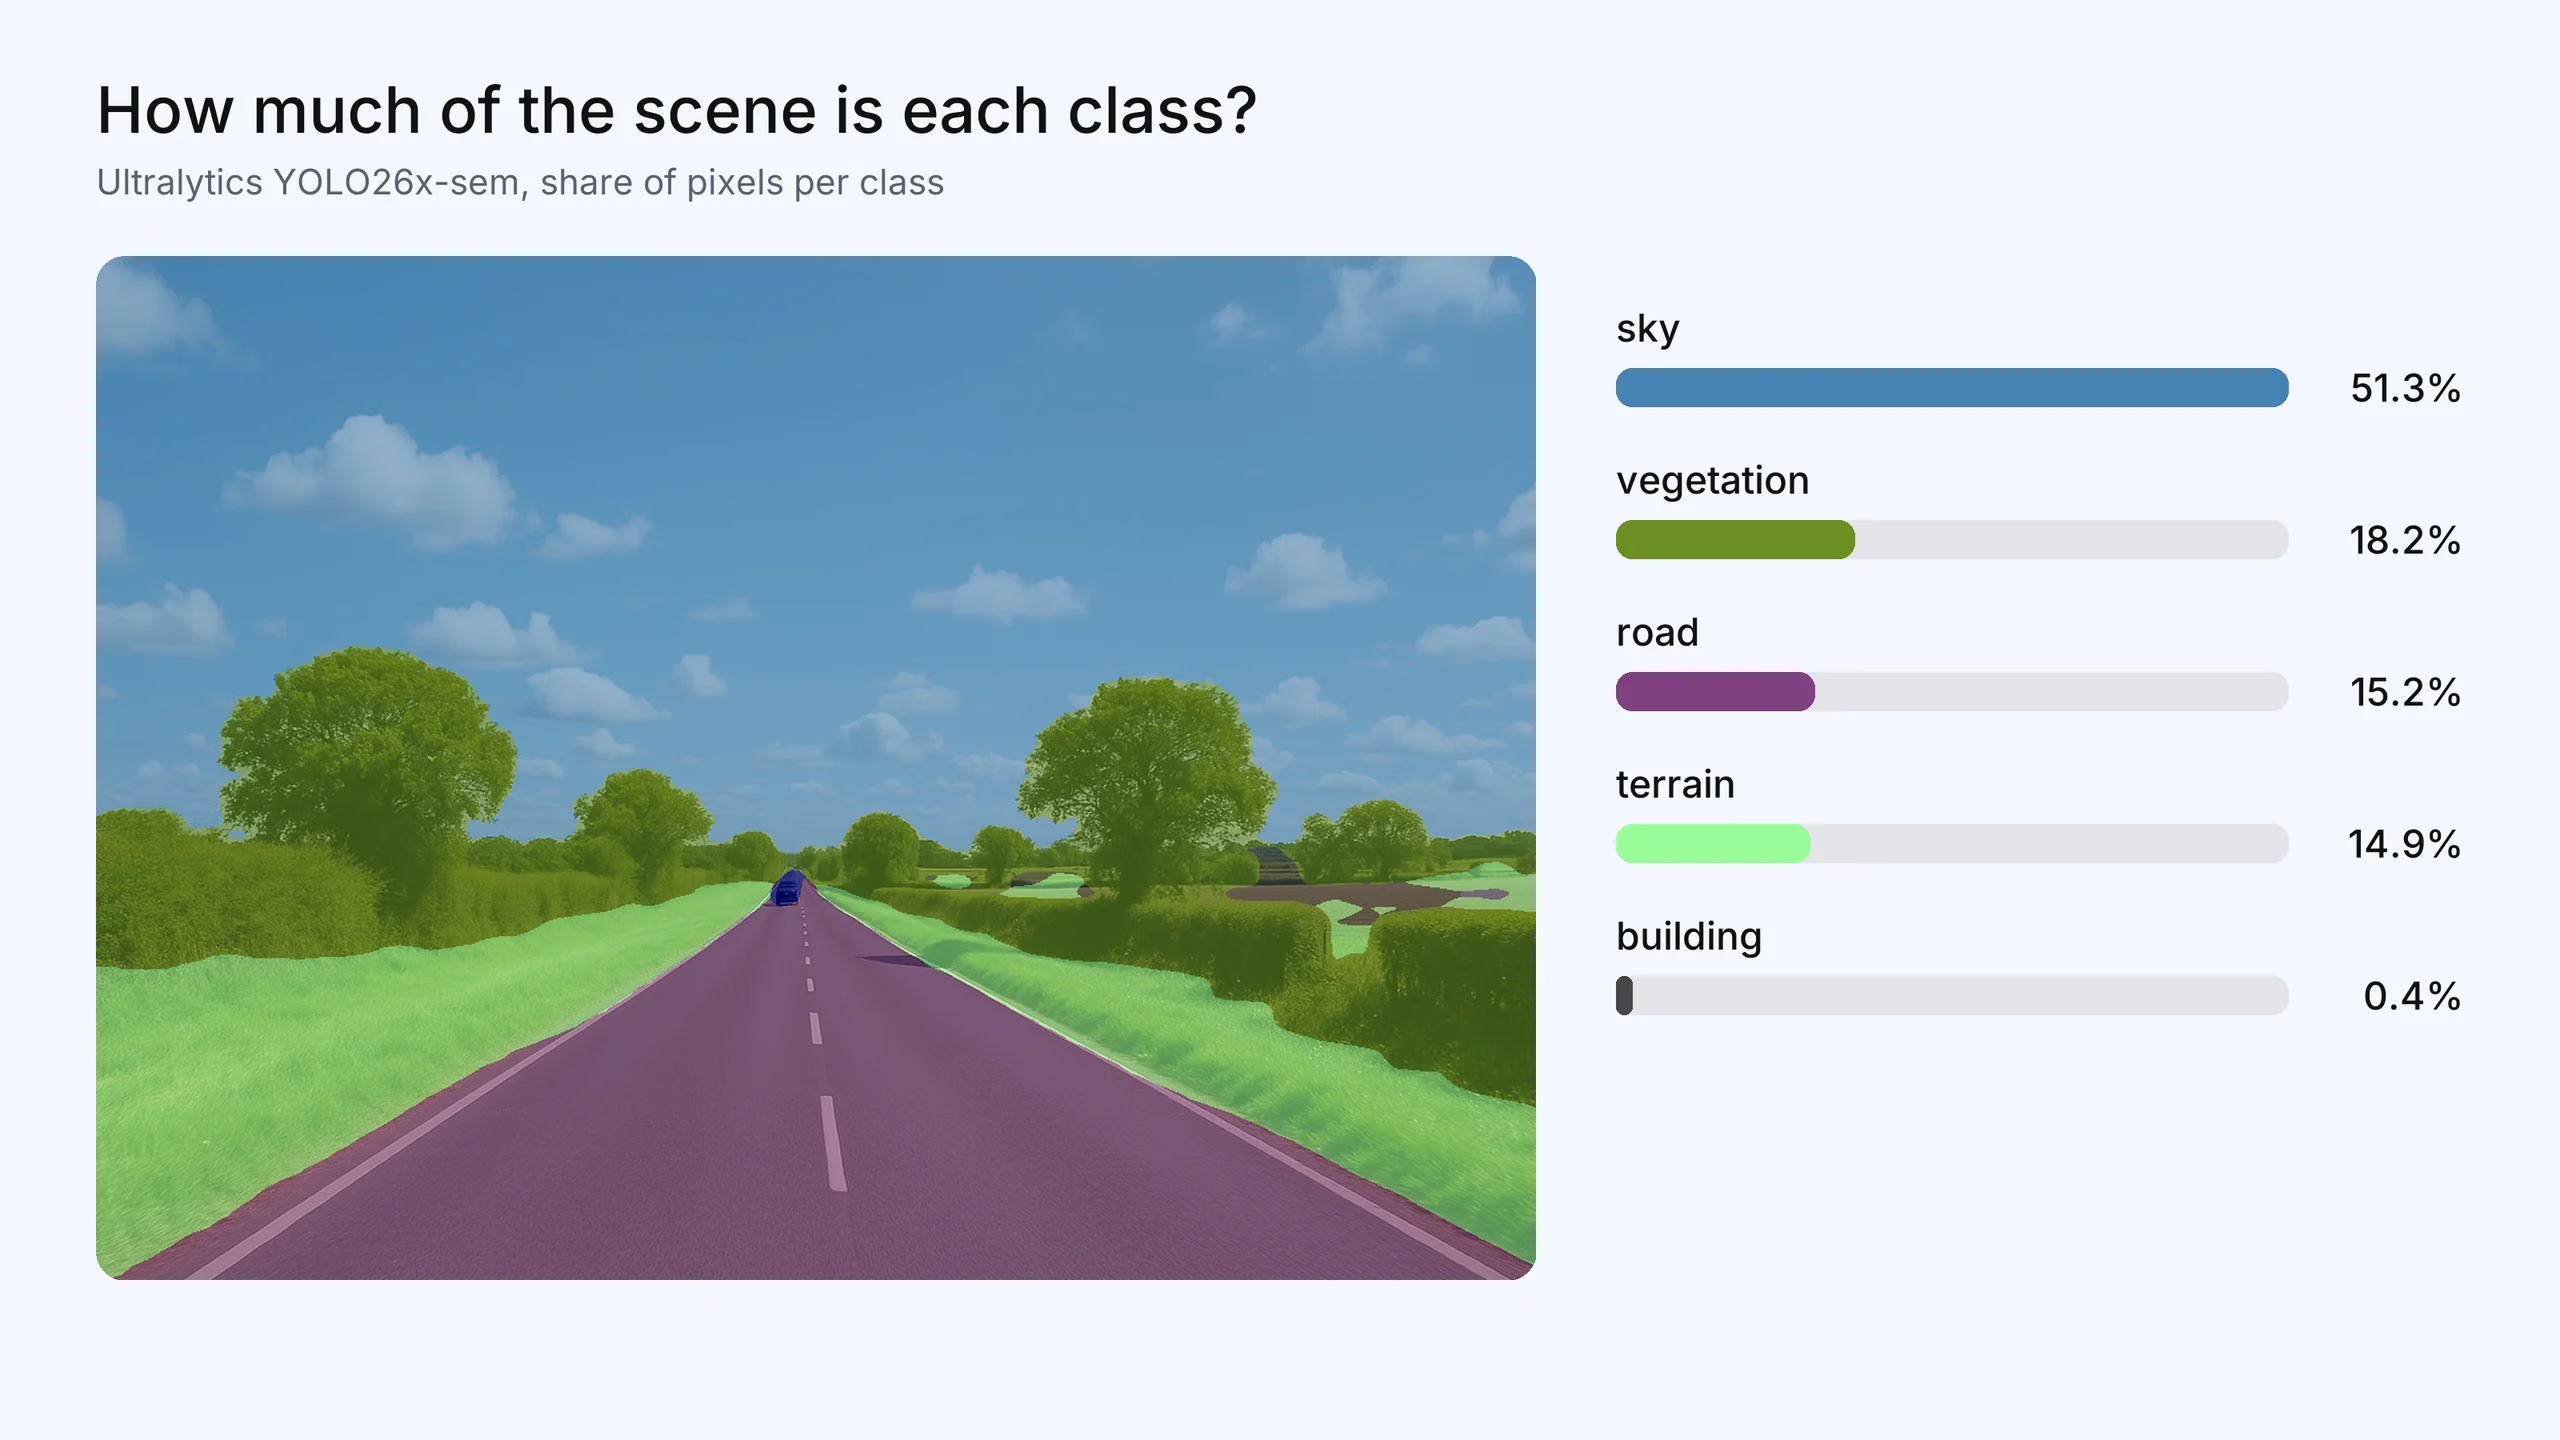
Şekil 3. Anlamsal segmentasyon, "sahnenin ne kadarı hangi sınıfa ait" sorusunu yanıtlar. Ultralytics YOLO26x-sem, bu görüntünün %51,3'ünü gökyüzü, %18,2'sini bitki örtüsü, %15,2'sini yol ve %14,9'unu arazi olarak etiketler. Fotoğraf bu makale için oluşturulmuştur; sınıf haritası ve oranlar gerçek model çıktılarıdır.
Sık sorulan sorular
Anlamsal segmentasyon her pikseli bir sınıfla etiketler, ancak aynı sınıftaki tüm nesneleri tek bir bölge olarak ele alır. Örnek segmentasyonu her nesneyi kendi maskesine ayırır; böylece aynı sınıftaki nesneler ayrı ayrı sayılabilir ve izlenebilir.
Aynı sınıftaki, birbirine dokunan iki nesnenin birbirinden ayırt edilmesi gerekip gerekmediğini düşün. Tek tek nesneleri sayman, izlemen veya bunlara göre işlem yapman gerekiyorsa örnek segmentasyonunu kullan. Yalnızca hangi bölgelerin hangi sınıfa ait olduğunu bilmen gerekiyorsa anlamsal segmentasyon daha basit bir seçenektir.
Mask R-CNN, örnek segmentasyonu modelidir. Önce her nesneyi tespit eder, ardından o nesnenin sınırlayıcı kutusunun içinde ayrı bir piksel maskesi tahmin eder.
Örnek segmentasyonu genellikle daha zordur. Pikselleri sınıflandırmanın yanı sıra aynı sınıftaki nesneleri birbirinden ayırması gerekir; bu da segmentasyonun yanında tespit işlemi de gerektirir.
Çoğunlukla, sınıflar genelinde tahmin edilen ve gerçek bölgelerin ortalama örtüşmesini ölçen ortalama Birleşim Üzerine Kesişim (mIoU) metriğiyle ölçülür. Örnek segmentasyonunda maske mAP, panoptik segmentasyonda ise Panoptik Kalite (PQ) kullanılır.









