Comment entraîner YOLO sur des données Amazon S3 et déployer une API hébergée avec Ultralytics Platform
Entraîne Ultralytics YOLO26 sur les images de ton compartiment Amazon S3 et déploie-le sous forme d’API hébergée avec Ultralytics Platform, étape par étape, en comparaison avec SageMaker.
 Miles Deans15 min de lecture
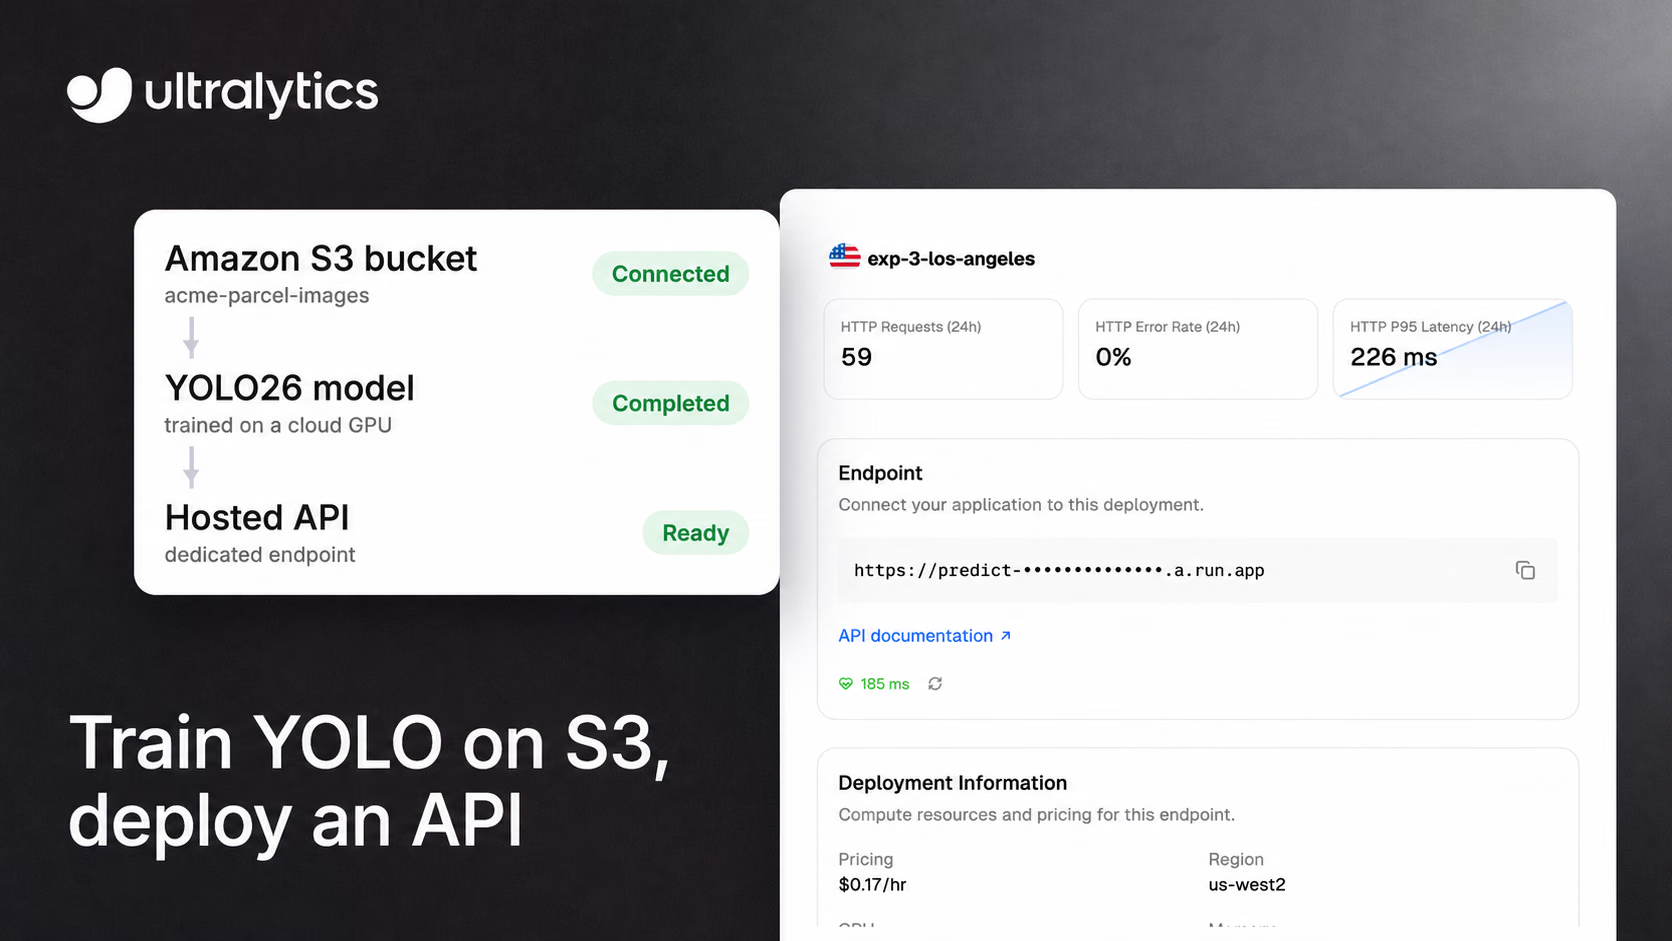
Si tes images se trouvent déjà dans un compartiment Amazon S3, tu peux entraîner un modèle Ultralytics YOLO avec ces images et le déployer sous forme d’API hébergée sans téléverser une deuxième copie du jeu de données. Ultralytics Platform indexe le compartiment sur place, te permet d’étiqueter et d’entraîner YOLO26 sur un GPU cloud, puis déploie le modèle entraîné sur un point de terminaison dédié que tu appelles via HTTPS. Ce guide détaille chaque étape, de la politique IAM à ta première prédiction, et compare ce processus à Amazon SageMaker, Google Vertex AI et Azure Machine Learning.
Le même processus fonctionne avec Google Cloud Storage et Azure Blob Storage, en utilisant une clé JSON de compte de service ou une chaîne de connexion avec clé d’accès au compte à la place de la clé d’accès AWS.
Comment s’articule le processus#
Le pipeline comporte cinq étapes. Tes images d’origine restent dans ton compartiment, et l’entraînement cloud utilise des copies temporaires pendant toute la durée d’une exécution :
- Connecter un compartiment S3 avec un utilisateur IAM en lecture seule.
- Indexer un dossier comme jeu de données Platform. Platform lit les dimensions des images et toutes les étiquettes YOLO trouvées, sans stocker de deuxième copie des images.
- Étiqueter les images dans le navigateur, ou conserver les étiquettes YOLO déjà présentes dans le compartiment.
- Entraîner un modèle YOLO26 sur un GPU cloud. L’entraînement utilise des copies temporaires des images pendant toute la durée de l’exécution.
- Déployer le modèle sur un point de terminaison dédié dans l’une des 42 régions et lui envoyer des images avec une clé API.
Les jeux de données de détection, de segmentation, de pose et de boîte englobante orientée (OBB) sont reconnus d’après la structure de leurs étiquettes ; les mêmes étapes s’appliquent donc à chaque tâche de vision par ordinateur.
Avant de commencer : forfaits, autorisations et limites des données#
Il te faut trois choses :
- Un espace de travail Pro ou Enterprise. Les jeux de données Amazon S3, Google Cloud Storage et Azure Blob Storage nécessitent un forfait Pro ou Enterprise. Pro coûte 29 $ par siège et par mois et comprend 30 $ de crédit mensuel par siège pour le calcul à l’usage, comme l’entraînement cloud.
- Le rôle d’administrateur ou de propriétaire de l’espace de travail, nécessaire pour connecter le stockage cloud.
- Un utilisateur AWS IAM disposant des autorisations nécessaires pour répertorier et lire le compartiment.
Avant de connecter le compartiment, il est utile de savoir quelles données en sortent. Platform récupère les originaux à la demande pour la navigation et l’annotation, et les images indexées ne sont pas comptabilisées dans ton quota de stockage Platform. Chaque connexion dispose d’un commutateur Fonctionnalités d’IA, activé par défaut. Lorsqu’il est activé, les GPU Ultralytics peuvent lire les images pour l’annotation, la recherche d’images similaires et l’entraînement cloud. Des fournisseurs d’IA externes peuvent également traiter les images pour les modèles d’annotation payants en utilisant la clé du fournisseur de ton espace de travail, ainsi que pour la génération d’images lorsque l’accès en écriture est activé. L’entraînement cloud utilise des copies temporaires pendant une exécution ; la recherche d’images similaires conserve les embeddings jusqu’à ce que les images quittent Platform. Désactive cette option et aucun nouveau travail d’IA ne démarre (les travaux déjà en cours se terminent), tandis que l’annotation manuelle et l’entraînement local continuent de fonctionner. Platform ne modifie ni ne supprime jamais tes objets.
Étape 1 : créer un utilisateur IAM en lecture seule#
Dans la console AWS, va dans IAM > Users, crée un utilisateur sans accès à la console et associe-lui une politique qui autorise la lecture et l’énumération du compartiment :
{
    "Version": "2012-10-17",
    "Statement": [
        { "Effect": "Allow", "Action": "s3:ListAllMyBuckets", "Resource": "*" },
        {
            "Effect": "Allow",
            "Action": ["s3:ListBucket", "s3:GetObject"],
            "Resource": ["arn:aws:s3:::my-bucket", "arn:aws:s3:::my-bucket/*"]
        }
    ]
}
s3:ListAllMyBuckets est facultatif. Il permet à Platform de détecter tes compartiments afin que tu n’aies pas à saisir leurs noms.
Ouvre ensuite l’onglet Security credentials de l’utilisateur et crée une clé d’accès. Platform a besoin d’une clé d’utilisateur IAM à longue durée de vie : la plateforme refuse les identifiants temporaires AWS STS, y compris les identifiants de session de rôle et les clés IAM Identity Center, car ils expireraient alors que le jeu de données est encore connecté. Pour cela, utilise un utilisateur dédié, jamais les identifiants root. Platform chiffre la clé au repos avec AES-256-GCM et ne l’expose jamais aux charges de travail d’entraînement ; tu peux révoquer l’accès à tout moment en désactivant la clé dans IAM.
Étape 2 : connecter le compartiment à Ultralytics Platform#
- Dans Platform, va dans Settings > Integrations et sélectionne Amazon S3.
- Saisis l’ID de la clé d’accès, la clé d’accès secrète et la région du compartiment, par exemple
us-east-1. - Clique sur Find available buckets et sélectionne les compartiments à connecter, ou saisis le nom d’un compartiment si la politique n’autorise pas leur détection.
- Clique sur Connect. Platform vérifie qu’il peut répertorier et lire chaque compartiment avant d’enregistrer quoi que ce soit.
Une connexion lit les compartiments d’une seule région ; si tes données sont réparties dans plusieurs régions, crée donc une connexion pour chacune. Le guide d’intégration Amazon S3 présente l’autorisation d’écriture facultative utilisée pour la génération d’images.
Étape 3 : créer un jeu de données à partir du compartiment#
Clique sur New Dataset, ouvre l’onglet Cloud, choisis le compartiment, accède au dossier contenant tes données et crée le jeu de données. Platform répertorie le dossier une fois et indexe les éléments trouvés :
- Images : objets
.jpg,.jpeg,.png,.webpet.avif. - Étiquettes : fichiers YOLO
.txt, associés selon la structure standardimages/àlabels/ou sous forme de fichiers placés à côté de chaque image. - Classes : un fichier
data.yamlfournit les noms des classes, comme dans un jeu de données YOLO classique. - Découpages : les noms de dossiers
train,valettestattribuent automatiquement les découpages.
Une seule importation indexe jusqu’à 500 000 objets ; répartis donc les compartiments plus volumineux entre plusieurs jeux de données. Considère les objets indexés comme immuables : chaque image est associée à l’ETag de son objet S3, et Platform cesse de diffuser une image qui a été remplacée. Pour ajouter des données par la suite, téléverse de nouveaux objets et crée un nouveau jeu de données, car l’index est créé une seule fois, lors de la création du jeu de données.
Étape 4 : étiqueter ou vérifier les images#
Ouvre le jeu de données pour examiner les étiquettes importées dans l’éditeur d’annotation. Si le compartiment ne contient pas encore d’étiquettes, tu peux tracer manuellement des boîtes et des masques ou, si les fonctionnalités d’IA sont activées, utiliser l’annotation intelligente (SAM pour la détection, la segmentation et OBB, YOLO pour la pose) ainsi que l’annotation automatique pour accélérer le travail. Les étiquettes sont stockées dans Platform, et les objets de ton compartiment restent inchangés.
Étape 5 : entraîner YOLO26 sur un GPU cloud#
Clique sur New Model dans le jeu de données ou dans un projet, choisis un modèle de base et lance une exécution cloud :
- Modèle de base : choisis un modèle officiel Ultralytics (YOLO26 est recommandé) ou l’un de tes propres modèles à affiner. Seuls les modèles compatibles avec la tâche du jeu de données sont répertoriés.
- Paramètres : définis le nombre d’époques, la taille des images et la taille du lot, ou conserve les valeurs par défaut.
- GPU : choisis un GPU dans Ultralytics Cloud. Avant de démarrer, la boîte de dialogue affiche le tarif horaire et estime la durée de l’exécution ainsi que son coût total. Notre guide pour choisir un GPU cloud t’aide à évaluer les compromis.
Les métriques, la sortie de la console et les graphiques système sont transmis au navigateur pendant l’exécution, et des points de contrôle sont automatiquement enregistrés. Une fois l’entraînement terminé, la page du modèle affiche ses métriques et, lorsque les résultats de validation sont disponibles, une analyse détaillée comme une matrice de confusion.
Étape 6 : déployer le modèle sous forme d’API hébergée#
Ouvre l’onglet Deploy du modèle. Une carte et un tableau répertorient 42 régions, triées selon la latence mesurée depuis ta position. Clique sur Deploy dans la région de ton choix, vérifie le CPU, la mémoire et le prix, puis clique sur Create Deployment.
La taille choisie détermine la facturation :
- Taille par défaut (1 vCPU, 2 GiB) : gratuite, avec mise à l’échelle jusqu’à zéro en période d’inactivité.
- Tailles personnalisées (jusqu’à 8 vCPU et 32 GiB) : maintiennent une instance en veille et sont facturées au tarif horaire régional affiché, de leur mise en service jusqu’à l’arrêt du point de terminaison, y compris pendant les périodes d’inactivité.
Chaque point de terminaison dédié est un service à locataire unique doté de sa propre URL et de son propre suivi, et il est associé à une seule clé API de ton espace de travail. Les espaces de travail gratuits peuvent exécuter 3 déploiements, les espaces Pro 10, et les espaces Enterprise un nombre illimité. Pour savoir quand un point de terminaison dédié est préférable à l’inférence partagée, consulte notre guide sur l’inférence dédiée ou partagée.
Étape 7 : appeler le point de terminaison#
Installe Requests avec python -m pip install requests et enregistre une image sous image.jpg. Remplace l’URL d’exemple par l’URL copiée de ton déploiement, suivie de /predict, puis remplace YOUR_API_KEY par la clé associée à ce déploiement :
import requests

url = "https://YOUR_DEPLOYMENT_URL.run.app/predict"
headers = {"Authorization": "Bearer YOUR_API_KEY"}
data = {"conf": 0.25, "iou": 0.5, "imgsz": 640}

with open("image.jpg", "rb") as f:
    response = requests.post(url, headers=headers, data=data, files={"file": f})

print(response.json())
La même requête avec cURL :
curl -X POST "https://YOUR_DEPLOYMENT_URL.run.app/predict" \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -F "file=@image.jpg" \
  -F "conf=0.25" \
  -F "iou=0.5" \
  -F "imgsz=640"
Chaque point de terminaison fournit également une référence API interactive à l’adresse /docs et une vérification /health. Les requêtes directes ne sont pas soumises à la limite de débit de l’API Platform, mais un seul exemplaire sert chaque point de terminaison : les requêtes qui ne peuvent pas être traitées rapidement reçoivent un 429 avec un en-tête Retry-After, et la taille des corps de requête est limitée à 32 MB. Une fois le point de terminaison en service, tu peux suivre ses requêtes, ses erreurs et sa latence depuis la page de déploiement.
Coûts, limites et sécurité en bref#
| Élément | À quoi s’attendre |
|---|---|
| Offre | Pro (29 $ par siège et par mois) ou Enterprise pour les jeux de données S3, Google Cloud Storage et Azure Blob |
| Stockage | Les images indexées restent dans ton compartiment et ne sont pas déduites du quota de stockage Platform |
| Entraînement | Facturé selon le temps d’utilisation du GPU, à partir des crédits ; la boîte de dialogue estime le coût avant le démarrage |
| Point de terminaison | Taille par défaut gratuite avec mise à l’échelle jusqu’à zéro ; tailles personnalisées facturées à l’heure pendant leur fonctionnement |
| Taille de l’importation | Jusqu’à 500 000 objets par importation |
| Identifiants | Clé d’utilisateur IAM à longue durée de vie, chiffrée au repos et jamais exposée aux charges de travail d’entraînement |
| Non disponible pour les jeux de données S3 | Clonage de jeux de données, instantanés de versions, floutage des visages, collage d’images provenant d’autres jeux de données |
Ultralytics Platform face à SageMaker, Vertex AI et Azure ML#
Les plateformes cloud de ML généralistes peuvent également entraîner des modèles avec les données de leur propre stockage et les servir. Les colonnes relatives au stockage et au service ci-dessous sont tirées de la documentation de chaque plateforme ; la dernière colonne présente notre évaluation.
| Plateforme | Emplacement des données d’entraînement | Options de service | Cas d’utilisation suggéré (notre évaluation) |
|---|---|---|---|
| Ultralytics Platform avec Ultralytics YOLO | Indexation sur place depuis S3, Google Cloud Storage ou Azure Blob | Points de terminaison dédiés à instance unique dans 42 régions ; mise à l’échelle jusqu’à zéro avec la taille par défaut | Équipes qui veulent passer de leur compartiment à l’API pour la détection, la segmentation, la pose ou OBB avec YOLO, sans écrire de code d’entraînement ni de service |
| Amazon SageMaker AI | Les tâches d’entraînement lisent les données depuis Amazon S3, Amazon EFS ou Amazon FSx for Lustre | Points de terminaison en temps réel avec mise à l’échelle automatique, sans serveur et inférence asynchrone | Équipes qui exécutent déjà des pipelines de ML sur AWS et veulent choisir leurs propres conteneurs et options de service |
| Google Vertex AI | Les tâches d’entraînement sans serveur montent les compartiments Cloud Storage accessibles sous /gcs/ | Points de terminaison gérés pour l’inférence en ligne | Équipes dont les données et les outils reposent sur Google Cloud |
| Azure Machine Learning | Les magasins de données référencent le stockage Azure existant, comme Blob Storage | Points de terminaison en ligne gérés pour l’inférence en temps réel | Équipes dont l’infrastructure repose sur Azure |
La documentation de SageMaker sur les données d’entraînement répertorie S3, EFS et FSx for Lustre comme sources, avec des modes d’entrée par flux et par téléchargement. Son inférence sans serveur gère la mise à l’échelle pour toi et convient au trafic entrecoupé de périodes d’inactivité pouvant tolérer des démarrages à froid ; tu peux utiliser un conteneur fourni par SageMaker ou apporter le tien. Vertex AI exécute un entraînement personnalisé à partir d’une application Python sur un conteneur prédéfini ou d’un conteneur personnalisé, et Azure Machine Learning se connecte au stockage Azure existant par l’intermédiaire de magasins de données et sert les modèles depuis des points de terminaison en ligne gérés. Cette polyvalence est le point fort d’une plateforme généraliste. Selon notre évaluation, un flux de travail YOLO personnalisé demande davantage de configuration ; les exigences relatives aux conteneurs dépendent des options d’entraînement et de service choisies. Si tu veux rester sur AWS, notre guide de déploiement SageMaker explique comment y servir un modèle YOLO.
Ultralytics Platform a volontairement un champ d’application plus restreint. Conçue autour des modèles Ultralytics YOLO, elle permet de remplacer le script d’entraînement et le conteneur de service par les étapes ci-dessus. Elle convient moins bien si ton organisation exige des identifiants STS temporaires pour chaque intégration ou si un point de terminaison doit se mettre à l’échelle sur de nombreuses instances sous une forte charge simultanée. Si tu hésites encore sur l’endroit où exécuter l’inférence, notre guide sur le cloud ou l’auto-hébergement compare les coûts, la latence et le contrôle des données.
Foire aux questions
Ultralytics Platform connecte un compartiment S3, indexe les images sur place, entraîne YOLO26 sur un GPU cloud et déploie le modèle sur un point de terminaison HTTPS dédié. Amazon SageMaker AI permet également d’entraîner des modèles depuis S3 et propose l’inférence en temps réel, sans serveur et asynchrone, avec des conteneurs fournis par SageMaker ou personnalisés selon l’option de service. Google Vertex AI et Azure Machine Learning proposent des processus similaires reposant sur leur propre stockage, Cloud Storage et le stockage Azure, plutôt que sur un compartiment S3 existant.
Platform ne conserve pas de deuxième copie de ton jeu de données : elle indexe les images et récupère les originaux à la demande. Lorsque les fonctionnalités d’IA sont activées, l’entraînement cloud utilise des copies temporaires situées hors de ton compartiment pendant toute la durée d’une exécution, et la recherche d’images similaires conserve un embedding de chaque image. Platform ne modifie ni ne supprime jamais tes objets.
Pas pour le moment. Platform exige une clé d’accès à longue durée de vie provenant d’un utilisateur IAM dédié et refuse les identifiants STS, car ils expirent pendant que le jeu de données est connecté. Limite les autorisations de l’utilisateur à la lecture et à l’énumération, et désactive la clé dans IAM pour révoquer l’accès.
Les jeux de données S3 nécessitent un forfait Pro (29 $ par siège et par mois, avec 30 $ de crédit mensuel par siège) ou Enterprise. L’entraînement est facturé selon le temps d’utilisation du GPU, et la boîte de dialogue d’entraînement estime le coût avant le démarrage. La taille par défaut du point de terminaison est gratuite et se met à l’échelle jusqu’à zéro ; les tailles personnalisées sont facturées à l’heure pendant leur fonctionnement.
Oui. Google Cloud Storage se connecte à l’aide d’une clé JSON de compte de service et du rôle Lecteur d’objets Storage, tandis qu’Azure Blob Storage se connecte à l’aide d’une chaîne de connexion HTTPS contenant la clé d’accès au compte (les chaînes avec jeton SAS ne sont pas acceptées). Les étapes liées au jeu de données, à l’entraînement et au déploiement sont les mêmes.
Un jeu de données est indexé une seule fois lors de sa création ; les nouveaux objets ne sont donc pas détectés automatiquement. Ajoute de nouveaux objets au lieu de remplacer ceux qui existent déjà, puis crée un nouveau jeu de données qui les inclut et entraîne ou ajuste de nouveau le modèle.
Oui. Télécharge les poids ou exporte le modèle vers des formats tels que ONNX, TensorRT et CoreML depuis la page du modèle, puis exécute-le sur tes propres serveurs ou appareils edge avec le package Python Ultralytics.
Écrit par
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









