OCR en Python avec Ultralytics YOLO26 : lis des documents, des photos et des PDF sous n’importe quel angle
Lis le texte des images et des pages PDF, quelle que soit leur rotation, avec Ultralytics YOLO26-Text et PP-OCRv6 en quelques lignes de Python, sur CPU ou GPU, avec TensorRT en option.
 Jing Qiu16 min de lecture
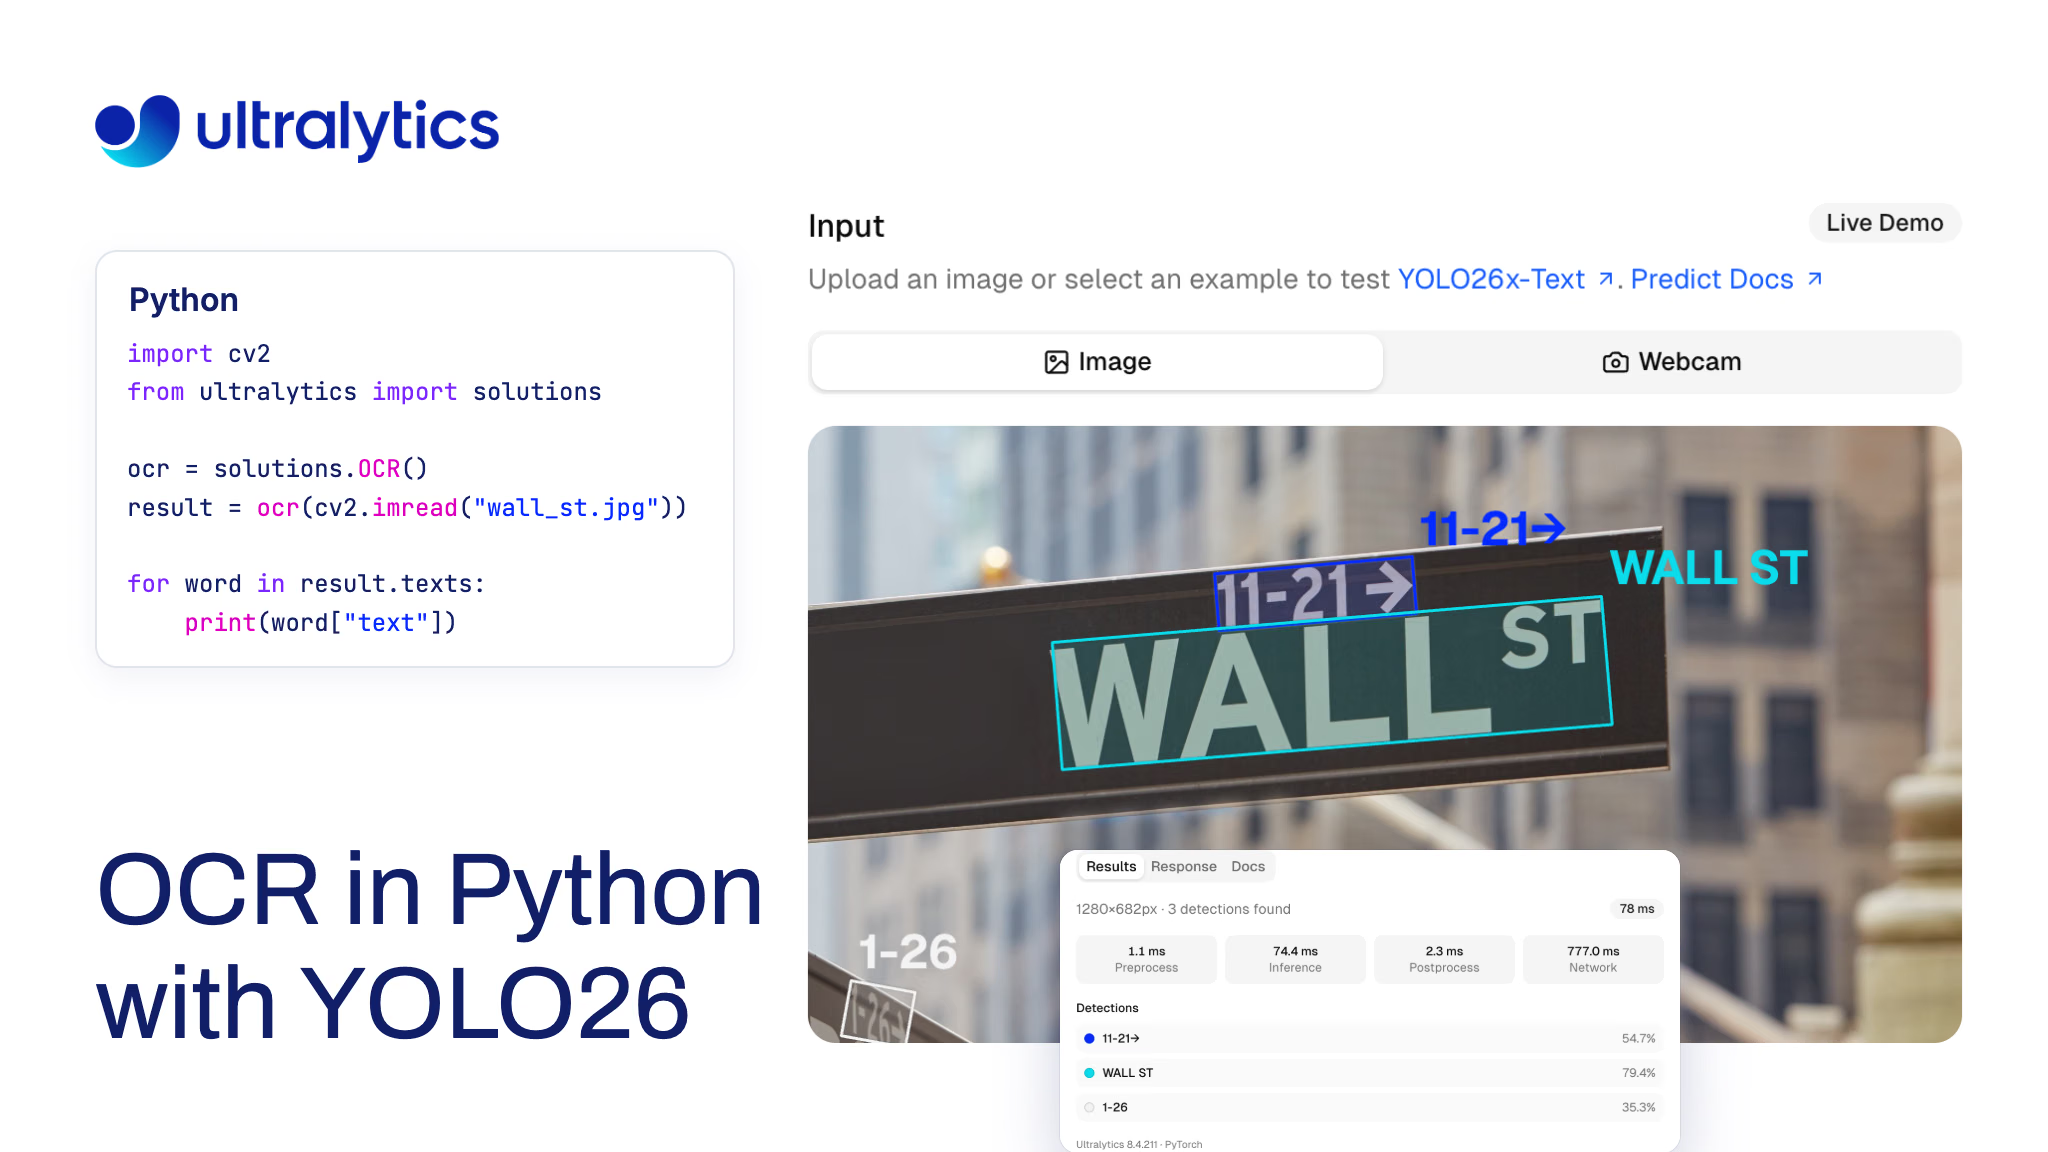
Comment lancer l’OCR en Python sur un scan de travers, une photo de panneau prise avec un téléphone ou une page de PDF, puis récupérer les mots dans l’ordre où une personne les lirait ? Avec le package Ultralytics, une seule classe suffit : solutions.OCR() détecte le texte avec un modèle Ultralytics YOLO26-Text, lit chaque mot avec le moteur de reconnaissance PP-OCRv6 de PaddleOCR et renvoie les mots reconnus ligne par ligne, quelle que soit la rotation de la page, sur CPU ou GPU.
Cette chaîne de traitement est nouvelle. Ultralytics 8.4.210 a reconstruit la solution OCR autour de PP-OCRv6 sur ONNX Runtime, avec gestion de la rotation et de l’ordre de lecture, et 8.4.211 a ajouté un moteur de reconnaissance TensorRT facultatif. Dans notre benchmark, avec une taille d’image de 1280, la configuration par défaut a obtenu un F1 au niveau des mots de 0.931 sur six pages PDF et de 0.722 sur 80 photos HierText. Sur une RTX PRO 6000, un moteur TensorRT FP16 mis en cache a lu en 82 ms les 251 mots détectés sur une photo, contre 249 ms avec ONNX Runtime sur CUDA.
Ce guide explique le fonctionnement de la chaîne, comment l’exécuter sur des images et des PDF, sa vitesse et les langues qu’elle lit actuellement. Ultralytics propose l’une des options OCR comparées ci-dessous ; la comparaison s’en tient donc aux capacités documentées de chaque projet.
YOLO26 OCR lit une page en deux étapes, puis remet les mots dans l’ordre#
La reconnaissance optique de caractères (OCR) a deux fonctions : trouver le texte, puis le lire. La solution OCR Ultralytics les sépare clairement :
- Détection : un modèle YOLO26-Text, détecteur de boîtes englobantes orientées, dessine des boîtes pivotées autour du texte. Il existe en tailles n, s, m, l et x, et le modèle x est celui utilisé par défaut.
- Reconnaissance : PP-OCRv6 medium lit chaque recadrage. Il s’exécute sur ONNX Runtime à partir de la version des ressources Ultralytics ; tu n’as donc pas besoin d’installer PaddlePaddle. Les recadrages qui ne donnent aucun texte sont supprimés.
- Ordonnancement : les mots sont regroupés en lignes et renvoyés de haut en bas et de gauche à droite, chacun associé à son numéro de ligne.
Chaque mot est renvoyé sous forme d’enregistrement contenant son texte, son score de confiance de reconnaissance, le score de confiance du détecteur, un numéro de ligne et un polygone dans les coordonnées de l’image d’origine. Comme les deux scores de confiance restent séparés, tu peux envoyer en vérification humaine un mot détecté avec confiance, mais lu avec incertitude, plutôt que de lui faire confiance.
Les deux étapes restent indépendantes. Tu peux remplacer le détecteur par un modèle plus petit, un modèle de détection ou de segmentation à toi, ou un autre moteur de reconnaissance ; la gestion de la rotation et l’ordre de lecture continuent de fonctionner. Tu peux essayer le même chemin d’exécution dans le navigateur sur notre page de traitement de documents avant d’installer quoi que ce soit.
Les pages pivotées et à l’envers sont lues dans le bon ordre#
La solution déduit la rotation d’une page à partir du texte qu’elle détecte ; tu n’as donc pas besoin de redresser ou de faire pivoter les pages au préalable :
- Trouver le sens du texte. Elle calcule la moyenne de l’angle du grand côté des boîtes détectées, pondérée par leur allongement. Les boîtes dont le rapport d’allongement est inférieur à 2:1, comme celles contenant un seul chiffre, ne sont pas prises en compte.
- Faire pivoter la page. Elle fait pivoter la page pour que le texte se lise de gauche à droite, redresse chaque mot recadré et regroupe les mots en lignes.
- Trancher entre 0° et 180°. Une boîte ne permet pas de savoir dans quel sens le texte est orienté ; la solution lit donc les 8 mots les plus larges dans les deux sens et conserve l’orientation qui donne le score de confiance le plus élevé. Le texte à l’envers ressemble à du bruit à faible confiance, ce qui fait ressortir la bonne réponse.
Après avoir fait pivoter de 90°, 180° et 270° 8 documents et captures d’écran, ainsi que 12 photos, le F1 au niveau des mots était de 0.925 pour les documents et de 0.654 pour les photos. Sur un formulaire IRS 8802 vierge, la solution a lu 404, 401 et 399 mots à 0°, 180° et 90°, avec des premières lignes identiques. La version précédente supposait que chaque page était à l’endroit.
Les valeurs par défaut sont issues d’un benchmark, pas d’une supposition#
Nous avons déterminé les principales valeurs par défaut par des mesures. Le benchmark a été exécuté sur une RTX PRO 6000 avec l’image Platform de production ; les fichiers téléversés étaient au format JPEG, avec un maximum de 1280 pixels sur le côté le plus long. Il utilisait 80 photos de validation du jeu de données HierText de Google avec leurs transcriptions des mots lisibles, 6 pages PDF évaluées par rapport à leurs calques de texte (4 tirées d’un article arXiv, plus des formulaires IRS 1040 et 8802 vierges), une capture d’écran synthétique et une image synthétique. La métrique est le score F1 au niveau des mots, qui équilibre la précision et le rappel, en comptant les mots en minuscules de 2 caractères alphanumériques ou plus.
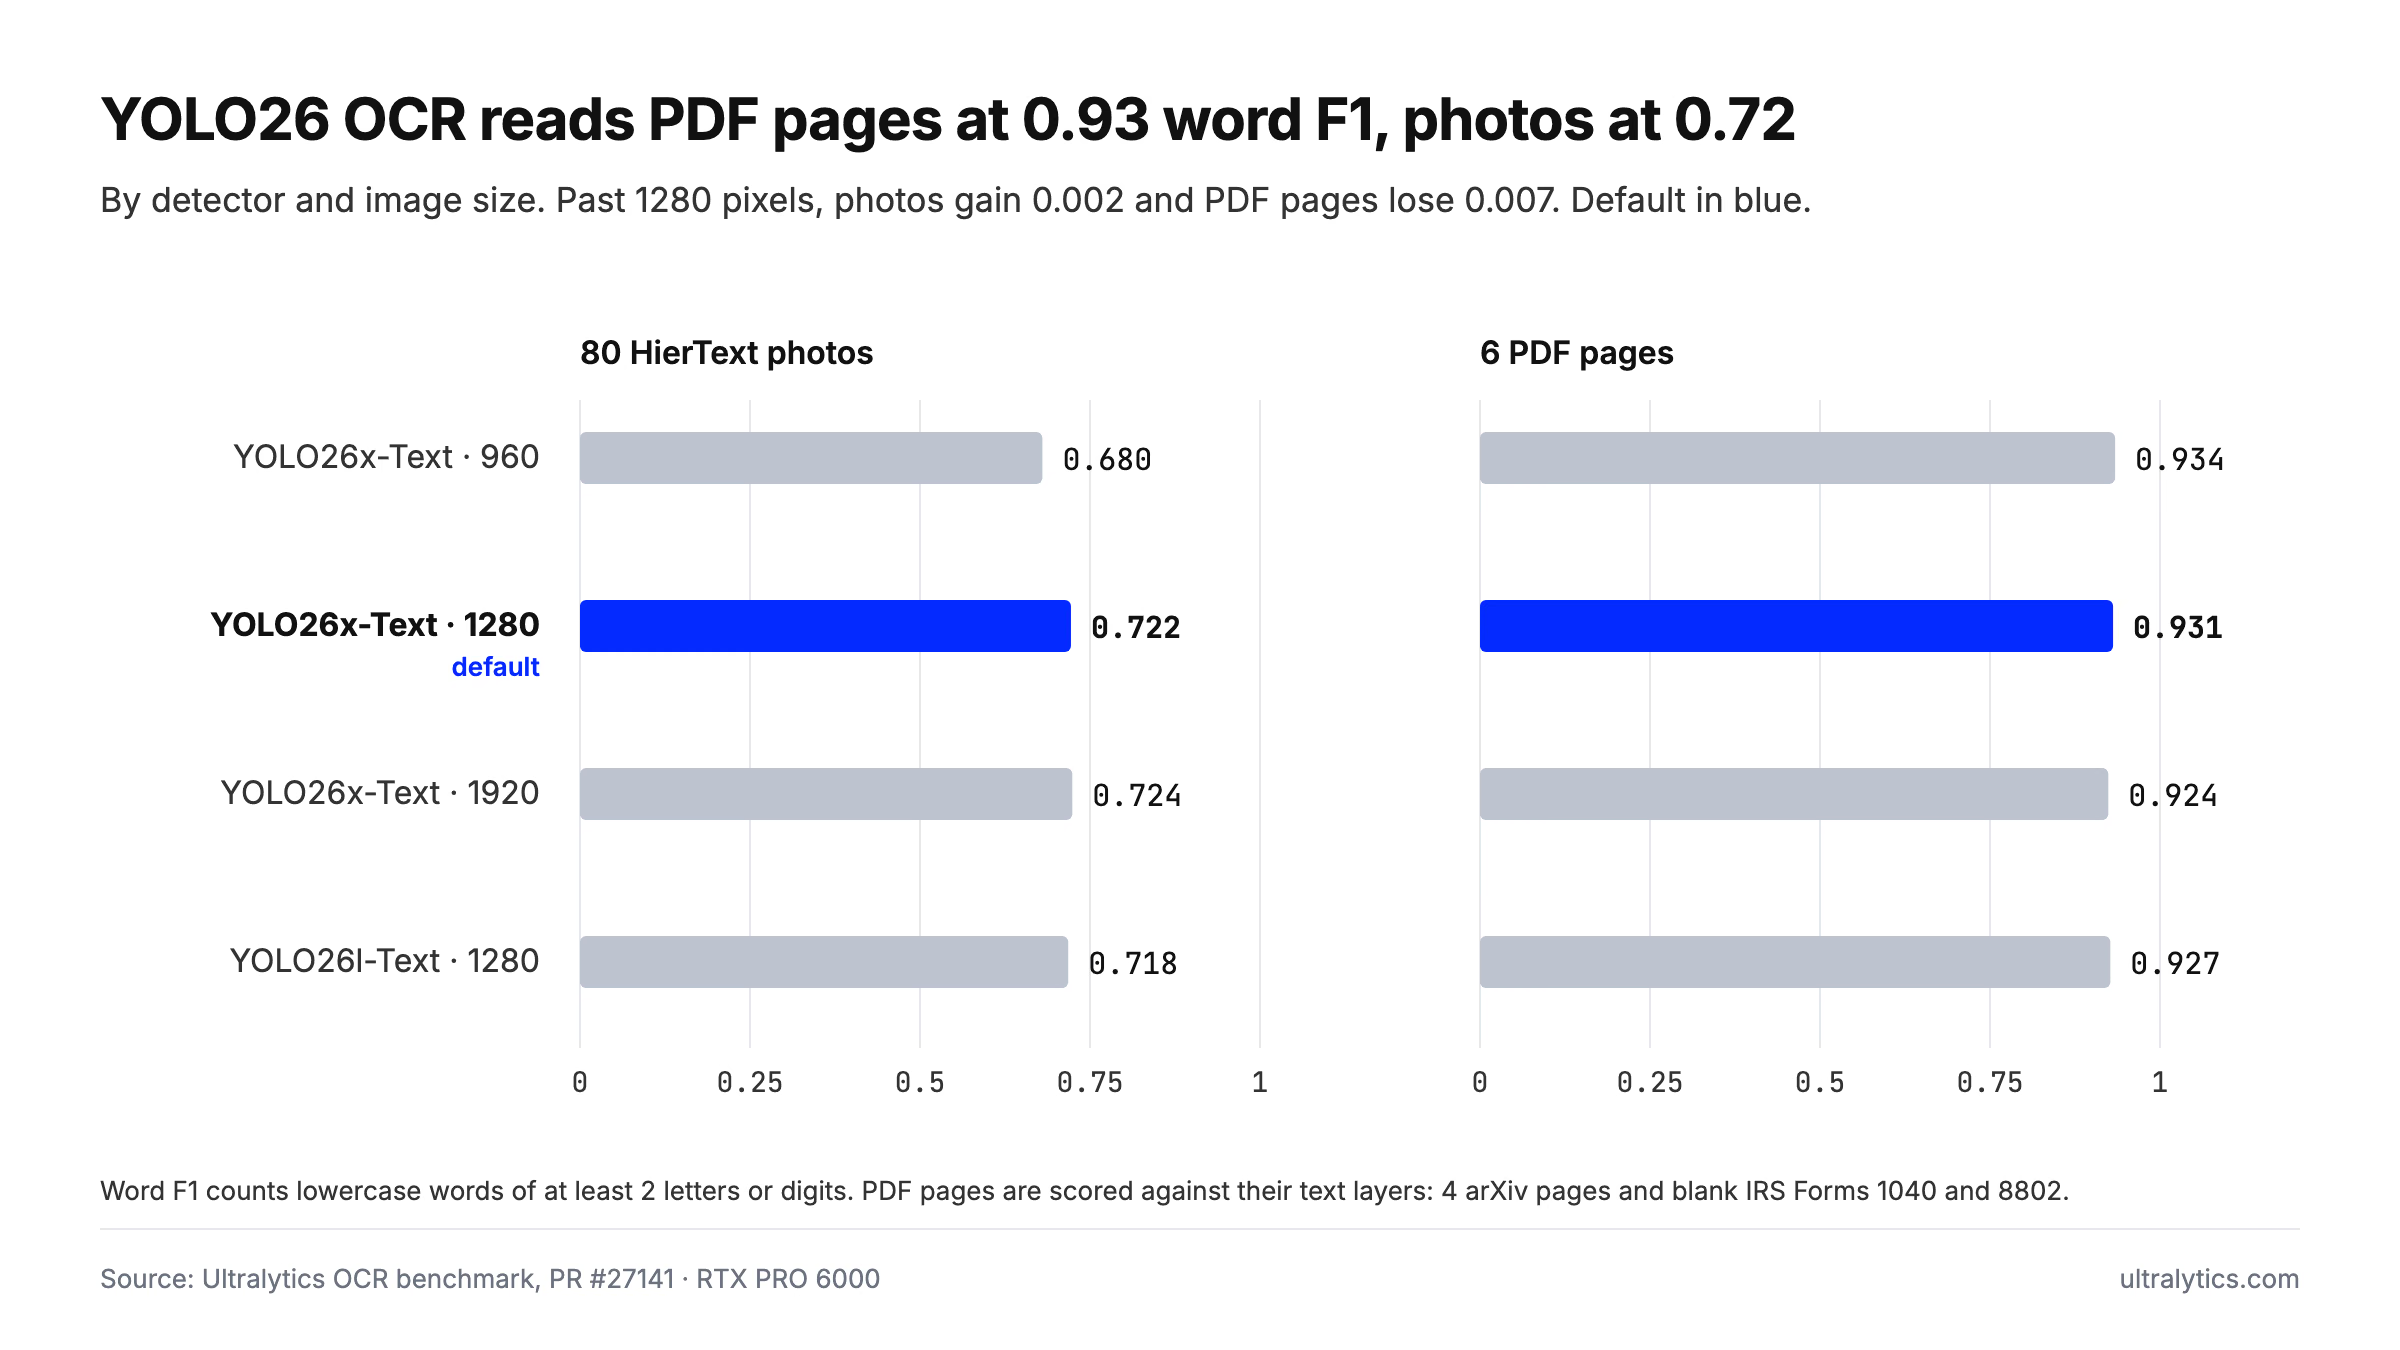
F1 au niveau des mots de YOLO26-Text avec PP-OCRv6 sur 80 photos HierText et 6 pages PDF, selon le détecteur et la taille de l’image, sur une RTX PRO 6000.
Les pages PDF nettes sont bien mieux lues que les photos de texte dans une scène, quelle que soit la configuration, et les chiffres conduisent à trois valeurs par défaut :
yolo26x-textàimgsz=1280. Passer à 960 a fait perdre 0.042 de F1 aux photos, tandis que 1920 a apporté 0.002 aux photos et fait perdre 0.007 aux pages PDF. Les images plus petites ne sont pas agrandies à 1280 ; elles sont traitées à leur taille d’origine, arrondie au multiple supérieur du pas de 32 pixels du modèle.- Lire mot à mot. La lecture de mots isolés a dépassé celle de lignes entières de 4 points de F1 sur les photos.
max_det=1000. Une page de document dense contient plus que les 300 détections habituelles.
Si tu as besoin d’un détecteur plus léger, YOLO26l-Text est resté à moins d’un demi-point du modèle x sur les deux ensembles.
Comment lancer l’OCR en Python avec YOLO26#
Installe ou mets à niveau le package avec pip install -U "ultralytics>=8.4.211". Le premier appel OCR télécharge YOLO26x-Text et PP-OCRv6 et installe ONNX Runtime, en utilisant onnxruntime-gpu lorsque CUDA est disponible. Le moteur de reconnaissance ONNX Runtime par défaut nécessite Python 3.11+ et ONNX Runtime 1.26+.
Lire une image#
import cv2

from ultralytics import solutions

ocr = solutions.OCR()  # YOLO26x-Text à imgsz=1280 avec PP-OCRv6
im0 = cv2.imread("receipt.jpg")
assert im0 is not None, "Image not found"
result = ocr(im0)
cv2.imwrite("receipt_ocr.jpg", result.plot_im)  # image annotée

for word in result.texts:
    print(word["line"], word["text"], round(word["confidence"], 2))
Depuis la ligne de commande, yolo solutions ocr source="path/to/video.mp4" fait la même chose sur chaque image. Chaque image est lue indépendamment, sans suivi.
Lire un PDF#
La solution prend des images en entrée ; commence donc par convertir chaque page PDF en image. PyMuPDF est une option :
import cv2
import numpy as np
import pymupdf  # pip install pymupdf

from ultralytics import solutions

ocr = solutions.OCR()
for page in pymupdf.open("document.pdf"):
    pix = page.get_pixmap(dpi=200)
    rgb = np.frombuffer(pix.samples, np.uint8).reshape(pix.height, pix.width, pix.n)
    result = ocr(cv2.cvtColor(rgb, cv2.COLOR_RGB2BGR))

    lines = {}
    for word in result.texts:  # déjà dans l’ordre de lecture
        lines.setdefault(word["line"], []).append(word["text"])
    print("\n".join(" ".join(words) for words in lines.values()))
Comme result.texts est déjà trié, reconstruire du texte brut se résume à un dictionnaire et une concaténation. Les polygones te permettent d’aller plus loin, par exemple en vérifiant qu’un montant se trouve à côté du mot « Total ».
Choisir le modèle, l’appareil et le moteur de reconnaissance#
- Détecteur plus petit :
solutions.OCR(model="yolo26s-text.pt")charge un détecteur plus petit et plus rapide ; vérifie sa précision sur tes propres pages. Les cinq tailles se téléchargent automatiquement. - CPU ou GPU : le moteur de reconnaissance s’exécute sur CUDA lorsqu’un GPU CUDA est sélectionné et que le fournisseur d’exécution CUDA d’ONNX Runtime est disponible, et sur CPU dans les autres cas ; le même script fonctionne donc sur un ordinateur portable ou un serveur.
- Ton propre moteur de reconnaissance : passe une fonction en tant que
recognizer. Elle reçoit chaque recadrage de mot BGR et renvoie(text, confidence); la solution continue d’assurer la détection, la rotation et l’ordonnancement autour de cette fonction.
def recognize(crop):
    # Exécuter n’importe quel modèle de reconnaissance sur le recadrage du mot en BGR
    return "example", 0.95


ocr = solutions.OCR(recognizer=recognize)
TensorRT lit les mots 2,5 à 3 fois plus vite sur les photos denses#
Lors de nos tests GPU sur des pages denses, la reconnaissance, et non la détection, prenait le plus de temps. Une optimisation antérieure avait mesuré la détection à environ 11 ms sur une requête de 250 ms, et la pull request TensorRT a montré qu’une grande partie du temps de reconnaissance restant était due à 33 petits lots dominés par la surcharge de lancement plutôt que par les calculs. Ultralytics 8.4.211 ajoute un argument pour cela :
ocr = solutions.OCR(recognizer="tensorrt") # Moteur TensorRT FP16 sur les GPU NVIDIALa première exécution construit un moteur TensorRT FP16 en environ 30 secondes et le met en cache à côté du modèle PP-OCRv6, une fois par version de TensorRT et architecture GPU. Les chargements suivants prennent de 0,05 à 0,2 seconde. Selon les notes de version, il est environ 2,5 fois plus rapide qu’ONNX Runtime sur les pages denses.
Nous avons chronométré read_words, l’étape qui suit la détection et qui recadre, fait pivoter, reconnaît et ordonne les mots, sur quatre photos de texte dans une scène. Sur les trois photos contenant de 195 à 263 mots, le moteur FP16 était 2,5 à 3 fois plus rapide qu’ONNX Runtime sur CUDA ; sur une photo de 48 mots, il était 1,4 fois plus rapide :
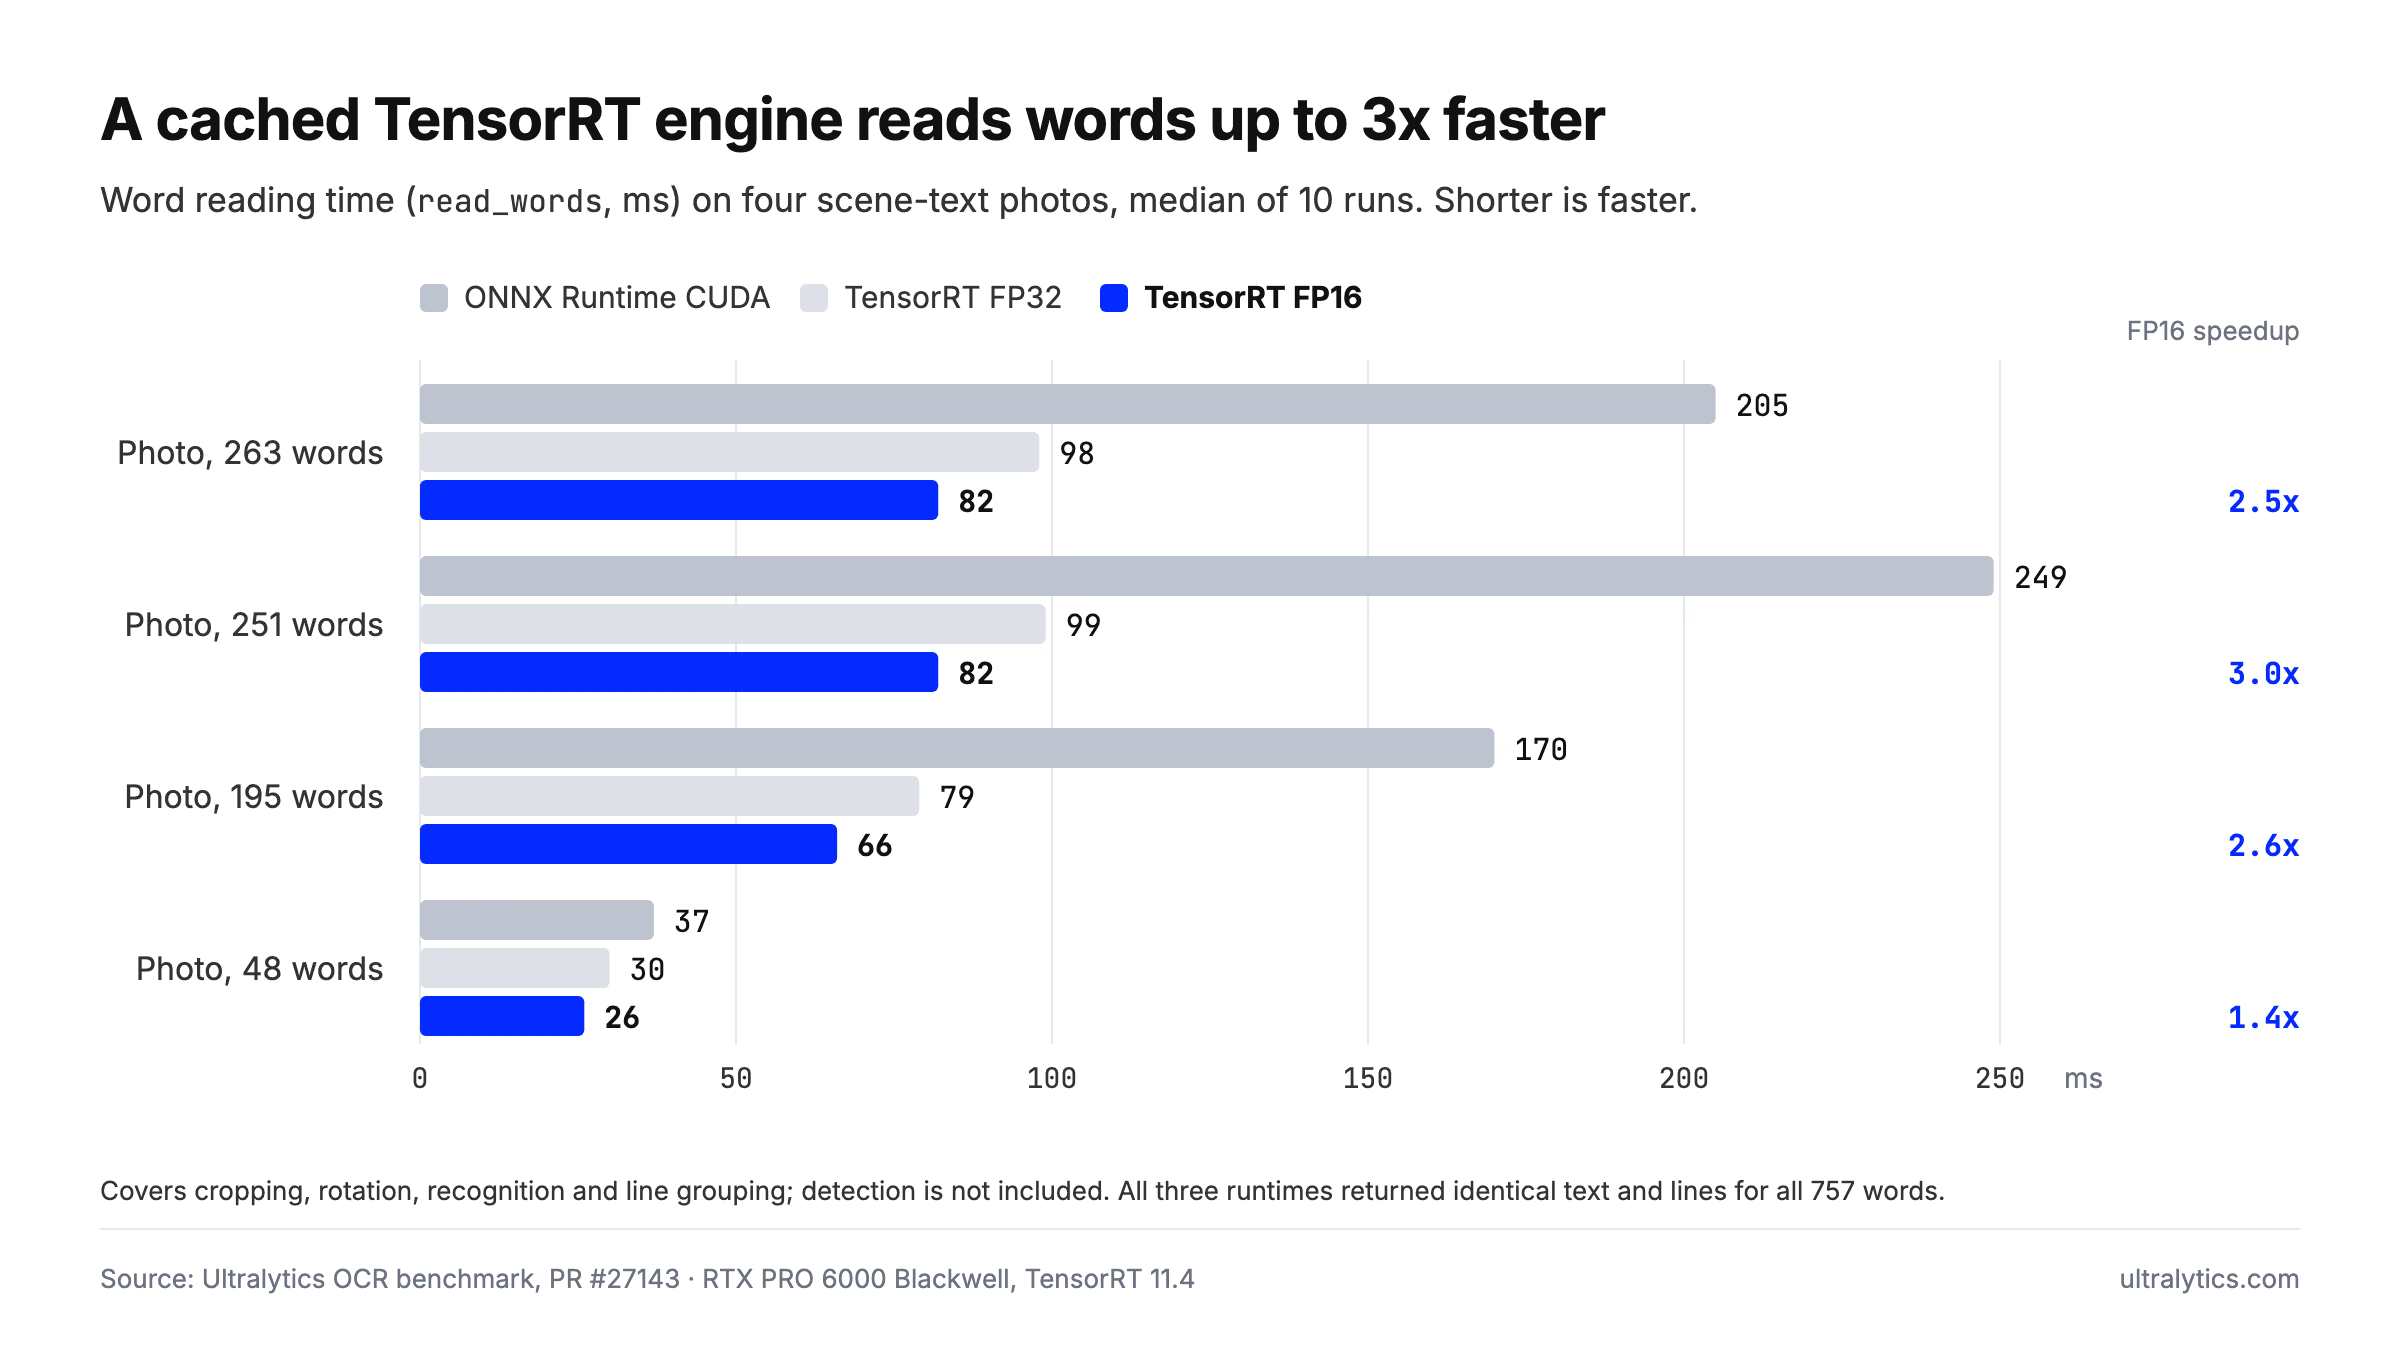
Temps de lecture des mots sur quatre photos de texte dans une scène avec ONNX Runtime CUDA et des moteurs TensorRT FP32 et FP16, médiane de 10 exécutions sur une RTX PRO 6000 Blackwell avec TensorRT 11.4.
L’appel OCR complet sur une page dense est passé de 182 ms à 94 ms. Sur ces quatre photos, le gain de vitesse n’a pas modifié le résultat : pour les 757 mots, ONNX Runtime et les deux moteurs ont renvoyé un texte et un regroupement des lignes identiques.
Garde le recognizer="paddleocr" par défaut si tu ne peux pas attendre la première compilation ou si tu n’utilises pas de matériel NVIDIA. Il ne compile rien et démarre en environ une seconde. Notre comparaison ONNX vs TensorRT présente le même compromis pour les modèles de détection, et le guide d’intégration TensorRT explique la configuration.
Les écritures chinoise, japonaise et latine sont prises en charge actuellement#
PP-OCRv6 ne peut produire que des caractères issus de son jeu intégré de 18,708 caractères. Le détecteur YOLO26-Text ne dépend pas de ce jeu de caractères et trouve toujours les mots dans d’autres écritures, mais un mot dont les caractères n’en font pas partie est renvoyé sous forme de caractères ressemblants. Le mot russe ТЕКСТ, par exemple, est lu « TEKCT », souvent avec un score de confiance élevé.
- Pris en charge : chinois simplifié et traditionnel (environ 15 600 caractères CJK), japonais (hiragana, katakana et kanji) et langues utilisant l’alphabet latin, notamment l’anglais, le français, l’allemand, l’espagnol, le portugais, l’italien, le néerlandais, le suédois, le finnois, le danois, le norvégien, le polonais, le tchèque, le hongrois, le roumain, le turc, le croate, l’indonésien et le malais. Toutes les lettres et lettres accentuées sont prises en charge, sauf le ẞ majuscule allemand et le ¡ espagnol.
- Partiellement pris en charge : le vietnamien, dont la plupart des voyelles avec tons sont absentes, et le grec, dont seules les lettres de base sont prises en charge.
- Pas encore pris en charge : cyrillique, coréen (hangul), arabe, hébreu, devanagari et thaï.
Pour une écriture non prise en charge, garde le détecteur YOLO26-Text et passe un moteur de reconnaissance entraîné pour cette écriture en tant que recognizer. Le tableau complet de couverture se trouve dans la section des langues prises en charge du guide OCR.
Comparaison des bibliothèques OCR Python selon leurs capacités documentées#
Il n’existe pas de modèle OCR universellement meilleur ; le bon choix dépend de tes pages, de tes langues et de l’environnement d’exécution du code. Le tableau compare les capacités documentées, et non les résultats mesurés, d’après les pages publiques de chaque projet consultées le 12 novembre 2026. Les options sont classées par ordre alphabétique.
| Solution | Environnement d’exécution | Texte pivoté | Langues documentées | Sortie |
|---|---|---|---|---|
| EasyOCR | PyTorch | rotation_info essaie 90°, 180° et 270° pour chaque boîte de texte | Plus de 80, dont le cyrillique, l’arabe, le devanagari, le coréen et le thaï | Boîtes, texte et score de confiance |
| PaddleOCR | PaddlePaddle | Classification d’orientation facultative | Plus de 100 (PP-OCRv6 en couvre 50 dans un seul modèle) | Boîtes, texte et score de confiance |
| Tesseract (pytesseract) | Binaire natif, CPU | Détection de l’orientation et de l’écriture (image_to_osd) ; faire pivoter l’image avant la lecture | 100+ | Texte, avec données sur les mots en option |
| Ultralytics YOLO26 OCR | Détecteur PyTorch ; moteur de reconnaissance sur ONNX Runtime, ou TensorRT sur les GPU NVIDIA | Rotation de la page estimée à partir du texte détecté ; choix automatique entre 0° et 180° | Chinois, japonais et écritures latines ; autres écritures avec un moteur de reconnaissance personnalisé | Mots dans l’ordre de lecture, avec numéros de ligne, polygones et scores de confiance séparés pour la détection et la reconnaissance |
Consulte la documentation d’EasyOCR, le dépôt PaddleOCR, la documentation de Tesseract et pytesseract pour connaître leurs options actuelles. Pour comprendre le fonctionnement de ces moteurs, consulte notre aperçu des modèles OCR open source populaires.
Le rôle d’Ultralytics#
Ultralytics YOLO26 OCR est conçu pour les développeurs Python qui veulent extraire du texte de sources variées, comme des formulaires numérisés, des pages PDF, des captures d’écran et des photos d’étiquettes et de panneaux, avec les mots dans l’ordre de lecture et des coordonnées qu’ils peuvent vérifier. Il convient bien aux pages dont l’angle est imprévisible, si tu veux exécuter l’OCR sur tes propres machines ou si tu utilises déjà des modèles Ultralytics YOLO26 et veux intégrer l’OCR au même package. Ajoute recognizer="tensorrt" pour traiter de gros volumes sur des GPU NVIDIA.
Le détecteur est un modèle Ultralytics classique : il s’entraîne, se valide et s’exporte comme n’importe quel autre. Le projet YOLO26-Text sur Ultralytics Platform regroupe les cinq tailles, de n à x ; tu peux y comparer leurs courbes d’entraînement et cloner le projet pour partir de ces modèles.
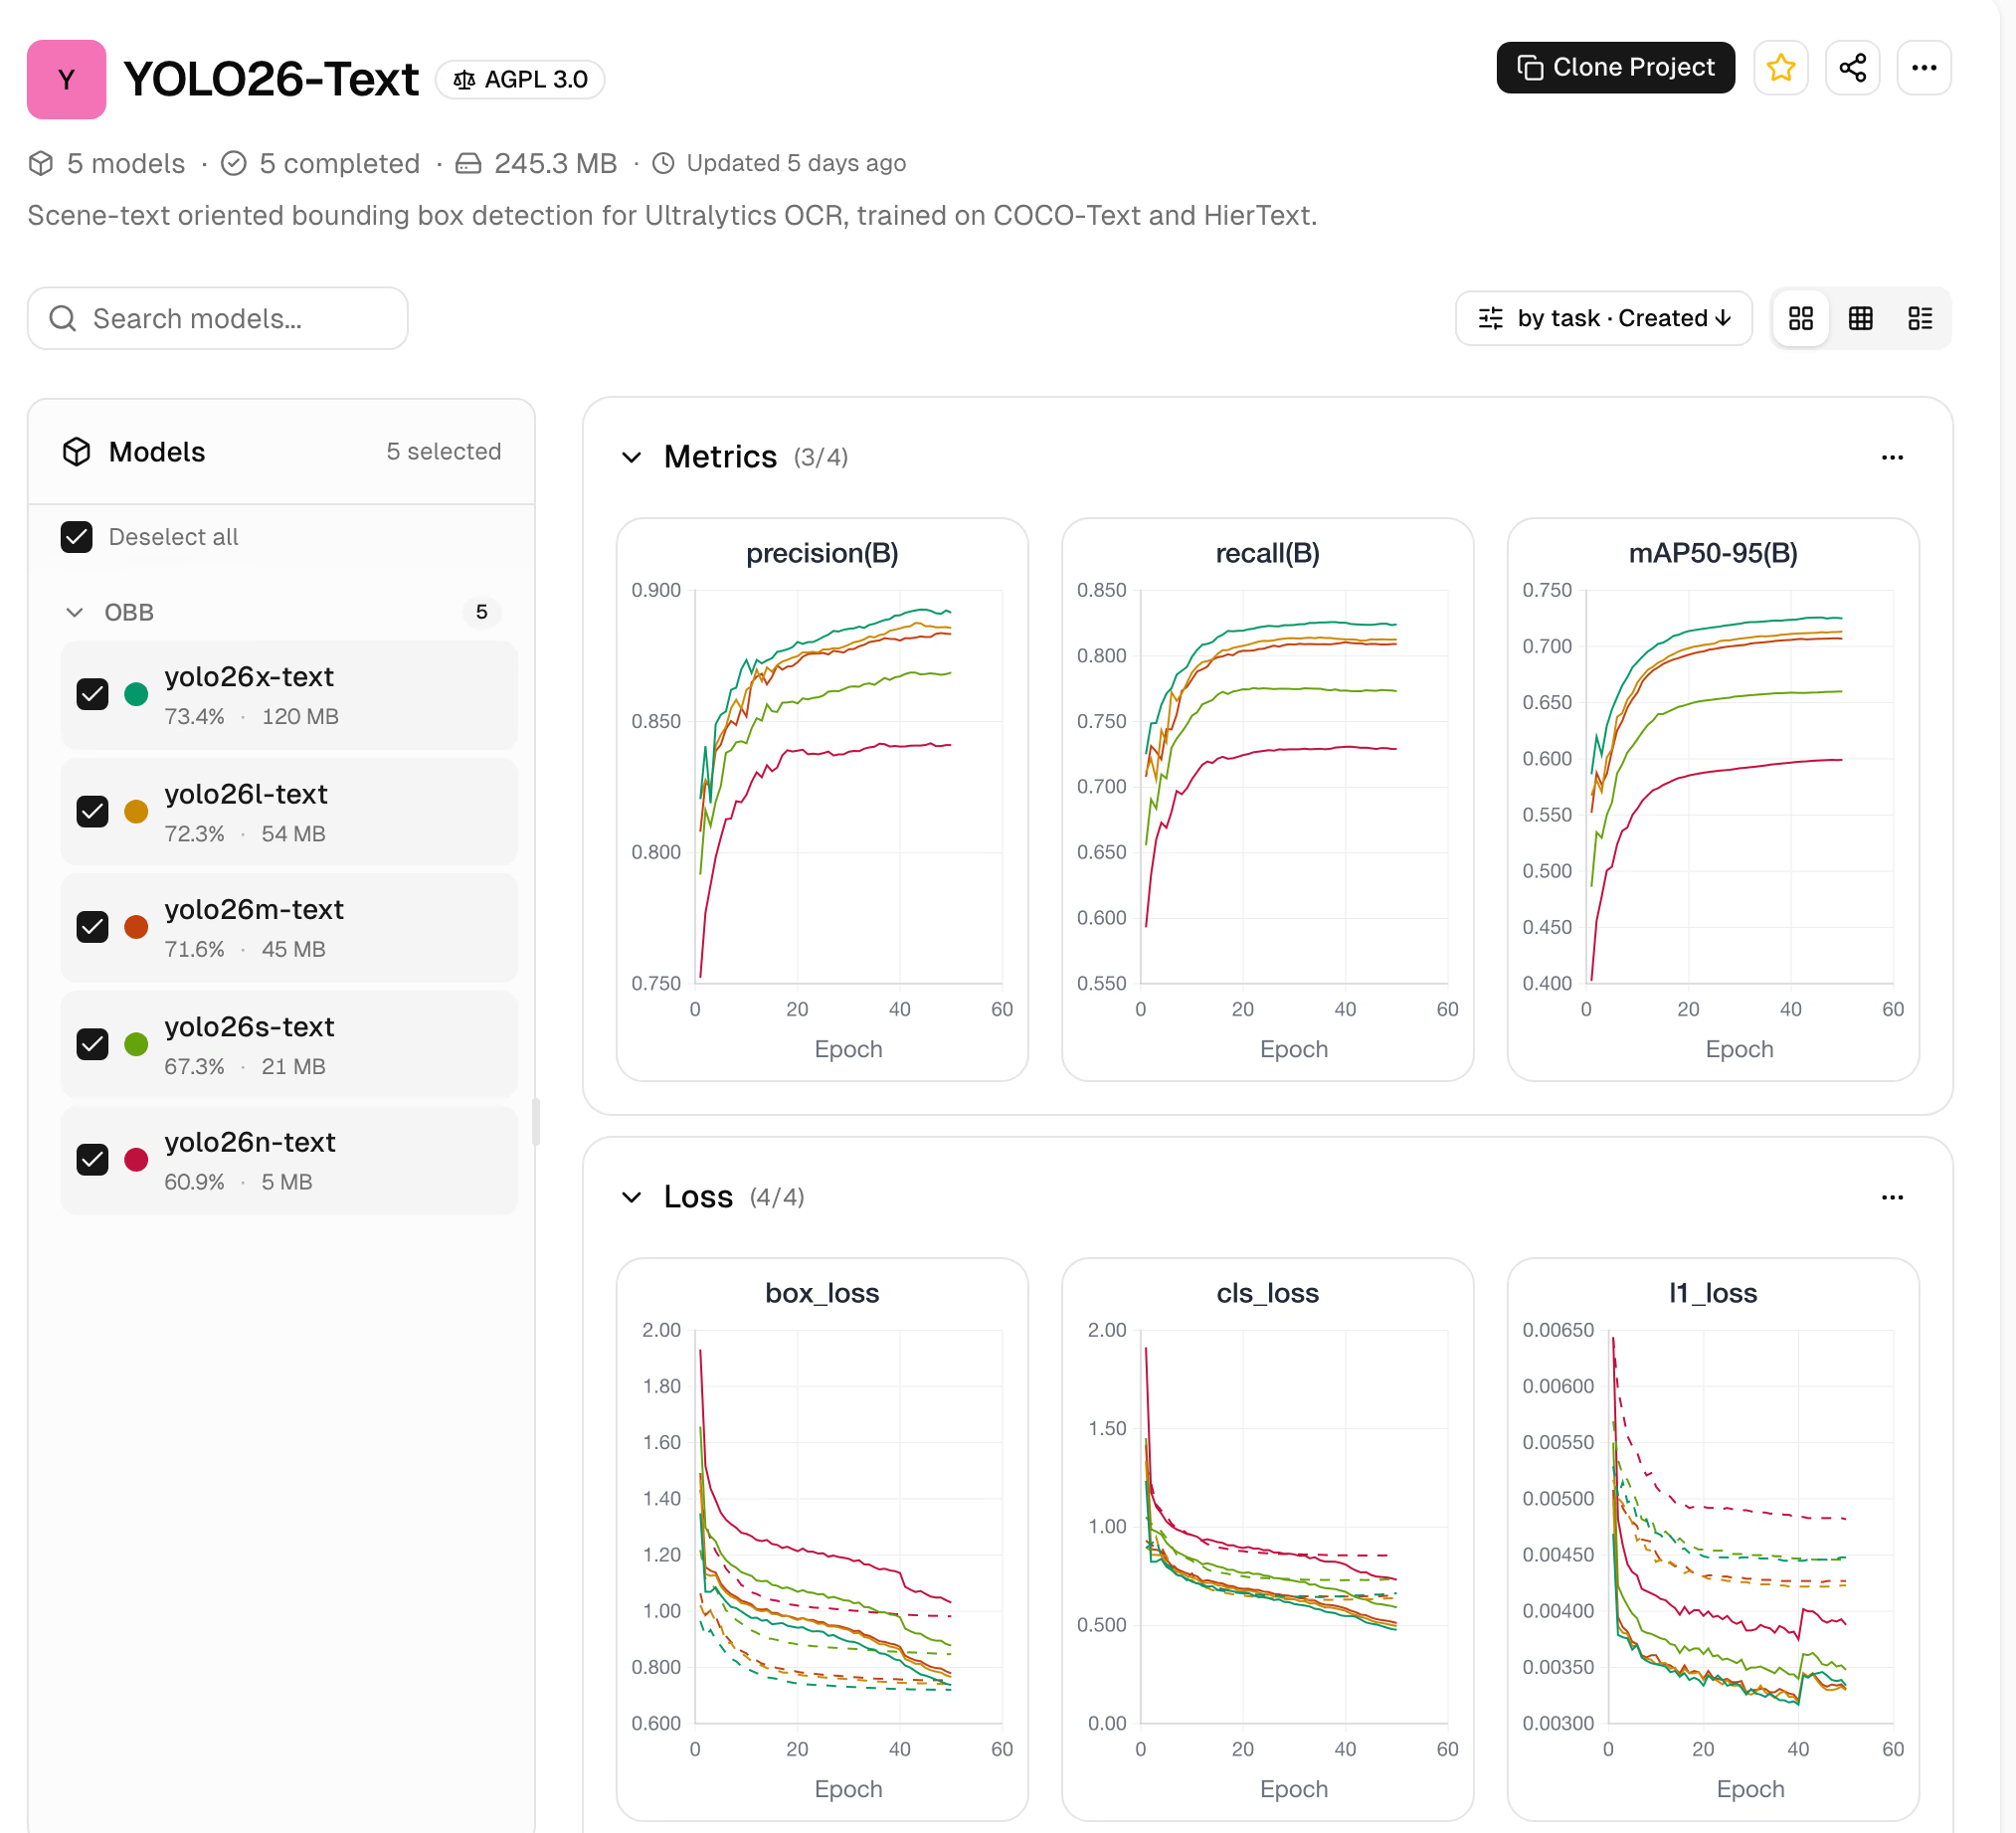
Le projet YOLO26-Text sur Ultralytics Platform : les cinq tailles de détecteur avec leurs courbes de précision, de rappel, de mAP50-95 et de perte pendant l’entraînement.
Pour l’adapter à tes documents, pars du jeu de données Scene Text OBB, qui combine COCO-Text et HierText en 65 325 images contenant environ 1,29 million de polygones de mots.
Ses limites sont précises :
- Écritures. Le moteur de reconnaissance par défaut ne lit pas encore le cyrillique, le coréen, l’arabe, l’hébreu, le devanagari ni le thaï. Associe le détecteur à ton propre moteur de reconnaissance ou choisis un moteur qui les prend en charge.
- Directions mixtes. La solution fait pivoter toute la page en fonction de l’orientation dominante du texte ; un texte orienté dans plusieurs directions sur une même page, comme une note verticale dans la marge, risque donc d’être moins bien lu.
- Exportation. Le moteur de reconnaissance n’est pas intégré au fichier du détecteur exporté ; déploie donc le détecteur et l’environnement d’exécution de reconnaissance côte à côte, ou garde la solution Python comme couche de liaison.
- Rust. Ultralytics Inference lit le texte dans une scène en Rust avec le même moteur de reconnaissance PP-OCRv6 via
ultralytics-inference predict --ocr, mais gère l’orientation avec un classifieur plutôt qu’avec l’étape de rotation de page de la solution Python. - Confidentialité. La solution Python s’exécute sur ton propre matériel ; les pages n’ont donc pas à quitter tes machines. La démo dans le navigateur téléverse les pages pour l’inférence. Pour les champs qui ne doivent pas être lus, masque les zones connues avec un masque opaque avant l’exécution de l’OCR.
Pour les formulaires et les contrats, un modèle YOLO personnalisé peut d’abord trouver les champs, les tableaux, les signatures et les tampons, afin que tu ne lises que les zones nécessaires. Le jeu de données Signature sur Ultralytics Platform et notre guide sur l’analyse intelligente de documents sont de bons points de départ, et Ultralytics Platform te permet d’annoter des pages et d’entraîner ce modèle au même endroit. Pour essayer d’abord l’OCR sur ta propre page, dépose une image ou un PDF dans la démo OCR en direct.
Foire aux questions
Installe le package Ultralytics avec
pip install -U "ultralytics>=8.4.211", puis appellesolutions.OCR()sur une image chargée avec OpenCV. La fonction renvoie les mots reconnus avec leur texte, leur score de confiance, leur numéro de ligne et leur polygone, dans l’ordre de lecture. Au premier lancement, le détecteur YOLO26-Text et le moteur de reconnaissance PP-OCRv6 sont téléchargés automatiquement.Tout dépend de tes documents, de tes langues et de ton matériel ; notre aperçu des modèles OCR open source populaires compare les principales options. Dans notre benchmark avec une taille d’image de 1280 sur une RTX PRO 6000, YOLO26x-Text avec PP-OCRv6 a obtenu un F1 au niveau des mots de 0.931 sur six pages PDF et de 0.722 sur 80 photos HierText, et il lit les pages quelle que soit leur rotation. Pour les écritures qu’il ne prend pas encore en charge, comme le cyrillique ou le coréen, utilise un moteur de reconnaissance entraîné pour cette écriture.
Un modèle YOLO détecte le texte, mais ne le lit pas. Ultralytics YOLO26-Text détecte le texte sous forme de boîtes orientées, et la solution OCR transmet chaque recadrage au moteur de reconnaissance PP-OCRv6 ; ensemble, ils réalisent donc une OCR complète en un seul appel.
Oui. Convertis chaque page du PDF en image, par exemple avec
get_pixmapde PyMuPDF, convertis-la en BGR et transmets-la àsolutions.OCR(). Dans le navigateur, la démo et l’onglet Platform Predict acceptent un PDF et lisent sa première page.Oui. PP-OCRv6 fonctionne avec ONNX Runtime sur CPU ou sur des GPU CUDA, et le même script fonctionne sur les deux. Le reconnaisseur TensorRT facultatif nécessite un GPU NVIDIA.
Pas encore avec le reconnaisseur par défaut. PP-OCRv6 prend en charge le chinois, le japonais et les langues utilisant l’alphabet latin, mais pas le cyrillique, le hangul, l’arabe, l’hébreu, le devanagari ou le thaï. Tu peux conserver le détecteur YOLO26-Text et lui transmettre un reconnaisseur entraîné pour le système d’écriture concerné.
Écrit par
Ingénieur senior en apprentissage automatique · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









