Auto-annotazione con Gemini 4 Carbon: il nuovo leader nella nostra classifica VLM
Gemini 4 Carbon supera 45 VLM nel nostro benchmark di rilevamento di oggetti su 36 dataset: 0.584 mAP50 e i migliori valori di precisione e richiamo. Quando GPT-6.1 Terra offre un rapporto qualità-prezzo migliore.
 Glenn Jocher14 min di lettura
Gemini 4 Carbon è al primo posto tra 45 modelli per l'auto-annotazione su UL37, il nostro benchmark di rilevamento di oggetti su 36 dataset, nella rilevazione dell'11 novembre 2026 della classifica VLM di Ultralytics. Ottiene 0.584 mAP50 e 0.371 mAP50-95 e ora è in testa sia alla colonna della precisione sia a quella del richiamo, che nei nostri risultati di ottobre erano occupate da due modelli diversi. GPT-6.1 Terra, il precedente leader, è al secondo posto con 0.560 mAP50 e un costo per immagine presso il fornitore pari a circa un terzo di quello di Carbon.
Quindi, per chiunque debba etichettare un dataset, la domanda non è quale modello ottiene il punteggio complessivo più alto, ma quando Carbon vale tre volte il prezzo. Di seguito vediamo dove Carbon ha stabilito nuovi punteggi record, dove Terra continua a prevalere, quanto costa ciascun modello prima e dopo la variazione dei prezzi di Google a dicembre e come usare Carbon sui tuoi dati con Ultralytics Platform.
Gemini 4 Carbon è ora disponibile per tutti gli sviluppatori paganti#
Google ha rilasciato Carbon per la prima volta a fine ottobre a un piccolo gruppo di esperti di sicurezza informatica. Il 10 novembre 2026 ha aperto il modello a tutti gli sviluppatori e alle aziende paganti e ha iniziato a distribuirlo agli abbonati a Google AI Ultra. Il post sulla disponibilità di Google dice che Carbon è disponibile tramite API in Google AI Studio e Gemini per le aziende, nonché nell'app Gemini, in AI Mode e in Antigravity per gli abbonati Ultra. Gli esperti di sicurezza mantengono l'accesso specializzato tramite il programma Fairwind di Google.
Google definisce Carbon il suo modello più potente, pensato per la sicurezza informatica e le attività agentiche a lungo orizzonte. La scheda del modello Gemini 4 Carbon dice che è basato su Gemini 4 Argon e usa più token di ragionamento di Argon «per esplorare a fondo le ipotesi, ragionare in profondità ed eseguire cicli di verifica prolungati». Elabora testo, immagini, audio e video, con una finestra di contesto fino a 1M di token, e risponde in testo.
Nessuna delle comunicazioni di lancio di Google presenta Carbon come un modello di rilevamento. Per l'etichettatura dei dati, ciò che conta è l'effetto di questo ragionamento aggiuntivo sui riquadri di delimitazione, ed è proprio questo che misura UL37. Puoi esaminare ogni risultato nella pagina del modello Gemini 4 Carbon.
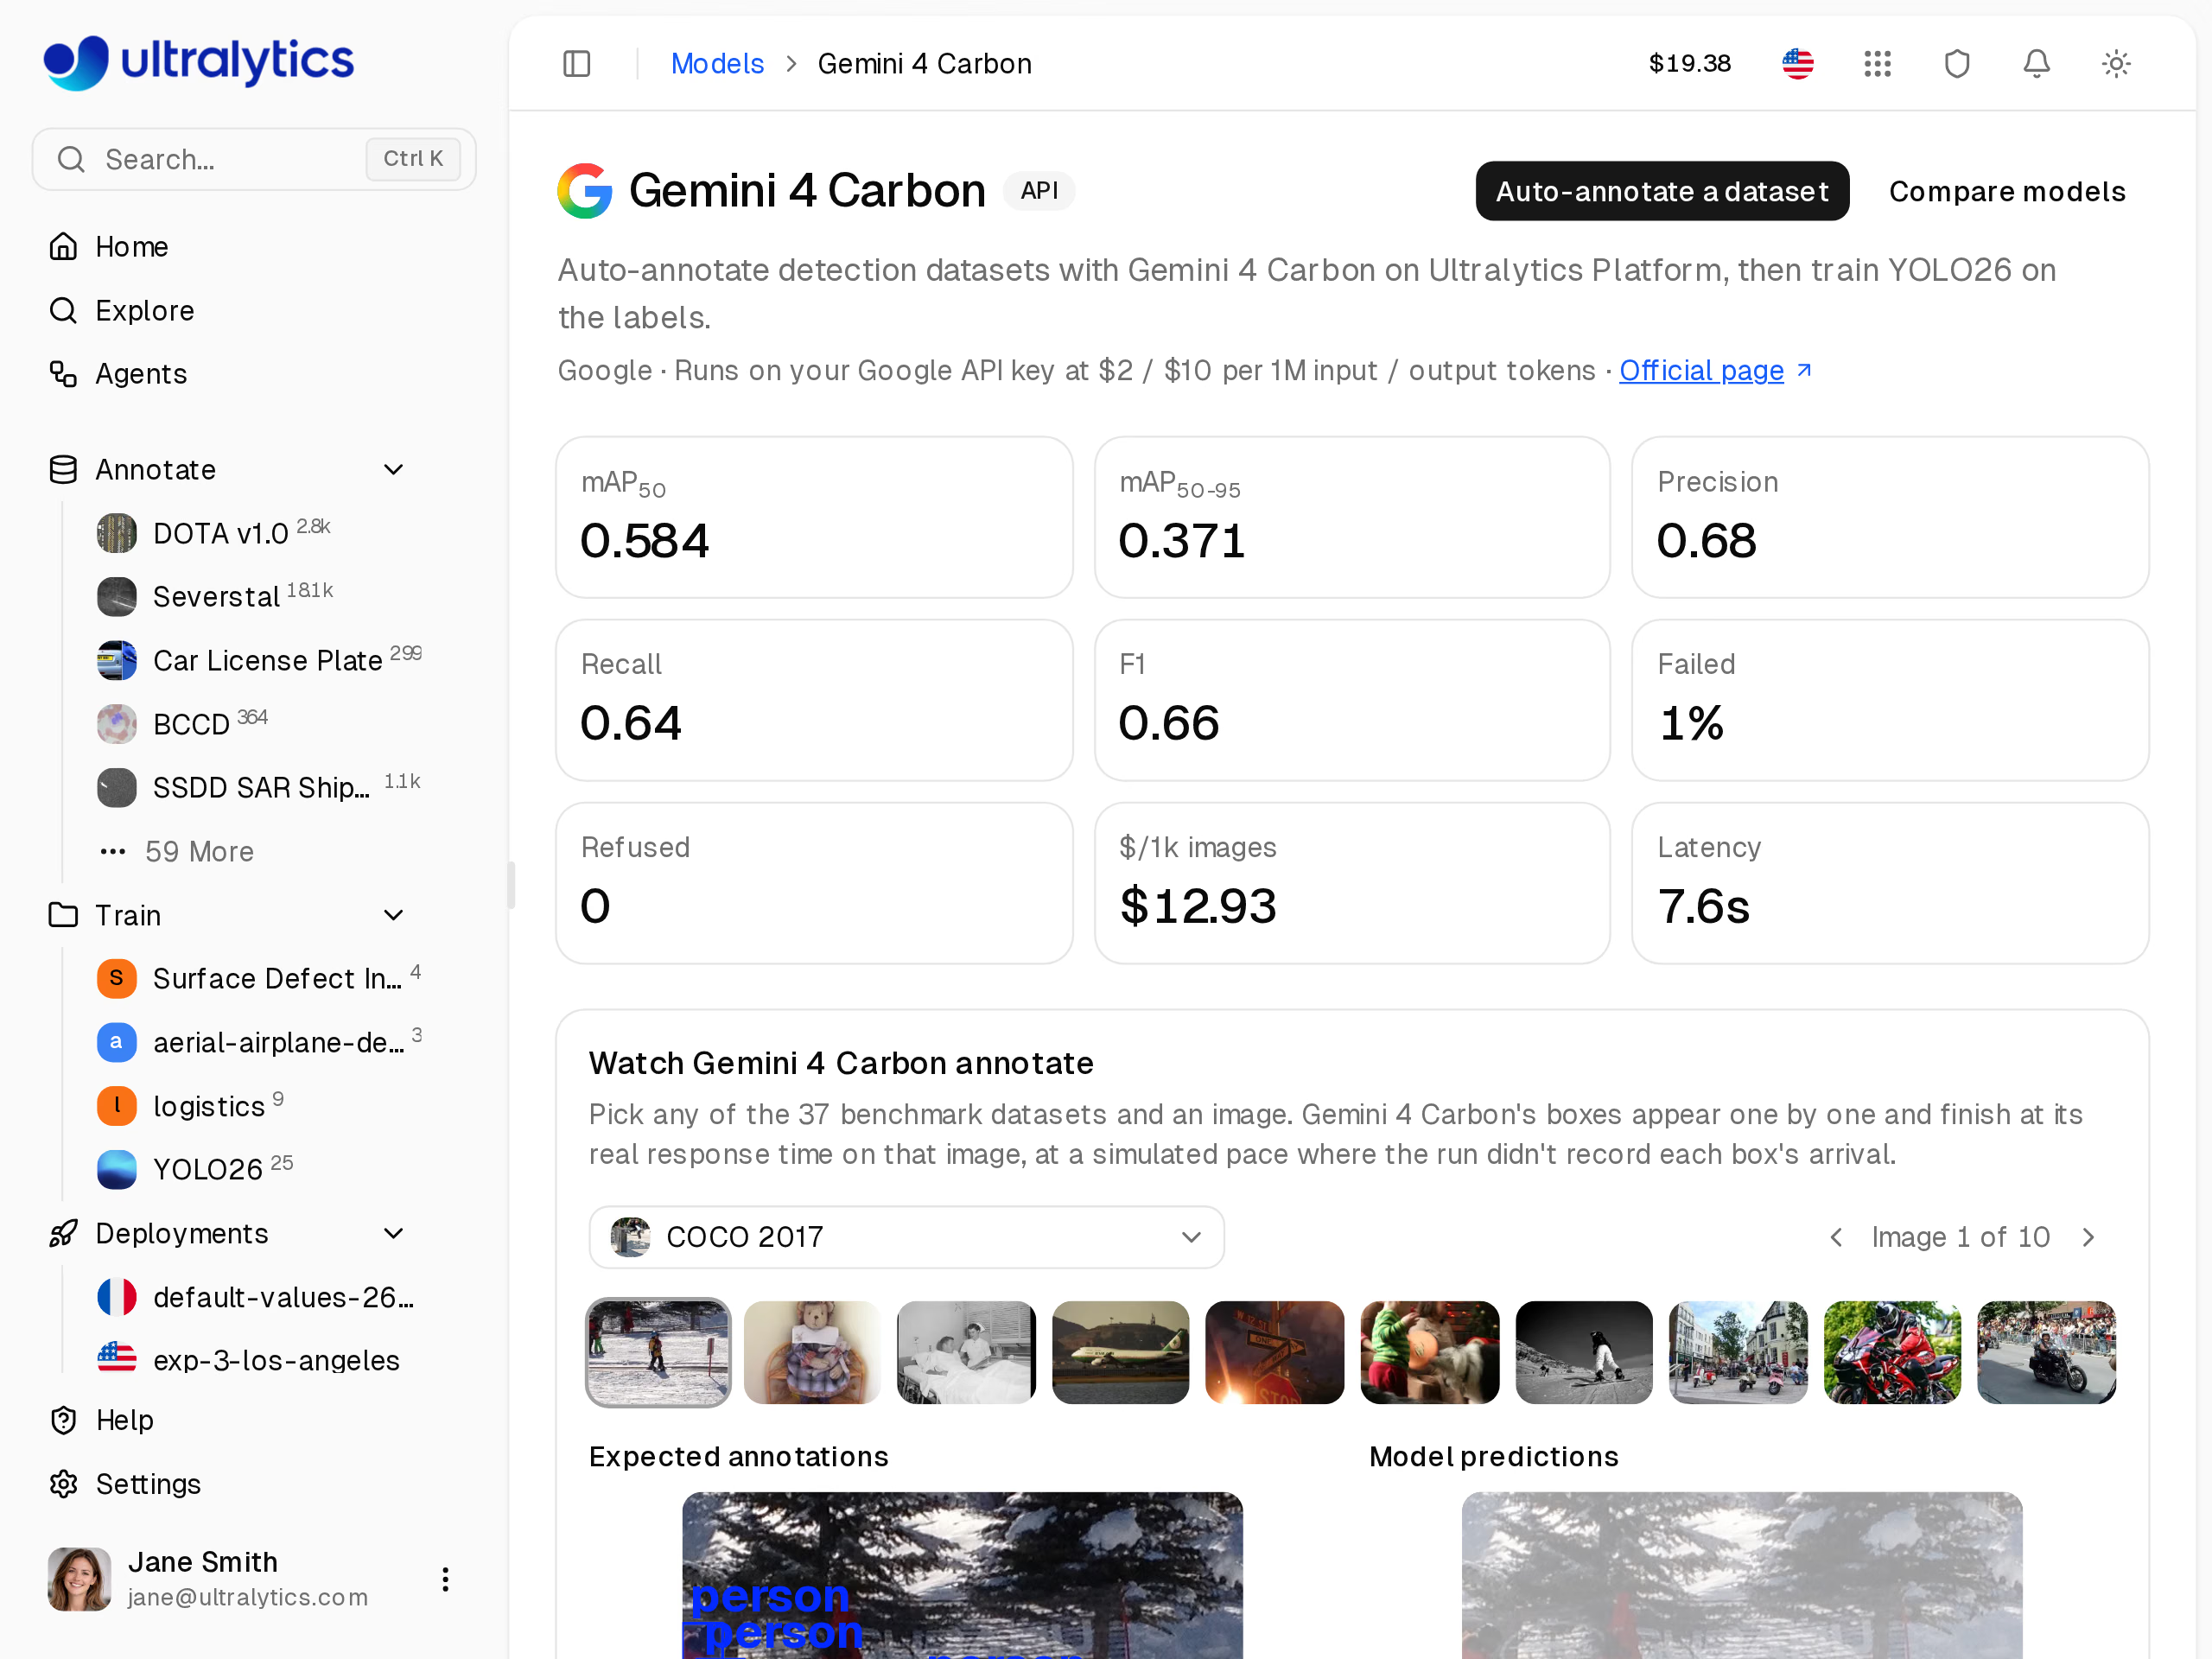
La pagina del modello Gemini 4 Carbon su Ultralytics Platform, con i punteggi UL37 e un link per auto-annotare un dataset.
Rilevamento di oggetti con Gemini 4 Carbon: primo posto in tutte le metriche di accuratezza#
UL37 misura quanto i riquadri di un modello corrispondono alle etichette di riferimento di ciascun dataset su 360 immagini: 10 per ciascuno dei 36 dataset reali di rilevamento di oggetti, che coprono scansioni mediche, immagini aeree e termiche, scaffali di negozi, sport, documenti, circuiti stampati e altro. Ogni immagine passa attraverso la stessa pipeline di produzione disponibile per gli utenti di Platform, con i nomi delle classi del dataset; SAM 3.1 perfeziona i riquadri di tutti i modelli tranne quelli di SAM 3, proprio come avviene per gli utenti. Tutti i dataset hanno lo stesso peso; consulta la metodologia del benchmark UL37.
Ecco come si posiziona Carbon rispetto ai quattro modelli successivi:
Carbon supera GPT-6.1 Terra di 0.024 in mAP50. La metrica più rigorosa mAP50-95, che premia i riquadri aderenti ai bordi degli oggetti, mostra un divario simile: 0.371 per Carbon contro 0.347 per Claude Fable 5.2, il precedente migliore, e 0.345 per Terra.
Carbon migliora anche il modello da cui è stato sviluppato. Gemini 4 Argon ottiene 0.537 mAP50 e 0.343 mAP50-95, quindi Carbon guadagna rispettivamente 0.047 e 0.028 sullo stesso benchmark e sulla stessa pipeline di annotazione.
Gemini 4 Carbon ottiene la precisione e il richiamo più alti su UL37#
Nei nostri risultati di ottobre, i modelli in testa alla classifica si dividevano in due gruppi, come spiega la nostra guida alla scelta di un VLM in base a precisione e richiamo. Gemini 4 Argon aveva la precisione più alta, 0.667: un'alta percentuale dei suoi riquadri corrispondeva agli oggetti, ma alcuni oggetti etichettati non venivano rilevati. GPT-6 Astra aveva il richiamo più alto, 0.627: rilevava più oggetti etichettati, ma una percentuale inferiore dei suoi riquadri era corretta.
Nella rilevazione dell'11 novembre 2026 della classifica, Carbon registra una precisione di 0.685 e un richiamo di 0.642, le medie più alte tra tutti i 45 modelli, superando la precisione di Argon e il richiamo di Astra.
Per chi revisiona le annotazioni, questa è la combinazione migliore che il benchmark possa mostrare. Una precisione più alta significa che una quota maggiore dei riquadri proposti è corretta; un richiamo più alto significa che una quota maggiore degli oggetti reali ha già un riquadro. Una precisione bassa lascia riquadri da eliminare, mentre un richiamo basso lascia oggetti da disegnare: le prime proposte di Carbon richiedono quindi meno correzioni di entrambi i tipi.
SKU110K mostra perché questo è importante nelle immagini affollate. Gli scaffali dei supermercati del dataset contengono 1,666 prodotti etichettati nelle 10 immagini del benchmark, tutti appartenenti a un'unica classe. Carbon ottiene 0.671 mAP50, il punteggio migliore di qualsiasi modello, superando il precedente record di Terra, 0.619. Su uno scaffale del genere, chi revisiona le annotazioni deve individuare ogni riquadro fuori posto tra decine di riquadri corretti.
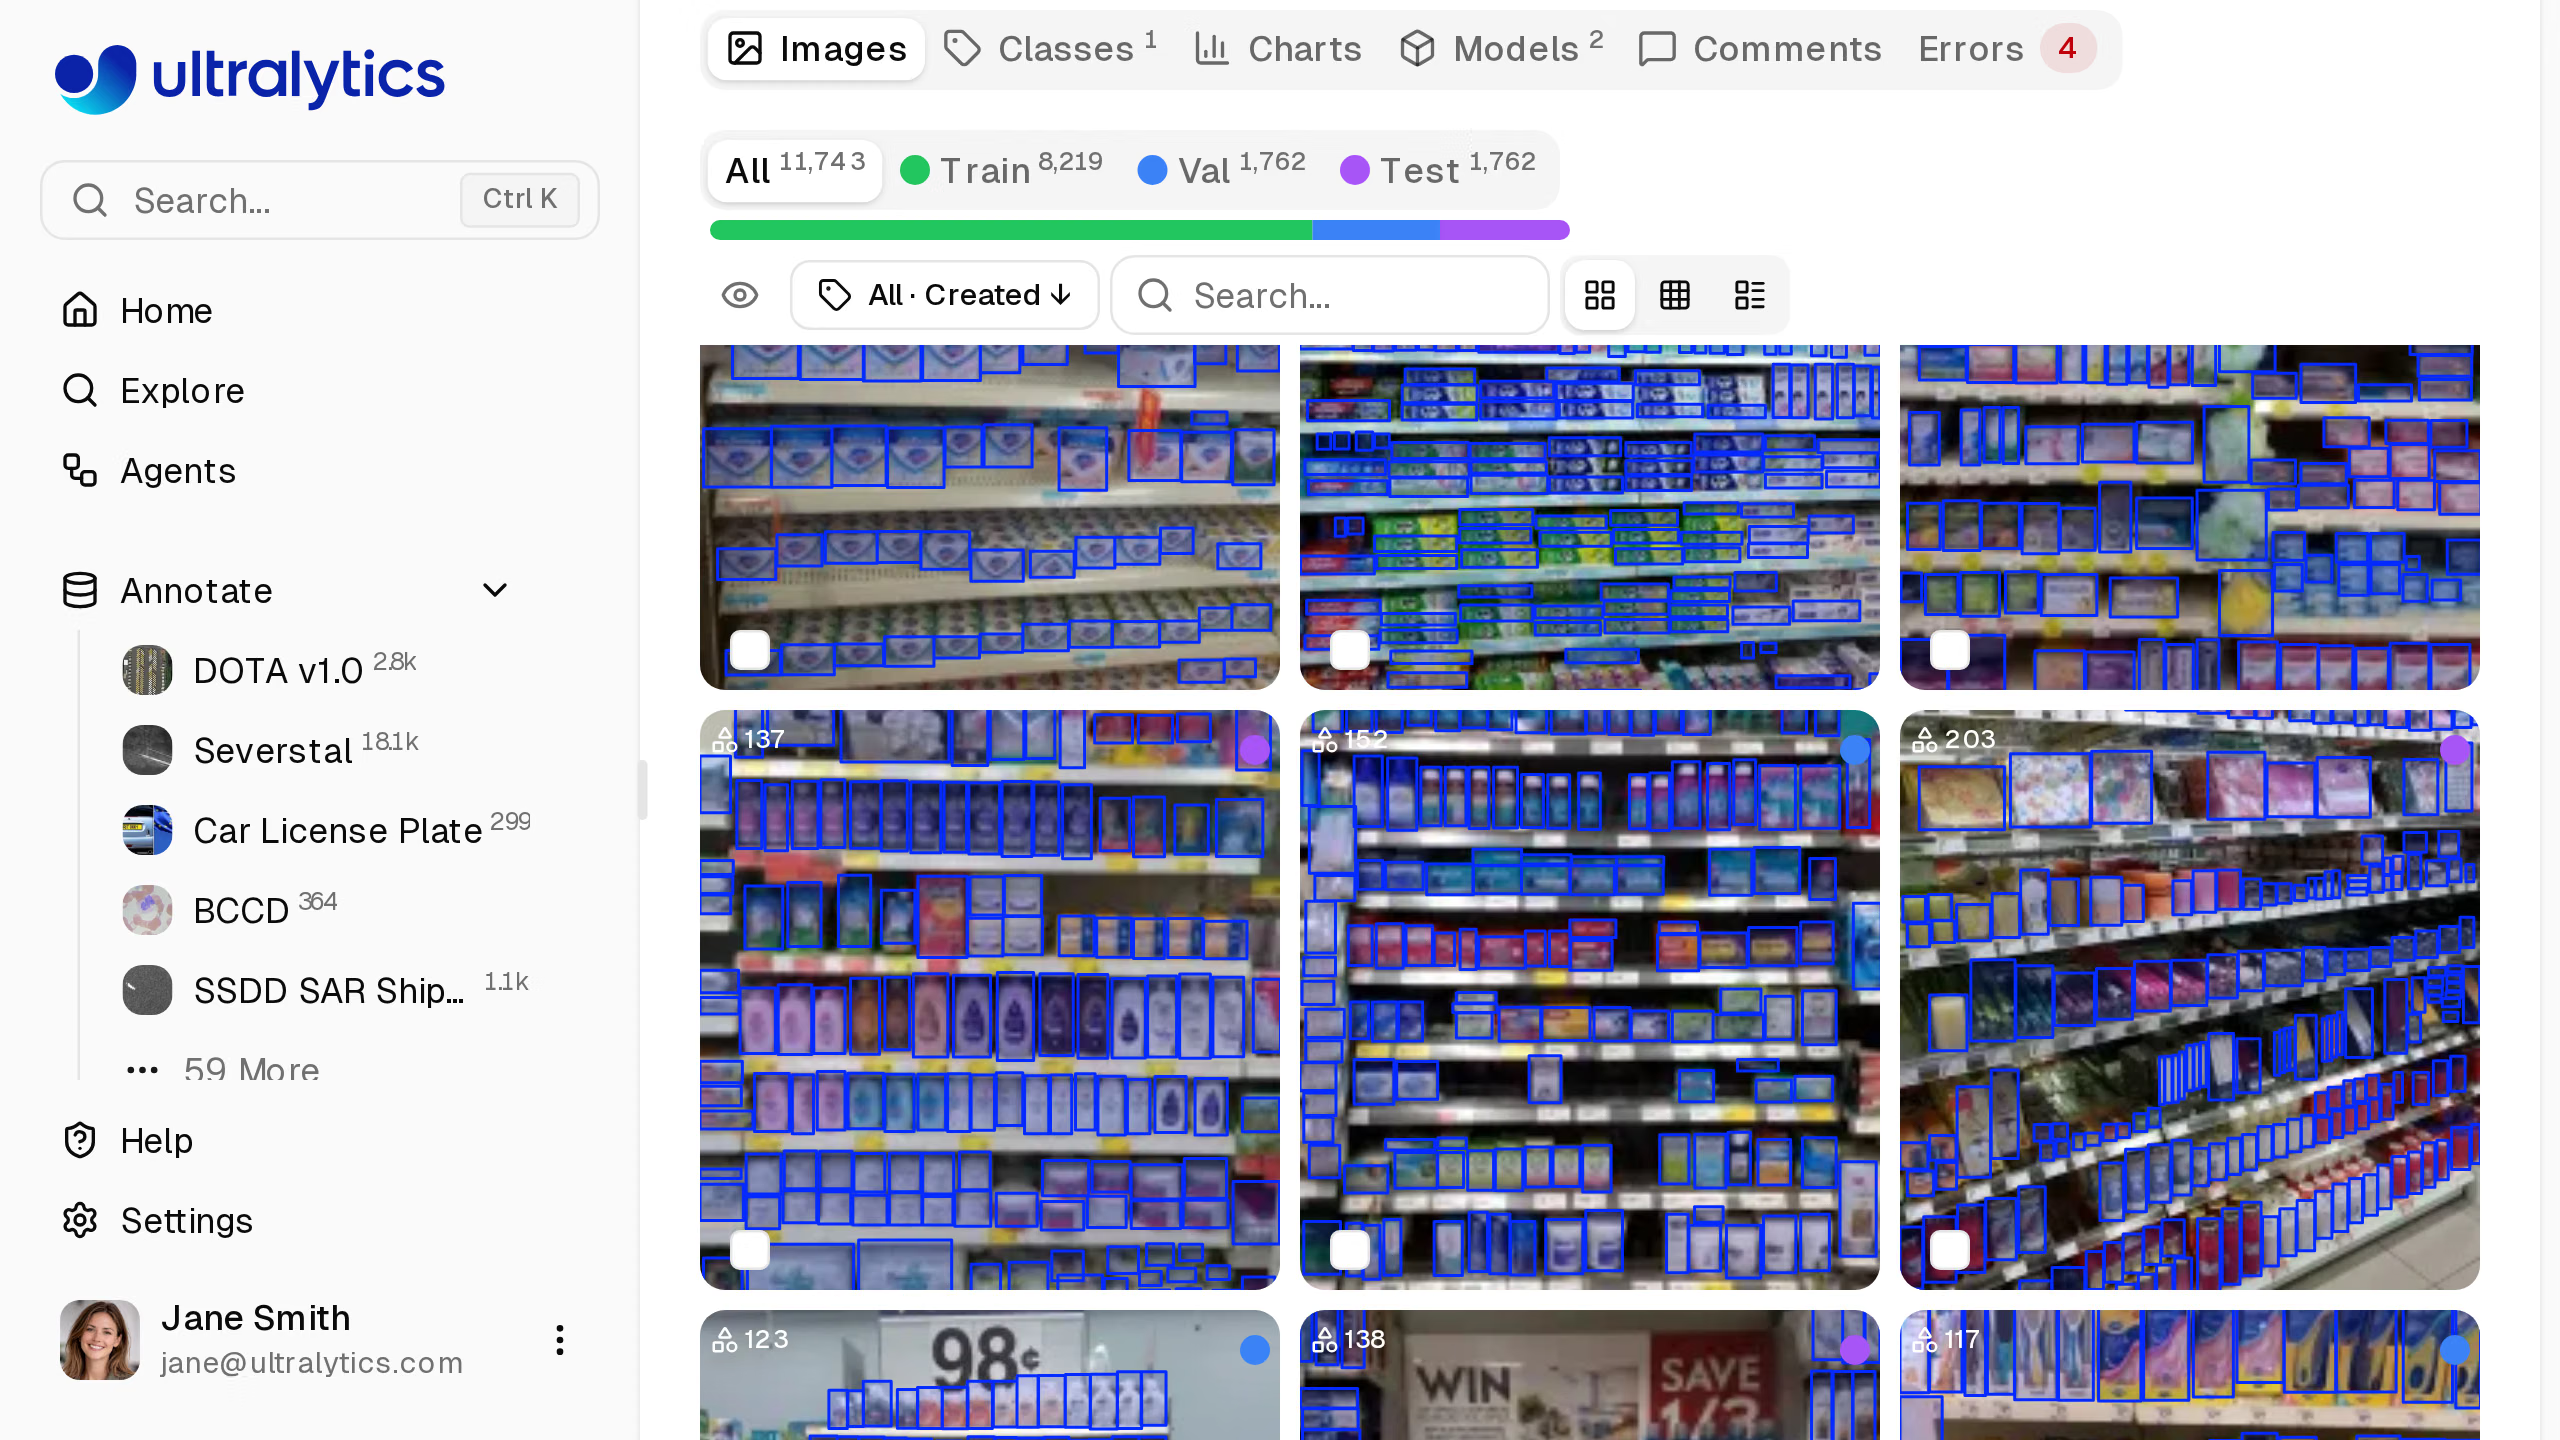
Il dataset SKU110K Dense Retail Shelf Detection 2 su Ultralytics Platform, dove Carbon ottiene il miglior punteggio UL37, 0.671 mAP50.
Gemini 4 Carbon ottiene i punteggi più alti in nove domini#
Secondo i risultati per dataset nelle pagine dei modelli su Platform, Carbon detiene ora il punteggio migliore tra tutti i modelli in un lungo elenco di dataset UL37. Eccoli a confronto con il precedente punteggio migliore:
| Dataset | Dominio | mAP50 di Gemini 4 Carbon | mAP50 del precedente migliore |
|---|---|---|---|
| Infrarosso LLVIP | Termico / scarsa illuminazione | 0.955 | Gemini 4 Argon, 0.915 |
| Risonanza magnetica del tumore cerebrale Cheng | Medicina | 0.942 | GPT-6.1 Terra, 0.904 |
| RPC Retail Checkout | Vendita al dettaglio | 0.935 | GPT-6 Astra, 0.935 (ex aequo) |
| Segnaletica stradale CeyMo | Strade / traffico | 0.905 | Gemini 4 Argon, 0.905 (ex aequo) |
| Pallacanestro e canestro | Sport | 0.882 | Claude Fable 5.2, 0.849 |
| FloorPlanCAD 2 | Documenti / interfaccia utente / CAD | 0.821 | GPT-6 Astra, 0.726 |
| RUOD subacqueo | Subacqueo | 0.788 | Gemini 4 Argon, 0.757 |
| Drone termico HIT-UAV | Aereo / telerilevamento | 0.689 | Gemini 4 Argon, 0.582 |
| Scaffali SKU110K | Vendita al dettaglio | 0.671 | GPT-6.1 Terra, 0.619 |
| PlantDoc | Natura / agricoltura | 0.594 | Claude Fable 5.2, 0.521 |
| Deposito di petrolio Airbus | Aereo / telerilevamento | 0.381 | Gemini 4 Argon, 0.347 |
| Lesioni retiniche DDR | Medicina | 0.133 | Claude Opus 5.5, 0.132 |
Emergono tre tendenze. Carbon mantiene i punti di forza di Argon nelle immagini termiche, aeree e subacquee e li migliora ulteriormente, con il salto più ampio nei filmati termici dei droni di HIT-UAV. Supera GPT-6 Astra nelle planimetrie di quasi 0.1. E nella risonanza magnetica dei tumori cerebrali, dove le classi sono meningioma, glioma e tumore ipofisario, supera Terra di poco.
Ogni dataset contribuisce con 10 immagini, quindi un singolo punteggio è un'indicazione da approfondire, non una sentenza. Carbon eguaglia il record esistente su RPC e CeyMo e supera il risultato precedente di 0.001 su DDR: differenze troppo piccole per distinguere i modelli.
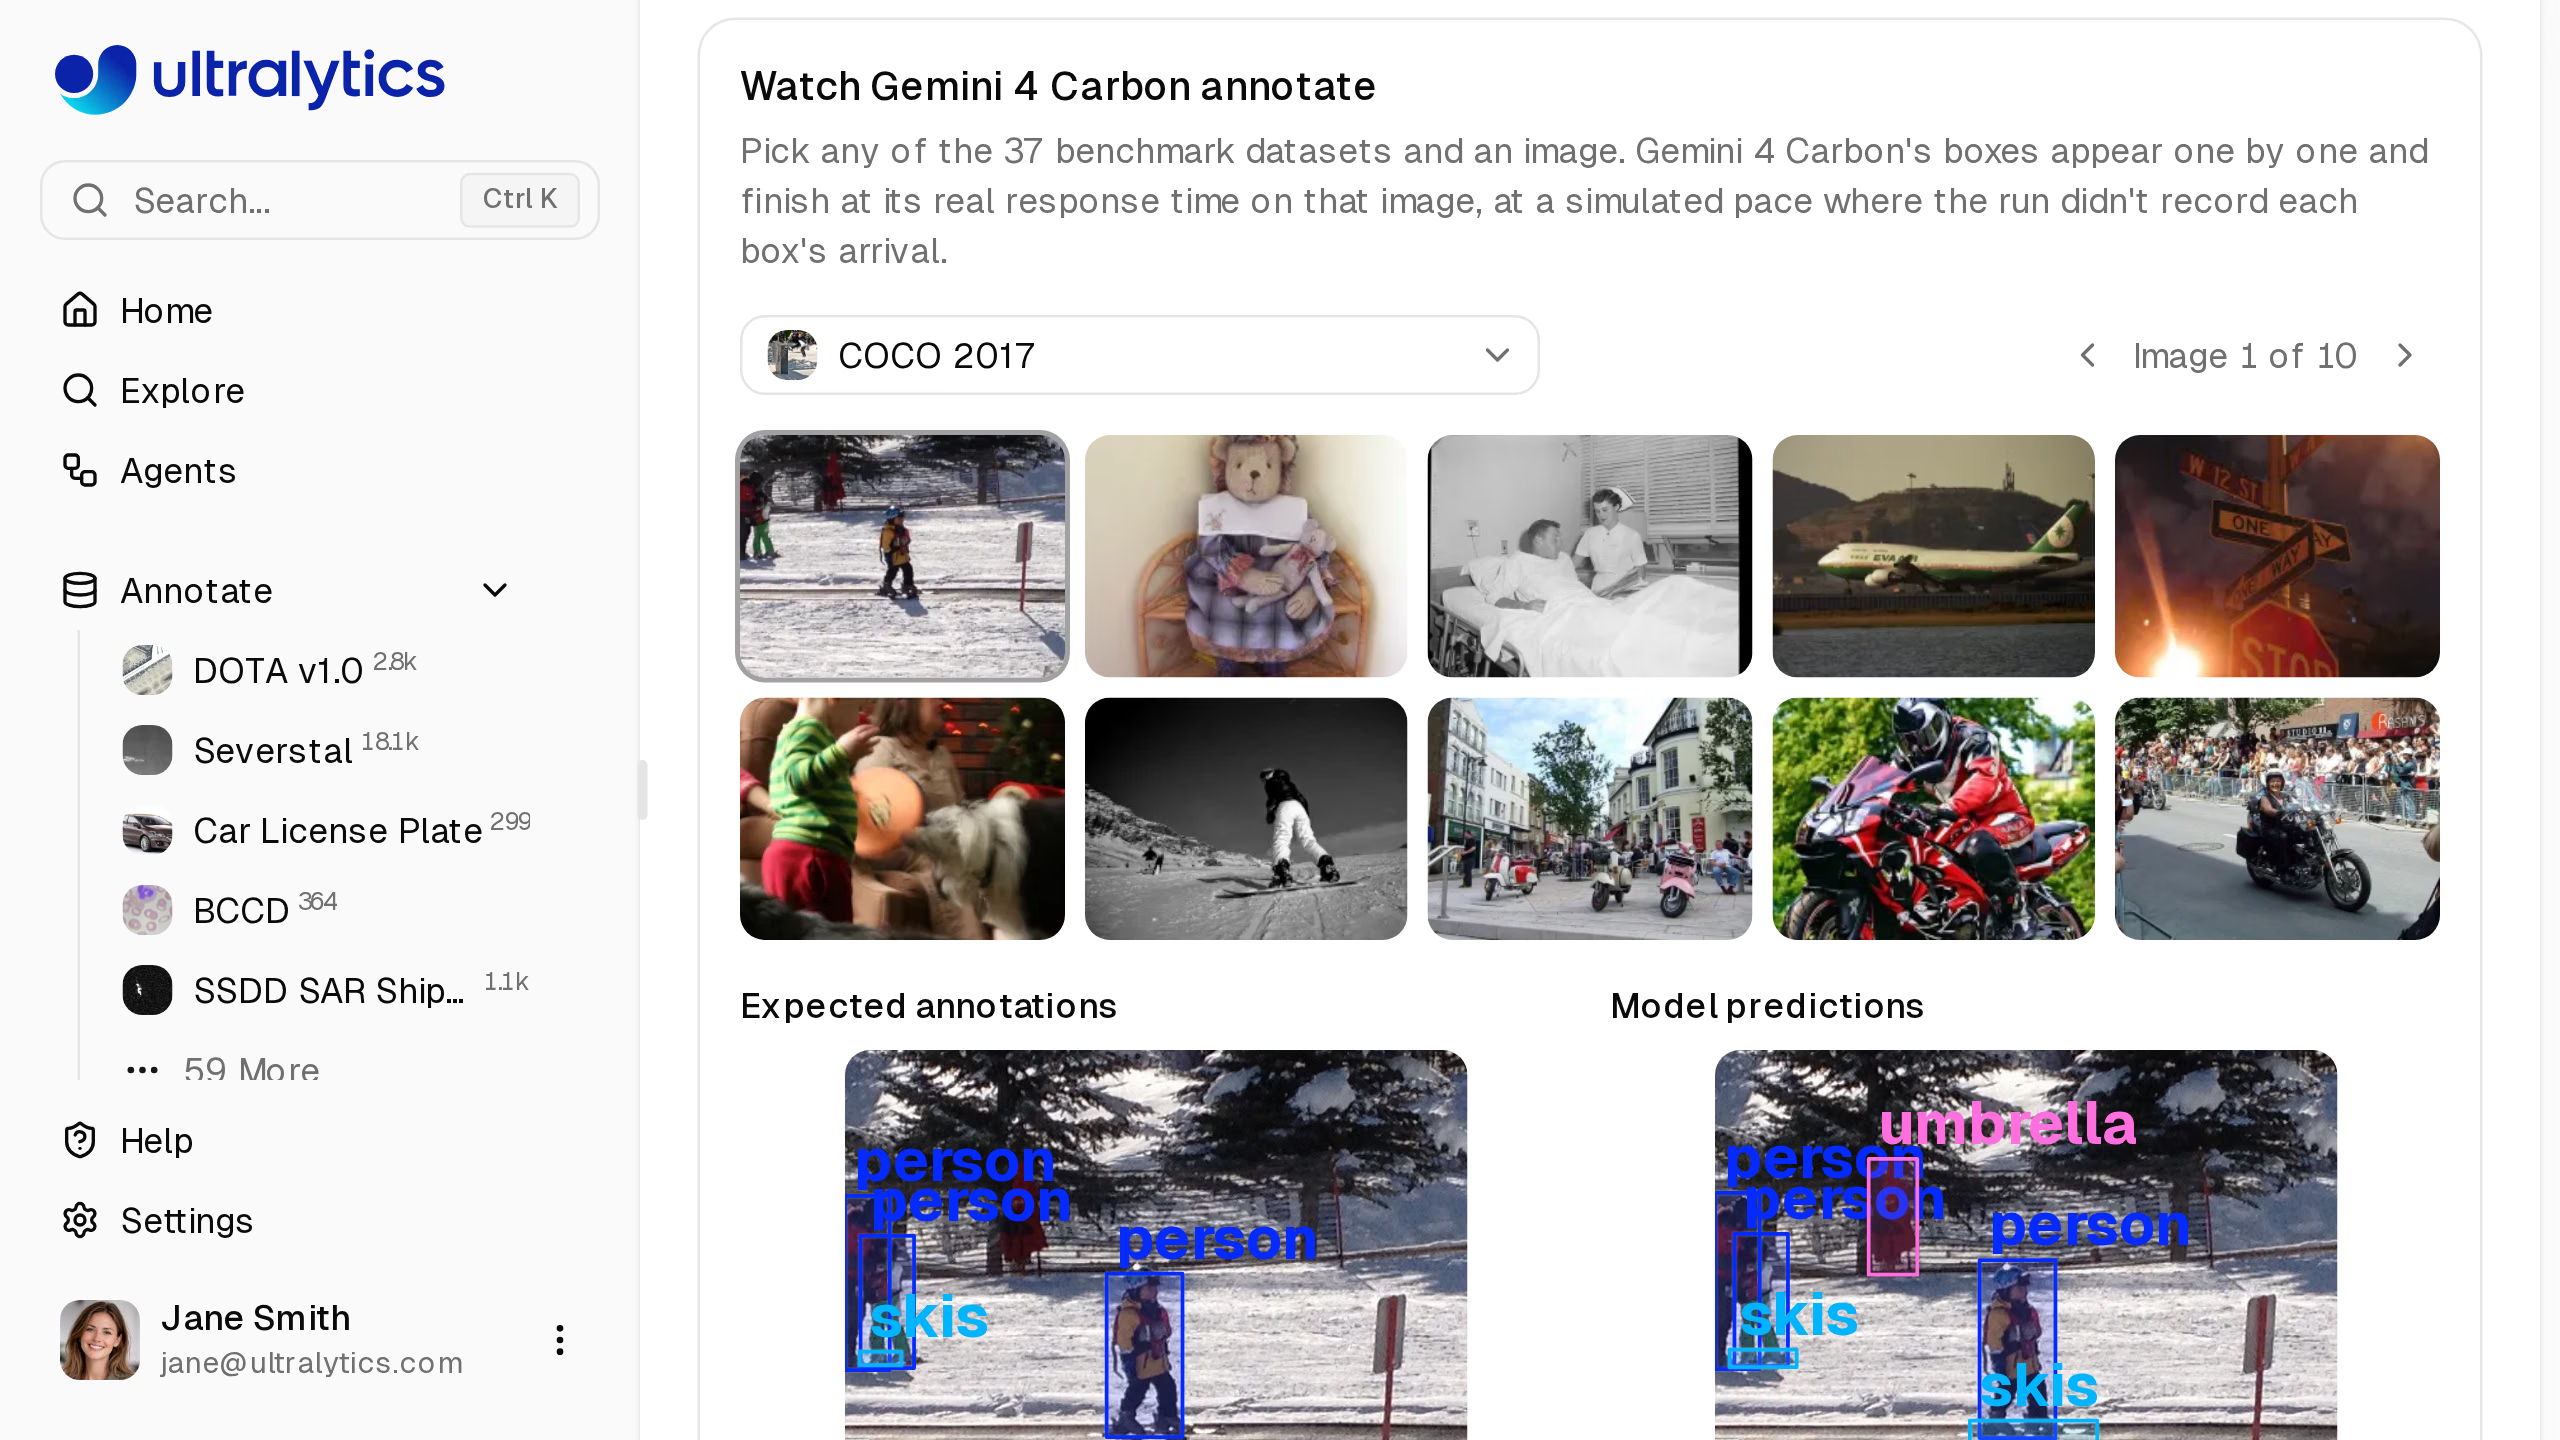
La pagina del modello riproduce i riquadri UL37 registrati da Carbon accanto alle annotazioni attese per ogni dataset del benchmark e per COCO.
Gemini 4 Carbon vs GPT-6.1 Terra: dove Terra continua a prevalere#
Terra conserva due punteggi migliori in ambito medico. La tabella dei dataset della classifica lo indica ancora come il miglior modello per l'ecografia tiroidea TN5000, con 0.935, e per la microscopia delle cellule del sangue TXL-PBC, con 0.889. Se i tuoi dati somigliano a uno dei due dataset, confronta le righe di entrambi i modelli nelle rispettive pagine prima di scegliere.
Il vantaggio maggiore di Terra è il prezzo. Ecco il confronto diretto su UL37:
| Risultato UL37 | Gemini 4 Carbon | GPT-6.1 Terra |
|---|---|---|
| mAP50 | 0.584 | 0.560 |
| mAP50-95 | 0.371 | 0.345 |
| Costo del provider per 1.000 immagini | $12.93 | $4.36 |
| Tempo mediano per immagine | 7.6 s | 5,1 s |
| Richieste non riuscite | 1% | 0% |
Il costo è stimato in base all'uso di token dichiarato dai fornitori per 1.000 immagini del benchmark annotate con successo, ai prezzi di listino. Terra raggiunge circa il 96% del mAP50 di Carbon a circa un terzo del costo, risponde più rapidamente e non ha avuto richieste non riuscite. Entrambi i modelli si trovano sulla linea «Miglior rapporto qualità-prezzo» della classifica, che unisce i modelli che nessun altro supera sia per costo sia per accuratezza.
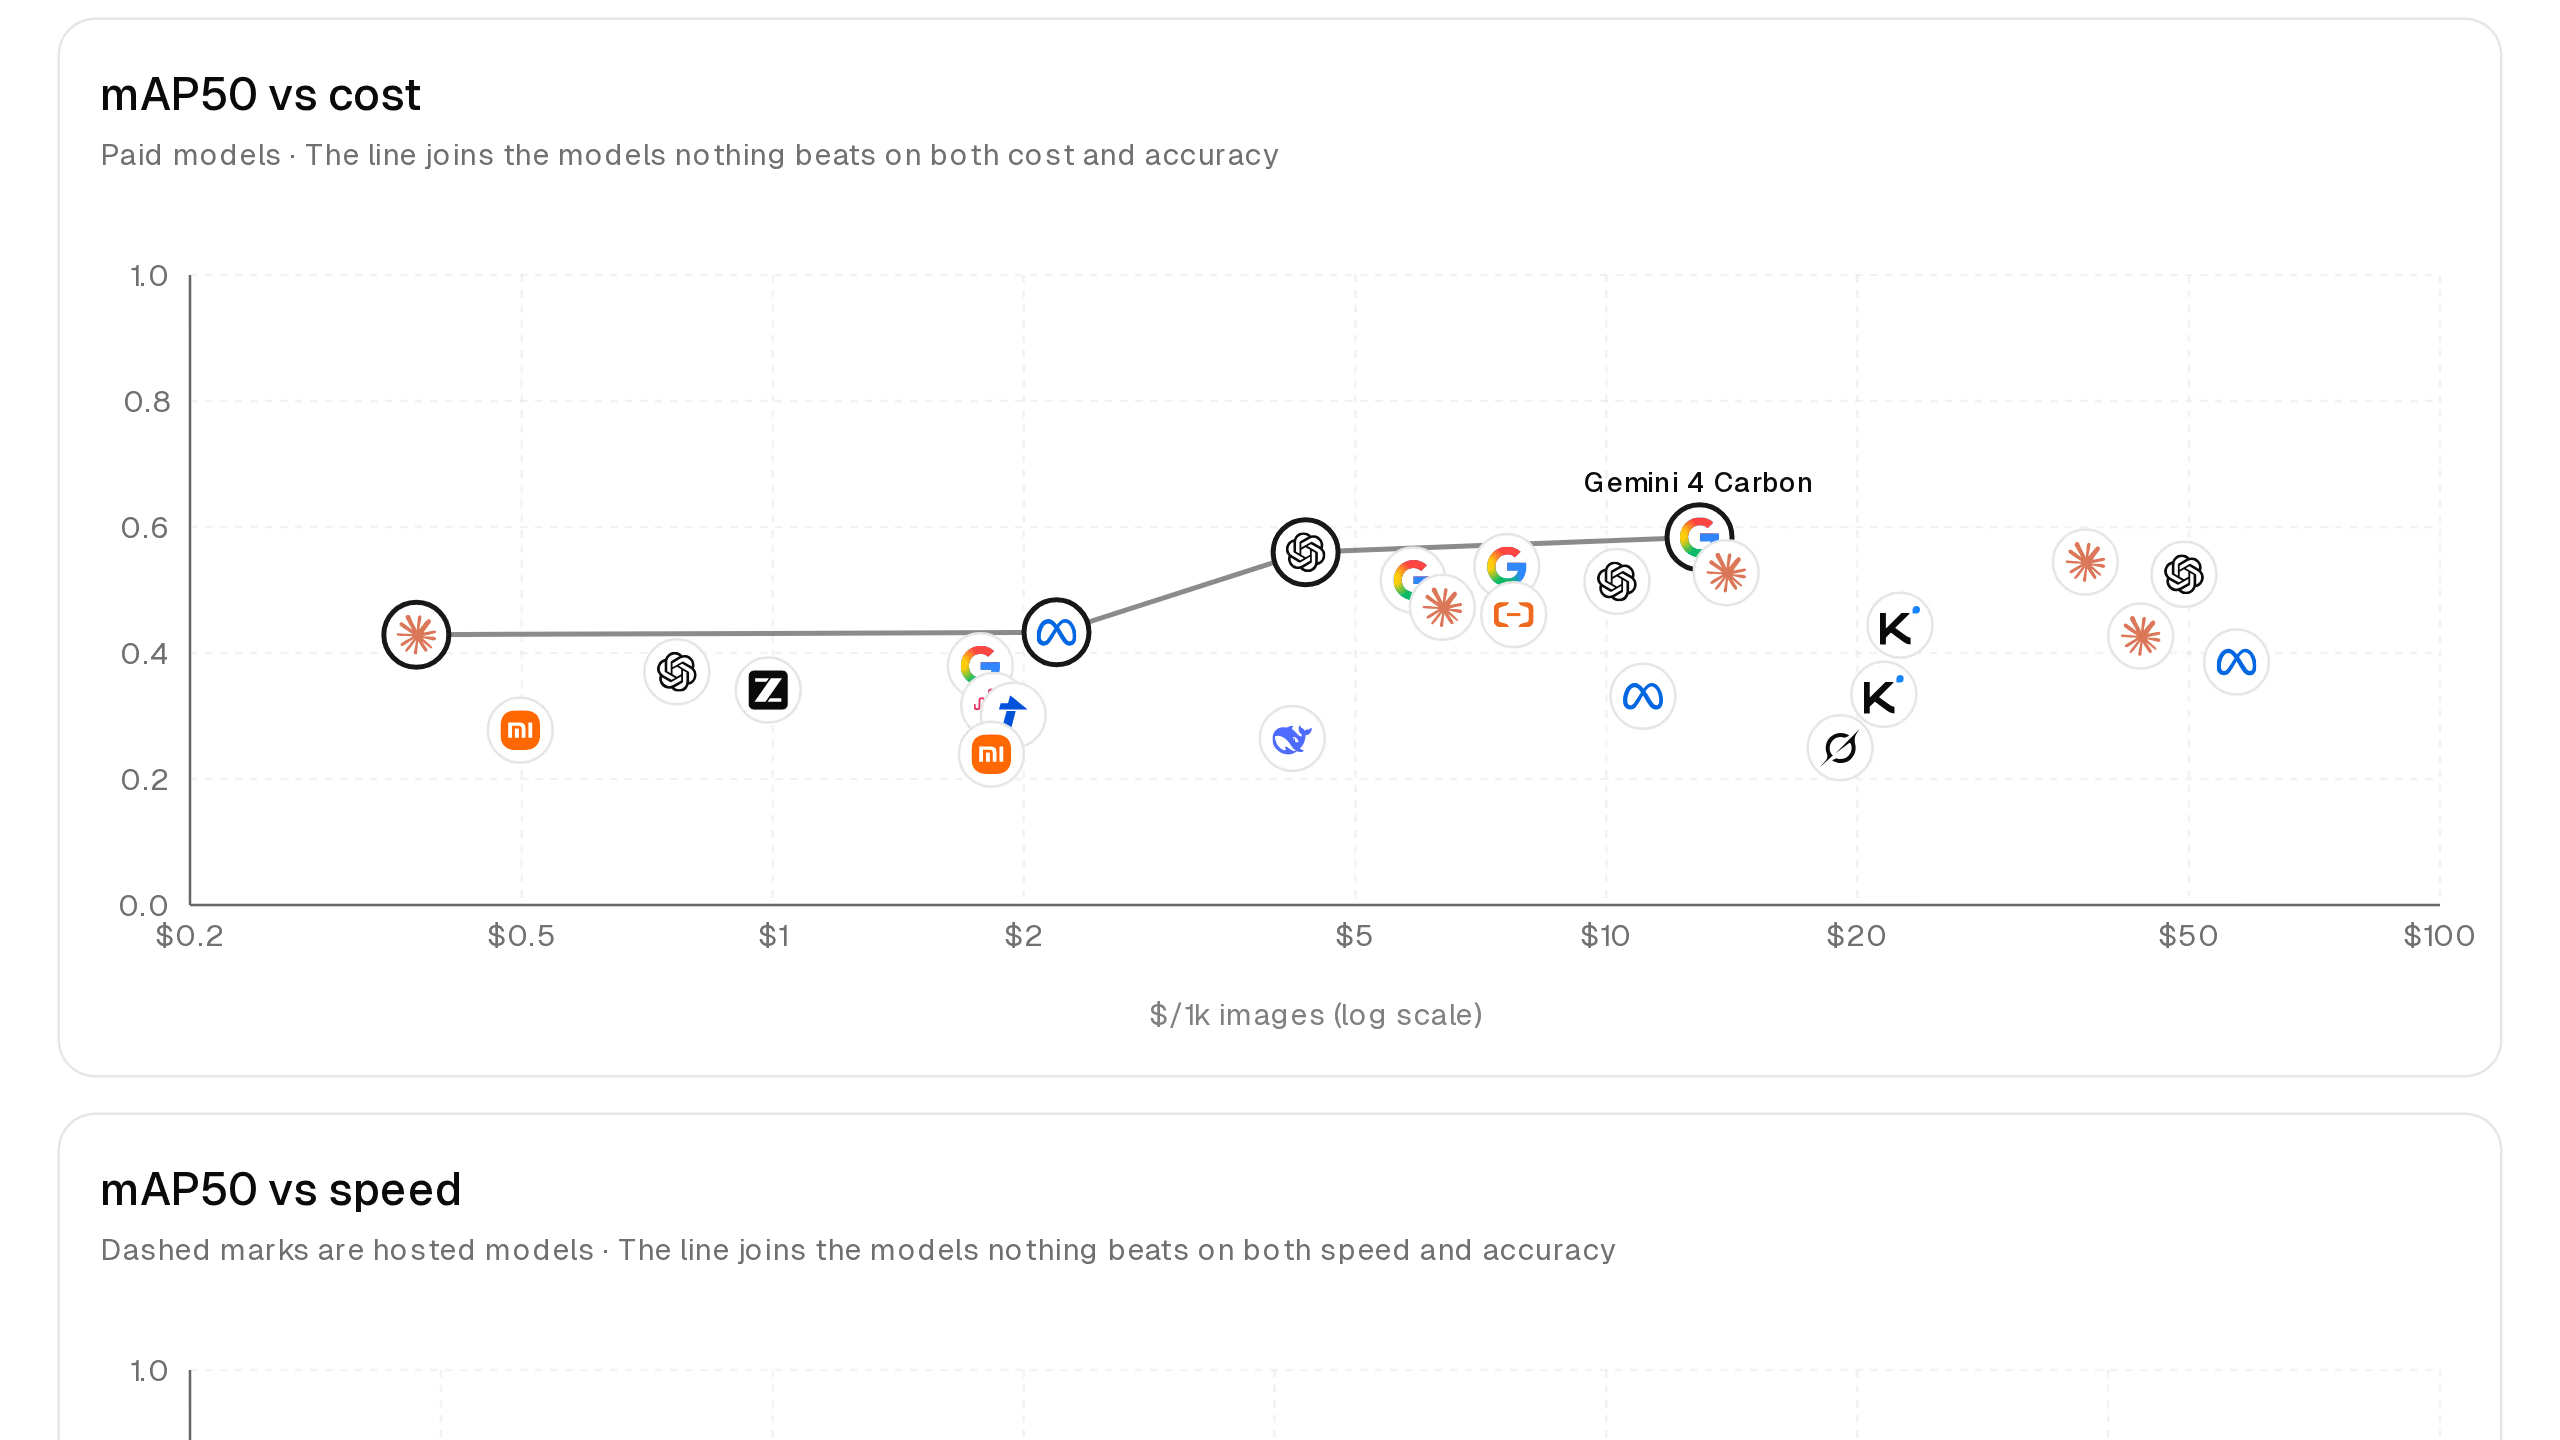
Grafico mAP50 rispetto al costo per i modelli a pagamento su UL37 nella classifica, ai prezzi di listino attuali.
Il divario di prezzo aumenterà. Secondo il post sulla disponibilità di Google, fino al 30 novembre 2026 Carbon sarà venduto al prezzo promozionale di $2 per milione di token in ingresso e $10 per milione di token in uscita; poi i prezzi saliranno rispettivamente a $4 e $20. A parità di uso dei token, i $12.93 per 1.000 immagini di Carbon diventeranno circa $26 il 1° dicembre.
Ecco come regolarti:
- Paga per Carbon quando la qualità delle etichette giustifica il costo: per scene affollate come gli scaffali dei negozi, immagini termiche e aeree, planimetrie e disegni CAD, nonché per qualsiasi dataset in cui la pagina del modello mostri un netto vantaggio di Carbon.
- Scegli Terra per grandi batch generici in cui il budget conta più di 0.024 mAP50 e per dati come quelli dei dataset di ecografia tiroidea TN5000 e cellule del sangue TXL-PBC.
- Avvia un'attività di grandi dimensioni con Carbon prima del 1° dicembre se prevedi di usarlo, finché è valida la tariffa promozionale.
Qualunque modello tu scelga, Batch Annotation aggiunge la tariffa di elaborazione di Ultralytics Platform, pari a $1.00 per 1.000 immagini elaborate, con un minimo di $0.01 per esecuzione, mentre il fornitore addebita direttamente la tua chiave. Ultralytics non applica ricarichi sui token. Per un'analisi più ampia, consulta la nostra guida ai costi dei software di annotazione delle immagini. Tra i modelli a pagamento più economici, Claude Haiku 5.5 ottiene 0.429 a $0.37 per 1.000 immagini; i modelli ospitati come Qwen3.8 27B e SAM 3.1 Text non richiedono affatto una chiave.
Come eseguire l'auto-annotazione con Gemini 4 Carbon sul tuo dataset#
Carbon è un modello per il rilevamento che usa prompt di classe, adatto a dataset con da 1 a 200 classi. Restituisce riquadri di delimitazione per i nomi delle classi del tuo dataset; Platform li richiede nel formato y-first di Gemini e li perfeziona con SAM 3.1.
- Crea una chiave API di Gemini in Google AI Studio. Carbon funziona con il livello a pagamento dell'API, quindi la chiave deve avere la fatturazione abilitata.
- Aggiungila in Impostazioni > Chiavi API nell'area di lavoro di Platform che contiene il tuo dataset. La documentazione sulle chiavi dei fornitori illustra i dettagli.
- Apri un'immagine nell'editor di annotazione, passa alla modalità Smart e scegli Gemini 4 Carbon nella sezione Google del selettore di modelli.
- Premi Prevedi oppure
Pper etichettare l'immagine corrente. Prima di estendere l'operazione, prova alcune immagini rappresentative dei tuoi dati. - Nella pagina del dataset, scegli Altre azioni > Batch Annotation per etichettare tutte le immagini non etichettate in un'unica operazione. Platform salva prima una versione del dataset, così puoi ripristinarla.
- Esamina e correggi i riquadri, che l'editor salva automaticamente, poi addestra un modello Ultralytics YOLO26 sul risultato nella stessa area di lavoro.
Gli sviluppatori possono anche richiamare Carbon dal codice: la release 0.1.109 di Platform SDK ha aggiunto gemini-4-carbon come modello per la previsione delle immagini. Per una panoramica più ampia, scopri come Ultralytics Platform usa l'AI per automatizzare l'annotazione e perché la revisione con intervento umano resta parte del flusso di lavoro. Per l'analisi di immagini mediche, considera i riquadri di qualsiasi modello come bozze da sottoporre alla verifica e all'approvazione di esperti clinici, mai come diagnosi.
A chi è consigliato Gemini 4 Carbon#
Usa Gemini 4 Carbon quando la qualità delle etichette conta più del costo del fornitore. È il modello di auto-annotazione più accurato che abbiamo valutato con un benchmark, l'attuale leader sia per precisione sia per richiamo e il modello con i punteggi migliori nei dataset di immagini termiche, aeree e subacquee, di scaffali di negozi, planimetrie e risonanze magnetiche cerebrali.
I team che già usano Argon ottengono un punteggio complessivo più alto e nuovi punteggi record nei domini in cui Argon eccelle, allo stesso prezzo promozionale per token, anche se a quel prezzo Carbon costa di più per immagine. I team che etichettano grandi batch generici con un budget limitato dovrebbero mantenere GPT-6.1 Terra come modello predefinito e passare a Carbon dataset per dataset, quando la pagina del modello mostra un vantaggio netto. Per conoscere i risultati di Argon, consulta i nostri risultati dell'auto-annotazione con Gemini 4 Argon.
Domande frequenti
Nel nostro benchmark UL37 ottiene 0.584 mAP50 e 0.371 mAP50-95, classificandosi al primo posto tra 45 modelli nella classifica VLM di Ultralytics; inoltre, ha la precisione media e il richiamo medio più alti. Ottiene il miglior punteggio tra tutti i modelli nei dataset di immagini termiche, aeree e subacquee, di scaffali di negozi, planimetrie e risonanze magnetiche cerebrali.
Nel complesso è più accurato: 0.584 mAP50 contro 0.560 di Terra e 0.371 mAP50-95 contro 0.345. Terra costa $4.36 per 1.000 immagini rispetto ai $12.93 di Carbon, risponde più rapidamente e resta il miglior modello della classifica per i dataset di ecografia tiroidea TN5000 e di cellule del sangue TXL-PBC. Scegli Carbon quando il suo vantaggio è ampio, per esempio sugli scaffali affollati e nelle immagini termiche.
Nel complesso, su UL37, sì. Carbon è basato su Argon e ottiene 0.047 in più in mAP50 (0.584 contro 0.537); inoltre, supera i precedenti punteggi migliori di Argon nelle immagini a infrarossi LLVIP, nei filmati dei droni termici HIT-UAV, nelle immagini subacquee RUOD e nelle immagini di Airbus Oil Storage. Entrambi hanno lo stesso prezzo promozionale per token, anche se Carbon usa più token di ragionamento per richiesta.
Google indica un prezzo introduttivo di 2 $ per milione di token in input e 10 $ per milione di token in output fino al 30 novembre 2026, poi di 4 $ e 20 $. Sul nostro benchmark, il costo del provider per Carbon è stato di 12,93 $ per 1.000 immagini al prezzo introduttivo, circa 26 $ per lo stesso utilizzo a partire dal 1° dicembre. Batch Annotation in Ultralytics Platform aggiunge 1,00 $ per ogni 1.000 immagini elaborate.
Dal 10 novembre 2026, gli sviluppatori paganti e le aziende possono usare Carbon tramite Gemini API in Google AI Studio e Gemini per le aziende, ed è in fase di distribuzione agli abbonati Google AI Ultra nell'app Gemini. Chi si occupa di difesa della cybersicurezza mantiene l'accesso specializzato tramite il Fairwind Program di Google. In Ultralytics Platform, puoi usarlo con la tua chiave Gemini API a pagamento.
Sì. Anche il modello migliore raggiunge in media 0,584 mAP50 su UL37, mentre i punteggi sui dataset più difficili sono molto più bassi, per esempio 0,381 su Airbus Oil Storage, considerando le sue 10 immagini di benchmark. Rivedi ogni immagine e, per i dati medici, fai approvare i riquadri dagli esperti clinici.
Scritto da
Fondatore e CEO · Ultralytics
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









