Segmentazione semantica e di istanza: come scegliere l'attività giusta
La segmentazione semantica assegna una classe a ogni pixel; la segmentazione di istanza distingue ogni singolo oggetto. Scopri quale serve al tuo progetto di visione artificiale e perché.
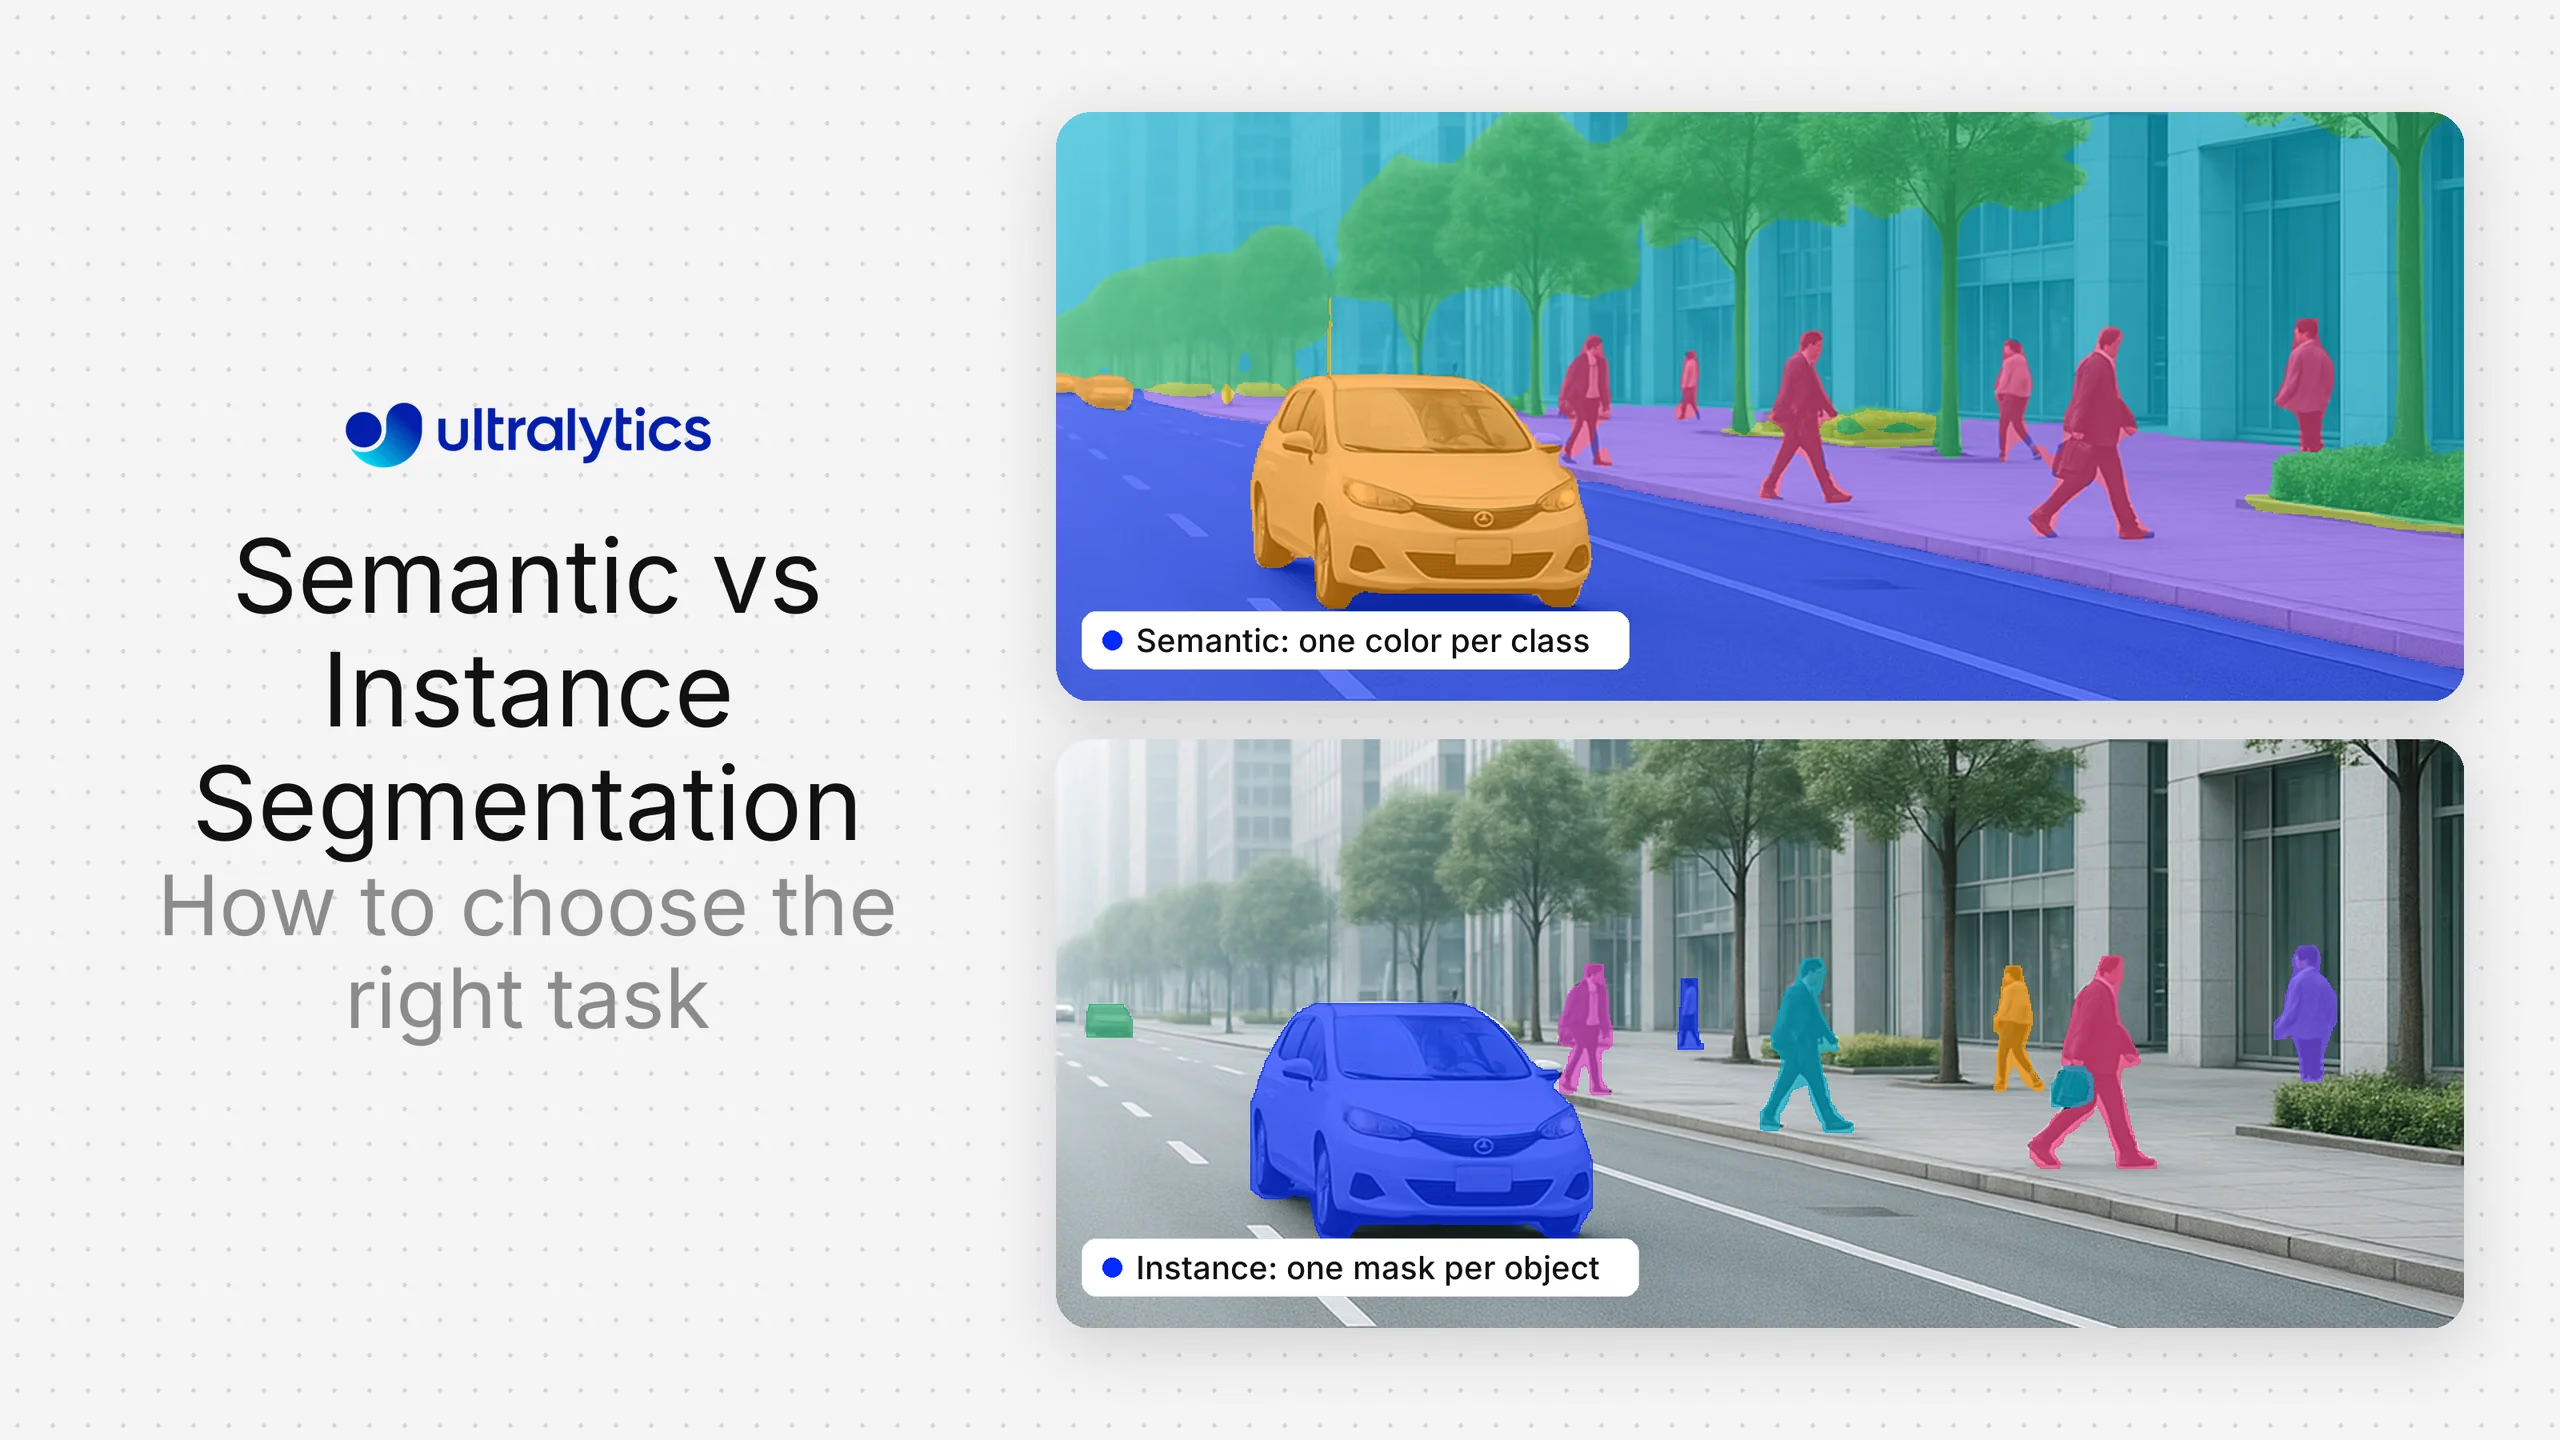
La segmentazione semantica e quella delle istanze assegnano entrambe etichette ai pixel delle immagini, ma rispondono a domande diverse. La segmentazione semantica assegna una classe a ogni pixel, quindi tutte le auto in una scena formano un'unica regione «auto». La segmentazione delle istanze separa ogni singolo oggetto, assegnando a ciascuna auto la propria maschera. La scelta dipende da una domanda: ti serve sapere che cosa c'è in ogni pixel o a quale oggetto appartiene ciascun pixel? Questa guida ti aiuta a scegliere. Spiega anche quanto costa annotare ogni attività e come viene valutata. Ultralytics YOLO supporta entrambe le attività nello stesso framework.
La differenza in una frase#
- La segmentazione semantica classifica ogni pixel in una categoria, come strada, cielo, persona o auto. Gli oggetti della stessa classe si fondono in un'unica regione. Consulta la voce del glossario sulla segmentazione semantica.
- La segmentazione delle istanze individua ogni singolo oggetto e gli assegna una maschera e un ID propri. In genere riguarda oggetti che si possono contare e ignora lo sfondo, come cielo o erba. Consulta la voce del glossario sulla segmentazione delle istanze.
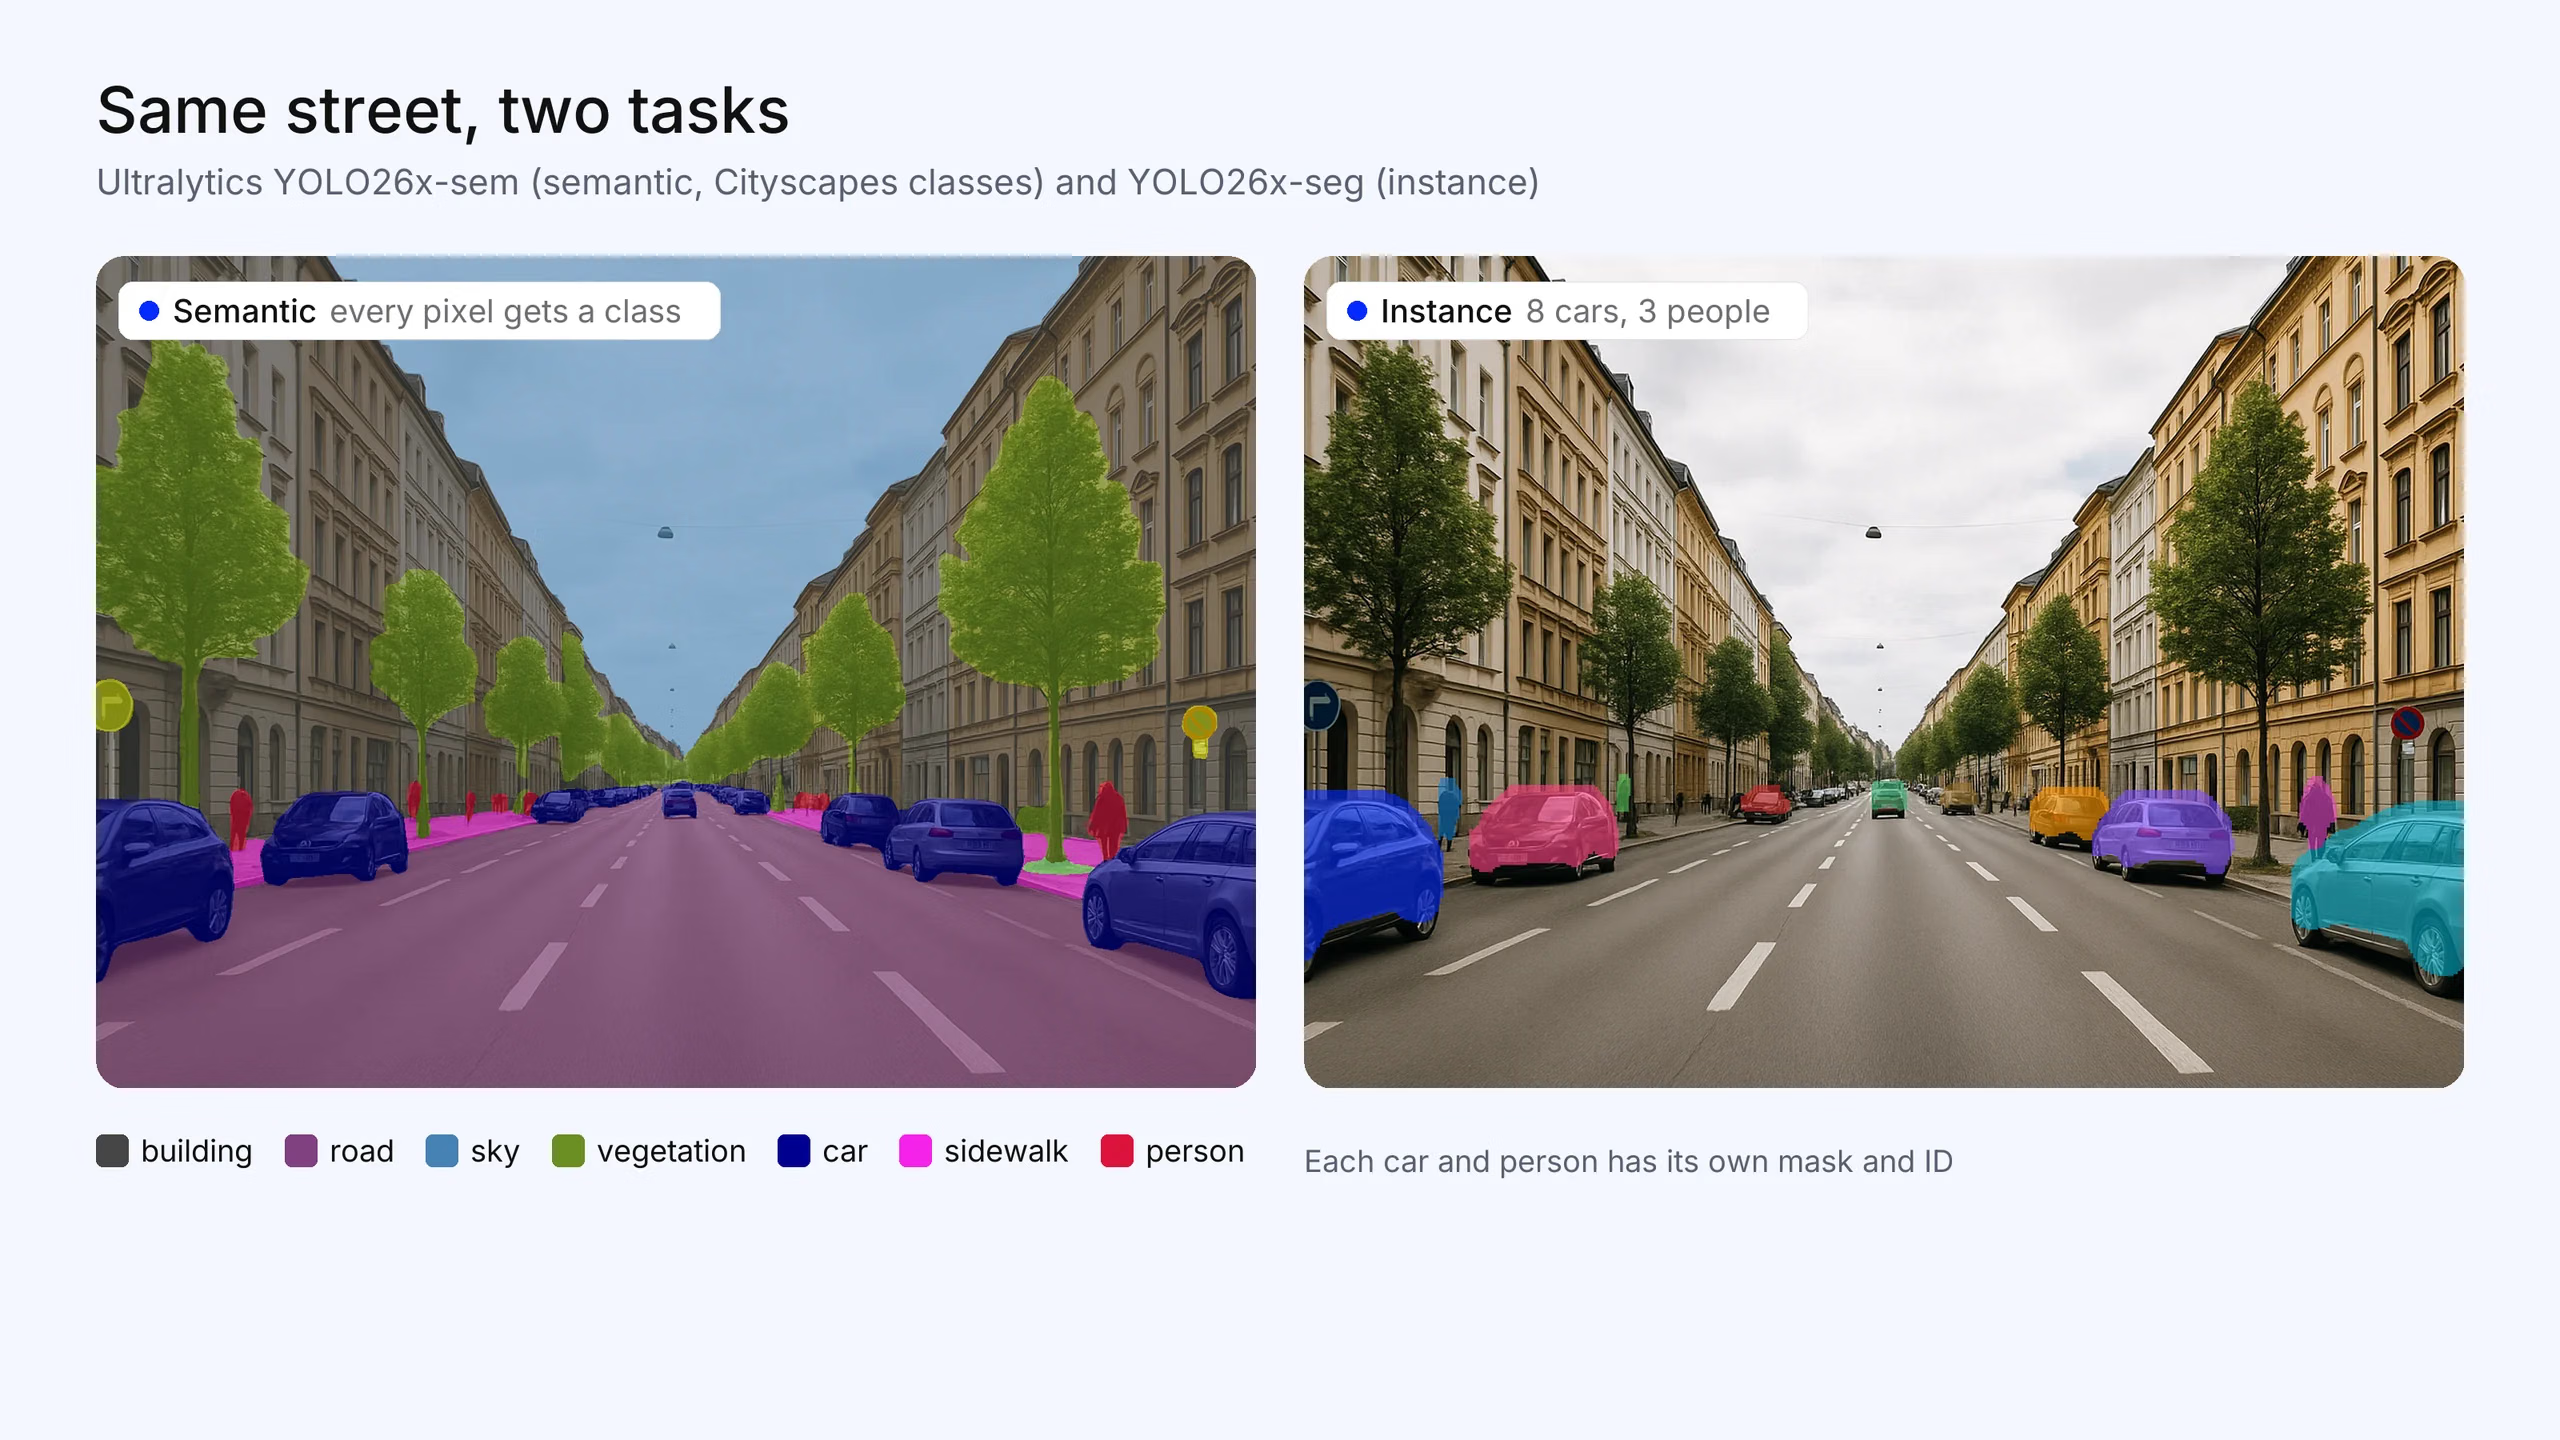
Fig. 1. La stessa strada con entrambe le attività. Ultralytics YOLO26x-sem (classi Cityscapes) assegna un'etichetta a ogni pixel, quindi tutte le auto condividono la classe «auto». Ultralytics YOLO26x-seg assegna una maschera propria a ciascuna delle 8 auto e delle 3 persone individuate (confidenza pari o superiore a 0,5). La foto è stata generata per questo articolo; le maschere sono output reali del modello.
Di quale attività ha bisogno il tuo progetto?#
Parti dalla domanda a cui deve rispondere la tua applicazione:
| Se la tua applicazione deve… | Usa | Esempio |
|---|---|---|
| Sapere quanta parte della scena appartiene a una determinata classe | Semantica | Area stradale percorribile, copertura di colture rispetto alle infestanti, copertura del suolo |
| Etichettare le regioni di sfondo con la stessa precisione degli oggetti | Semantica | Cielo, acqua, vegetazione, tipi di tessuto in una scansione |
| Contare gli oggetti | Delle istanze | Frutti su un albero, persone in una coda |
| Tracciare gli oggetti tra i fotogrammi di un video | Delle istanze, più un tracker | Persone o veicoli che si muovono in una scena |
| Misurare un singolo oggetto alla volta o intervenire su di esso | Delle istanze | Un robot che preleva un componente da una pila, misurare ogni difetto |
| Fare entrambe le cose: coprire tutta la scena e separare i singoli oggetti | Panottica | Scene stradali per la guida autonoma |
Se hai dubbi, chiediti se sia necessario distinguere due oggetti adiacenti della stessa classe. Se sì, ti serve la segmentazione delle istanze (o panottica). Se no, la segmentazione semantica è più semplice e in genere meno costosa da eseguire.
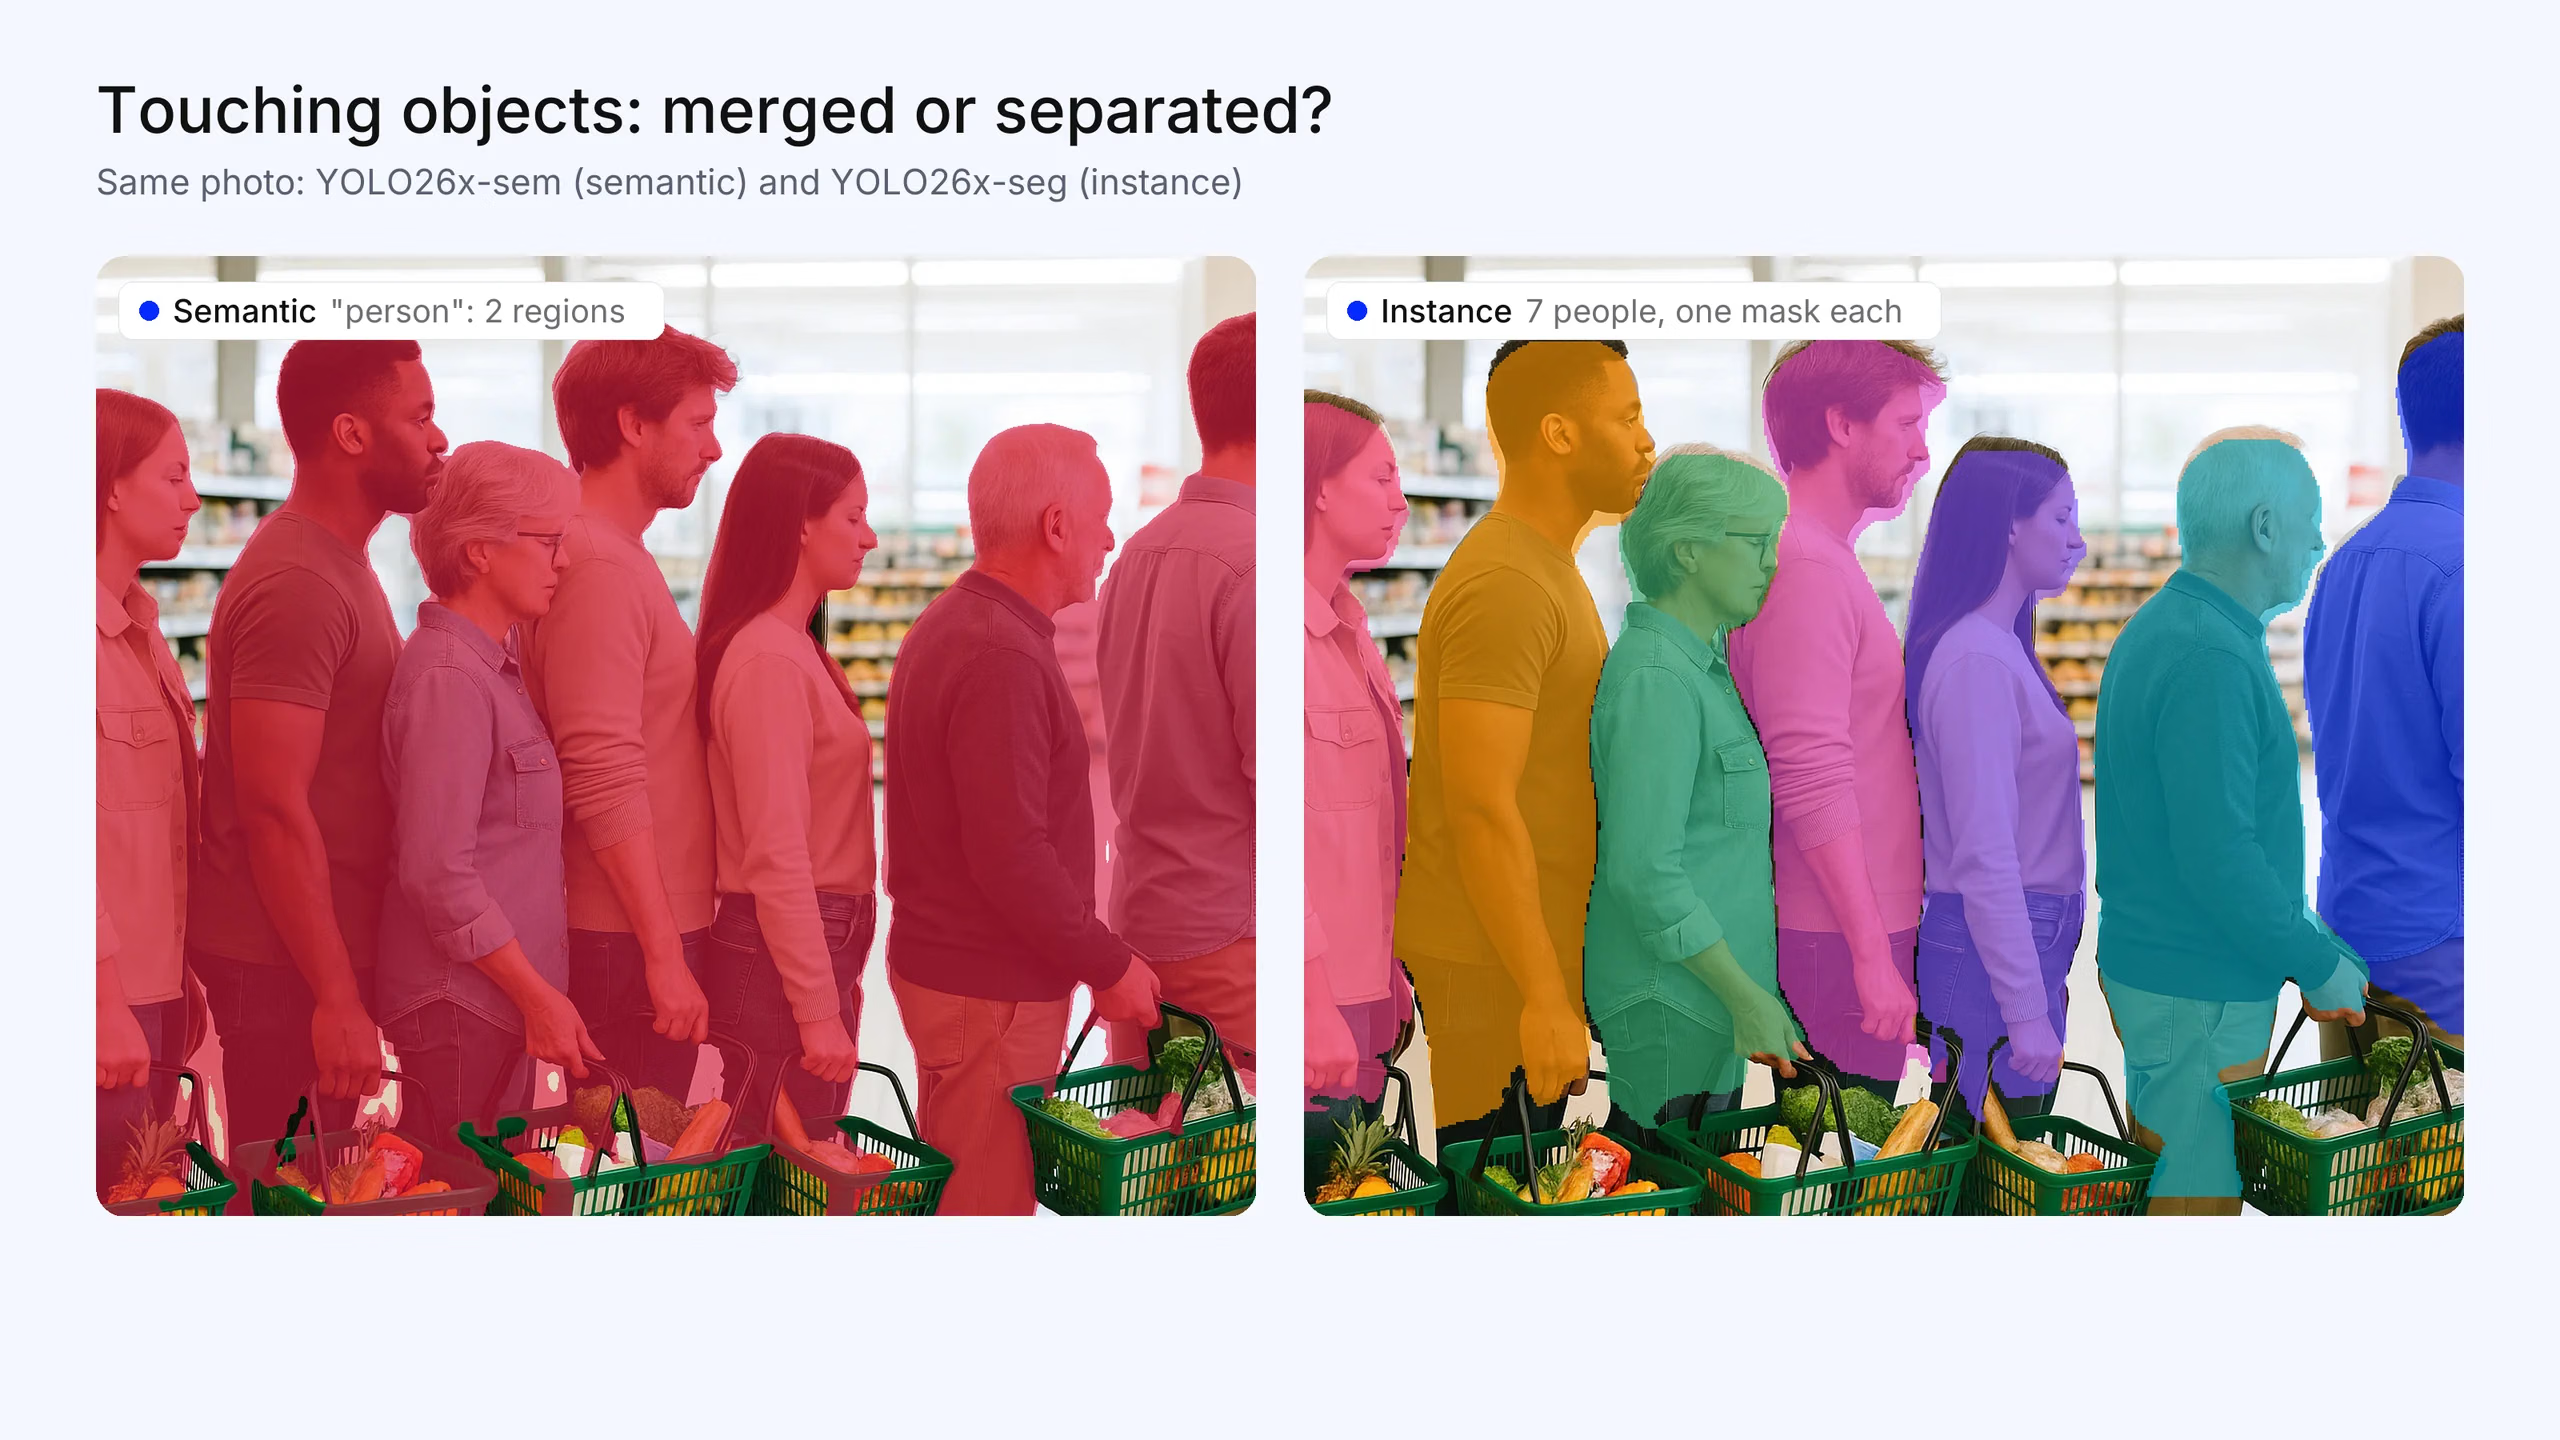
Fig. 2. Sette clienti in piedi molto vicini in una fila alla cassa. Nell'output semantico (Ultralytics YOLO26x-sem) formano due regioni «persona» connesse, quindi non puoi contarli. L'output per istanze (Ultralytics YOLO26x-seg) li separa tutti e 7. La foto è stata generata per questo articolo; le maschere sono output reali del modello.
Differenze principali a colpo d'occhio#
| Criterio | Segmentazione semantica | Segmentazione di istanze |
|---|---|---|
| Domanda a cui risponde | A quale classe appartiene ogni pixel? | A quale oggetto appartiene ogni pixel? |
| Oggetti della stessa classe | Fusi in un'unica regione | Separati, ciascuno con la propria maschera e il proprio ID |
| Copertura | Tutti i pixel, compreso lo sfondo | Di solito solo gli oggetti di interesse |
| Output | Un'unica mappa delle classi delle dimensioni dell'immagine | Un elenco di maschere, ciascuna con una classe e un livello di confidenza |
| Puoi contare gli oggetti? | Non direttamente | Sì |
| Metrica principale | Intersezione media sull'unione (mIoU) | Precisione media delle maschere (mask mAP) |
| Complessità relativa | Inferiore: classificazione per pixel | Superiore: rilevamento più maschere per oggetto |
Quanto costa annotare ciascuna attività#
In pratica, spesso è l'impegno richiesto per l'annotazione a determinare la scelta.
- I dataset semantici assegnano una classe a ogni pixel di ogni immagine, sfondo compreso. Di solito sono memorizzati come immagini di maschere a un solo canale. Ogni immagine è etichettata integralmente, quindi non si può tralasciare alcun pixel, a meno che non sia contrassegnato esplicitamente come «ignore».
- I dataset per istanze delineano separatamente ogni oggetto di interesse, tramite un poligono o una maschera. Lo sfondo può non essere etichettato, ma ogni oggetto deve avere il proprio contorno e le scene affollate moltiplicano il lavoro.
Entrambi richiedono molto lavoro. L'annotazione assistita, in cui un clic o un riquadro viene trasformato in una maschera, riduce l'impegno per entrambe le attività. Se ti servono solo risposte a livello di regione, non investire nell'annotazione delle istanze.
Come si valuta ciascuna attività#
- La segmentazione semantica viene valutata principalmente con mIoU: la sovrapposizione tra le regioni predette e quelle reali, mediata su tutte le classi. Si riporta anche l'accuratezza per pixel. IoU è la stessa misura di sovrapposizione usata nel rilevamento.
- La segmentazione delle istanze viene valutata con la mask mAP, la precisione media usata per il rilevamento, ma calcolata sulla sovrapposizione delle maschere. Premia l'individuazione di ogni oggetto, non solo la copertura dei pixel corretti.
Queste metriche non sono confrontabili tra loro. Un valore elevato di mIoU non dice nulla sulla separazione dei singoli oggetti.
Segmentazione panottica: quando ti servono entrambe#
La segmentazione panottica assegna una classe a ogni pixel e un ID di istanza agli oggetti che si possono contare. Gli elementi di sfondo, come strada e cielo, sono etichettati semanticamente. Gli oggetti in primo piano, come auto e persone, vengono separati uno per uno. Si valuta con la Qualità Panottica (PQ). Sceglila quando ti servono contemporaneamente la copertura completa della scena e la separazione dei singoli oggetti. Consulta la segmentazione panottica.
Come funziona ciascuna, in breve#
I modelli di segmentazione semantica sono in genere reti encoder-decoder che predicono una classe per ogni pixel. U-Net, DeepLab e SegFormer sono esempi noti. I modelli di segmentazione delle istanze si basano di solito sul rilevamento degli oggetti. Mask R-CNN predice una maschera all'interno di ogni riquadro rilevato, mentre i modelli a singolo stadio come YOLACT e i modelli di segmentazione Ultralytics YOLO predicono riquadri e maschere in un unico passaggio per l'uso in tempo reale. Architetture universali come Mask2Former gestiscono la segmentazione semantica, delle istanze e panottica con un solo modello. Per saperne di più sulla segmentazione delle istanze, consulta cos'è la segmentazione delle istanze.
Entrambe le attività in Ultralytics YOLO#
Ultralytics YOLO esegue entrambe le attività con la stessa API Python e CLI:
- La segmentazione di istanze usa l'attività
segment. - La segmentazione semantica usa l'attività
semantic. I modelli semantici YOLO26 hanno il suffisso-seme sono preaddestrati su Cityscapes e ADE20K. La pagina dell'attività include una tabella che mostra esattamente in che modo gli output delle due attività differiscono nel codice.
Entrambe possono essere addestrate localmente o nel cloud su Ultralytics Platform.
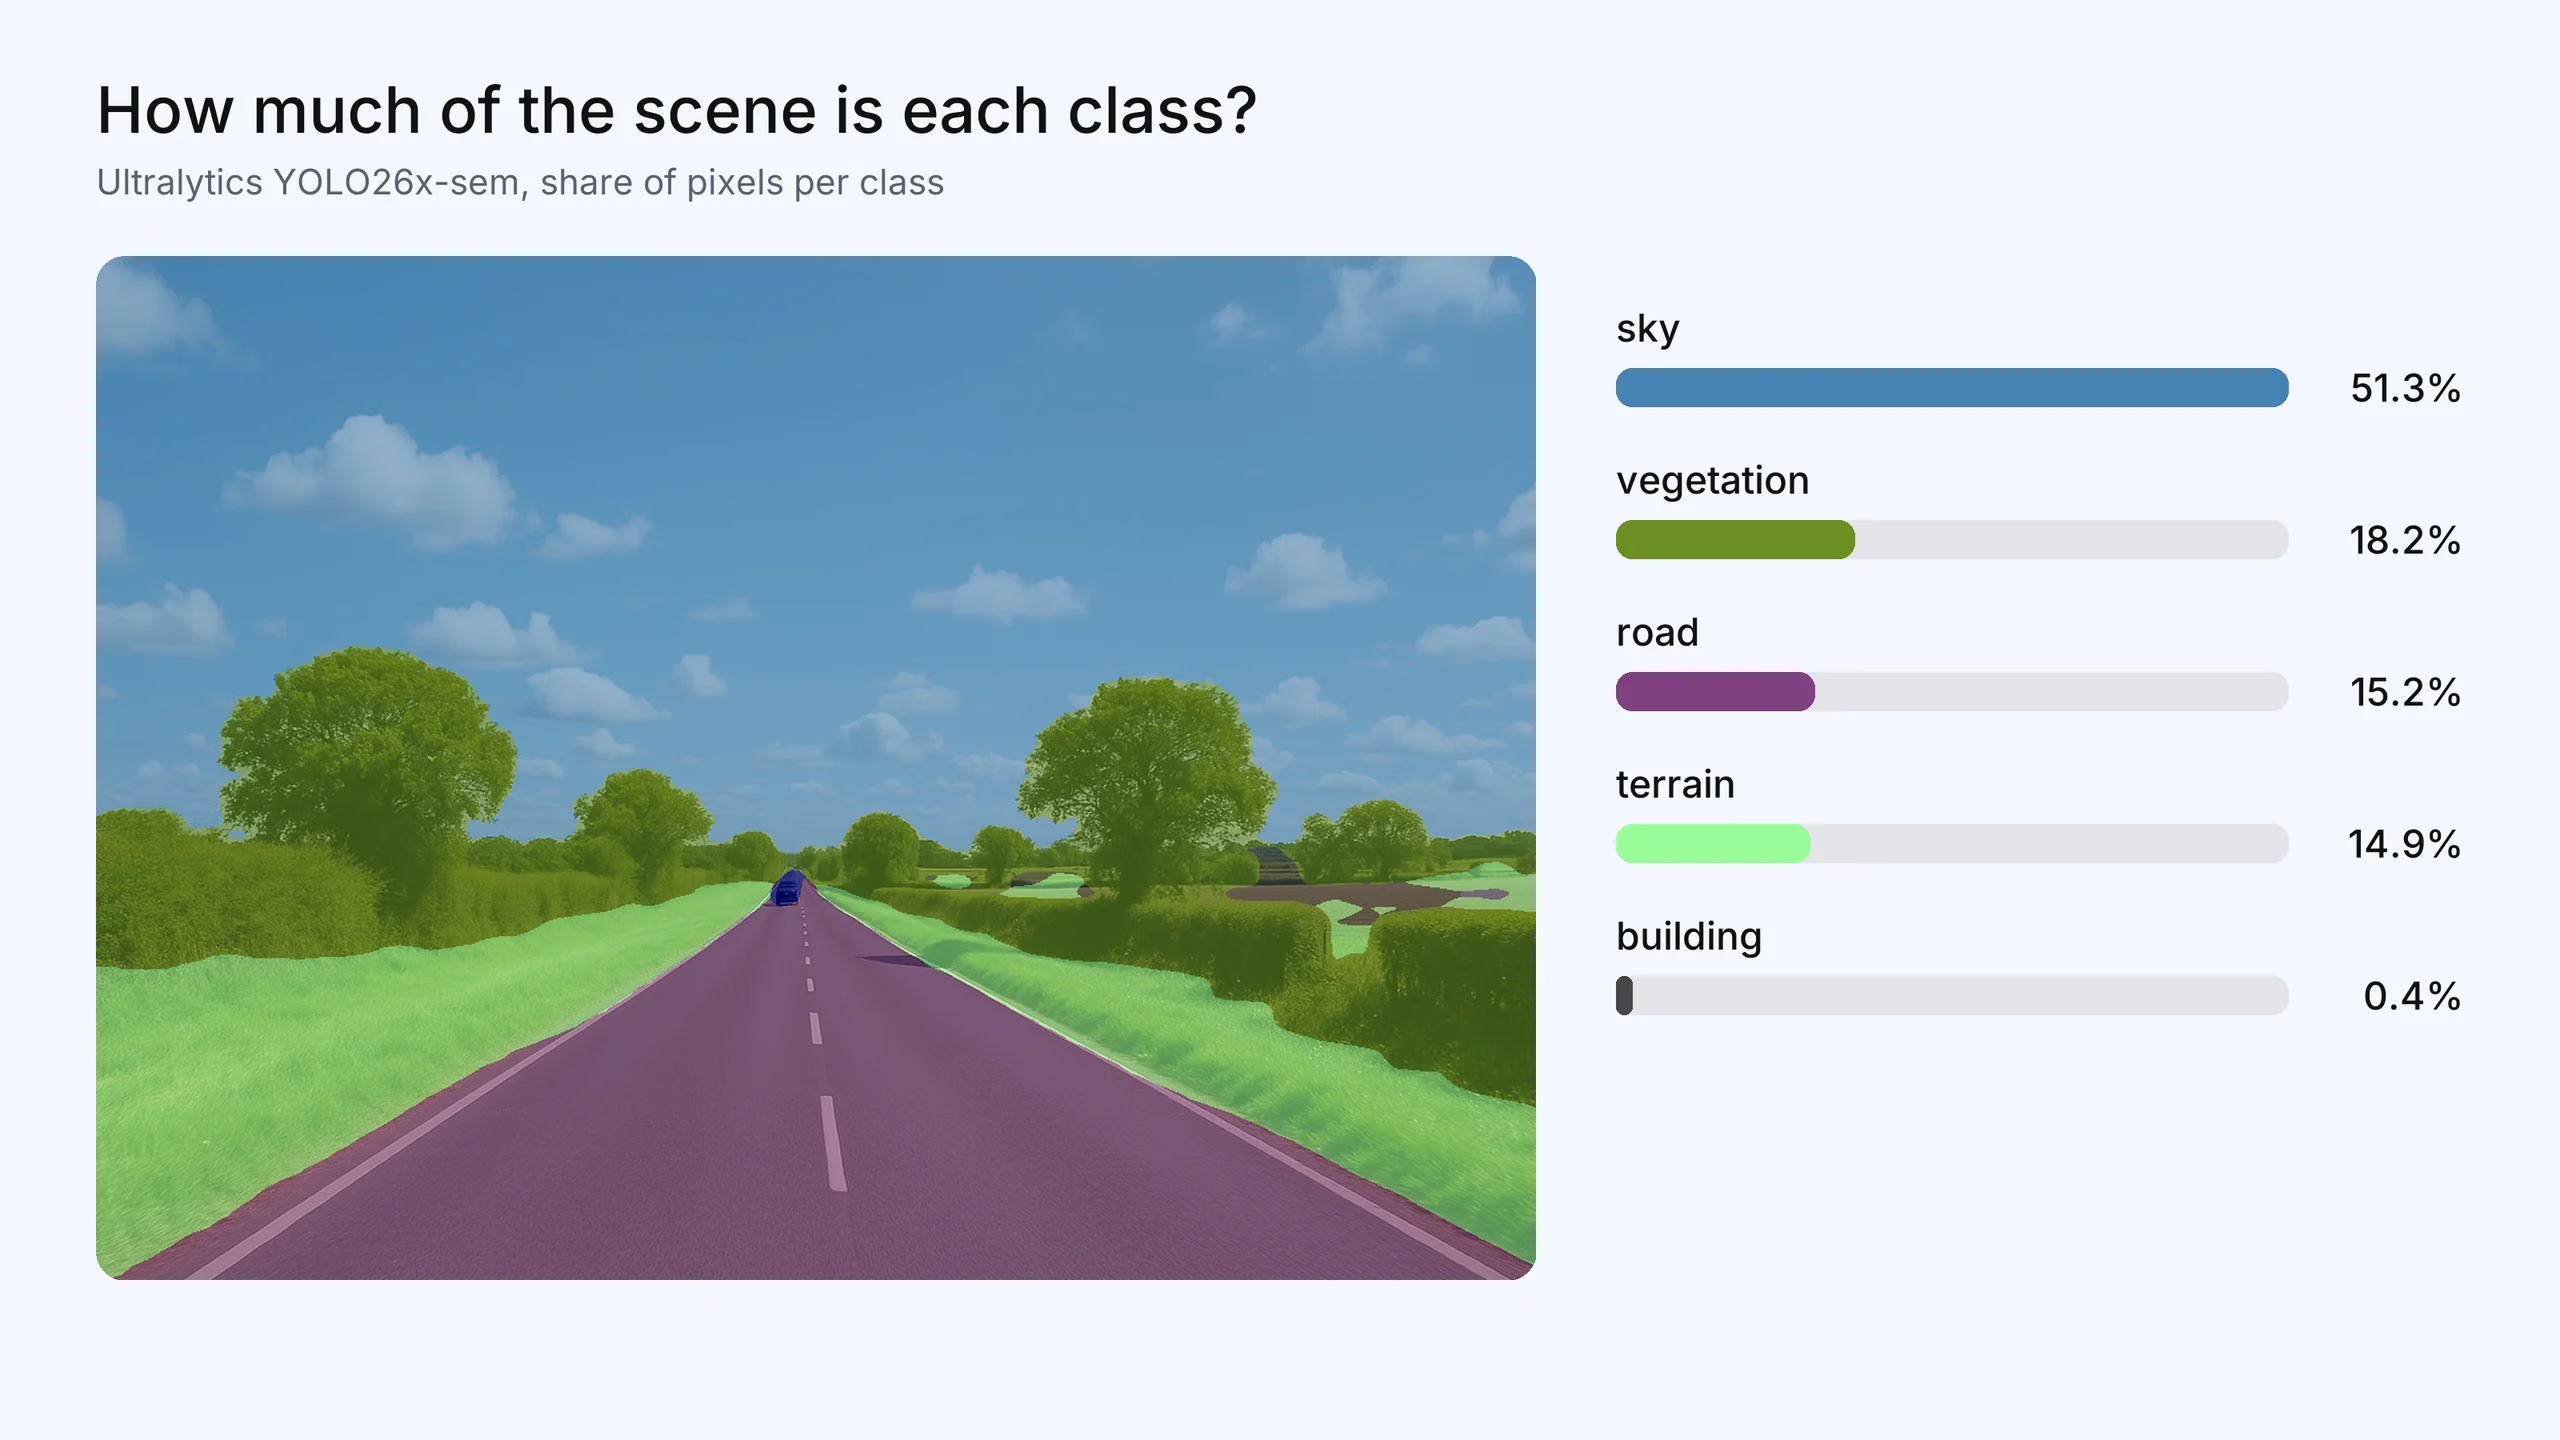
Fig. 3. La segmentazione semantica risponde alla domanda «quale percentuale della scena appartiene a ciascuna classe». Ultralytics YOLO26x-sem classifica il 51,3% di questa visuale come cielo, il 18,2% come vegetazione, il 15,2% come strada e il 14,9% come terreno. La foto è stata generata per questo articolo; la mappa delle classi e le percentuali sono output reali del modello.
Domande frequenti
La segmentazione semantica assegna una classe a ogni pixel, ma considera tutti gli oggetti della stessa classe come un'unica regione. La segmentazione di istanze separa ciascun oggetto in una maschera distinta, così gli oggetti della stessa classe possono essere contati e tracciati singolarmente.
Chiediti se è necessario distinguere due oggetti della stessa classe che si toccano. Se devi contare, tracciare o agire su singoli oggetti, usa la segmentazione di istanze. Se devi solo sapere quali regioni appartengono a ciascuna classe, la segmentazione semantica è più semplice.
Mask R-CNN è un modello di segmentazione di istanze. Rileva ogni oggetto e poi predice una maschera di pixel separata all'interno del riquadro di delimitazione dell'oggetto.
In genere, la segmentazione di istanze è più difficile. Deve classificare i pixel e anche separare gli oggetti della stessa classe, il che richiede sia il rilevamento sia la segmentazione.
Principalmente con la media dell'intersezione sull'unione (mIoU), ovvero la sovrapposizione media tra le regioni predette e quelle reali per tutte le classi. Per la segmentazione di istanze si usa la mAP delle maschere, mentre per la segmentazione panottica si usa la qualità panottica (PQ).









