I migliori modelli di classificazione delle immagini: come scegliere
Confronta i principali modelli di classificazione delle immagini, da ConvNeXt V2 e DINOv3 a EfficientNetV2, ViT e Ultralytics YOLO26-cls, e scopri come scegliere.
Non esiste un unico modello di classificazione delle immagini migliore in assoluto. La scelta giusta dipende dalla quantità di dati etichettati di cui disponi, dall'ambiente in cui deve funzionare il modello e dalla compatibilità della licenza con il tuo utilizzo. Nel 2026, le applicazioni che puntano alla massima accuratezza si basano su grandi backbone Transformer e auto-supervisionati, come DINOv3 ed EVA-02. Per la distribuzione su hardware con risorse limitate, i modelli più piccoli, perlopiù convoluzionali, come ConvNeXt V2, EfficientNetV2, MobileNetV4 e Ultralytics YOLO26-cls, sono spesso più pratici, a seconda delle dimensioni del checkpoint, della configurazione di training e dell'hardware di destinazione. Confronta accuratezza e latenza sul tuo carico di lavoro. Questa guida illustra le quattro famiglie di modelli, confronta dieci modelli ampiamente usati e propone un percorso decisionale per sceglierne uno.
Se non conosci ancora l'attività, inizia da cos'è la classificazione delle immagini. Questa pagina tratta la scelta del modello.
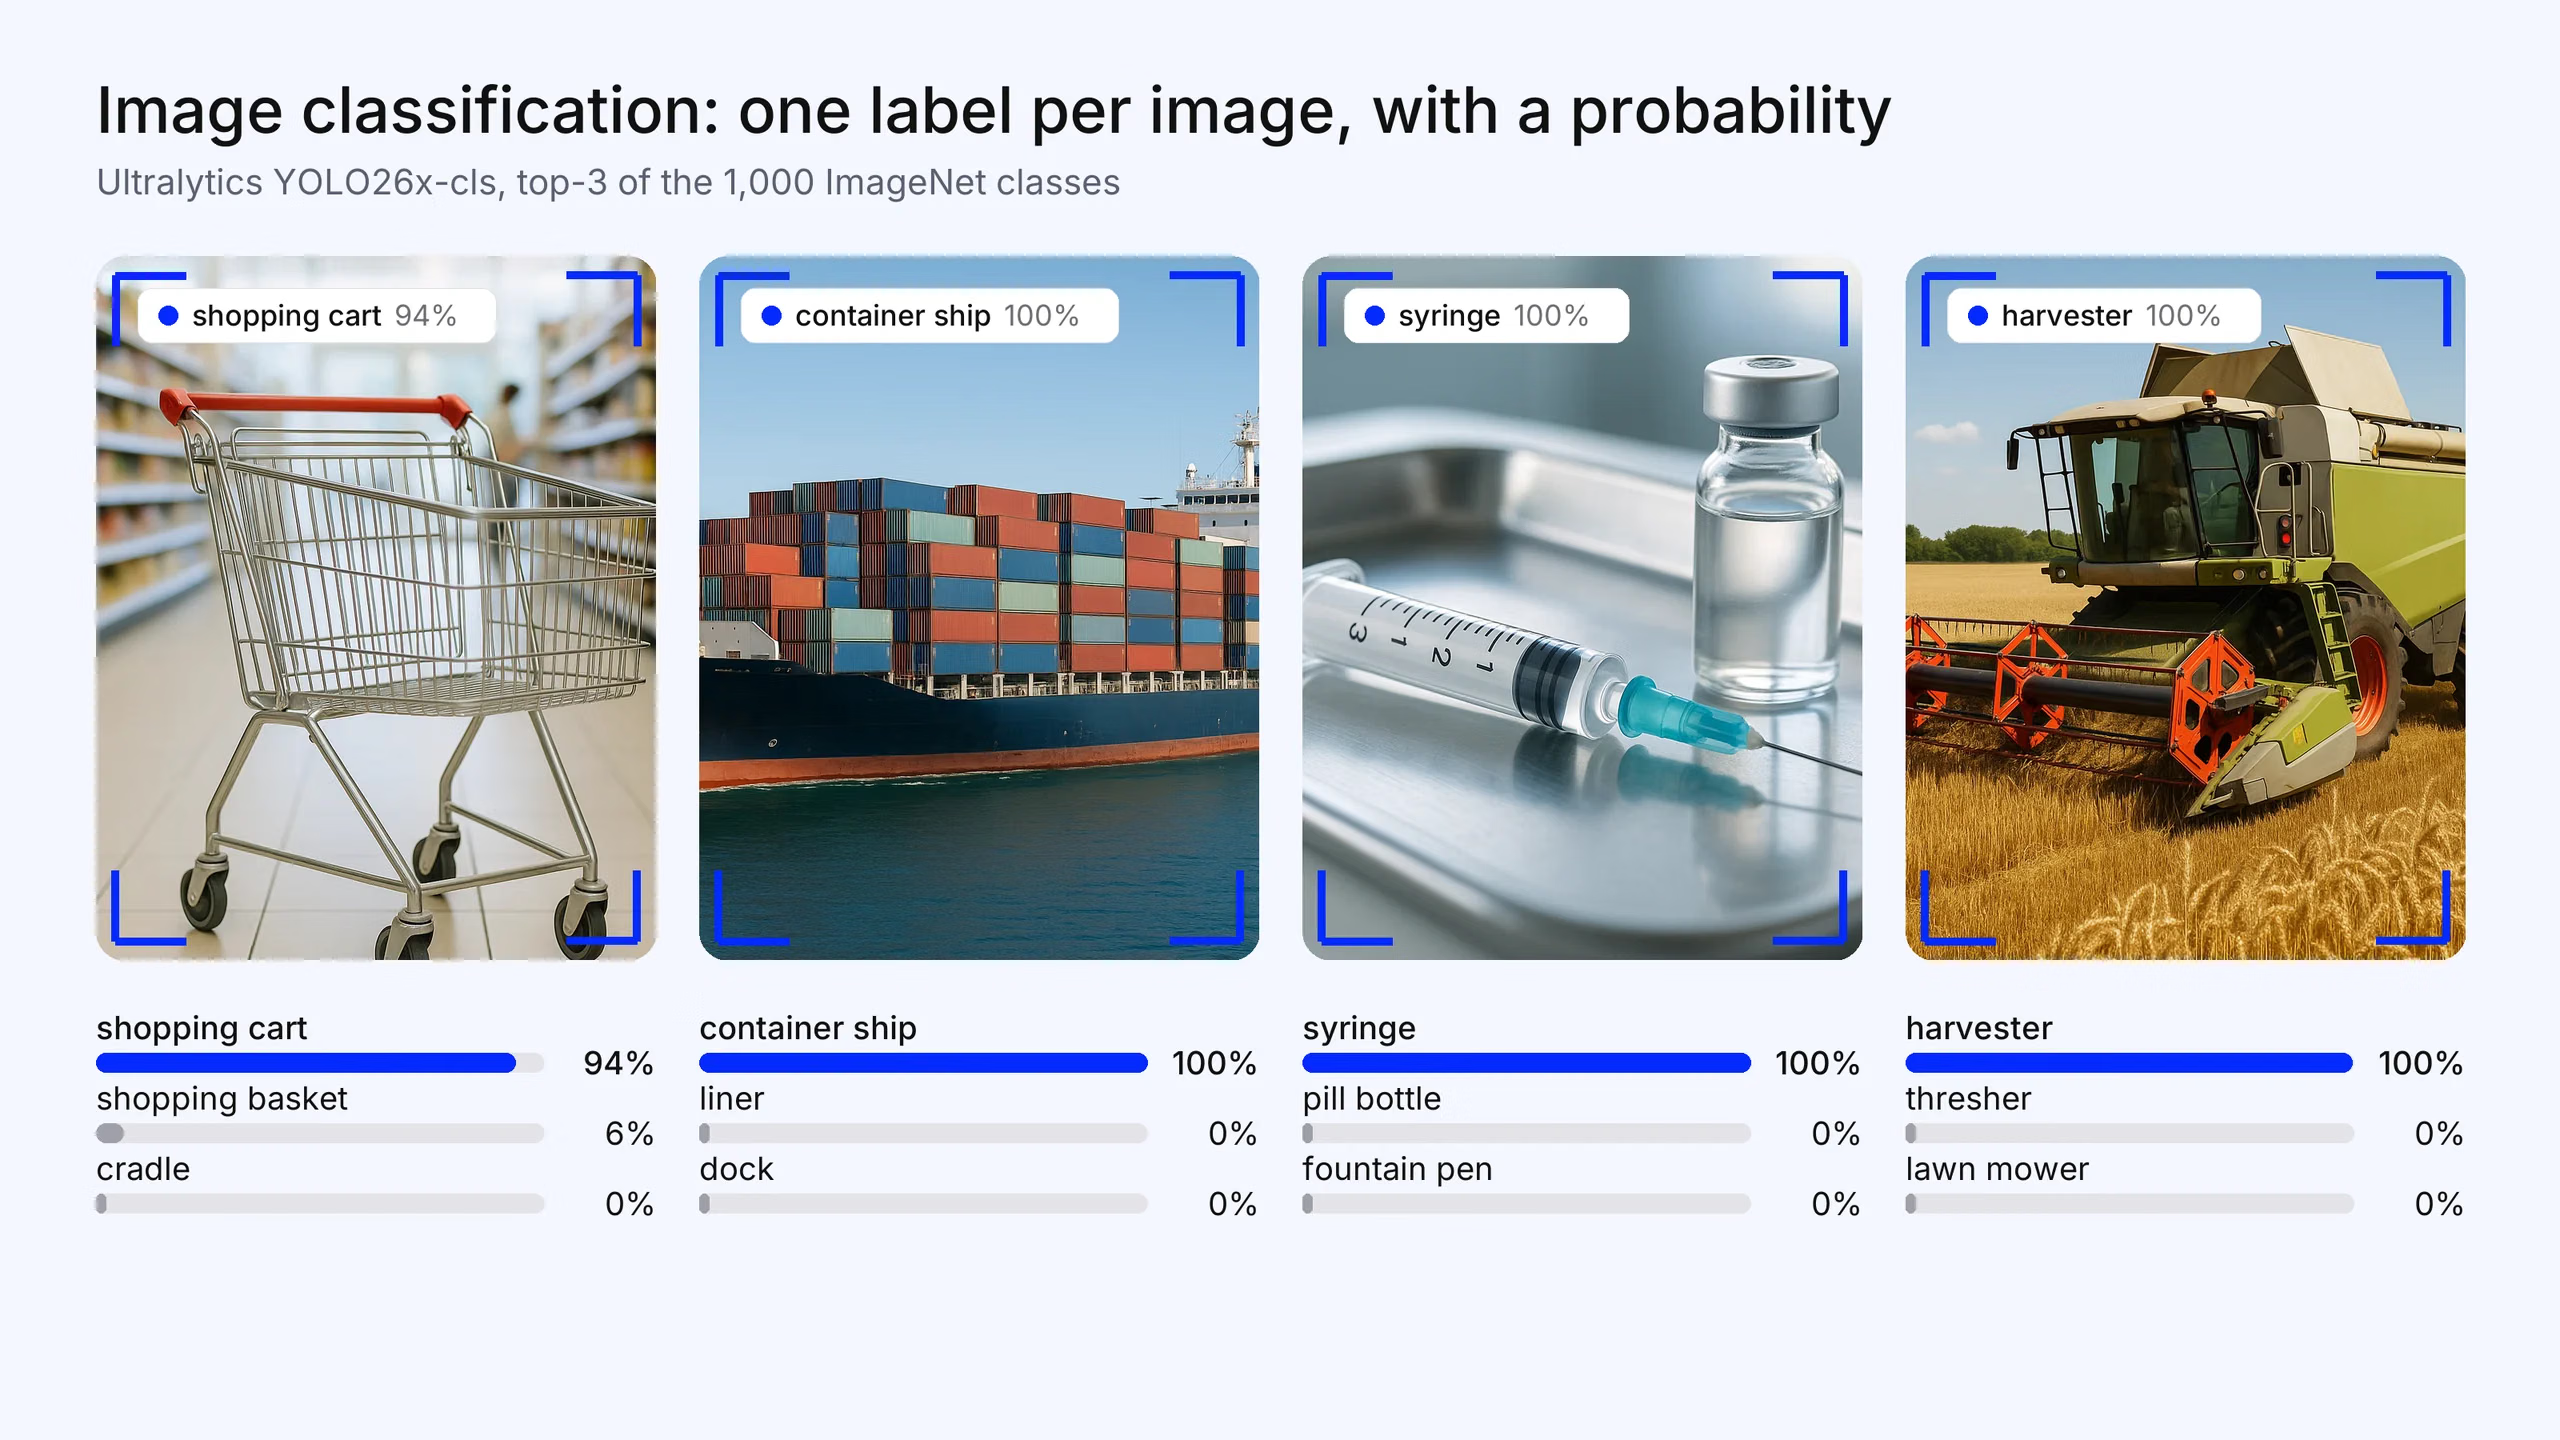
Fig. 1. La classificazione delle immagini restituisce un'etichetta per l'intera immagine, con una probabilità per ogni classe: esempi relativi a commercio al dettaglio, logistica, sanità e agricoltura. Le prime 3 previsioni sono di Ultralytics YOLO26x-cls, preaddestrato sulle 1.000 classi di ImageNet. Le foto sono state generate per questo articolo; le previsioni sono risultati reali del modello.
Cosa significa «migliore» per un modello di classificazione delle immagini#
Le classifiche ordinano i modelli in base all'accuratezza top-1 sul set di validazione di ImageNet. Questo valore è utile, ma viene misurato a una risoluzione fissa, su un solo dataset e spesso dopo un pretraining su dataset molto grandi. In un progetto reale, di solito sono altri quattro fattori a fare la differenza:
- Dati. Quante immagini etichettate hai per ogni classe e quanto sono simili ai dati di pretraining.
- Calcolo e latenza. Se l'inferenza viene eseguita su una GPU di un data center, su una CPU o sull'NPU di un telefono o di una telecamera.
- Percorso di distribuzione. Se il modello si esporta senza problemi nel runtime di cui hai bisogno, come ONNX, TensorRT, Core ML o TFLite.
- Licenza. Se il codice e, separatamente, i pesi preaddestrati consentono l'utilizzo che intendi farne.
Un modello con un punteggio ImageNet leggermente inferiore, ma che si adatta bene alle tue immagini e funziona in tempo reale sul tuo hardware, è di solito la scelta migliore.
Le quattro famiglie di modelli di classificazione delle immagini#
Reti neurali convoluzionali (CNN)#
Le CNN applicano filtri appresi all'intera immagine, partendo dal presupposto che i pixel vicini siano correlati. Questa ipotesi integrata (un bias induttivo) consente loro di apprendere bene da dataset piccoli e medi e di funzionare in modo efficiente su hardware modesto. ResNet ed EfficientNet sono gli esempi classici.
- Punti di forza: efficienti dal punto di vista dei dati, veloci, facili da quantizzare e distribuire.
- Compromessi: meno contesto globale per livello; i miglioramenti ottenuti aumentando la scala tendono a ridursi prima rispetto ai Transformer.
Vision transformer (ViT)#
Un Transformer per la visione suddivide un'immagine in patch e le elabora come una sequenza mediante self-attention, così ogni patch può essere messa in relazione con tutte le altre. I ViT offrono le prestazioni migliori quando vengono preaddestrati su grandi quantità di dati e poi trasferiti.
- Punti di forza: si adatta bene all'aumento dei dati e delle dimensioni del modello; ottimo trasferimento; base naturale per il training auto-supervisionato e multimodale.
- Compromessi: richiede un pretraining su larga scala o una regolarizzazione intensa; in genere è più lento e pesante in inferenza rispetto a una CNN di accuratezza simile.
Modelli ibridi CNN-Transformer#
I modelli ibridi usano convoluzioni nelle prime fasi per cogliere i dettagli locali e l'attenzione nelle fasi successive per acquisire il contesto globale. CoAtNet è il modello di riferimento: i suoi autori hanno dimostrato che combinare livelli convoluzionali e di attenzione in un ordine ben definito migliora la capacità di generalizzazione, la capacità del modello e l'efficienza.
- Punti di forza: buon equilibrio con dataset di medie dimensioni.
- Compromessi: più complesso da implementare, ottimizzare ed esportare rispetto a un'architettura interamente convoluzionale o interamente basata sull'attenzione.
Backbone auto-supervisionati e visione-linguaggio#
La famiglia più recente non è definita dall'architettura, ma dal metodo di training. I modelli auto-supervisionati, come DINOv2 e DINOv3, apprendono da immagini non etichettate. Gli encoder visione-linguaggio, come SigLIP 2, apprendono da coppie di immagini e testo. Entrambi producono feature di uso generale che puoi classificare con una piccola testa lineare oppure, nel caso dei modelli visione-linguaggio, con prompt testuali e senza alcun training (apprendimento zero-shot). Meta ha addestrato DINOv3 con 7 miliardi di parametri su 1,7 miliardi di immagini, rispetto a 1,1 miliardi di parametri e 142 milioni di immagini per DINOv2.
- Punti di forza: feature efficaci con pochi dati etichettati; un solo backbone per molte attività.
- Compromessi: i checkpoint più grandi sono troppo pesanti per i dispositivi edge; le licenze variano e vanno verificate.
Confronto tra modelli di classificazione delle immagini#
I modelli sono elencati in ordine alfabetico, non in base alla classifica. Non abbiamo incluso i valori di accuratezza: i numeri pubblicati su ImageNet variano in base alla risoluzione, ai dati di pretraining e al protocollo di valutazione, quindi non sono confrontabili tra queste righe. L'articolo o la documentazione di ciascun modello, linkati qui sotto, riportano i relativi valori.
| Modello | Famiglia | Autore | Pretraining | Ideale per | Principale compromesso |
|---|---|---|---|---|---|
| ConvNeXt V2 | CNN | Meta | Autoencoding mascherato auto-supervisionato (FCMAE), seguito da fine-tuning supervisionato | CNN accurata e distribuibile, disponibile in molte dimensioni | I pesi per ImageNet sono CC-BY-NC (uso non commerciale) |
| DINOv3 | Auto-supervisionato (ViT e ConvNeXt) | Meta | Auto-supervisionato su 1,7 miliardi di immagini | Feature congelate efficaci, pochi dati etichettati | Licenza DINOv3 personalizzata; il modello più grande ha 7 miliardi di parametri |
| EfficientNetV2 | CNN | Supervisionato | Training rapido, fine-tuning efficiente | Architettura più datata; i backbone più recenti offrono maggiore accuratezza | |
| EVA-02 | ViT | BAAI | Modellazione di immagini mascherate su feature CLIP | Ricerca e fine-tuning orientati alla massima accuratezza | Le varianti più grandi sono pesanti in inferenza |
| MobileNetV4 | CNN e ibrido (dispositivi mobili) | Supervisionato | Telefoni, NPU e acceleratori edge | Limite massimo di accuratezza inferiore rispetto ai modelli per server | |
| ResNet | CNN | Microsoft Research | Supervisionato | Baseline, formazione, pipeline legacy | Non è più competitiva per accuratezza per FLOP |
| SigLIP 2 | Visione-linguaggio (ViT) | Coppie di immagini e testo, multilingue | Classificazione zero-shot e a vocabolario aperto | Convalida i risultati zero-shot sulle classi di interesse prima di farci affidamento | |
| Swin Transformer | ViT (gerarchico) | Microsoft Research | Supervisionato | Input ad alta risoluzione, riutilizzo del backbone | Più pesante delle CNN a parità di accuratezza |
| Ultralytics YOLO26-cls | CNN | Ultralytics | Supervisionato su ImageNet | Classificatori personalizzati veloci, esportazione edge, un'unica API per il rilevamento | Limite massimo di accuratezza inferiore rispetto ai grandi Transformer preaddestrati |
| ViT | ViT | Supervisionato, spesso su grandi dataset | Transfer learning su larga scala | Richiede molti dati senza un pretraining su larga scala |
Approfondimento sui modelli#
Elencati in ordine alfabetico.
ConvNeXt V2#
ConvNeXt V2 combina un autoencoder convoluzionale mascherato (FCMAE) con un livello di normalizzazione della risposta globale. È disponibile in otto dimensioni, da Atto (3,7 milioni di parametri) a Huge (660 milioni), quindi la famiglia copre dispositivi edge e server. È un'ottima scelta predefinita se vuoi l'accuratezza dei Transformer moderni con la facilità di distribuzione delle CNN. Compromesso: il codice è concesso in licenza MIT, ma i pesi preaddestrati e sottoposti a fine-tuning per ImageNet sono CC-BY-NC, il che ne impedisce l'uso commerciale.
DINOv3#
DINOv3 è il backbone per la visione auto-supervisionato di Meta. È disponibile in modelli ViT da ViT-S/16 a ViT-7B/16, oltre a modelli ConvNeXt distillati per l'uso sul dispositivo. Meta lo valuta mantenendo congelato il backbone e il repository include una testa di classificazione ImageNet per il modello 7B. È il modello da provare quando hai poche etichette e vuoi feature trasferibili. Compromesso: è distribuito con una licenza DINOv3 propria, anziché con una licenza open source standard, e i risultati più citati provengono dal modello più grande.
EfficientNetV2#
EfficientNetV2 di Google usa l'apprendimento progressivo: aumenta la dimensione delle immagini durante il training e adegua la regolarizzazione di conseguenza. In questo modo, il training è più rapido e richiede meno parametri rispetto ai modelli precedenti. Rimane una scelta affidabile per il fine-tuning su dataset piccoli o medi. Compromesso: è precedente ai backbone del periodo 2023–2025 e non è più al vertice in termini di accuratezza. Per approfondire il progetto originale, consulta la nostra panoramica di EfficientNet.
EVA-02#
EVA-02 è un Transformer standard, preaddestrato con la modellazione di immagini mascherate per ricostruire feature a partire da un grande encoder visivo CLIP. Le quattro dimensioni disponibili vanno da 6 a 304 milioni di parametri. È disponibile in timm per il fine-tuning. Compromesso: le varianti più grandi sono costose da sottoporre a fine-tuning e da distribuire, e sono eccessive per classificatori di dominio semplici.
MobileNetV4#
MobileNetV4 è la più recente famiglia mobile di Google, progettata per essere efficiente su CPU mobili, DSP, GPU, Apple Neural Engine e Google Pixel EdgeTPU. È la scelta naturale per un telefono o un acceleratore a basso consumo. Compromesso: sacrifica l'accuratezza massima in favore della latenza.
ResNet#
ResNet ha introdotto le connessioni residue ed è ancora la baseline standard, supportata da tutti i framework. Compromesso: le CNN più recenti raggiungono una maggiore accuratezza a parità di calcolo. Scopri cos'è ResNet-50 per conoscere l'architettura.
SigLIP 2#
SigLIP 2 (consulta la nostra voce del glossario SigLIP) è una famiglia di encoder visione-linguaggio multilingue di Google. Può classificare immagini confrontandole con un elenco di etichette testuali senza alcun training (con un approccio simile a CLIP) e la sua variante NaFlex mantiene le proporzioni originali dell'input. È la scelta più adatta se il tuo set di etichette cambia spesso o non hai ancora dati etichettati. Compromesso: la qualità zero-shot varia in base al dominio, quindi convalidala sulle classi di tuo interesse (per esempio, i tipi di difetto) prima di farci affidamento. Se i risultati non sono sufficienti, addestra una testa di classificazione o esegui il fine-tuning.
Swin Transformer#
Swin Transformer calcola l'attenzione all'interno di finestre locali sfalsate, mantenendo il calcolo lineare rispetto alle dimensioni dell'immagine e adattandosi così agli input ad alta risoluzione. Compromesso: è più pesante di una CNN con accuratezza simile; ConvNeXt è stato progettato per competere con Swin Transformer usando convoluzioni standard.
Ultralytics YOLO26-cls#
Ultralytics YOLO26-cls è la variante per la classificazione di Ultralytics YOLO26. È disponibile in cinque dimensioni (n, s, m, l, x), da 2,8 a 29,6 milioni di parametri (dopo la fusione), accetta input da 224 pixel ed è preaddestrato su ImageNet. La documentazione riporta l'accuratezza top-1 e top-5 sul set di validazione ImageNet, nonché la latenza su CPU e GPU per ciascuna dimensione. La stessa API Python e la stessa CLI consentono di addestrare, convalidare ed esportare modelli di classificazione, rilevamento, segmentazione e stima della posa; i classificatori si esportano in formati come ONNX, TensorRT, Core ML, OpenVINO e LiteRT. I precedenti modelli YOLO11-cls usano le stesse cinque dimensioni e la stessa dimensione di input. Compromessi:
- Limite massimo di accuratezza. Anche la versione x è piccola rispetto ai grandi Transformer preaddestrati, come EVA-02 o DINOv3, quindi non è la scelta ideale per la ricerca orientata alla massima accuratezza.
- Ritagli quadrati per impostazione predefinita. Il training usa un ritaglio casuale ridimensionato, mentre la convalida usa un ritaglio centrale; entrambi possono tagliare parti di immagini con proporzioni estreme. La documentazione spiega come sostituirli con un semplice ridimensionamento.
- Licenza. I modelli Ultralytics sono distribuiti con licenza AGPL-3.0. Per l'uso commerciale con codice sorgente chiuso serve una licenza Ultralytics Enterprise.
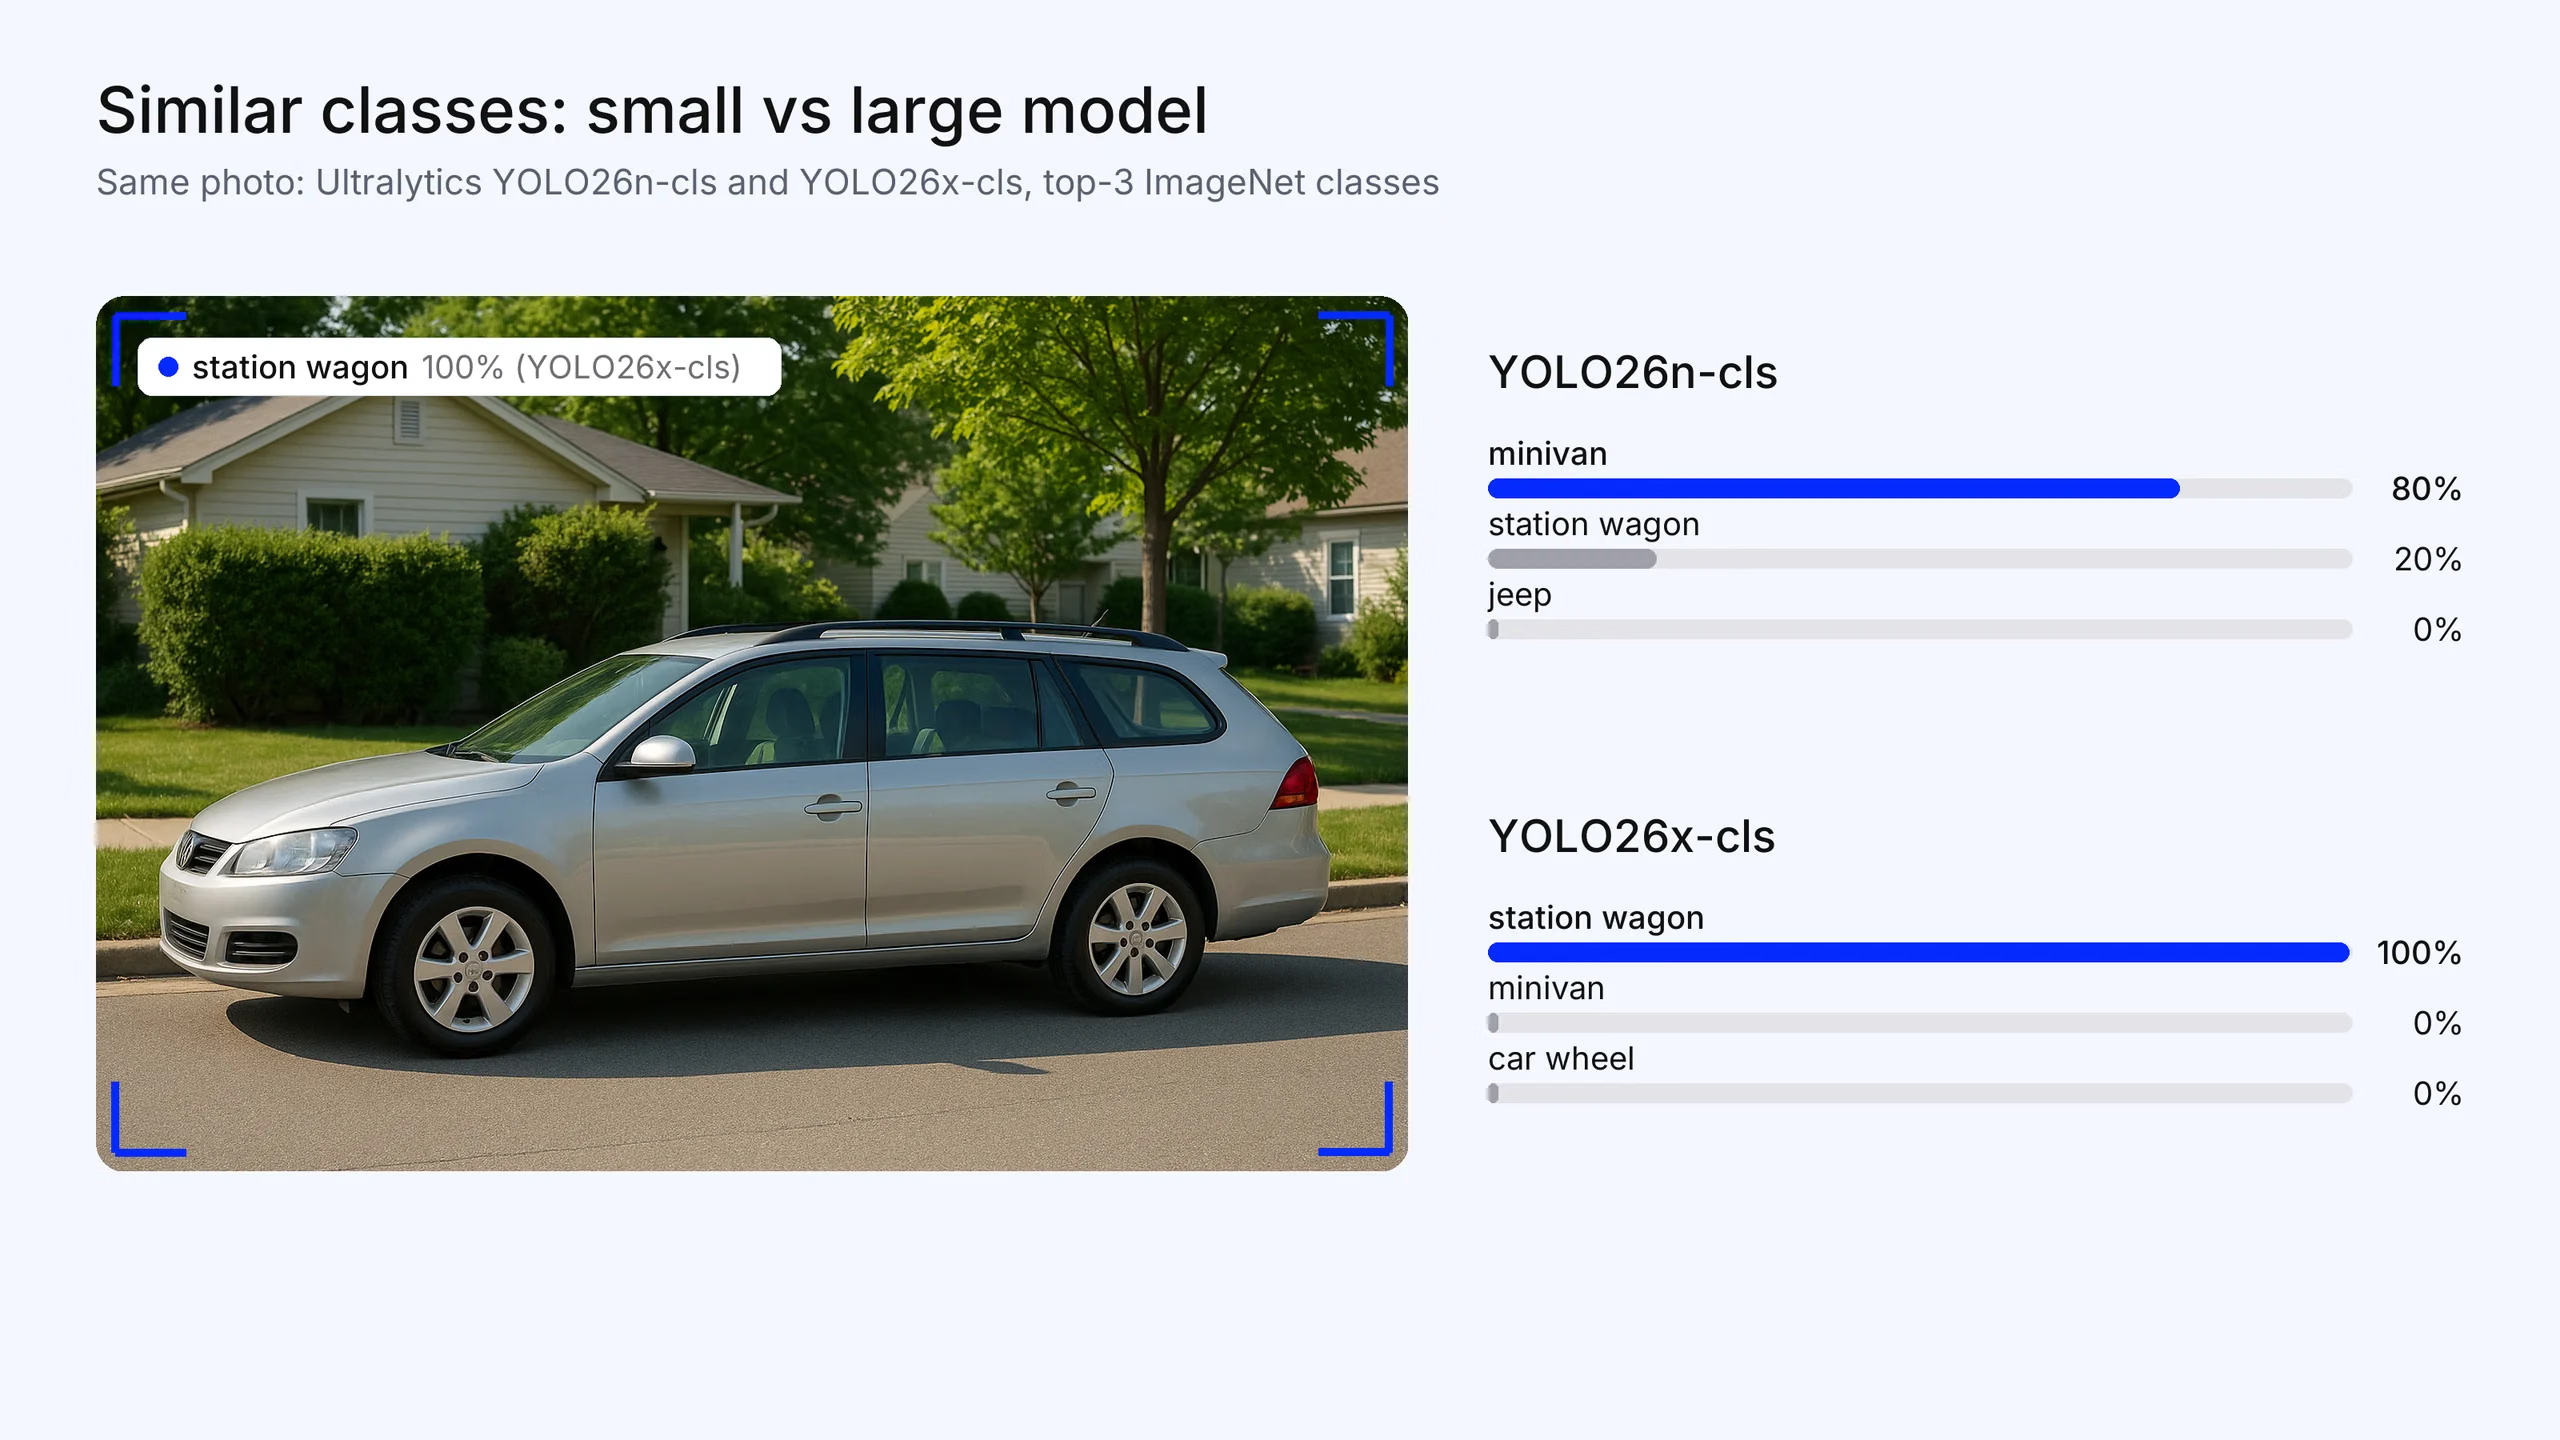
Fig. 2. È con le classi simili che si nota la differenza dovuta alle dimensioni del modello. In questa foto di una station wagon, Ultralytics YOLO26n-cls classifica per prima «minivan» (80%), mentre YOLO26x-cls classifica per prima station wagon (100%, indicata dalla classe ImageNet «beach wagon, station wagon»). Verifica classi così specifiche sul tuo set di convalida. La foto è stata generata per questo articolo; le predizioni sono output reali del modello.
ViT#
L'originale Vision Transformer di Google ha dimostrato che un Transformer puro applicato a patch di immagini può eguagliare o superare le CNN se preaddestrato su grandi quantità di dati. Compromesso: senza un preaddestramento su larga scala, le prestazioni sono inferiori a quelle delle CNN sui dataset piccoli e l'inferenza richiede più risorse di calcolo.
Come scegliere un modello di classificazione delle immagini#
Valuta queste domande nell'ordine indicato:
- Hai dati etichettati? Se non hai esempi etichettati, inizia con un modello visione-linguaggio come SigLIP 2 per la classificazione zero-shot. Con un dataset etichettato di piccole dimensioni, valuta anche un backbone DINOv3 congelato con una testa lineare addestrata.
- Dove verrà eseguito? Su un telefono o una NPU, considera MobileNetV4 o una CNN piccola come YOLO26n-cls o una versione compatta di ConvNeXt V2. Se ti serve l'elaborazione in tempo reale su una GPU edge o una CPU, valuta YOLO26-cls, EfficientNetV2 o ConvNeXt V2. Su un server senza vincoli stringenti di latenza, considera EVA-02, Swin o un ViT DINOv3.
- Quanti dati etichettati hai per classe? Con centinaia o poche migliaia di immagini, la scelta più sicura è il transfer learning a partire da una CNN preaddestrata o da un backbone auto-supervisionato congelato. Con decine di migliaia di immagini o più, il fine-tuning completo dei Transformer inizia a dare risultati.
- Puoi usare la licenza? Controlla i pesi, non solo il codice: i pesi ImageNet di ConvNeXt V2 non sono destinati all'uso commerciale, DINOv3 ha una licenza propria e i modelli Ultralytics sono soggetti ad AGPL-3.0, a meno che tu non abbia una licenza Enterprise.
- È esportabile nel tuo runtime? Prima di decidere, verifica che sia supportato un percorso di esportazione verso ONNX, TensorRT, Core ML o TFLite.
Poi esegui il fine-tuning di due o tre modelli selezionati e confrontali sul tuo split di convalida.
Quando un altro modello è più adatto di YOLO#
YOLO26-cls è progettato per classificatori personalizzati veloci e facili da distribuire. Per alcuni casi d'uso è più indicato un altro modello:
- Ricerca o benchmark in cui la priorità è la precisione: usa EVA-02, ConvNeXt V2 o un ViT tramite timm, per cui sono disponibili ricette e pesi che consentono di riprodurre risultati di livello ImageNet.
- Pochissime etichette o molte attività a valle basate su un unico backbone: usa le feature DINOv3 con una testa lineare.
- Set di etichette aperti o soggetti a frequenti cambiamenti: usa SigLIP 2 zero-shot.
- NPU per telefoni, come Apple Neural Engine o EdgeTPU: MobileNetV4 è stato progettato e testato proprio su questi dispositivi.
Se oltre a sapere cosa mostra l'immagine devi anche individuare la posizione degli oggetti, ti serve un detector. Consulta il nostro confronto tra modelli di rilevamento degli oggetti.
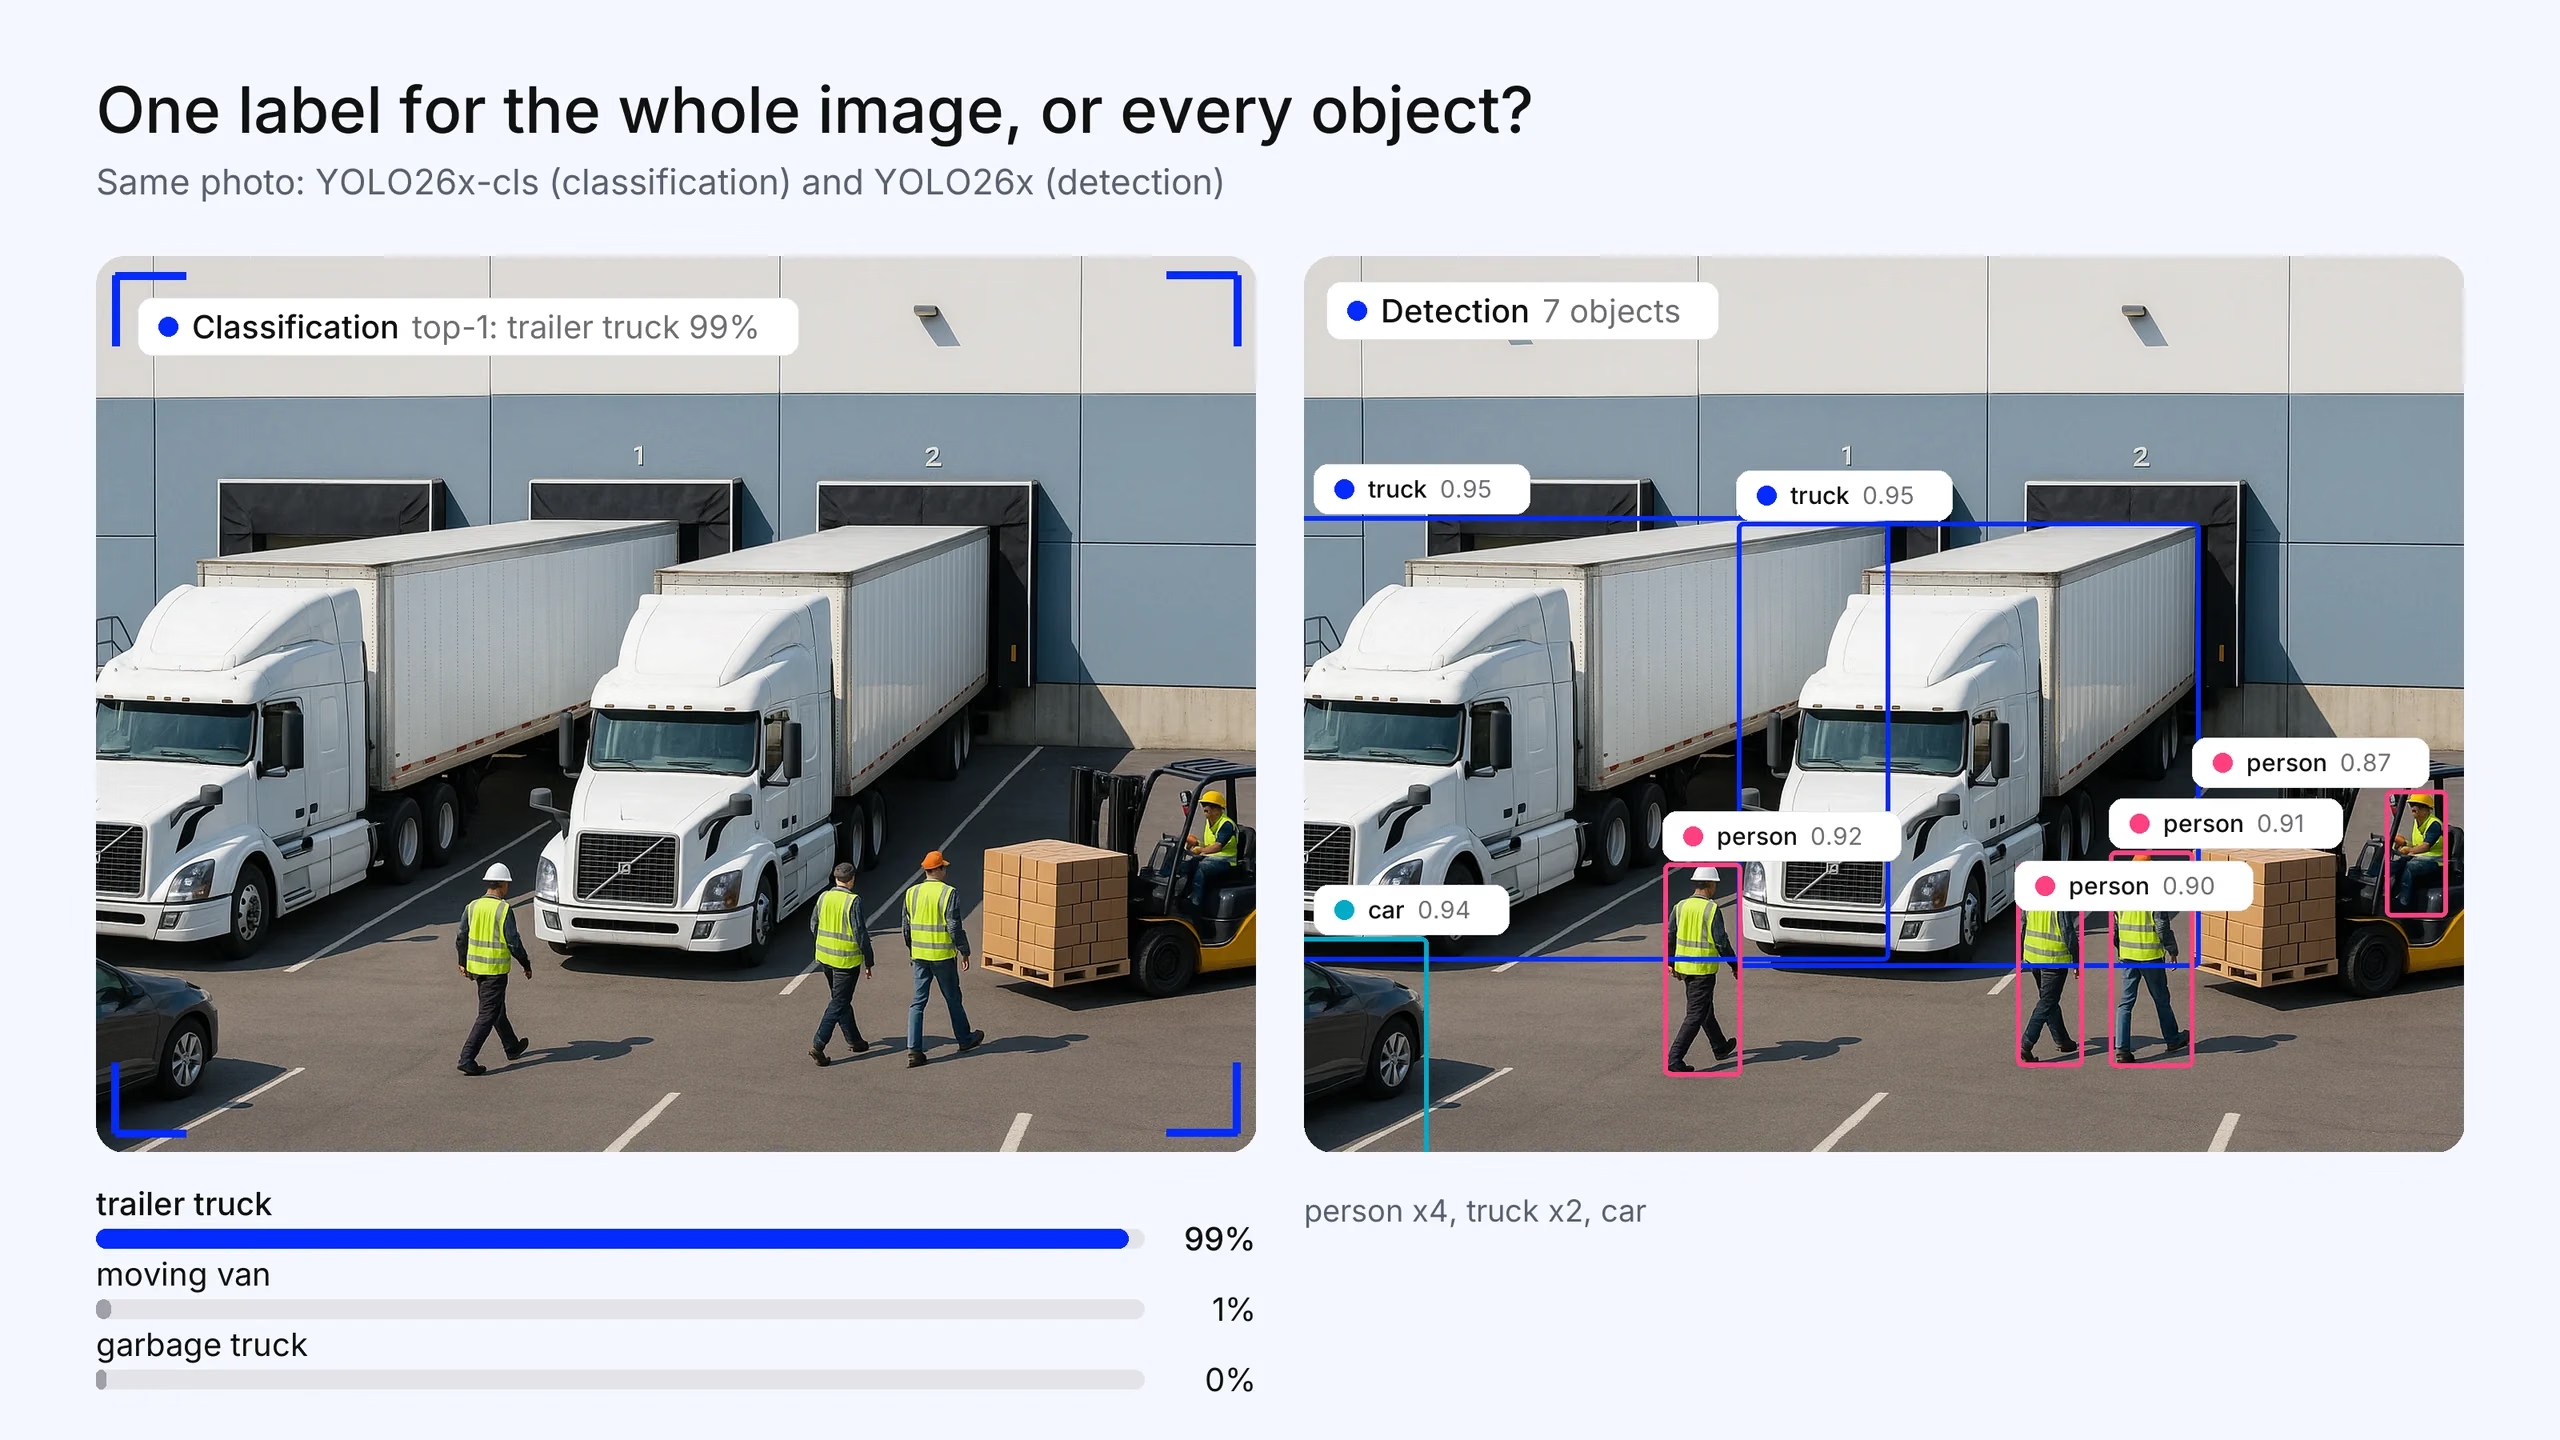
Fig. 3. In una scena con molti oggetti, un classificatore restituisce comunque una sola etichetta: Ultralytics YOLO26x-cls classifica questo piazzale di distribuzione come «camion con rimorchio» al 99%. Il rilevamento di Ultralytics YOLO26x individua 7 oggetti: 4 persone, 2 camion e un'auto, ognuno con il proprio riquadro (confidenza pari o superiore a 0,5). La foto è stata generata per questo articolo; gli output sono reali.
Dove trovare modelli preaddestrati e addestrarne di tuoi#
- timm (PyTorch Image Models) raccoglie la maggior parte dei backbone citati sopra, da ViT e ConvNeXt a MobileNetV4, EVA e DINOv3, insieme a script di addestramento e valutazione. Il codice è rilasciato con licenza Apache 2.0; le licenze dei pesi variano.
- Hugging Face ospita la maggior parte dei classificatori basati su Transformer, tra cui SigLIP 2 e DINOv3, con pipeline già pronte per la classificazione zero-shot e delle immagini.
- Il pacchetto Python di Ultralytics addestra YOLO26-cls su una cartella di immagini suddivise in base alla classe. Consulta il formato dei dataset di classificazione e la guida all'attività di classificazione.
- Ultralytics Platform aggiunge l'annotazione e l'addestramento nel cloud per gli stessi modelli. È stata lanciata nel 2026, quindi è più recente dei servizi di addestramento ospitati già affermati. Per distribuire i modelli dopo l'addestramento, consulta il nostro confronto tra piattaforme di inferenza per la visione artificiale.
Domande frequenti
Non esiste un modello migliore in ogni situazione. Per i lavori in cui la priorità è la precisione e le risorse di calcolo sono abbondanti, i primi modelli da valutare sono i grandi backbone basati su Transformer e auto-supervisionati, come EVA-02 e DINOv3. Per la produzione su hardware limitato, sono più pratiche le CNN come ConvNeXt V2, EfficientNetV2, MobileNetV4 e Ultralytics YOLO26-cls. Per classificare senza dati etichettati, SigLIP 2 supporta la classificazione zero-shot.
I Transformer tendono a prevalere se preaddestrati su dataset molto grandi e quando le risorse di calcolo non sono limitate. Le CNN tendono a prevalere sui dataset di piccole o medie dimensioni e sull'hardware edge, perché le loro ipotesi incorporate sulla struttura locale le rendono efficienti nell'uso dei dati e veloci. CNN moderne come ConvNeXt hanno ridotto il divario di precisione, mentre architetture ibride come CoAtNet combinano entrambi gli approcci.
Sì. DINOv3 è un backbone general-purpose. Estrai le feature con il modello congelato e addestri una piccola classificatore lineare in cima; il repository di Meta include una testa di classificazione ImageNet per il modello più grande. Prima dell'uso commerciale, controlla la licenza DINOv3.
Principalmente con l'accuratezza top-1 (la predizione con il punteggio più alto è corretta) e top-5 (la classe corretta è tra le cinque predizioni con il punteggio più alto), di solito sul set di convalida ImageNet. Nei dataset personalizzati sbilanciati, precisione, richiamo o F1 per classe sono più informativi dell'accuratezza complessiva.









