Come scegliere un VLM per l'annotazione automatica usando precisione e richiamo
Scegli un VLM per l'annotazione automatica in base a precisione e richiamo: quali modelli generano meno riquadri indesiderati, quali mancano meno oggetti e come testarli sui tuoi dati.
 Sergiu Waxmann16 min di lettura
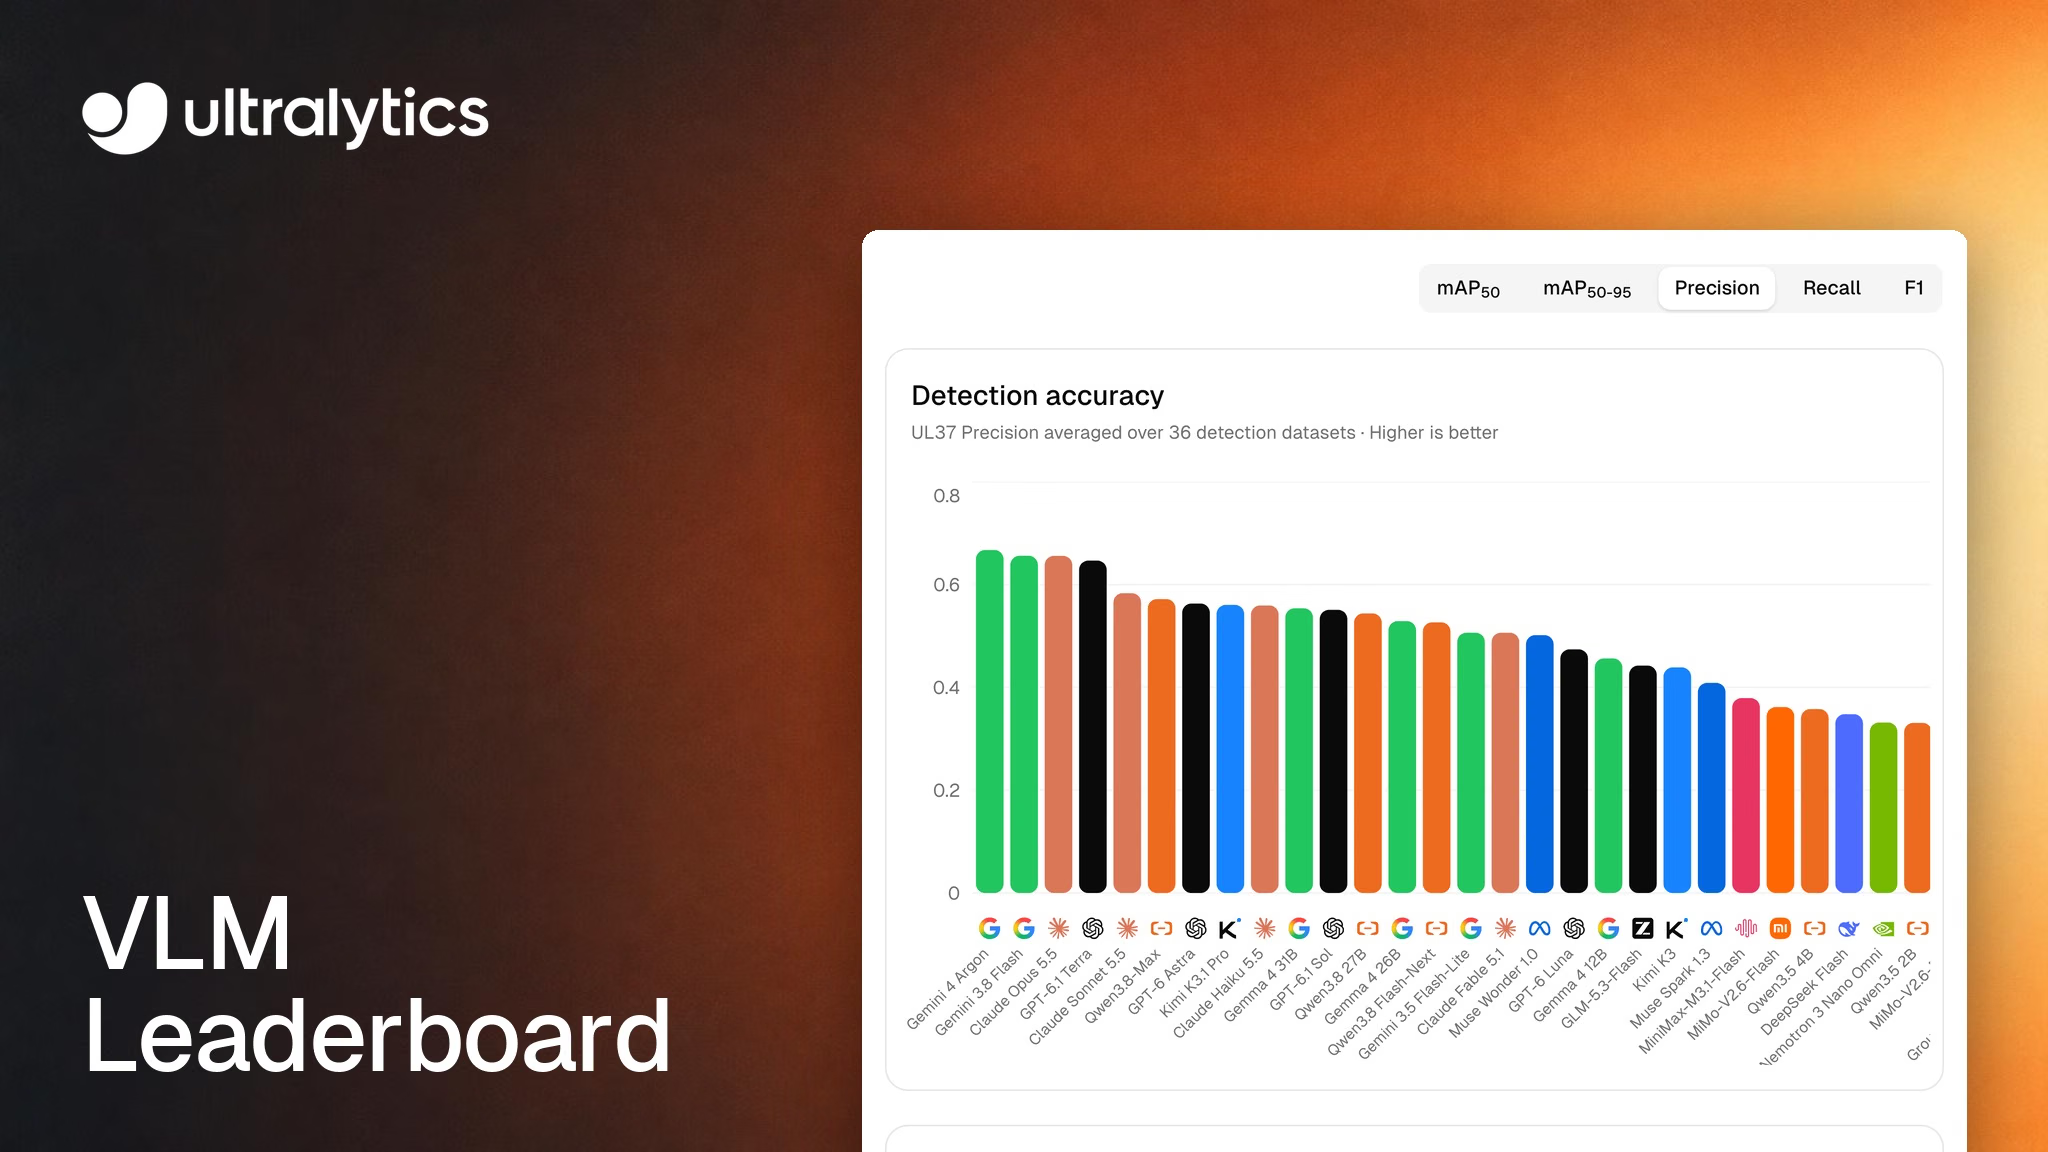
Scegliere un modello per annotare automaticamente un dataset dipende dal tipo di correzioni che i revisori preferiscono fare: eliminare i riquadri in eccesso o aggiungere quelli che il modello non ha rilevato. La classifica VLM di Ultralytics mostra ora questo compromesso per ogni modello, con precisione (la quota di riquadri del modello corretti) e richiamo (la quota di oggetti etichettati che individua), sulla base dei risultati del benchmark pubblicati il 28 ottobre 2026.
Per ottenere le bozze iniziali più pulite, inizia con Gemini 4 Argon. Per non perdere quasi nessun oggetto, inizia con GPT-6 Astra. Per il miglior equilibrio e il costo più basso tra i sei modelli con i punteggi più alti, scegli GPT-6.1 Terra. Se non hai una tua chiave API per un provider di IA, inizia con Qwen3.8 27B ospitato oppure con SAM 3.1 Text per le scene affollate in cui preferisci eliminare i riquadri superflui.
Questa guida spiega come interpretare i numeri, in quali casi è adatto ciascun modello e come verificare la tua scelta sulle tue immagini. Le classifiche e i prezzi cambiano dopo ogni esecuzione, quindi considera i dati qui riportati come esempi di ottobre 2026 e consulta la classifica per i risultati aggiornati.
I modelli basati su prompt di classe non hanno un cursore della confidenza, quindi la scelta del modello determina la soglia#
Con un modello Ultralytics YOLO nell'editor delle annotazioni, regoli tu il compromesso. Aumenta la soglia di confidenza per ottenere meno riquadri falsi e più oggetti non rilevati; abbassala e succede il contrario. I modelli di visione-linguaggio (VLM) basati su prompt di classe funzionano diversamente. Come spiegato nella documentazione dell'editor delle annotazioni, rilevano le classi del tuo dataset usando soglie specifiche del modello e non restituiscono punteggi di confidenza, perciò Ultralytics Platform nasconde le impostazioni di confidenza e IoU quando ne selezioni uno.
Questo cambia il significato di precisione e richiamo nella classifica. Secondo la metodologia del benchmark, precisione e richiamo conteggiano ogni riquadro restituito da un modello con una IoU di 0,5, senza un punto operativo nascosto. Descrivono i riquadri che ricevono effettivamente i tuoi revisori.
Il benchmark alla base della classifica è UL37 v2: 10 immagini da ciascuno dei 36 dataset reali di rilevamento di oggetti su Platform, più 10 immagini di riferimento COCO 2017 valutate separatamente, per un totale di 370 immagini e 7.268 riquadri. Ogni immagine passa attraverso la stessa pipeline di produzione usata da Smart e Batch Annotation, con i nomi delle classi del dataset, e SAM 3.1 perfeziona i riquadri di ogni modello, tranne quelli di SAM 3. La valutazione usa le metriche di rilevamento del pacchetto Ultralytics, lo stesso codice che convalida i modelli YOLO, e attribuisce lo stesso peso a ogni dataset nel calcolo della media.
La precisione misura i riquadri non abbinati, il richiamo gli oggetti non abbinati#
La precisione è la percentuale dei riquadri del modello che corrispondono a un oggetto etichettato della classe corretta con IoU 0,5. Il richiamo è la percentuale degli oggetti etichettati a cui il modello ha abbinato un riquadro. In termini di revisione:
- Una precisione bassa significa più riquadri da eliminare, rietichettare o ridimensionare finché non corrispondono.
- Un richiamo basso significa più oggetti etichettati a cui aggiungere un riquadro, o di cui ridimensionare o rietichettare il riquadro.
- F1 è la media armonica dei due valori, 2 x P x R / (P + R): un singolo numero che li riassume entrambi. Non misura la durata della revisione.
- mAP50 e mAP50-95 classificano i modelli in base alla precisione media tra le classi, con IoU 0,5 e alle soglie più rigorose da 0,50 a 0,95. mAP50 determina l'ordinamento della classifica.
Ecco i sei modelli con un punteggio superiore a 0,51 mAP50. Il costo è stimato in base all'uso di token dichiarato dai provider per 1.000 immagini del benchmark annotate correttamente; la latenza è il tempo mediano di risposta:
| Modello | mAP50 | mAP50-95 | Precisione | Richiamo | F1 | Costo del provider / 1.000 immagini (utilizzo nel benchmark) | Latenza |
|---|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 0.560 | 0.345 | 0.65 | 0.61 | 0.63 | $4.36 | 5.1 s |
| Gemini 4 Argon | 0.537 | 0.343 | 0.67 | 0.59 | 0.62 | $7.60* | 4.6 s |
| Claude Opus 5.5 | 0.527 | 0.333 | 0.66 | 0.59 | 0.62 | $13.92 | 2.7 s |
| GPT-6 Astra | 0.525 | 0.325 | 0.56 | 0.63 | 0.59 | $49.31 | 11.6 s |
| Gemini 3.8 Flash | 0.516 | 0.321 | 0.66 | 0.56 | 0.60 | $5.86 | 7.4 s |
| GPT-6.1 Sol | 0.514 | 0.318 | 0.55 | 0.62 | 0.58 | $10.30 | 10.5 s |
*La stima di Gemini 4 Argon usa i prezzi promozionali di Google, validi fino al 30 novembre 2026. Dal 1° dicembre, la tariffa standard di Google raddoppia, arrivando a circa $15 per 1.000 immagini con lo stesso utilizzo. Batch Annotation su Ultralytics Platform aggiunge $1.00 per 1.000 immagini elaborate per qualsiasi modello, compresi quelli ospitati.
I sei modelli si dividono in due gruppi. Argon, Opus 5.5 e Gemini 3.8 Flash hanno una precisione compresa tra 0,66 e 0,67 e un richiamo inferiore a 0,60: un'alta percentuale dei loro riquadri è corretta, ma rilevano meno oggetti etichettati. Astra e Sol raggiungono un richiamo compreso tra 0,62 e 0,63, con una precisione tra 0,55 e 0,56: rilevano una percentuale maggiore di oggetti etichettati, ma una percentuale inferiore dei loro riquadri è corretta. Terra si colloca tra i due gruppi ed è in testa per mAP50 e F1.
Dai priorità alla precisione quando correggere i riquadri indesiderati è costoso#
Con 0,667, Gemini 4 Argon ha la precisione complessiva più alta tra i 40 modelli del benchmark. Il compromesso è un richiamo medio di 0,585, inferiore a quello dei modelli leader per richiamo.
La precisione conta soprattutto quando è difficile individuare i riquadri non abbinati. In un'immagine affollata, prima di correggerlo un revisore deve trovare il riquadro errato tra molti riquadri corretti. Gli scaffali fitti di SKU110K mostrano quanto possa variare la precisione in immagini di questo tipo: nei nostri risultati di GPT-6.1 Terra, Terra ha registrato una precisione di 0,79 e un richiamo di 0,73, contro 0,49 e 0,77 di GPT-6.1 Sol.
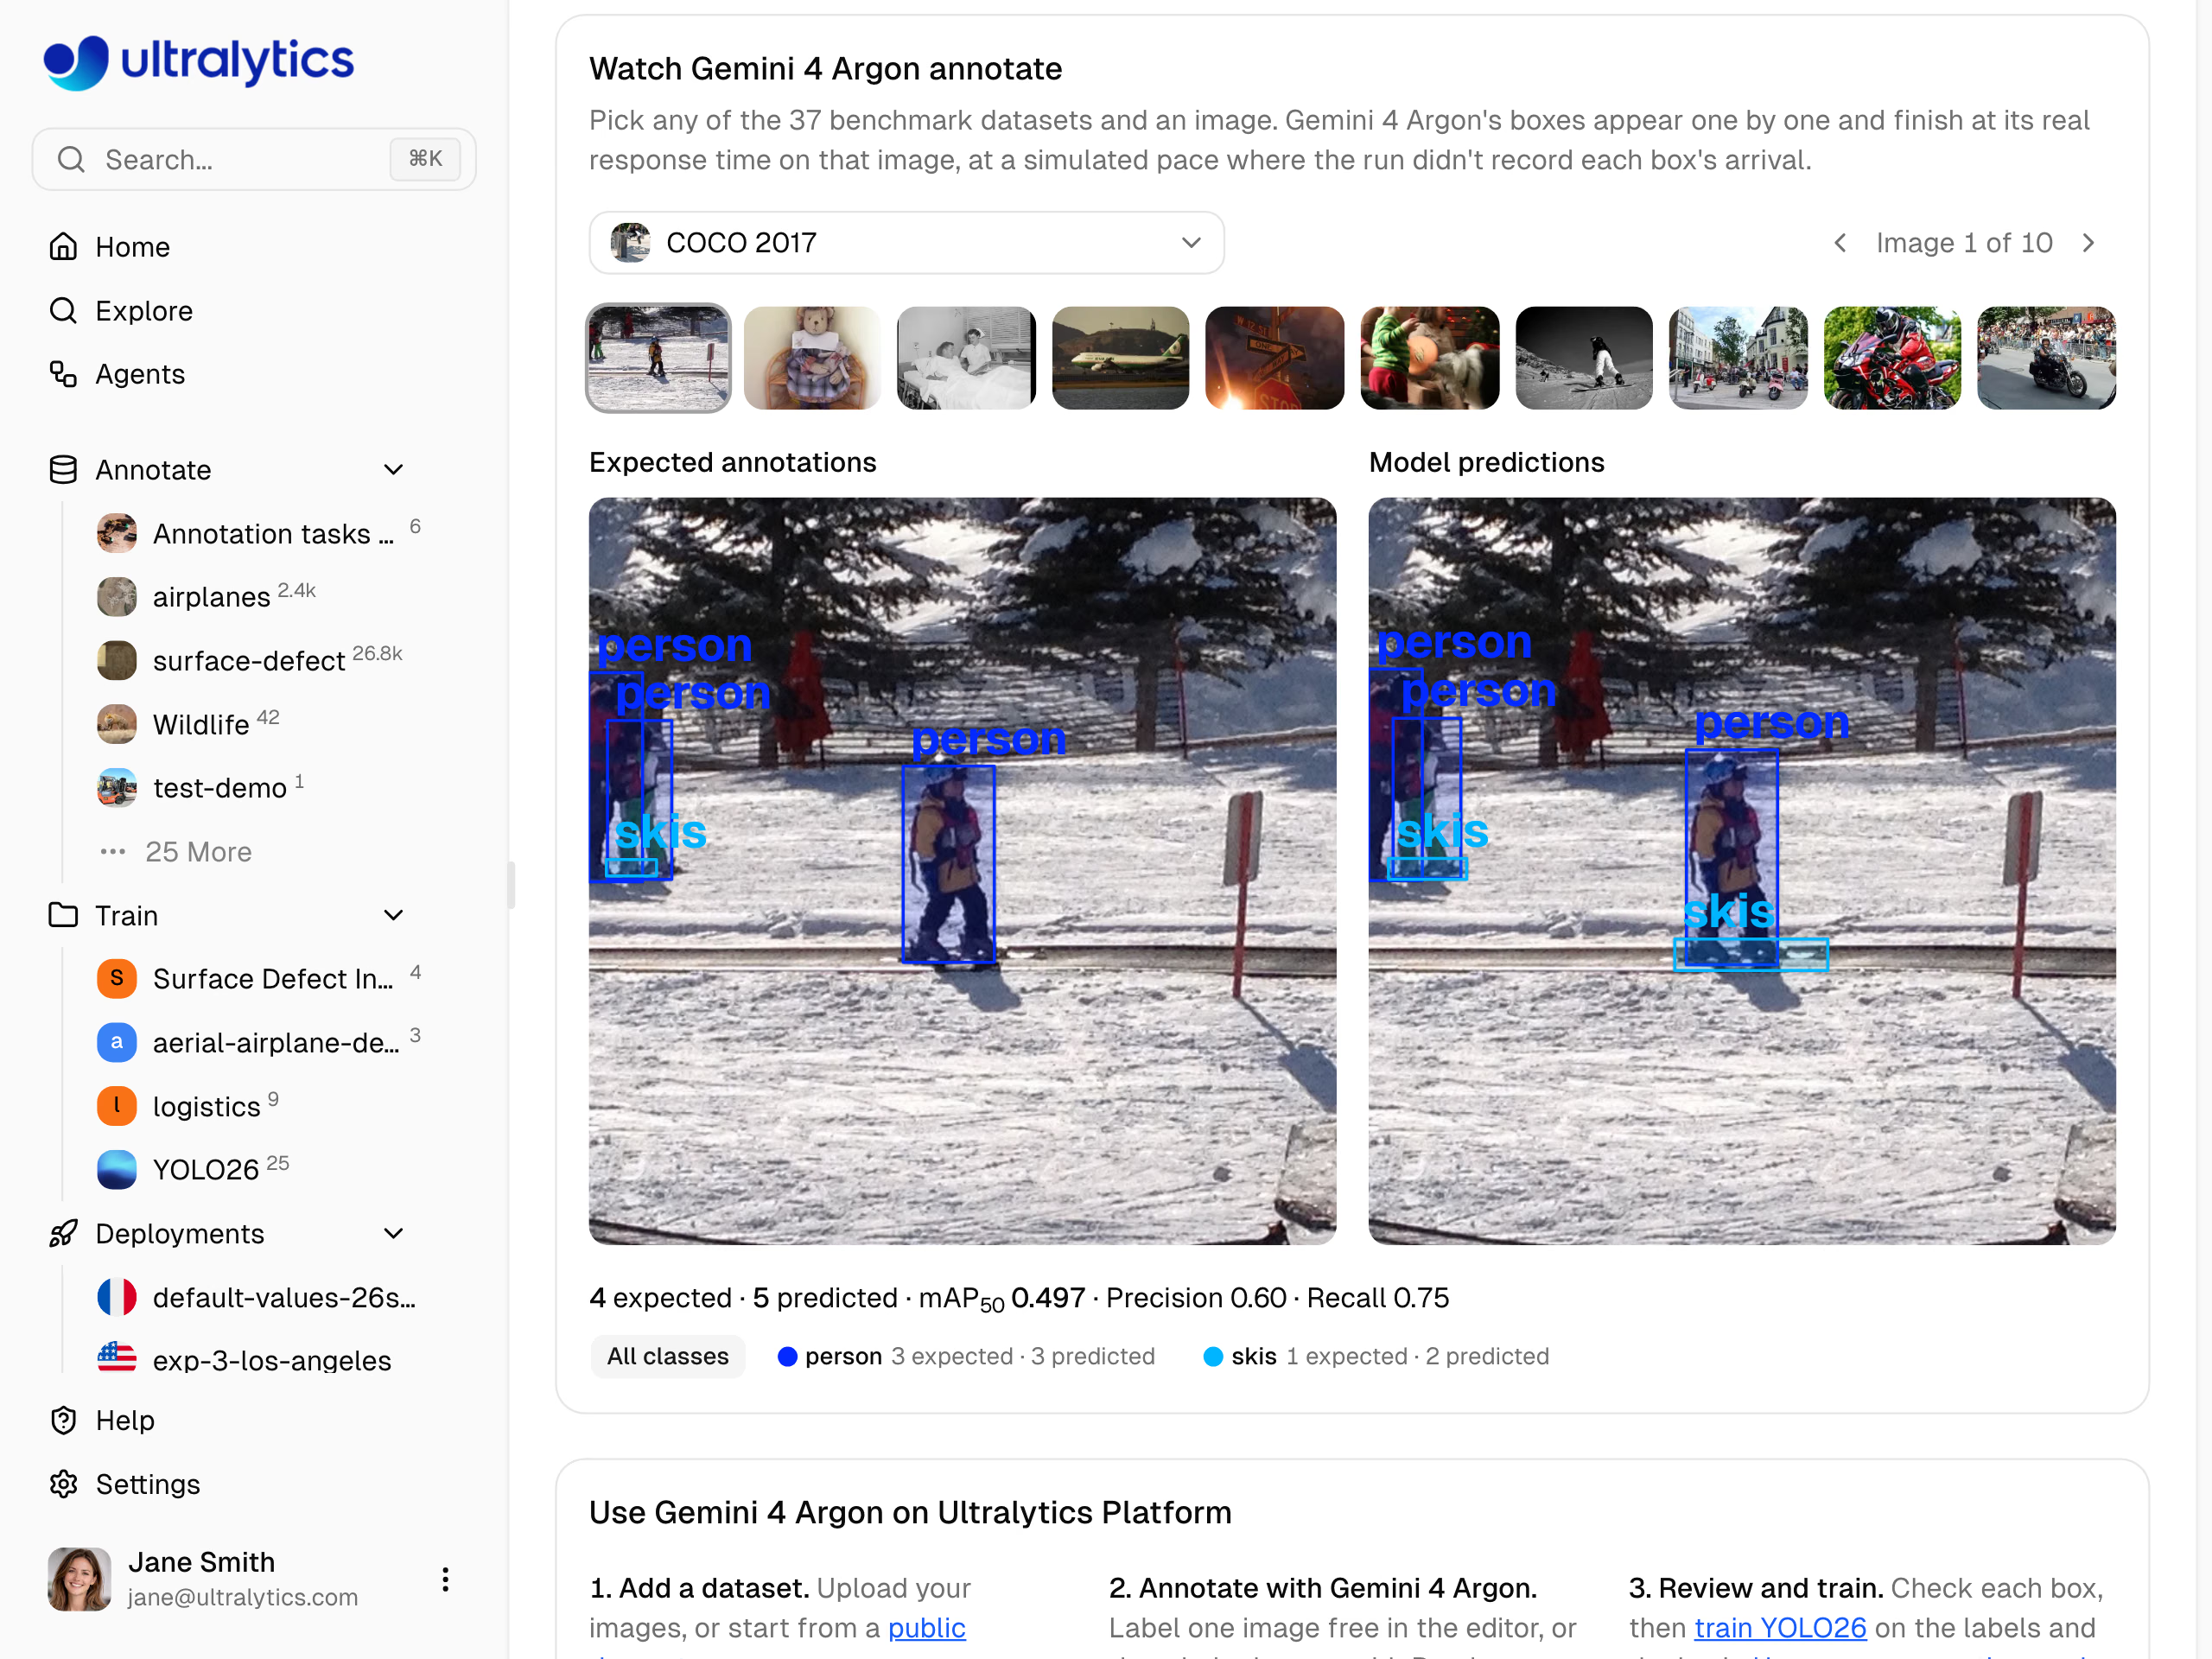
Gemini 4 Argon: 5 riquadri previsti per 4 oggetti etichettati, precisione 0,60, richiamo 0,75.
Argon non ha registrato neanche una richiesta non riuscita nel benchmark e la sua mediana di 4,6 secondi è la più rapida tra i due modelli migliori. Sceglilo quando i tuoi dati somigliano a quelli dei domini in cui ottiene i risultati migliori: immagini aeree, subacquee, termiche e radiografiche di sicurezza (registra il miglior mAP50 nelle scansioni di sicurezza IEDXray, con 0,298), e quando il tuo team preferisce completare l’annotazione di qualche oggetto non rilevato anziché cercare riquadri superflui.
Dai priorità al richiamo quando non rilevare un oggetto è un errore costoso#
GPT-6 Astra ha il richiamo medio più alto della classifica: 0,627. Il prezzo da pagare è una precisione di 0,56.
Etichettare dando priorità al richiamo ha senso quando il costo di un oggetto non etichettato è maggiore. Un difetto o una lesione non rilevati nel tuo set di addestramento insegnano al rilevatore che l’oggetto è uno sfondo, e trovare un riquadro mancante significa esaminare ogni immagine alla ricerca di qualcosa che non è contrassegnato. Astra registra il miglior mAP50 in 7 dei 36 dataset, tra cui le radiografie del torace di TBX11K (0,330), le radiografie pediatriche del polso di GRAZPEDWRI-DX (0,354) e i difetti superficiali dei PCB di DsPCBSD+ (0,394): un motivo per provarlo su dati simili, non la prova che perderà meno oggetti nei tuoi.
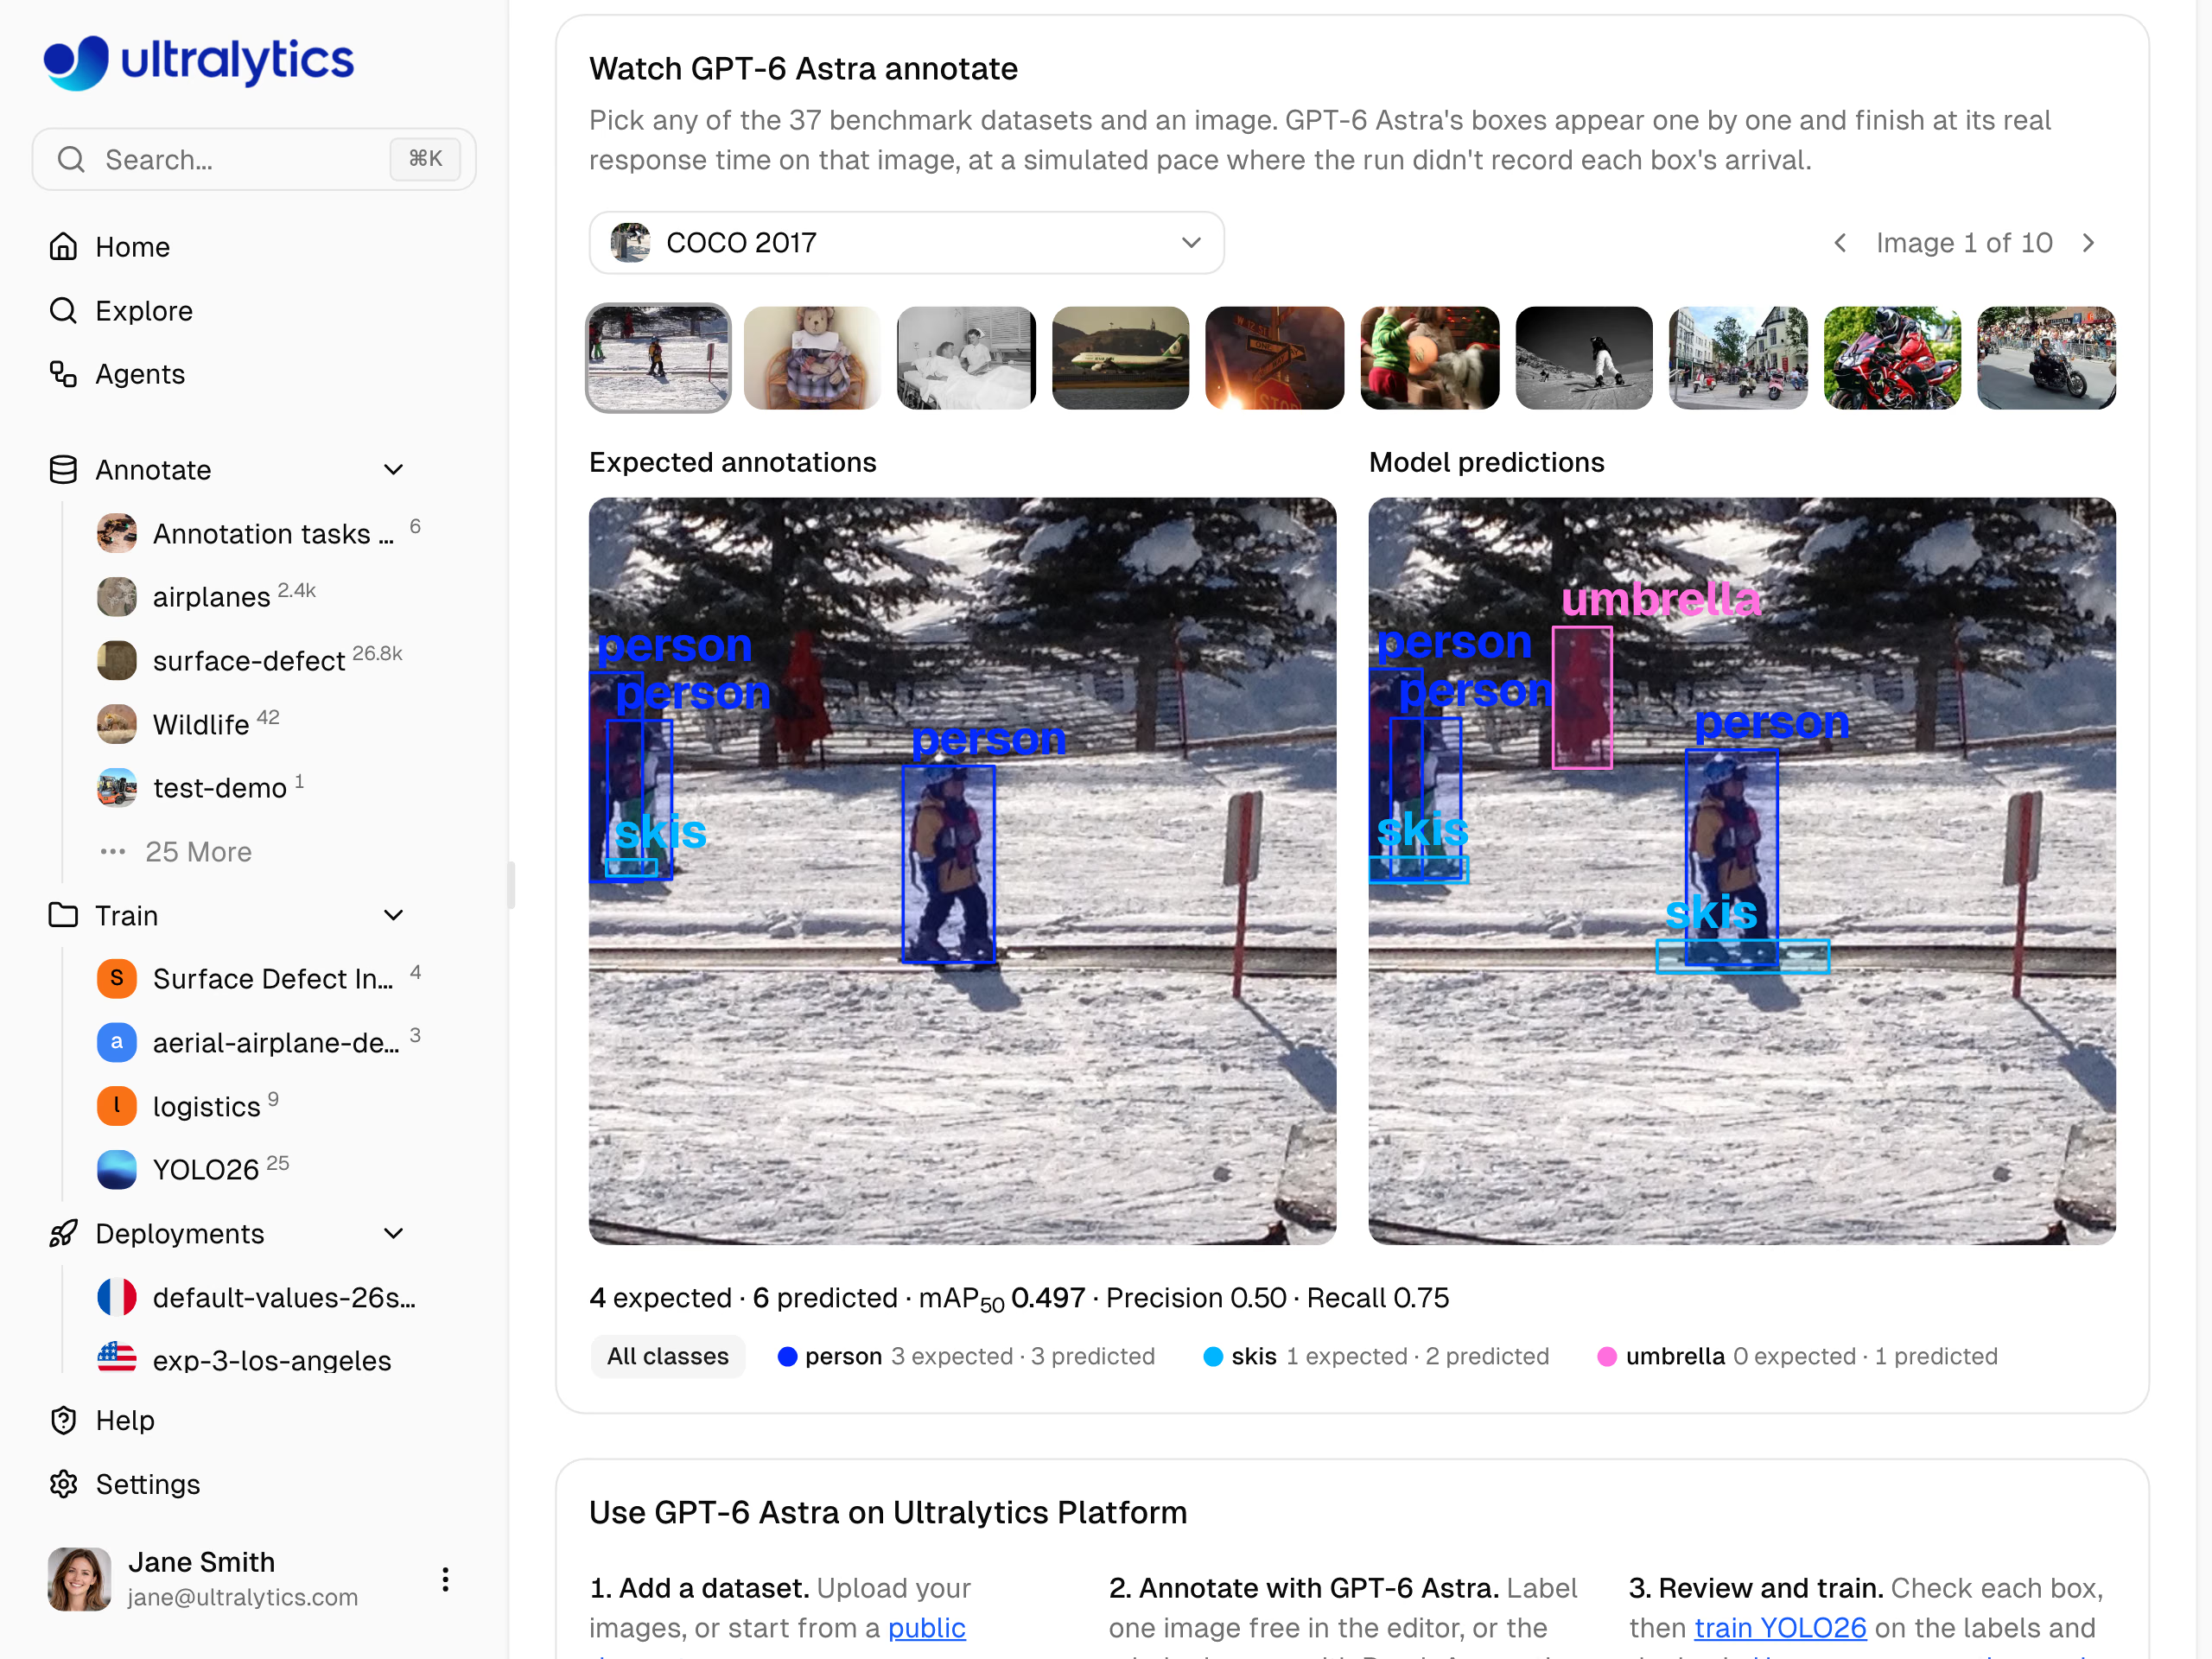
GPT-6 Astra: 6 riquadri per gli stessi 4 oggetti, compreso un ombrello escluso dalle etichette COCO, precisione 0,50, richiamo 0,75.
Astra ha la stima di costo più alta tra i sei modelli principali: $49.31 per 1.000 immagini, con una mediana di 11,6 secondi e richieste non riuscite sull'1% delle immagini. Altri due modelli OpenAI si avvicinano per richiamo: GPT-6.1 Sol a 0,62, con un costo stimato di $10.30, e GPT-6.1 Terra a 0,61, con un costo stimato di $4.36.
Valuta entrambi gli errori con mAP50-95 e F1#
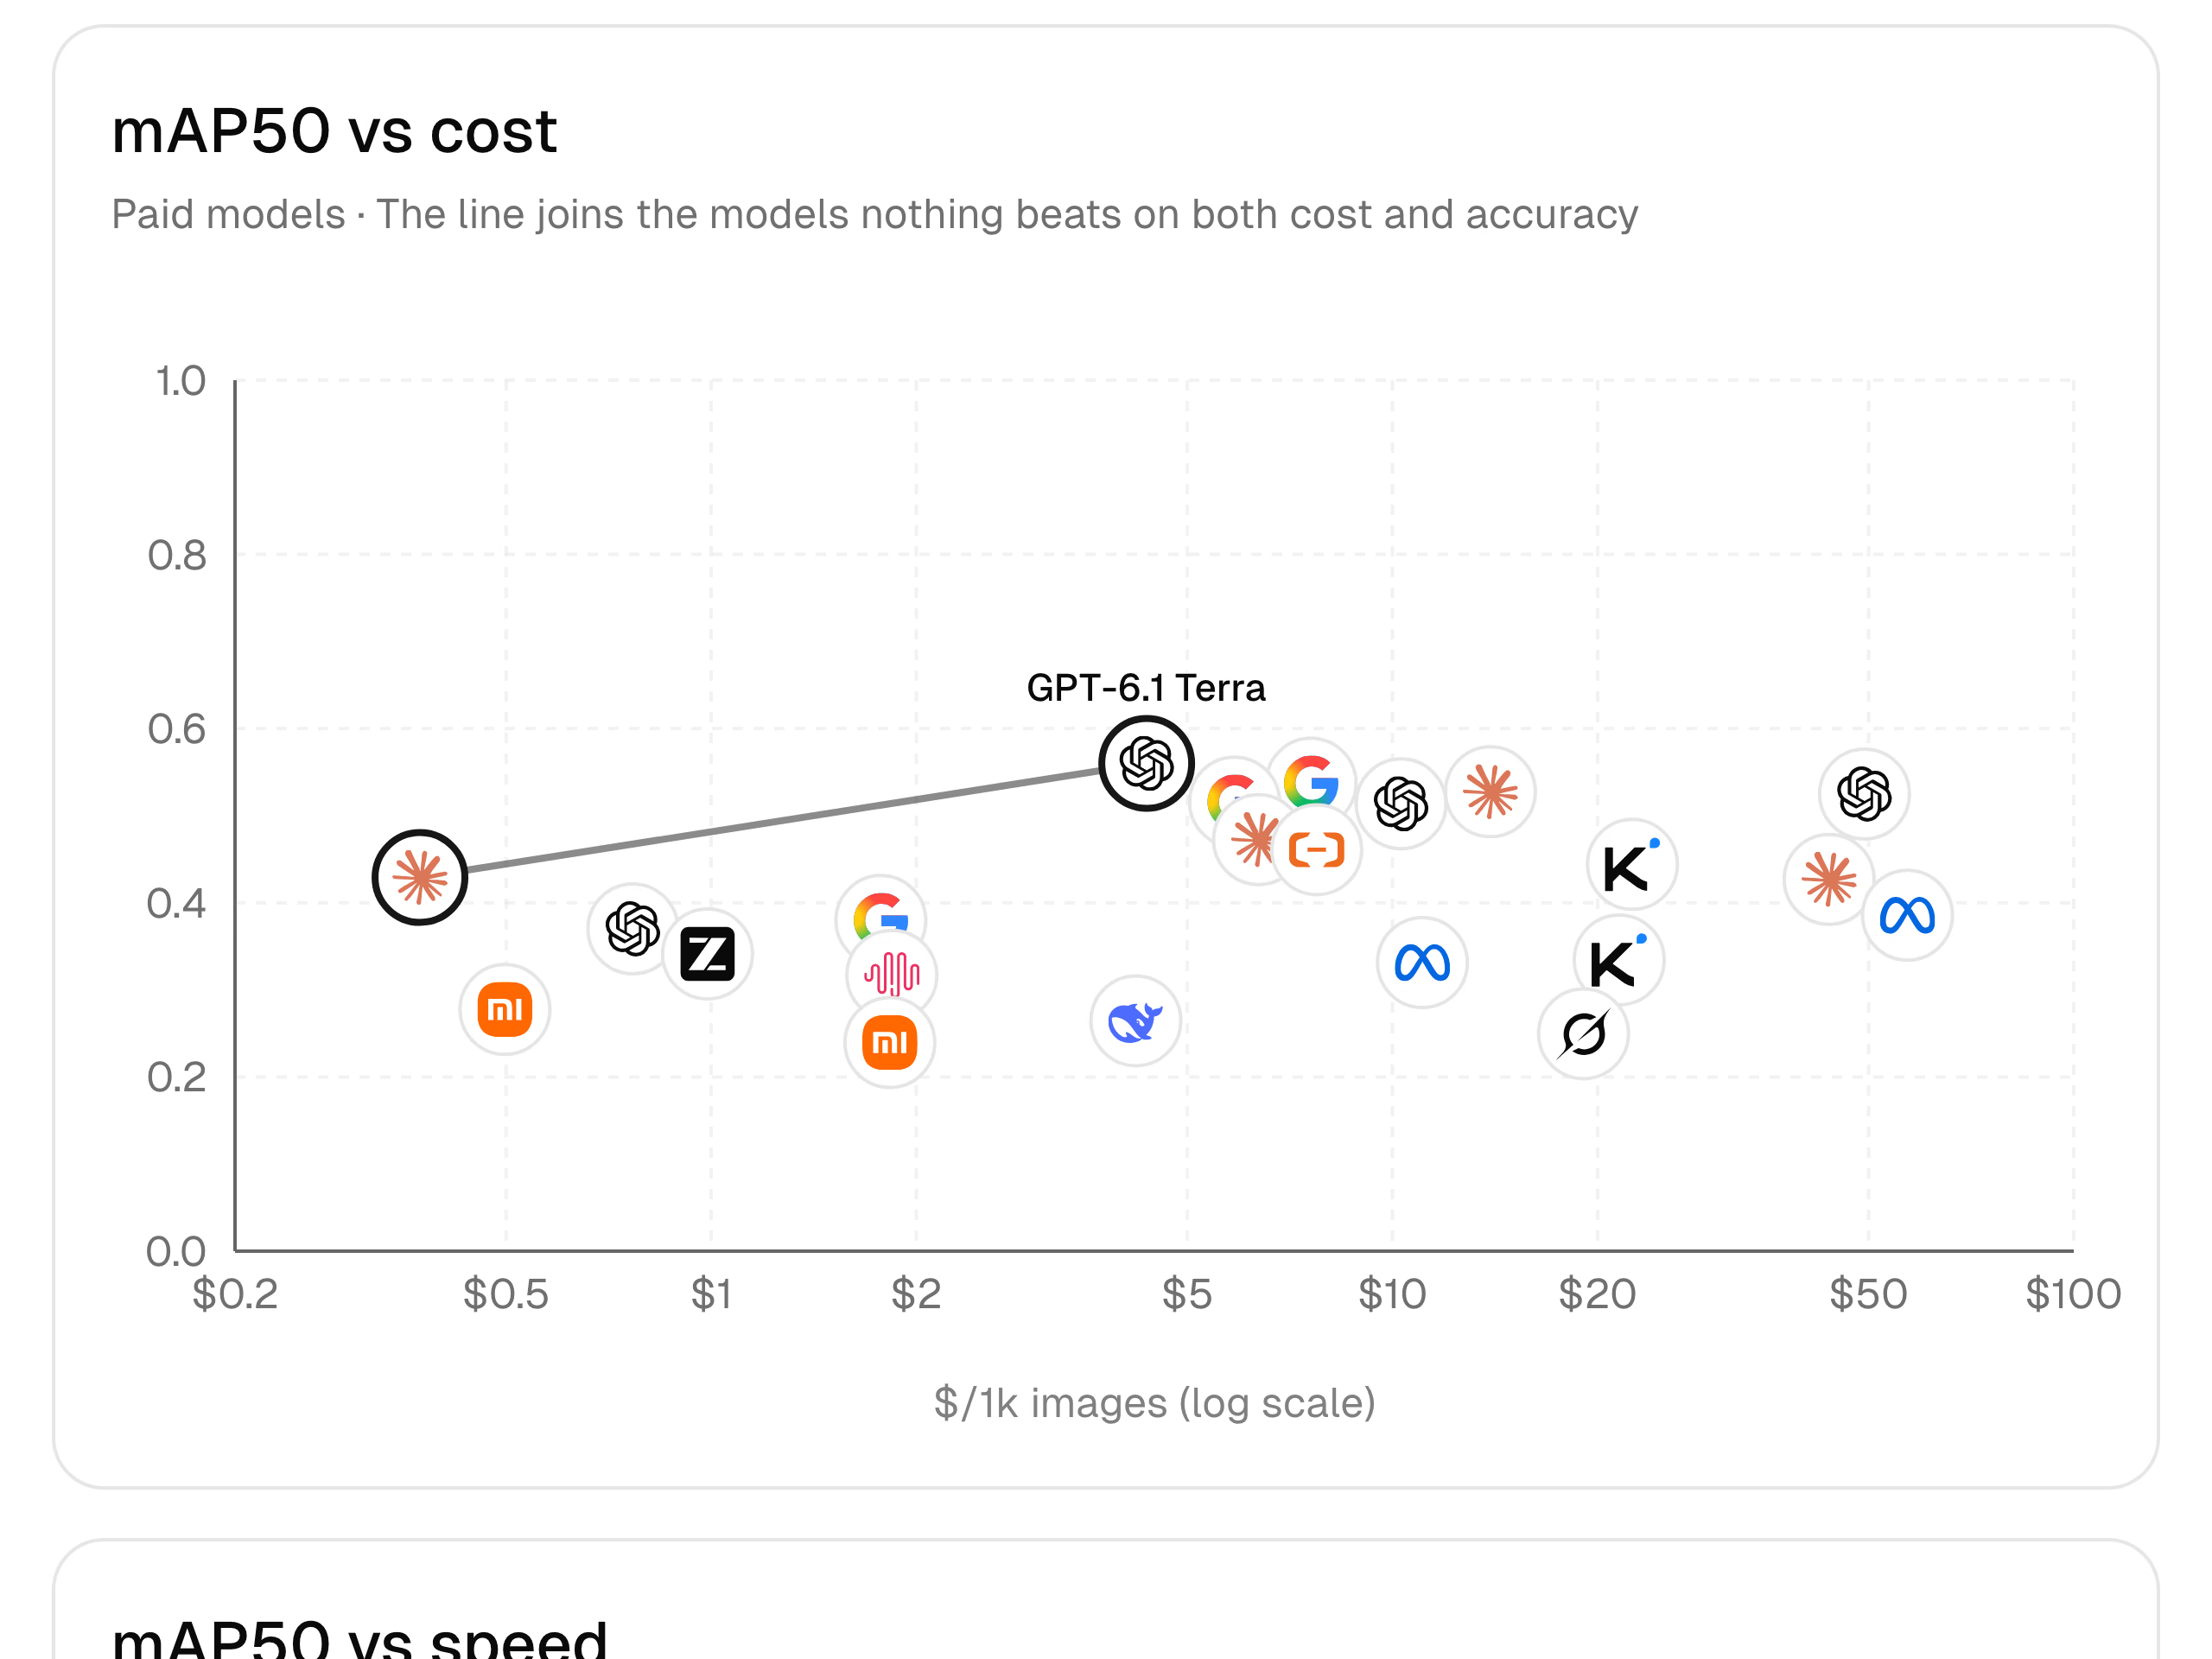
GPT-6.1 Terra è in testa alla classifica con 0,560 mAP50 e 0,345 mAP50-95. La sua precisione di 0,646 e il suo richiamo di 0,613 sono entrambi a pochi centesimi dai valori dei modelli leader, e il suo F1 di 0,63 è il più alto dei sei, appena sopra Argon e Opus 5.5 a 0,62. Con valori di F1 così vicini, e dato che F1 non dice nulla sulla durata della revisione, lascia che siano i risultati per dominio e una prova sulle tue immagini a decidere.
Il primato in mAP50-95 aggiunge un secondo indicatore. Poiché mAP50-95 calcola la media su soglie di sovrapposizione fino a 0,95, premia sia i modelli che adattano bene i riquadri agli oggetti rilevati, sia quelli che trovano gli oggetti corretti; Terra è in testa anche qui. Ha inoltre la stima di costo più bassa tra i sei modelli principali e non ha avuto richieste non riuscite; la classifica lo contrassegna come "Miglior rapporto qualità-prezzo".
Annota senza una chiave del provider: modelli ospitati e rilevatori a vocabolario aperto#
Non tutti i team vogliono una chiave di un provider a pagamento. I modelli ospitati su Platform funzionano senza chiave e le relative colonne raccontano una storia diversa:
- SAM 3.1 Text: 0,332 mAP50, 0,19 di precisione, 0,47 di richiamo, 0,2 s per immagine. È il migliore tra tutti i 40 modelli su VisDrone (0,479 mAP50) e nel traffico Fisheye8K (0,478).
- Qwen3.8 27B: 0,351 mAP50, 0,54 di precisione, 0,40 di richiamo, 1,5 s.
- Gemma 4 26B: 0,344 mAP50, 0,53 di precisione, 0,39 di richiamo, 0,9 s.
Anche i rilevatori a vocabolario aperto sono ospitati. In questo benchmark, OWLv2 Large ha ottenuto 0,133 mAP50 e Grounding DINO Base 0,104, entrambi con 0,2 secondi per immagine, contro 0,332 di SAM 3.1 Text. Questi punteggi misurano la pipeline di Platform basata su prompt di classe e con il perfezionamento dei riquadri di SAM 3.1, non la configurazione originale di ciascun modello.
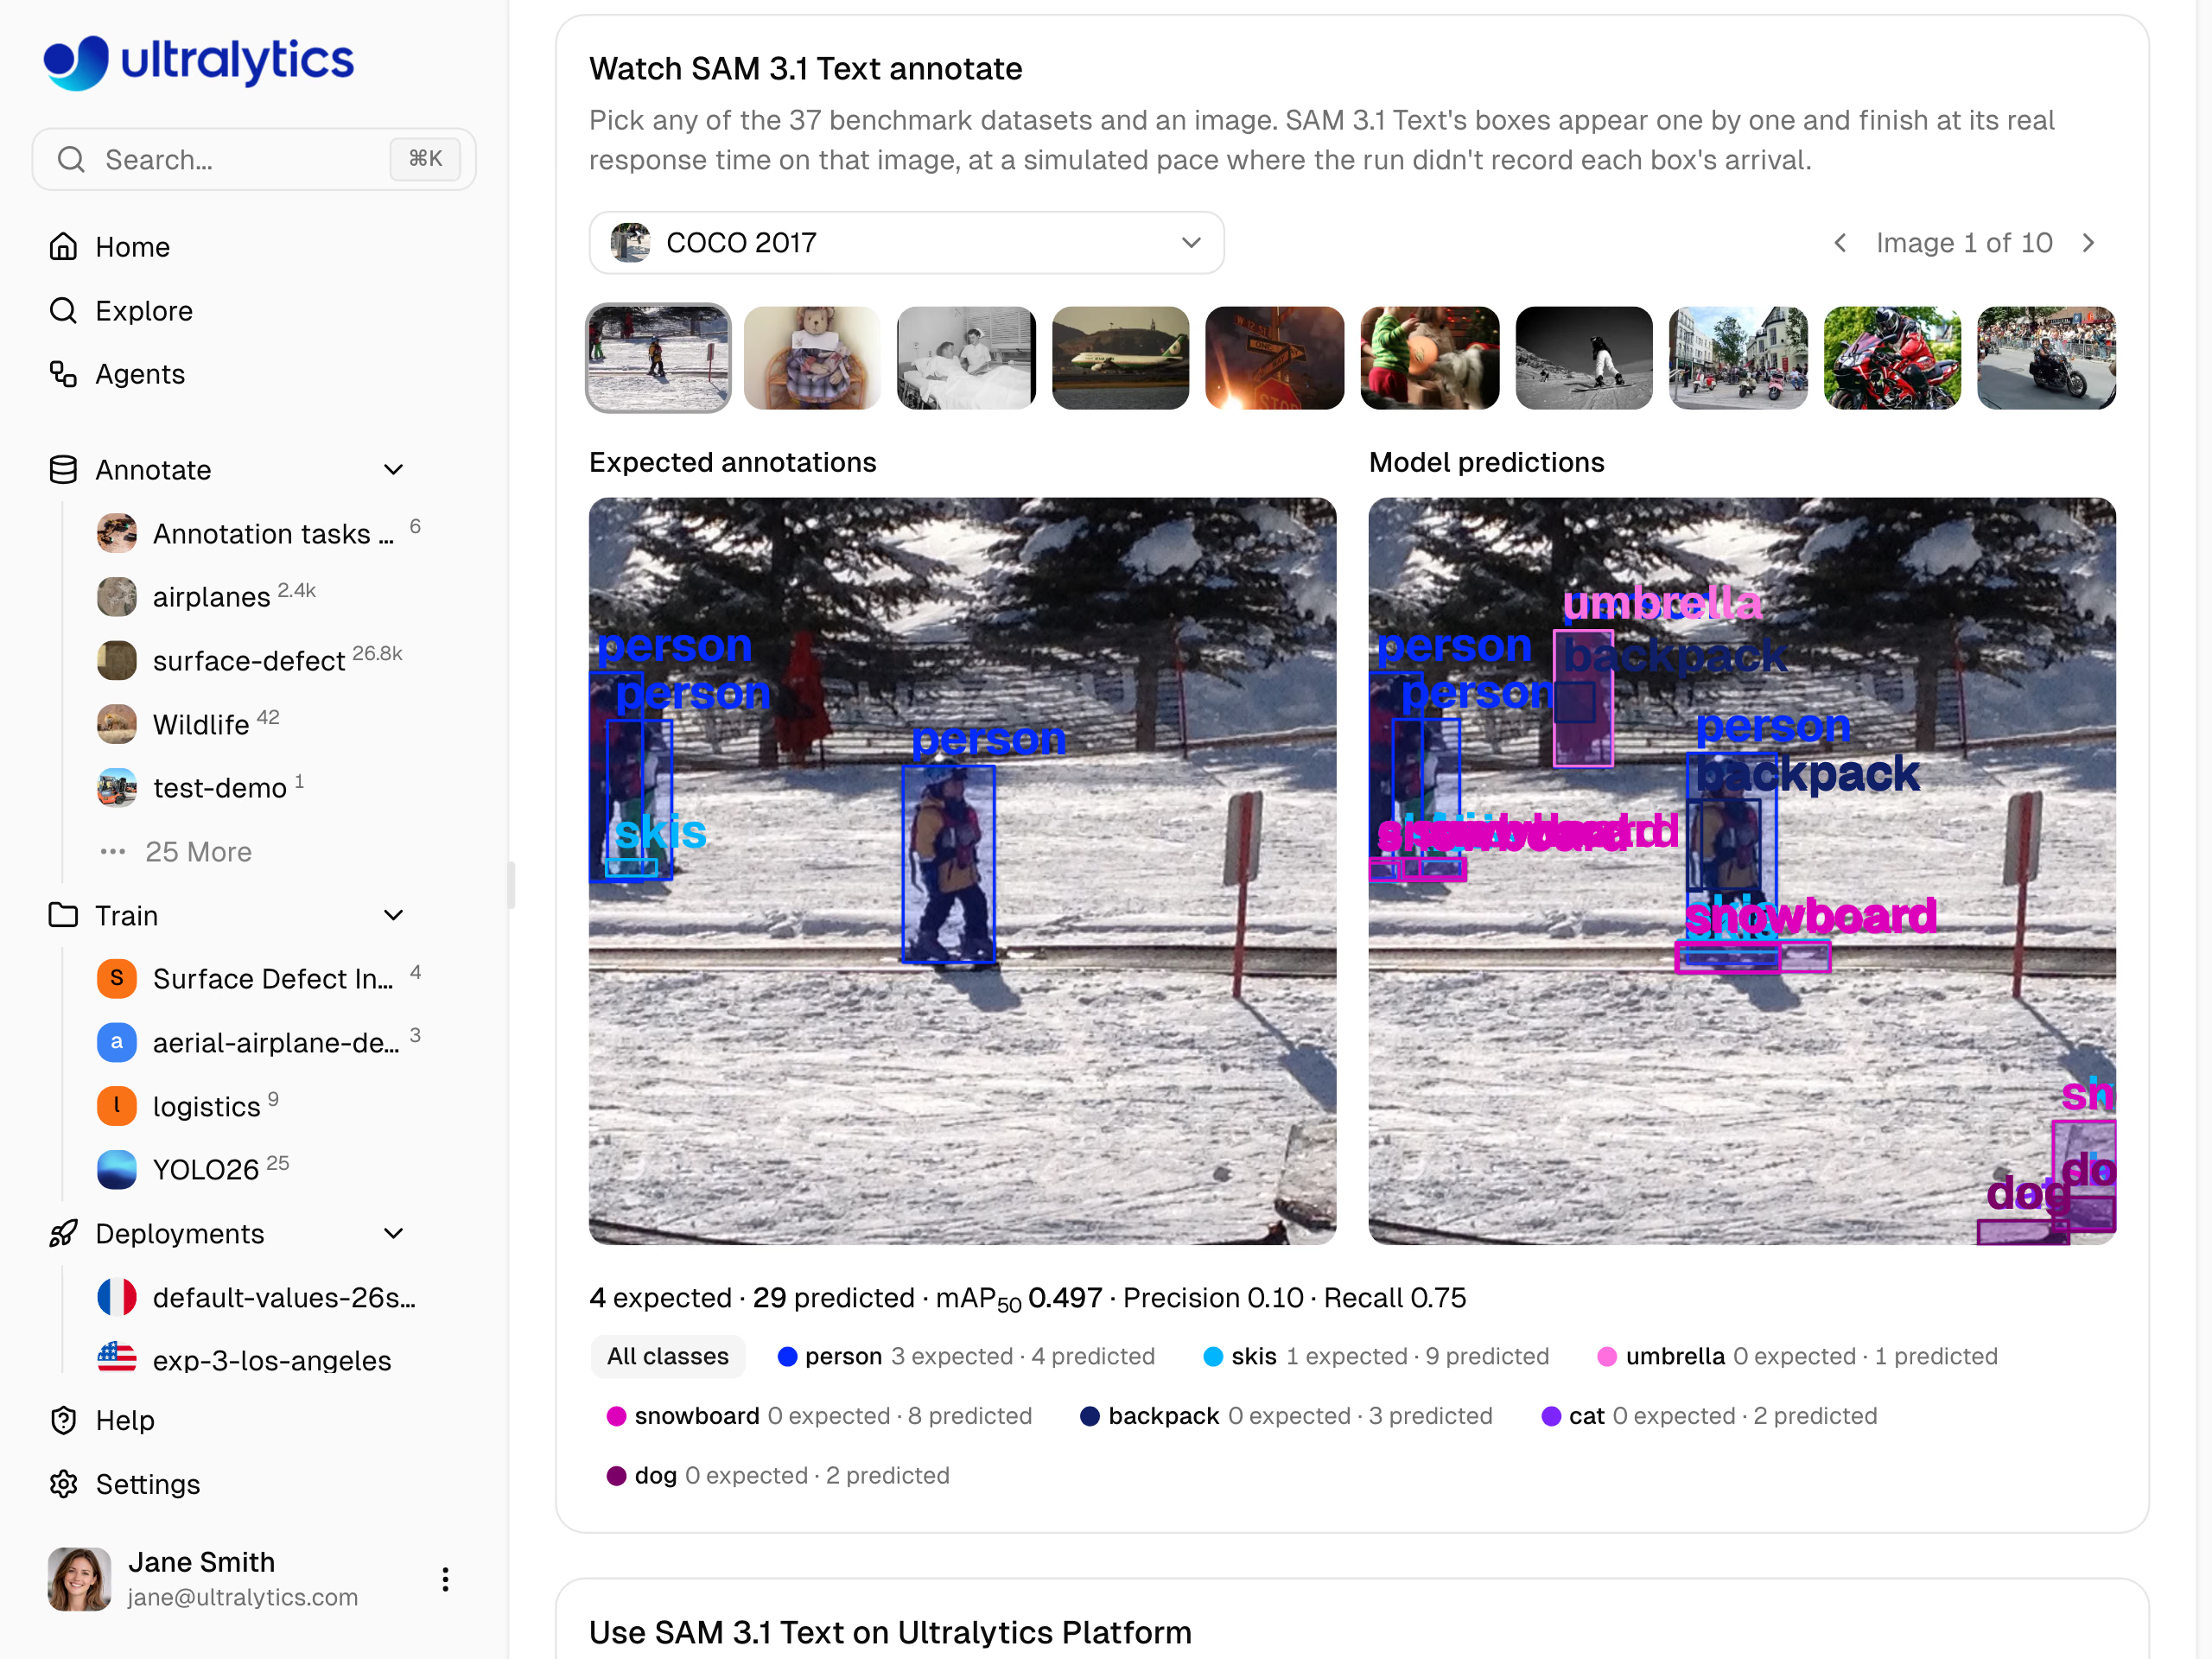
SAM 3.1 Text: 29 riquadri per 4 oggetti, precisione 0,10, richiamo 0,75. Tutte e tre le esecuzioni rilevano 3 dei 4 oggetti; ciò che cambia è il numero di riquadri in eccesso che i revisori eliminano.
SAM 3.1 Text è adatto a scene affollate, aeree e di traffico, in cui i revisori si aspettano di dover sfoltire una bozza generosa. Qwen3.8 27B e Gemma 4 26B si comportano come il gruppo più selettivo, ma con una precisione inferiore. Tra i modelli a pagamento a basso costo, Claude Haiku 5.5 raggiunge 0,429 mAP50 con 0,56 di precisione e 0,47 di richiamo; il costo stimato è $0.37 per 1.000 immagini. È l'altro modello che la classifica contrassegna come "Miglior rapporto qualità-prezzo".
Le medie generali nascondono le specificità del tuo dominio: controlla la tabella dei dataset#
La precisione e il richiamo di ciascun modello sono medie calcolate su 36 dataset, mentre i tuoi dati appartengono a un solo dominio. La tabella dei dataset nella classifica dei VLM riporta la precisione e il richiamo medi di tutti i 40 modelli per ogni dataset, a partire da quelli più difficili, oltre al modello migliore per ciascuno.
Usala per individuare eventuali segnali d'allarme. In Airbus Oil Storage Detection, con 2.267 serbatoi etichettati nelle sue 10 immagini, i modelli hanno una precisione media di 0,39 e un richiamo medio di 0,11; il miglior mAP50 è quello di Gemini 4 Argon, con 0,347. In DeepPCB, la precisione e il richiamo medi sono rispettivamente 0,03 e 0,04, mentre GPT-6.1 Sol si distingue con 0,393 mAP50.
Considera questi numeri come una rosa di candidati, non come un verdetto. La metodologia specifica che 10 immagini per dataset bastano per classificare i modelli e i domini, ma non per certificare il punteggio di un singolo dataset; inoltre, le esecuzioni ripetute spostano i singoli valori di alcuni punti. La pagina di ciascun modello su Platform mostra, affiancati, i riquadri registrati dal modello e quelli attesi sui dataset del benchmark e su COCO, così puoi esaminare il dataset più simile al tuo prima di avviare un'esecuzione.
Abbina il modello al flusso di lavoro della tua revisione in cinque passaggi#
Parti dalla tua priorità nella selezione, poi verifica la scelta sulle tue immagini:
| La tua priorità | Rosa di candidati (risultati di ottobre 2026) |
|---|---|
| Dare priorità alla precisione | Gemini 4 Argon |
| Dare priorità al richiamo | GPT-6 Astra o GPT-6.1 Sol |
| Valutare entrambi | GPT-6.1 Terra |
| Nessuna chiave del provider | Ospitati: Qwen3.8 27B o SAM 3.1 Text |
L'annotazione basata su prompt di classe funziona con dataset di rilevamento da 1 a 200 classi.
- Crea una rosa di candidati sulla classifica. Filtra la classifica VLM per il rilevamento degli oggetti in base ai modelli a pagamento o ospitati (escludi quelli contrassegnati come Non disponibile sulla piattaforma), leggi la colonna corrispondente alla tua priorità e consulta la tabella dei dataset per il tuo dominio.
- Aggiungi una chiave del provider. Per usare un modello a pagamento, salva la tua chiave in Impostazioni > Chiavi API nell'area di lavoro che contiene il dataset. Il provider addebita i costi direttamente alla tua chiave; la documentazione sulle chiavi dei provider spiega come configurarla.
- Esegui una prova su un campione revisionato. Scegli alcune immagini rappresentative dei tuoi dati che hai etichettato manualmente. Apri l'editor delle annotazioni, passa alla modalità Smart, seleziona il modello sotto il relativo provider nel selettore dei modelli e premi Predict (
P). Conta i riquadri che elimini, quelli che aggiungi e i minuti necessari per la revisione. - Etichetta il dataset. Nella pagina del dataset, seleziona Altre azioni > Batch Annotation, disponibile per i dataset ospitati su Platform con un massimo di tre canali di immagine. Per impostazione predefinita, etichetta le immagini non etichettate, non modifica mai le etichette esistenti e salva prima una versione del dataset per consentirti di ripristinarla. Prima di iniziare, controlla il costo stimato nella finestra di dialogo: Batch Annotation costa $1.00 per 1.000 immagini elaborate, oltre agli eventuali addebiti del provider.
- Controlla le annotazioni, poi esegui l'addestramento. Controlla i riquadri tenendo a mente il punto debole del tuo modello, salvali e addestra un modello Ultralytics YOLO sui risultati nella stessa area di lavoro.
Per approfondire, scopri come Ultralytics Platform usa l'IA per automatizzare l'annotazione e perché la revisione con intervento umano resta parte del lavoro. Per confrontare l'etichettatura automatica con l'apprendimento attivo nei vari strumenti, leggi il nostro confronto tra etichettatura automatica e apprendimento attivo.
Rosa di candidati per team (risultati di ottobre 2026)#
- Revisori che preferiscono completare una bozza anziché ripulirla: Gemini 4 Argon, il modello più preciso in assoluto, è particolarmente efficace con immagini aeree, subacquee, termiche e radiografiche di sicurezza.
- Oggetti rari per cui una mancata rilevazione compromette i dati di addestramento: GPT-6 Astra per il richiamo massimo, oppure GPT-6.1 Sol, poco distante.
- Etichettatura generica, senza una preferenza netta: GPT-6.1 Terra, primo per mAP50, mAP50-95 e F1.
- Team senza una chiave del provider: SAM 3.1 Text per le prime passate che privilegiano il richiamo nelle scene affollate, oppure Qwen3.8 27B per una bozza più selettiva.
Qualunque sia la tua scelta, la classifica ti permette di anticipare la revisione prima di iniziarla. Per approfondire la teoria alla base di queste metriche, la nostra guida a accuratezza, precisione e richiamo illustra le basi, mentre la lezione dell'Academy su come leggere le metriche di rilevamento approfondisce l'argomento.
Domande frequenti
Dai priorità alla precisione quando eliminare i riquadri errati richiede più tempo, ad esempio nelle immagini affollate, dove un riquadro indesiderato si confonde tra quelli corretti. Dai priorità al richiamo quando un oggetto non rilevato ha un costo maggiore, come nel caso di difetti o lesioni rari, perché un oggetto non etichettato insegna al rilevatore che si tratta di sfondo. Poi verifica la scelta su un campione delle tue immagini revisionato manualmente.
I modelli basati su prompt di classe restituiscono riquadri senza punteggi di confidenza e usano soglie specifiche del modello, quindi Platform nasconde le impostazioni di confidenza e IoU quando ne selezioni uno. Di conseguenza, la precisione e il richiamo della classifica conteggiano ogni riquadro restituito dal modello con IoU 0,5. Per modificare l'equilibrio tra riquadri non abbinati e oggetti non abbinati, devi scegliere un altro modello.
Usa mAP50 per vedere se un modello trova ed etichetta gli oggetti corretti; usa mAP50-95 per includere soglie di sovrapposizione più rigorose, che premiano i riquadri meglio aderenti. Entrambe riflettono anche le mancate rilevazioni e i falsi positivi, quindi leggile insieme a precisione e richiamo. Nei risultati di ottobre 2026, GPT-6.1 Terra è in testa a entrambe, con 0,560 e 0,345.
Sì. Il modello migliore su UL37 v2 ha una media di 0,560 mAP50 (ottobre 2026) e, nei dataset più difficili, come quelli di difetti dei PCB e radiografie toraciche, la media dei 40 modelli è inferiore a 0,05. Controlla ogni immagine e presta particolare attenzione al punto debole del modello: i riquadri in eccesso se privilegia il richiamo, gli oggetti non rilevati se privilegia la precisione.
I costi si dividono in due parti. Batch Annotation su Ultralytics Platform costa $1.00 per 1.000 immagini elaborate (minimo $0.01) per qualsiasi modello, compresi quelli ospitati; le singole predizioni con un modello ospitato nell'editor sono gratuite. I modelli a pagamento vengono addebitati anche dal provider, che fattura direttamente alla tua chiave API. Nel benchmark di ottobre 2026, le stime dei costi dei provider per i modelli di questa guida andavano da $0.37 per 1.000 immagini (Claude Haiku 5.5) a $49.31 (GPT-6 Astra). Se interrompi un'esecuzione, ti vengono addebitate le immagini già elaborate.
Sì. I modelli ospitati come SAM 3.1 Text, Qwen3.8 27B e Gemma 4 26B funzionano su Ultralytics Platform senza una chiave del provider, così come i tuoi modelli YOLO. Le esecuzioni in batch costano comunque $1.00 per 1.000 immagini elaborate e la finestra di dialogo mostra la stima prima di ogni esecuzione.
Dipende dal lavoro. Un VLM basato su prompt di classe può preparare bozze di etichette per nuove classi usando solo i loro nomi, ma i sei modelli con i punteggi più alti nel benchmark di ottobre 2026 impiegavano da 2,7 a 11,6 secondi per immagine ed erano fatturati a token. Per il rilevamento in tempo reale, un approccio comune consiste nell'annotare automaticamente con un VLM, controllare le etichette e addestrare un modello Ultralytics YOLO su di esse. Puoi anche usare un modello YOLO già addestrato per annotare automaticamente nuove immagini nello stesso editor.
Scritto da
Ingegnere software capo · Ultralytics
Commenti2
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
 Glenn JocherUltralytics
Great job Wax on your first blog!
 Sergiu WaxmannUltralytics
Appreciate it! More coming soon.









