Ultralytics YOLO và NVIDIA Cosmos Data Factory: Dữ liệu tổng hợp để phát hiện lỗi
Dữ liệu tổng hợp từ NVIDIA Cosmos Data Factory và vòng lặp huấn luyện tăng cường dữ liệu bằng tác tử tự động, do NVIDIA hỗ trợ, giúp Ultralytics YOLO đạt độ chính xác tương đương khi dùng toàn bộ dataset nhưng chỉ cần một phần nhỏ số nhãn.
Ultralytics và NVIDIA đã hợp tác để chứng minh dữ liệu huấn luyện có mục tiêu có thể làm được gì cho Ultralytics YOLO. Vòng lặp huấn luyện tăng cường dữ liệu bằng tác tử của NVIDIA xác định những hình ảnh model cần, NVIDIA Cosmos Data Factory tạo ra những hình ảnh chưa tồn tại, còn Ultralytics YOLO là model được huấn luyện bằng dữ liệu thu được. Nhóm học máy (ML) của chúng tôi đã đánh giá sự kết hợp này trên 19 benchmark kiểm tra công nghiệp công khai, so sánh Ultralytics YOLO26 được huấn luyện bằng pipeline tác tử và dữ liệu tổng hợp từ Cosmos Data Factory với cùng model được huấn luyện theo cách thông thường. Bài viết này chia sẻ các kết quả.
Thêm dữ liệu không phải là câu trả lời. Dữ liệu phù hợp mới là điều cần thiết.#
Mọi nhóm kiểm tra đều hiểu tình huống này. Model phát hiện lỗi hoạt động tốt với những lỗi đã gặp nhiều lần, nhưng lại bỏ sót vết xước hiếm gặp, điều kiện ánh sáng bất thường hoặc góc camera khác lạ—những yếu tố quan trọng nhất trên dây chuyền sản xuất. Cách khắc phục thường thấy là thu thập và gắn nhãn thêm mọi loại dữ liệu, việc này chậm, tốn kém và phần lớn chỉ bổ sung những hình ảnh mà model vốn đã xử lý tốt.
Quy trình huấn luyện tự động bằng tác tử, do NVIDIA hỗ trợ, áp dụng cách tiếp cận khác: tìm ra những điểm yếu cụ thể trong dataset rồi bổ sung dữ liệu để khắc phục, bằng hình ảnh thực đã có hoặc bằng hình ảnh tổng hợp từ Cosmos Data Factory khi chưa có ví dụ thực. Khi kết hợp với Ultralytics YOLO, cách này giúp model được huấn luyện chính xác trên những dữ liệu còn thiếu.
Vòng lặp huấn luyện tăng cường dữ liệu của NVIDIA hoạt động như thế nào?#
Vòng lặp huấn luyện tăng cường dữ liệu bằng tác tử của NVIDIA dành cho Ultralytics YOLO là một pipeline cải thiện model, bao bọc vòng lặp huấn luyện và quyết định dữ liệu tiếp theo mà model cần:
• Khai thác dữ liệu thực. Tìm kiếm trong các tập hợp hình ảnh hiện có để tìm ví dụ thực bù đắp những khoảng trống cụ thể trong tập huấn luyện.
• Tạo dữ liệu tổng hợp. Khi không có ví dụ thực, pipeline tạo hình ảnh cho các trường hợp biên bằng Cosmos Data Factory.
• Tự động gắn nhãn. Một thành phần có tên AnomalyGen gắn nhãn các hình ảnh tổng hợp, vì vậy không cần gắn nhãn thủ công trước khi huấn luyện lại.
Ý tưởng định hướng là ưu tiên dữ liệu có mục tiêu thay vì hiệu quả sử dụng dữ liệu. Mục tiêu không chỉ đơn thuần là huấn luyện với ít dữ liệu hơn. Mục tiêu là bổ sung chính xác những phần còn thiếu trong dataset mà model hoạt động kém, thông qua khai thác hoặc tạo dữ liệu, rồi huấn luyện lại trên tập dữ liệu đã được làm giàu đó. Như các kết quả bên dưới cho thấy, huấn luyện trên ít hình ảnh hơn thường là hệ quả phụ của việc thực hiện tốt quy trình này.
Pipeline đã được benchmark chuyên sâu với Ultralytics YOLO, và mọi kết quả trong bài viết này đều sử dụng Ultralytics YOLO26.
Vai trò của NVIDIA Cosmos Data Factory#
Cosmos Data Factory là nền tảng tuyển chọn, xử lý và tạo dữ liệu của NVIDIA, được xây dựng trên các model thế giới Cosmos. Trong vòng lặp huấn luyện bằng tác tử, nền tảng này tạo hình ảnh cho các tình huống mà dataset thực chưa bao phủ tốt, chẳng hạn như các loại lỗi cụ thể trong sản xuất hoặc hiện tượng méo do ống kính mắt cá trong video giao thông.
Quy trình bàn giao rất đơn giản. Cosmos tạo hình ảnh cho các trường hợp biên, AnomalyGen gắn nhãn hình ảnh, rồi Ultralytics YOLO được huấn luyện lại trên tập dữ liệu kết hợp giữa dữ liệu thực và dữ liệu tổng hợp bằng pipeline huấn luyện Ultralytics tiêu chuẩn.
Thử nghiệm Cosmos Data Factory trên 19 dataset công khai#
Để tìm hiểu khả năng của Cosmos Data Factory + Ultralytics YOLO, nhóm ML của chúng tôi đã chạy pipeline tinh chỉnh tăng cường dữ liệu bằng tác tử trên 19 dataset kiểm tra công nghiệp công khai, bao gồm thép, PCB, vải, bề mặt kim loại và sản phẩm tiêu dùng, với tổng cộng khoảng 91.000 hình ảnh huấn luyện. Mỗi lần chạy sử dụng một máy chủ có 8 GPU.
Phép so sánh được thiết kế nghiêm ngặt có chủ đích. Baseline và model Cosmos Data Factory được huấn luyện với cùng một cấu hình: Ultralytics YOLO26x, 100 epoch, cùng optimizer, learning rate và seed, đồng thời được đánh giá trên cùng một tập kiểm tra giữ lại. Điểm khác biệt duy nhất là các hình ảnh dùng để huấn luyện từng model. Baseline được huấn luyện trên mọi hình ảnh đã gắn nhãn (và chỉ dùng hình ảnh thực trong thử nghiệm dữ liệu tổng hợp).
1. Đạt độ chính xác tương đương chỉ với một phần nhãn#
Trên 11 trong số 19 dataset, Ultralytics YOLO26x được huấn luyện bằng pipeline tác tử đạt kết quả tương đương model được huấn luyện trên toàn bộ dataset. Trong 11 dataset này, không cần đến 53% số hình ảnh đã gắn nhãn.
| dataset | đã gắn nhãn | đã sử dụng | không cần dùng | mAP@0.5 toàn bộ | mAP@0.5 đã tuyển chọn |
|---|---|---|---|---|---|
| dagm class 1 | 1,035 | 90 | 91% | 0.9923 | 0.9998 |
| dagm class 2 | 1,035 | 90 | 91% | 1.0000 | 0.9999 |
| dagm class 3 | 1,035 | 90 | 91% | 1.0000 | 0.9987 |
| dagm class 4 | 1,035 | 90 | 91% | 1.0000 | 0.9991 |
| dagm class 7 | 2,070 | 180 | 91% | 1.0000 | 0.9995 |
| dagm class 8 | 2,070 | 178 | 91% | 0.9991 | 1.0000 |
| dagm class 9 | 2,070 | 180 | 91% | 1.0000 | 0.9992 |
| dagm class 10 | 2,070 | 180 | 91% | 1.0000 | 1.0000 |
| pcb-defect | 20,924 | 13,903 | 34% | 0.9900 | 0.9893 |
| hripcb | 559 | 414 | 26% | 0.9891 | 0.9754 |
| deeppcb | 1,000 | 900 | 10% | 0.9887 | 0.9885 |
Bảng 1. Các dataset mà Cosmos Data Factory đạt kết quả tương đương model dùng toàn bộ dữ liệu. mAP@0.5 trên cùng tập dữ liệu giữ lại.
Trên các dataset DAGM, pipeline tác tử đạt cùng mAP@0.5 chỉ với một phần mười số nhãn; trên hai lớp, kết quả còn nhỉnh hơn một chút so với model dùng toàn bộ dữ liệu. Với pcb-defect, pipeline loại bỏ 7.000 trong số 20.924 hình ảnh, trong khi chênh lệch độ chính xác nhỏ hơn nhiễu giữa các lần chạy đến bốn lần.
Đối với các nhóm phải trả phí gắn nhãn, đây là điểm đáng chú ý nhất: phần lớn ngân sách gắn nhãn cho các dataset này đã được dùng cho những hình ảnh không làm thay đổi kết quả.
2. Huấn luyện nhanh hơn tới 74%#
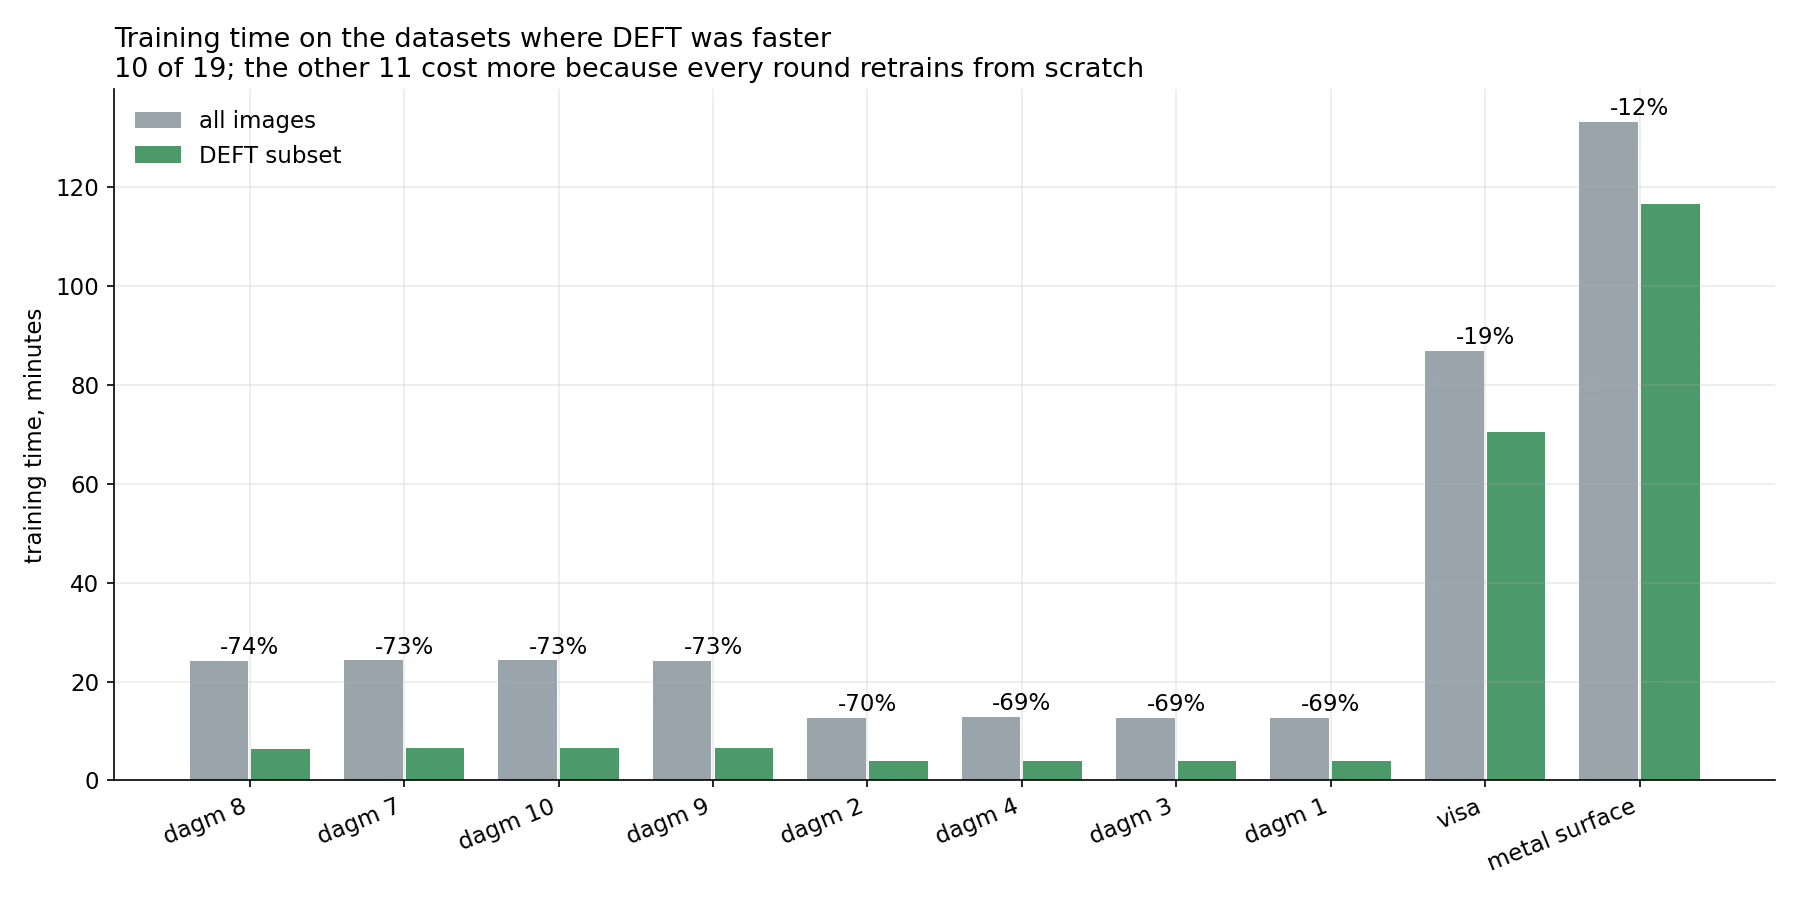
Hình 1. Thời gian huấn luyện trên toàn bộ dataset so với tập con từ Cosmos Data Factory, với các dataset mà Cosmos Data Factory giúp rút ngắn thời gian.
Huấn luyện Ultralytics YOLO trên tập dữ liệu nhỏ hơn, được lựa chọn có mục tiêu, cũng giảm mức sử dụng tài nguyên tính toán. Trong 19 dataset, có 10 dataset được huấn luyện nhanh hơn với pipeline tác tử. Trên DAGM, thời gian huấn luyện giảm từ 13–24 phút xuống còn 4–7 phút, tức giảm 69–74%. Các dataset lớn hơn cũng tiết kiệm được thời gian, dù ít hơn: 19% trên VisA và 12% trên metal-surface-defect.
Mức tiết kiệm này không phải lúc nào cũng đạt được. Trên 9 dataset còn lại, pipeline tác tử mất nhiều thời gian hơn một lần chạy trên toàn bộ dữ liệu, vì mỗi vòng tuyển chọn đều huấn luyện lại từ đầu. Khi tập con được tuyển chọn không nhỏ hơn đáng kể so với tập ban đầu, thời gian của các vòng bổ sung sẽ lớn hơn phần tiết kiệm.
3. Lỗi được tạo ra giúp hộp khớp chính xác hơn#
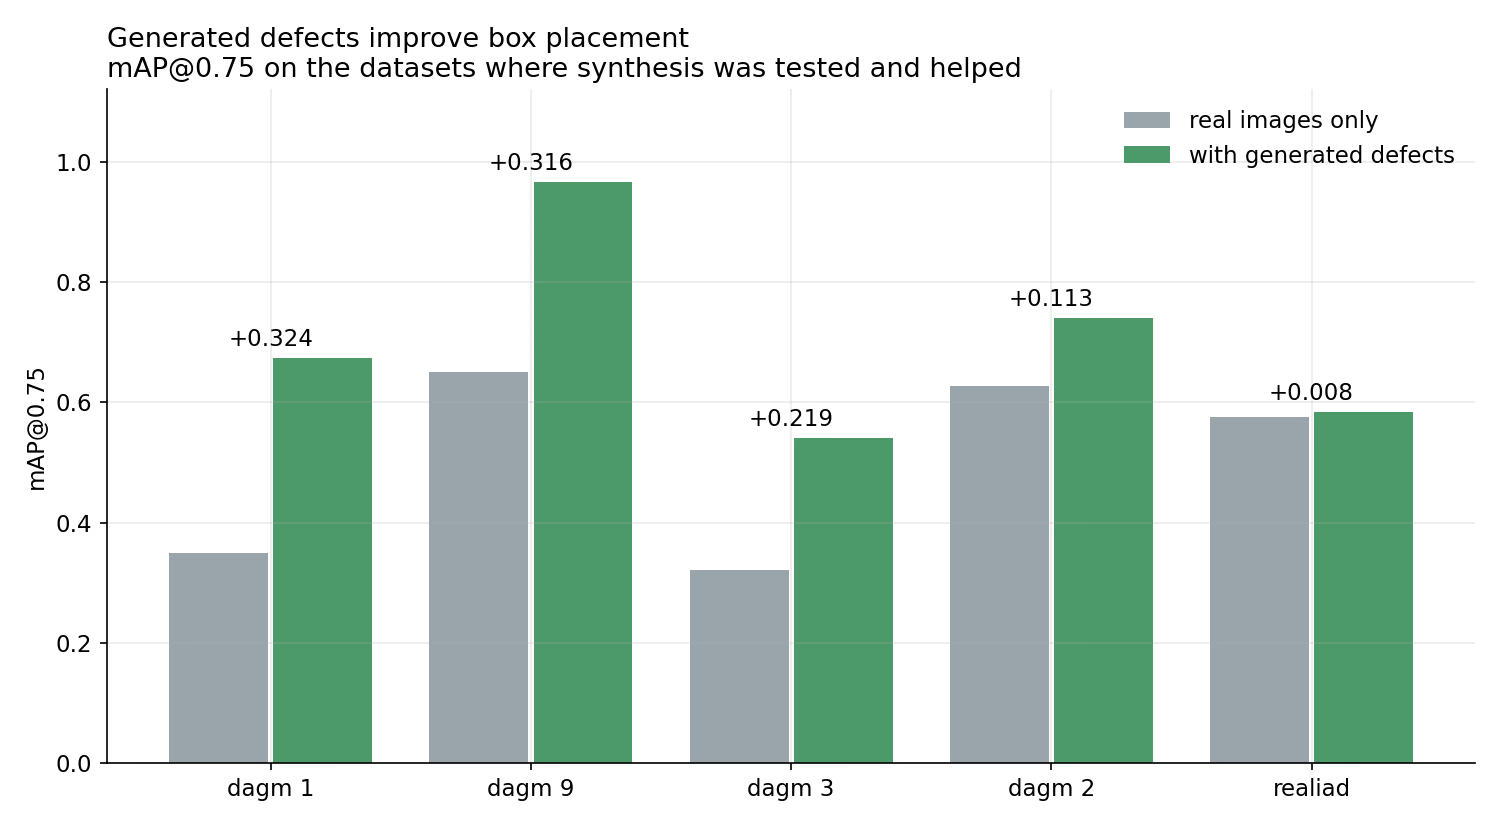
Hình 2. mAP@0.75 khi chỉ dùng hình ảnh thực so với khi bổ sung lỗi được tạo ra, trên các dataset đã thử nghiệm và ghi nhận lợi ích từ việc tổng hợp dữ liệu.
Thử nghiệm thứ ba tập trung riêng vào dữ liệu tổng hợp. Trên các dataset có chú thích đa giác, chúng tôi bổ sung lỗi được tạo bằng Cosmos Data Factory và gắn nhãn bởi AnomalyGen, sau đó so sánh model Ultralytics YOLO thu được với model chỉ được huấn luyện trên hình ảnh thực.
Chúng tôi báo cáo mAP@0.75, một chỉ số nghiêm ngặt hơn mAP@0.5: một dự đoán chỉ được tính nếu hộp của nó chồng lấp ít nhất 75% với lỗi thực tế. Chỉ số này đo độ chính xác khi model xác định vị trí lỗi, chứ không chỉ đo việc model có phát hiện được lỗi hay không. Việc bổ sung lỗi được tạo ra giúp mAP@0.75 tăng từ 0.11 lên 0.32 trên các lớp DAGM, đồng thời recall cải thiện trên mọi dataset được thử nghiệm. Mức tăng lớn nhất là ở DAGM class 9, từ 0.650 lên 0.966. Trên Real-IAD, mức cải thiện không đáng kể (+0.008).
Lỗi vốn hiếm gặp, vì vậy các ví dụ thực về một loại lỗi nhất định luôn khan hiếm. Tạo sẵn lỗi và gắn nhãn cho chúng giúp Ultralytics YOLO học chính xác hình dạng và phạm vi của lỗi mà không cần ai vẽ đa giác.
Lượng dữ liệu tổng hợp được sử dụng#
Mỗi lần tạo dữ liệu gồm ba bước. Trước tiên, Cosmos Data Factory tìm các vị trí có thể xuất hiện lỗi trên hình ảnh thực (placed); bộ tạo tạo hình ảnh lỗi tại các vị trí đó (generated), sau đó chỉ đưa vào tập huấn luyện số lượng tối đa theo giới hạn đã đặt (kept). Chúng tôi thử nghiệm hai giới hạn: số hình ảnh tổng hợp bằng 25% hoặc 100% số hình ảnh thực trong tập huấn luyện.
Trong 18 vòng tạo dữ liệu (9 baseline và 9 tổng hợp), pipeline đã tạo 11.448 hình ảnh. Chỉ 1.481 hình ảnh trong số đó, khoảng một phần tám, được giữ lại, vì vậy giới hạn quyết định lượng dữ liệu tổng hợp mà mỗi model Ultralytics YOLO sử dụng, chứ không phải lượng dữ liệu do bộ tạo tạo ra. Với giới hạn 100%, mỗi tập huấn luyện có một hình ảnh tổng hợp cho mỗi hình ảnh thực; với giới hạn 25%, tỷ lệ là khoảng một hình ảnh tổng hợp trên bốn hình ảnh thực. Xét về số lượng tuyệt đối, các con số này khá nhỏ: trên DAGM, có 90–180 hình ảnh thực và tối đa số hình ảnh tổng hợp tương đương.
| dataset | giới hạn | được đặt | được tạo | bị chặn | được giữ lại | thực | tỷ lệ |
|---|---|---|---|---|---|---|---|
| dagm class 1 | 25% | 870 | 440 | 0 | 22 | 90 | 1 : 0.24 |
| dagm class 1 | 100% | 870 | 400 | 0 | 90 | 90 | 1 : 1.00 |
| dagm class 2 | 25% | 606 | 254 | 0 | 22 | 90 | 1 : 0.24 |
| dagm class 2 | 100% | 606 | 304 | 0 | 90 | 90 | 1 : 1.00 |
| dagm class 3 | 25% | 900 | 370 | 0 | 22 | 90 | 1 : 0.24 |
| dagm class 3 | 100% | 900 | 370 | 0 | 90 | 90 | 1 : 1.00 |
| dagm class 9 | 100% | 1,800 | 620 | 0 | 180 | 180 | 1 : 1.00 |
| realiad | 25% | 9,534 | 4,440 | 0 | 193 | 772 | 1 : 0.25 |
| realiad | 100% | 9,534 | 4,250 | 0 | 772 | 772 | 1 : 1.00 |
| Tổng | 11,448 | 0 | 1,481 |
Bảng 2. Số lượng hình ảnh được tạo và tỷ lệ dữ liệu thực trên dữ liệu tổng hợp, lấy từ hồ sơ tạo và đưa dữ liệu vào của mỗi lần chạy.
Ý nghĩa đối với các nhóm xây dựng model kiểm tra#
Đối với các nhóm đã huấn luyện Ultralytics YOLO, Cosmos Data Factory và quy trình huấn luyện tự động bằng tác tử do NVIDIA hỗ trợ phù hợp với workflow hiện có và quen thuộc: vẫn là những model cũ, cùng cấu hình huấn luyện, nhưng đầu vào là dữ liệu thông minh hơn.
• Bao phủ các trường hợp biên mà bạn không thể thu thập. Lỗi tổng hợp được tự động gắn nhãn giúp Ultralytics YOLO xác định vị trí lỗi khi ví dụ thực khan hiếm.
• Phân bổ ngân sách gắn nhãn vào đúng chỗ. Trên hơn một nửa số dataset được thử nghiệm, phần lớn nhãn là dư thừa. Việc lựa chọn có mục tiêu giúp tìm ra những hình ảnh quan trọng.
• Lặp lại nhanh hơn. Tập huấn luyện nhỏ hơn, được tuyển chọn, giúp rút ngắn thời gian huấn luyện Ultralytics YOLO và đẩy nhanh quá trình thử nghiệm trên nhiều dataset.
Tính khả dụng#
Bước tạo dữ liệu tổng hợp dựa trên Cosmos hiện được cung cấp dưới dạng mẫu và bản demo, chưa được phát hành thành một tích hợp hoàn chỉnh.
Để thử Cosmos Data Factory với các model Ultralytics YOLO của riêng bạn, hãy liên hệ với các nhóm Ultralytics. Chúng tôi sẽ tiếp tục hợp tác với NVIDIA khi bước tạo dữ liệu tổng hợp được phát triển thành một tích hợp hoàn chỉnh.
Phụ lục: cấu hình thử nghiệm và các dataset#
Tất cả các lần chạy đều sử dụng Ultralytics YOLO26x, 100 epoch, cùng optimizer, learning rate và seed cho baseline và Cosmos Data Factory; một máy chủ có 8 GPU; cùng một tập kiểm tra giữ lại cho mỗi dataset. Có thể sử dụng lỗi được tạo ra trên 11 dataset có chú thích đa giác.
| dataset | hình ảnh huấn luyện | chú thích | nguồn |
|---|---|---|---|
| dagm class 1, 2, 3, 4 | 1,035 mỗi lớp | đa giác | DAGM 2007 |
| dagm class 7, 8, 9, 10 | 2,070 mỗi lớp | đa giác | DAGM 2007 |
| pcb-defect | 20,924 | hộp | PCB defect |
| dspcbsd | 6,575 | hộp | DsPCBSD+ |
| deeppcb | 1,000 | hộp | DeepPCB |
| hripcb | 559 | hộp | HRIPCB |
| metal-surface-defect | 11,845 | hộp | NEU surface defect |
| tianchifabric | 10,332 | hộp | Tianchi fabric |
| severstal | 10,061 | đa giác | Severstal steel |
| mvtec-ad | 4,637 | hộp | MVTec AD |
| visa | 7,794 | đa giác | VisA |
| realiad-bottle-cap | 3,581 | đa giác | Real-IAD |
| vết nứt | 1,290 | hộp | phân đoạn vết nứt |
Bảng 3. 19 bộ dữ liệu (DAGM được tính là tám bộ, mỗi bộ tương ứng với một lớp).









