Segmentación semántica frente a segmentación de instancias: cómo elegir la tarea adecuada
La segmentación semántica asigna una clase a cada píxel; la segmentación de instancias separa cada objeto. Descubre cuál necesita tu proyecto de visión artificial y por qué.
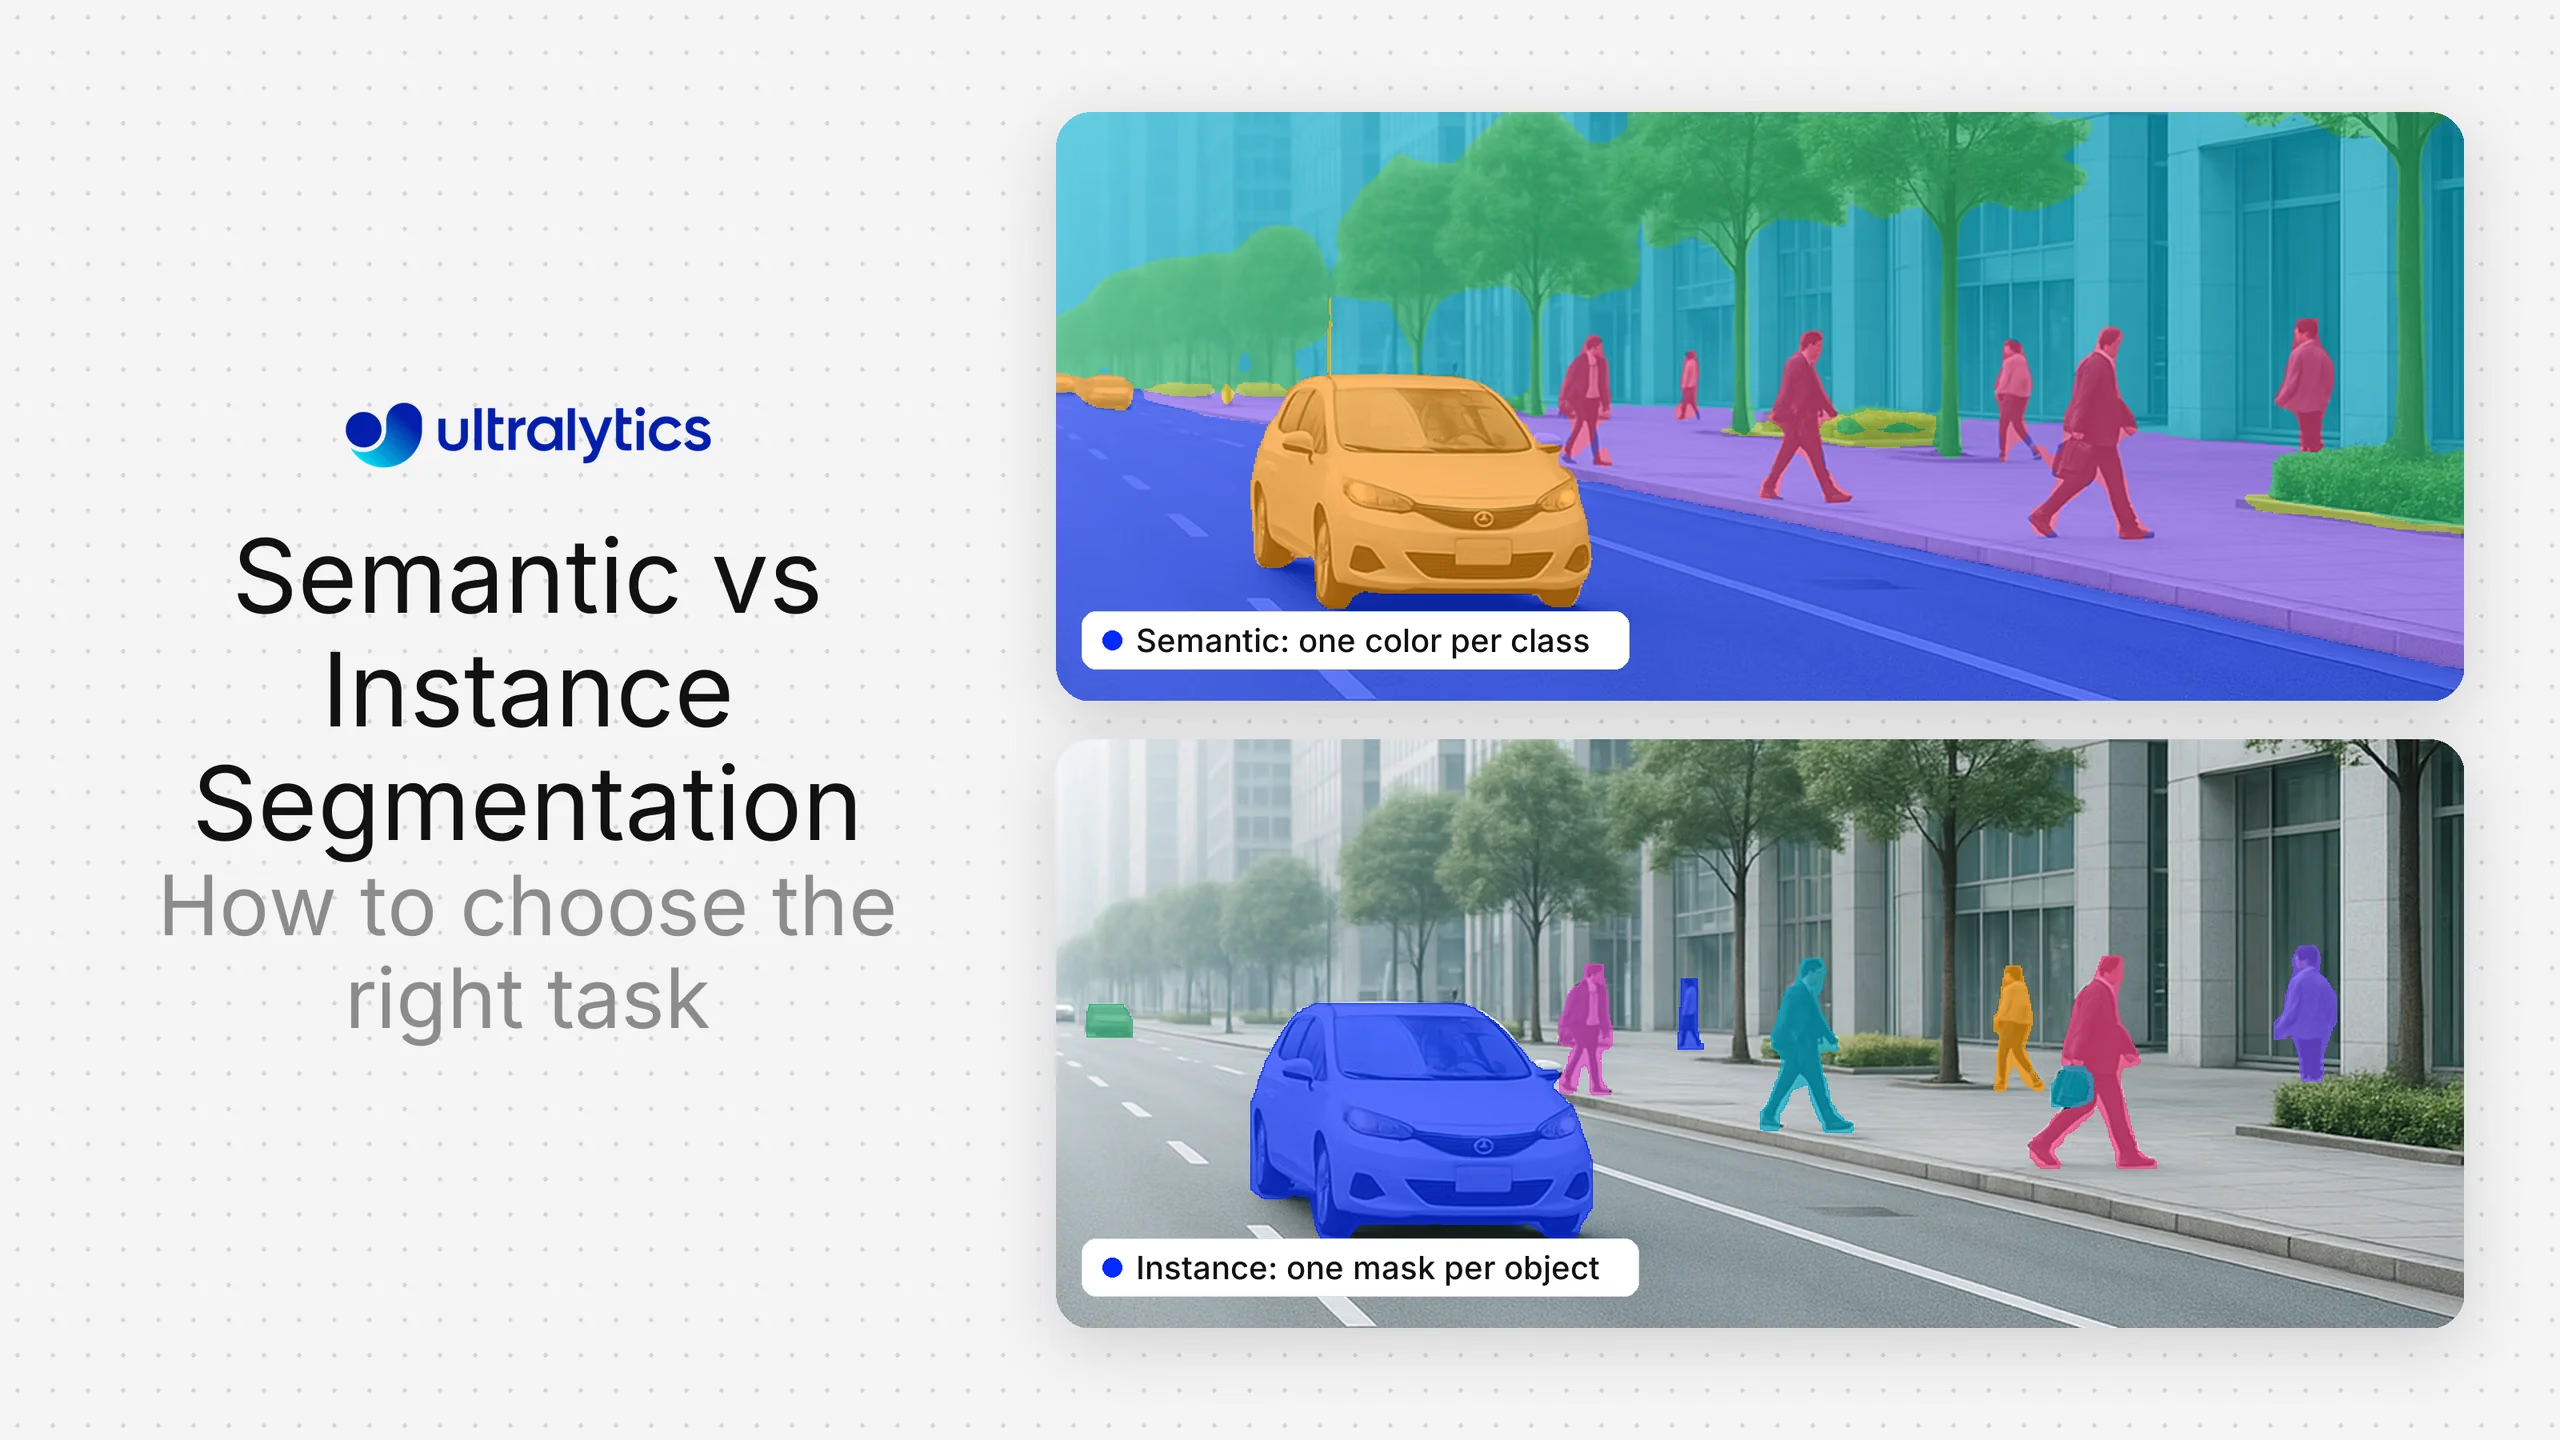
La segmentación semántica y la segmentación de instancias asignan etiquetas a las imágenes a nivel de píxel, pero responden a preguntas distintas. La segmentación semántica asigna una clase a cada píxel, así que todos los coches de una escena forman una sola región «coche». La segmentación de instancias separa cada objeto, de modo que cada coche obtiene su propia máscara. Para elegir entre ambas, basta con responder a una pregunta: ¿necesitas saber qué hay en cada píxel o a qué objeto pertenece cada píxel? Esta guía te ayuda a decidir. También explica cuánto cuesta etiquetar cada tarea y cómo se evalúa. Ultralytics YOLO admite ambas tareas en el mismo marco de trabajo.
La diferencia en una frase#
- La segmentación semántica clasifica cada píxel en una categoría, como carretera, cielo, persona o coche. Los objetos de la misma clase se fusionan en una sola región. Consulta la entrada del glosario sobre segmentación semántica.
- La segmentación de instancias localiza cada objeto individual y le asigna su propia máscara e ID. Normalmente abarca objetos contables e ignora el fondo, como el cielo o la hierba. Consulta la entrada del glosario sobre segmentación de instancias.
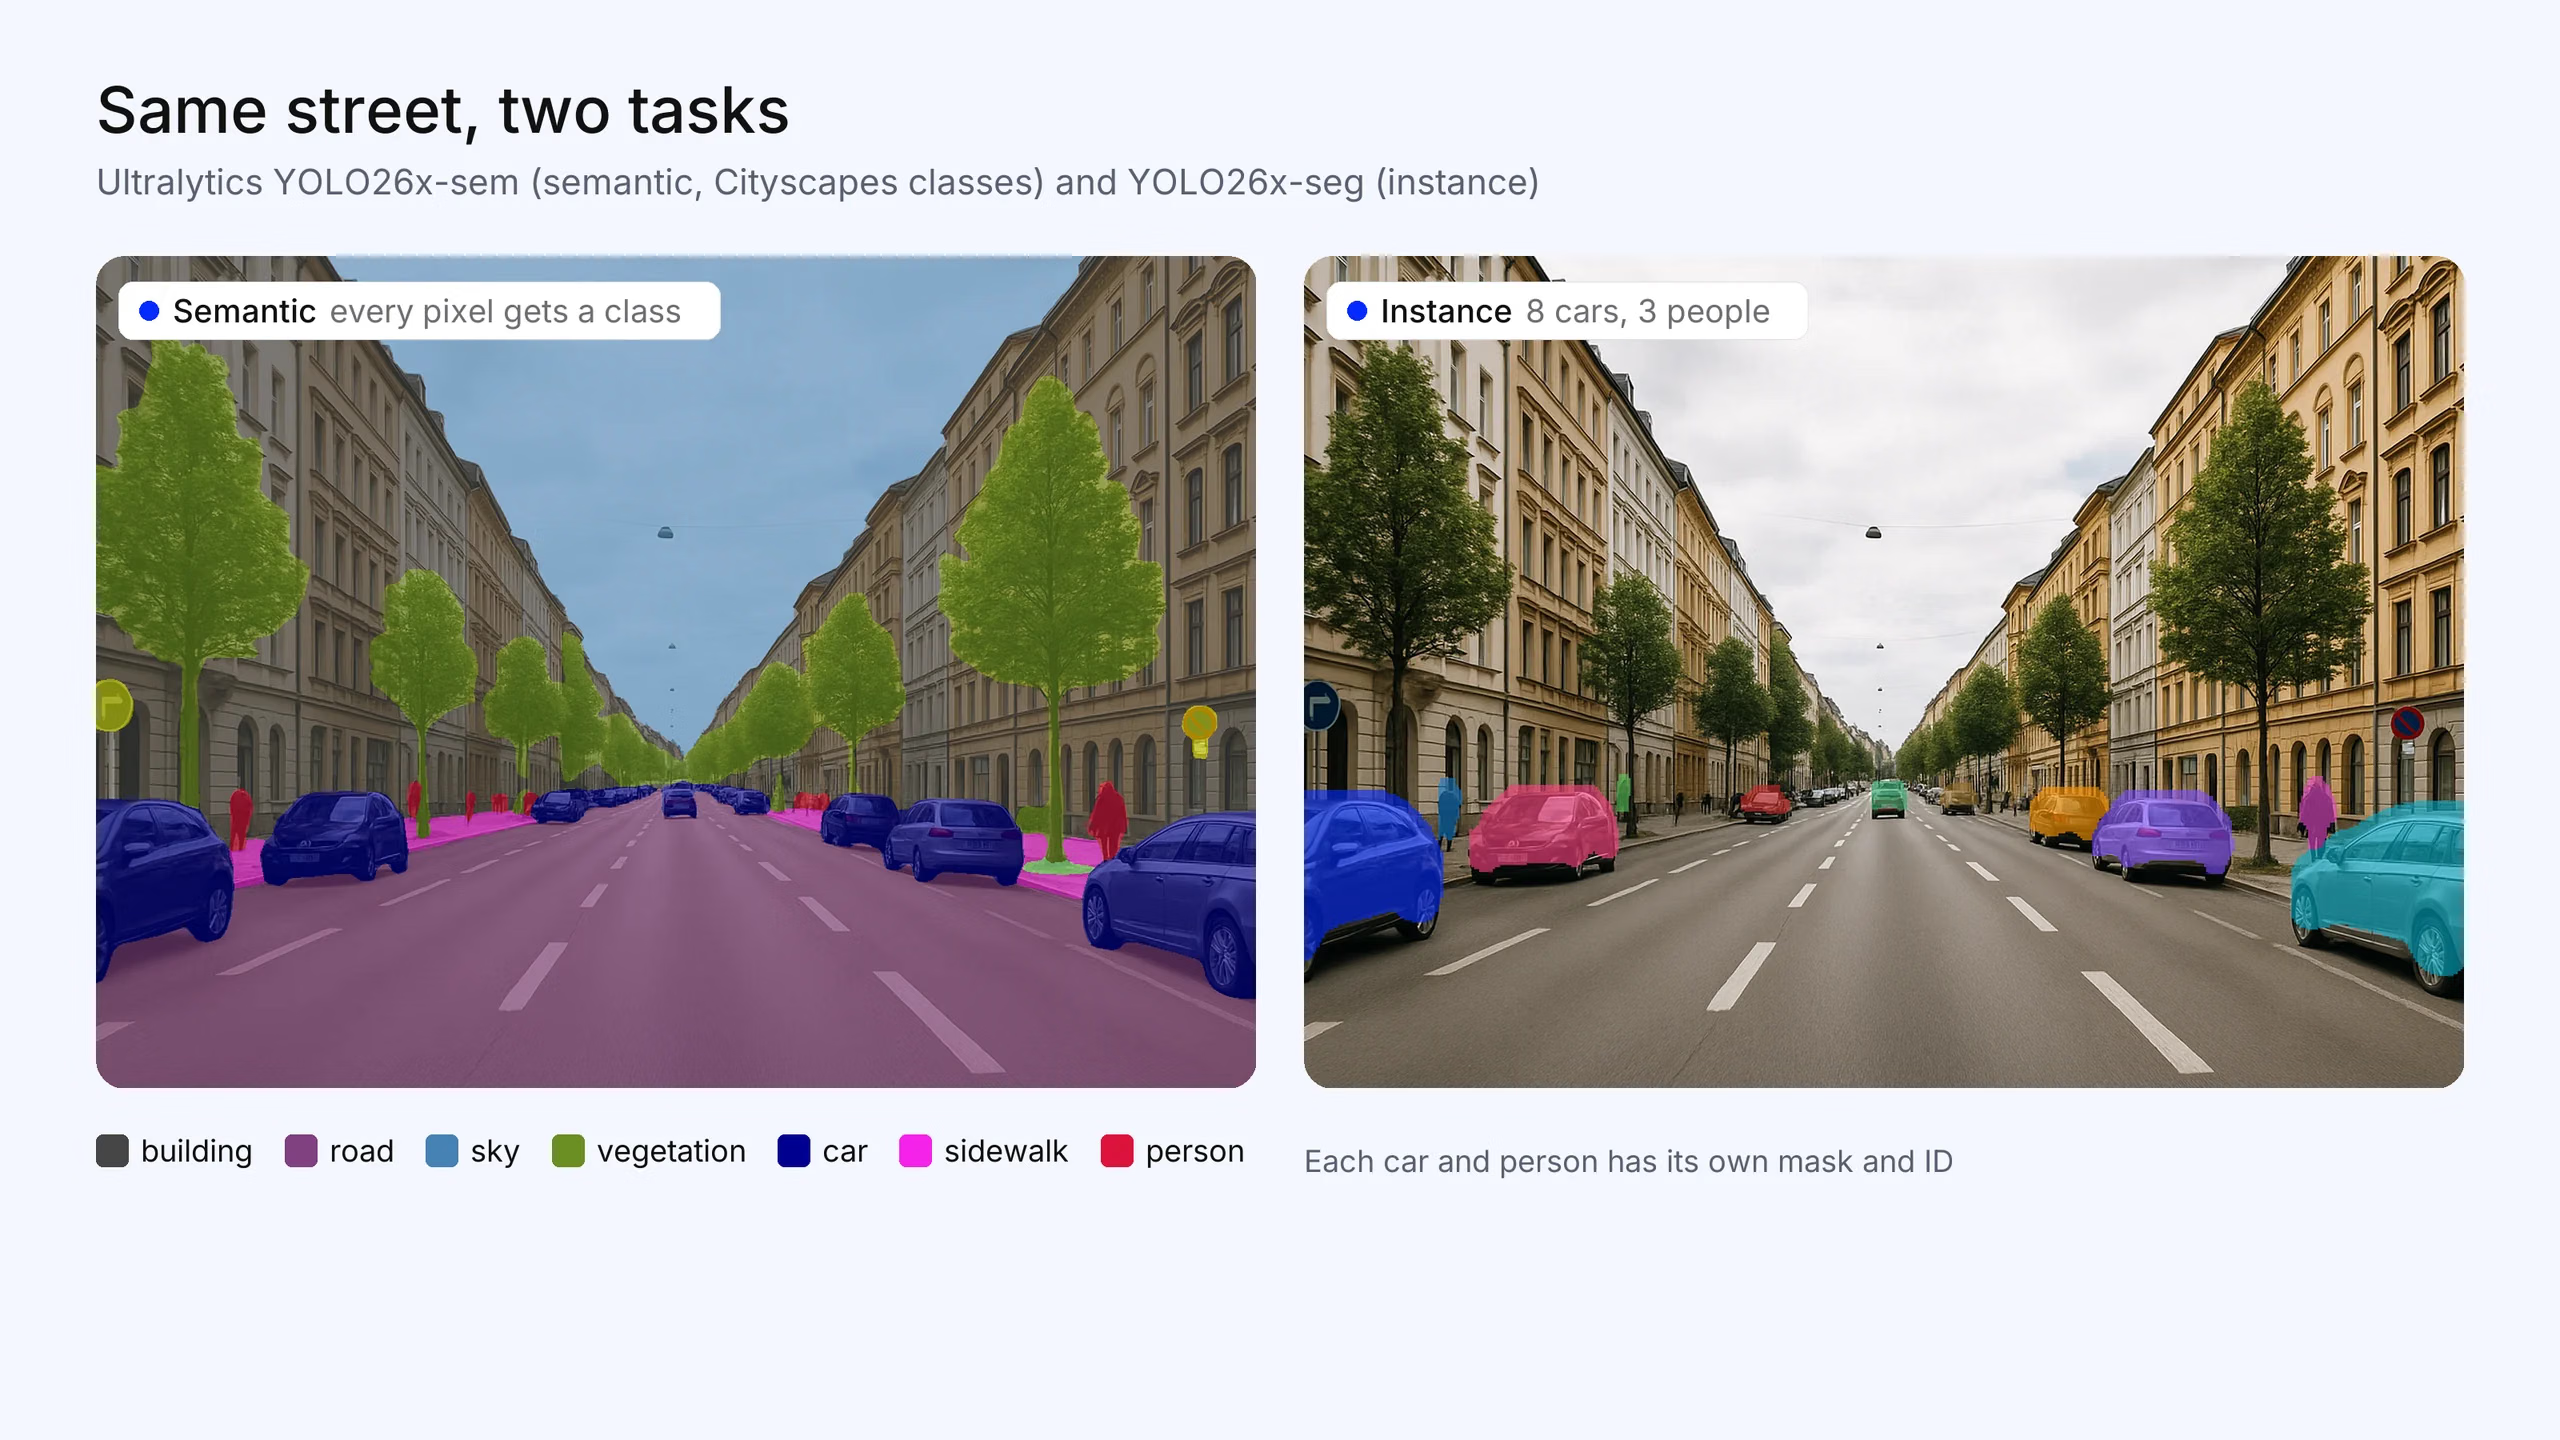
Fig. 1. La misma calle con ambas tareas. Ultralytics YOLO26x-sem (clases de Cityscapes) etiqueta cada píxel, así que todos los coches comparten una sola clase «coche». Ultralytics YOLO26x-seg asigna su propia máscara a cada uno de los 8 coches y las 3 personas que detecta (confianza de 0,5 o superior). La foto se generó para este artículo; las máscaras son resultados reales del modelo.
¿Qué tarea necesita tu proyecto?#
Empieza por la pregunta a la que debe responder tu aplicación:
| Si tu aplicación necesita… | Usa | Ejemplo |
|---|---|---|
| Saber qué proporción de la escena corresponde a una clase determinada | Semántica | Superficie de carretera transitable, cobertura de cultivo frente a malas hierbas, cubierta terrestre |
| Etiquetar las regiones de fondo con tanto cuidado como los objetos | Semántica | Cielo, agua, vegetación, tipos de tejido en una exploración |
| Contar objetos | Instancias | Fruta en un árbol, personas en una cola |
| Seguir objetos a través de los fotogramas de un vídeo | Instancias y un rastreador | Personas o vehículos que se desplazan por una escena |
| Medir o actuar sobre un objeto cada vez | Instancias | Un robot que recoge una pieza de un montón, medir cada defecto |
| Hacer ambas cosas: cubrir toda la escena y separar los objetos | Panóptica | Escenas urbanas para la conducción autónoma |
Si no lo tienes claro, pregúntate si es necesario distinguir dos objetos de la misma clase que se tocan. Si la respuesta es sí, necesitas segmentación de instancias (o panóptica). Si la respuesta es no, la segmentación semántica es más sencilla y suele requerir menos recursos.
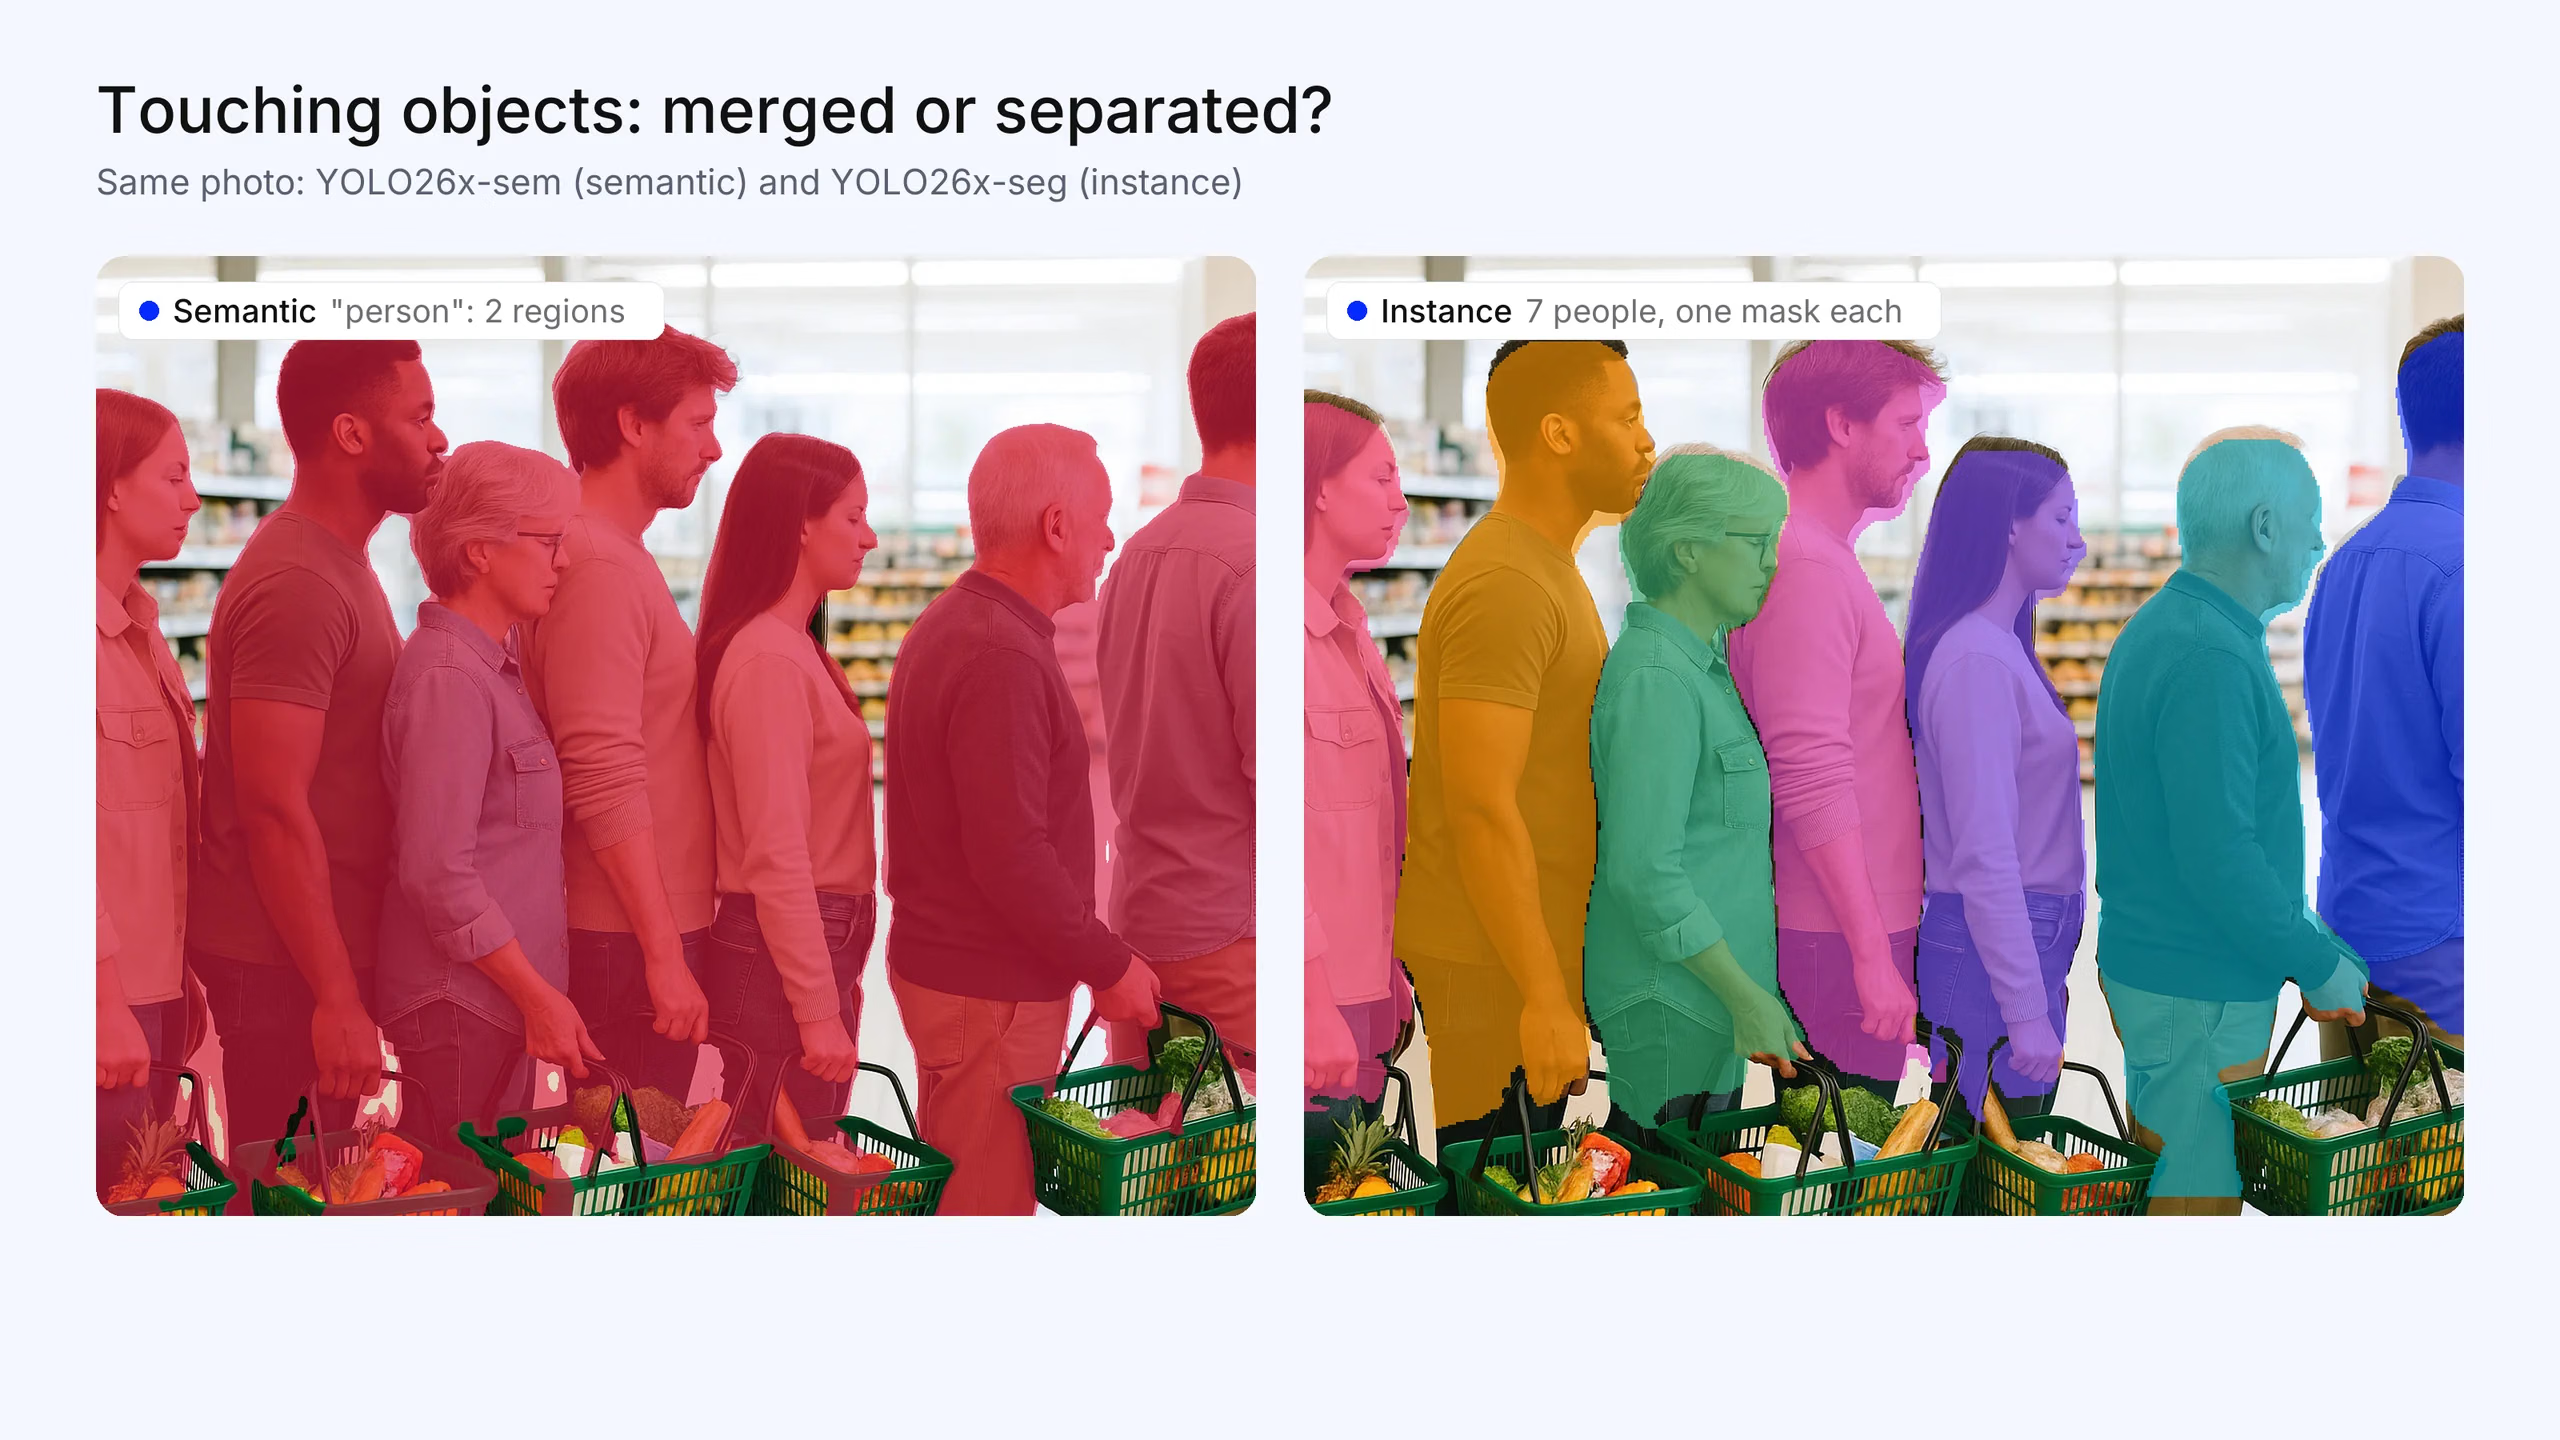
Fig. 2. Siete compradores muy juntos en una cola de caja. En el resultado semántico (Ultralytics YOLO26x-sem), se fusionan en dos regiones conectadas de «persona», así que no puedes contarlos. El resultado de instancias (Ultralytics YOLO26x-seg) los separa a los 7. La foto se generó para este artículo; las máscaras son resultados reales del modelo.
Diferencias clave de un vistazo#
| Criterio | Segmentación semántica | Segmentación de instancias |
|---|---|---|
| Pregunta a la que responde | ¿Qué clase corresponde a cada píxel? | ¿A qué objeto pertenece cada píxel? |
| Objetos de la misma clase | Se fusionan en una sola región | Se separan y cada uno tiene su propia máscara e ID |
| Cobertura | Todos los píxeles, incluido el fondo | Normalmente, solo los objetos de interés |
| Resultado | Un mapa de clases del tamaño de la imagen | Una lista de máscaras, cada una con una clase y una confianza |
| ¿Se pueden contar los objetos? | No directamente | Sí |
| Métrica principal | Intersección sobre unión media (mIoU) | Precisión media de máscaras (mask mAP) |
| Complejidad relativa | Menor: clasificación por píxel | Mayor: detección y máscaras por objeto |
Cuánto cuesta etiquetar cada tarea#
En la práctica, el esfuerzo de etiquetado suele ser lo que determina la elección.
- Los conjuntos de datos semánticos asignan una clase a cada píxel de cada imagen, incluido el fondo. Suelen almacenarse como imágenes de máscara de un solo canal. Todas las imágenes están completamente etiquetadas, así que no se puede omitir ningún píxel, salvo que se marque explícitamente como «ignorar».
- Los conjuntos de datos de instancias delimitan por separado cada objeto de interés, mediante un polígono o una máscara. El fondo puede dejarse sin etiquetar, pero cada objeto necesita su propio contorno y las escenas concurridas multiplican el trabajo.
Ambas tareas requieren mucho trabajo. El etiquetado asistido, en el que un clic o una caja se convierte en una máscara, reduce el esfuerzo de cualquiera de las dos. Si solo necesitas respuestas a nivel de región, no pagues por etiquetas de instancias.
Cómo se evalúa cada tarea#
- La segmentación semántica se mide principalmente con mIoU: la superposición entre las regiones predichas y las reales, promediada entre clases. También se informa de la precisión por píxel. IoU es la misma medida de superposición que se utiliza en detección.
- La segmentación de instancias se mide con mask mAP, la precisión media que se utiliza en detección, pero calculada a partir de la superposición de máscaras. Esta métrica premia la detección de cada objeto, no solo la cobertura de los píxeles correctos.
Estas métricas no son comparables entre sí. Un mIoU alto no indica si se han separado los objetos individuales.
Segmentación panóptica: cuándo necesitas ambas#
La segmentación panóptica asigna una clase a cada píxel y un ID de instancia a los objetos contables. El «stuff» del fondo, como la carretera y el cielo, se etiqueta semánticamente. Los «things» del primer plano, como los coches y las personas, se separan uno a uno. Se mide con la calidad panóptica (PQ). Elígela cuando necesites cubrir toda la escena y separar cada objeto a la vez. Consulta la segmentación panóptica.
Cómo funciona cada una, brevemente#
Los modelos de segmentación semántica suelen ser redes codificador-decodificador que predicen una clase para cada píxel. U-Net, DeepLab y SegFormer son ejemplos conocidos. Los modelos de segmentación de instancias suelen basarse en la detección de objetos. Mask R-CNN predice una máscara dentro de cada caja detectada, mientras que los modelos de una sola etapa, como YOLACT y los modelos de segmentación de Ultralytics YOLO, predicen cajas y máscaras en una sola pasada para su uso en tiempo real. Las arquitecturas universales, como Mask2Former, gestionan la segmentación semántica, de instancias y panóptica con un solo modelo. Para obtener más información sobre la segmentación de instancias, consulta qué es la segmentación de instancias.
Ambas tareas en Ultralytics YOLO#
Ultralytics YOLO ejecuta ambas tareas con la misma API de Python y CLI:
- La segmentación de instancias utiliza la tarea
segment. - La segmentación semántica utiliza la tarea
semantic. Los modelos semánticos YOLO26 llevan el sufijo-semy vienen preentrenados con Cityscapes y ADE20K. La página de la tarea incluye una tabla que muestra exactamente en qué se diferencian las salidas de ambas tareas en el código.
Puedes entrenar ambos localmente o en la nube en Ultralytics Platform.
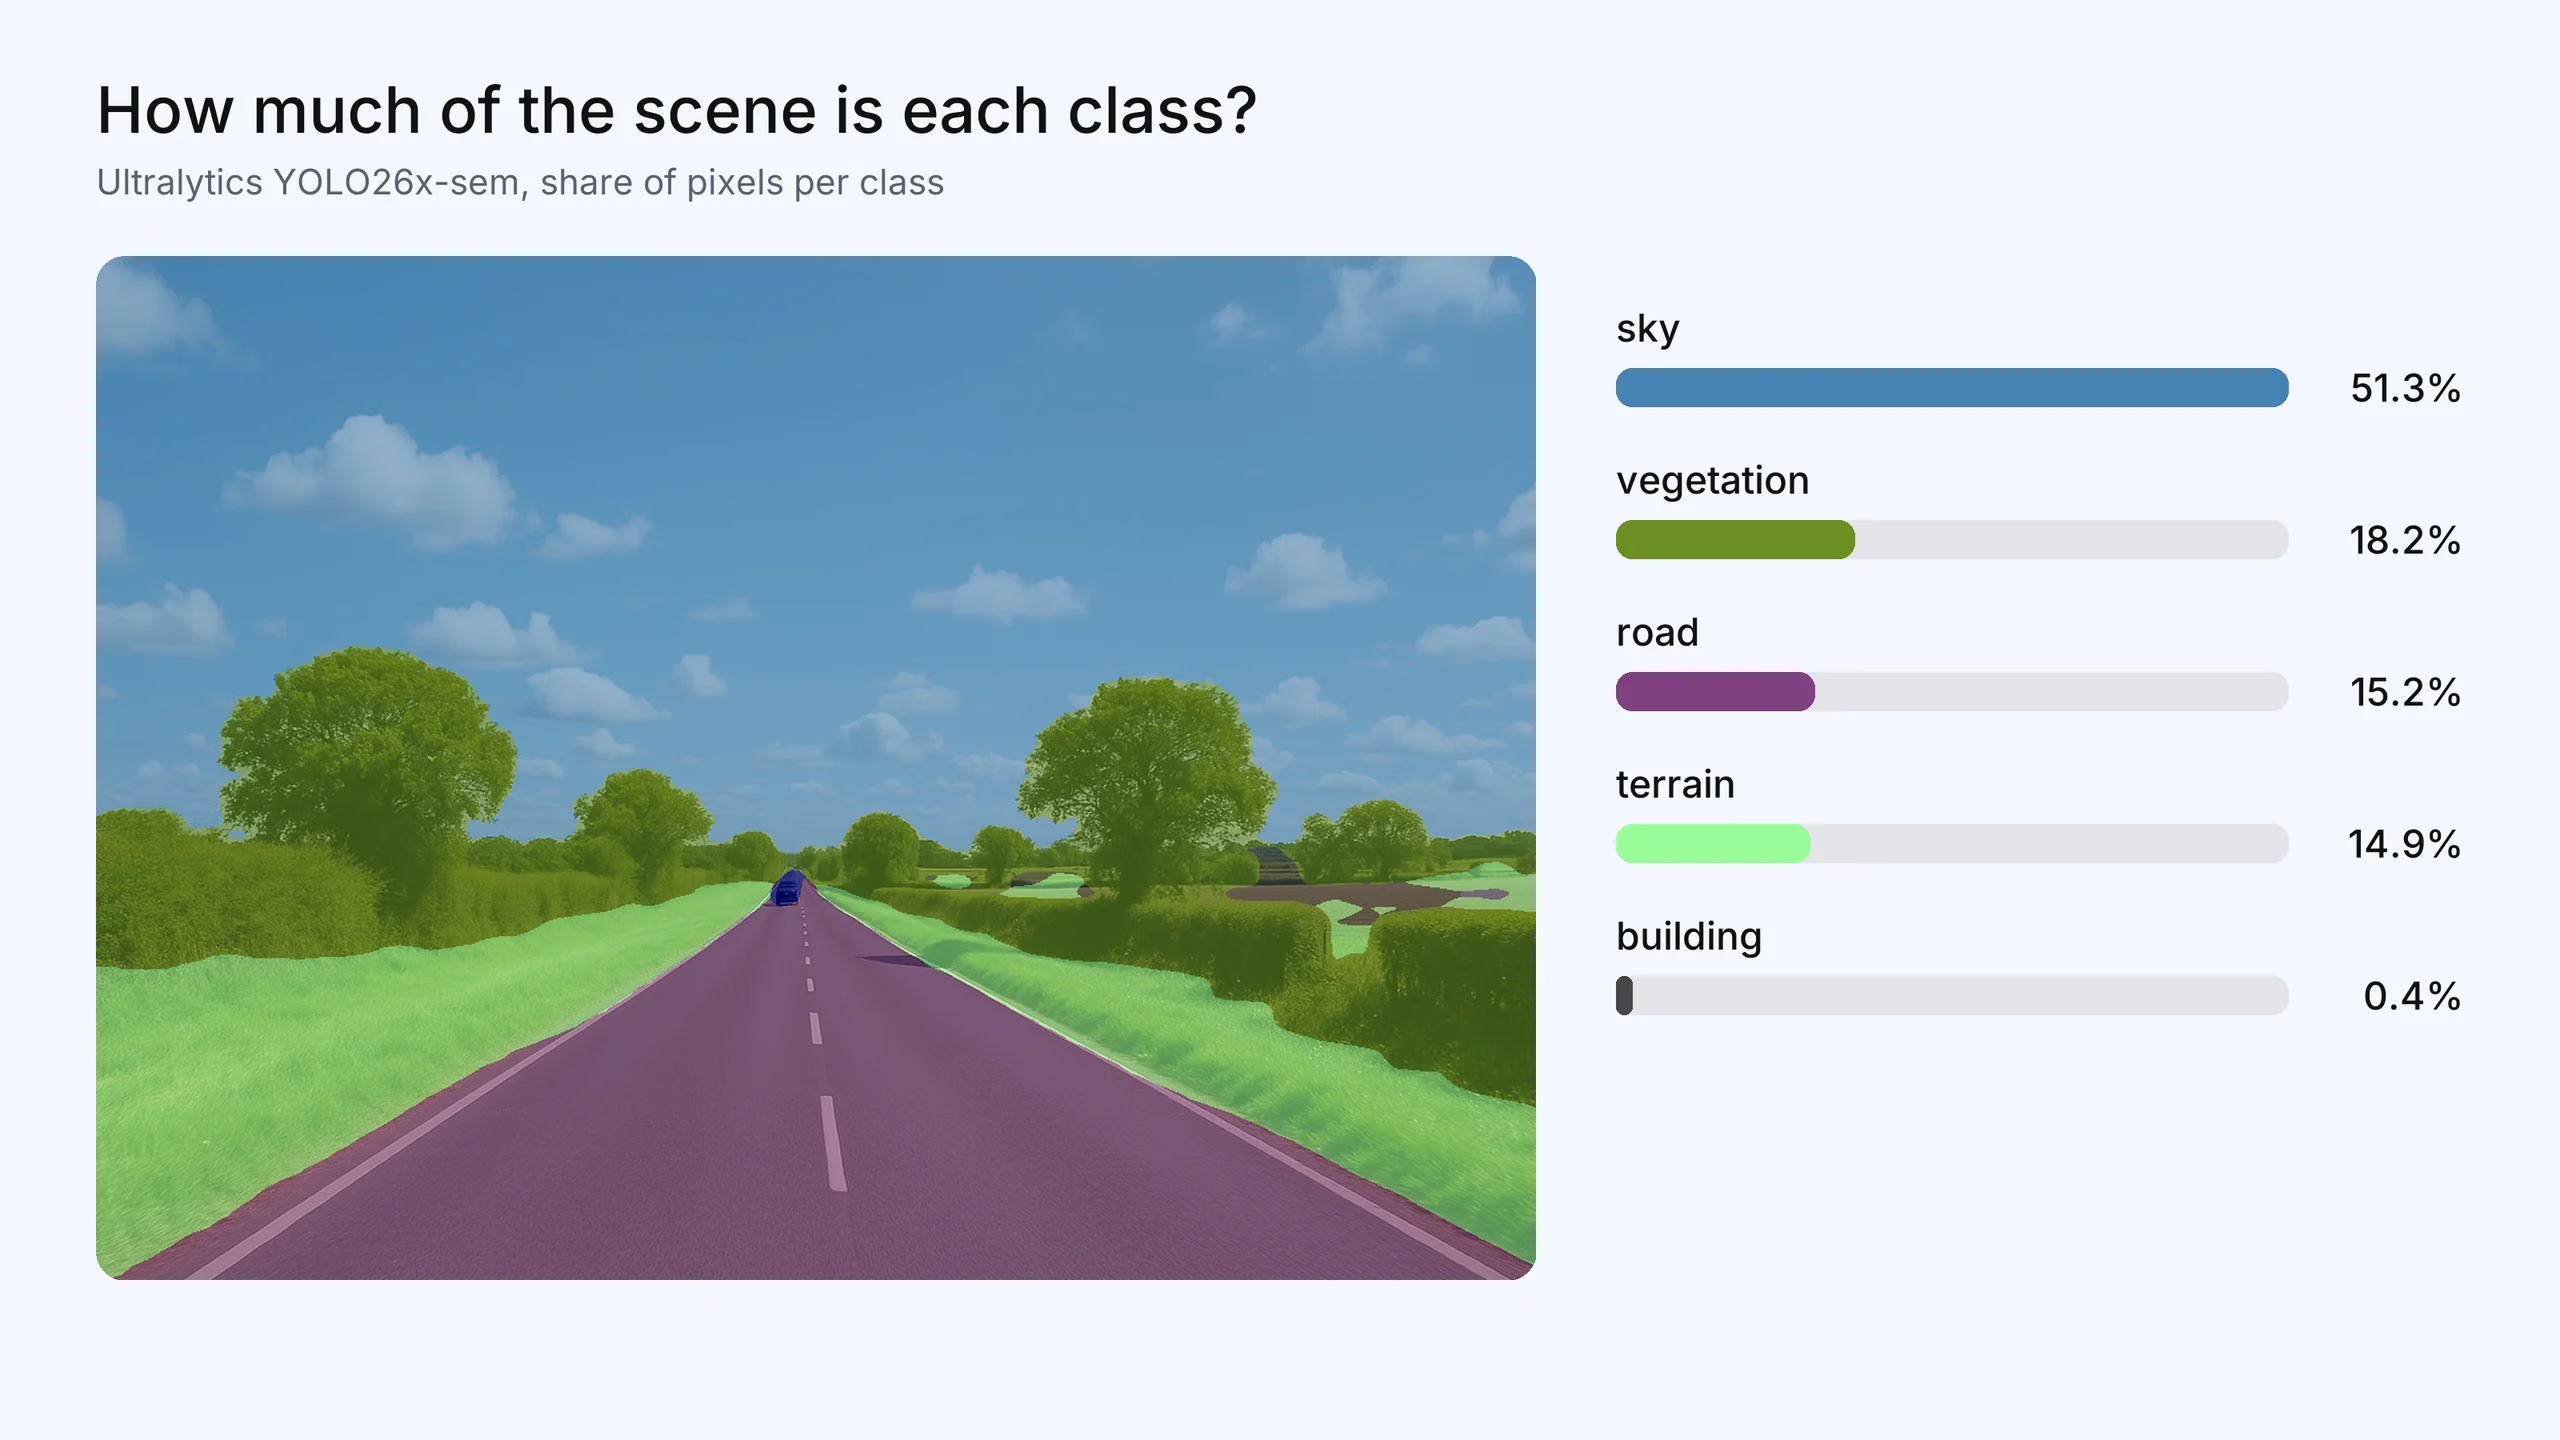
Fig. 3. La segmentación semántica responde a la pregunta «¿qué proporción de la escena corresponde a cada clase?». Ultralytics YOLO26x-sem etiqueta el 51,3 % de esta vista como cielo, el 18,2 % como vegetación, el 15,2 % como carretera y el 14,9 % como terreno. La foto se generó para este artículo; el mapa de clases y las proporciones son resultados reales del modelo.
Preguntas frecuentes
La segmentación semántica asigna una clase a cada píxel, pero trata todos los objetos de una misma clase como una sola región. La segmentación de instancias separa cada objeto en su propia máscara, de modo que los objetos de una misma clase se pueden contar y seguir individualmente.
Plantéate si necesitas distinguir dos objetos de la misma clase que se tocan. Si necesitas contar, seguir o actuar sobre objetos individuales, utiliza la segmentación de instancias. Si solo necesitas saber qué regiones pertenecen a cada clase, la segmentación semántica es más sencilla.
Mask R-CNN es un modelo de segmentación de instancias. Detecta cada objeto y, a continuación, predice una máscara de píxeles independiente dentro del cuadro delimitador de ese objeto.
Por lo general, la segmentación de instancias es más difícil. Tiene que clasificar los píxeles y, además, separar los objetos de una misma clase, lo que requiere tanto detección como segmentación.
Principalmente con la intersección sobre la unión media (mIoU), que mide la superposición media entre las regiones predichas y las reales en todas las clases. La segmentación de instancias utiliza mAP de máscaras y la segmentación panóptica utiliza la calidad panóptica (PQ).









