Los mejores modelos de clasificación de imágenes: cómo elegir
Compara los principales modelos de clasificación de imágenes, desde ConvNeXt V2 y DINOv3 hasta EfficientNetV2, ViT y Ultralytics YOLO26-cls, y aprende a elegir.
No existe un único mejor modelo de clasificación de imágenes. El modelo adecuado depende de cuántos datos etiquetados tengas, de dónde tenga que ejecutarse y de si puedes utilizar su licencia. En 2026, los trabajos que priorizan la precisión se centran en grandes backbones Transformer y auto supervisados, como DINOv3 y EVA-02. Para desplegarlos en hardware limitado, los modelos más pequeños y principalmente convolucionales, como ConvNeXt V2, EfficientNetV2, MobileNetV4 y Ultralytics YOLO26-cls, suelen ser más prácticos, según el tamaño del checkpoint, la configuración de entrenamiento y el hardware de destino. Compara su precisión y latencia con tu propia carga de trabajo. Esta guía explica las cuatro familias de modelos, compara diez modelos de uso extendido y ofrece un proceso de decisión para elegir uno.
Si todavía no conoces bien la tarea, empieza por qué es la clasificación de imágenes. Esta página trata sobre cómo elegir un modelo.
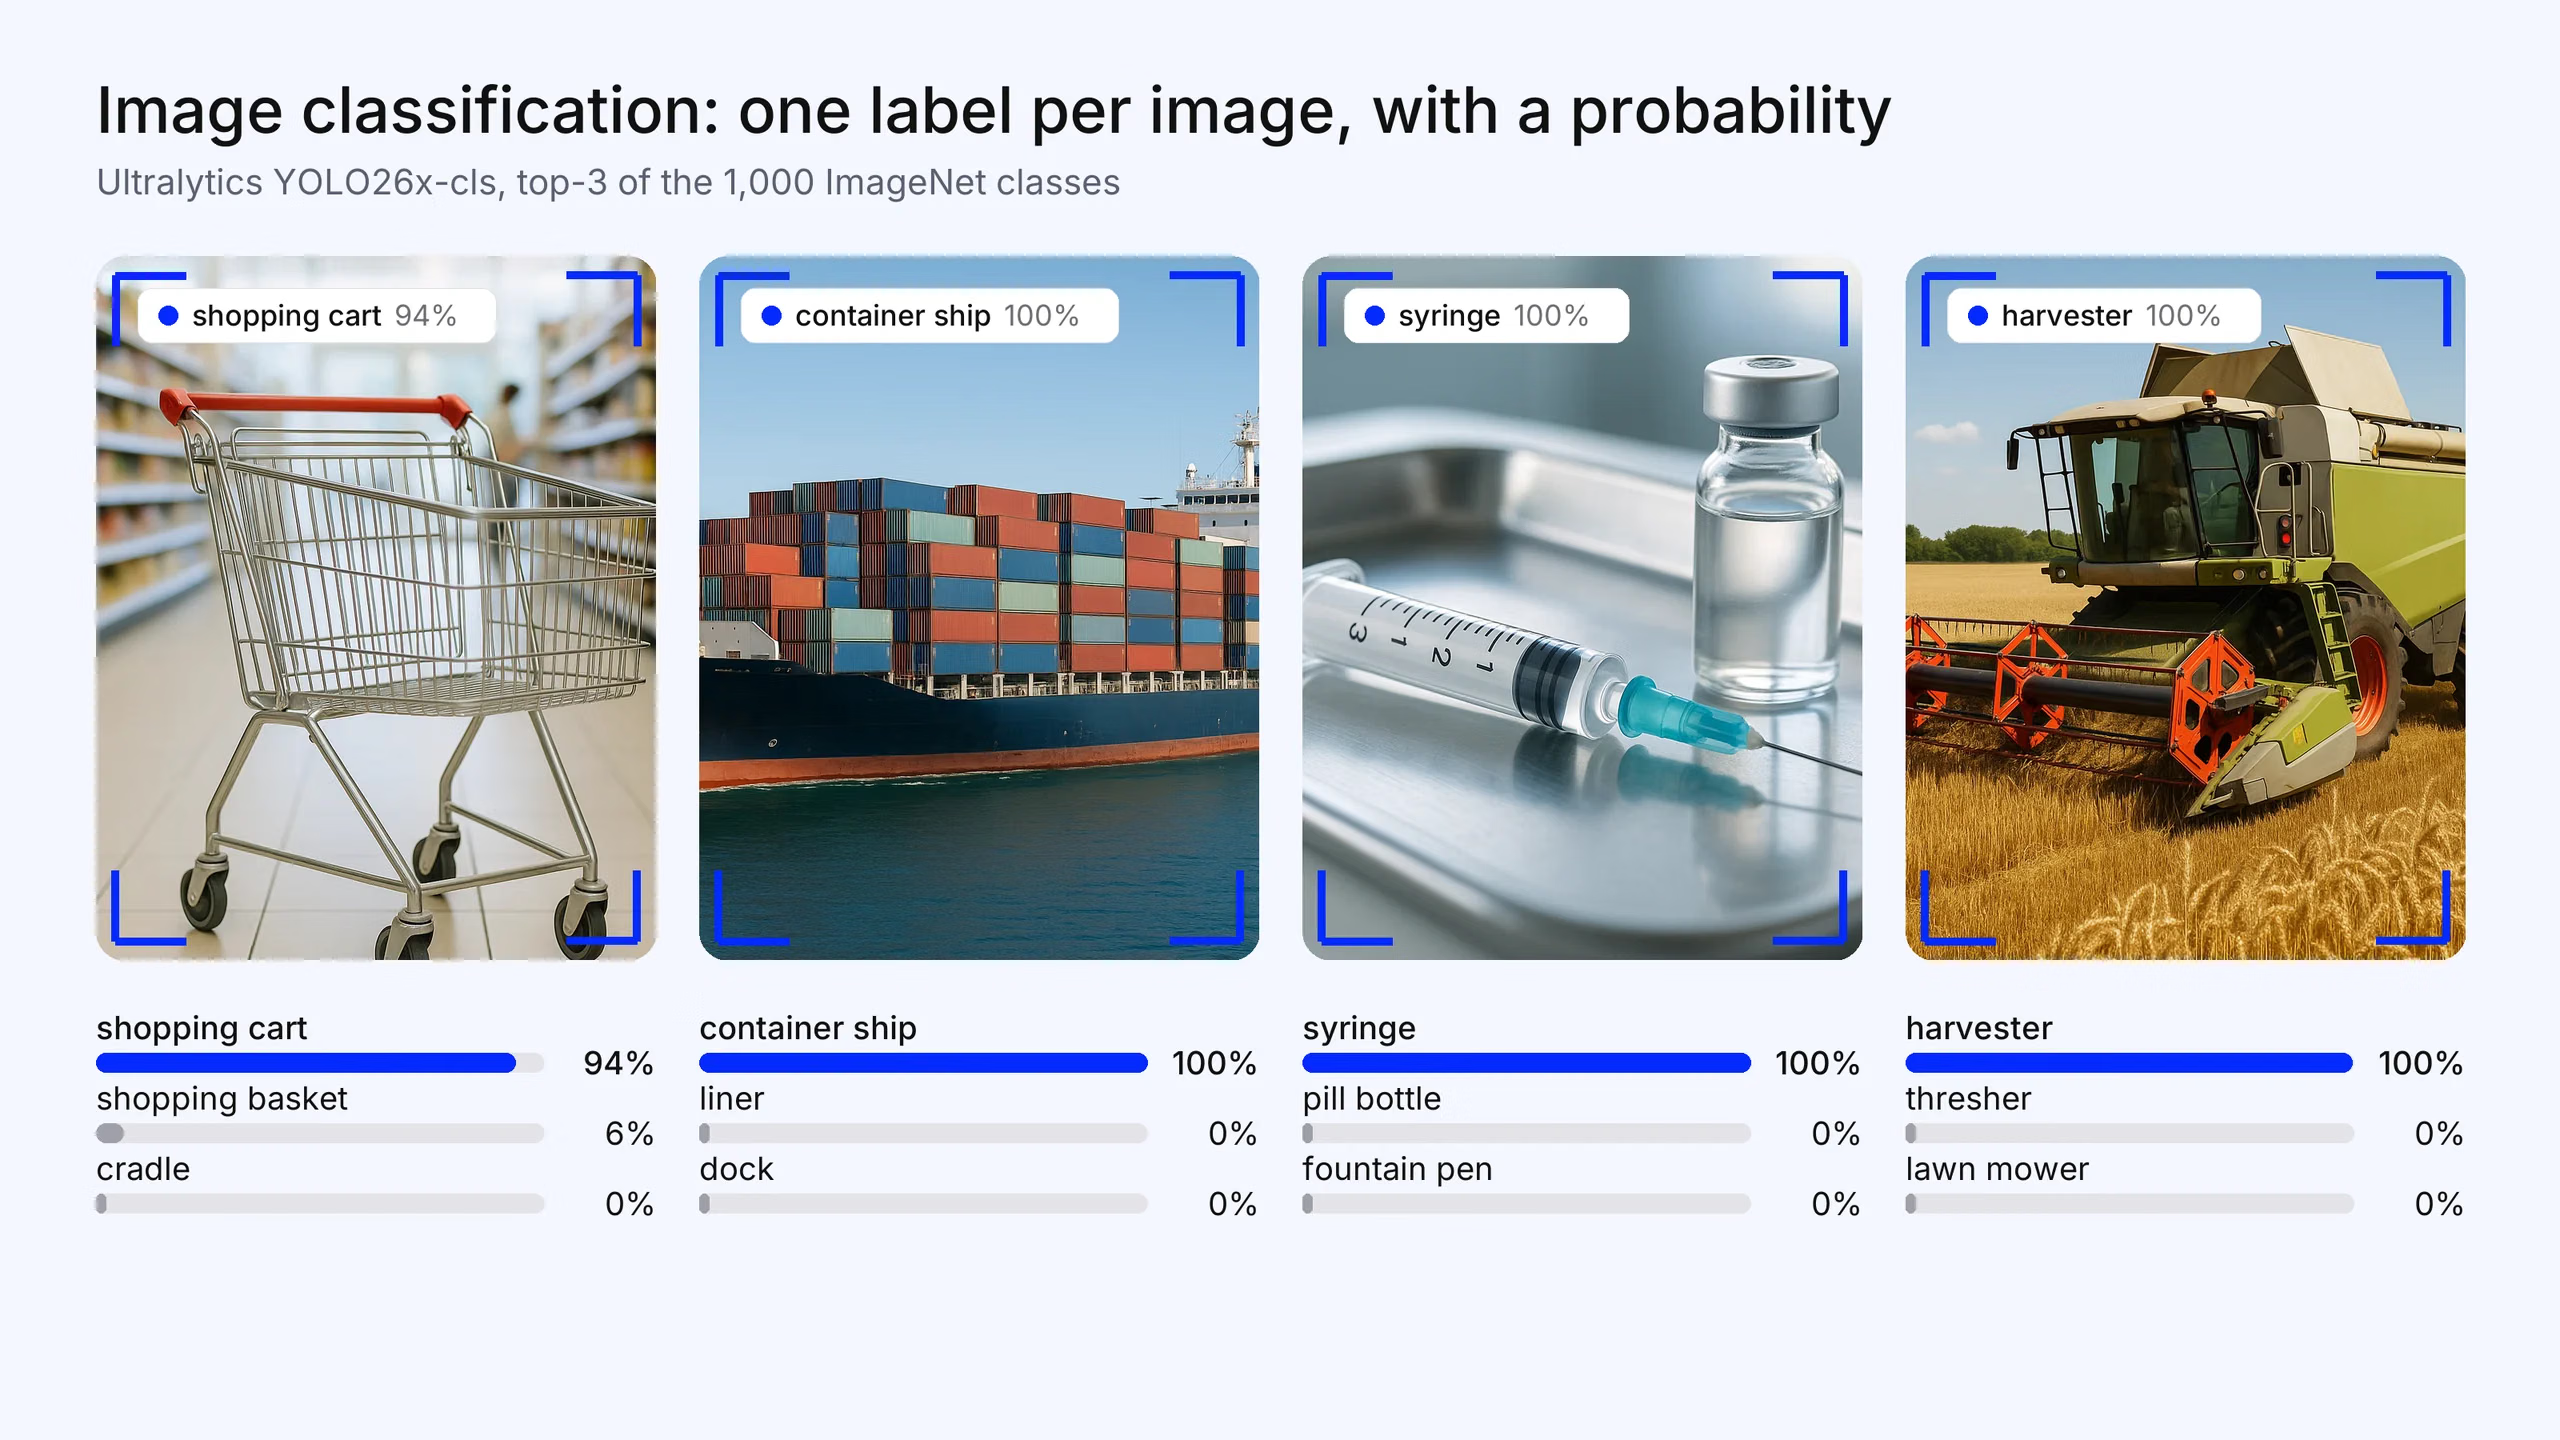
Fig. 1. La clasificación de imágenes devuelve una etiqueta para toda la imagen, con una probabilidad para cada clase: ejemplos de comercio minorista, logística, sanidad y agricultura. Las tres predicciones principales son de Ultralytics YOLO26x-cls, preentrenado con las 1.000 clases de ImageNet. Las fotografías se generaron para este artículo; las predicciones son resultados reales del modelo.
Qué significa «mejor» en un modelo de clasificación de imágenes#
Las clasificaciones comparativas ordenan los modelos según la precisión top-1 en el conjunto de validación de ImageNet. Esa cifra es útil, pero se mide con una resolución fija y un único conjunto de datos, a menudo con un preentrenamiento muy amplio. En un proyecto real suelen ser determinantes otros cuatro factores:
- Datos. Cuántas imágenes etiquetadas tienes por clase y cuánto se parecen a los datos de preentrenamiento.
- Cómputo y latencia. Si la inferencia se ejecuta en una GPU de centro de datos, una CPU o la NPU de un móvil o una cámara.
- Vía de despliegue. Si el modelo se exporta sin problemas al entorno de ejecución que necesitas, como ONNX, TensorRT, Core ML o TFLite.
- Licencia. Si el código y, por separado, los pesos preentrenados permiten el uso que quieres darles.
Un modelo con unos puntos menos en ImageNet, que se ajuste bien a tus imágenes y se ejecute en tiempo real en tu hardware, suele ser la mejor opción.
Las cuatro familias de modelos de clasificación de imágenes#
Redes neuronales convolucionales (CNNs)#
Las CNNs deslizan filtros aprendidos por la imagen, por lo que asumen que los píxeles cercanos están relacionados. Esta suposición incorporada (sesgo inductivo) les permite aprender bien con conjuntos de datos pequeños y medianos, y ejecutarse de forma eficiente en hardware modesto. ResNet y EfficientNet son los ejemplos clásicos.
- Ventajas: aprovechan bien los datos, son rápidas y fáciles de cuantizar y desplegar.
- Compromisos: ofrecen menos contexto global por capa; las mejoras al aumentar la escala suelen estancarse antes que en los Transformer.
Transformers de visión (ViT)#
Un Transformer de visión divide una imagen en parches y los procesa como una secuencia mediante autoatención, de modo que cada parche puede relacionarse con cualquier otro. Los ViT funcionan mejor cuando se preentrenan con grandes cantidades de datos y después se transfieren.
- Ventajas: escalan bien con los datos y el tamaño del modelo; ofrecen una transferencia sólida y son la base natural para el entrenamiento auto supervisado y multimodal.
- Compromisos: necesitan un preentrenamiento a gran escala o una regularización intensa; normalmente, la inferencia es más lenta y pesada que con una CNN de precisión similar.
Modelos híbridos de CNN y Transformer#
Los modelos híbridos utilizan convoluciones en las primeras etapas para captar detalles locales y atención en las posteriores para obtener contexto global. CoAtNet es el diseño de referencia: sus autores descubrieron que apilar capas de convolución y atención en un orden bien fundamentado mejora la generalización, la capacidad y la eficiencia.
- Ventajas: ofrecen un buen equilibrio con conjuntos de datos de tamaño medio.
- Compromisos: son más complejos de implementar, ajustar y exportar que cualquiera de los dos diseños puros.
Backbones auto supervisados y de visión y lenguaje#
La familia más reciente no se define por su arquitectura, sino por cómo se entrena. Los modelos auto supervisados, como DINOv2 y DINOv3, aprenden de imágenes sin etiquetar. Los codificadores de visión y lenguaje, como SigLIP 2, aprenden a partir de pares de imágenes y texto. Ambos generan características de propósito general que puedes clasificar con una pequeña capa lineal o, en el caso de los modelos de visión y lenguaje, con instrucciones de texto y sin entrenamiento (aprendizaje de cero ejemplos). Meta entrenó DINOv3 con 7.000 millones de parámetros y 1.700 millones de imágenes, frente a los 1.100 millones de parámetros y 142 millones de imágenes de DINOv2.
- Ventajas: características sólidas con pocos datos etiquetados; un mismo backbone sirve para muchas tareas.
- Compromisos: los checkpoints más grandes son demasiado pesados para dispositivos periféricos; las licencias varían y hay que comprobarlas.
Comparativa de modelos de clasificación de imágenes#
Los modelos aparecen en orden alfabético, no por clasificación. No hemos incluido cifras de precisión: los resultados publicados en ImageNet varían según la resolución, los datos de preentrenamiento y el procedimiento de evaluación, por lo que no son comparables entre estas filas. El artículo o la documentación de cada modelo, enlazados a continuación, incluyen sus propias cifras.
| Modelo | Familia | De | Preentrenamiento | Ideal para | Principal contrapartida |
|---|---|---|---|---|---|
| ConvNeXt V2 | CNN | Meta | Auto codificación enmascarada auto supervisada (FCMAE) y, después, ajuste fino supervisado | CNN precisa y desplegable en muchos tamaños | Los pesos de ImageNet tienen licencia CC-BY-NC (uso no comercial) |
| DINOv3 | Auto supervisado (ViT y ConvNeXt) | Meta | Auto supervisado con 1.700 millones de imágenes | Características congeladas sólidas con pocos datos etiquetados | Licencia DINOv3 propia; el modelo más grande tiene 7.000 millones de parámetros |
| EfficientNetV2 | CNN | Supervisado | Entrenamiento rápido y ajuste fino eficiente | Diseño anterior; los backbones más recientes ofrecen mayor precisión | |
| EVA-02 | ViT | BAAI | Modelado de imágenes enmascaradas sobre características CLIP | Investigación y ajuste fino con prioridad en la precisión | Las variantes grandes son pesadas durante la inferencia |
| MobileNetV4 | CNN e híbrido (móvil) | Supervisado | Móviles, NPU y aceleradores periféricos | Menor precisión máxima que los modelos de clase servidor | |
| ResNet | CNN | Microsoft Research | Supervisado | Modelos de referencia, docencia y flujos de trabajo heredados | Ya no es competitiva en precisión por FLOP |
| SigLIP 2 | Visión y lenguaje (ViT) | Pares de imágenes y texto, multilingües | Clasificación de cero ejemplos y con vocabulario abierto | Valida los resultados de cero ejemplos con las clases que tienes previstas antes de confiar en ellos | |
| Swin Transformer | ViT (jerárquico) | Microsoft Research | Supervisado | Entradas de mayor resolución y reutilización del backbone | Más pesado que las CNN con una precisión similar |
| Ultralytics YOLO26-cls | CNN | Ultralytics | Supervisado con ImageNet | Clasificadores personalizados rápidos, exportación a dispositivos periféricos y una misma API para detección | Menor precisión máxima que los Transformer grandes preentrenados |
| ViT | ViT | Supervisado, a menudo con conjuntos de datos grandes | Aprendizaje por transferencia a gran escala | Necesita muchos datos si no cuenta con un preentrenamiento amplio |
Los modelos, en detalle#
En orden alfabético.
ConvNeXt V2#
ConvNeXt V2 combina un autocodificador enmascarado totalmente convolucional (FCMAE) con una capa de normalización de respuesta global. Está disponible en ocho tamaños, desde Atto (3,7 millones de parámetros) hasta Huge (660 millones), por lo que una misma familia abarca desde dispositivos periféricos hasta servidores. Es una opción predeterminada sólida si buscas una precisión propia de la era de los Transformer con un despliegue basado en CNN. Compromiso: el código tiene licencia MIT, pero los pesos preentrenados y ajustados con ImageNet tienen licencia CC-BY-NC, que excluye el uso comercial de esos pesos.
DINOv3#
DINOv3 es el backbone de visión auto supervisado de Meta. Se publica como modelos ViT, desde ViT-S/16 hasta ViT-7B/16, además de modelos ConvNeXt destilados para uso en el dispositivo. Meta lo evalúa con el backbone congelado y el repositorio incluye una cabeza de clasificación de ImageNet para el modelo 7B. Es el modelo que puedes probar si tienes pocas etiquetas y buscas características que se transfieran bien. Compromiso: se publica con su propia licencia DINOv3, no con una licencia estándar de código abierto, y los resultados más destacados corresponden al modelo más grande.
EfficientNetV2#
EfficientNetV2, de Google, utiliza aprendizaje progresivo: aumenta el tamaño de la imagen durante el entrenamiento y ajusta la regularización para adaptarla. Así, se entrena más rápido y utiliza menos parámetros que los modelos anteriores. Sigue siendo una opción fiable para el ajuste fino con conjuntos de datos pequeños o medianos. Compromiso: es anterior a los backbones de 2023–2025 y ya no lidera en precisión. Para conocer los antecedentes del diseño original, consulta nuestra descripción general de EfficientNet.
EVA-02#
EVA-02 es un Transformer convencional preentrenado mediante modelado de imágenes enmascaradas para reconstruir características de un gran codificador visual CLIP. Sus cuatro tamaños van de 6 a 304 millones de parámetros. Está disponible en timm para ajuste fino. Compromiso: las variantes grandes son costosas de ajustar y ejecutar, y resultan excesivas para clasificadores de dominios sencillos.
MobileNetV4#
MobileNetV4 es la familia móvil más reciente de Google, diseñada para ofrecer eficiencia en CPU móviles, DSP, GPU, Apple Neural Engine y Google Pixel EdgeTPU. Es la opción natural para un móvil o un acelerador de bajo consumo. Compromiso: sacrifica precisión máxima a cambio de latencia.
ResNet#
ResNet introdujo las conexiones residuales y sigue siendo el modelo de referencia estándar, compatible con todos los frameworks. Compromiso: las CNN más recientes ofrecen mayor precisión con el mismo cómputo. Consulta qué es ResNet-50 para conocer la arquitectura.
SigLIP 2#
SigLIP 2 (consulta nuestra entrada del glosario sobre SigLIP) es la familia de codificadores de visión y lenguaje multilingües de Google. Puede clasificar imágenes comparándolas con una lista de etiquetas de texto sin entrenamiento (con un enfoque similar al de CLIP), y su variante NaFlex conserva la relación de aspecto original de la entrada. Es la opción más adecuada si tu conjunto de etiquetas cambia a menudo o todavía no tienes datos etiquetados. Compromiso: la calidad de cero ejemplos varía según el dominio, así que valídala con las clases previstas (por ejemplo, tipos de defectos) antes de confiar en ella. Si no es suficiente, entrena una cabeza de clasificación o ajusta el modelo.
Swin Transformer#
Swin Transformer calcula la atención dentro de ventanas locales desplazadas, lo que mantiene el cómputo lineal respecto al tamaño de la imagen y lo hace adecuado para entradas de mayor resolución. Compromiso: es más pesado que una CNN de precisión similar; ConvNeXt se diseñó para competir con él mediante convoluciones convencionales.
Ultralytics YOLO26-cls#
Ultralytics YOLO26-cls es la variante de clasificación de Ultralytics YOLO26. Está disponible en cinco tamaños (n, s, m, l, x), de 2,8 a 29,6 millones de parámetros (fusionados), admite entradas de 224 píxeles y está preentrenado con ImageNet. La documentación indica la precisión top-1 y top-5 en el conjunto de validación de ImageNet y la latencia en CPU y GPU para cada tamaño. La misma API de Python y la CLI permiten entrenar, validar y exportar modelos de clasificación, detección, segmentación y pose; los clasificadores se exportan a formatos como ONNX, TensorRT, Core ML, OpenVINO y LiteRT. Los modelos YOLO11-cls anteriores utilizan los mismos cinco tamaños y el mismo tamaño de entrada. Compromisos:
- Límite de precisión. Incluso el modelo x es pequeño en comparación con los grandes Transformer preentrenados, como EVA-02 o DINOv3, por lo que no es la opción adecuada para investigación que priorice la precisión.
- Recortes cuadrados de forma predeterminada. El entrenamiento utiliza un recorte redimensionado aleatorio y la validación, un recorte centrado, lo que puede cortar partes de las imágenes con relaciones de aspecto extremas. La documentación muestra cómo sustituirlo por un redimensionamiento sencillo.
- Licencia. Los modelos de Ultralytics tienen licencia AGPL-3.0. Para uso comercial con código cerrado, necesitas una licencia Ultralytics Enterprise.
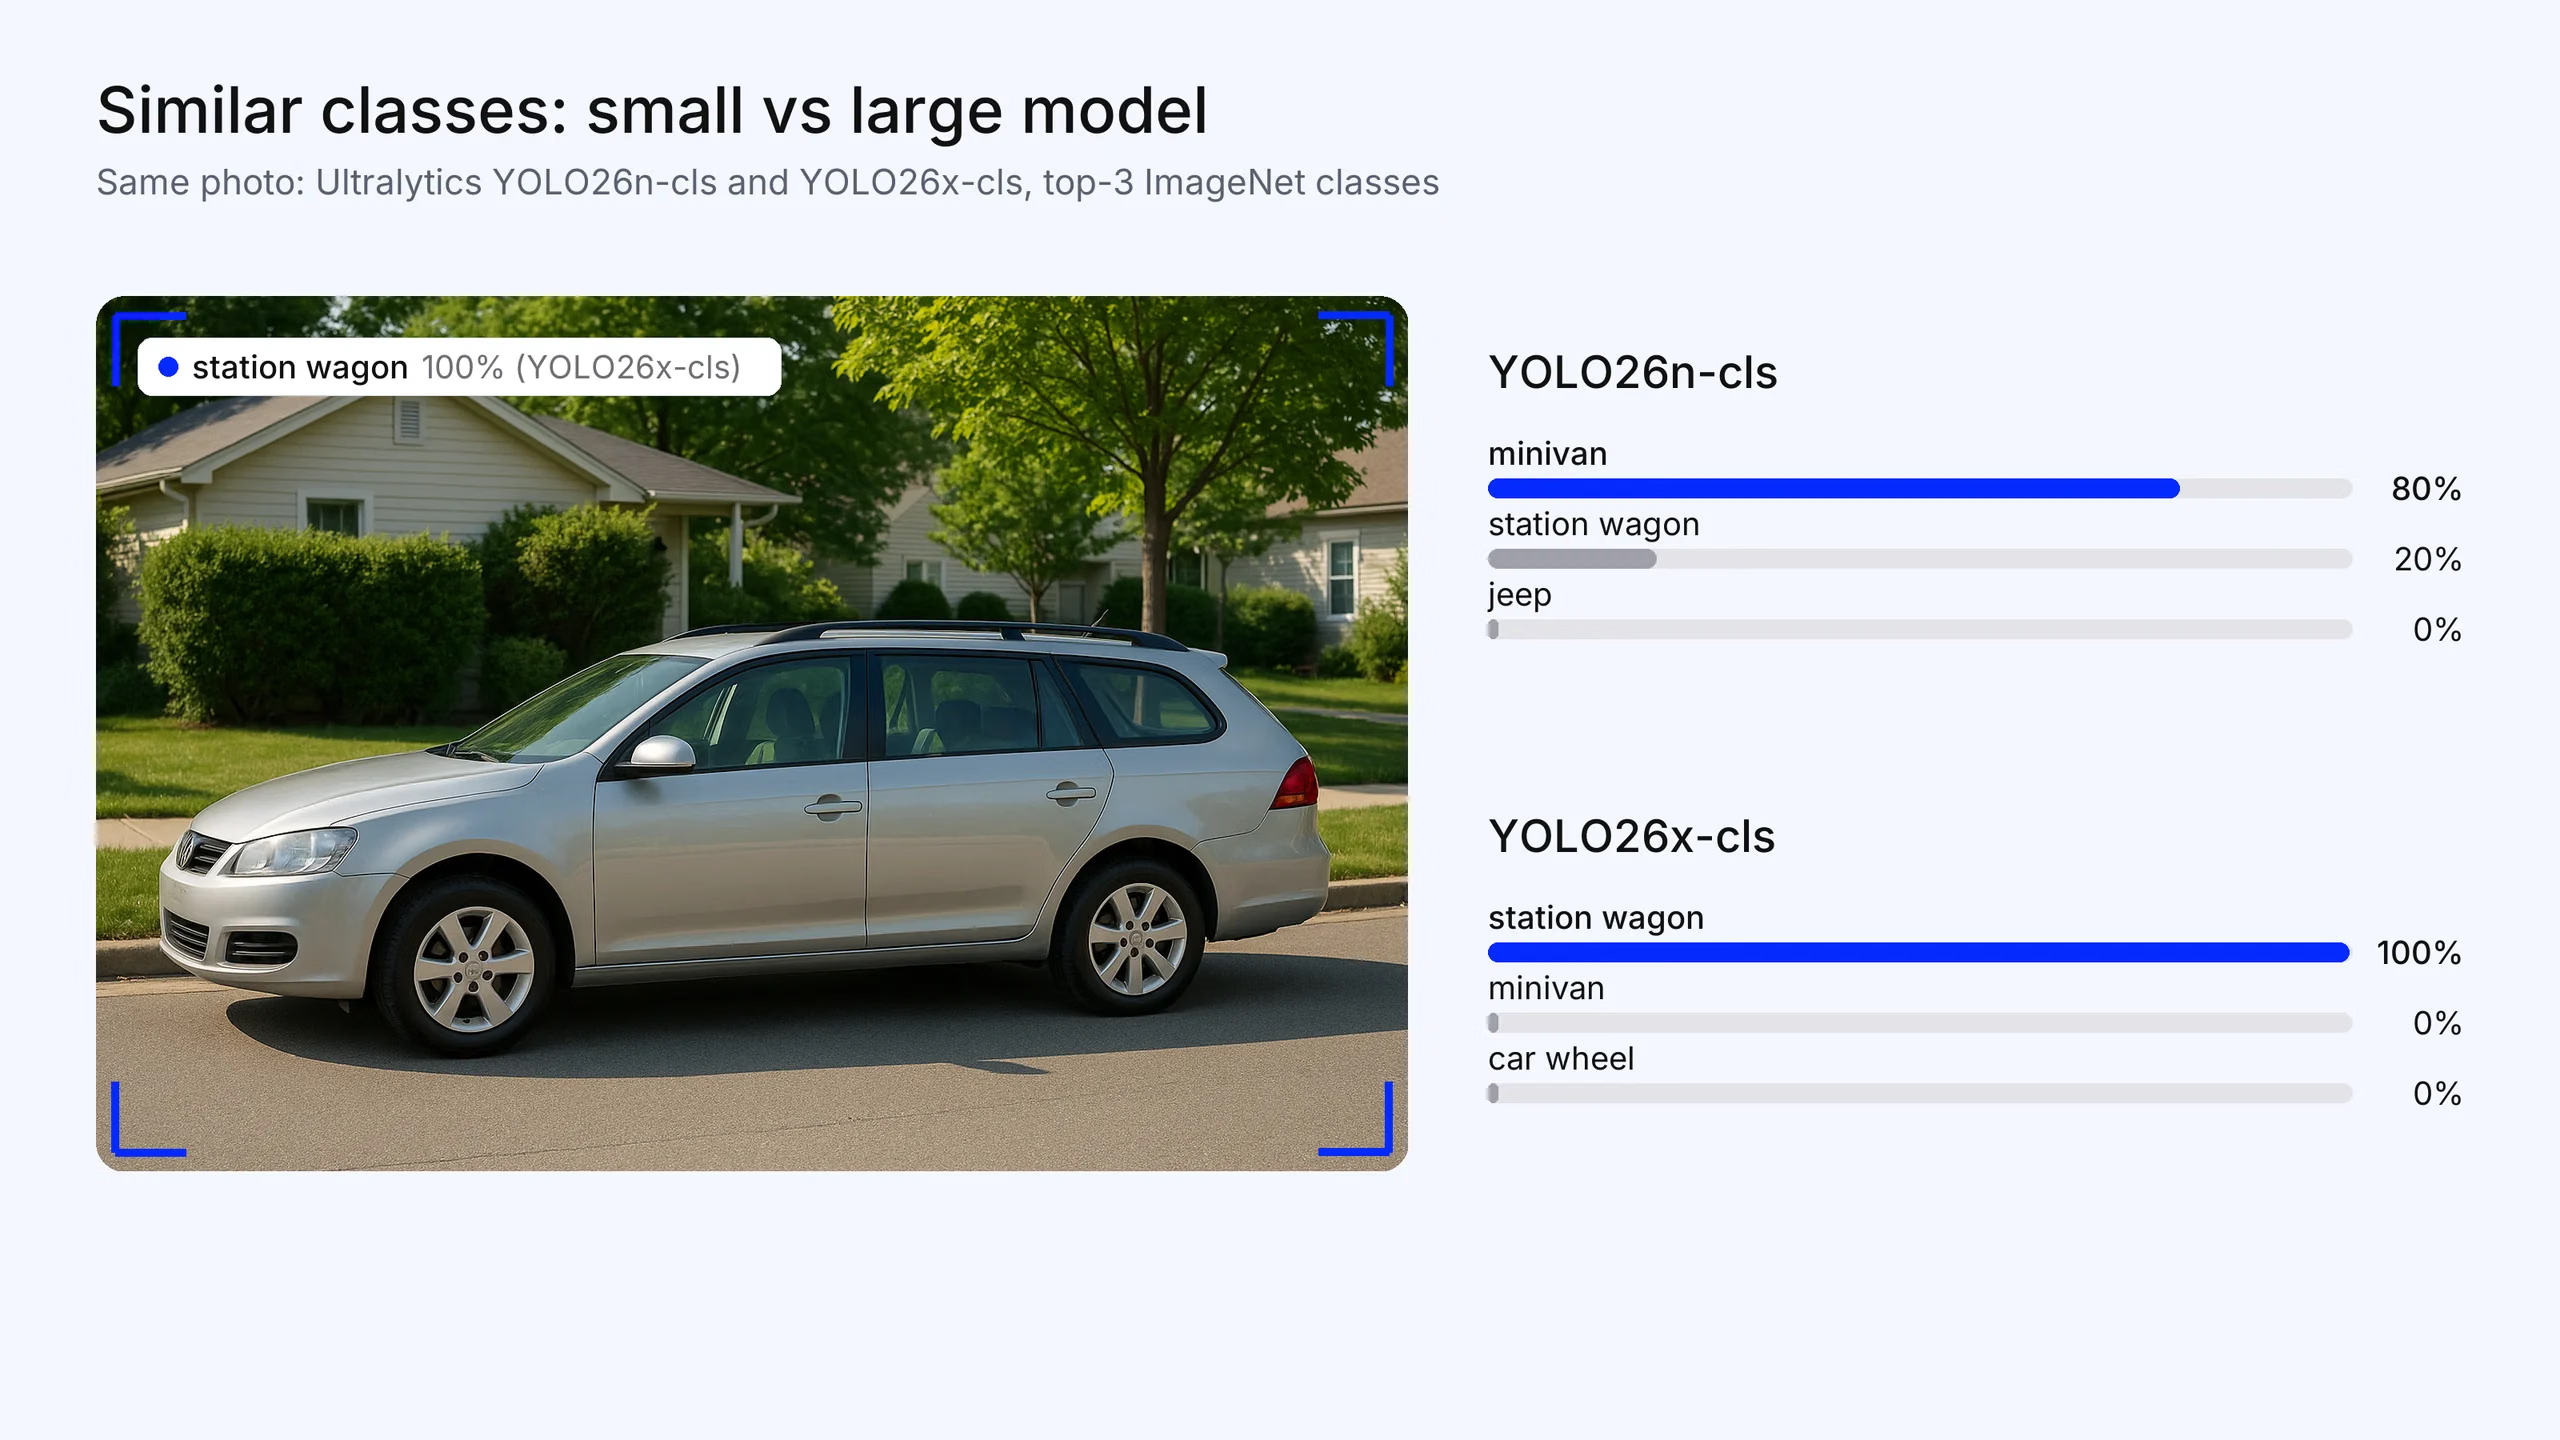
Fig. 2. Las clases similares son donde se aprecia el tamaño del modelo. En esta foto de un familiar, Ultralytics YOLO26n-cls clasifica primero «minivan» (80 %), mientras que YOLO26x-cls clasifica primero «familiar» (100 %, mostrado como la clase «beach wagon, station wagon» de ImageNet). Comprueba estas clases específicas en tu propio conjunto de validación. La foto se generó para este artículo; las predicciones son resultados reales del modelo.
ViT#
El Vision Transformer original de Google demostró que un Transformer puro aplicado a parches de imagen puede igualar o superar a las CNN si se preentrena con grandes cantidades de datos. Compromiso: sin un preentrenamiento a gran escala, rinde peor que las CNN con conjuntos de datos pequeños y necesita más capacidad de cálculo durante la inferencia.
Cómo elegir un modelo de clasificación de imágenes#
Responde a estas preguntas en orden:
- ¿Tienes datos etiquetados? Si no tienes ejemplos etiquetados, empieza con un modelo de visión y lenguaje como SigLIP 2 para la clasificación zero-shot. Si tienes un conjunto de datos pequeño etiquetado, evalúa también una base DINOv3 congelada con una capa lineal entrenada.
- ¿Dónde se ejecutará? En un móvil o una NPU, preselecciona MobileNetV4 o una CNN pequeña, como YOLO26n-cls o una ConvNeXt V2 pequeña. Para una GPU edge o una CPU en tiempo real, considera YOLO26-cls, EfficientNetV2 o ConvNeXt V2. En un servidor sin un presupuesto de latencia estricto, considera EVA-02, Swin o un ViT DINOv3.
- ¿Cuántos datos etiquetados tienes por clase? Con cientos o unos pocos miles de imágenes, el aprendizaje por transferencia a partir de una CNN preentrenada o una base autosupervisada congelada es la opción más segura. Con decenas de miles de imágenes o más, el ajuste fino completo de los Transformers empieza a dar resultados.
- ¿Puedes usar la licencia? Comprueba los pesos, no solo el código: los pesos de ImageNet de ConvNeXt V2 no son comerciales, DINOv3 tiene su propia licencia y los modelos de Ultralytics están sujetos a AGPL-3.0, a menos que tengas una licencia Enterprise.
- ¿Se puede exportar a tu entorno de ejecución? Confirma que haya una ruta compatible con ONNX, TensorRT, Core ML o TFLite antes de decidirte.
A continuación, ajusta dos o tres de los modelos preseleccionados y compáralos con tu propia partición de validación.
Cuándo otro modelo te dará mejores resultados que YOLO#
YOLO26-cls está diseñado para crear clasificadores personalizados rápidos y fáciles de implementar. Para algunos trabajos, es mejor elegir otro modelo:
- Investigación o pruebas de rendimiento que priorizan la precisión: usa EVA-02, ConvNeXt V2 o un ViT a través de timm, con recetas y pesos disponibles para reproducir resultados de nivel ImageNet.
- Muy pocas etiquetas o muchas tareas posteriores a partir de una misma base: usa características DINOv3 con una capa lineal.
- Conjuntos de etiquetas abiertos o que cambian con frecuencia: usa SigLIP 2 zero-shot.
- NPU de móviles, como Apple Neural Engine o EdgeTPU: MobileNetV4 se diseñó y probó específicamente para estos dispositivos.
Si también necesitas localizar objetos, y no solo saber qué muestra la imagen, necesitas un detector. Consulta nuestra comparativa de modelos de detección de objetos.
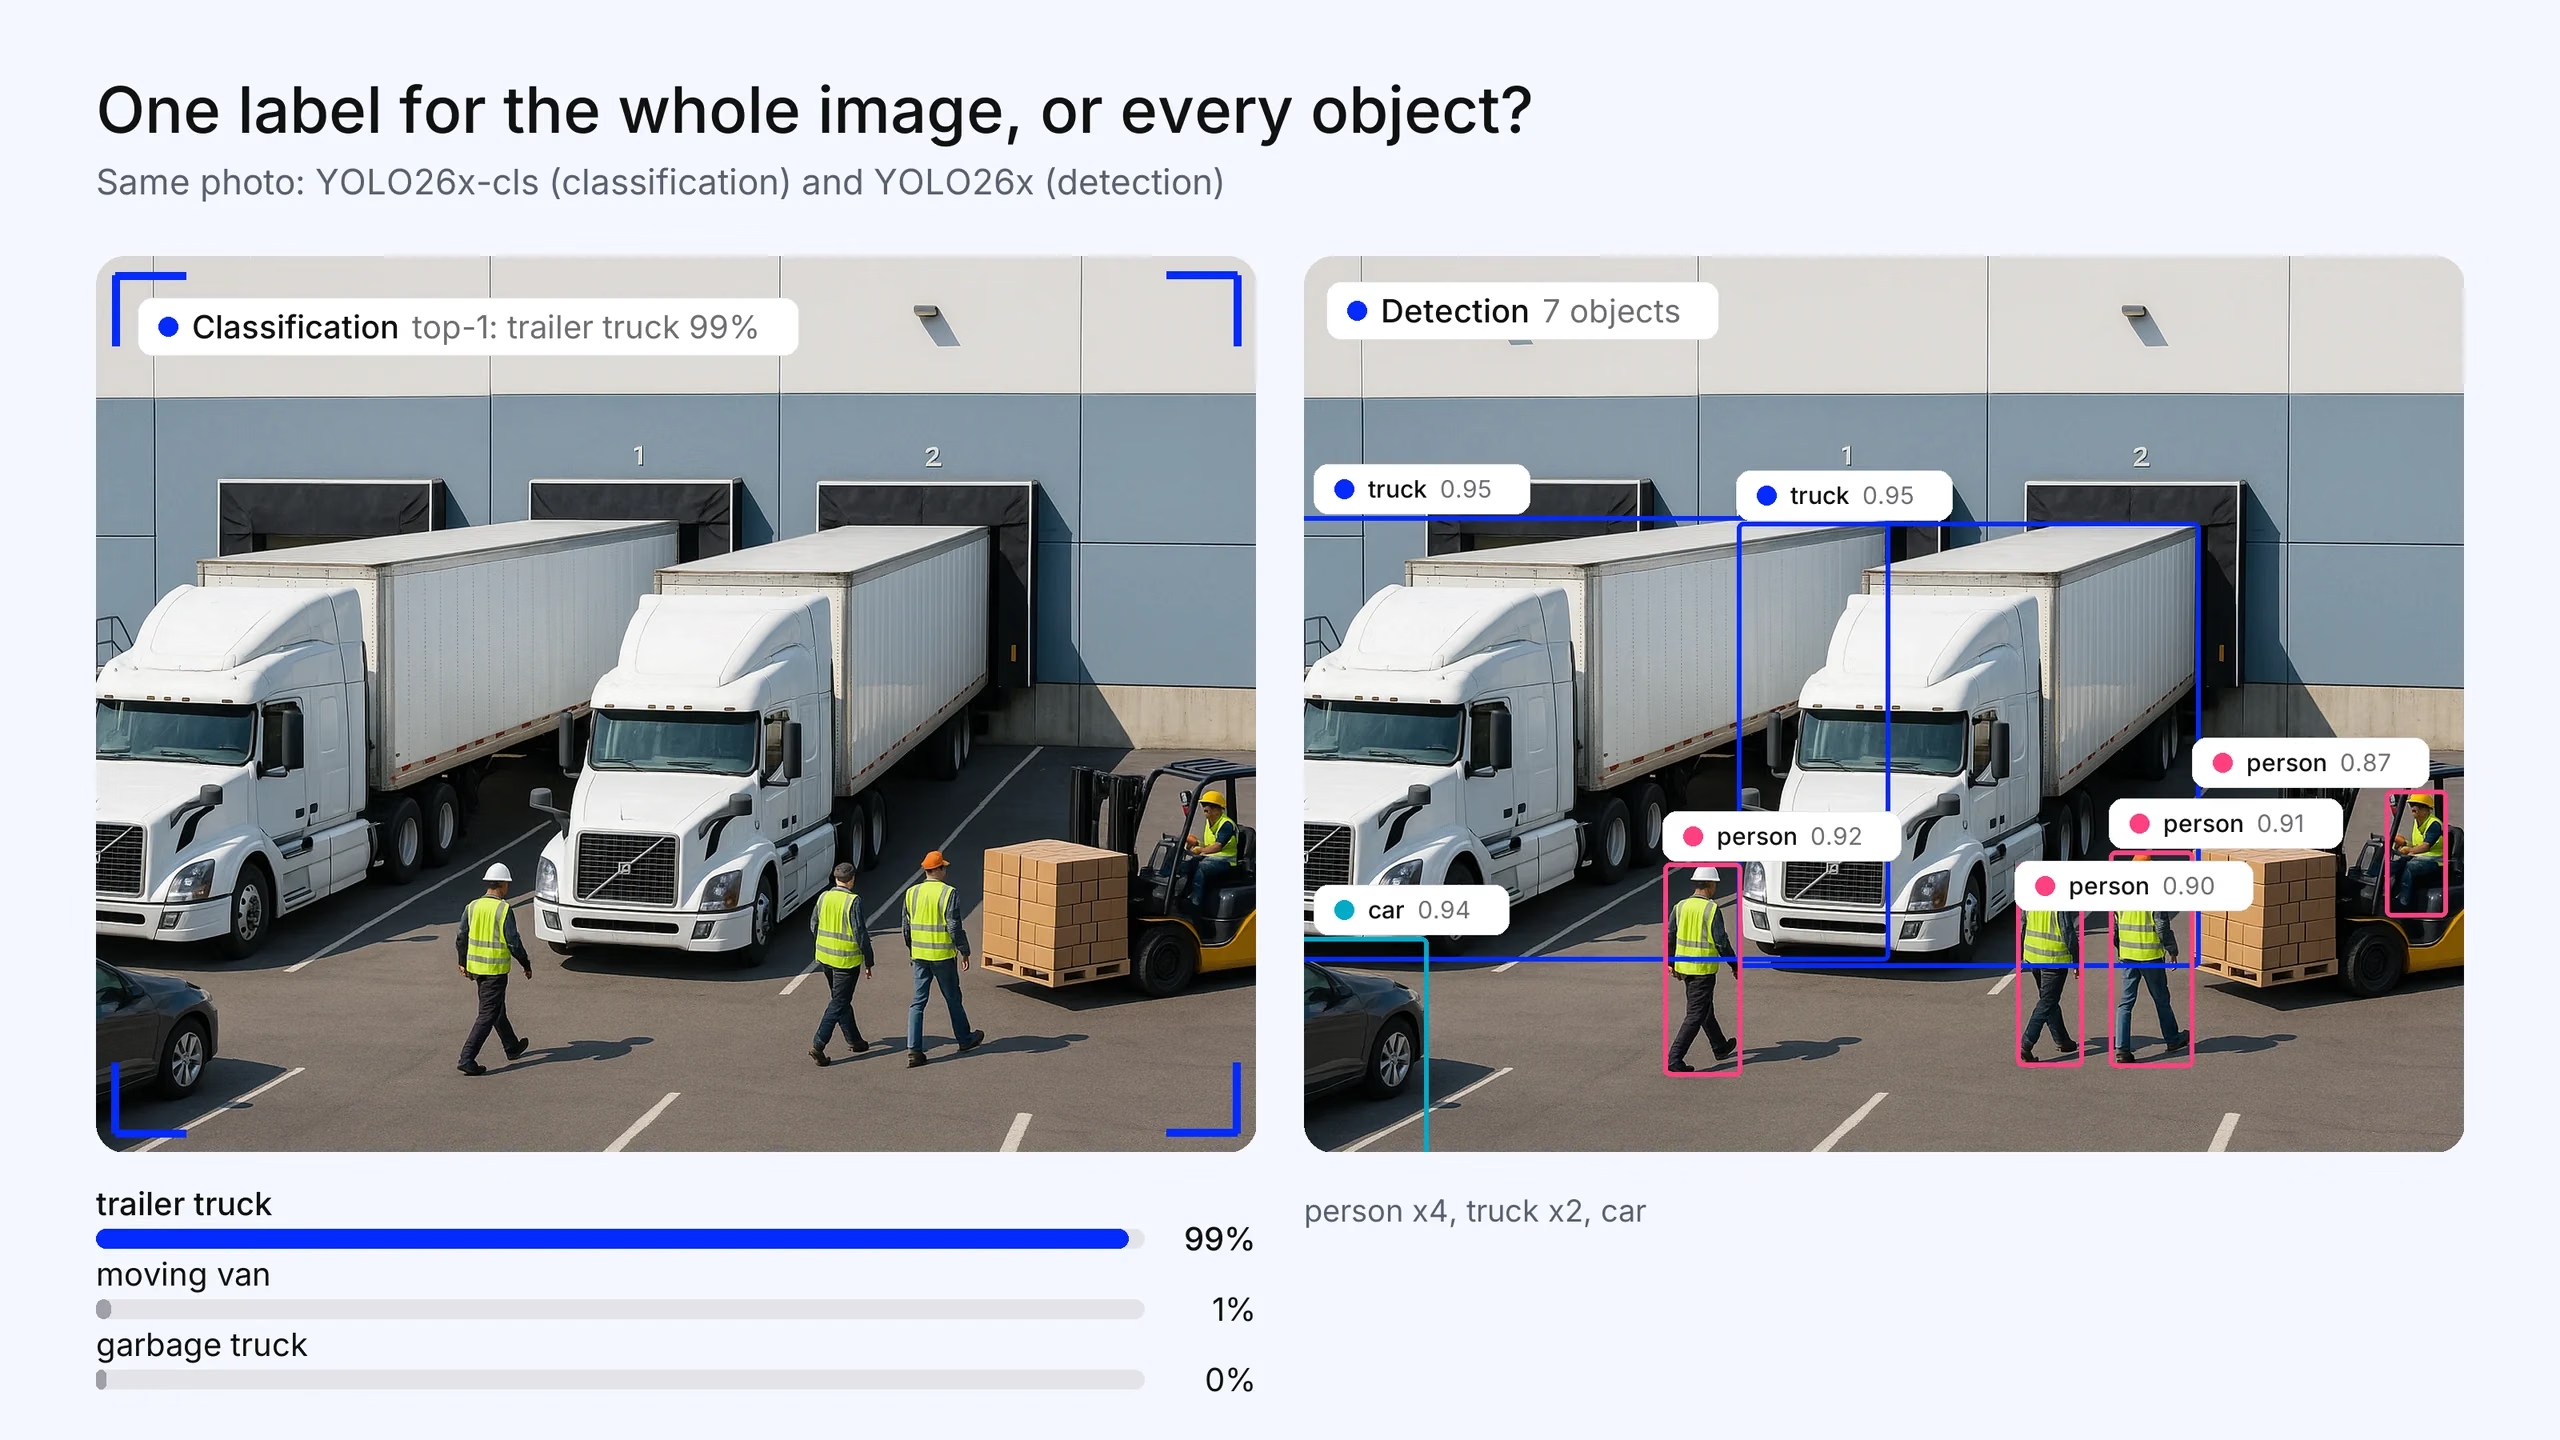
Fig. 3. En una escena con muchos objetos, un clasificador sigue devolviendo una sola etiqueta: Ultralytics YOLO26x-cls clasifica este patio de distribución como «camión con remolque» con un 99 %. La detección de Ultralytics YOLO26 encuentra 7 objetos: 4 personas, 2 camiones y un coche, cada uno con su propia caja (confianza de 0,5 o superior). La foto se generó para este artículo; los resultados son reales.
Dónde conseguir modelos preentrenados y entrenar los tuyos#
- timm (Modelos de imagen de PyTorch) reúne la mayoría de las bases anteriores, desde ViT y ConvNeXt hasta MobileNetV4, EVA y DINOv3, junto con scripts de entrenamiento y evaluación. El código está sujeto a Apache 2.0; las licencias de los pesos varían.
- Hugging Face aloja la mayoría de los clasificadores basados en Transformers, incluidos SigLIP 2 y DINOv3, con pipelines listos para clasificación zero-shot y de imágenes.
- El paquete de Python de Ultralytics entrena YOLO26-cls con una carpeta de imágenes ordenadas por clase. Consulta el formato del conjunto de datos de clasificación y la guía de la tarea de clasificación.
- Ultralytics Platform añade anotación y entrenamiento en la nube para los mismos modelos. Se lanzó en 2026, así que es más reciente que los servicios de entrenamiento alojados ya consolidados. Para servir modelos después del entrenamiento, consulta nuestra comparativa de plataformas de inferencia de visión artificial.
Preguntas frecuentes
No hay uno que sea el mejor en todos los casos. Para trabajos que priorizan la precisión y disponen de abundante capacidad de cálculo, las grandes bases Transformer y autosupervisadas, como EVA-02 y DINOv3, son las primeras opciones que conviene evaluar. Para producción en hardware limitado, las CNN, como ConvNeXt V2, EfficientNetV2, MobileNetV4 y Ultralytics YOLO26-cls, son más prácticas. Para clasificar sin datos etiquetados, SigLIP 2 permite la clasificación zero-shot.
Los Transformers suelen ganar cuando se preentrenan con conjuntos de datos muy grandes y la capacidad de cálculo no es limitada. Las CNN suelen ganar con conjuntos de datos pequeños o medianos y en hardware edge, porque sus supuestos incorporados sobre la estructura local hacen que necesiten menos datos y sean rápidas. Las CNN modernas, como ConvNeXt, han reducido la diferencia de precisión, y las arquitecturas híbridas, como CoAtNet, combinan ambos enfoques.
Sí. DINOv3 es una base de propósito general. Extraes características con el modelo congelado y entrenas encima un pequeño clasificador lineal; el repositorio de Meta incluye una capa de clasificación de ImageNet para su modelo más grande. Consulta la licencia de DINOv3 antes de usarlo con fines comerciales.
Principalmente con la precisión top-1 (la predicción principal es correcta) y la precisión top-5 (la clase correcta está entre las cinco predicciones con mayor puntuación), normalmente en el conjunto de validación de ImageNet. En conjuntos de datos personalizados desequilibrados, la precisión, la exhaustividad o la puntuación F1 por clase aportan más información que la precisión global.









