Cómo entrenar YOLO con datos de Amazon S3 y desplegar una API alojada con Ultralytics Platform
Entrena Ultralytics YOLO26 con imágenes de tu bucket de Amazon S3 y despliega el modelo como una API alojada con Ultralytics Platform, paso a paso, en comparación con SageMaker.
 Miles Deans15 min de lectura
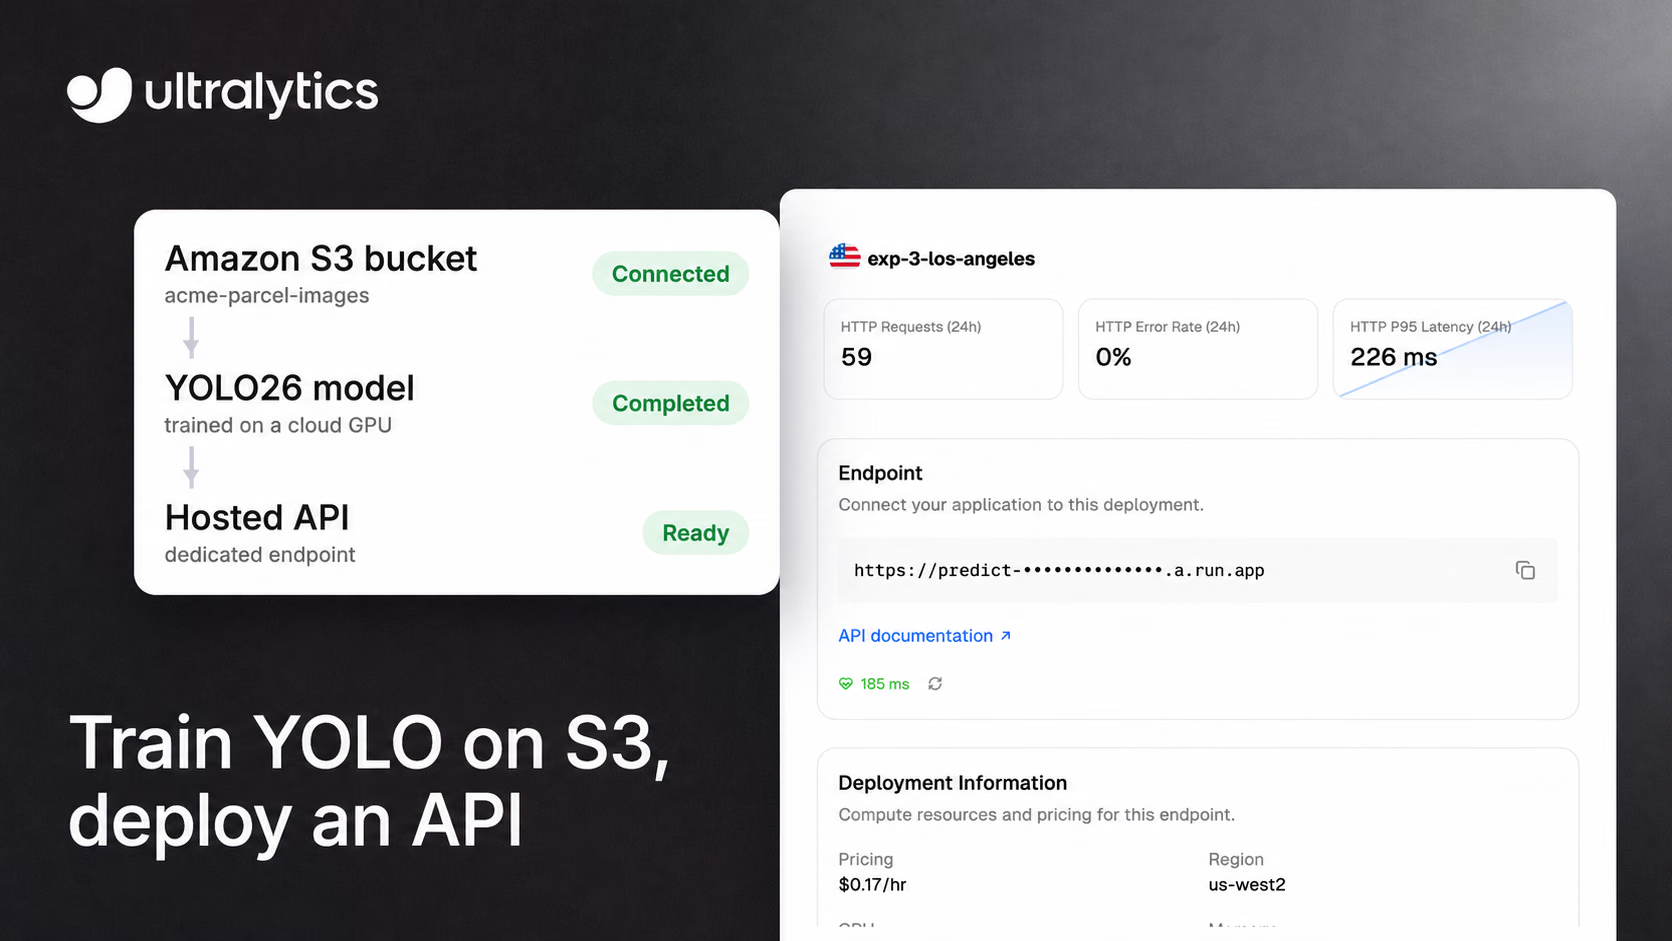
Si tus imágenes ya están en un bucket de Amazon S3, puedes entrenar un modelo Ultralytics YOLO con ellas y desplegarlo como una API alojada sin subir una segunda copia del conjunto de datos. Ultralytics Platform indexa el bucket sin mover los datos, te permite etiquetar y entrenar YOLO26 en una GPU en la nube y despliega el modelo entrenado en un endpoint dedicado al que llamas mediante HTTPS. Esta guía recorre cada paso, desde la política de IAM hasta tu primera predicción, y compara el flujo de trabajo con Amazon SageMaker, Google Vertex AI y Azure Machine Learning.
El mismo flujo funciona con Google Cloud Storage y Azure Blob Storage, usando una clave JSON de cuenta de servicio o una cadena de conexión con la clave de acceso de la cuenta en lugar de la clave de acceso de AWS.
Cómo encaja el flujo de trabajo#
El proceso tiene cinco etapas. Las imágenes originales permanecen en tu bucket y el entrenamiento en la nube trabaja con copias temporales durante cada ejecución:
- Conecta un bucket de S3 con un usuario de IAM de solo lectura.
- Indexa una carpeta como conjunto de datos de Platform. Platform lee las dimensiones de las imágenes y las etiquetas YOLO que encuentra, y no almacena una segunda copia de las imágenes.
- Etiqueta las imágenes en el navegador o conserva las etiquetas YOLO que ya tienes en el bucket.
- Entrena un modelo YOLO26 en una GPU en la nube. El entrenamiento usa copias temporales de las imágenes durante cada ejecución.
- Despliega el modelo en un endpoint dedicado de una de las 42 regiones y envíale imágenes con una clave de API.
Los conjuntos de datos de detección, segmentación, pose y cuadro delimitador orientado (OBB) se reconocen por la estructura de sus etiquetas, así que los mismos pasos se aplican a cada tarea de visión artificial.
Antes de empezar: planes, permisos y límites de los datos#
Necesitas tres cosas:
- Un espacio de trabajo Pro o Enterprise. Los conjuntos de datos de Amazon S3, Google Cloud Storage y Azure Blob Storage requieren un plan Pro o Enterprise. Pro cuesta 29 $ por usuario y mes e incluye 30 $ de crédito por usuario al mes para recursos informáticos de pago por uso, como el entrenamiento en la nube.
- El rol de administrador o propietario del espacio de trabajo, necesario para conectar el almacenamiento en la nube.
- Un usuario de AWS IAM que pueda enumerar y leer el bucket.
Conviene saber qué sale del bucket antes de conectarlo. Platform transmite los originales bajo demanda para explorarlos y anotarlos, y las imágenes indexadas no cuentan para la cuota de almacenamiento de Platform. Cada conexión tiene una opción Funciones de IA, activada de forma predeterminada. Mientras esté activada, las GPU de Ultralytics pueden leer imágenes para anotarlas, buscar imágenes similares y entrenar en la nube. Los proveedores de IA externos también pueden procesar imágenes para modelos de anotación de pago que usan la clave del proveedor de tu espacio de trabajo y para generar imágenes cuando se habilita el acceso de escritura. El entrenamiento en la nube usa copias temporales durante cada ejecución; la búsqueda de imágenes similares conserva las incrustaciones hasta que las imágenes dejan de estar en Platform. Desactívala y no se iniciará ningún trabajo nuevo de IA (los trabajos que ya estén en curso finalizarán), mientras que la anotación manual y el entrenamiento local seguirán funcionando. Platform nunca modifica ni elimina tus objetos.
Paso 1: Crea un usuario de IAM de solo lectura#
En la consola de AWS, ve a IAM > Users, crea un usuario sin acceso a la consola y adjúntale una política que conceda permisos para enumerar y leer el bucket:
{
    "Version": "2012-10-17",
    "Statement": [
        { "Effect": "Allow", "Action": "s3:ListAllMyBuckets", "Resource": "*" },
        {
            "Effect": "Allow",
            "Action": ["s3:ListBucket", "s3:GetObject"],
            "Resource": ["arn:aws:s3:::my-bucket", "arn:aws:s3:::my-bucket/*"]
        }
    ]
}
s3:ListAllMyBuckets es opcional. Permite que Platform descubra tus buckets para que no tengas que escribir sus nombres.
A continuación, abre la pestaña Security credentials del usuario y crea una clave de acceso. Platform necesita una clave de usuario de IAM de larga duración: rechaza las credenciales temporales de AWS STS, incluidas las credenciales de sesión de rol y las claves de IAM Identity Center, porque caducarían mientras el conjunto de datos sigue conectado. Para ello, usa un usuario específico, nunca las credenciales de la cuenta raíz. Platform cifra la clave en reposo con AES-256-GCM y nunca la expone a las cargas de trabajo de entrenamiento; puedes revocar el acceso en cualquier momento desactivando la clave en IAM.
Paso 2: Conecta el bucket a Ultralytics Platform#
- En Platform, ve a Settings > Integrations y selecciona Amazon S3.
- Introduce el ID de la clave de acceso, la clave de acceso secreta y la región del bucket, por ejemplo,
us-east-1. - Haz clic en Find available buckets y selecciona los buckets que quieras conectar, o escribe el nombre de un bucket si la política no permite descubrirlos.
- Haz clic en Connect. Platform comprueba que puede enumerar y leer cada bucket antes de guardar nada.
Una conexión lee buckets de una sola región, así que conecta una vez por región si tus datos están repartidos entre varias. La guía de integración de Amazon S3 explica el permiso de escritura opcional que se usa para generar imágenes.
Paso 3: Crea un conjunto de datos a partir del bucket#
Haz clic en New Dataset, abre la pestaña Cloud, elige el bucket, busca la carpeta que contiene tus datos y crea el conjunto de datos. Platform enumera la carpeta una vez e indexa lo que encuentra:
- Imágenes: objetos
.jpg,.jpeg,.png,.webpy.avif. - Etiquetas: archivos YOLO
.txt, vinculados según la estructura estándarimages/alabels/o como archivos junto a cada imagen. - Clases: un archivo
data.yamlproporciona los nombres de las clases, como en un conjunto de datos YOLO normal. - Divisiones: los nombres de carpeta
train,valytestasignan las divisiones automáticamente.
Una sola importación indexa hasta 500 000 objetos, así que divide los buckets más grandes en varios conjuntos de datos. Trata los objetos indexados como inmutables: cada imagen queda vinculada al ETag de su objeto de S3 y Platform deja de servir una imagen si se sobrescribe. Para añadir datos más adelante, sube objetos nuevos y crea un conjunto de datos nuevo, ya que el índice se genera una sola vez al crear el conjunto de datos.
Paso 4: Etiqueta o revisa las imágenes#
Abre el conjunto de datos para revisar las etiquetas importadas en el editor de anotaciones. Si el bucket aún no tiene etiquetas, puedes dibujar cuadros y máscaras a mano o, con las funciones de IA activadas, usar la anotación inteligente (SAM para detección, segmentación y OBB; YOLO para pose) y la anotación automática para agilizar el trabajo. Las etiquetas se guardan en Platform y los objetos de tu bucket no se modifican.
Paso 5: Entrena YOLO26 en una GPU en la nube#
Haz clic en New Model en el conjunto de datos o en un proyecto, elige un modelo base e inicia una ejecución en la nube:
- Modelo base: elige un modelo oficial de Ultralytics (se recomienda YOLO26) o uno de tus propios modelos para ajustarlo. Solo se muestran los modelos compatibles con la tarea del conjunto de datos.
- Parámetros: configura las épocas, el tamaño de imagen y el tamaño del lote, o conserva los valores predeterminados.
- GPU: elige una GPU de Ultralytics Cloud. El cuadro de diálogo muestra la tarifa por hora y calcula la duración y el coste total de la ejecución antes de que la inicies. Nuestra guía para elegir una GPU en la nube te ayuda a valorar las opciones.
Las métricas, la salida de la consola y los gráficos del sistema se transmiten al navegador mientras la ejecución está activa, y los puntos de control se guardan automáticamente. Al finalizar el entrenamiento, la página del modelo muestra sus métricas y, cuando hay resultados de validación disponibles, un análisis detallado, como una matriz de confusión.
Paso 6: Despliega el modelo como una API alojada#
Abre la pestaña Deploy del modelo. Un mapa y una tabla muestran las 42 regiones, ordenadas según la latencia medida desde tu ubicación. Haz clic en Deploy en la región que quieras, revisa la CPU, la memoria y el precio, y haz clic en Create Deployment.
El tamaño que elijas determina cómo se te cobra:
- Tamaño predeterminado (1 vCPU, 2 GiB): gratis y se reduce a cero cuando está inactivo.
- Tamaños personalizados (hasta 8 vCPU y 32 GiB): mantienen una instancia activa y se cobran según la tarifa por hora de la región que se muestra, desde que están listas hasta que detienes el endpoint, incluido el tiempo de inactividad.
Cada endpoint dedicado es un servicio de un solo inquilino, con su propia URL y supervisión, y está vinculado a una clave de API de tu espacio de trabajo. Los espacios de trabajo gratuitos pueden ejecutar 3 despliegues, Pro permite 10 y Enterprise, un número ilimitado. Si quieres saber cuándo conviene más un endpoint dedicado que la inferencia compartida, consulta nuestra guía sobre inferencia dedicada frente a compartida.
Paso 7: Llama al endpoint#
Instala Requests con python -m pip install requests y guarda una imagen como image.jpg. Sustituye la URL de ejemplo por la URL copiada de tu despliegue seguida de /predict y sustituye YOUR_API_KEY por la clave vinculada a ese despliegue:
import requests

url = "https://YOUR_DEPLOYMENT_URL.run.app/predict"
headers = {"Authorization": "Bearer YOUR_API_KEY"}
data = {"conf": 0.25, "iou": 0.5, "imgsz": 640}

with open("image.jpg", "rb") as f:
    response = requests.post(url, headers=headers, data=data, files={"file": f})

print(response.json())
La misma solicitud con cURL:
curl -X POST "https://YOUR_DEPLOYMENT_URL.run.app/predict" \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -F "file=@image.jpg" \
  -F "conf=0.25" \
  -F "iou=0.5" \
  -F "imgsz=640"
Cada endpoint también ofrece una referencia interactiva de la API en /docs y una comprobación /health. Las solicitudes directas omiten el límite de velocidad de la API de Platform, pero cada endpoint tiene una sola instancia: las solicitudes que no se puedan atender rápidamente recibirán un 429 con una cabecera Retry-After, y el tamaño del cuerpo de las solicitudes está limitado a 32 MB. Cuando el endpoint esté activo, podrás supervisar sus solicitudes, errores y latencia desde la página de despliegue.
Costes, límites y seguridad de un vistazo#
| Elemento | Qué puedes esperar |
|---|---|
| Plan | Pro (29 $ por usuario y mes) o Enterprise para conjuntos de datos de S3, Google Cloud Storage y Azure Blob |
| Almacenamiento | Las imágenes indexadas permanecen en tu bucket y no consumen la cuota de almacenamiento de Platform |
| Entrenamiento | Se cobra según el tiempo de GPU con cargo a los créditos; el cuadro de diálogo calcula el coste antes de que empieces |
| Endpoint | El tamaño predeterminado es gratuito y se reduce a cero; los tamaños personalizados se cobran por hora mientras están en ejecución |
| Tamaño de importación | Hasta 500 000 objetos por importación |
| Credenciales | Clave de usuario de IAM de larga duración, cifrada en reposo y nunca expuesta a las cargas de trabajo de entrenamiento |
| No disponible en conjuntos de datos de S3 | Clonación de conjuntos de datos, instantáneas de versiones, desenfoque de caras y pegado de imágenes de otros conjuntos de datos |
Ultralytics Platform frente a SageMaker, Vertex AI y Azure ML#
Las plataformas de ML en la nube de propósito general también pueden entrenar con datos almacenados en sus propios sistemas y servir el modelo. Las columnas de almacenamiento y servicio que aparecen a continuación se basan en la documentación de cada plataforma; la última columna refleja nuestra valoración.
| Plataforma | Dónde se almacenan los datos de entrenamiento | Opciones de servicio | Uso recomendado (nuestra valoración) |
|---|---|---|---|
| Ultralytics Platform con Ultralytics YOLO | Indexación directa desde S3, Google Cloud Storage o Azure Blob | Endpoints dedicados de una sola instancia en 42 regiones; reducción a cero con el tamaño predeterminado | Equipos que quieren pasar de un bucket a una API de detección, segmentación, pose u OBB con YOLO, sin escribir código de entrenamiento ni de servicio |
| Amazon SageMaker AI | Los trabajos de entrenamiento leen datos de Amazon S3, Amazon EFS o Amazon FSx for Lustre | Endpoints en tiempo real con escalado automático, sin servidor e inferencia asíncrona | Equipos que ya ejecutan procesos de ML en AWS y quieren elegir sus propios contenedores y opciones de servicio |
| Google Vertex AI | Los trabajos de entrenamiento sin servidor montan los buckets accesibles de Cloud Storage en /gcs/ | Endpoints gestionados para inferencia en línea | Equipos que han estandarizado sus datos y herramientas en Google Cloud |
| Azure Machine Learning | Los almacenes de datos hacen referencia a almacenamiento de Azure existente, como Blob Storage | Endpoints en línea gestionados para inferencia en tiempo real | Equipos que han estandarizado sus operaciones en Azure |
La documentación sobre datos de entrenamiento de SageMaker enumera S3, EFS y FSx for Lustre como fuentes con modos de entrada de transmisión y descarga. La inferencia sin servidor gestiona el escalado por ti y es adecuada para un tráfico con periodos de inactividad que puede tolerar arranques en frío; puedes usar un contenedor proporcionado por SageMaker o aportar el tuyo. Vertex AI ejecuta entrenamiento personalizado desde una aplicación Python en un contenedor prediseñado o en uno personalizado, y Azure Machine Learning se conecta al almacenamiento existente de Azure mediante almacenes de datos y sirve modelos desde endpoints en línea gestionados. Esa amplitud es el punto fuerte de una plataforma de propósito general. En nuestra opinión, un flujo de trabajo personalizado con YOLO requiere más configuración; los requisitos de los contenedores dependen de las opciones de entrenamiento y servicio seleccionadas. Si quieres seguir en AWS, nuestra guía de despliegue en SageMaker muestra cómo servir un modelo YOLO allí.
Ultralytics Platform tiene un propósito más específico. Está diseñada en torno a los modelos Ultralytics YOLO, por lo que los pasos anteriores sustituyen el script de entrenamiento y el contenedor de servicio. Es menos adecuada si tu organización exige credenciales STS temporales para cada integración o si un endpoint debe escalar a muchas instancias con una carga concurrente elevada. Si aún estás decidiendo dónde ejecutar la inferencia, nuestra guía sobre la nube frente al alojamiento propio compara costes, latencia y control de los datos.
Preguntas frecuentes
Ultralytics Platform conecta un bucket de S3, indexa las imágenes sin moverlas, entrena YOLO26 en una GPU en la nube y despliega el modelo en un endpoint HTTPS dedicado. Amazon SageMaker AI también entrena con datos de S3 y ofrece inferencia en tiempo real, sin servidor y asíncrona, con contenedores proporcionados por SageMaker o personalizados según la opción de servicio. Google Vertex AI y Azure Machine Learning ofrecen flujos de trabajo similares basados en sus propios sistemas de almacenamiento, Cloud Storage y el almacenamiento de Azure, en lugar de un bucket de S3 existente.
Platform no guarda una segunda copia de tu conjunto de datos: indexa las imágenes y transmite los originales bajo demanda. Con las funciones de IA activadas, el entrenamiento en la nube usa copias temporales fuera de tu bucket durante cada ejecución, y la búsqueda de imágenes similares conserva una incrustación de cada imagen. Platform nunca modifica ni elimina tus objetos.
De momento, no. Platform necesita una clave de acceso de larga duración de un usuario de IAM específico y rechaza las credenciales STS porque caducan mientras el conjunto de datos está conectado. Limita el usuario a permisos de enumeración y lectura, y desactiva la clave en IAM para revocar el acceso.
Los conjuntos de datos de S3 requieren un plan Pro (29 $ por usuario y mes, con 30 $ de crédito mensual por usuario) o Enterprise. El entrenamiento se cobra según el tiempo de GPU y el cuadro de diálogo calcula el coste antes de que empieces. El tamaño de endpoint predeterminado es gratuito y se reduce a cero; los tamaños personalizados se cobran por hora mientras están en ejecución.
Sí. Google Cloud Storage se conecta mediante una clave JSON de cuenta de servicio y el rol Lector de objetos de Storage, mientras que Azure Blob Storage se conecta mediante una cadena de conexión HTTPS con una clave de acceso de la cuenta (no se aceptan cadenas con tokens SAS). Los pasos para el conjunto de datos, el entrenamiento y la implementación son los mismos.
Un conjunto de datos se indexa una sola vez al crearlo, por lo que los objetos nuevos no se detectan automáticamente. Añade objetos nuevos en lugar de sobrescribir los existentes; después, crea un conjunto de datos que los incluya y vuelve a entrenar o a ajustar el modelo.
Sí. Descarga los pesos o exporta el modelo a formatos como ONNX, TensorRT y CoreML desde la página del modelo; después, ejecútalo en tus propios servidores o dispositivos periféricos con el paquete de Python de Ultralytics.
Escrito por
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









