OCR en Python con Ultralytics YOLO26: lee documentos, fotos y PDF desde cualquier ángulo
Lee texto en imágenes y páginas PDF con cualquier orientación usando Ultralytics YOLO26-Text y PP-OCRv6 con unas pocas líneas de Python, en CPU o GPU, con TensorRT opcional.
 Jing Qiu15 min de lectura
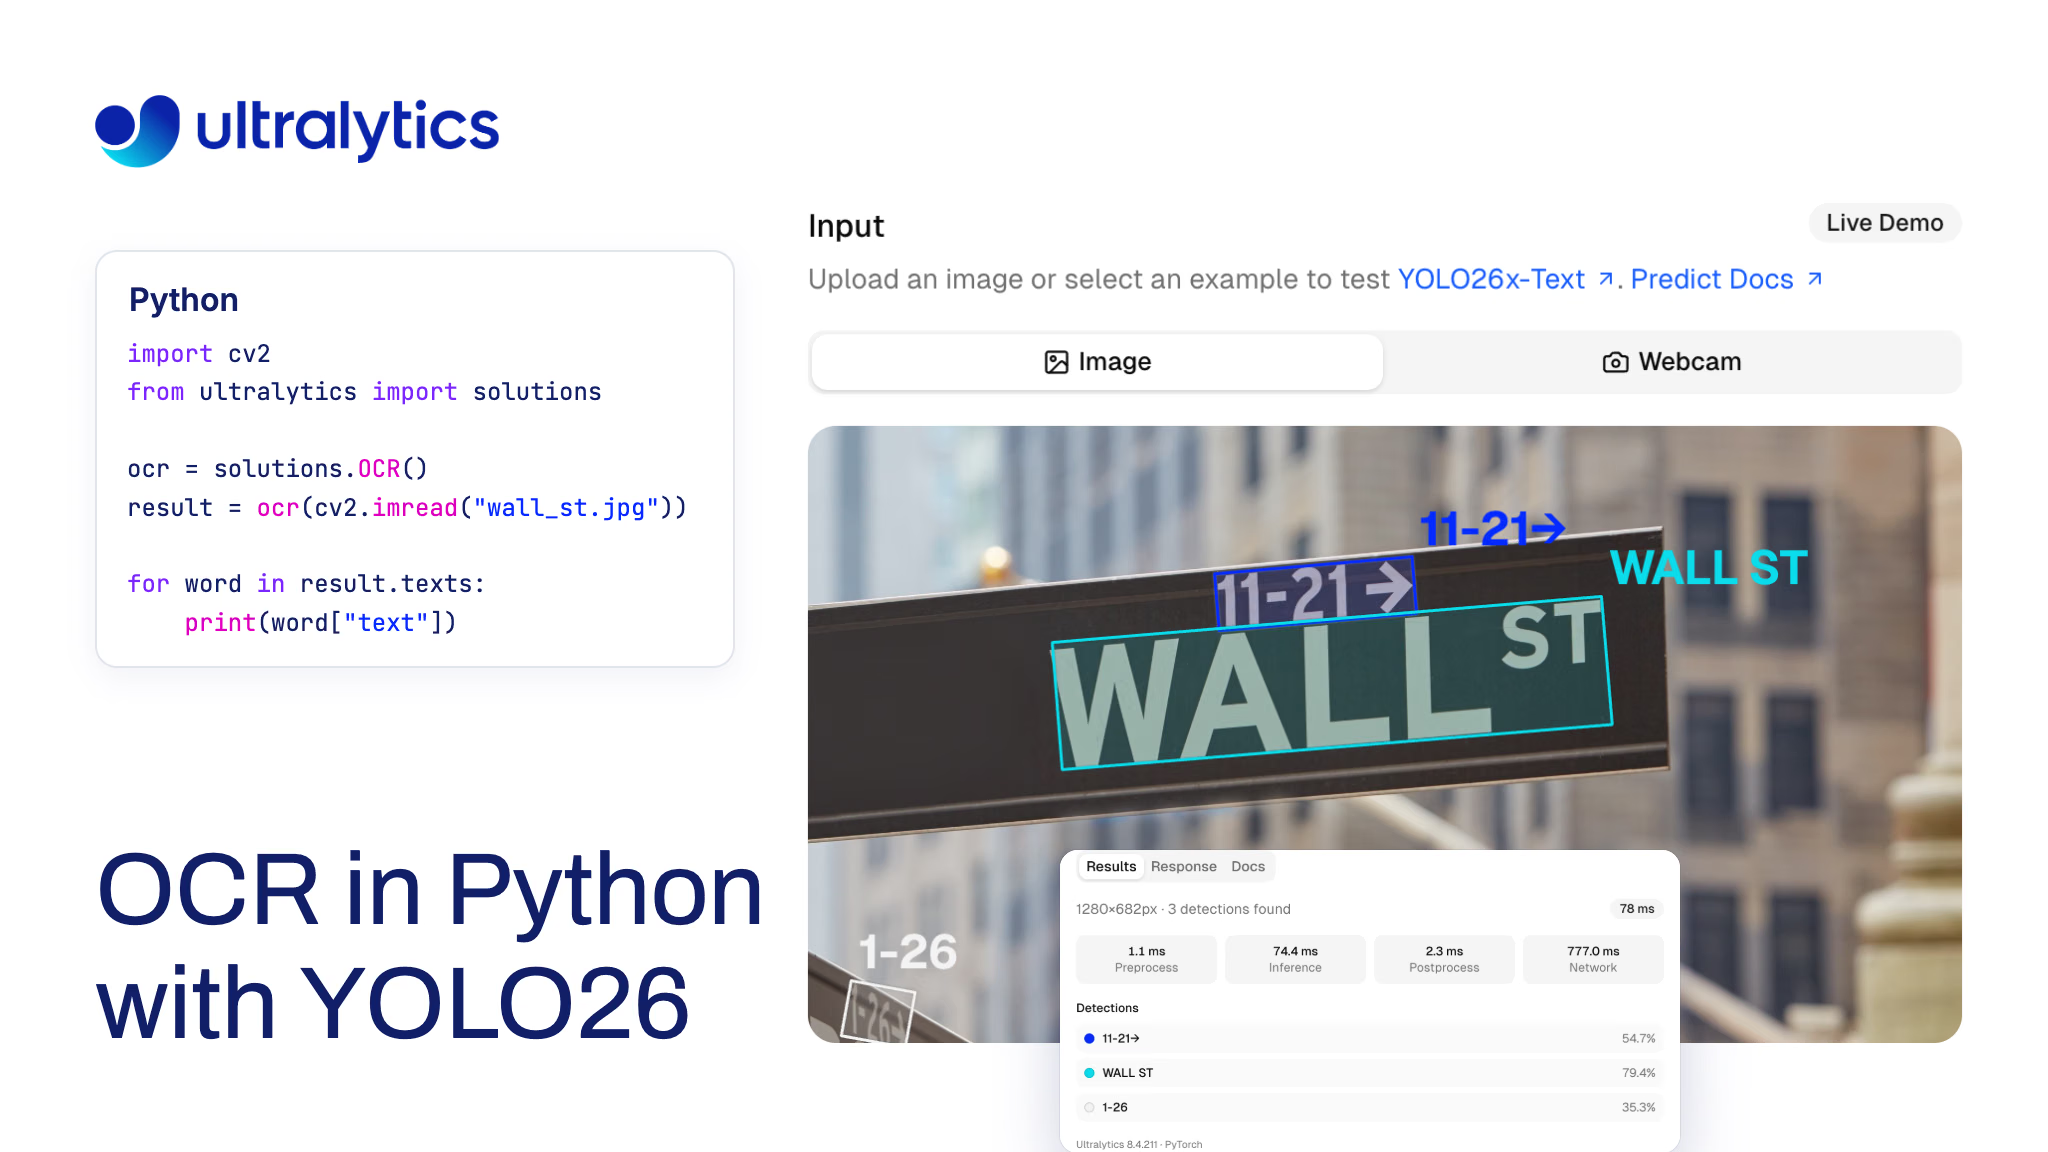
¿Cómo puedes ejecutar OCR en Python en un escaneo girado, una foto de un cartel hecha con el móvil o una página de un PDF y obtener las palabras en el orden en que las leería una persona? Con el paquete Ultralytics, basta con una clase: solutions.OCR() detecta texto con un modelo YOLO26-Text de Ultralytics, lee cada palabra con el reconocedor PP-OCRv6 de PaddleOCR y devuelve las palabras reconocidas línea por línea, con cualquier orientación de página, en CPU o GPU.
Esta canalización es nueva. Ultralytics 8.4.210 reconstruyó la solución de OCR en torno a PP-OCRv6 en ONNX Runtime, con gestión de la rotación y del orden de lectura, y 8.4.211 añadió un reconocedor TensorRT opcional. En nuestra evaluación con un tamaño de imagen de 1280, la configuración predeterminada obtuvo una F1 de palabras de 0,931 en seis páginas PDF y de 0,722 en 80 fotos de HierText. En una RTX PRO 6000, un motor TensorRT FP16 almacenado en caché leyó las 251 palabras detectadas en una foto en 82 ms, frente a los 249 ms de ONNX Runtime en CUDA.
Esta guía explica cómo funciona la canalización, cómo ejecutarla en imágenes y PDF, su velocidad y los idiomas que reconoce actualmente. Ultralytics ofrece una de las opciones de OCR que se comparan a continuación, así que la comparación se limita a las capacidades documentadas de cada proyecto.
YOLO26 OCR lee una página en dos pasos y después ordena las palabras#
El reconocimiento óptico de caracteres (OCR) tiene dos tareas: encontrar el texto y después leerlo. La solución de OCR de Ultralytics las separa claramente:
- Detección: un modelo YOLO26-Text, un detector de cajas delimitadoras orientadas, dibuja cajas giradas alrededor del texto. Está disponible en tamaños n, s, m, l y x, y el modelo x es el predeterminado.
- Reconocimiento: PP-OCRv6 medium lee cada recorte. Se ejecuta en ONNX Runtime desde la versión de recursos de Ultralytics, así que no tienes que instalar PaddlePaddle. Se descartan los recortes que no se leen como texto.
- Ordenación: las palabras se agrupan en líneas y se devuelven de arriba abajo y de izquierda a derecha, cada una etiquetada con su número de línea.
Cada palabra se devuelve como un registro con su texto, la confianza del reconocimiento, la confianza del detector, un número de línea y un polígono en las coordenadas de la imagen original. Como las dos confianzas se mantienen separadas, puedes enviar a revisión humana una palabra detectada con confianza pero leída con poca certeza, en lugar de fiarte de ella.
Las dos etapas son independientes. Puedes sustituir el detector por uno más pequeño, por un modelo de detección o segmentación propio, o por otro reconocedor; la gestión de la rotación y el orden de lectura seguirán funcionando. Puedes probar el mismo flujo de código en el navegador, en nuestra página de procesamiento de documentos, antes de instalar nada.
Las páginas giradas y boca abajo se leen en el orden correcto#
La solución calcula la orientación de la página a partir del texto que detecta, así que no tienes que corregir la inclinación ni girar las páginas de antemano:
- Determina la dirección del texto. Calcula la media del ángulo del lado largo de las cajas detectadas, ponderándola según lo alargada que sea cada caja. Las cajas con una proporción inferior a 2:1, como las de un solo dígito, se excluyen del cálculo.
- Gira la página. Gira la página para que el texto vaya de izquierda a derecha, recorta cada palabra en posición vertical y agrupa las palabras en líneas.
- Resuelve si está a 0° o a 180°. Una caja no permite saber en qué sentido está orientado el texto, así que la solución lee las 8 palabras más anchas en ambos sentidos y conserva la orientación con mayor confianza de lectura. El texto boca abajo se lee como ruido de baja confianza, lo que hace que la respuesta correcta destaque.
Al girar 8 documentos y capturas de pantalla, además de 12 fotos, a 90°, 180° y 270°, la F1 de palabras fue de 0,925 en los documentos y de 0,654 en las fotos. En un formulario IRS 8802 en blanco, la solución leyó 404, 401 y 399 palabras a 0°, 180° y 90°, con las mismas primeras líneas. La versión anterior daba por sentado que todas las páginas estaban en posición vertical.
Los valores predeterminados se basan en una evaluación, no en una suposición#
Definimos los principales valores predeterminados mediante mediciones. La evaluación se ejecutó en una RTX PRO 6000 con la imagen de Platform de producción; las imágenes cargadas se enviaron como JPEG de hasta 1280 píxeles por el lado más largo. Se utilizaron 80 fotos de validación del conjunto de datos HierText de Google, con sus transcripciones de palabras legibles, 6 páginas PDF evaluadas frente a sus capas de texto (4 de un artículo de arXiv y los formularios IRS 1040 y 8802 en blanco), una captura de pantalla sintética y una imagen sintética. La métrica es la puntuación F1 a nivel de palabra, el equilibrio entre la precisión y la exhaustividad, contando las palabras en minúsculas de al menos 2 caracteres alfanuméricos.
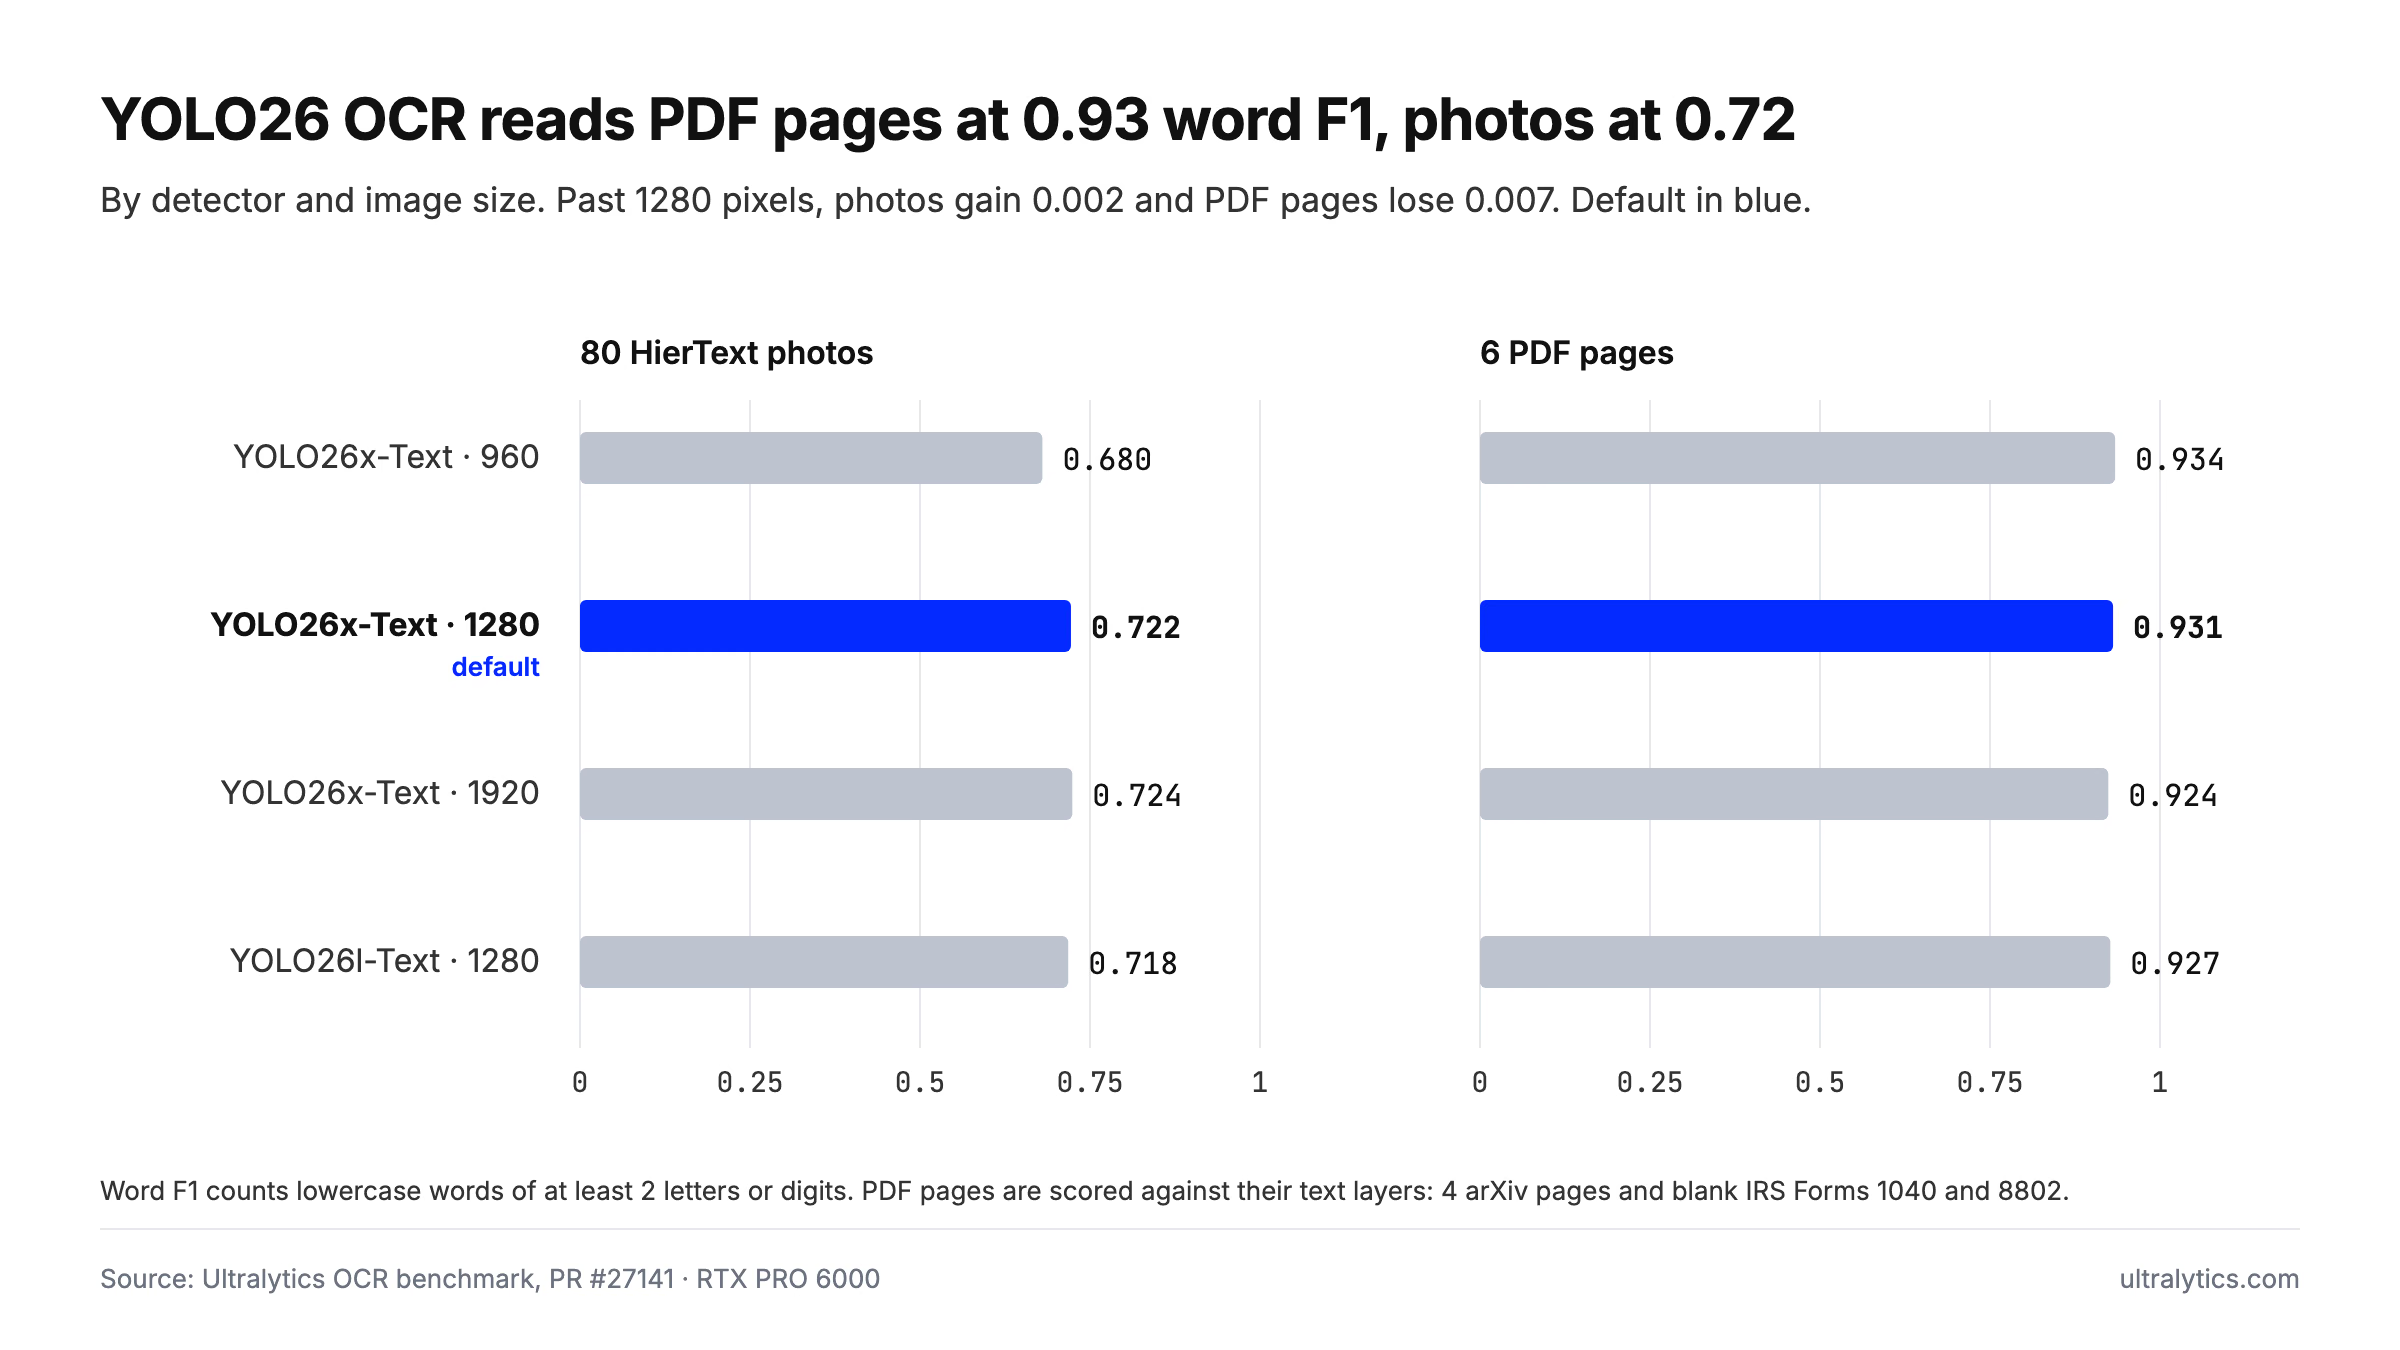
F1 de palabras de YOLO26-Text con PP-OCRv6 en 80 fotos de HierText y 6 páginas PDF, por detector y tamaño de imagen, en una RTX PRO 6000.
Las páginas PDF limpias se leen mucho mejor que las fotos de texto en escenas en todos los ajustes, y las cifras justifican tres valores predeterminados:
yolo26x-textaimgsz=1280. Bajar a 960 restó 0.042 de F1 en las fotos, mientras que subir a 1920 añadió 0.002 en las fotos y restó 0.007 en las páginas PDF. Las imágenes más pequeñas no se amplían a 1280; se procesan a su propio tamaño, redondeado hacia arriba al múltiplo del paso de 32 píxeles del modelo.- Leer palabra por palabra. Leer palabras sueltas superó en 4 puntos de F1 a la lectura de líneas completas en las fotos.
max_det=1000. Una página de documento densa contiene más de las 300 detecciones habituales.
Si necesitas un detector más ligero, YOLO26l-Text se quedó a menos de medio punto del modelo x en ambos conjuntos.
Cómo ejecutar OCR en Python con YOLO26#
Instala o actualiza con pip install -U "ultralytics>=8.4.211". La primera llamada de OCR descarga YOLO26x-Text y PP-OCRv6 e instala ONNX Runtime; usa onnxruntime-gpu si CUDA está disponible. El reconocedor ONNX Runtime predeterminado requiere Python 3.11+ y ONNX Runtime 1.26+.
Leer una imagen#
import cv2

from ultralytics import solutions

ocr = solutions.OCR()  # YOLO26x-Text con imgsz=1280 y PP-OCRv6
im0 = cv2.imread("receipt.jpg")
assert im0 is not None, "Image not found"
result = ocr(im0)
cv2.imwrite("receipt_ocr.jpg", result.plot_im)  # imagen anotada

for word in result.texts:
    print(word["line"], word["text"], round(word["confidence"], 2))
Desde la línea de comandos, yolo solutions ocr source="path/to/video.mp4" hace lo mismo con cada fotograma. Cada fotograma se lee de forma independiente, sin seguimiento.
Leer un PDF#
La solución acepta imágenes, así que primero debes renderizar cada página del PDF. PyMuPDF es una opción para hacerlo:
import cv2
import numpy as np
import pymupdf  # pip install pymupdf

from ultralytics import solutions

ocr = solutions.OCR()
for page in pymupdf.open("document.pdf"):
    pix = page.get_pixmap(dpi=200)
    rgb = np.frombuffer(pix.samples, np.uint8).reshape(pix.height, pix.width, pix.n)
    result = ocr(cv2.cvtColor(rgb, cv2.COLOR_RGB2BGR))

    lines = {}
    for word in result.texts:  # ya está en el orden de lectura
        lines.setdefault(word["line"], []).append(word["text"])
    print("\n".join(" ".join(words) for words in lines.values()))
Como result.texts ya está ordenado, reconstruir el texto sin formato solo requiere un diccionario y una operación de unión. Los polígonos permiten ir más allá; por ejemplo, puedes comprobar que una cantidad aparezca junto a la palabra "Total".
Elige el modelo, el dispositivo y el reconocedor#
- Detector más pequeño:
solutions.OCR(model="yolo26s-text.pt")carga un detector más pequeño y rápido; comprueba su precisión con tus propias páginas. Los cinco tamaños se descargan automáticamente. - CPU o GPU: el reconocedor se ejecuta en CUDA cuando se selecciona una GPU CUDA y está disponible el proveedor de ejecución CUDA de ONNX Runtime; de lo contrario, se ejecuta en CPU. Así, el mismo script funciona en un portátil o en un servidor.
- Tu propio reconocedor: pasa una función como
recognizer. Recibe cada recorte de palabra BGR y devuelve(text, confidence); la solución sigue encargándose de la detección, la rotación y la ordenación.
def recognize(crop):
    # Ejecuta cualquier modelo de reconocimiento sobre el recorte de palabra BGR
    return "example", 0.95


ocr = solutions.OCR(recognizer=recognize)
TensorRT lee palabras entre 2,5 y 3 veces más rápido en fotos densas#
En nuestras pruebas con GPU en páginas densas, el reconocimiento, y no la detección, era lo que más tiempo llevaba. Una optimización anterior midió unos 11 ms para la detección en una solicitud de 250 ms, y la solicitud de incorporación de TensorRT atribuyó buena parte del tiempo restante de reconocimiento a 33 lotes pequeños dominados por la sobrecarga de ejecución, no por el cálculo. Ultralytics 8.4.211 añade un argumento para esto:
ocr = solutions.OCR(recognizer="tensorrt") # Motor TensorRT FP16 en GPU NVIDIALa primera ejecución crea un motor TensorRT FP16 en unos 30 segundos y lo guarda en caché junto al modelo PP-OCRv6, una vez por versión de TensorRT y arquitectura de GPU. Las cargas posteriores tardan entre 0,05 y 0,2 segundos. Según la versión, es aproximadamente 2,5 veces más rápido que ONNX Runtime en páginas densas.
Medimos read_words, la etapa posterior a la detección que recorta, gira, reconoce y ordena las palabras, en cuatro fotos de texto en escenas. En las tres fotos con entre 195 y 263 palabras, el motor FP16 fue entre 2,5 y 3 veces más rápido que ONNX Runtime en CUDA; en una foto de 48 palabras fue 1,4 veces más rápido:
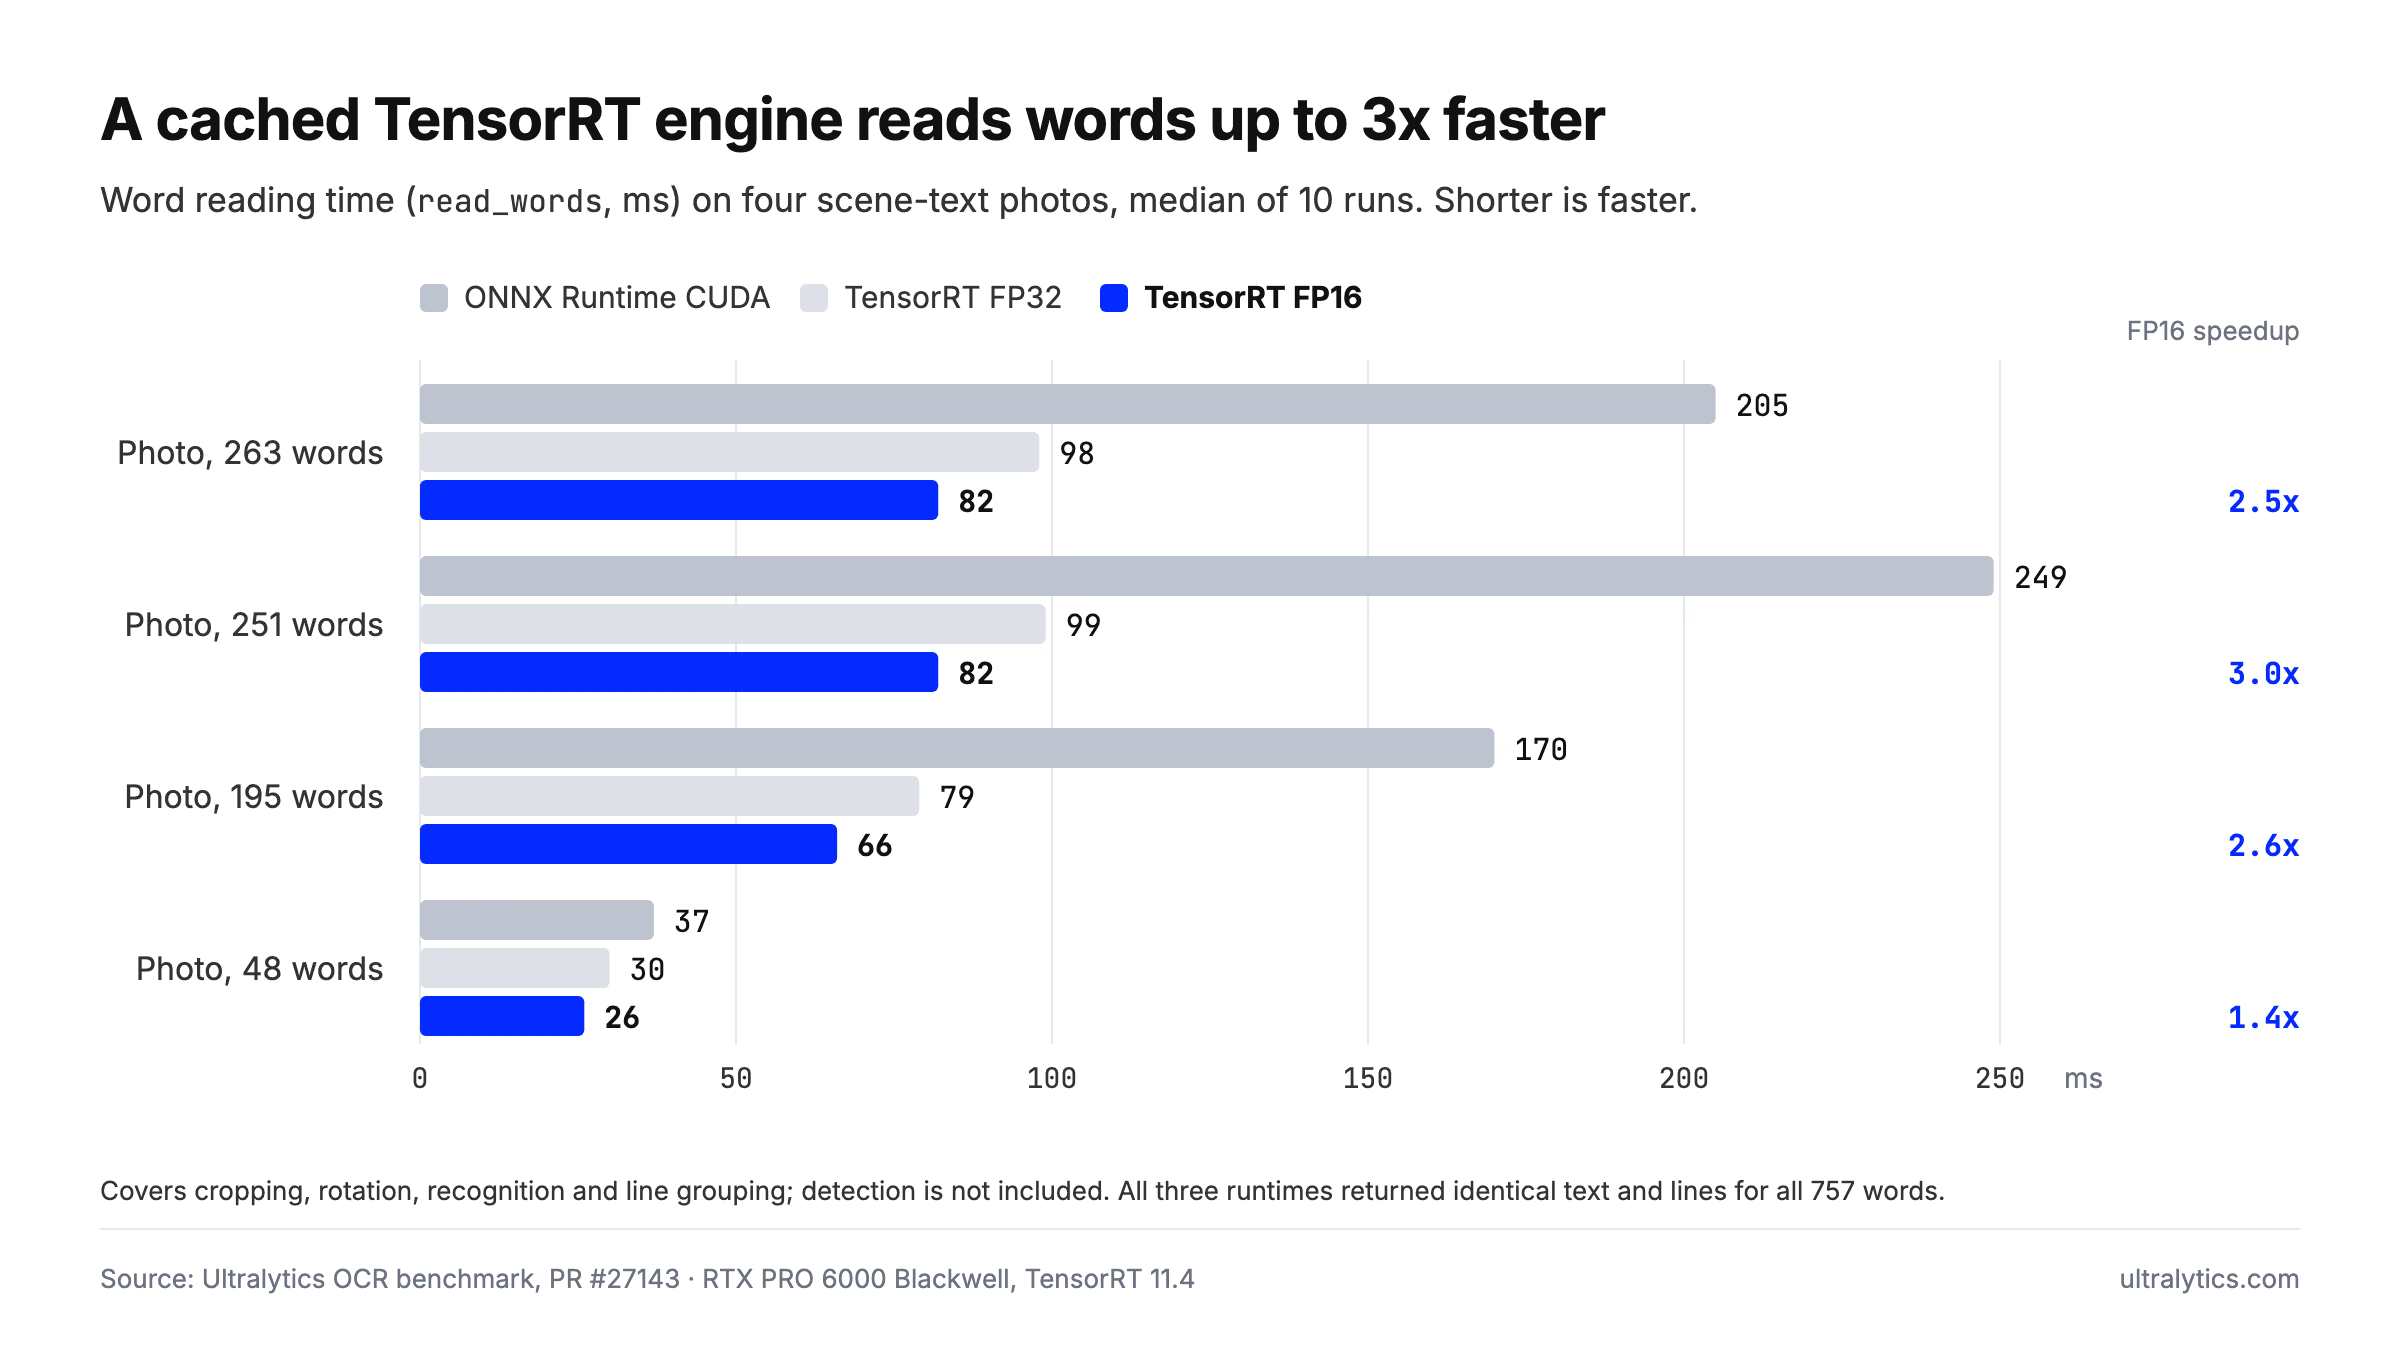
Tiempo de lectura de palabras en cuatro fotos de texto en escenas con ONNX Runtime CUDA y motores TensorRT FP32 y FP16, mediana de 10 ejecuciones en una RTX PRO 6000 Blackwell con TensorRT 11.4.
Una llamada completa de OCR en una página densa pasó de 182 ms a 94 ms. En estas cuatro fotos, la aceleración no cambió el resultado: para las 757 palabras, ONNX Runtime y ambos motores devolvieron el mismo texto y la misma agrupación de líneas.
Mantén el valor predeterminado recognizer="paddleocr" si no puedes esperar a la primera compilación o no usas hardware NVIDIA. No compila nada y se inicia en aproximadamente un segundo. Nuestra comparación entre ONNX y TensorRT explica la misma disyuntiva para los modelos de detección, y la guía de integración de TensorRT explica cómo configurarlo.
Actualmente se admiten la escritura china, japonesa y latina#
PP-OCRv6 solo puede generar caracteres de su conjunto integrado de 18.708 caracteres. El detector YOLO26-Text no depende de ese conjunto y sigue encontrando palabras en otras escrituras, pero las palabras que no están incluidas se devuelven como caracteres parecidos. Por ejemplo, el texto ruso ТЕКСТ se lee como «TEKCT», a menudo con una confianza alta.
- Admitidos: chino simplificado y tradicional (unos 15.600 caracteres CJK), japonés (hiragana, katakana y kanji) e idiomas con escritura latina, como inglés, francés, alemán, español, portugués, italiano, neerlandés, sueco, finés, danés, noruego, polaco, checo, húngaro, rumano, turco, croata, indonesio y malayo. Se admiten todas las letras, incluidas las acentuadas, excepto la ẞ mayúscula alemana y la ¡ española.
- Parcialmente admitidos: vietnamita, al que le faltan la mayoría de las vocales con tonos, y griego, del que solo se admiten las letras básicas.
- Aún no admitidos: cirílico, coreano (hangul), árabe, hebreo, devanagari y tailandés.
Para una escritura no admitida, conserva el detector YOLO26-Text y pasa un reconocedor entrenado para esa escritura como recognizer. La tabla completa de cobertura está en la sección de idiomas admitidos de la guía de OCR.
Comparativa de bibliotecas de OCR para Python según sus capacidades documentadas#
No hay un único modelo de OCR que sea el mejor; la elección depende de tus páginas, tus idiomas y dónde se ejecute el código. La tabla compara las capacidades documentadas, no los resultados medidos, según las páginas públicas de cada proyecto consultadas el 12 de noviembre de 2026. Las opciones aparecen en orden alfabético.
| Opción | Entorno de ejecución | Texto girado | Idiomas documentados | Resultado |
|---|---|---|---|---|
| EasyOCR | PyTorch | rotation_info prueba 90°, 180° y 270° en cada cuadro de texto | Más de 80, incluidos cirílico, árabe, devanagari, coreano y tailandés | Cuadros, texto y confianza |
| PaddleOCR | PaddlePaddle | Clasificación de orientación opcional | Más de 100 (PP-OCRv6 admite 50 con un solo modelo) | Cuadros, texto y confianza |
| Tesseract (pytesseract) | Binario nativo, CPU | Detección de orientación y escritura (image_to_osd); gira la imagen antes de leerla | 100+ | Texto, con datos de palabras opcionales |
| OCR de Ultralytics YOLO26 | Detector PyTorch; reconocedor en ONNX Runtime o TensorRT en GPU NVIDIA | Orientación de la página estimada a partir del texto detectado; la solución determina automáticamente si está a 0° o a 180° | Escrituras china, japonesa y latina; otras, mediante un reconocedor personalizado | Palabras en orden de lectura con números de línea, polígonos y valores de confianza de detección y reconocimiento por separado |
Consulta la documentación de EasyOCR, el repositorio de PaddleOCR, la documentación de Tesseract y pytesseract para conocer las opciones actuales. Para saber cómo funcionan estos motores, consulta nuestra visión general de los modelos de OCR de código abierto más populares.
Dónde encaja Ultralytics#
El OCR de Ultralytics YOLO26 está pensado para desarrolladores de Python que necesitan extraer texto de entradas variadas, como formularios escaneados, páginas PDF, capturas de pantalla y fotos de etiquetas y carteles, con las palabras en orden de lectura y coordenadas que puedan comprobar. Es una buena opción cuando las páginas llegan con ángulos impredecibles, quieres ejecutar el OCR en tus propios equipos o ya utilizas modelos de Ultralytics YOLO26 y quieres OCR en el mismo paquete. Añade recognizer="tensorrt" si procesas grandes volúmenes en GPU NVIDIA.
El detector es un modelo normal de Ultralytics, así que se entrena, valida y exporta como cualquier otro. El proyecto YOLO26-Text en Ultralytics Platform incluye los cinco tamaños, de n a x, para que puedas comparar sus curvas de entrenamiento y clonar el proyecto para empezar a partir de ellos.
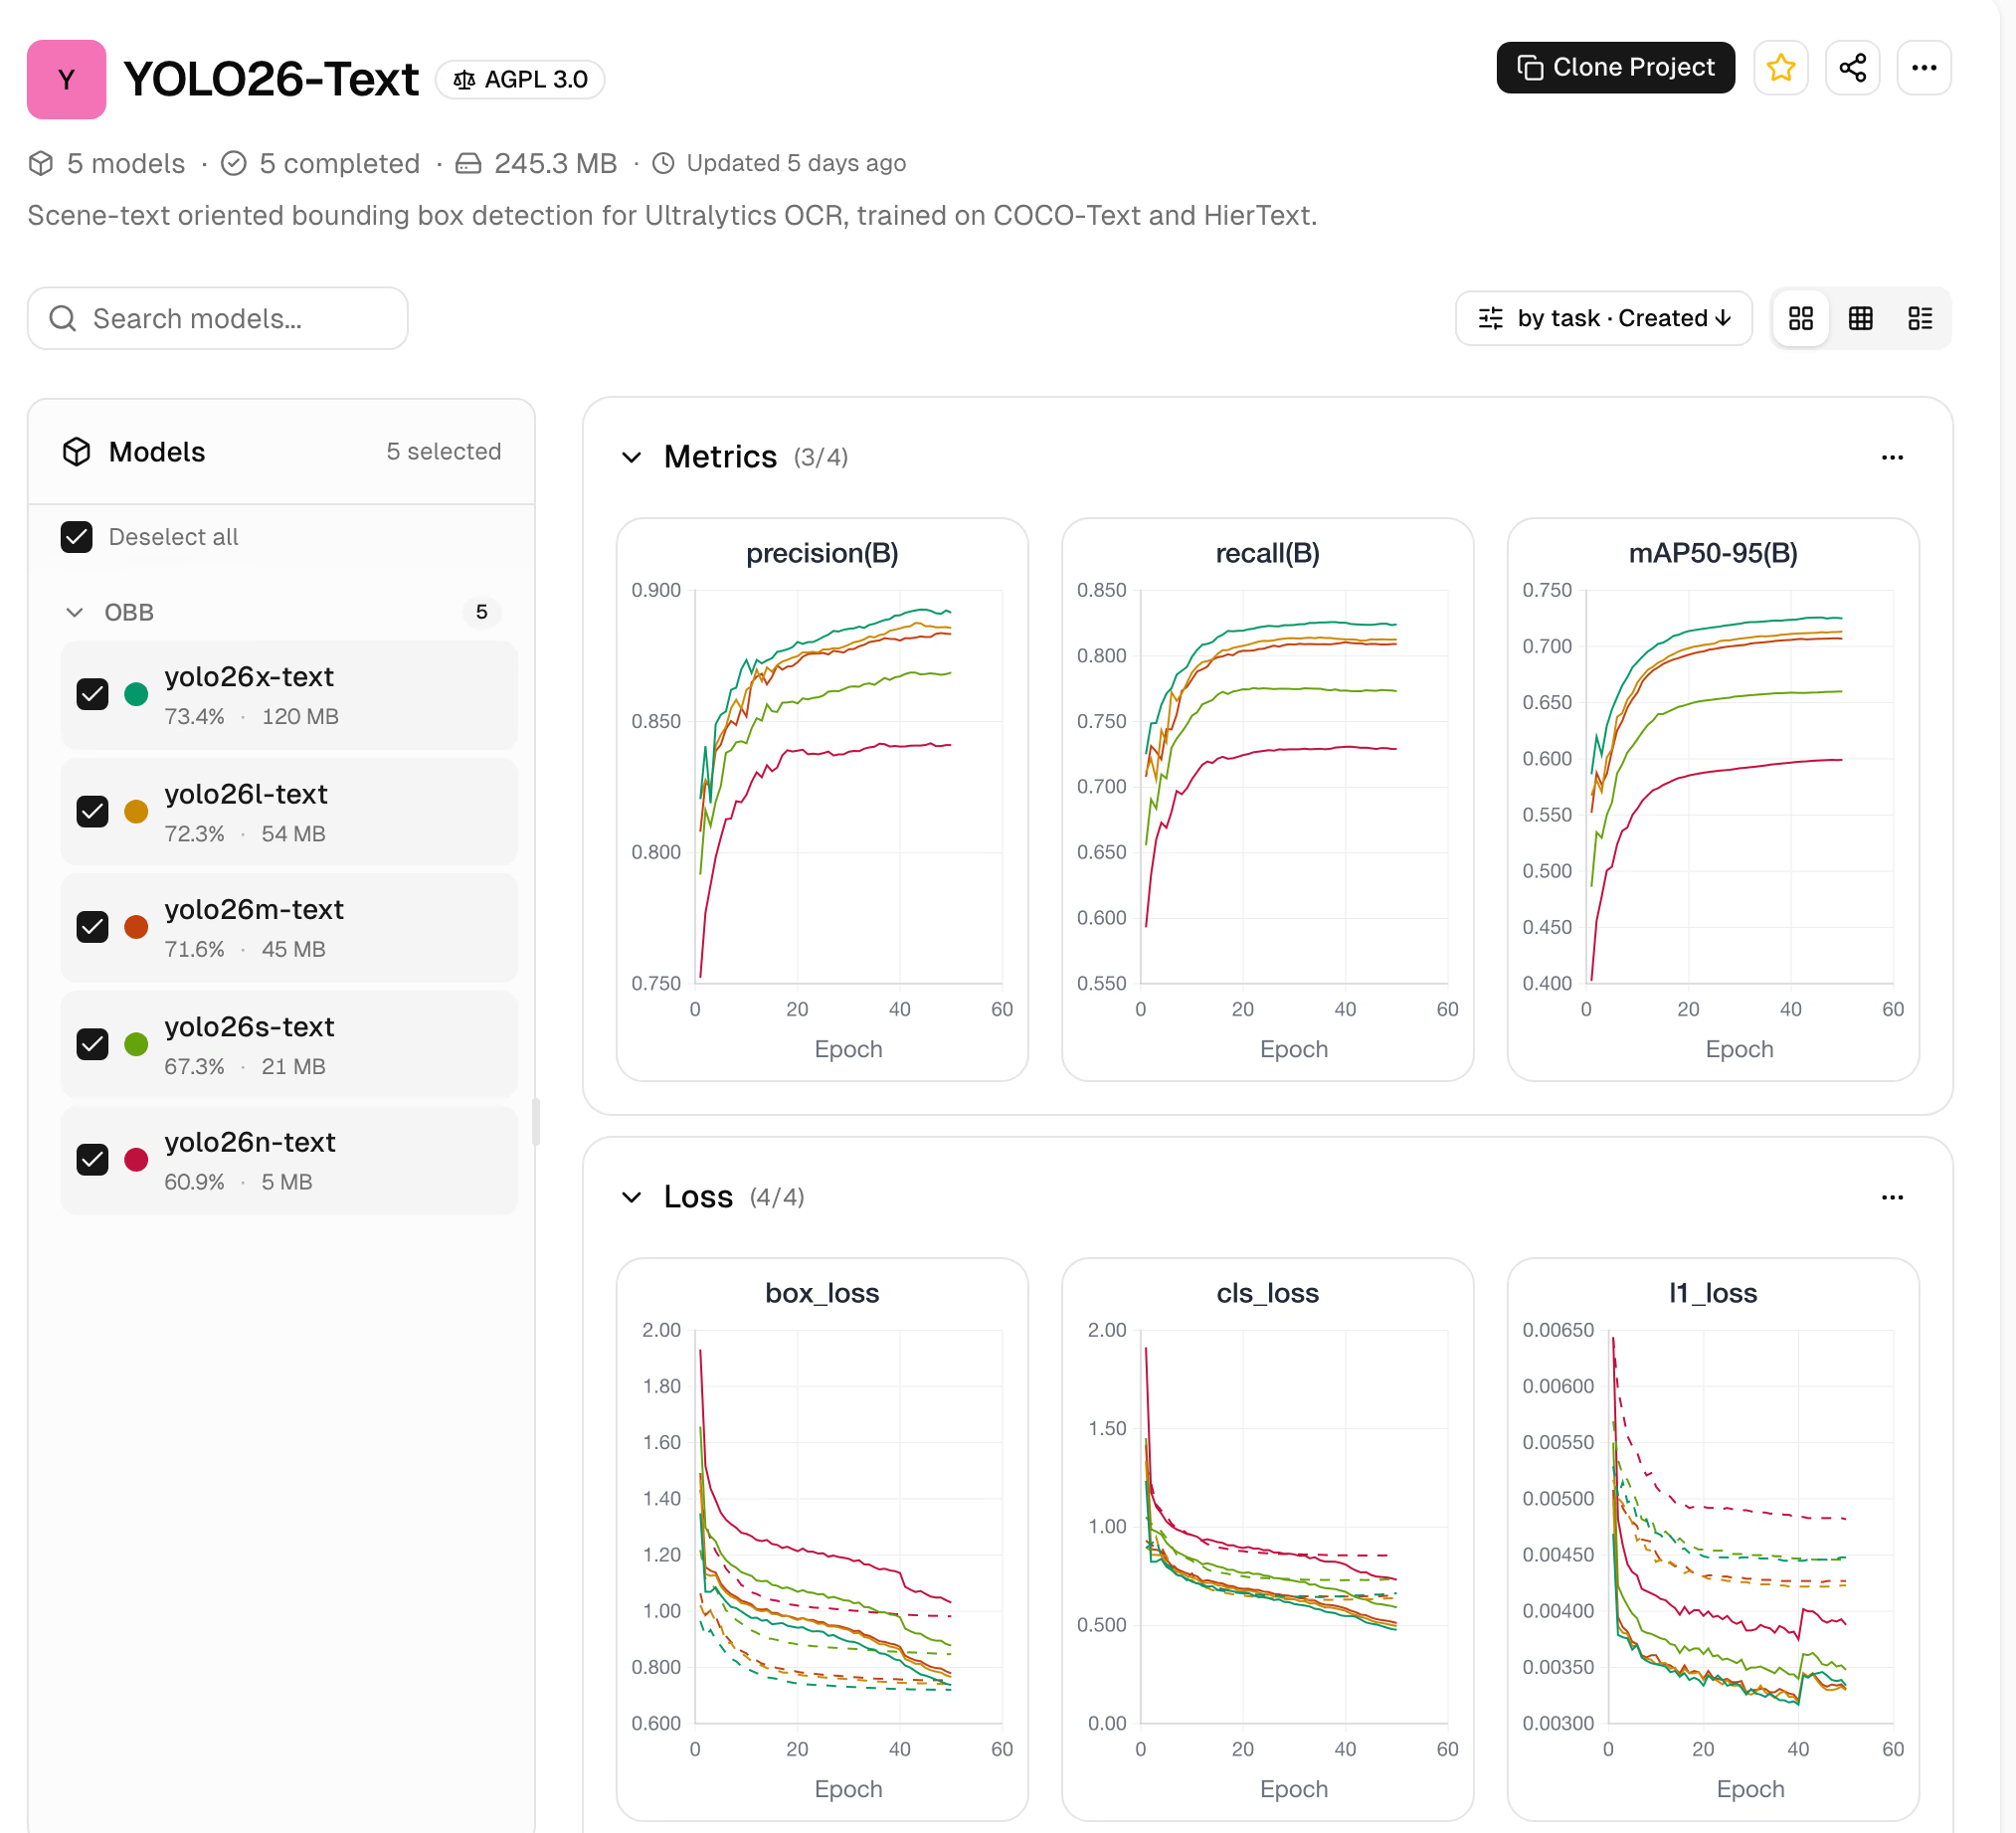
El proyecto YOLO26-Text en Ultralytics Platform: los cinco tamaños del detector con sus curvas de precisión, exhaustividad, mAP50-95 y pérdida durante el entrenamiento.
Para adaptarlo a tus documentos, empieza con el conjunto de datos Scene Text OBB, que combina COCO-Text y HierText en 65.325 imágenes con aproximadamente 1,29 millones de polígonos de palabras.
Sus limitaciones son concretas:
- Escrituras. El reconocedor predeterminado aún no lee cirílico, coreano, árabe, hebreo, devanagari ni tailandés. Combina el detector con tu propio reconocedor o elige un motor que admita esas escrituras.
- Direcciones mixtas. La solución gira toda la página según la dirección predominante del texto, así que el texto que va en varias direcciones en una misma página, como una nota vertical en el margen, puede leerse peor.
- Exportación. El reconocedor no está integrado en el archivo exportado del detector, así que implementa el detector y el entorno de ejecución del reconocimiento en paralelo, o mantén la solución Python como elemento de conexión.
- Rust. Ultralytics Inference lee texto en escenas con Rust y el mismo reconocedor PP-OCRv6 mediante
ultralytics-inference predict --ocr, pero gestiona la orientación con un clasificador en lugar de usar el paso de rotación de página de la solución Python. - Privacidad. La solución Python se ejecuta en tu propio hardware, así que las páginas no tienen que salir de tus equipos; la demo del navegador carga las páginas para hacer la inferencia. En el caso de los campos que no se deben leer, cubre las zonas conocidas con una máscara opaca antes de ejecutar el OCR.
En formularios y contratos, un modelo YOLO personalizado puede localizar primero campos, tablas, firmas y sellos, para que solo tengas que leer las zonas necesarias. El conjunto de datos Signature en Ultralytics Platform y nuestra guía de análisis inteligente de documentos son buenos puntos de partida, y Ultralytics Platform te permite etiquetar páginas y entrenar ese modelo en un mismo lugar. Para probar primero el OCR en una página tuya, suelta una imagen o un PDF en la demo de OCR en directo.
Preguntas frecuentes
Instala el paquete Ultralytics con
pip install -U "ultralytics>=8.4.211"y, después, llama asolutions.OCR()con una imagen cargada mediante OpenCV. Devuelve las palabras reconocidas con su texto, confianza, número de línea y polígono, en orden de lectura. La primera ejecución descarga automáticamente el detector YOLO26-Text y el reconocedor PP-OCRv6.Depende de tus documentos, tus idiomas y tu hardware; nuestra visión general de los modelos de OCR de código abierto más populares compara las principales opciones. En nuestra evaluación con un tamaño de imagen de 1280 en una RTX PRO 6000, YOLO26x-Text con PP-OCRv6 obtuvo una F1 de palabras de 0,931 en seis páginas PDF y de 0,722 en 80 fotos de HierText, y lee páginas con cualquier orientación. Para las escrituras que aún no admite, como el cirílico o el coreano, utiliza un reconocedor entrenado para esa escritura.
Un modelo YOLO detecta texto, pero no lo lee. Ultralytics YOLO26-Text detecta el texto en forma de cuadros orientados y la solución de OCR pasa cada recorte al reconocedor PP-OCRv6, por lo que juntos realizan un OCR completo en una sola llamada.
Sí. Renderiza cada página del PDF como una imagen, por ejemplo, con
get_pixmapde PyMuPDF; conviértela a BGR y pásala asolutions.OCR(). En el navegador, la demo y la pestaña Platform Predict aceptan un PDF y leen su primera página.Sí. PP-OCRv6 funciona en ONNX Runtime en CPU o GPU con CUDA, y el mismo script funciona en ambos casos. El reconocedor opcional de TensorRT necesita una GPU NVIDIA.
Todavía no con el reconocedor predeterminado. PP-OCRv6 admite chino, japonés e idiomas que usan el alfabeto latino, pero no cirílico, hangul, árabe, hebreo, devanagari ni tailandés. Puedes mantener el detector YOLO26-Text y pasarle un reconocedor entrenado para ese sistema de escritura.
Escrito por
Ingeniero sénior de aprendizaje automático · Ultralytics
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









