O Kimi K3.1 Pro já está disponível para anotação automática na Ultralytics Platform
O Kimi K3.1 Pro da Moonshot AI já está disponível na Ultralytics Platform. Ele obteve 0.444 mAP50 no nosso VLM Leaderboard, um terço acima do Kimi K3, e ocupa o 7.º lugar entre 29 modelos.
A Moonshot AI lançou o Kimi K3.1 Pro em 23 de outubro de 2026, e ele já está disponível para anotação automática na Ultralytics Platform. Testamos o modelo da mesma forma que todos os outros modelos do nosso VLM Leaderboard: com 360 imagens de 36 conjuntos de dados de detecção do mundo real.
O Kimi K3.1 Pro obteve 0.444 mAP50, um terço a mais que o Kimi K3 (0.334), e ocupa o 7.º lugar entre 29 modelos, dez posições acima de seu antecessor. Todos os modelos à sua frente são modelos fechados da Google, Anthropic ou OpenAI.
Novidades no Kimi K3.1 Pro#
O Kimi K3.1 Pro é o primeiro modelo da série K3.1 da Moonshot, que o considera seu modelo de pesos abertos da classe 3T mais capaz até hoje. É uma versão do Kimi K3 submetida a pós-treinamento, com muito mais poder computacional dedicado a esse processo, janela de contexto de 1 milhão de tokens e entrada de imagens e vídeos. O modelo sempre raciocina antes de responder, e a Moonshot planeja lançar os pesos completos até 4 de novembro de 2026. O anúncio da Moonshot aborda os resultados em programação, finanças e alucinações.
A Moonshot também reduziu o preço. O Kimi K3.1 Pro custa US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, abaixo dos US$ 3 e US$ 15 cobrados pelo Kimi K3.
Kimi K3.1 Pro para anotação automática na Ultralytics Platform#
O Kimi K3.1 Pro se junta aos modelos de linguagem visual com prompts de classe no editor de anotação da Ultralytics Platform. Em um conjunto de dados de detecção de objetos com 1–200 classes, o modelo analisa cada imagem e retorna caixas delimitadoras das instâncias das classes do conjunto de dados que encontra. Depois, você revisa e salva essas caixas como qualquer outra previsão.
Podes usá-lo de duas maneiras:
- Uma imagem por vez: no editor de anotação, mude para o modo Smart, selecione Kimi K3.1 Pro em Kimi no seletor de modelos e clique em Predict (ou pressione
P). - Um conjunto de dados inteiro: executa Batch Annotation em More actions > Batch Annotation na página do conjunto de dados para rotular todas as imagens ainda não rotuladas em uma única execução.
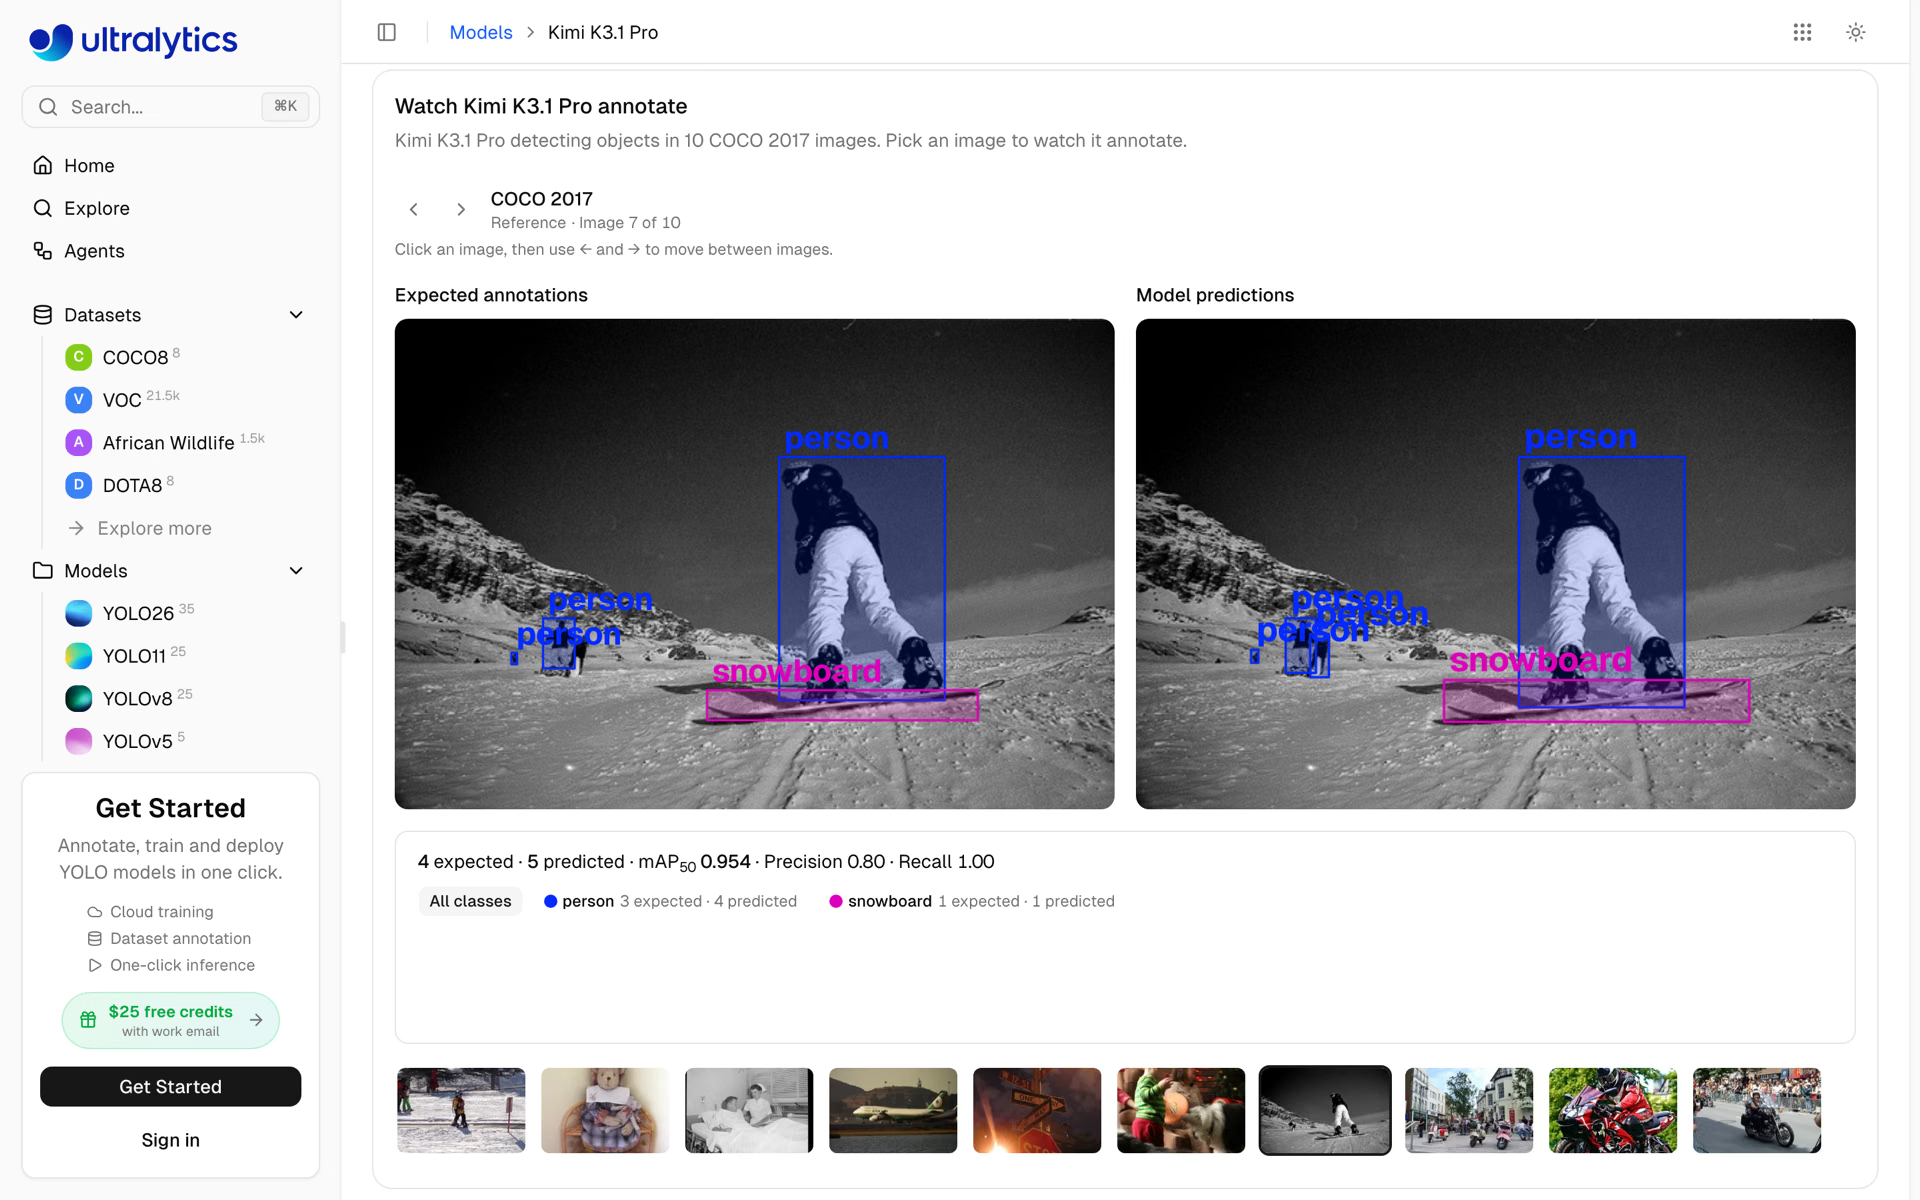
Para ver o modelo em ação antes de adicionar uma chave, abra a página do modelo Kimi K3.1 Pro na Ultralytics Platform. Ela reproduz as previsões registradas do Kimi K3.1 Pro em 10 imagens do COCO, ao lado das caixas esperadas, e mostra a pontuação do modelo em cada conjunto de dados de benchmark.
Como fizemos o benchmark do Kimi K3.1 Pro#
Um modelo que encontra quase todos os objetos em fotos do dia a dia ainda pode deixar passar a maioria deles em um exame médico ou em uma placa de circuito. Por isso, todos os modelos do VLM Leaderboard são avaliados com o mesmo teste fixo, UL37 v2: 10 imagens rotuladas escolhidas aleatoriamente de cada um dos 36 conjuntos de dados de detecção do UL37, um conjunto de conjuntos de dados de benchmark do mundo real que a Ultralytics usa para avaliação. Eles abrangem imagens médicas, imagens aéreas e de satélite, inspeção de PCB, raios X de segurança, prateleiras de lojas, trânsito, esportes, cenas subaquáticas, imagens térmicas e muito mais.
Cada imagem passa pelo pipeline de anotação de produção da Ultralytics Platform com os nomes das classes do conjunto de dados, exatamente como acontece nos modos Smart e Batch Annotation, incluindo a etapa SAM 3.1 que ajusta as caixas de cada modelo. Avaliamos as caixas com as próprias métricas de detecção do pacote Ultralytics e calculamos a média dos 36 conjuntos de dados com pesos iguais. A metodologia do VLM Leaderboard traz os detalhes.
Uma configuração é diferente no caso do Kimi. Por padrão, o Kimi K3.1 Pro usa o nível máximo de raciocínio da Moonshot. No nível máximo, o Kimi K3 ultrapassou o limite de 115 segundos da Ultralytics Platform em cerca de 40% das imagens nos nossos testes. Por isso, a Ultralytics Platform executa todos os modelos Kimi com alto nível de raciocínio. Tanto o Kimi K3 quanto o Kimi K3.1 Pro foram avaliados dessa forma.
Kimi K3.1 Pro vs. Gemini 4 Argon, Claude Opus 5.5 e GPT-6 Astra#
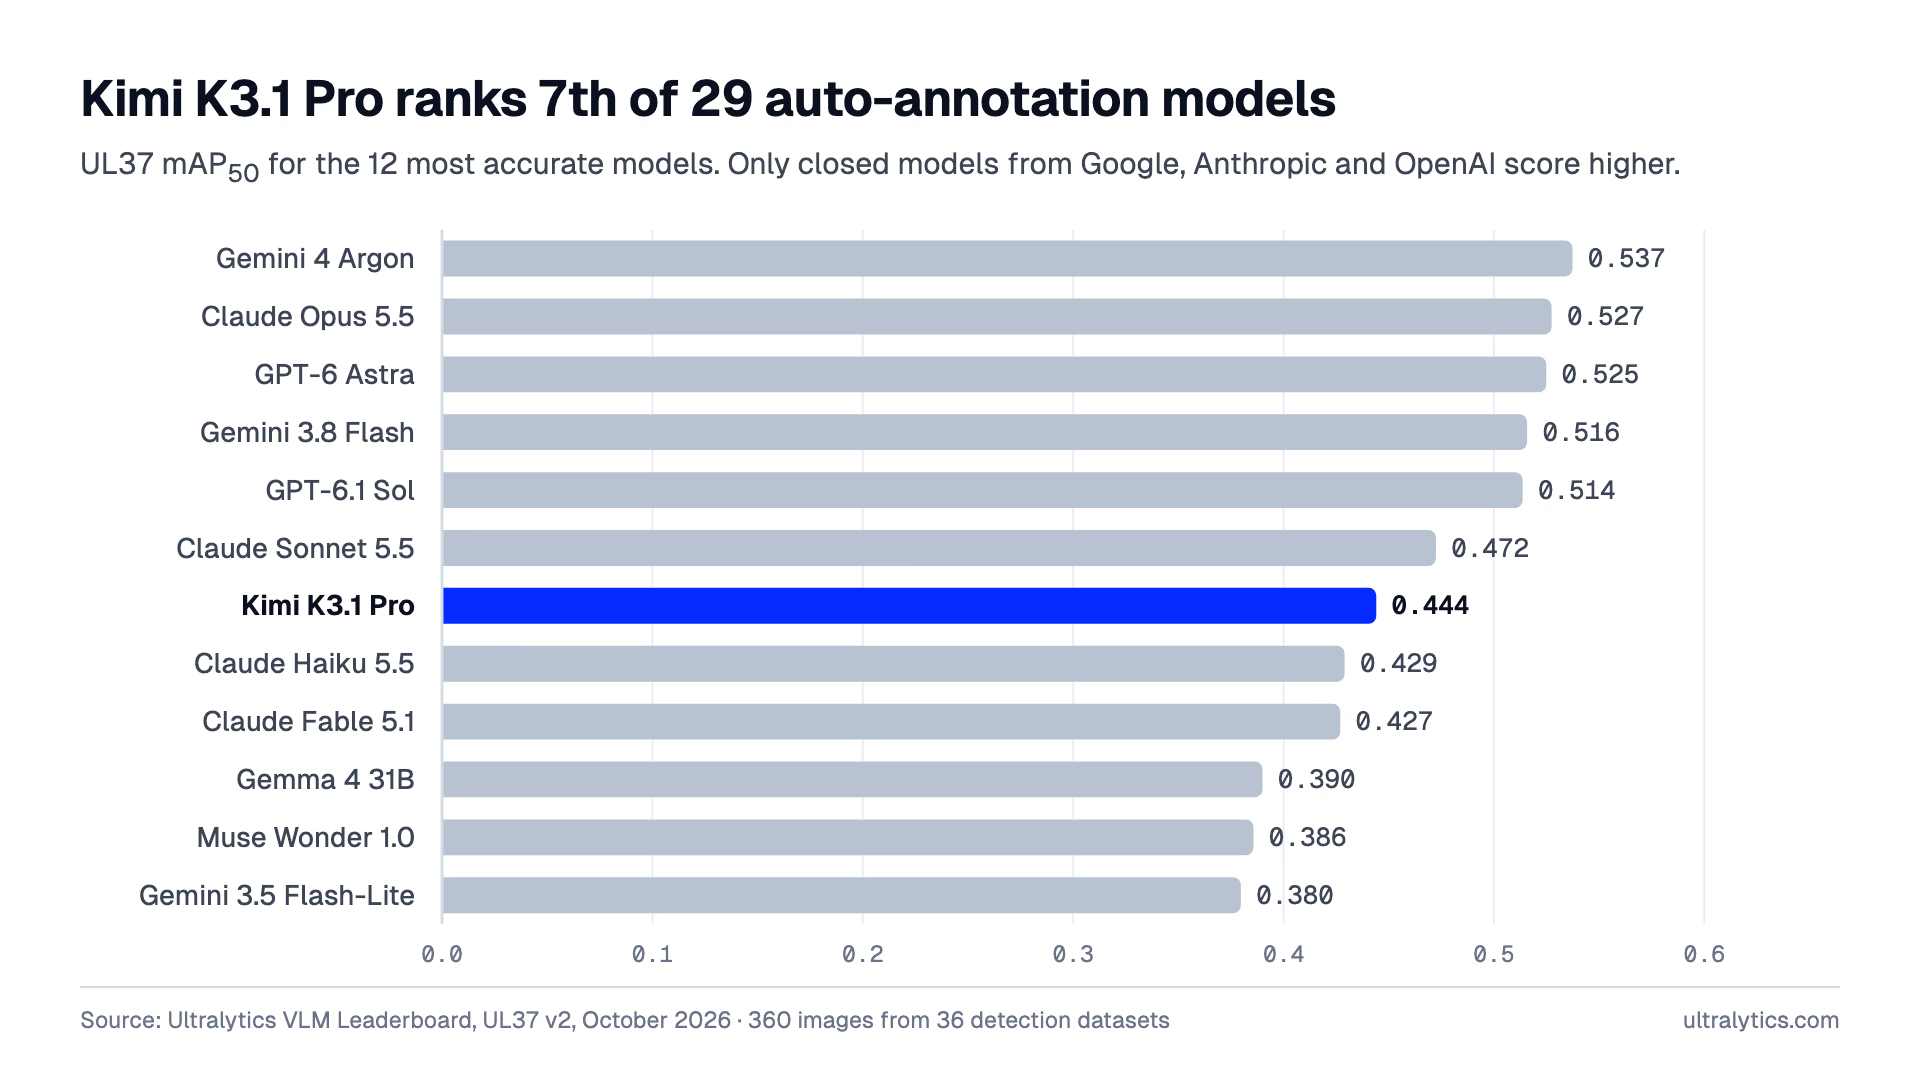
O Kimi K3.1 Pro obteve 0.444 mAP50. Gemini 4 Argon (0.537), Claude Opus 5.5 (0.527), GPT-6 Astra (0.525), Gemini 3.8 Flash (0.516), GPT-6.1 Sol (0.514) e Claude Sonnet 5.5 (0.472) tiveram pontuações mais altas. O Kimi ficou à frente de Claude Haiku 5.5 (0.429), Claude Fable 5.1 (0.427) e de todos os modelos de pesos abertos que executamos nas nossas próprias GPUs, liderados pelo Gemma 4 31B (0.390), que ainda não está disponível na Ultralytics Platform.
As duas partes da pontuação melhoraram. A precisão subiu de 0.439, no Kimi K3, para 0.560, e a revocação subiu de 0.376 para 0.483. Assim, uma proporção maior das caixas estava correta, e o modelo encontrou mais objetos rotulados.
Kimi K3.1 Pro vs. Kimi K3: onde a atualização faz diferença#
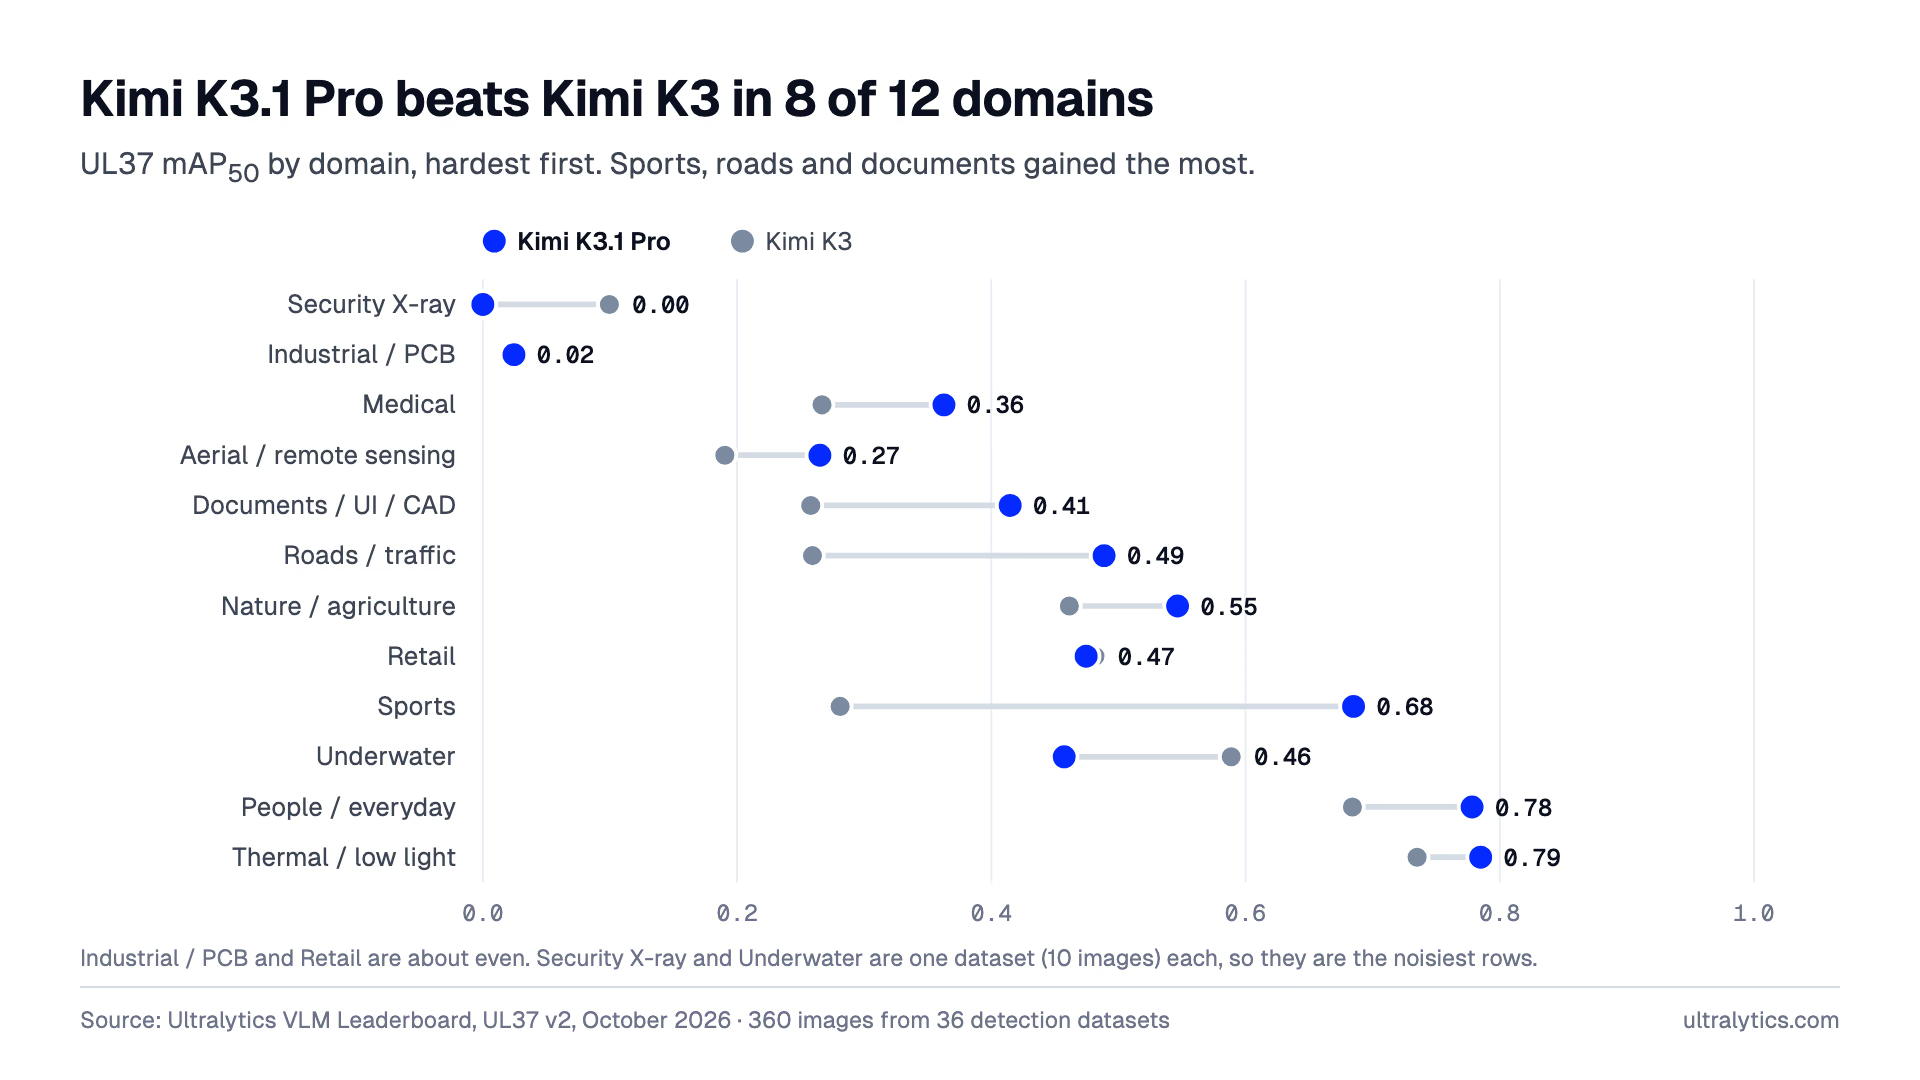
O Kimi K3.1 Pro superou o Kimi K3 em 25 dos 36 conjuntos de dados e em 8 dos 12 domínios. Os maiores ganhos ocorreram em esportes (0.68 vs. 0.28), estradas e trânsito (0.49 vs. 0.26) e documentos, interfaces de usuário e CAD (0.41 vs. 0.26). No conjunto de dados de bolas de tênis, a pontuação passou de 0.08 para 0.74 mAP50, empatando com Gemini 3.8 Flash na maior pontuação desse conjunto. Já nas marcações rodoviárias do CeyMo, passou de 0.17 para 0.80.
Em esportes, o Kimi K3.1 Pro também superou o Gemini 4 Argon (0.68 vs. 0.60) e teve pontuação maior que o Argon em seis conjuntos de dados no total, incluindo os de bolas de tênis, futebol, espigas de trigo e ultrassom da tireoide.
Nem todos os domínios melhoraram. As pontuações caíram em imagens subaquáticas e raios X de segurança (um conjunto de dados cada), recuaram um pouco no varejo (0.47 vs. 0.48) e permaneceram próximas de zero para defeitos industriais em PCB nos dois modelos Kimi. Imagens especializadas continuam sendo um desafio para todos os modelos. Por isso, trate as caixas do Kimi K3.1 Pro como um primeiro rascunho para revisão humana no ciclo e confira algumas previsões nas suas próprias imagens antes de anotar um conjunto de dados inteiro.
Precisão, custo e velocidade#
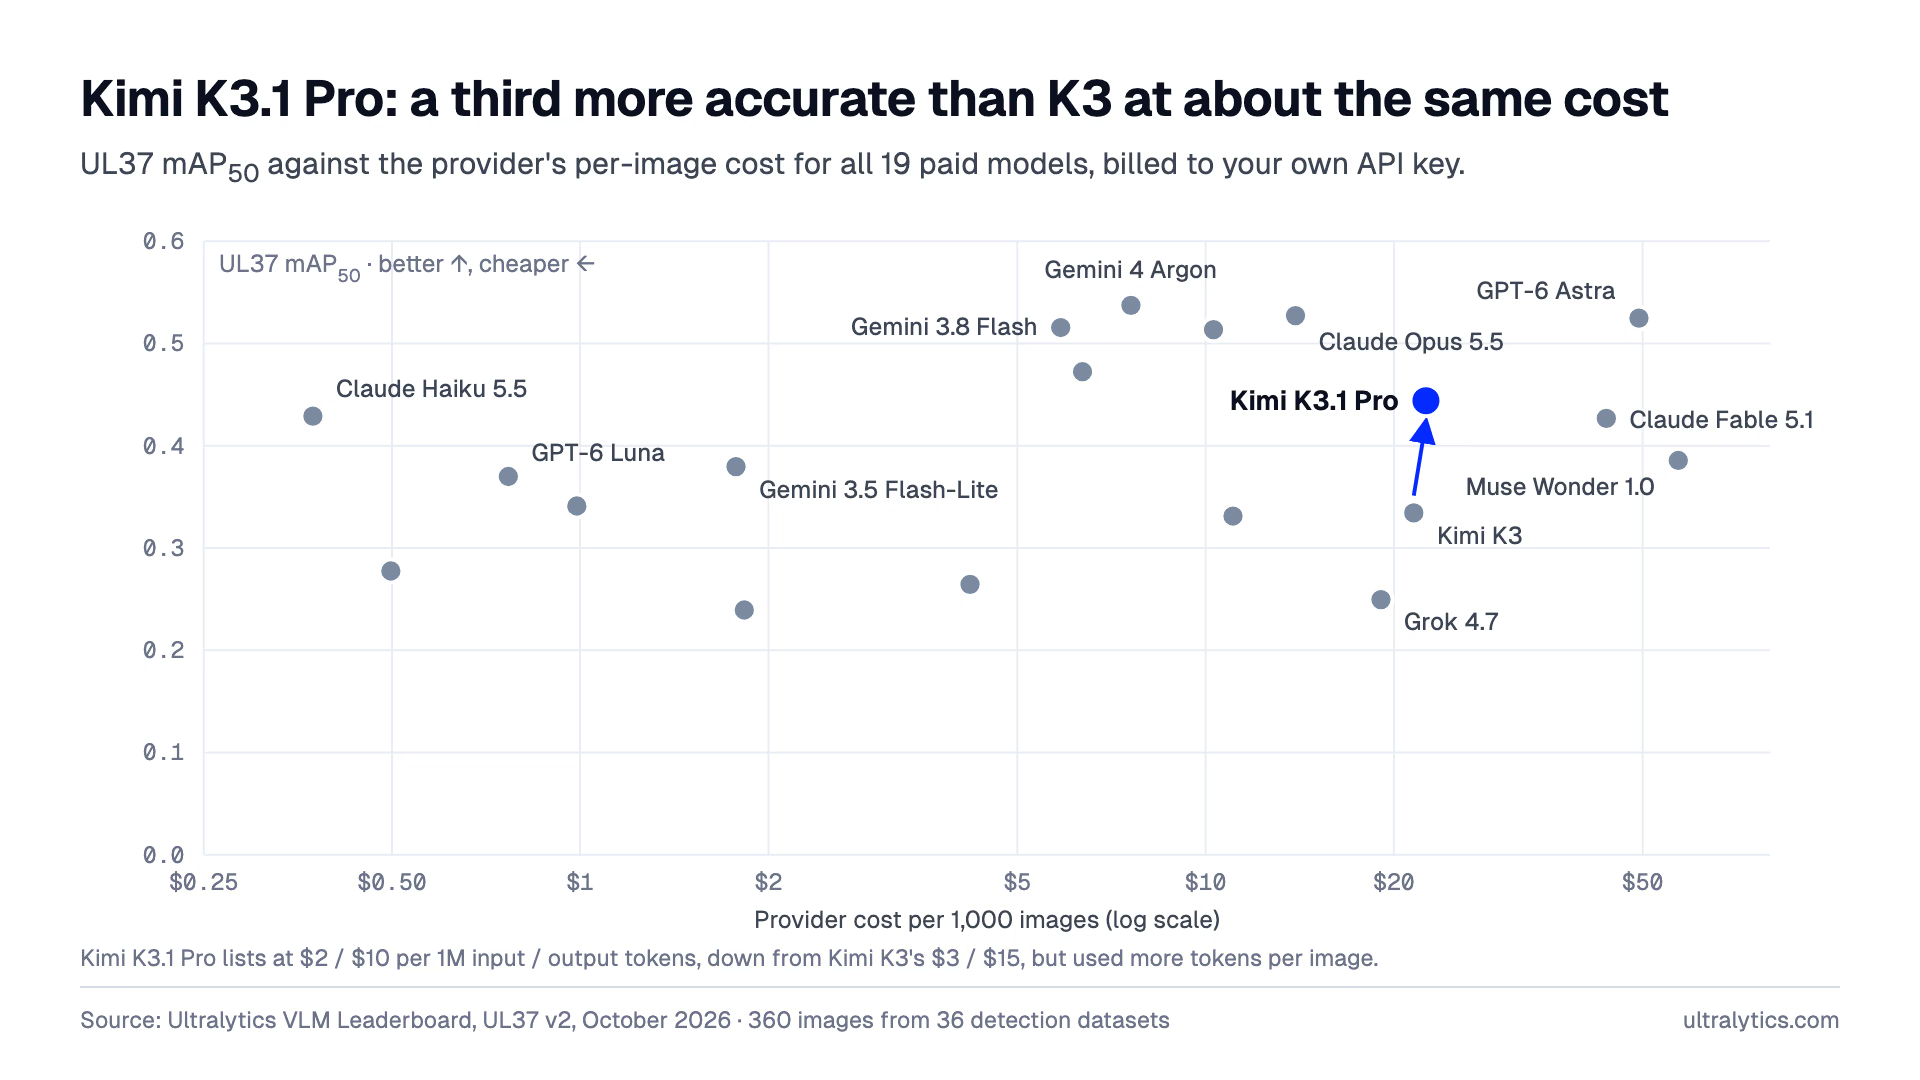
Os modelos pagos usam a chave de API do seu próprio provedor, que cobra diretamente por cada previsão. No nosso benchmark, o Kimi K3.1 Pro custou cerca de US$ 22.50 por 1.000 imagens, próximo dos US$ 21.50 do Kimi K3. O preço por token é um terço menor, mas o modelo usou mais tokens por imagem. Assim, a atualização oferece cerca de um terço a mais de precisão por um custo semelhante.
Não é a opção mais barata para alcançar essa precisão. Cinco dos seis modelos acima dele no ranking custam menos, incluindo Gemini 4 Argon (cerca de US$ 7.60 por 1.000 imagens) e Claude Opus 5.5 (cerca de US$ 13.90). Claude Haiku 5.5 ficou a cerca de 0.015 mAP50 do Kimi K3.1 Pro, custando aproximadamente US$ 0.37 por 1.000 imagens.
O Kimi K3.1 Pro também é lento. A solicitação mediana levou cerca de 22 segundos por imagem, contra 4.6 segundos para Gemini 4 Argon e 2.7 segundos para Claude Opus 5.5. Além disso, 6.4% das solicitações não foram concluídas dentro do limite de 115 segundos da Ultralytics Platform, acima dos 1.7% do Kimi K3. Uma imagem que excede o tempo limite volta sem caixas, e você pode fazer uma nova previsão. A Moonshot também oferece o Kimi K3.1 Pro Highspeed, que, segundo a empresa, é duas a três vezes mais rápido e mantém os mesmos recursos. A Ultralytics Platform oferece o Kimi K3.1 Pro padrão.
Comece a usar o Kimi K3.1 Pro na Ultralytics Platform#
- Crie uma chave de API na Kimi API Platform e adicione-a em Settings > API Keys no espaço de trabalho que contém o seu conjunto de dados, ou peça ao proprietário do espaço de trabalho para adicionar uma (veja como).
- Abra um conjunto de dados de detecção na Ultralytics Platform, mude o editor de anotação para o modo Smart e selecione Kimi K3.1 Pro em Kimi.
- Clica em Predict para rotular a imagem atual e, em seguida, revisa, ajusta e salva as caixas.
- Quando os resultados estiverem corretos, executa Batch Annotation para rotular o restante do conjunto de dados.
O Batch Annotation acrescenta a taxa padrão de processamento da Ultralytics Platform, de US$ 1.00 por 1.000 imagens, separada do valor cobrado pela Moonshot na sua chave de API. Cada execução salva primeiro uma versão do conjunto de dados, para que você possa sempre reverter as alterações.
Quando o conjunto de dados estiver rotulado, treine um modelo Ultralytics YOLO26 nele, no mesmo espaço de trabalho (consulte a documentação de treinamento). Para comparar o Kimi K3.1 Pro com o líder, leia nossa publicação sobre a anotação automática com Gemini 4 Argon ou confira todos os modelos no VLM Leaderboard e nas páginas de modelos da Ultralytics Platform. Depois, inicie sessão na Ultralytics Platform para testar o Kimi K3.1 Pro nos seus próprios dados.
Perguntas frequentes
O Kimi K3.1 Pro é o carro-chefe da série Kimi K3.1 da Moonshot AI, lançada em 23 de outubro de 2026. É uma versão do Kimi K3 submetida a pós-treinamento, com janela de contexto de 1 milhão de tokens e entrada de imagens e vídeos. A Moonshot planeja lançar os pesos até 4 de novembro de 2026. Na Ultralytics Platform, ele está disponível como um modelo de anotação automática com prompts de classe que desenha caixas delimitadoras para as classes do seu conjunto de dados.
Sim. No nosso VLM Leaderboard, o Kimi K3.1 Pro obteve 0.444 mAP50, contra 0.334 do Kimi K3, e superou o Kimi K3 em 25 dos 36 conjuntos de dados. O custo por imagem foi semelhante (US$ 22.50 vs. US$ 21.50 por 1.000 imagens). A solicitação mediana foi um pouco mais rápida, mas o modelo excedeu o tempo limite com mais frequência (6.4% vs. 1.7% das solicitações).
No nosso benchmark, Gemini 4 Argon (0.537 mAP50) e Claude Opus 5.5 (0.527) foram mais precisos, mais rápidos e mais baratos por imagem. O Kimi K3.1 Pro (0.444) ocupa o 7.º lugar entre 29 modelos, atrás apenas de modelos fechados da Google, Anthropic e OpenAI. Além disso, superou o Gemini 4 Argon em seis conjuntos de dados, incluindo os de bolas de tênis, futebol, espigas de trigo e ultrassom da tireoide.
A Moonshot cobra na sua própria chave de API US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, o que resultou em cerca de US$ 22.50 por 1.000 imagens no nosso benchmark. O Batch Annotation também acrescenta a taxa de processamento da Ultralytics Platform, de US$ 1.00 por 1.000 imagens.
Sim. Modelos hospedados, como Qwen3.8 27B, Gemma 4 26B e SAM 3.1 Text, são executados na Ultralytics Platform sem uma chave de provedor. Você também pode fazer anotações automáticas com modelos Ultralytics YOLO pré-treinados ou ajustados por você.









