Auto-annotation avec Gemini 4 Carbon : le nouveau leader de notre classement VLM
Gemini 4 Carbon arrive en tête des 45 VLM sur notre benchmark de détection d’objets composé de 36 jeux de données : 0,584 mAP50, avec la meilleure précision et le meilleur rappel. Quand GPT-6.1 Terra offre un meilleur rapport qualité-prix.
 Glenn Jocher15 min de lecture
Gemini 4 Carbon se classe premier parmi 45 modèles pour l’auto-annotation sur UL37, notre benchmark de détection d’objets composé de 36 jeux de données, dans le relevé du classement VLM Ultralytics du 11 novembre 2026. Il obtient 0,584 mAP50 et 0,371 mAP50-95, et arrive désormais en tête des colonnes de précision et de rappel, qui revenaient à deux modèles différents dans nos résultats d’octobre. GPT-6.1 Terra, le précédent leader, se classe deuxième avec 0,560 mAP50, pour un coût par image d’environ un tiers de celui de Carbon chez le fournisseur.
La question pour toute personne qui annote un jeu de données n’est donc pas de savoir quel modèle obtient le meilleur score global. Il s’agit de savoir quand Carbon vaut trois fois son prix. Voici les domaines où Carbon établit de nouveaux records, ceux où Terra reste en tête, le coût de chacun avant et après le changement de prix de Google en décembre, ainsi que la marche à suivre pour utiliser Carbon sur tes propres données dans Ultralytics Platform.
Gemini 4 Carbon est désormais accessible à tous les développeurs payants#
Google a d’abord lancé Carbon fin octobre auprès d’un petit groupe de spécialistes de la cybersécurité chargés de la défense. Le 10 novembre 2026, Google a ouvert le modèle à tous les développeurs et entreprises payants, et a commencé à le déployer auprès des abonnés Google AI Ultra. Selon la publication de Google sur la disponibilité, Carbon est disponible via l’API dans Google AI Studio et Gemini pour les entreprises, ainsi que dans l’application Gemini, AI Mode et Antigravity pour les abonnés Ultra. Les spécialistes de la défense conservent un accès spécialisé via le programme Fairwind de Google.
Google présente Carbon comme son modèle le plus puissant, destiné à la cybersécurité et aux tâches agentiques à long horizon. La fiche du modèle Gemini 4 Carbon indique qu’il repose sur Gemini 4 Argon et utilise davantage de jetons de réflexion qu’Argon « pour explorer les hypothèses en profondeur, raisonner avec rigueur et exécuter de longues boucles de vérification ». Il traite le texte, les images, l’audio et la vidéo, avec une fenêtre de contexte pouvant atteindre 1 million de jetons, et produit des réponses textuelles.
Aucun élément de la présentation de lancement de Google ne décrit Carbon comme un détecteur. Pour l’annotation des données, ce qui compte, c’est l’effet de ce raisonnement supplémentaire sur les boîtes englobantes, et c’est ce que mesure UL37. Tu peux examiner chaque résultat sur la page du modèle Gemini 4 Carbon.
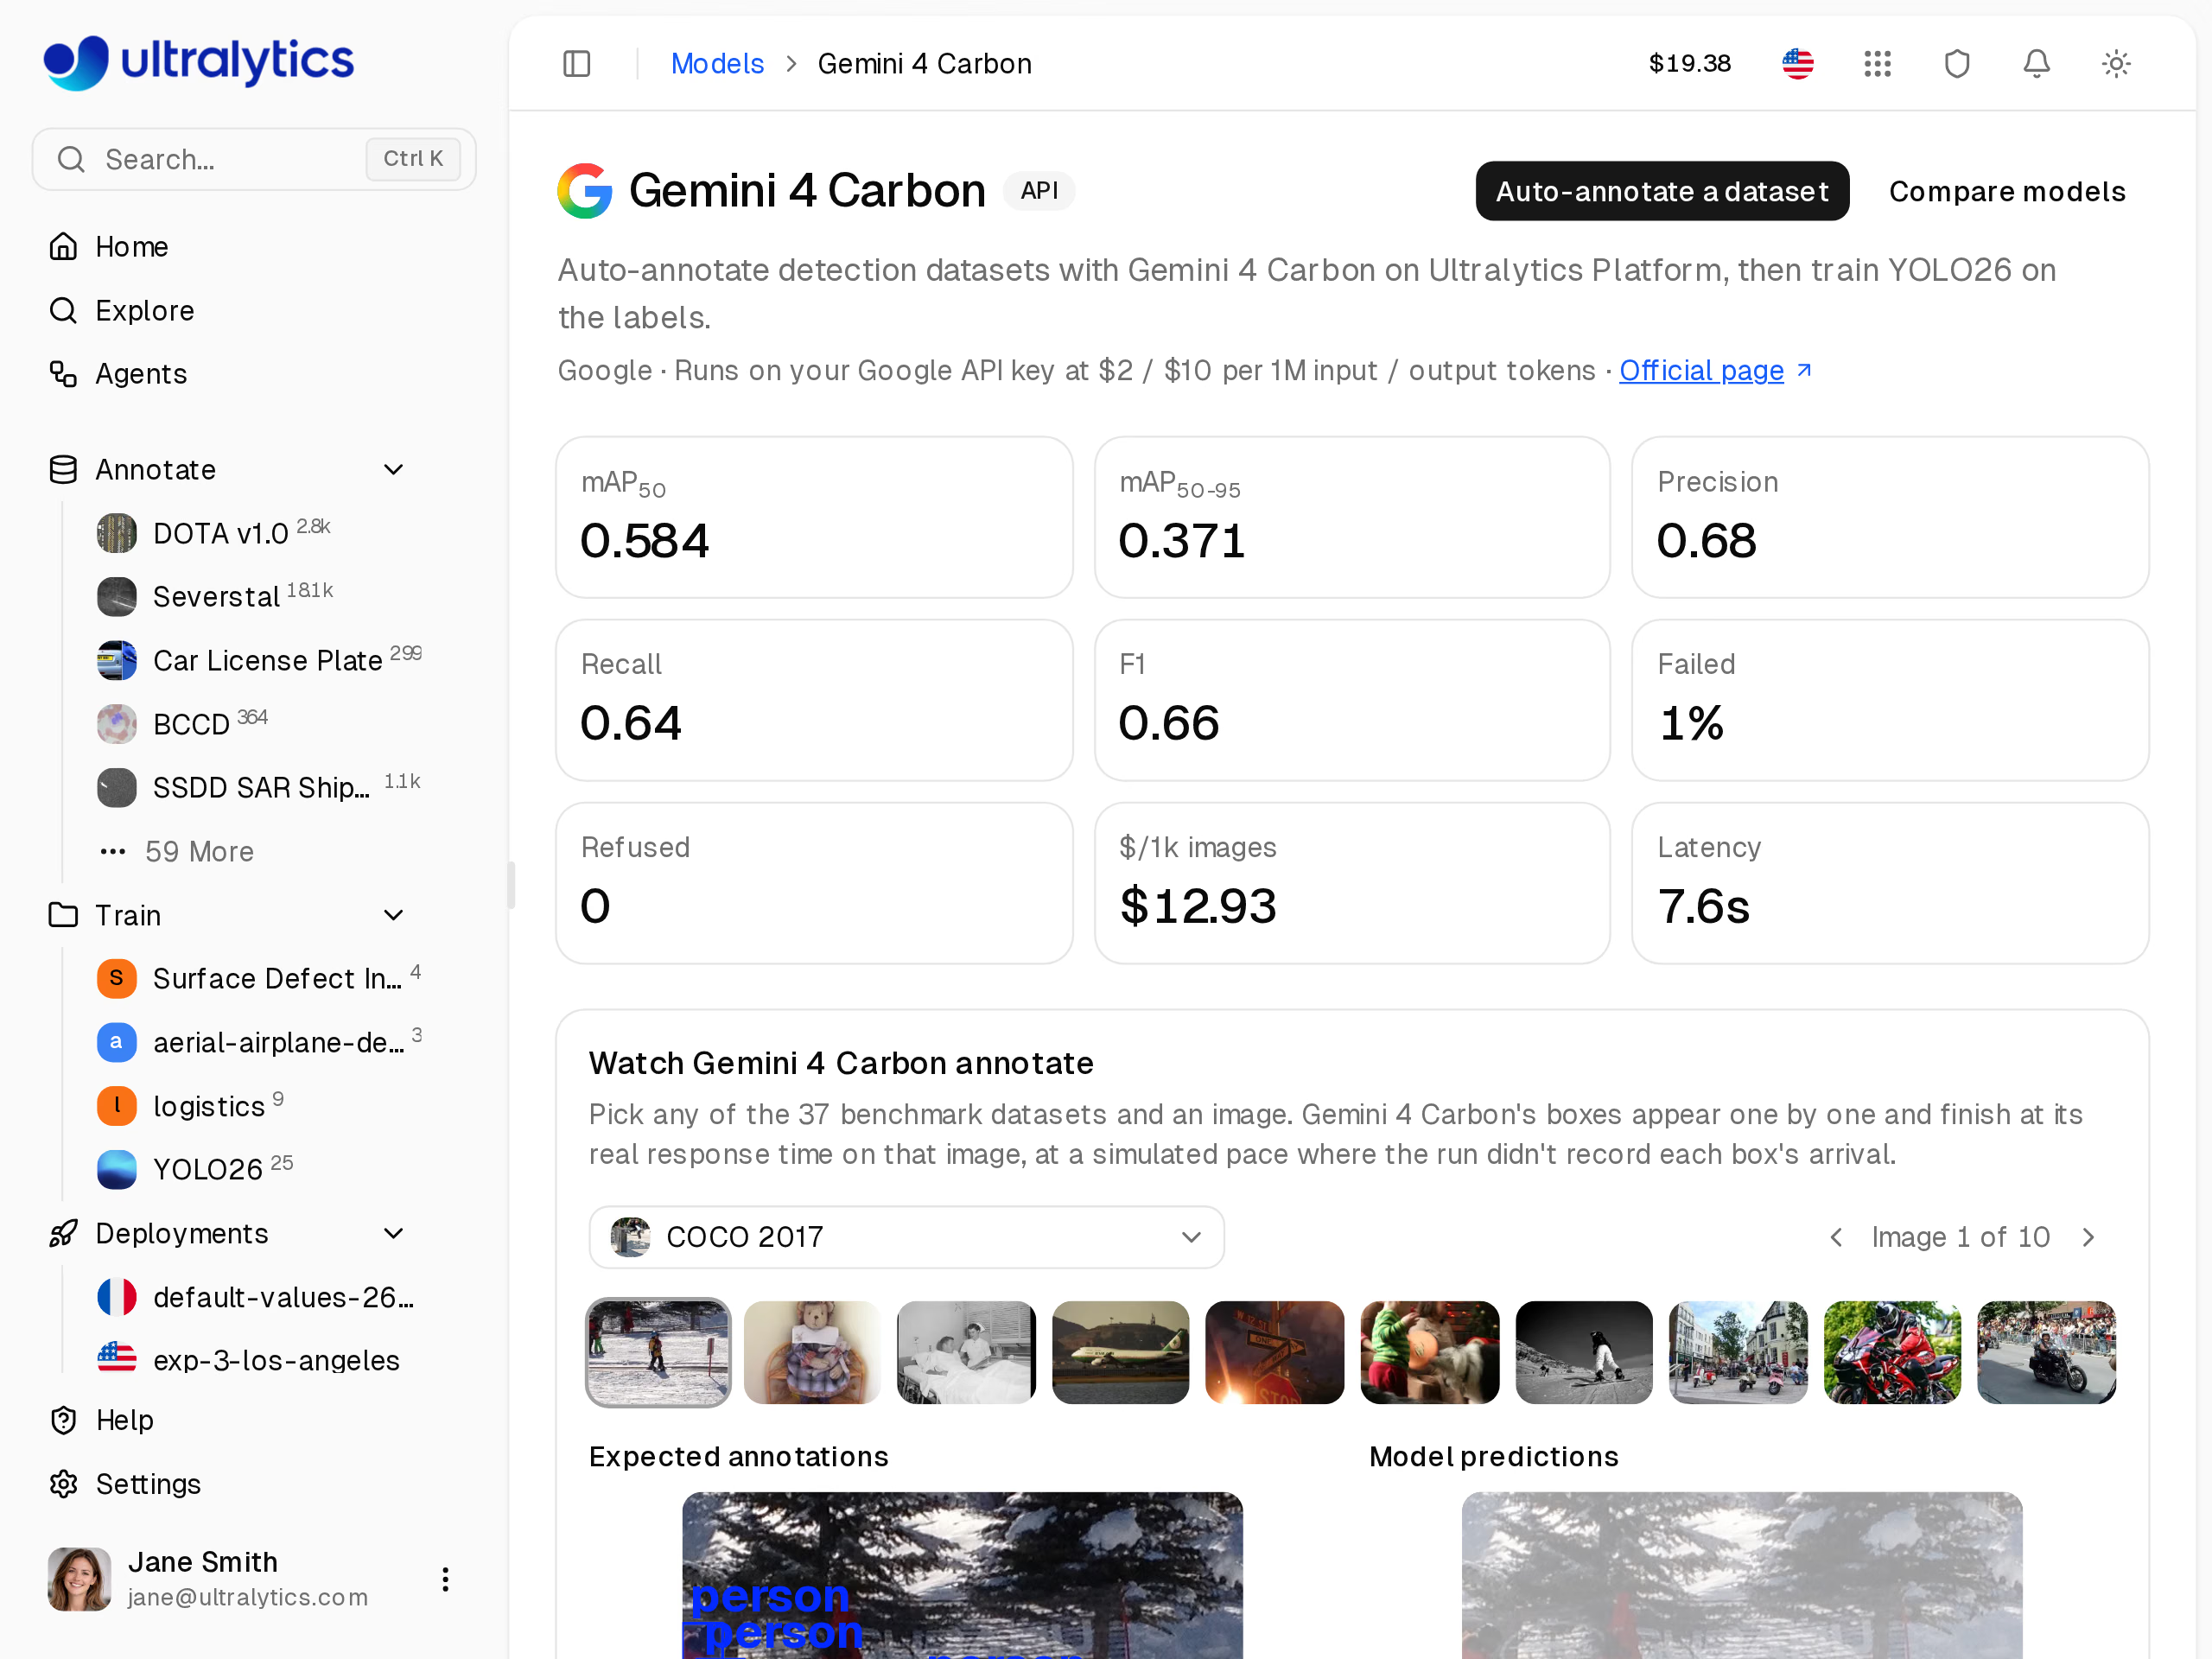
Page du modèle Gemini 4 Carbon sur Ultralytics Platform, avec ses scores UL37 et un lien pour annoter automatiquement un jeu de données.
Détection d’objets avec Gemini 4 Carbon : premier sur toutes les métriques de précision#
UL37 évalue la proximité entre les boîtes d’un modèle et les annotations de référence de chaque jeu de données sur 360 images : 10 images issues de chacun des 36 jeux de données réels de détection d’objets, qui couvrent les scanners médicaux, les images aériennes et thermiques, les rayons de magasins, le sport, les documents, les cartes de circuits imprimés et bien plus. Chaque image passe par le même pipeline de production que celui utilisé par les utilisateurs de Platform, avec les noms de classes propres au jeu de données ; SAM 3.1 affine les boîtes de chaque modèle, à l’exception de celles de SAM 3, comme il le fait pour les utilisateurs. Chaque jeu de données a le même poids ; consulte la méthodologie du benchmark UL37.
Voici les résultats de Carbon par rapport aux quatre modèles suivants :
Carbon devance GPT-6.1 Terra de 0,024 en mAP50. La métrique plus stricte mAP50-95, qui valorise les boîtes épousant les contours des objets, révèle un écart similaire : 0,371 pour Carbon, contre 0,347 pour Claude Fable 5.2, le précédent meilleur modèle, et 0,345 pour Terra.
Carbon améliore aussi les performances du modèle dont il est issu. Gemini 4 Argon obtient 0,537 mAP50 et 0,343 mAP50-95 : Carbon gagne donc respectivement 0,047 et 0,028 sur le même benchmark et avec le même pipeline d’annotation.
Gemini 4 Carbon affiche la meilleure précision et le meilleur rappel sur UL37#
Dans nos résultats d’octobre, les meilleurs modèles du classement se répartissaient en deux groupes, comme l’explique notre guide pour choisir un VLM selon la précision et le rappel. Gemini 4 Argon affichait la meilleure précision, à 0,667 : une forte proportion de ses boîtes correspondaient aux objets, mais certaines annotations lui échappaient. GPT-6 Astra affichait le meilleur rappel, à 0,627 : il détectait davantage d’objets annotés, mais une plus faible proportion de ses boîtes était correcte.
Dans le relevé du classement du 11 novembre 2026, Carbon affiche une précision de 0,685 et un rappel de 0,642, les moyennes les plus élevées parmi les 45 modèles, devant la précision d’Argon et le rappel d’Astra.
Pour une personne chargée de la révision, c’est la meilleure combinaison que le benchmark puisse montrer. Une précision plus élevée signifie qu’une plus grande proportion des boîtes proposées est correcte ; un rappel plus élevé signifie qu’une plus grande proportion des objets réels possède déjà une boîte. Une faible précision laisse des boîtes à supprimer, et un faible rappel laisse des objets à encadrer : les premières annotations de Carbon nécessitent donc moins de corrections de part et d’autre.
SKU110K montre pourquoi cela compte pour les images très chargées. Ses rayons de supermarché présentent 1 666 produits annotés sur les 10 images du benchmark, tous dans une seule classe. Carbon y obtient 0,671 mAP50, le meilleur score de tous les modèles, devant le précédent record de Terra, à 0,619. Sur un rayon aussi dense, chaque boîte parasite est une boîte que la personne chargée de la révision doit repérer parmi des dizaines de boîtes correctes.
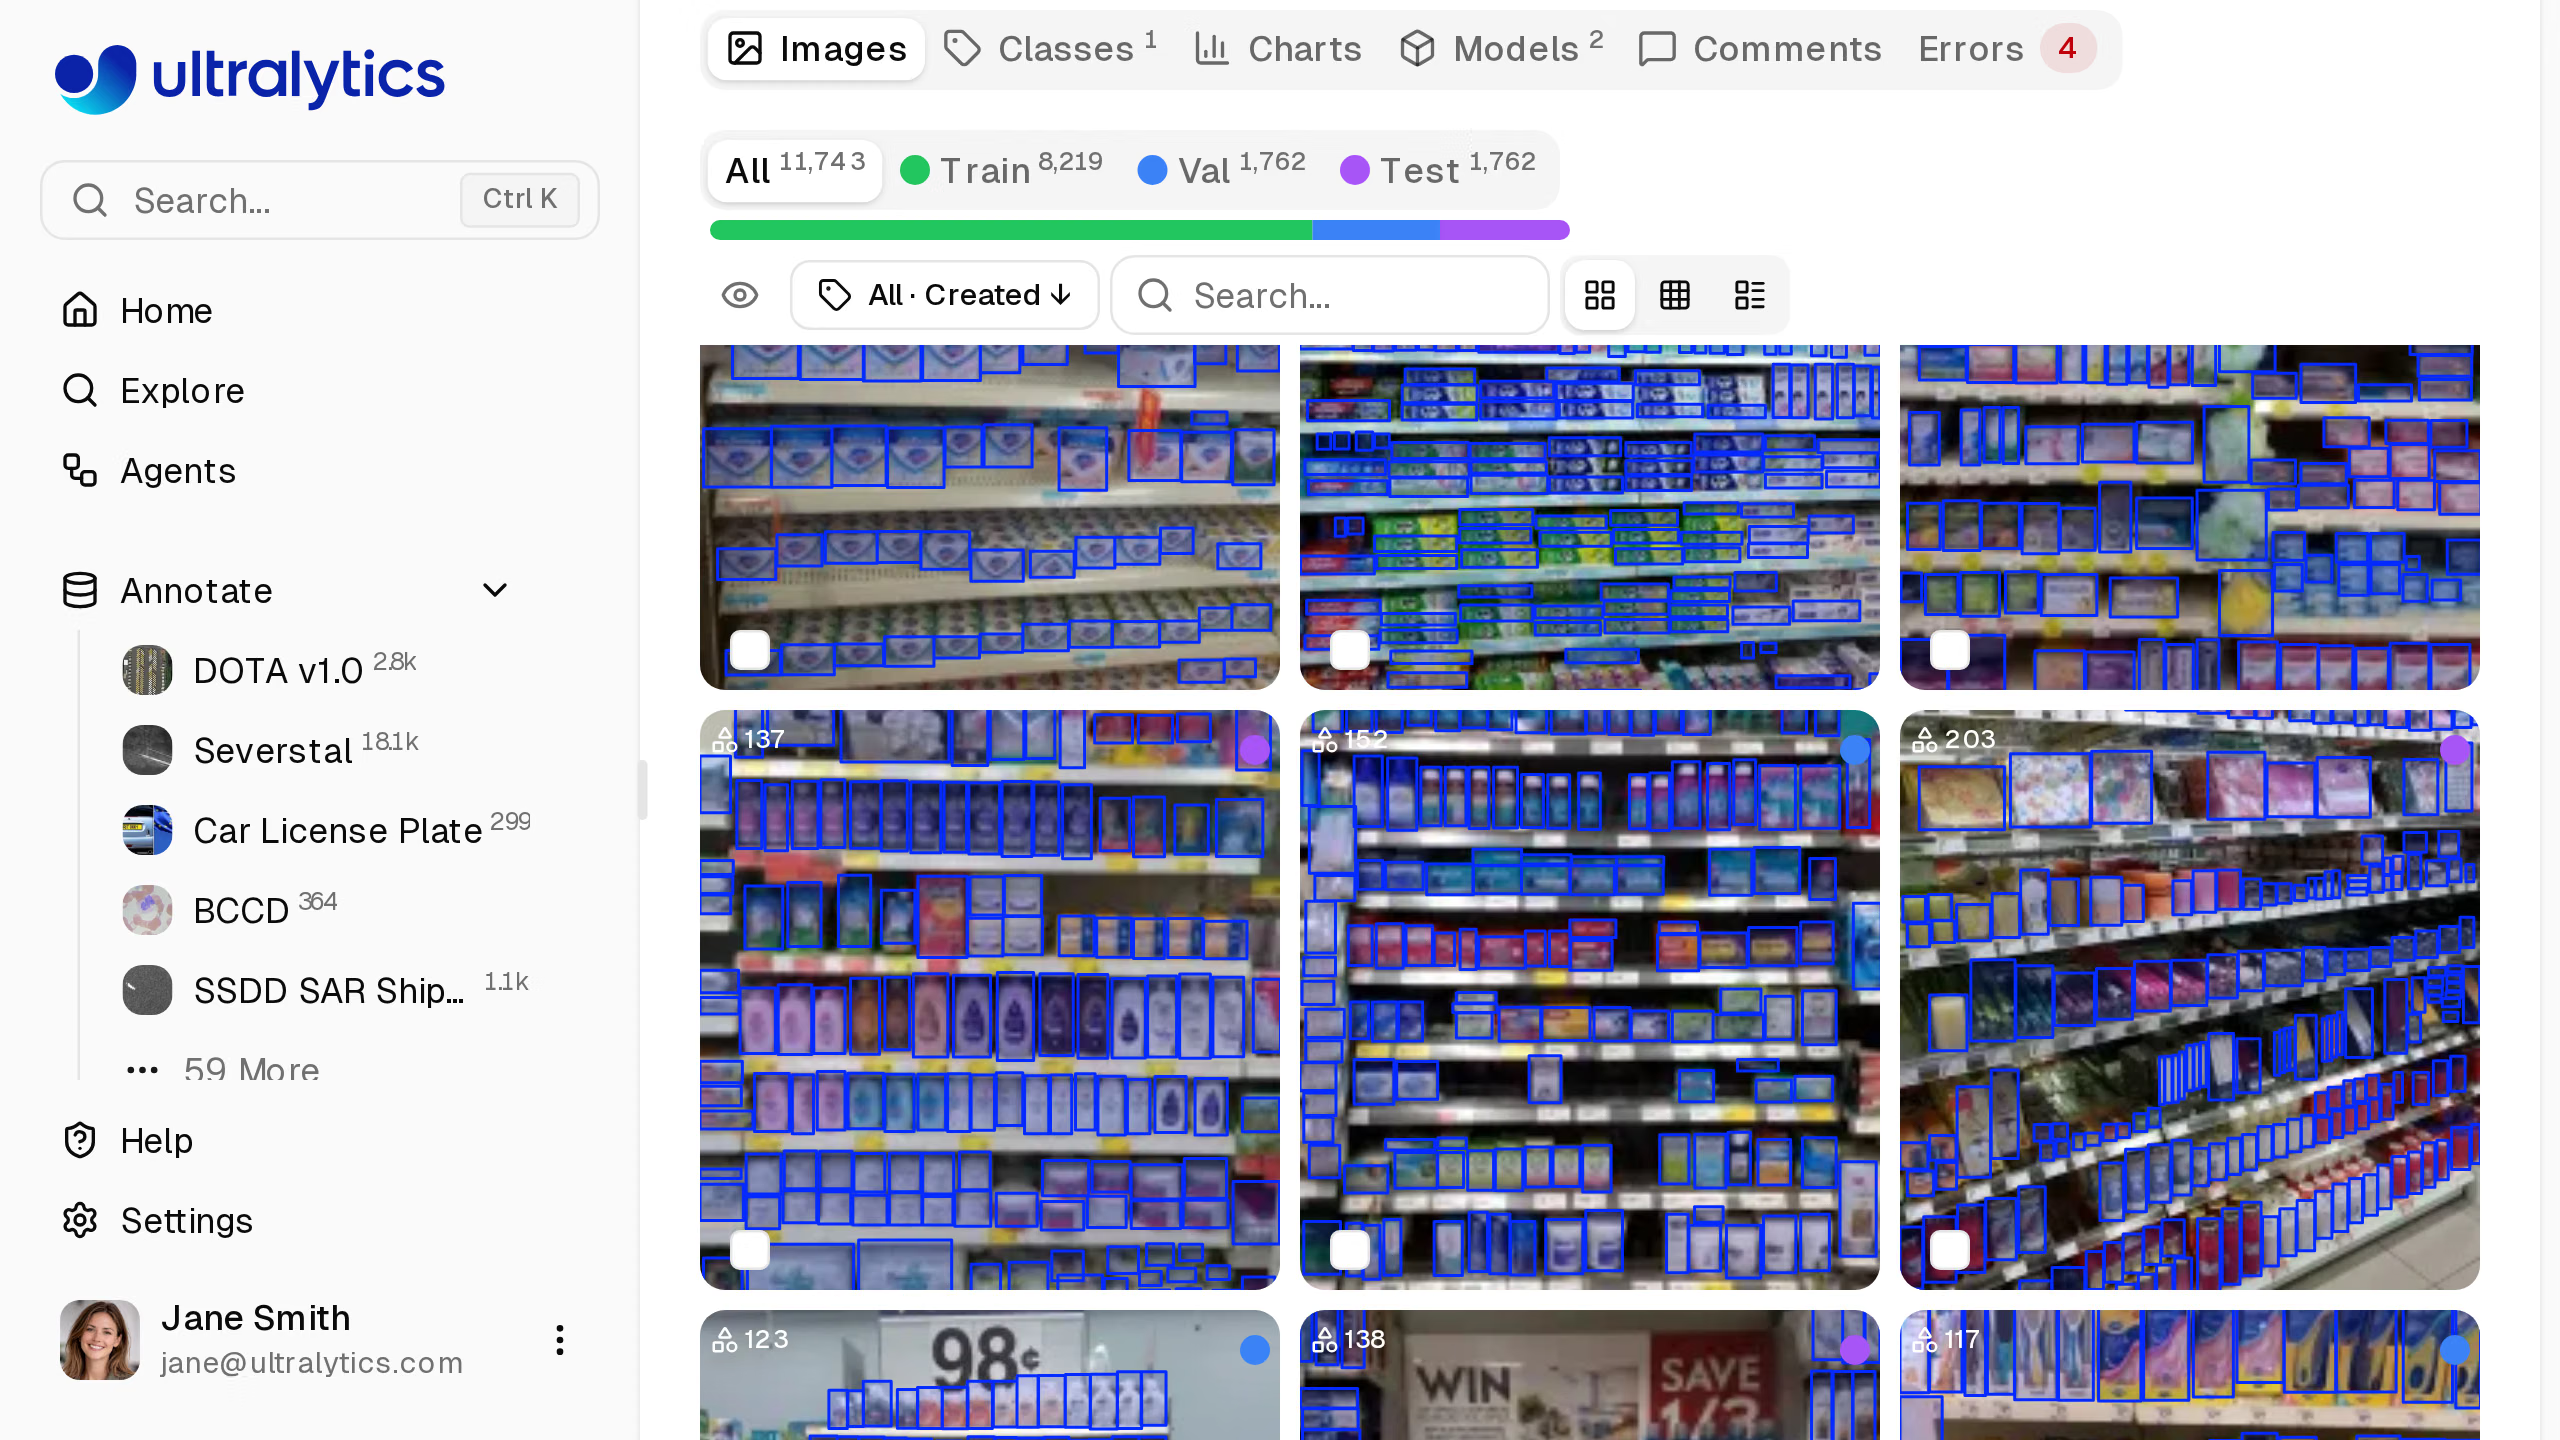
Le jeu de données SKU110K Dense Retail Shelf Detection 2 sur Ultralytics Platform, où Carbon signe le meilleur score UL37, avec 0,671 mAP50.
Gemini 4 Carbon obtient les meilleurs scores dans neuf domaines#
D’après les résultats par jeu de données sur les pages des modèles de Platform, Carbon détient désormais le meilleur score de tous les modèles pour un grand nombre de jeux de données UL37. Les voici, avec le précédent meilleur score :
| Jeu de données | Domaine | mAP50 de Gemini 4 Carbon | Meilleur mAP50 précédent |
|---|---|---|---|
| LLVIP infrarouge | Thermique / faible luminosité | 0.955 | Gemini 4 Argon, 0,915 |
| Cheng Brain Tumor MRI | Médical | 0.942 | GPT-6.1 Terra, 0,904 |
| RPC Retail Checkout | Commerce de détail | 0.935 | GPT-6 Astra, 0,935 (égalité) |
| CeyMo Road Markings | Routes / circulation | 0.905 | Gemini 4 Argon, 0,905 (égalité) |
| Basketball and Hoop | Sports | 0.882 | Claude Fable 5.2, 0,849 |
| FloorPlanCAD 2 | Documents / interfaces utilisateur / CAO | 0.821 | GPT-6 Astra, 0,726 |
| RUOD Underwater | Sous-marin | 0.788 | Gemini 4 Argon, 0,757 |
| HIT-UAV drone thermique | Aérien / télédétection | 0.689 | Gemini 4 Argon, 0,582 |
| Rayons SKU110K | Commerce de détail | 0.671 | GPT-6.1 Terra, 0,619 |
| PlantDoc | Nature / agriculture | 0.594 | Claude Fable 5.2, 0,521 |
| Airbus Oil Storage | Aérien / télédétection | 0.381 | Gemini 4 Argon, 0,347 |
| Lésions rétiniennes DDR | Médical | 0.133 | Claude Opus 5.5, 0,132 |
Trois tendances se dégagent. Carbon conserve les points forts d’Argon sur les images thermiques, aériennes et sous-marines, et les renforce, avec le plus grand progrès sur les images de drones thermiques HIT-UAV. Il ravit à GPT-6 Astra la première place sur les plans d’étage avec près de 0,1 point d’avance. Enfin, sur les IRM de tumeurs cérébrales, où les classes sont le méningiome, le gliome et la tumeur hypophysaire, il dépasse de peu Terra.
Chaque jeu de données ne comporte que 10 images : un score isolé est donc un signal à examiner, pas une conclusion définitive. Carbon égale le record existant sur RPC et CeyMo et ne devance les autres modèles que de 0,001 sur DDR ; ces marges sont trop faibles pour les départager.
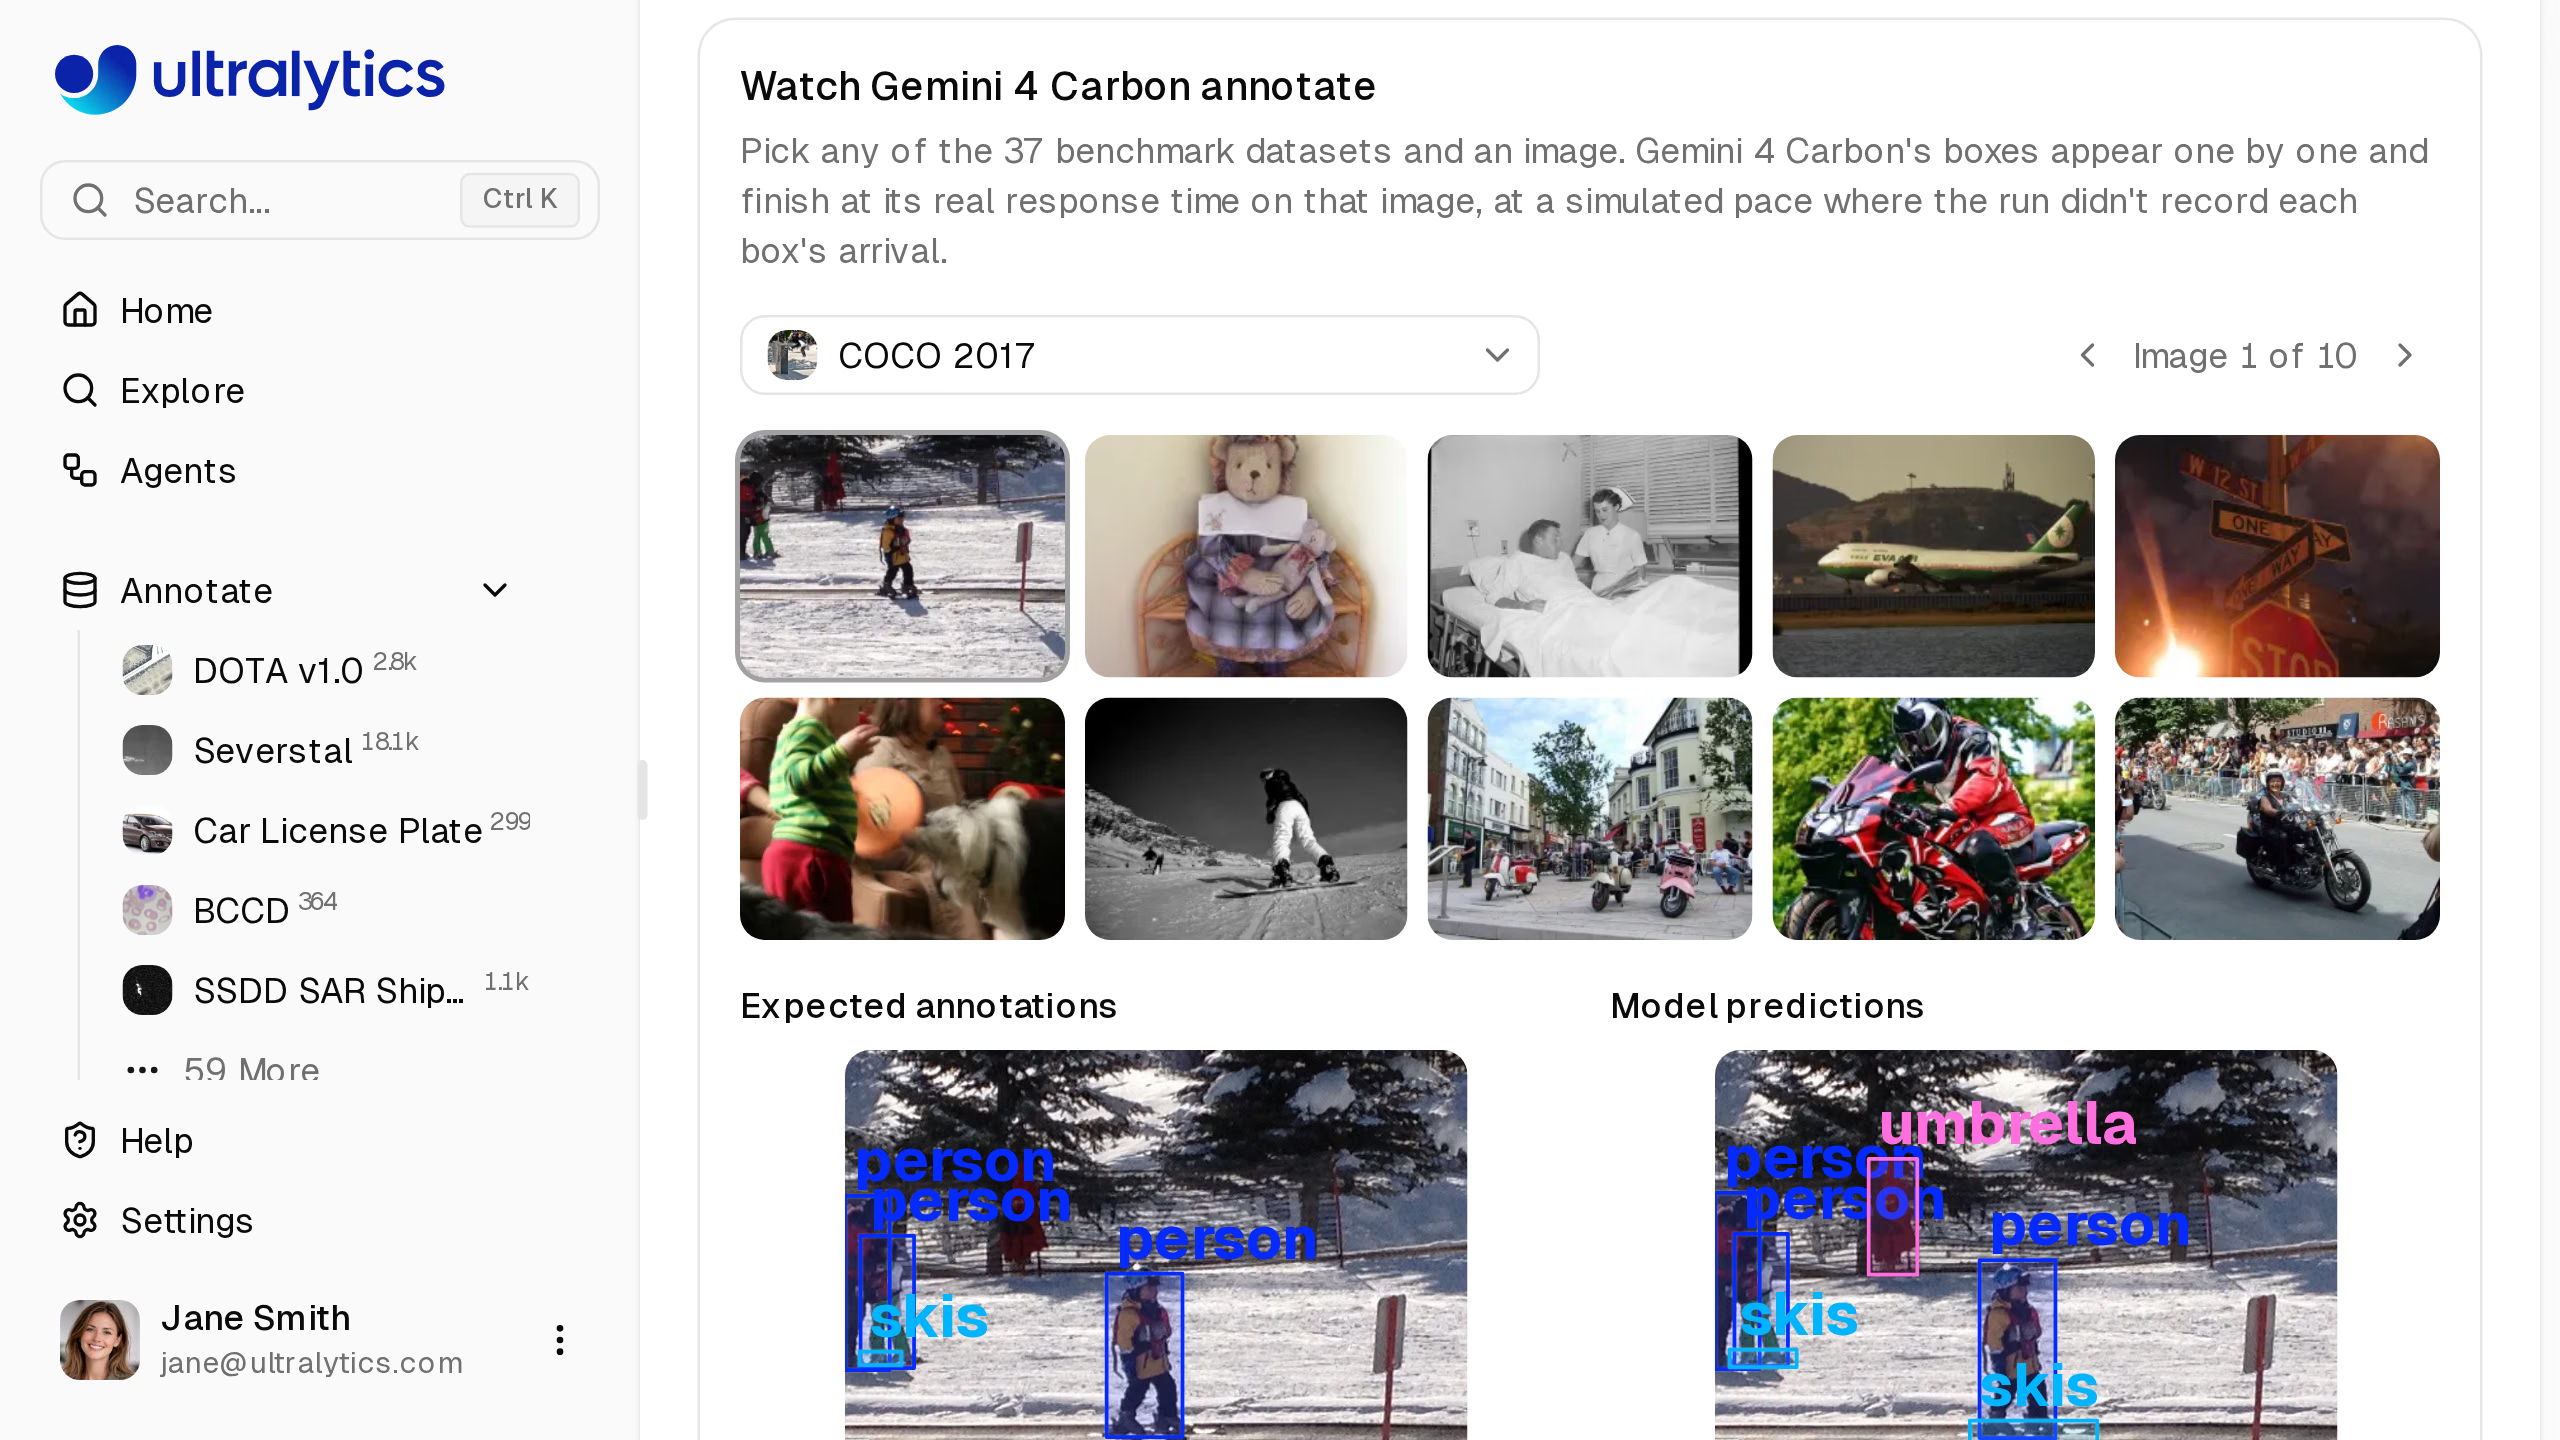
La page du modèle affiche côte à côte les boîtes UL37 enregistrées par Carbon et les annotations attendues pour chaque jeu de données du benchmark, ainsi que pour COCO.
Gemini 4 Carbon contre GPT-6.1 Terra : les domaines où Terra reste en tête#
Terra conserve deux meilleurs scores dans le domaine médical. Le tableau des jeux de données du classement le désigne toujours comme meilleur modèle pour l’échographie thyroïdienne TN5000, avec 0,935, et pour la microscopie de cellules sanguines TXL-PBC, avec 0,889. Si tes données ressemblent à l’un de ces jeux de données, compare les résultats des deux modèles sur leurs pages respectives avant de faire ton choix.
Le principal avantage de Terra reste son prix. Voici la comparaison directe sur UL37 :
| Résultat UL37 | Gemini 4 Carbon | GPT-6.1 Terra |
|---|---|---|
| mAP50 | 0.584 | 0.560 |
| mAP50-95 | 0.371 | 0.345 |
| Coût fournisseur pour 1 000 images | $12.93 | $4.36 |
| Temps médian par image | 7.6 s | 5,1 s |
| Requêtes ayant échoué | 1% | 0% |
Le coût est estimé à partir de l’utilisation des jetons déclarée par le fournisseur pour 1 000 images de benchmark annotées avec succès, aux prix catalogue. Terra atteint environ 96 % du mAP50 de Carbon pour environ un tiers du coût, répond plus rapidement et n’a échoué sur aucune requête. Les deux modèles figurent sur la ligne « meilleur rapport qualité-prix » du classement, qui regroupe les modèles qu’aucun autre ne surpasse à la fois en coût et en précision.
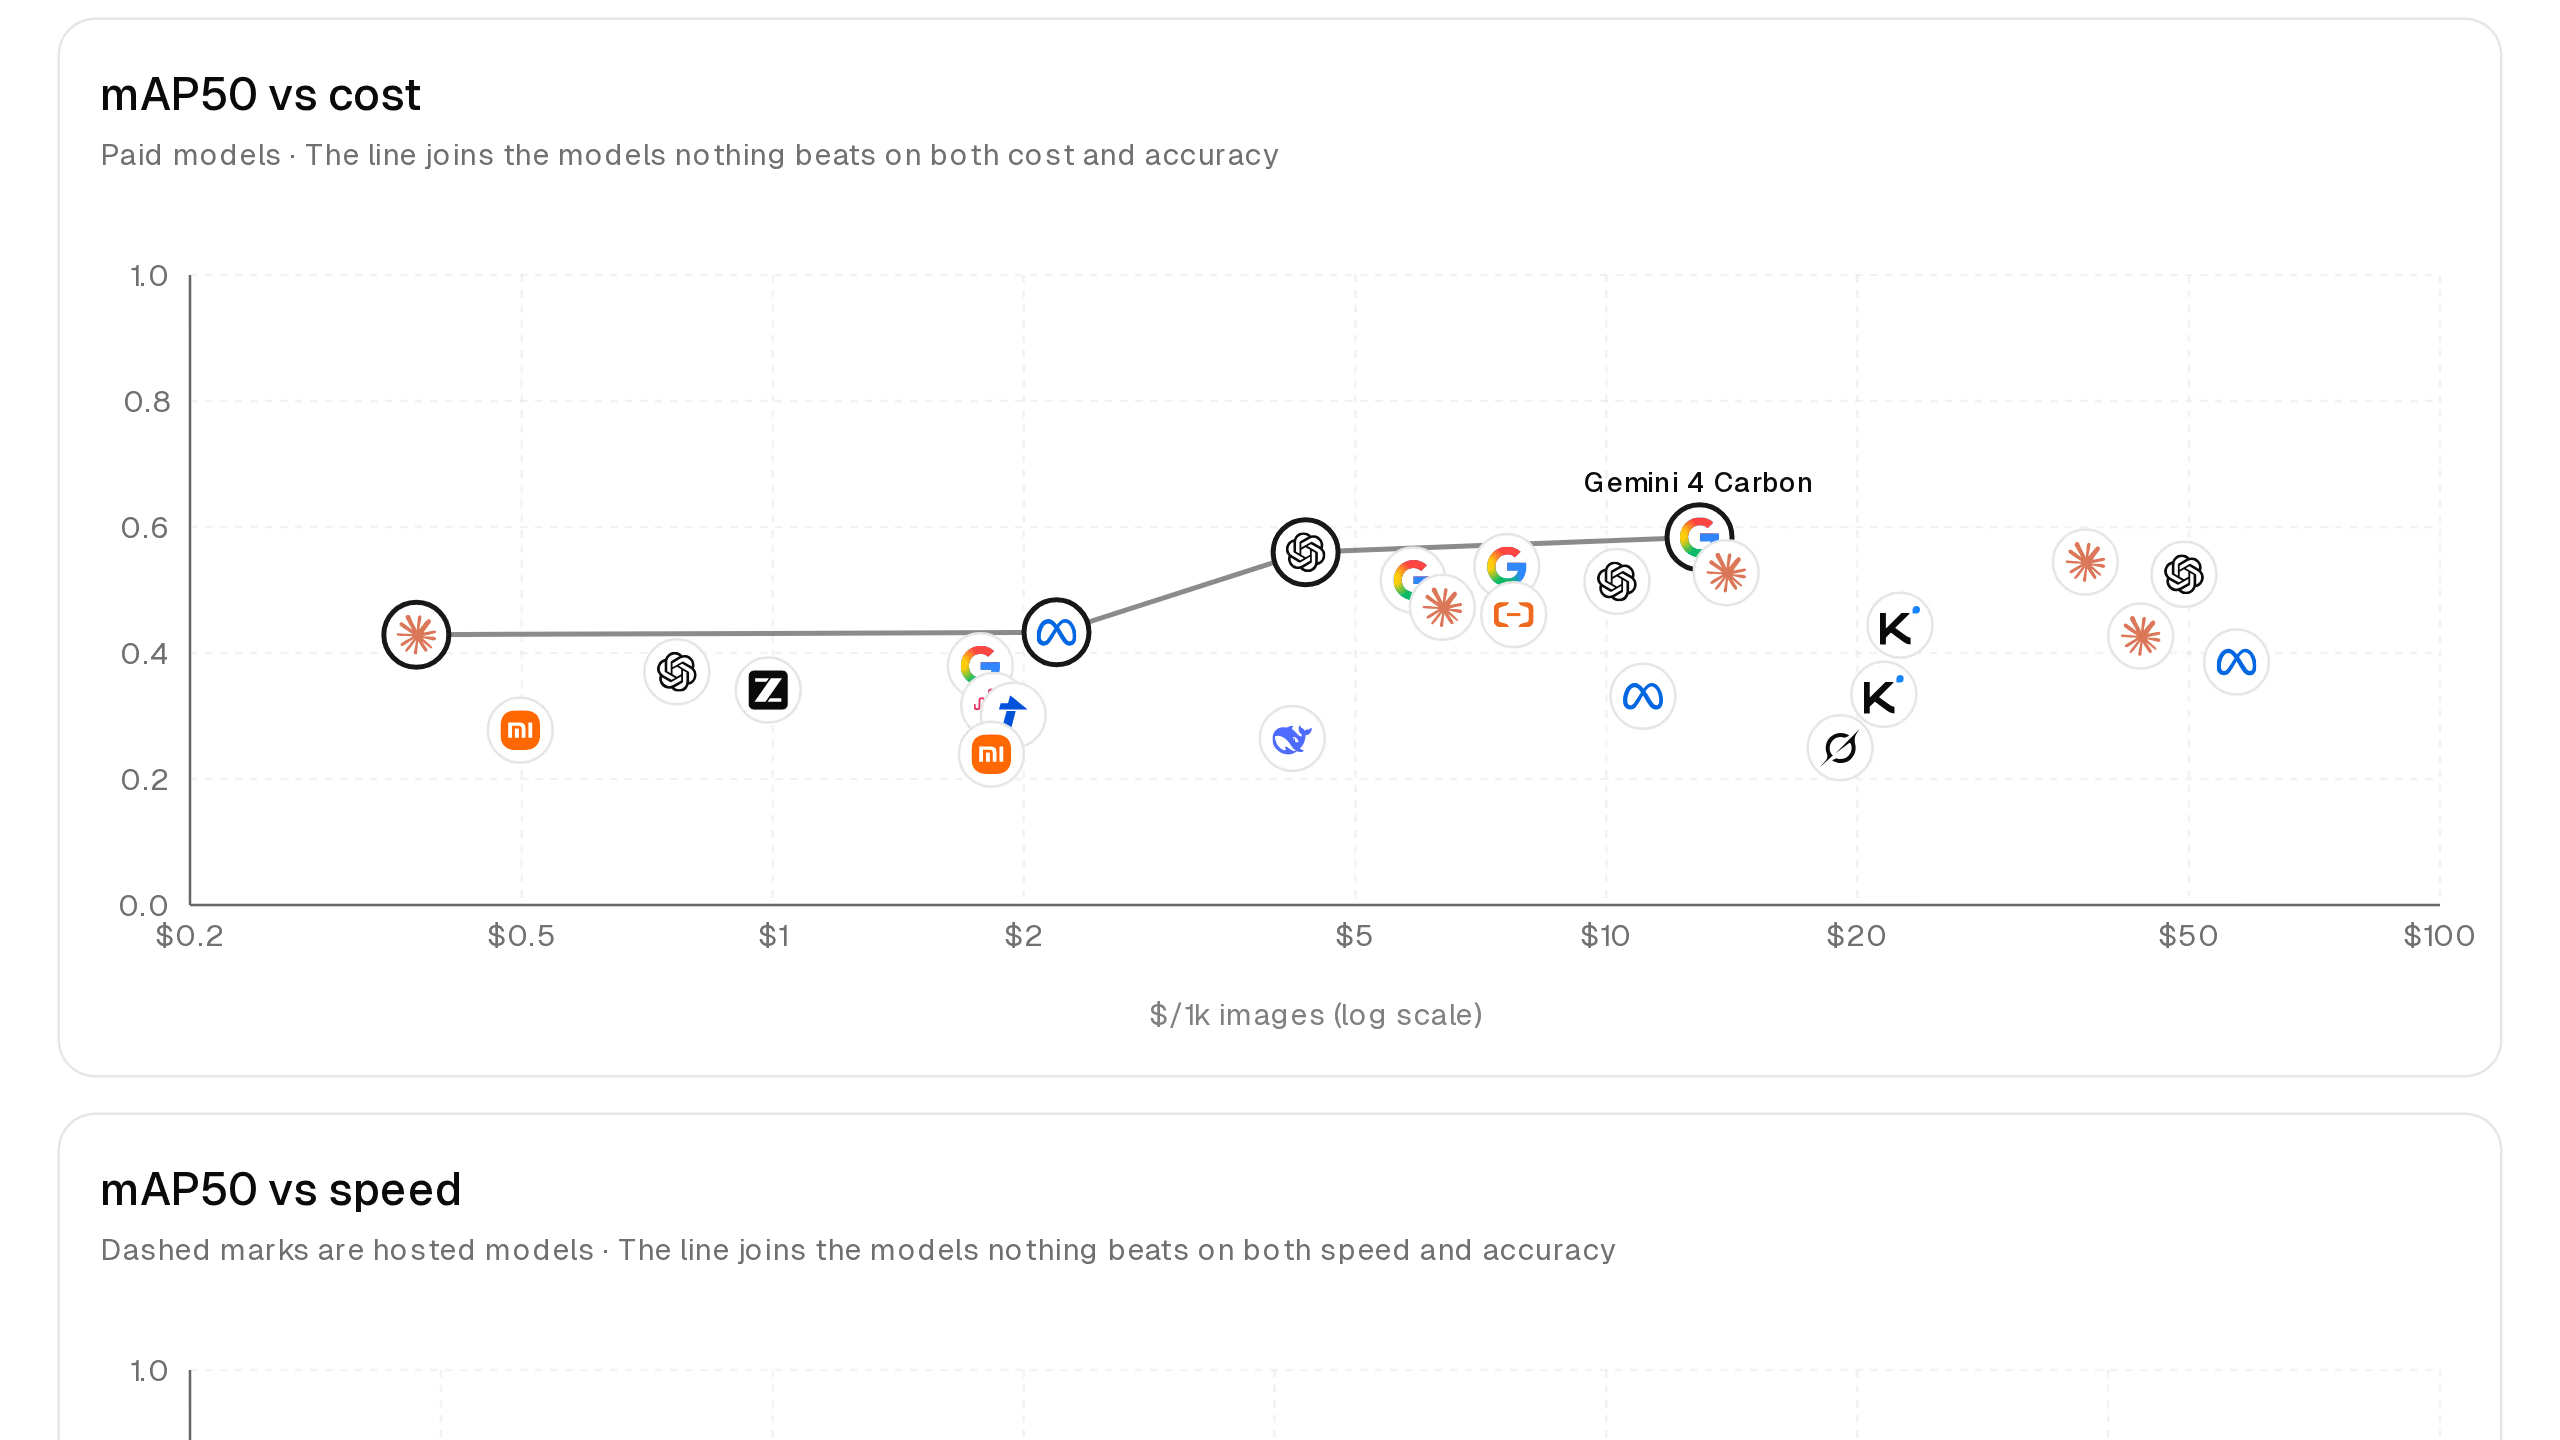
Graphique mAP50 en fonction du coût des modèles payants sur UL37 dans le classement, aux prix catalogue actuels.
L’écart de prix va se creuser. D’après sa publication sur la disponibilité, Google propose Carbon au tarif de lancement de 2 $ par million de jetons d’entrée et de 10 $ par million de jetons de sortie jusqu’au 30 novembre 2026, puis les tarifs passent à 4 $ et 20 $. À utilisation de jetons identique, les 12,93 $ de Carbon pour 1 000 images passeront à environ 26 $ le 1er décembre.
Voici comment faire ton choix en pratique :
- Paie pour Carbon lorsque la qualité des annotations justifie le coût : scènes denses comme les rayons de magasins, images thermiques et aériennes, plans d’étage et dessins de CAO, ainsi que tout jeu de données où la page du modèle montre une nette avance de Carbon.
- Choisis Terra pour les grands lots généralistes où le budget compte davantage qu’un écart de 0,024 mAP50, et pour les données comme celles des jeux de données d’échographies thyroïdiennes TN5000 et de cellules sanguines TXL-PBC.
- Lance une grosse tâche avec Carbon avant le 1er décembre si tu comptes l’utiliser, tant que le tarif de lancement s’applique.
Quel que soit ton choix, Batch Annotation ajoute des frais de traitement Ultralytics Platform de 1,00 $ par tranche de 1 000 images traitées, avec un minimum de 0,01 $ par exécution ; le fournisseur facture directement ta propre clé. Ultralytics n’ajoute aucune marge sur les jetons. Pour une analyse plus détaillée, consulte notre guide des coûts des logiciels d’annotation d’images. Parmi les modèles payants moins chers, Claude Haiku 5.5 obtient 0,429 pour 0,37 $ par tranche de 1 000 images, et les modèles hébergés comme Qwen3.8 27B et SAM 3.1 Text ne nécessitent aucune clé.
Comment lancer l’auto-annotation de ton jeu de données avec Gemini 4 Carbon#
Carbon est un modèle de détection guidé par des invites de classes, conçu pour les jeux de données de 1 à 200 classes. Il renvoie des boîtes englobantes pour les noms de classes propres à ton jeu de données ; Platform les transmet au format Gemini avec l’axe y en premier, puis les affine avec SAM 3.1.
- Crée une clé API Gemini dans Google AI Studio. Carbon fonctionne avec l’offre payante de l’API : la facturation doit donc être activée pour la clé.
- Ajoute-la dans Paramètres > Clés API, dans l’espace de travail Platform qui contient ton jeu de données. La documentation sur les clés fournisseur donne les détails.
- Ouvre une image dans l’éditeur d’annotation, passe en mode Smart, puis sélectionne Gemini 4 Carbon sous Google dans le sélecteur de modèles.
- Clique sur Prédire, ou utilise
P, pour annoter l’image en cours. Avant de passer à l’échelle, essaie le modèle sur quelques images représentatives de tes données. - Sur la page du jeu de données, choisis Plus d’actions > Annotation par lots pour annoter toutes les images non annotées en une seule passe. Platform enregistre d’abord une version du jeu de données, afin que tu puisses revenir en arrière.
- Vérifie et corrige les boîtes, que l’éditeur enregistre automatiquement, puis entraîne un modèle Ultralytics YOLO26 sur le résultat dans le même espace de travail.
Les développeurs peuvent aussi appeler Carbon depuis du code : la version 0.1.109 du SDK Platform a ajouté gemini-4-carbon comme modèle de prédiction d’image. Pour une vue d’ensemble, découvre comment Ultralytics Platform utilise l’IA pour automatiser l’annotation et pourquoi la révision avec intervention humaine reste une étape du flux de travail. Pour l’analyse d’images médicales, considère les boîtes de tout modèle comme un brouillon à vérifier et à approuver par des spécialistes cliniques, jamais comme un diagnostic.
À qui s’adresse Gemini 4 Carbon#
Utilise Gemini 4 Carbon lorsque la qualité des annotations compte davantage que la facture du fournisseur. C’est le modèle d’auto-annotation le plus précis que nous ayons évalué, le leader actuel en précision comme en rappel, et le meilleur modèle sur les jeux de données d’imagerie thermique, aérienne et sous-marine, de rayons de magasins, de plans d’étage et d’IRM cérébrales.
Les équipes qui utilisent déjà Argon obtiennent un meilleur score global et de nouveaux meilleurs scores dans les domaines où Argon excelle, au même tarif de lancement par jeton, même si Carbon coûte plus cher par image à ce tarif. Les équipes qui annotent de gros lots généralistes avec un budget limité devraient conserver GPT-6.1 Terra comme modèle par défaut et passer à Carbon jeu de données par jeu de données, lorsque la page du modèle montre une nette avance. Pour découvrir l’autre versant de l’histoire, consulte nos résultats d’auto-annotation avec Gemini 4 Argon.
Foire aux questions
Sur notre benchmark UL37, il obtient 0,584 mAP50 et 0,371 mAP50-95, se classe premier parmi les 45 modèles du classement VLM Ultralytics et affiche les moyennes de précision et de rappel les plus élevées. Il obtient le meilleur score de tous les modèles sur les jeux de données d’imagerie thermique, aérienne et sous-marine, de rayons de magasins, de plans d’étage et d’IRM cérébrales.
Il est globalement plus précis : 0,584 mAP50 contre 0,560 pour Terra, et 0,371 mAP50-95 contre 0,345. Terra coûte 4,36 $ par tranche de 1 000 images, contre 12,93 $ pour Carbon, répond plus rapidement et reste le meilleur modèle du classement sur les jeux de données d’échographies thyroïdiennes TN5000 et de cellules sanguines TXL-PBC. Paie pour Carbon là où son avance est importante, par exemple sur les rayons très chargés et les images thermiques.
Globalement sur UL37, oui. Carbon repose sur Argon et obtient un score mAP50 supérieur de 0,047 (0,584 contre 0,537). Il dépasse aussi les précédents meilleurs scores d’Argon sur les images infrarouges LLVIP, les images de drones thermiques HIT-UAV, les images sous-marines RUOD et les images Airbus Oil Storage. Les deux modèles ont le même tarif de lancement par jeton, même si Carbon utilise davantage de jetons de réflexion par requête.
Google indique un tarif de lancement de 2 $ par million de jetons en entrée et de 10 $ par million de jetons en sortie jusqu'au 30 novembre 2026, puis de 4 $ et 20 $. Lors de notre benchmark, le coût du fournisseur pour Carbon s'est élevé à 12,93 $ pour 1 000 images au tarif de lancement, soit environ 26 $ pour la même utilisation à partir du 1er décembre. L'annotation par lots dans Ultralytics Platform ajoute 1,00 $ par tranche de 1 000 images traitées.
Depuis le 10 novembre 2026, les développeurs payants et les entreprises peuvent appeler Carbon via l'API Gemini dans Google AI Studio et Gemini pour les entreprises, et son déploiement auprès des abonnés Google AI Ultra dans l'application Gemini est en cours. Les défenseurs de la cybersécurité conservent un accès spécialisé grâce au programme Fairwind de Google. Dans Ultralytics Platform, tu l'utilises avec ta propre clé API Gemini payante.
Oui. Même le meilleur modèle obtient en moyenne 0,584 mAP50 sur UL37, et les scores sont bien plus faibles sur les jeux de données les plus difficiles, comme 0,381 sur Airbus Oil Storage pour ses 10 images de benchmark. Vérifie chaque image et, pour les données médicales, fais approuver les boîtes par des experts cliniques.
Écrit par
Fondateur et PDG · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









