Comment choisir un VLM pour l’annotation automatique en fonction de la précision et du rappel
Choisis un VLM pour l’annotation automatique en fonction de la précision et du rappel : quels modèles génèrent moins de boîtes superflues, lesquels omettent moins d’objets et comment les tester sur tes propres données.
 Sergiu Waxmann17 min de lecture
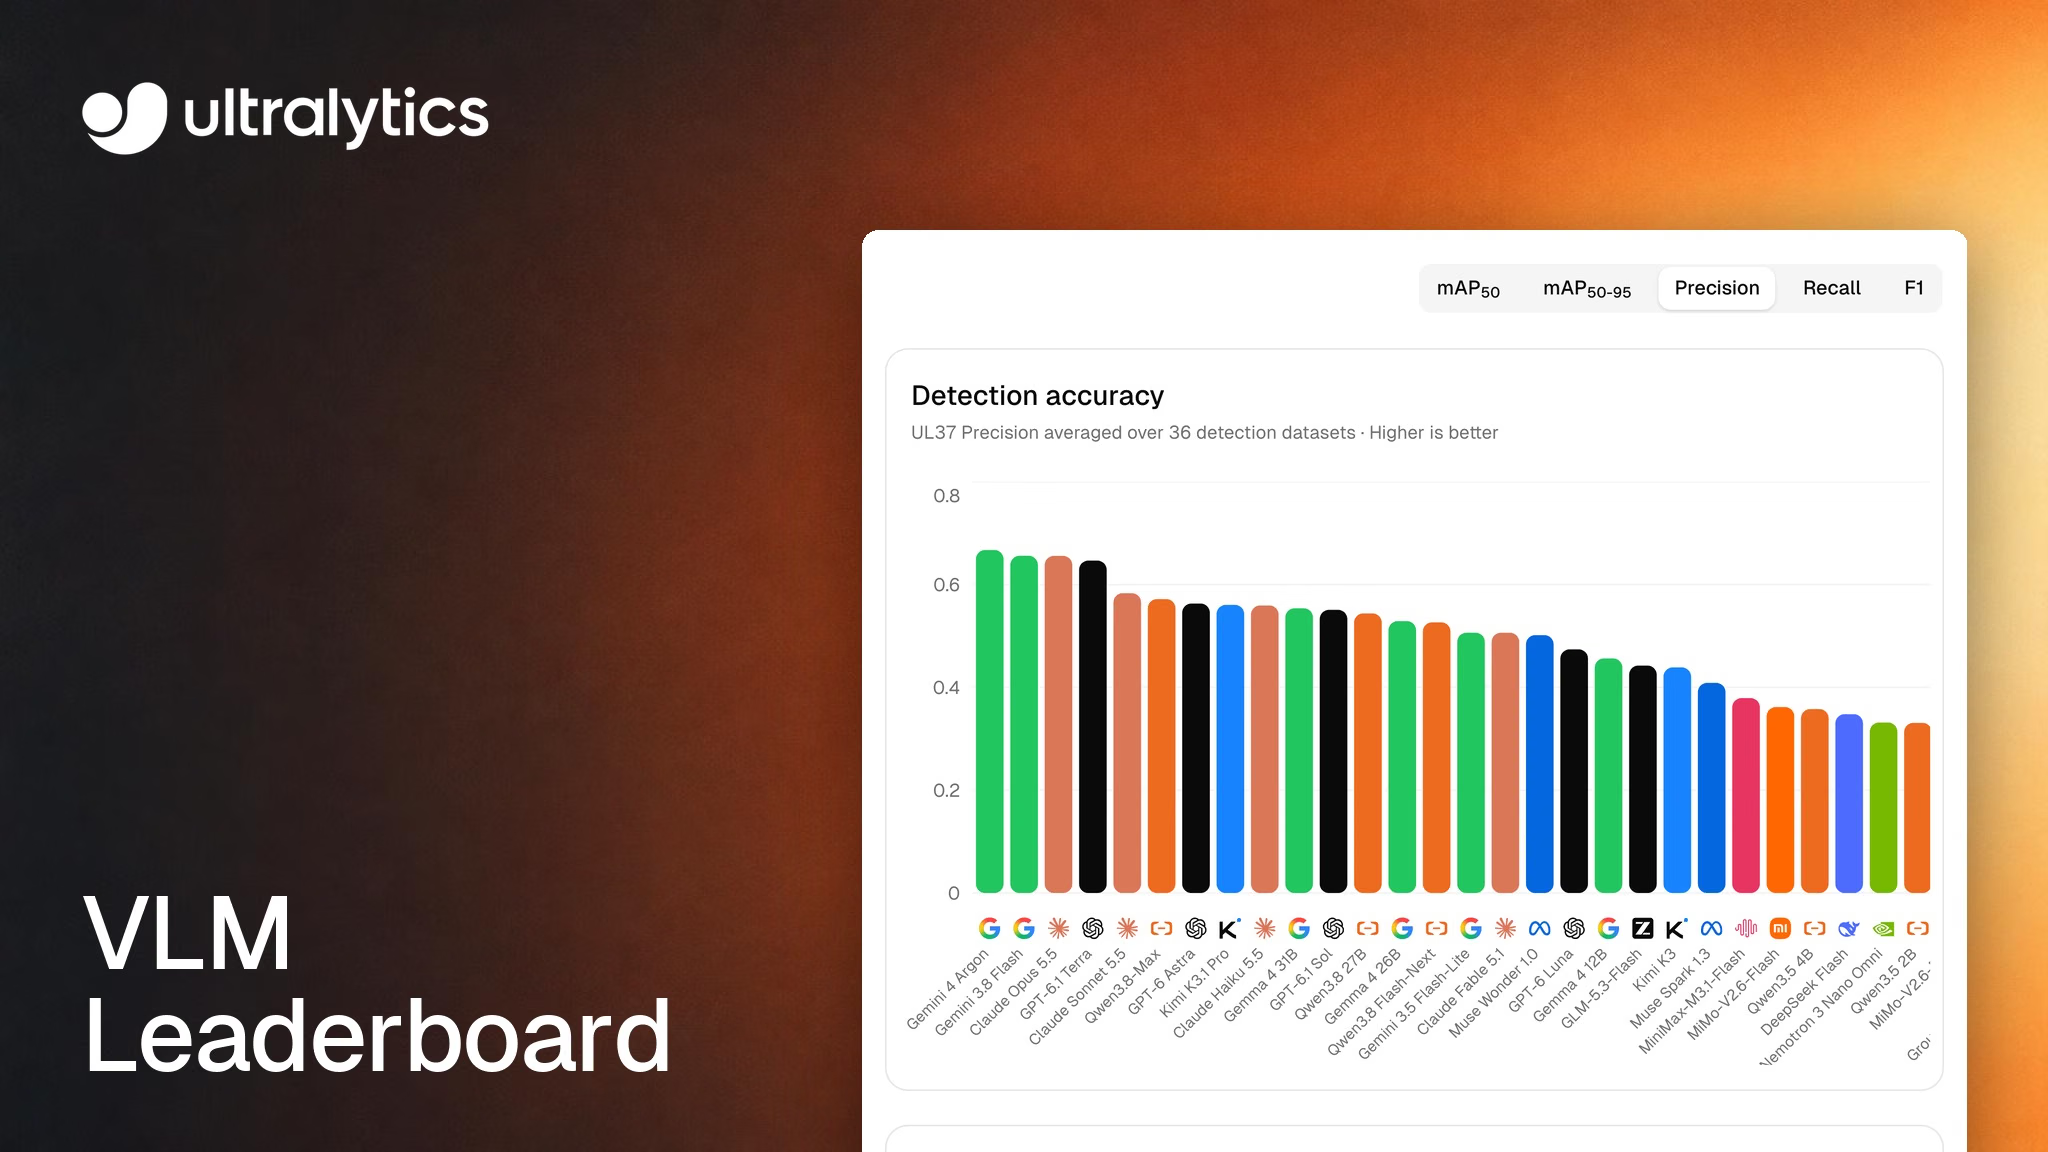
Choisir un modèle pour annoter automatiquement un jeu de données revient à déterminer quel type de nettoyage tes réviseurs préfèrent faire : supprimer les boîtes en trop ou ajouter celles qu’un modèle a manquées. Le classement VLM d’Ultralytics présente désormais cet équilibre pour chaque modèle, avec la précision (la proportion de boîtes prédites par un modèle qui sont correctes) et le rappel (la proportion d’objets annotés qu’il détecte), à partir des résultats de benchmark publiés le 28 octobre 2026.
Pour obtenir les premières annotations les plus propres, commence par Gemini 4 Argon. Pour manquer le moins d’objets possible, commence par GPT-6 Astra. Pour le meilleur équilibre et le coût le plus bas parmi les six modèles les mieux classés, choisis GPT-6.1 Terra. Si tu n’as pas ta propre clé API d’un fournisseur d’IA, commence avec Qwen3.8 27B hébergé, ou SAM 3.1 Text pour les scènes encombrées que tu préfères élaguer.
Ce guide explique comment interpréter les chiffres, à quels cas chaque modèle convient et comment confirmer ton choix sur tes propres images. Les classements et les prix changent après chaque exécution : considère donc les chiffres présentés ici comme des exemples d’octobre 2026 et consulte le classement pour obtenir les résultats à jour.
Les modèles guidés par classe n’ont pas de curseur de confiance : le choix du modèle détermine donc ton seuil.#
Avec un modèle Ultralytics YOLO dans l’éditeur d’annotations, tu ajustes toi-même le compromis. Augmente le seuil de confiance pour obtenir moins de fausses boîtes, mais davantage d’omissions ; diminue-le pour obtenir l’effet inverse. Les modèles de vision-langage (VLMs) guidés par classe fonctionnent différemment. Comme l’explique la documentation de l’éditeur d’annotations, ils détectent les classes de ton jeu de données à l’aide de seuils propres à chaque modèle et ne renvoient aucun score de confiance. Ultralytics Platform masque donc les paramètres de confiance et d’IoU lorsqu’un tel modèle est sélectionné.
Cela change le sens de la précision et du rappel dans le classement. Selon la méthodologie du benchmark, la précision et le rappel comptabilisent toutes les boîtes renvoyées par un modèle à un IoU de 0,5, sans seuil de fonctionnement caché. Ces mesures décrivent les boîtes que tes réviseurs reçoivent réellement.
Le benchmark à l’origine du classement est UL37 v2 : 10 images tirées de chacun des 36 jeux de données réels de détection d’objets sur Platform, auxquelles s’ajoutent 10 images de référence COCO 2017 évaluées séparément, soit 370 images et 7 268 boîtes. Chaque image suit le même pipeline de production que Smart et Batch Annotation, avec les noms de classes propres au jeu de données, et SAM 3.1 affine les boîtes de chaque modèle, à l’exception de celles de SAM 3. L’évaluation utilise les métriques de détection du package Ultralytics, le code qui valide les modèles YOLO, et chaque jeu de données a le même poids dans la moyenne.
La précision mesure les boîtes non appariées, le rappel mesure les objets non appariés#
La précision est la proportion de boîtes d’un modèle qui correspondent à un objet annoté de la bonne classe, avec un IoU de 0,5. Le rappel est la proportion d’objets annotés auxquels le modèle a associé une boîte. En pratique, pour la révision :
- Une faible précision signifie davantage de boîtes à supprimer, réétiqueter ou redimensionner pour les faire correspondre.
- Un faible rappel signifie davantage d’objets annotés auxquels ajouter une boîte, qu’il faut redimensionner ou réétiqueter.
- F1 est la moyenne harmonique des deux, 2 x P x R / (P + R), un chiffre qui résume les deux. Il ne mesure pas la durée de révision.
- mAP50 et mAP50-95 classent les modèles selon la précision moyenne sur l’ensemble des classes, à un IoU de 0,5 et sur les seuils plus stricts de 0,50 à 0,95. Le classement est trié par mAP50.
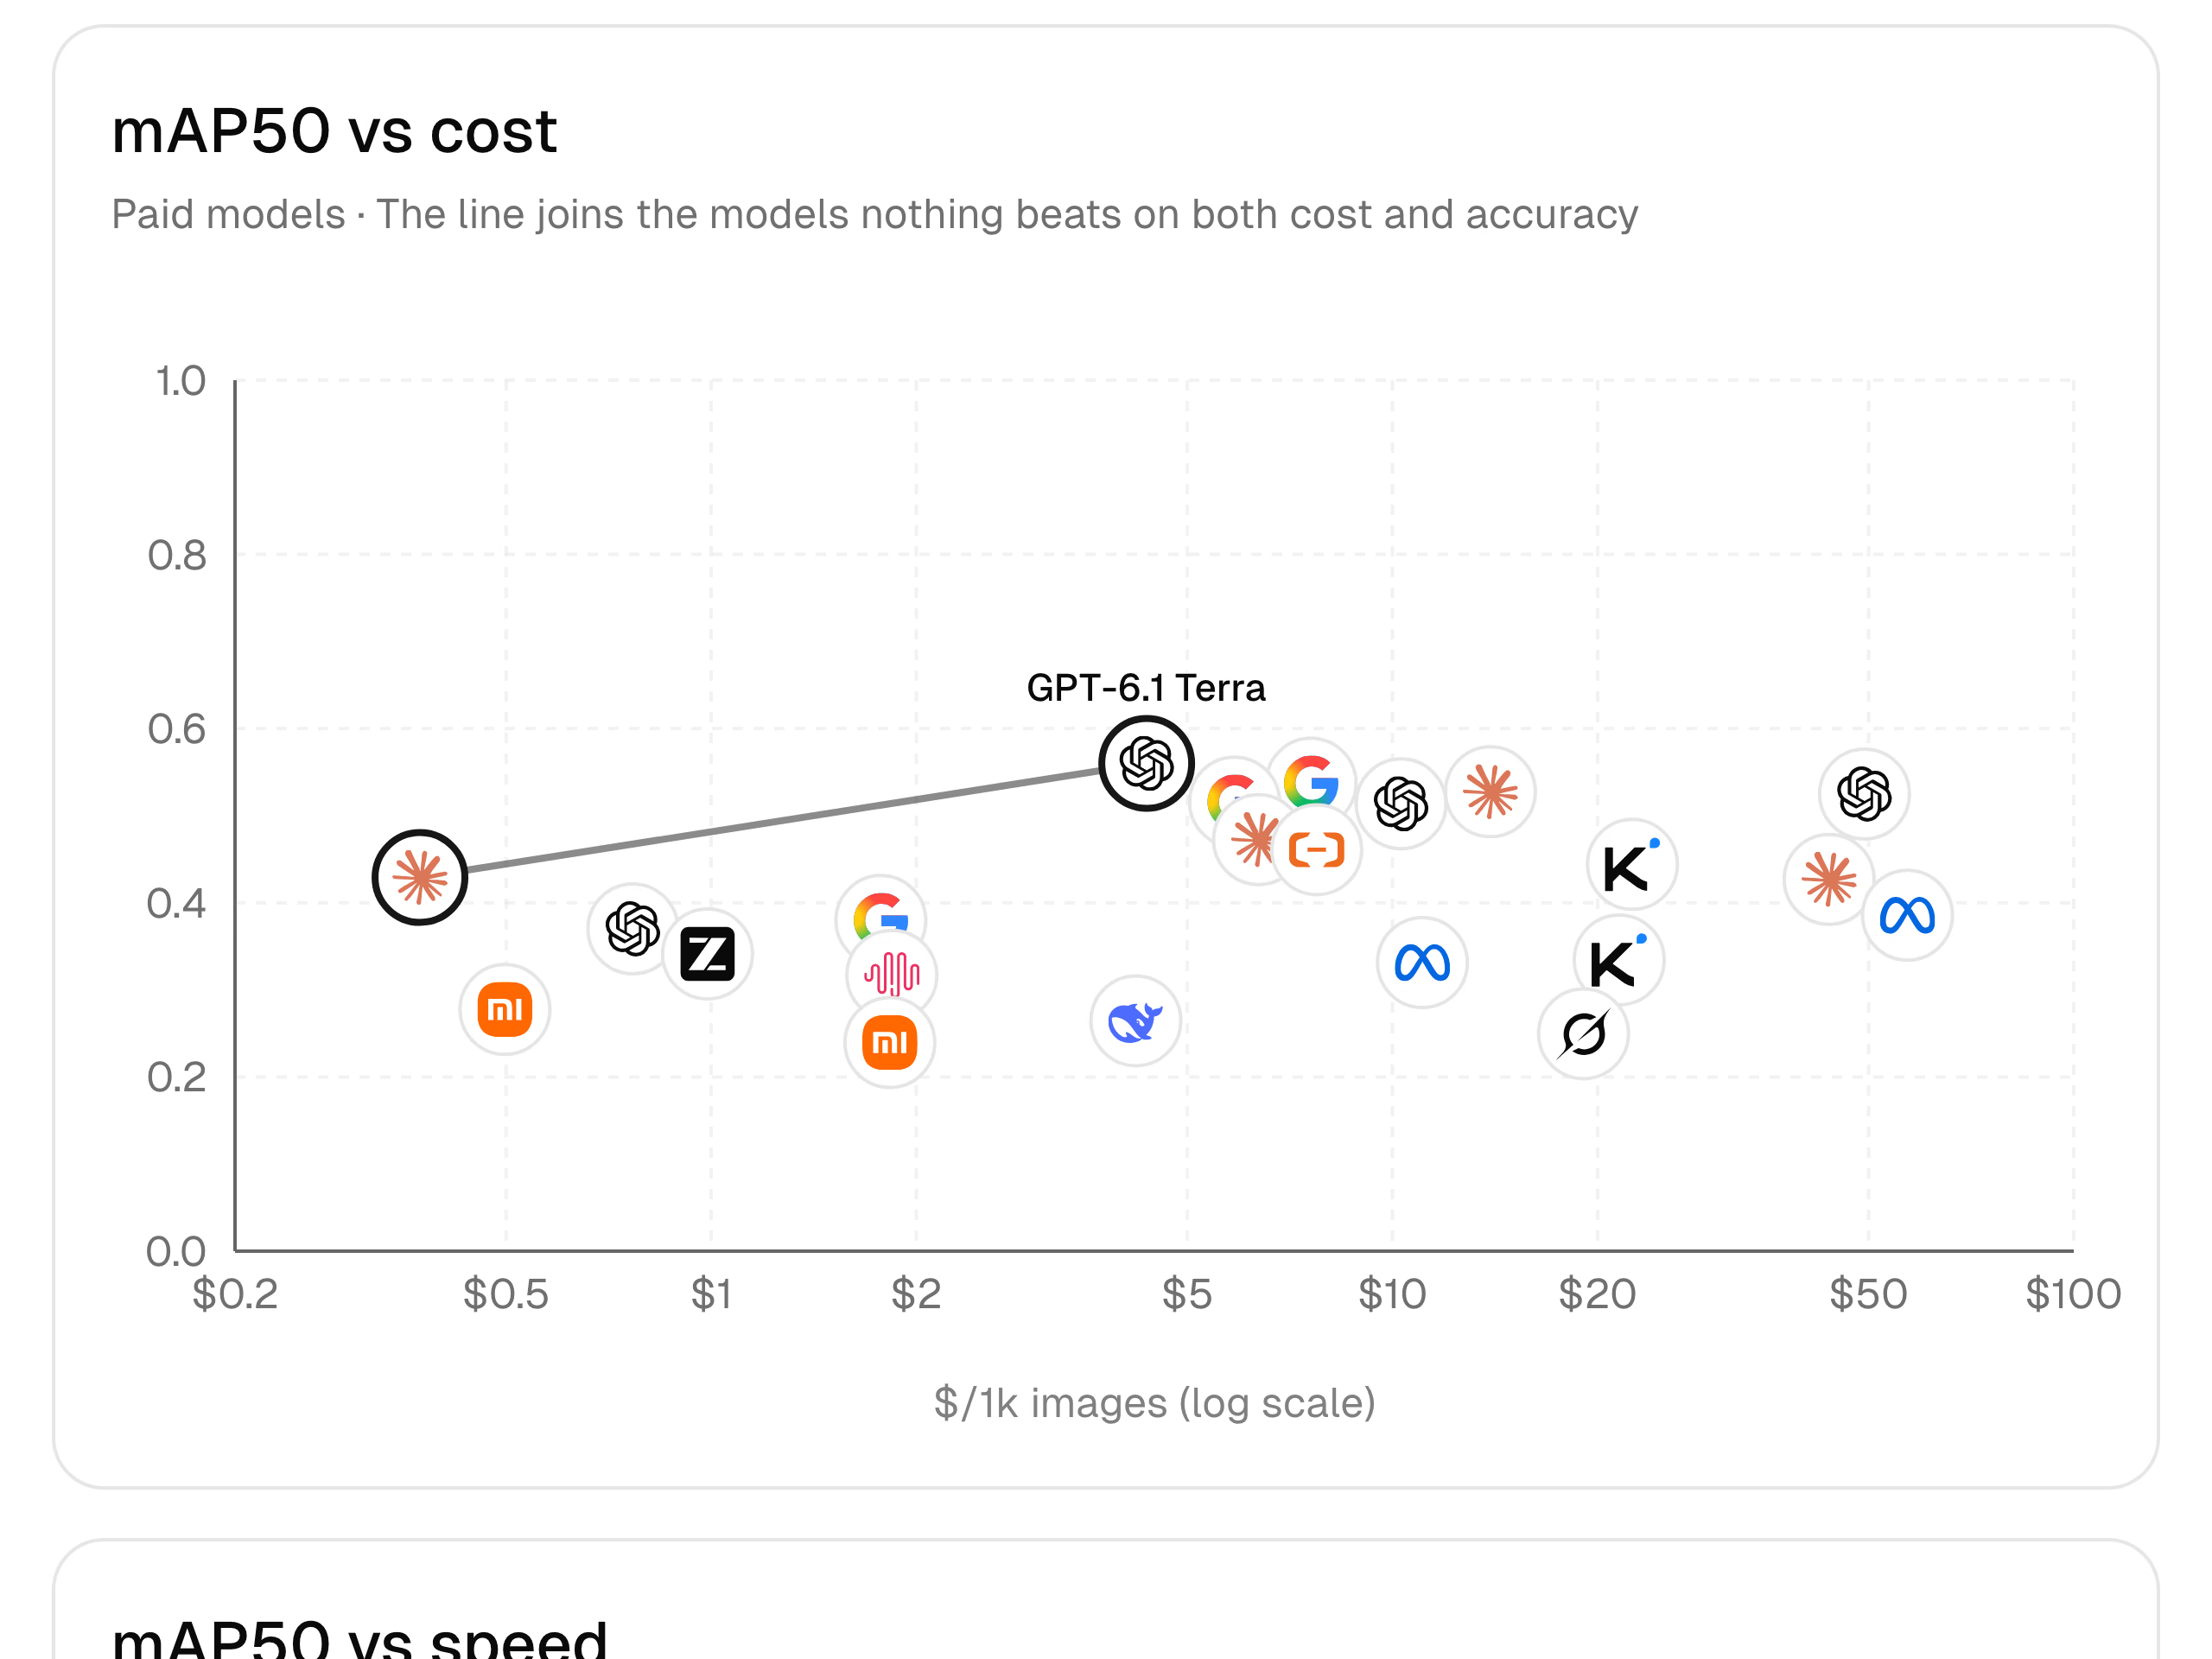
Voici les six modèles qui obtiennent un mAP50 supérieur à 0,51. Le coût est estimé à partir de l’utilisation de jetons déclarée par les fournisseurs pour 1 000 images du benchmark annotées avec succès, et la latence correspond au temps médian de requête :
| Modèle | mAP50 | mAP50-95 | Précision | Rappel | F1 | Coût fournisseur / 1 000 images (utilisation du benchmark) | Latence |
|---|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 0.560 | 0.345 | 0.65 | 0.61 | 0.63 | $4.36 | 5.1 s |
| Gemini 4 Argon | 0.537 | 0.343 | 0.67 | 0.59 | 0.62 | $7.60* | 4.6 s |
| Claude Opus 5.5 | 0.527 | 0.333 | 0.66 | 0.59 | 0.62 | $13.92 | 2.7 s |
| GPT-6 Astra | 0.525 | 0.325 | 0.56 | 0.63 | 0.59 | $49.31 | 11.6 s |
| Gemini 3.8 Flash | 0.516 | 0.321 | 0.66 | 0.56 | 0.60 | $5.86 | 7.4 s |
| GPT-6.1 Sol | 0.514 | 0.318 | 0.55 | 0.62 | 0.58 | $10.30 | 10.5 s |
*L’estimation de Gemini 4 Argon repose sur les tarifs de lancement de Google, en vigueur jusqu’au 30 novembre 2026. À partir du 1er décembre, le tarif standard de Google double pour atteindre environ 15 $ par 1 000 images, à utilisation identique. Batch Annotation sur Ultralytics Platform ajoute 1,00 $ par tranche de 1 000 images traitées, quel que soit le modèle, y compris les modèles hébergés.
Les six modèles se répartissent en deux groupes. Argon, Opus 5.5 et Gemini 3.8 Flash affichent une précision de 0,66 à 0,67 et un rappel inférieur à 0,60 : une forte proportion de leurs boîtes correspondent, mais elles couvrent moins d’objets annotés. Astra et Sol atteignent un rappel de 0,62 à 0,63, avec une précision de 0,55 à 0,56 : ils couvrent une plus grande proportion d’objets annotés, mais une moindre proportion de leurs boîtes correspondent. Terra se situe entre les deux groupes et arrive en tête pour le mAP50 et le F1.
Privilégie la précision lorsque les boîtes superflues sont coûteuses à corriger#
Avec 0,667, Gemini 4 Argon affiche la précision globale la plus élevée parmi les 40 modèles du benchmark. En contrepartie, son rappel moyen est de 0,585, en dessous des modèles les mieux classés pour le rappel.
La précision est particulièrement importante lorsque les boîtes non appariées sont difficiles à repérer. Sur une image chargée, un réviseur doit trouver une mauvaise boîte parmi de nombreuses bonnes avant de la corriger. Les rayons denses de SKU110K montrent à quel point la précision peut varier sur ce type d’image : dans nos résultats pour GPT-6.1 Terra, Terra affiche une précision de 0,79 et un rappel de 0,73, contre 0,49 et 0,77 pour GPT-6.1 Sol.
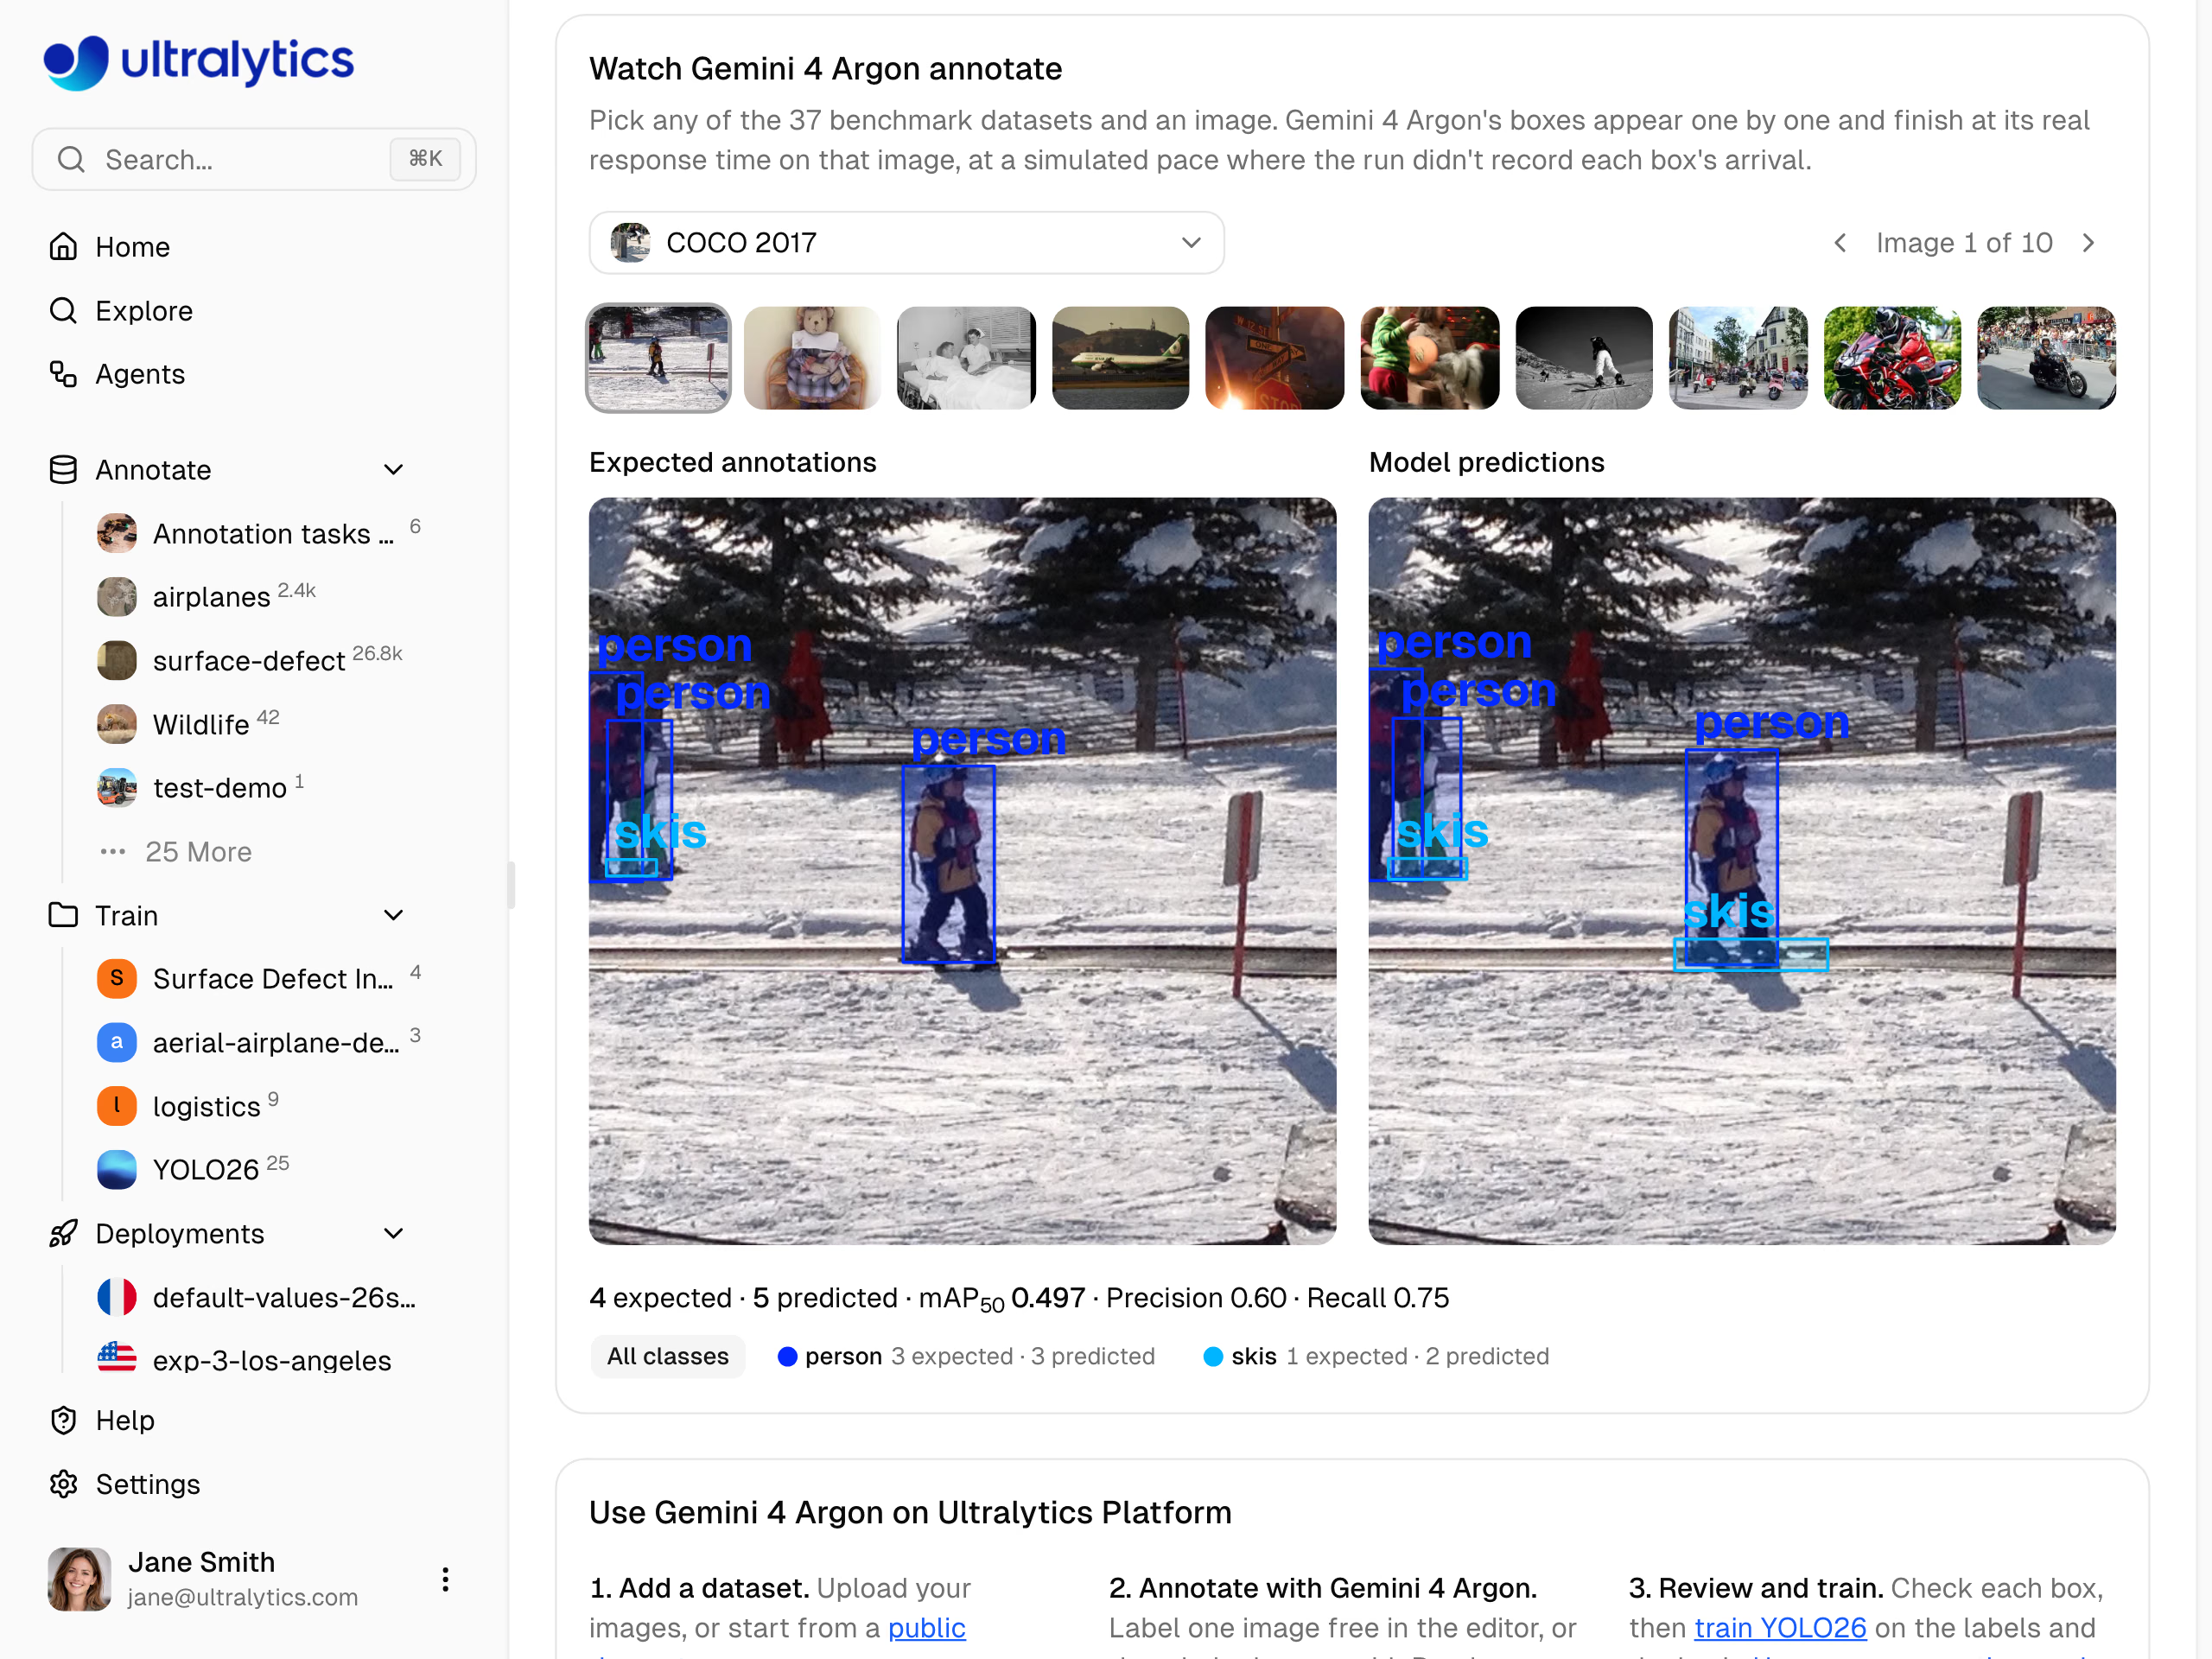
Gemini 4 Argon : 5 boîtes prédites pour 4 objets annotés, précision de 0,60, rappel de 0,75.
Argon n’a également enregistré aucune requête échouée lors du benchmark, et sa médiane de 4,6 secondes est la plus rapide des deux modèles en tête. Choisis-le lorsque tes données ressemblent aux domaines où il excelle — imagerie aérienne, sous-marine, thermique et radiographique de sécurité (il obtient le meilleur mAP50 sur les scans de sécurité IEDXray, avec 0,298) — et lorsque ton équipe préfère compléter quelques objets manquants plutôt que rechercher des boîtes superflues.
Privilégie le rappel lorsque l’omission d’un objet est une erreur coûteuse#
GPT-6 Astra affiche le rappel moyen le plus élevé du classement, à 0,627. Sa précision de 0,56 en est le prix à payer.
L’annotation axée sur le rappel est judicieuse lorsqu’un objet non annoté constitue l’erreur la plus coûteuse. Un défaut ou une lésion manquant dans ton jeu d’entraînement apprend au détecteur que l’objet appartient à l’arrière-plan, et trouver une boîte manquante oblige à examiner chaque image à la recherche d’un élément qui n’est pas annoté. Astra obtient le meilleur mAP50 sur 7 des 36 jeux de données, notamment les radiographies thoraciques TBX11K (0,330), les radiographies pédiatriques du poignet GRAZPEDWRI-DX (0,354) et les défauts de surface de circuits imprimés DsPCBSD+ (0,394) : une raison de le tester sur des données similaires, mais pas la preuve qu’il manquera moins d’objets sur les tiennes.
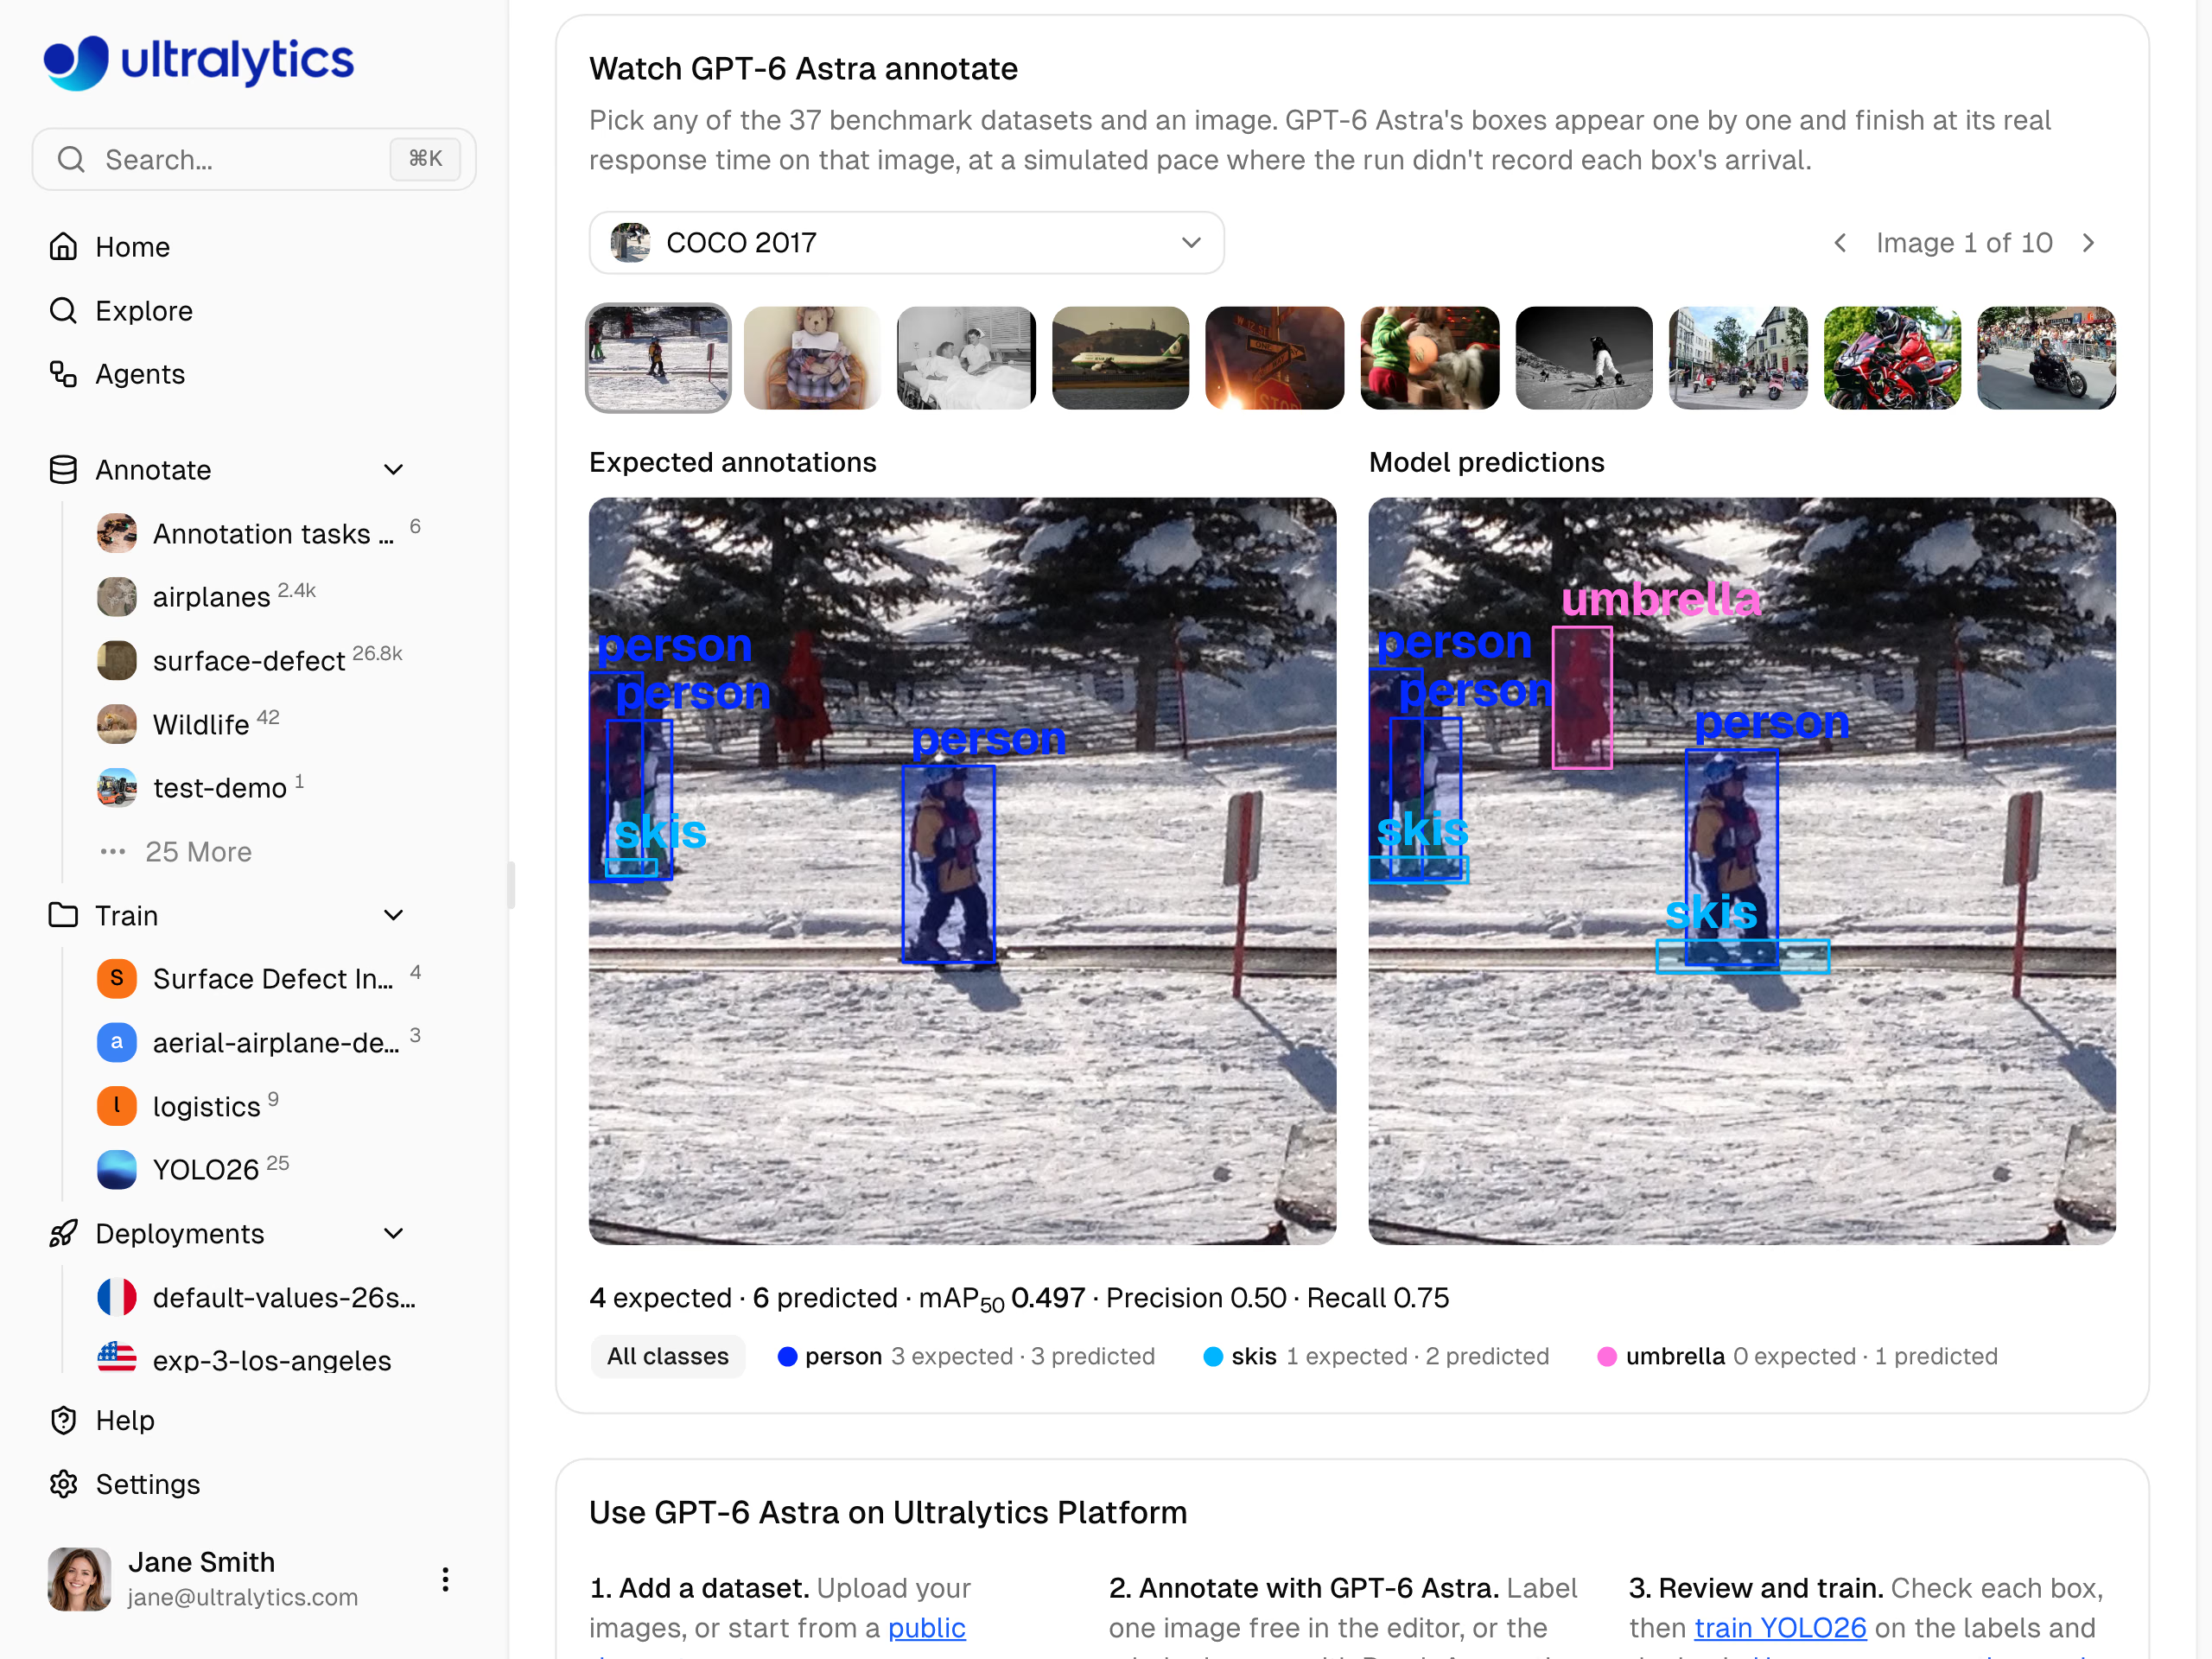
GPT-6 Astra : 6 boîtes pour les 4 mêmes objets, dont un parapluie absent des annotations COCO, précision de 0,50, rappel de 0,75.
Astra présente l’estimation de coût la plus élevée parmi les six meilleurs modèles : 49,31 $ par tranche de 1 000 images, avec un temps médian de 11,6 secondes et des requêtes en échec sur 1 % des images. Deux autres modèles OpenAI s’approchent de son rappel : GPT-6.1 Sol, à 0,62 pour un coût estimé de 10,30 $, et GPT-6.1 Terra, à 0,61 pour un coût estimé de 4,36 $.
Évalue les deux types d’erreurs avec le mAP50-95 et le F1#
GPT-6.1 Terra arrive en tête avec un mAP50 de 0,560 et un mAP50-95 de 0,345. Sa précision de 0,646 et son rappel de 0,613 sont tous deux à quelques centièmes des meilleurs résultats, et son F1 de 0,63 est le plus élevé des six, juste devant Argon et Opus 5.5, à 0,62. Le F1 étant si proche et ne disant rien du temps de révision, laisse les résultats par domaine et un test sur tes propres images départager les modèles.
Son avance en mAP50-95 apporte un second indicateur. Comme le mAP50-95 calcule la moyenne sur des seuils de recouvrement allant jusqu’à 0,95, il favorise les modèles dont les boîtes appariées s’ajustent étroitement, ainsi que ceux qui trouvent les bons objets. Terra arrive également en tête sur cette mesure. Il affiche aussi l’estimation de coût la plus basse parmi les six meilleurs modèles et n’a connu aucun échec de requête ; le classement le désigne comme « meilleur rapport qualité-prix ».
Annoter sans clé de fournisseur : modèles hébergés et détecteurs à vocabulaire ouvert#
Toutes les équipes ne souhaitent pas utiliser une clé de fournisseur payante. Les modèles hébergés sur Platform fonctionnent sans clé, et leurs résultats racontent une autre histoire :
- SAM 3.1 Text : mAP50 de 0,332, précision de 0,19, rappel de 0,47, 0,2 s par image. C’est le meilleur des 40 modèles sur VisDrone (mAP50 de 0,479) et sur les scènes de circulation de Fisheye8K (0,478).
- Qwen3.8 27B : mAP50 de 0,351, précision de 0,54, rappel de 0,40, 1,5 s.
- Gemma 4 26B : mAP50 de 0,344, précision de 0,53, rappel de 0,39, 0,9 s.
Les détecteurs à vocabulaire ouvert sont également hébergés. Dans ce benchmark, OWLv2 Large obtient un mAP50 de 0,133 et Grounding DINO Base, de 0,104, tous deux à 0,2 seconde par image, contre 0,332 pour SAM 3.1 Text. Ces scores évaluent le pipeline de Platform guidé par classe, avec l’affinage des boîtes par SAM 3.1, et non la configuration d’origine de chaque modèle.
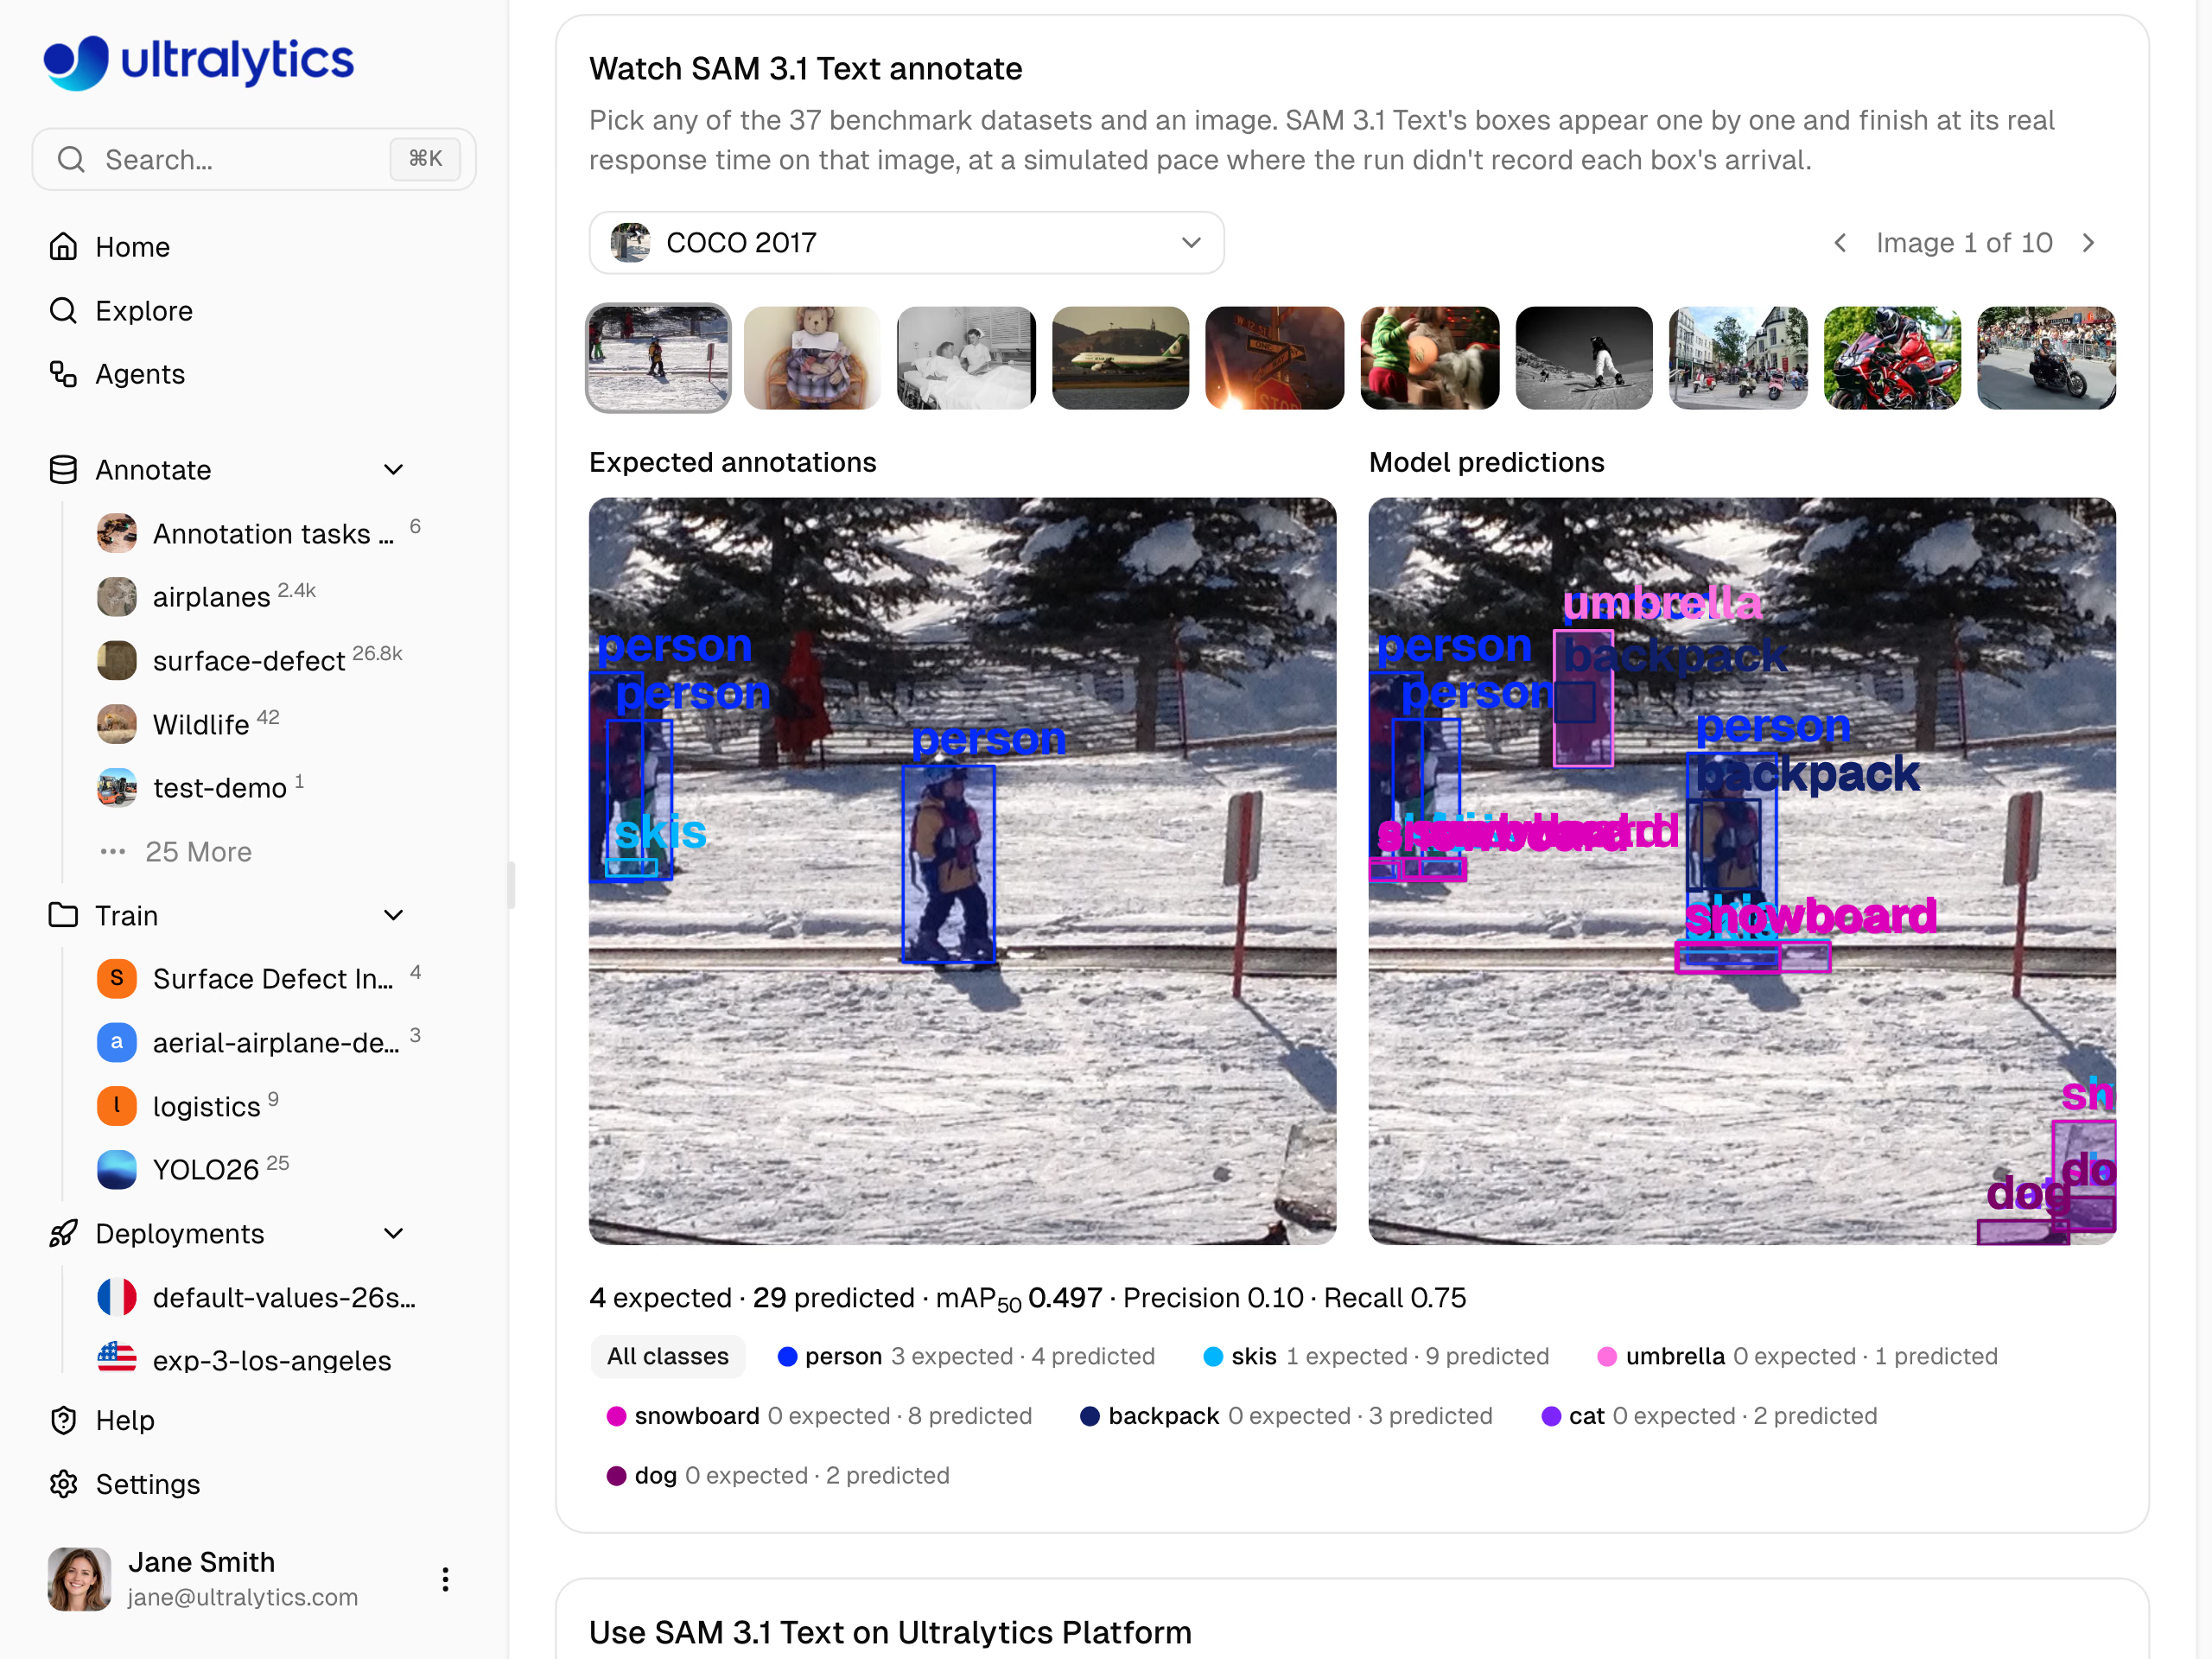
SAM 3.1 Text : 29 boîtes pour 4 objets, précision de 0,10, rappel de 0,75. Les trois relectures détectent 3 des 4 objets ; seule varie la quantité de boîtes supplémentaires que les réviseurs doivent supprimer.
SAM 3.1 Text convient aux scènes de circulation et aux scènes aériennes chargées, où les réviseurs s’attendent à élaguer une première version généreuse. Qwen3.8 27B et Gemma 4 26B se comportent comme les modèles prudents, mais avec une précision plus faible. Parmi les modèles payants peu coûteux, Claude Haiku 5.5 atteint un mAP50 de 0,429, avec une précision de 0,56 et un rappel de 0,47, pour un coût estimé à 0,37 $ par tranche de 1 000 images. C’est l’autre modèle que le classement désigne comme ayant le « meilleur rapport qualité-prix ».
Les moyennes globales masquent les différences entre domaines : consulte le tableau des jeux de données#
La précision et le rappel de chaque modèle sont calculés en moyenne sur 36 jeux de données, alors que tes données appartiennent à un seul domaine. Le tableau des jeux de données du classement des VLM répertorie la précision et le rappel moyens des 40 modèles pour chaque jeu de données, classés du plus difficile au plus facile, ainsi que le meilleur modèle pour chacun.
Consulte-le pour repérer les signaux d’alerte. Sur Airbus Oil Storage Detection, qui compte 2 267 réservoirs annotés sur ses 10 images, les modèles affichent en moyenne une précision de 0,39 et un rappel de 0,11 ; le meilleur mAP50 est celui de Gemini 4 Argon, à 0,347. Sur DeepPCB, la précision et le rappel moyens sont respectivement de 0,03 et 0,04, et GPT-6.1 Sol se distingue avec un mAP50 de 0,393.
Considère ces chiffres comme une liste restreinte, pas comme un verdict. La méthodologie indique que 10 images par jeu de données suffisent pour classer les modèles et les domaines, mais pas pour certifier le score d’un jeu de données donné ; les exécutions répétées font varier certains chiffres de quelques points. Chaque page de modèle sur Platform permet de revoir les boîtes enregistrées par le modèle à côté des annotations attendues sur les jeux de données du benchmark et sur COCO. Tu peux ainsi examiner le jeu de données le plus proche du tien avant de lancer une exécution.
Fais correspondre le modèle à ton processus de révision en cinq étapes#
Commence par définir ta priorité, puis confirme ton choix sur tes propres images :
| Ta priorité | Liste restreinte (résultats d’octobre 2026) |
|---|---|
| Privilégier la précision | Gemini 4 Argon |
| Privilégier le rappel | GPT-6 Astra ou GPT-6.1 Sol |
| Évaluer les deux | GPT-6.1 Terra |
| Pas de clé de fournisseur | Hébergés : Qwen3.8 27B ou SAM 3.1 Text |
L’annotation guidée par classe fonctionne sur les jeux de données de détection comprenant de 1 à 200 classes.
- Présélectionne des modèles dans le classement. Filtre le classement VLM pour la détection d’objets afin d’afficher les modèles payants ou hébergés (ignore ceux portant la mention « Non disponible sur la plateforme »), consulte la colonne correspondant à ta priorité et vérifie le tableau des jeux de données pour ton domaine.
- Ajoute une clé de fournisseur. Pour un modèle payant, enregistre ta clé dans Paramètres > Clés API, dans l’espace de travail qui héberge le jeu de données. Le fournisseur facture directement l’utilisation de ta clé ; la documentation sur les clés de fournisseur explique la configuration.
- Teste sur un échantillon vérifié. Choisis quelques images représentatives de tes données que tu as annotées à la main. Ouvre l’éditeur d’annotations, passe en mode Smart, sélectionne le modèle sous son fournisseur dans le sélecteur de modèles, puis clique sur Prédire (
P). Compte les boîtes que tu supprimes, celles que tu ajoutes et les minutes consacrées à la révision. - Annote le jeu de données. Sur la page du jeu de données, sélectionne Plus d’actions > Batch Annotation, disponible pour les jeux de données hébergés sur Platform comptant jusqu’à trois canaux d’image. L’outil annote par défaut les images non annotées, ne modifie jamais les annotations existantes et enregistre d’abord une version du jeu de données afin que tu puisses revenir en arrière. Vérifie le coût estimé dans la boîte de dialogue avant de commencer : Batch Annotation coûte 1,00 $ par tranche de 1 000 images traitées, auxquels s’ajoutent les frais éventuels du fournisseur.
- Révise, puis entraîne. Vérifie les boîtes en tenant compte du point faible de ton modèle, enregistre-les et entraîne un modèle Ultralytics YOLO sur le résultat, dans le même espace de travail.
Pour en savoir plus, découvre comment Ultralytics Platform utilise l’IA pour automatiser l’annotation et pourquoi la révision avec intervention humaine reste indispensable. Pour comparer l’étiquetage automatique et l’apprentissage actif dans différents outils, lis notre comparatif de l’étiquetage automatique et de l’apprentissage actif.
Liste restreinte par équipe (résultats d’octobre 2026)#
- Réviseurs qui préfèrent compléter une première version plutôt que la nettoyer : Gemini 4 Argon, le modèle le plus précis dans l’ensemble, particulièrement performant sur les images aériennes, sous-marines, thermiques et les radiographies de sécurité.
- Objets rares dont l’omission nuit aux données d’entraînement : GPT-6 Astra pour maximiser le rappel, ou GPT-6.1 Sol, qui s’en approche.
- Étiquetage généraliste sans préférence marquée : GPT-6.1 Terra, en tête pour le mAP50, le mAP50-95 et le F1.
- Équipes sans clé de fournisseur : SAM 3.1 Text pour des premières passes privilégiant le rappel sur des scènes chargées, ou Qwen3.8 27B pour une première version plus prudente.
Quel que soit ton choix, le classement te permet d’anticiper la révision avant de commencer. Pour comprendre la théorie derrière ces métriques, notre guide sur l’exactitude, la précision et le rappel présente les bases, et la leçon de l’Academy sur l’interprétation des métriques de détection va plus loin.
Foire aux questions
Privilégie la précision lorsque supprimer les mauvaises boîtes est la correction la plus longue, par exemple sur les images chargées où une boîte superflue se cache parmi les bonnes. Privilégie le rappel lorsqu’un objet manquant coûte plus cher, comme pour les défauts ou les lésions rares, car un objet non annoté apprend au détecteur qu’il appartient à l’arrière-plan. Confirme ensuite ton choix sur un échantillon de tes propres images révisées à la main.
Les modèles guidés par classe renvoient des boîtes sans score de confiance et utilisent des seuils propres à chaque modèle. Platform masque donc les paramètres de confiance et d’IoU lorsqu’un tel modèle est sélectionné. La précision et le rappel du classement comptabilisent donc toutes les boîtes renvoyées par le modèle à un IoU de 0,5. Pour modifier l’équilibre entre les boîtes non appariées et les objets non appariés, choisis un autre modèle.
Utilise le mAP50 pour vérifier si un modèle trouve et étiquette les bons objets, et le mAP50-95 pour ajouter des seuils de recouvrement plus stricts, qui favorisent les boîtes ajustées avec précision. Les deux mesures reflètent aussi les omissions et les faux positifs : interprète-les donc avec la précision et le rappel. Dans les résultats d’octobre 2026, GPT-6.1 Terra arrive en tête des deux classements, avec 0,560 et 0,345.
Oui. Le meilleur modèle sur UL37 v2 obtient en moyenne un mAP50 de 0,560 (octobre 2026), et sur les jeux de données les plus difficiles, comme ceux sur les défauts de circuits imprimés et les radiographies thoraciques, la moyenne des 40 modèles est inférieure à 0,05. Révise chaque image et porte une attention particulière au point faible du modèle : les boîtes supplémentaires si le modèle privilégie le rappel, les objets manquants s’il privilégie la précision.
Le coût comporte deux parties. Batch Annotation sur Ultralytics Platform coûte 1,00 $ par tranche de 1 000 images traitées (minimum de 0,01 $), quel que soit le modèle, y compris les modèles hébergés ; les prédictions individuelles avec un modèle hébergé dans l’éditeur sont gratuites. Les modèles payants sont également facturés par le fournisseur sur ta propre clé API. Dans le benchmark d’octobre 2026, les estimations des fournisseurs pour les modèles de ce guide vont de 0,37 $ par tranche de 1 000 images (Claude Haiku 5.5) à 49,31 $ (GPT-6 Astra). Si tu arrêtes une exécution, les images déjà traitées te sont facturées.
Oui. Les modèles hébergés comme SAM 3.1 Text, Qwen3.8 27B et Gemma 4 26B fonctionnent sur Ultralytics Platform sans clé de fournisseur, tout comme tes propres modèles YOLO. Les traitements par lot coûtent toujours 1,00 $ par tranche de 1 000 images traitées, et la boîte de dialogue affiche l’estimation avant chaque exécution.
Cela dépend de la tâche. Un VLM guidé par classe peut générer une première version des étiquettes de nouvelles classes à partir de leur nom uniquement, mais les six modèles ayant obtenu les meilleurs scores dans le benchmark d’octobre 2026 ont mis de 2,7 à 11,6 secondes par image et sont facturés au jeton. Pour la détection en temps réel, une approche courante consiste à annoter automatiquement avec un VLM, à réviser les étiquettes, puis à entraîner un modèle Ultralytics YOLO sur ces dernières. Un modèle YOLO que tu as déjà entraîné peut également annoter automatiquement de nouvelles images dans le même éditeur.
Écrit par
Ingénieur logiciel principal · Ultralytics
Commentaires2
Pose une question, partage tes résultats ou aide quelqu’un.
 Glenn JocherUltralytics
Great job Wax on your first blog!
 Sergiu WaxmannUltralytics
Appreciate it! More coming soon.









