Ultralytics YOLO y NVIDIA Cosmos Data Factory: datos sintéticos para detectar defectos
Los datos sintéticos de NVIDIA Cosmos Data Factory y un ciclo automatizado de entrenamiento agéntico mejorado con datos, impulsado por NVIDIA, ayudan a Ultralytics YOLO a igualar la precisión obtenida con el conjunto de datos completo usando solo una fracción de las etiquetas.
Ultralytics y NVIDIA se han asociado para demostrar lo que pueden conseguir los datos de entrenamiento seleccionados de forma específica con Ultralytics YOLO. El ciclo de entrenamiento agéntico mejorado con datos de NVIDIA identifica las imágenes que necesita un modelo; NVIDIA Cosmos Data Factory genera las que aún no existen, y Ultralytics YOLO es el modelo que se entrena con el resultado. Nuestro equipo de aprendizaje automático (ML) probó esta combinación en 19 pruebas de referencia públicas de inspección industrial, comparando Ultralytics YOLO26, entrenado con la canalización agéntica de NVIDIA y datos sintéticos de Cosmos Data Factory, con el mismo modelo entrenado de la forma convencional. En esta publicación compartimos los resultados.
Más datos no son la solución. Los datos adecuados sí.#
Todos los equipos de inspección conocen este patrón. Un modelo de detección de defectos funciona bien con los defectos que ha visto muchas veces, pero luego no detecta el arañazo poco frecuente, la iluminación inusual o el ángulo de cámara extraño que más importa en la línea de producción. La solución habitual es recopilar y etiquetar más de todo, algo lento y caro que, en su mayor parte, solo añade imágenes que el modelo ya procesa bien.
El entrenamiento agéntico automatizado impulsado por NVIDIA adopta un enfoque distinto: encuentra los puntos débiles concretos de un conjunto de datos y los corrige con imágenes reales que ya existen o, cuando no hay ejemplos reales, con imágenes sintéticas de Cosmos Data Factory. Junto con Ultralytics YOLO, esto permite entrenar un modelo justo con los datos que le faltan.
¿Cómo funciona el ciclo de entrenamiento de NVIDIA mejorado con datos?#
El ciclo de entrenamiento agéntico de NVIDIA mejorado con datos para Ultralytics YOLO es una canalización de mejora del modelo que envuelve el ciclo de entrenamiento y decide qué datos necesita el modelo a continuación:
• Busca datos reales. Examina los conjuntos de imágenes existentes para encontrar ejemplos reales que cubran carencias concretas del conjunto de entrenamiento.
• Genera datos sintéticos. Cuando no existen ejemplos reales, genera imágenes de casos límite con Cosmos Data Factory.
• Etiqueta automáticamente. Un componente llamado AnomalyGen etiqueta las imágenes sintéticas, por lo que no hace falta anotarlas manualmente antes de volver a entrenar.
La idea central es priorizar los datos específicos frente a la eficiencia en el uso de los datos. El objetivo no es simplemente entrenar con menos datos, sino cubrir con precisión las carencias de un conjunto de datos en los puntos débiles del modelo, ya sea buscando o generando datos, y volver a entrenarlo con ese conjunto enriquecido. Entrenar con menos imágenes suele ser un efecto secundario de hacerlo bien, como muestran los resultados a continuación.
La canalización se ha evaluado en profundidad con Ultralytics YOLO, y todos los resultados de este artículo utilizan Ultralytics YOLO26.
El papel de NVIDIA Cosmos Data Factory#
Cosmos Data Factory es la plataforma de NVIDIA para seleccionar, procesar y generar datos, basada en sus modelos del mundo Cosmos. Dentro del ciclo de entrenamiento agéntico, su función es generar imágenes de escenarios que un conjunto de datos real no cubre bien, como tipos concretos de defectos de fabricación o la distorsión de ojo de pez en grabaciones de transporte.
El traspaso es sencillo. Cosmos genera las imágenes de casos límite, AnomalyGen las etiqueta y Ultralytics YOLO vuelve a entrenarse con el conjunto combinado de datos reales y sintéticos mediante la canalización de entrenamiento estándar de Ultralytics.
Prueba de NVIDIA Cosmos Data Factory con 19 conjuntos de datos públicos#
Para ver hasta dónde pueden llegar Cosmos Data Factory + Ultralytics YOLO, nuestro equipo de ML ejecutó la canalización de ajuste fino agéntico mejorado con datos en 19 conjuntos de datos públicos de inspección industrial, que abarcan acero, PCB, tejidos, superficies metálicas y productos de consumo, con un total aproximado de 91 000 imágenes de entrenamiento. Todas las ejecuciones utilizaron un único equipo con 8 GPU.
La comparación es deliberadamente rigurosa. El modelo de referencia y el modelo de Cosmos Data Factory se entrenaron con una configuración idéntica: Ultralytics YOLO26x, 100 épocas, el mismo optimizador, tasa de aprendizaje y semilla, y ambos se evaluaron con el mismo conjunto de prueba reservado. La única diferencia son las imágenes con las que se entrenó cada modelo. El modelo de referencia se entrena con todas las imágenes etiquetadas (y, en la prueba con datos sintéticos, solo con imágenes reales).
1. La misma precisión con una fracción de las etiquetas#
En 11 de los 19 conjuntos de datos, Ultralytics YOLO26x entrenado con la canalización agéntica igualó al mismo modelo entrenado con el conjunto de datos completo. En esos 11 conjuntos, no hizo falta usar el 53 % de las imágenes etiquetadas.
| conjunto de datos | etiquetadas | utilizadas | no necesarias | mAP@0.5 completo | mAP@0.5 seleccionado |
|---|---|---|---|---|---|
| clase DAGM 1 | 1,035 | 90 | 91% | 0.9923 | 0.9998 |
| clase DAGM 2 | 1,035 | 90 | 91% | 1.0000 | 0.9999 |
| clase DAGM 3 | 1,035 | 90 | 91% | 1.0000 | 0.9987 |
| clase DAGM 4 | 1,035 | 90 | 91% | 1.0000 | 0.9991 |
| clase DAGM 7 | 2,070 | 180 | 91% | 1.0000 | 0.9995 |
| clase DAGM 8 | 2,070 | 178 | 91% | 0.9991 | 1.0000 |
| clase DAGM 9 | 2,070 | 180 | 91% | 1.0000 | 0.9992 |
| clase DAGM 10 | 2,070 | 180 | 91% | 1.0000 | 1.0000 |
| pcb-defect | 20,924 | 13,903 | 34% | 0.9900 | 0.9893 |
| hripcb | 559 | 414 | 26% | 0.9891 | 0.9754 |
| deeppcb | 1,000 | 900 | 10% | 0.9887 | 0.9885 |
Tabla 1. Conjuntos de datos en los que Cosmos Data Factory igualó al modelo entrenado con todos los datos. mAP@0.5 en el mismo conjunto reservado.
En los conjuntos de datos DAGM, la canalización agéntica alcanzó el mismo mAP@0.5 con una décima parte de las etiquetas, y en dos clases superó ligeramente al modelo entrenado con todos los datos. En pcb-defect, descartó 7000 de las 20 924 imágenes con una diferencia de precisión cuatro veces menor que la variación entre ejecuciones.
Para los equipos que pagan por el etiquetado, esta es la conclusión principal: en estos conjuntos de datos, la mayor parte del presupuesto de etiquetado se destinó a imágenes que no cambiaron el resultado.
2. Hasta un 74 % más rápido el entrenamiento#
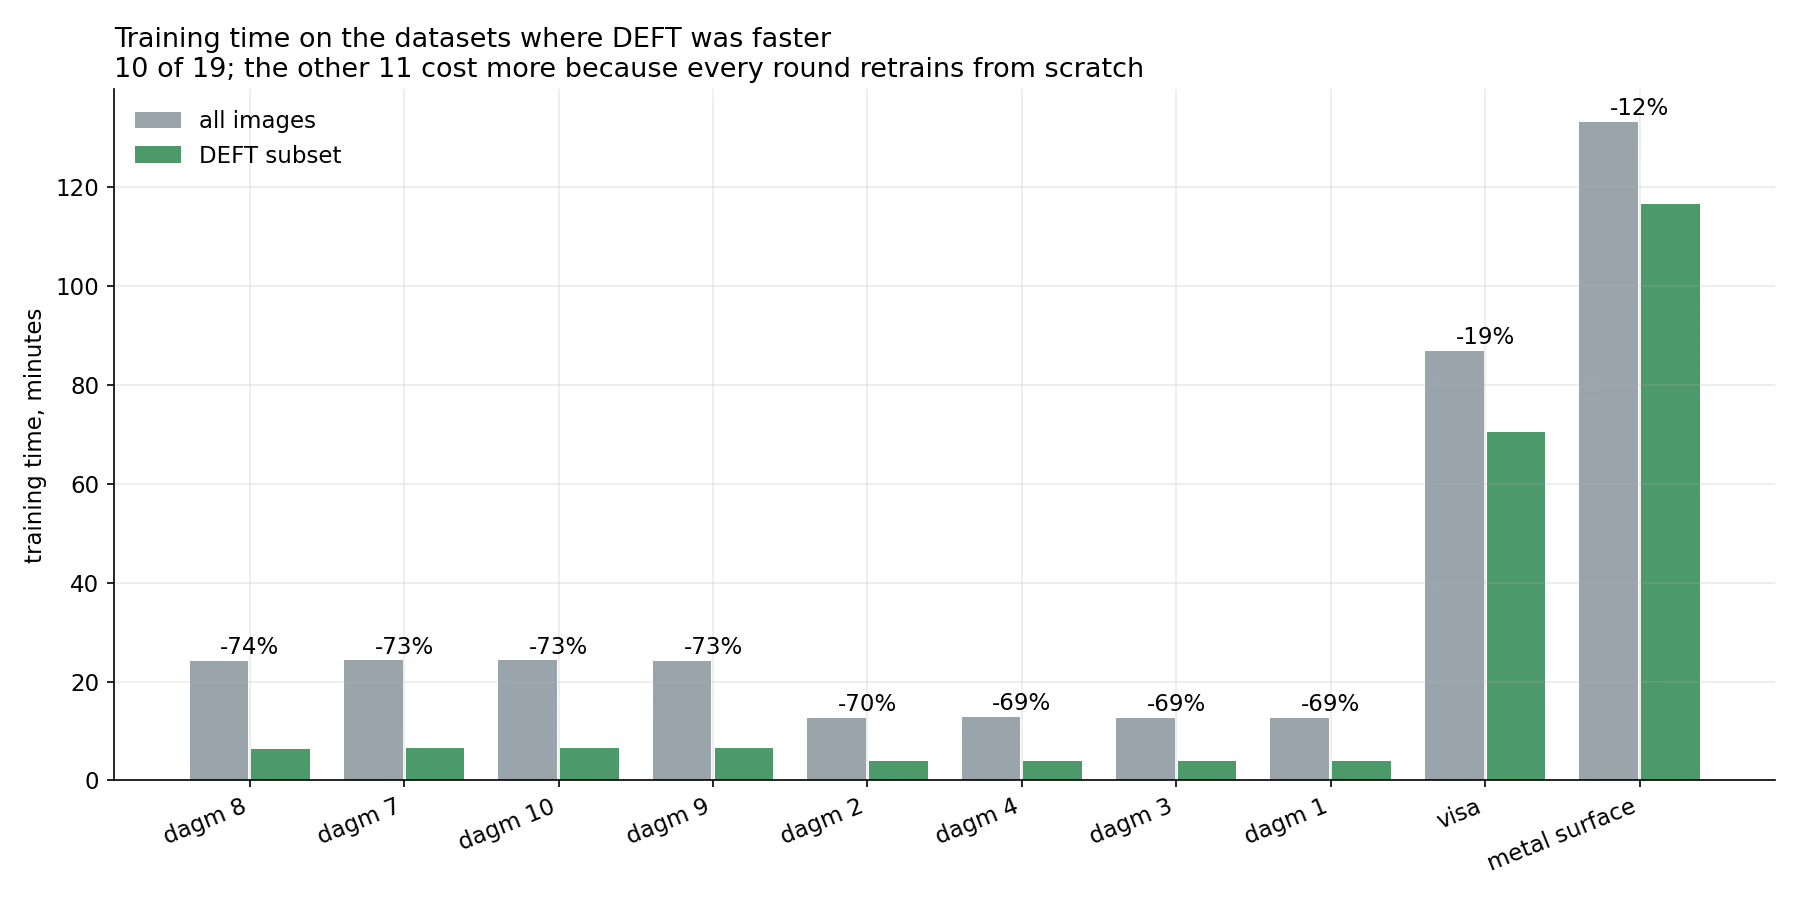
Figura 1. Tiempo de entrenamiento con el conjunto de datos completo frente al subconjunto de Cosmos Data Factory, en los conjuntos de datos en los que Cosmos Data Factory fue más rápido.
Entrenar Ultralytics YOLO con un conjunto más pequeño y específico también reduce el coste de computación. En 10 de los 19 conjuntos de datos, el entrenamiento fue más rápido con la canalización agéntica. En DAGM, el tiempo de entrenamiento bajó de 13–24 minutos a 4–7 minutos, una reducción del 69–74 %. Los conjuntos de datos más grandes también registraron ahorros menores, pero reales: un 19 % en VisA y un 12 % en metal-surface-defect.
El ahorro no es universal. En los nueve conjuntos de datos restantes, la canalización agéntica tardó más que una única ejecución con todos los datos, porque cada ronda de selección vuelve a entrenar el modelo desde cero. Cuando el subconjunto seleccionado no es mucho más pequeño que el original, las rondas adicionales superan el ahorro.
3. Los defectos generados afinan las cajas#
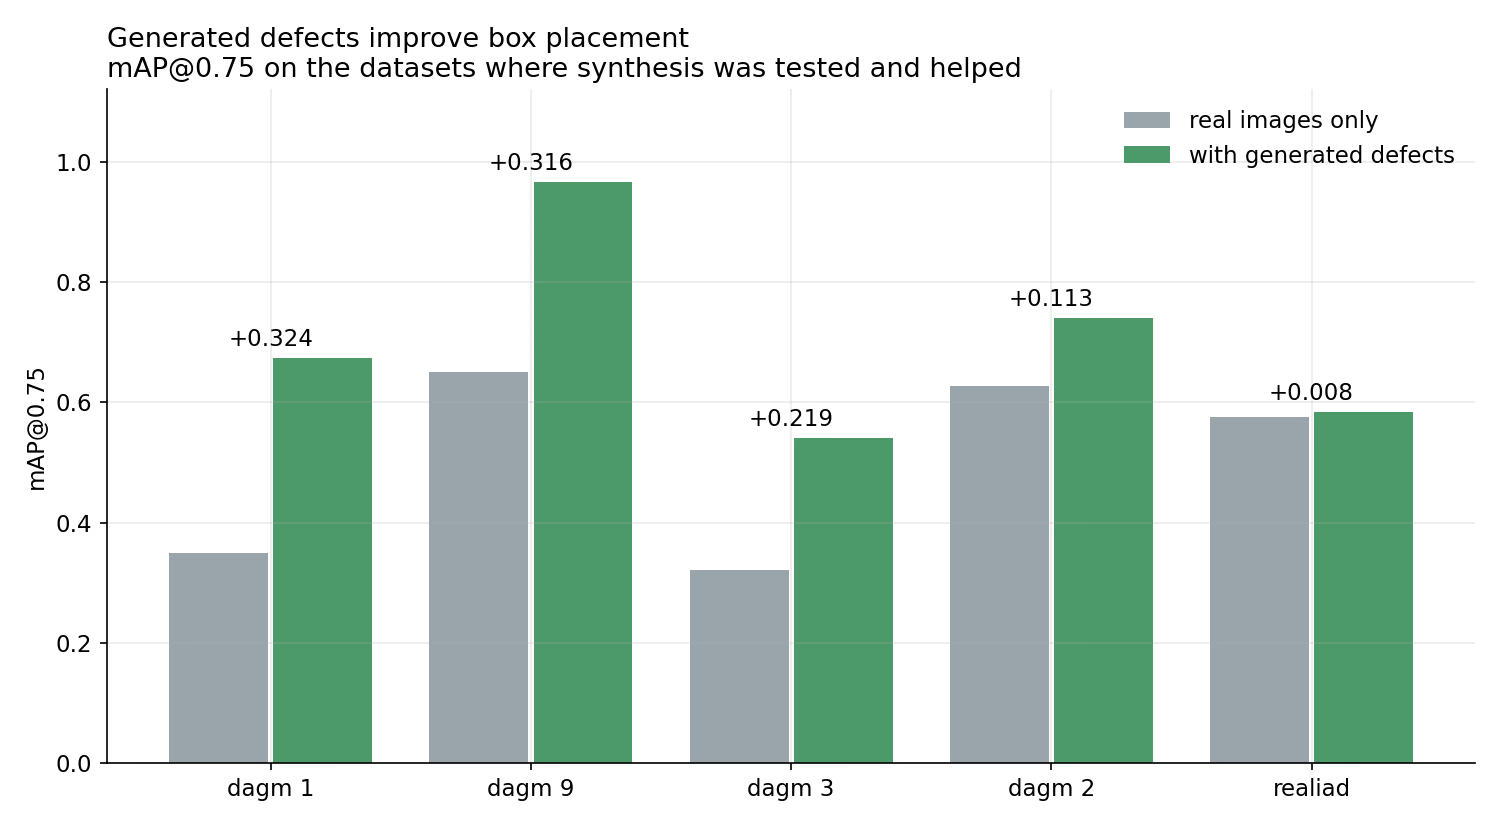
Figura 2. mAP@0.75 con imágenes reales únicamente frente a imágenes con defectos generados, en los conjuntos de datos en los que se probó la generación y esta resultó útil.
La tercera prueba se centra exclusivamente en los datos sintéticos. En los conjuntos de datos con anotaciones poligonales, añadimos defectos generados con Cosmos Data Factory, etiquetados por AnomalyGen, y comparamos el modelo resultante de Ultralytics YOLO con otro entrenado únicamente con imágenes reales.
Presentamos mAP@0.75, una métrica más estricta que mAP@0.5: una predicción solo cuenta si su caja se solapa al menos un 75 % con el defecto real. Mide con qué precisión localiza el modelo un defecto, no solo si lo detecta. Añadir defectos generados aumentó el mAP@0.75 entre 0.11 y 0.32 en las clases DAGM, y la recuperación mejoró en todos los conjuntos de datos probados. El mayor aumento se dio en la clase DAGM 9, de 0.650 a 0.966. En Real-IAD, la mejora fue marginal (+0.008).
Los defectos son poco frecuentes por naturaleza, por lo que siempre escasean los ejemplos reales de un tipo concreto de defecto. Generarlos ya etiquetados permite que Ultralytics YOLO aprenda la forma y la extensión exactas de un defecto sin que nadie tenga que dibujar un polígono.
Cantidad de datos sintéticos utilizados#
Cada generación consta de tres pasos. Cosmos Data Factory primero encuentra ubicaciones plausibles para los defectos en las imágenes reales (ubicados); el generador dibuja imágenes con defectos en esas ubicaciones (generados), y solo se admite en el conjunto de entrenamiento una cantidad que no supere el límite establecido (conservados). Probamos dos límites: imágenes sintéticas equivalentes al 25 % o al 100 % de las imágenes reales del conjunto de entrenamiento.
En 18 rondas de generación (9 de referencia y 9 sintéticas), la canalización generó 11 448 imágenes. Solo se conservaron 1481, aproximadamente una de cada ocho, por lo que el límite determinó cuántos datos sintéticos vio cada modelo de Ultralytics YOLO, no la cantidad generada. Con el límite del 100 %, cada conjunto de entrenamiento contenía una imagen sintética por cada imagen real; con el 25 %, aproximadamente una por cada cuatro imágenes reales. En términos absolutos, las cantidades son pequeñas: en DAGM, entre 90 y 180 imágenes reales y, como máximo, el mismo número de imágenes sintéticas.
| conjunto de datos | límite | ubicados | generados | bloqueados | conservados | reales | proporción |
|---|---|---|---|---|---|---|---|
| clase DAGM 1 | 25% | 870 | 440 | 0 | 22 | 90 | 1 : 0.24 |
| clase DAGM 1 | 100% | 870 | 400 | 0 | 90 | 90 | 1 : 1.00 |
| clase DAGM 2 | 25% | 606 | 254 | 0 | 22 | 90 | 1 : 0.24 |
| clase DAGM 2 | 100% | 606 | 304 | 0 | 90 | 90 | 1 : 1.00 |
| clase DAGM 3 | 25% | 900 | 370 | 0 | 22 | 90 | 1 : 0.24 |
| clase DAGM 3 | 100% | 900 | 370 | 0 | 90 | 90 | 1 : 1.00 |
| clase DAGM 9 | 100% | 1,800 | 620 | 0 | 180 | 180 | 1 : 1.00 |
| realiad | 25% | 9,534 | 4,440 | 0 | 193 | 772 | 1 : 0.25 |
| realiad | 100% | 9,534 | 4,250 | 0 | 772 | 772 | 1 : 1.00 |
| Total | 11,448 | 0 | 1,481 |
Tabla 2. Imágenes generadas y proporción de imágenes reales respecto a las sintéticas, según los registros de generación e incorporación de cada ejecución.
Qué significa esto para los equipos que desarrollan modelos de inspección#
Para los equipos que ya entrenan Ultralytics YOLO, Cosmos Data Factory y el entrenamiento agéntico automatizado impulsado por NVIDIA se integran en el flujo de trabajo que ya conocen: los mismos modelos y la misma configuración de entrenamiento, pero con datos de entrada más adecuados.
• Cubre los casos límite que no puedes recopilar. Los defectos sintéticos etiquetados automáticamente ayudan a Ultralytics YOLO a localizar defectos cuando escasean los ejemplos reales.
• Invierte el presupuesto de etiquetado donde más importa. En más de la mitad de los conjuntos de datos probados, la mayoría de las etiquetas eran redundantes. La selección específica encuentra las imágenes que importan.
• Itera más rápido. Los conjuntos de entrenamiento más pequeños y seleccionados permiten reducir la duración de los entrenamientos de Ultralytics YOLO y acelerar los experimentos en muchos conjuntos de datos.
Disponibilidad#
El paso de generación sintética basado en Cosmos está disponible actualmente como ejemplo y demostración, pero todavía no se ha publicado como integración.
Para probar Cosmos Data Factory con tus propios modelos de Ultralytics YOLO, ponte en contacto con los equipos de Ultralytics. Seguiremos trabajando con NVIDIA a medida que el paso de generación sintética avance hacia una integración completa.
Apéndice: configuración de las pruebas y conjuntos de datos#
Todas las ejecuciones: Ultralytics YOLO26x, 100 épocas, optimizador, tasa de aprendizaje y semilla idénticos para el modelo de referencia y Cosmos Data Factory; un equipo con 8 GPU; el mismo conjunto de prueba reservado para cada conjunto de datos. Los 11 conjuntos de datos con anotaciones poligonales permiten generar defectos.
| conjunto de datos | imágenes de entrenamiento | anotación | origen |
|---|---|---|---|
| clase DAGM 1, 2, 3, 4 | 1035 cada una | polígono | DAGM 2007 |
| clase DAGM 7, 8, 9, 10 | 2070 cada una | polígono | DAGM 2007 |
| pcb-defect | 20,924 | caja | PCB defect |
| dspcbsd | 6,575 | caja | DsPCBSD+ |
| deeppcb | 1,000 | caja | DeepPCB |
| hripcb | 559 | caja | HRIPCB |
| metal-surface-defect | 11,845 | caja | defecto en superficie NEU |
| tianchifabric | 10,332 | caja | tejido Tianchi |
| severstal | 10,061 | polígono | acero Severstal |
| mvtec-ad | 4,637 | caja | MVTec AD |
| visa | 7,794 | polígono | VisA |
| realiad-bottle-cap | 3,581 | polígono | Real-IAD |
| grieta | 1,290 | caja | segmentación de grietas |
Tabla 3. Los 19 conjuntos de datos (DAGM cuenta como ocho, uno por clase).









