Cómo elegir un VLM para el autoetiquetado según la precisión y la exhaustividad
Elige un VLM para el autoetiquetado según la precisión y la exhaustividad: qué modelos generan menos cajas sobrantes, cuáles omiten menos objetos y cómo probarlos con tus propios datos.
 Sergiu Waxmann17 min de lectura
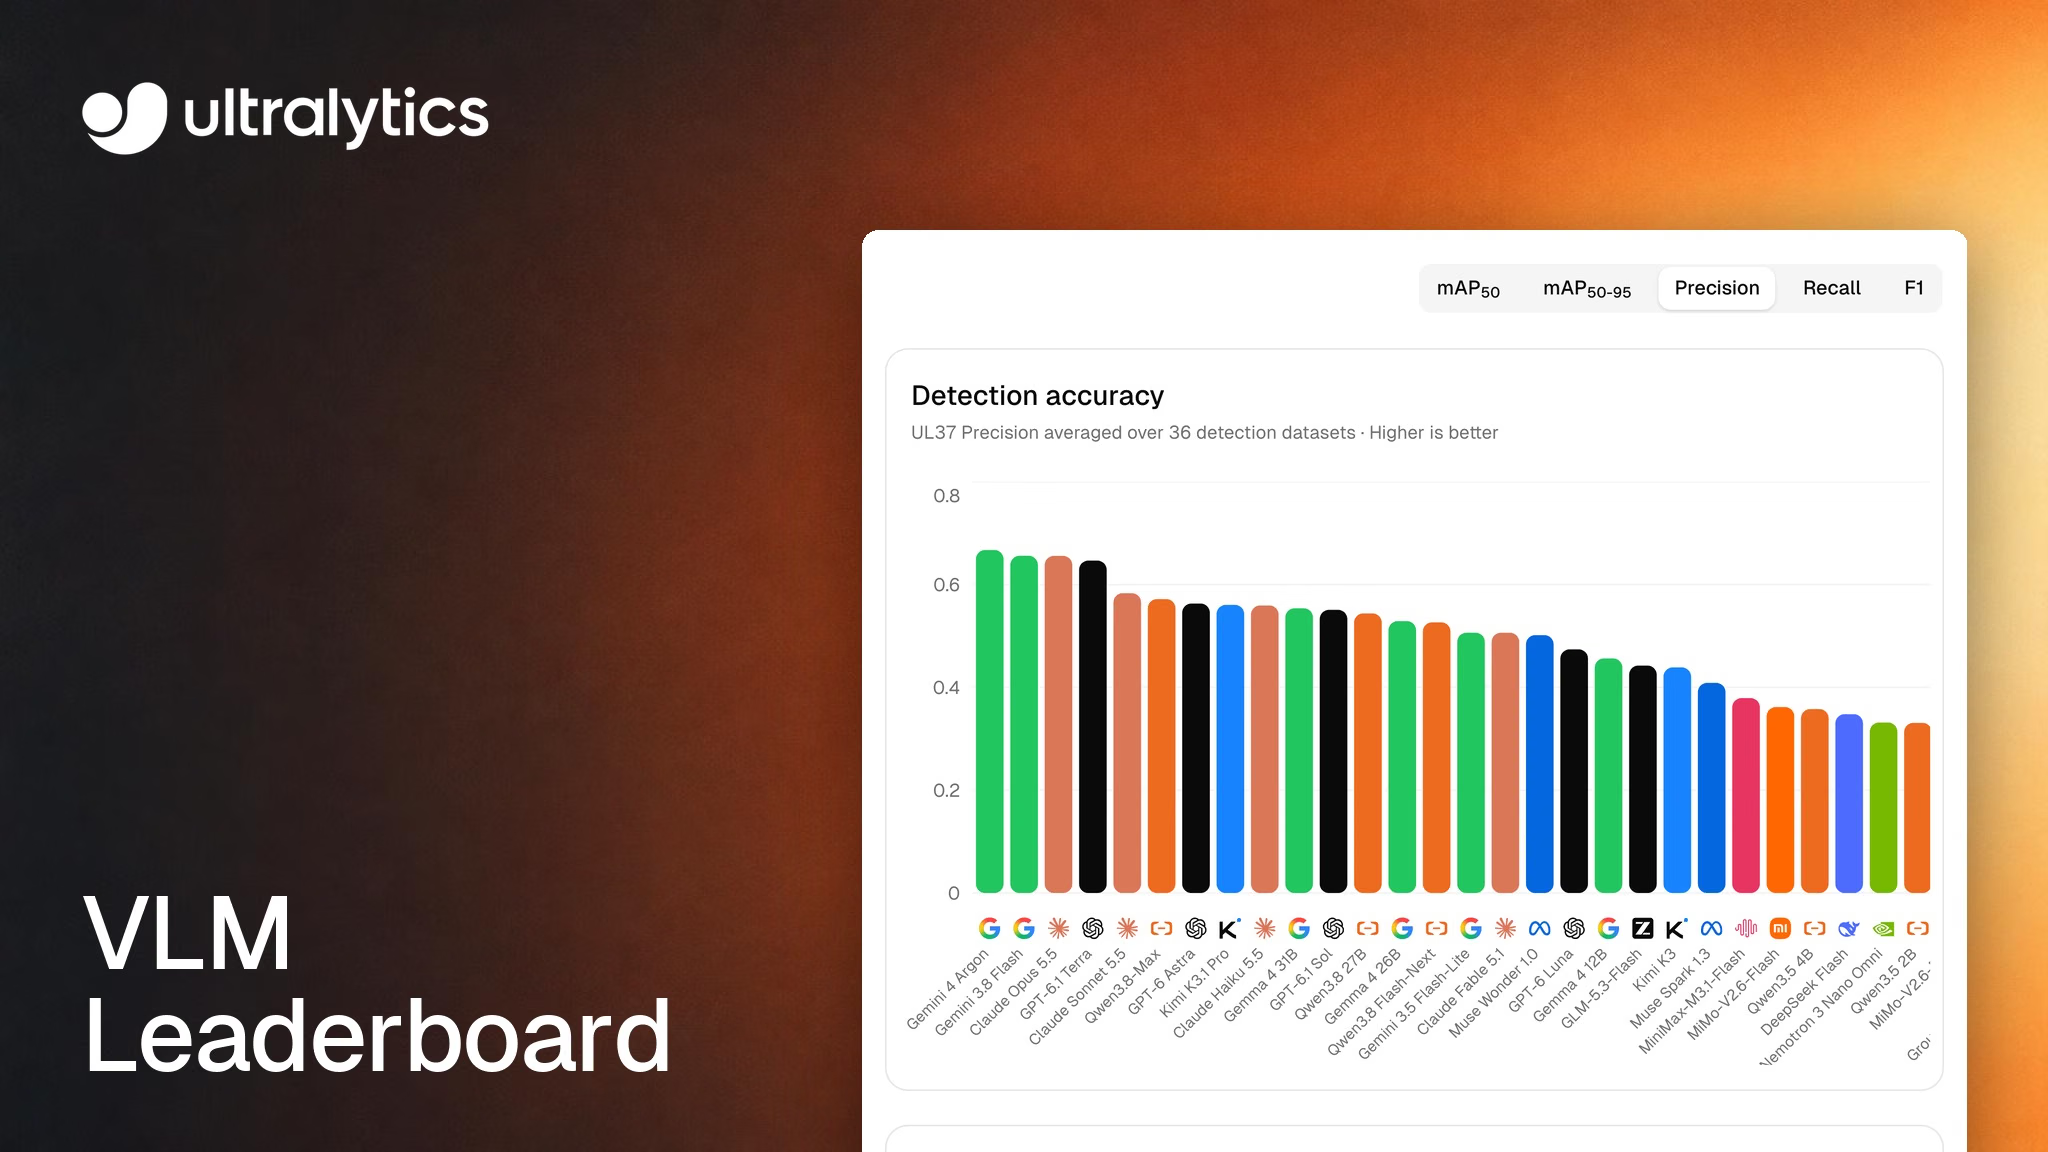
Elegir un modelo para anotar automáticamente un conjunto de datos depende del tipo de limpieza que prefieran hacer tus revisores: eliminar cajas de más o añadir las que el modelo haya pasado por alto. La clasificación de modelos VLM de Ultralytics muestra ahora ese equilibrio para cada modelo, con la precisión (la proporción de cajas del modelo que son correctas) y la exhaustividad (la proporción de objetos etiquetados que encuentra), a partir de los resultados de la evaluación comparativa publicados el 28 de octubre de 2026.
Para obtener los primeros borradores más limpios, empieza con Gemini 4 Argon. Para pasar por alto el menor número de objetos, empieza con GPT-6 Astra. Para conseguir el mejor equilibrio y el coste más bajo de los seis modelos con mejor puntuación, elige GPT-6.1 Terra. Si no tienes tu propia clave de API de un proveedor de IA, empieza con Qwen3.8 27B alojado o con SAM 3.1 Text para escenas abarrotadas que prefieras depurar.
Esta guía explica cómo interpretar las cifras, dónde encaja cada modelo y cómo confirmar tu elección con tus propias imágenes. Las clasificaciones y los precios cambian después de cada ejecución, así que toma las cifras de aquí como ejemplos de octubre de 2026 y consulta la clasificación para ver los resultados actuales.
Los modelos con indicaciones de clase no tienen control deslizante de confianza, así que el modelo que elijas marca el umbral#
Con un modelo Ultralytics YOLO en el editor de anotaciones, tú ajustas el equilibrio. Si subes el umbral de confianza, obtienes menos cajas falsas y más omisiones; si lo bajas, ocurre lo contrario. Los modelos de lenguaje y visión (VLMs) con indicaciones de clase funcionan de otra forma. Tal como explican los documentos del editor de anotaciones, detectan las clases de tu conjunto de datos con umbrales específicos del modelo y no devuelven puntuaciones de confianza, por lo que Ultralytics Platform oculta los ajustes de confianza e IoU mientras hay uno seleccionado.
Eso cambia el significado de la precisión y la exhaustividad de la clasificación. Según la metodología de evaluación comparativa, la precisión y la exhaustividad cuentan todas las cajas que devuelve un modelo con un IoU de 0,5, sin ningún punto de funcionamiento oculto. Describen las cajas que reciben realmente las personas revisoras.
La evaluación comparativa que sustenta la clasificación es UL37 v2: 10 imágenes de cada uno de los 36 conjuntos de datos reales de detección de objetos de Platform, más 10 imágenes de referencia de COCO 2017 puntuadas por separado, para un total de 370 imágenes y 7268 cajas. Cada imagen pasa por la misma canalización de producción que Smart y Batch Annotation, con los nombres de clase del propio conjunto de datos, y SAM 3.1 refina las cajas de todos los modelos excepto las de SAM 3. La puntuación utiliza las métricas de detección del paquete Ultralytics, el código que valida los modelos YOLO, y todos los conjuntos de datos tienen el mismo peso en el promedio.
La precisión mide las cajas no emparejadas; la exhaustividad, los objetos no emparejados#
La precisión es la proporción de cajas de un modelo que coinciden con un objeto etiquetado de la clase correcta con un IoU de 0,5. La exhaustividad es la proporción de objetos etiquetados con los que ha coincidido el modelo. En términos de revisión:
- Una precisión baja significa que hay más cajas que eliminar, volver a etiquetar o redimensionar hasta que coincidan.
- Una exhaustividad baja significa que hay más objetos etiquetados a los que añadir una caja, redimensionarla o volver a etiquetarla.
- F1 es la media armónica de ambas, 2 x P x R / (P + R), un único valor que resume las dos. No mide cuánto dura una revisión.
- mAP50 y mAP50-95 clasifican los modelos según la precisión media entre clases, con un IoU de 0,5 y con los umbrales más estrictos de 0,50 a 0,95. mAP50 es el criterio de ordenación de la clasificación.
Estos son los seis modelos con una puntuación superior a 0,51 mAP50. El coste se estima a partir del uso de tokens indicado por el proveedor por cada 1000 imágenes de evaluación comparativa anotadas correctamente, y la latencia es el tiempo mediano de respuesta:
| Modelo | mAP50 | mAP50-95 | Precisión | Exhaustividad | F1 | Coste del proveedor / 1000 imágenes (uso en la evaluación comparativa) | Latencia |
|---|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 0.560 | 0.345 | 0.65 | 0.61 | 0.63 | $4.36 | 5.1 s |
| Gemini 4 Argon | 0.537 | 0.343 | 0.67 | 0.59 | 0.62 | $7.60* | 4.6 s |
| Claude Opus 5.5 | 0.527 | 0.333 | 0.66 | 0.59 | 0.62 | $13.92 | 2.7 s |
| GPT-6 Astra | 0.525 | 0.325 | 0.56 | 0.63 | 0.59 | $49.31 | 11.6 s |
| Gemini 3.8 Flash | 0.516 | 0.321 | 0.66 | 0.56 | 0.60 | $5.86 | 7.4 s |
| GPT-6.1 Sol | 0.514 | 0.318 | 0.55 | 0.62 | 0.58 | $10.30 | 10.5 s |
*La estimación de Gemini 4 Argon se basa en los precios introductorios de Google, vigentes hasta el 30 de noviembre de 2026. A partir del 1 de diciembre, la tarifa estándar de Google se duplica, hasta unos 15 $ por cada 1000 imágenes con el mismo uso. Batch Annotation en Ultralytics Platform añade 1,00 $ por cada 1000 imágenes procesadas, para cualquier modelo, incluidos los alojados.
Los seis modelos se dividen en dos grupos. Argon, Opus 5.5 y Gemini 3.8 Flash tienen una precisión de entre 0,66 y 0,67 y una exhaustividad inferior a 0,60: una gran proporción de sus cajas coincide, pero encuentran menos objetos etiquetados. Astra y Sol alcanzan una exhaustividad de entre 0,62 y 0,63, con una precisión de entre 0,55 y 0,56: encuentran una proporción mayor de los objetos etiquetados, aunque una proporción menor de sus cajas coincide. Terra se sitúa entre ambos grupos y lidera en mAP50 y F1.
Da prioridad a la precisión cuando corregir las cajas sobrantes resulta costoso#
Con 0,667, Gemini 4 Argon tiene la precisión general más alta de los 40 modelos de la evaluación comparativa. El equilibrio que ofrece implica una exhaustividad media de 0,585, por debajo de los modelos líderes en exhaustividad.
La precisión es lo más importante cuando cuesta detectar las cajas no coincidentes. En una imagen abarrotada, antes de corregir una caja incorrecta, la persona revisora tiene que encontrarla entre muchas cajas correctas. Las estanterías densas de SKU110K muestran cuánto puede variar la precisión en este tipo de imágenes: en nuestros resultados de GPT-6.1 Terra, Terra registró allí una precisión de 0,79 y una exhaustividad de 0,73, frente a los valores de 0,49 y 0,77 de GPT-6.1 Sol.
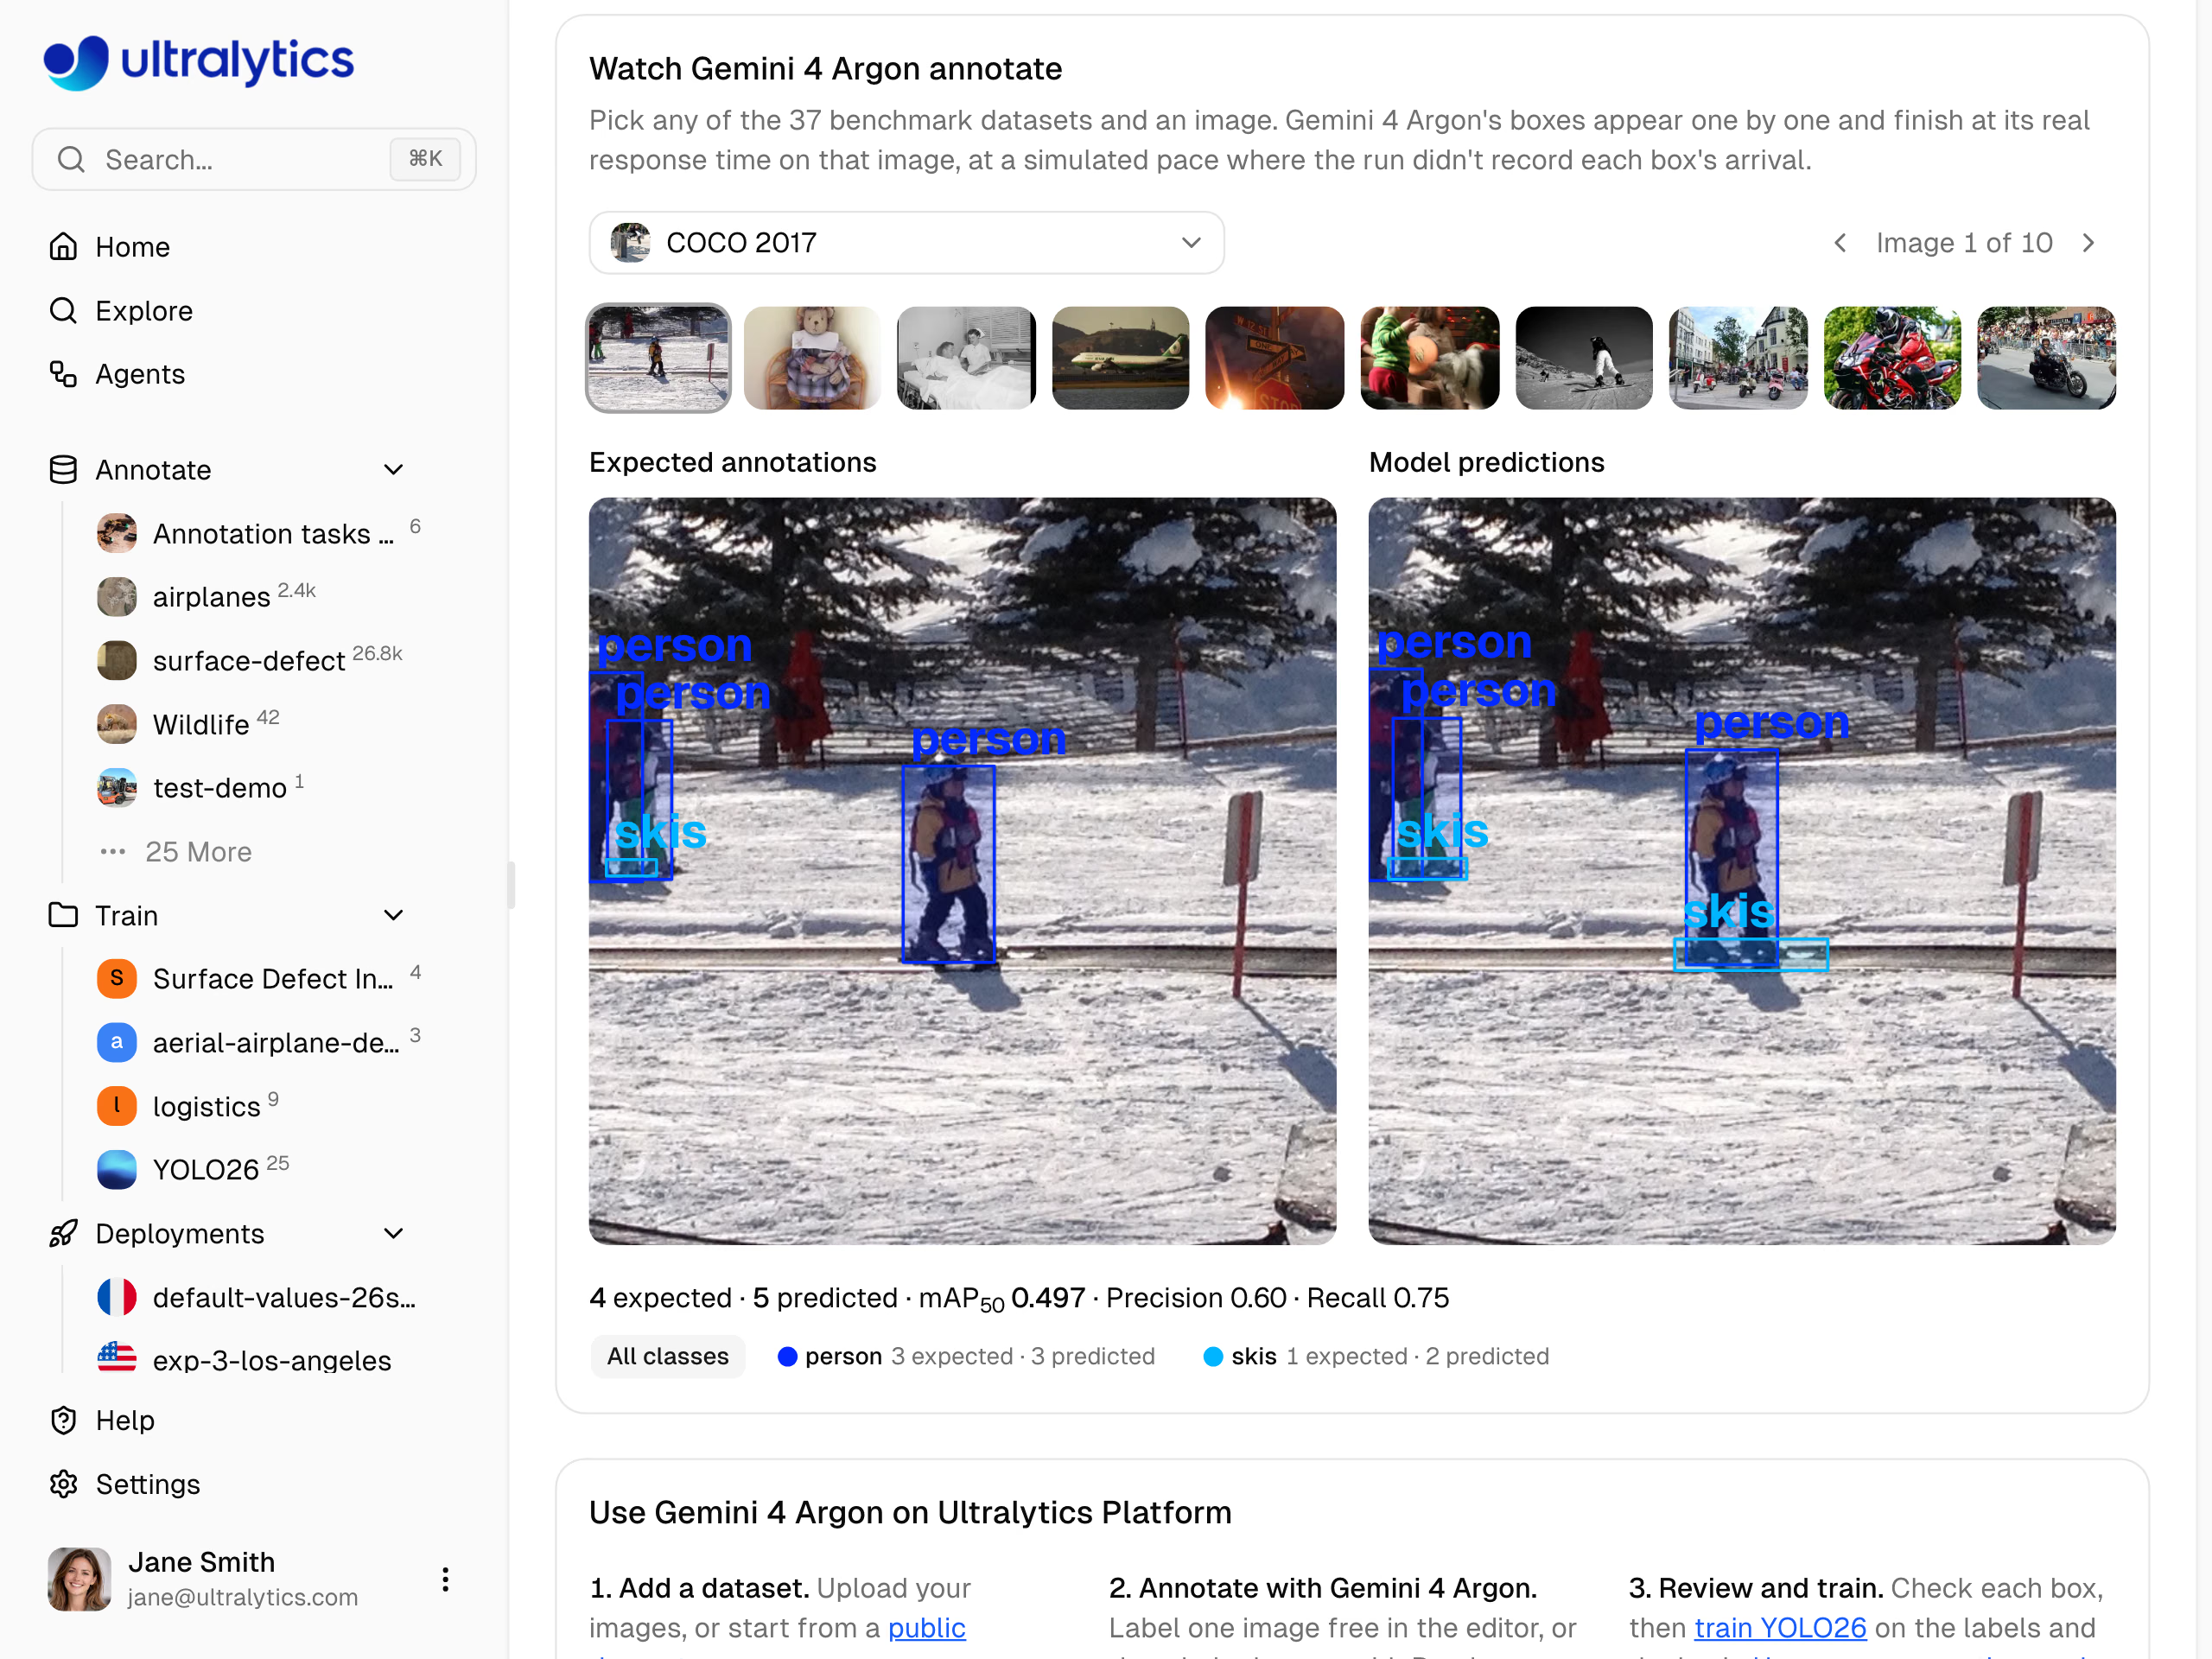
Gemini 4 Argon: 5 cajas predichas para 4 objetos etiquetados, precisión de 0,60 y exhaustividad de 0,75.
Argon tampoco tuvo solicitudes fallidas en la evaluación comparativa, y su mediana de 4,6 segundos es la más rápida de los dos primeros. Elígelo cuando tus datos se parezcan a los ámbitos en los que destaca: imágenes aéreas, submarinas, térmicas y de rayos X de seguridad (obtiene el mejor mAP50 en las radiografías de seguridad de IEDXray, 0.298), y cuando tu equipo prefiera completar unos pocos objetos omitidos antes que buscar cajas sueltas.
Da prioridad a la exhaustividad cuando omitir un objeto sea un error costoso#
GPT-6 Astra tiene la mayor exhaustividad media de la clasificación, 0,627. Su precisión de 0,56 es el precio que hay que pagar.
Etiquetar priorizando la exhaustividad tiene sentido cuando un objeto sin etiquetar supone el error más costoso. Un defecto o una lesión que no se detecte en tu conjunto de entrenamiento enseña al detector que ese objeto es fondo, y encontrar una caja que falta implica revisar todas las imágenes para detectar algo que no está marcado. Astra obtiene el mejor mAP50 en 7 de los 36 conjuntos de datos, incluidos los rayos X de tórax de TBX11K (0.330), las radiografías pediátricas de muñeca de GRAZPEDWRI-DX (0.354) y los defectos de superficie de PCB de DsPCBSD+ (0.394): un motivo para probarlo con datos similares, no una prueba de que pase por alto menos objetos en los tuyos.
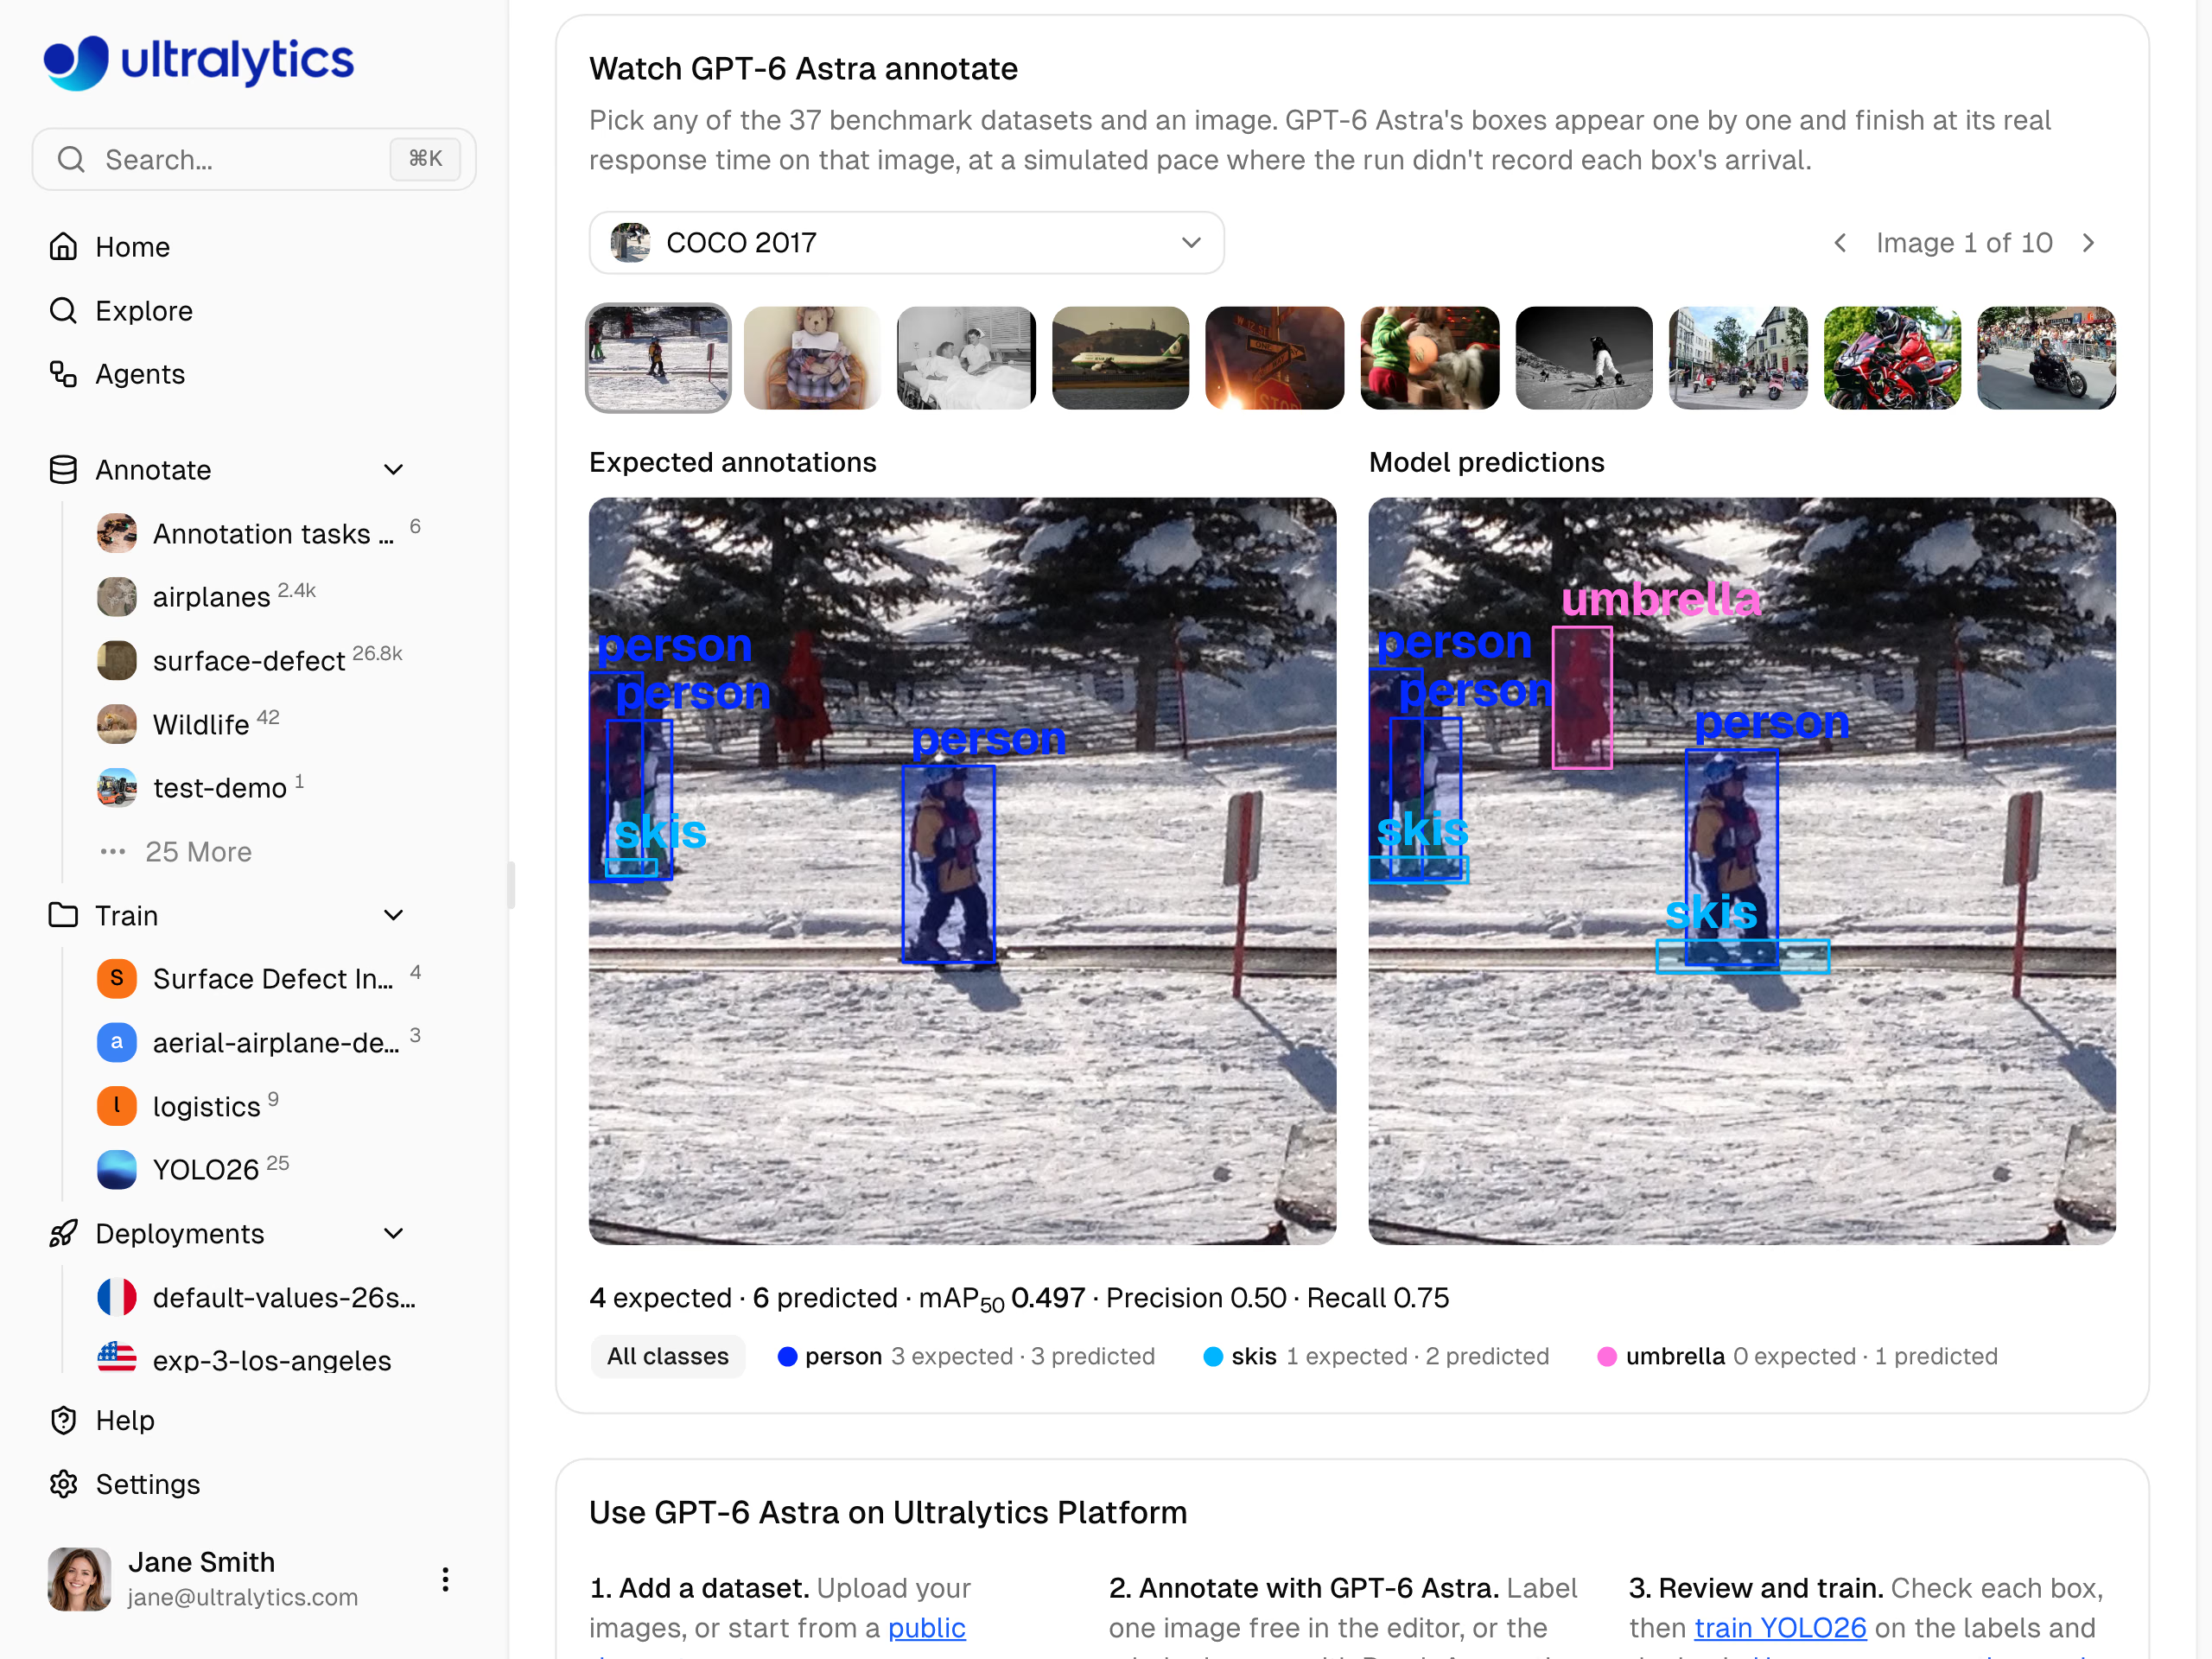
GPT-6 Astra: 6 cajas para los mismos 4 objetos, incluido un paraguas que las etiquetas COCO omiten; precisión 0.50, exhaustividad 0.75.
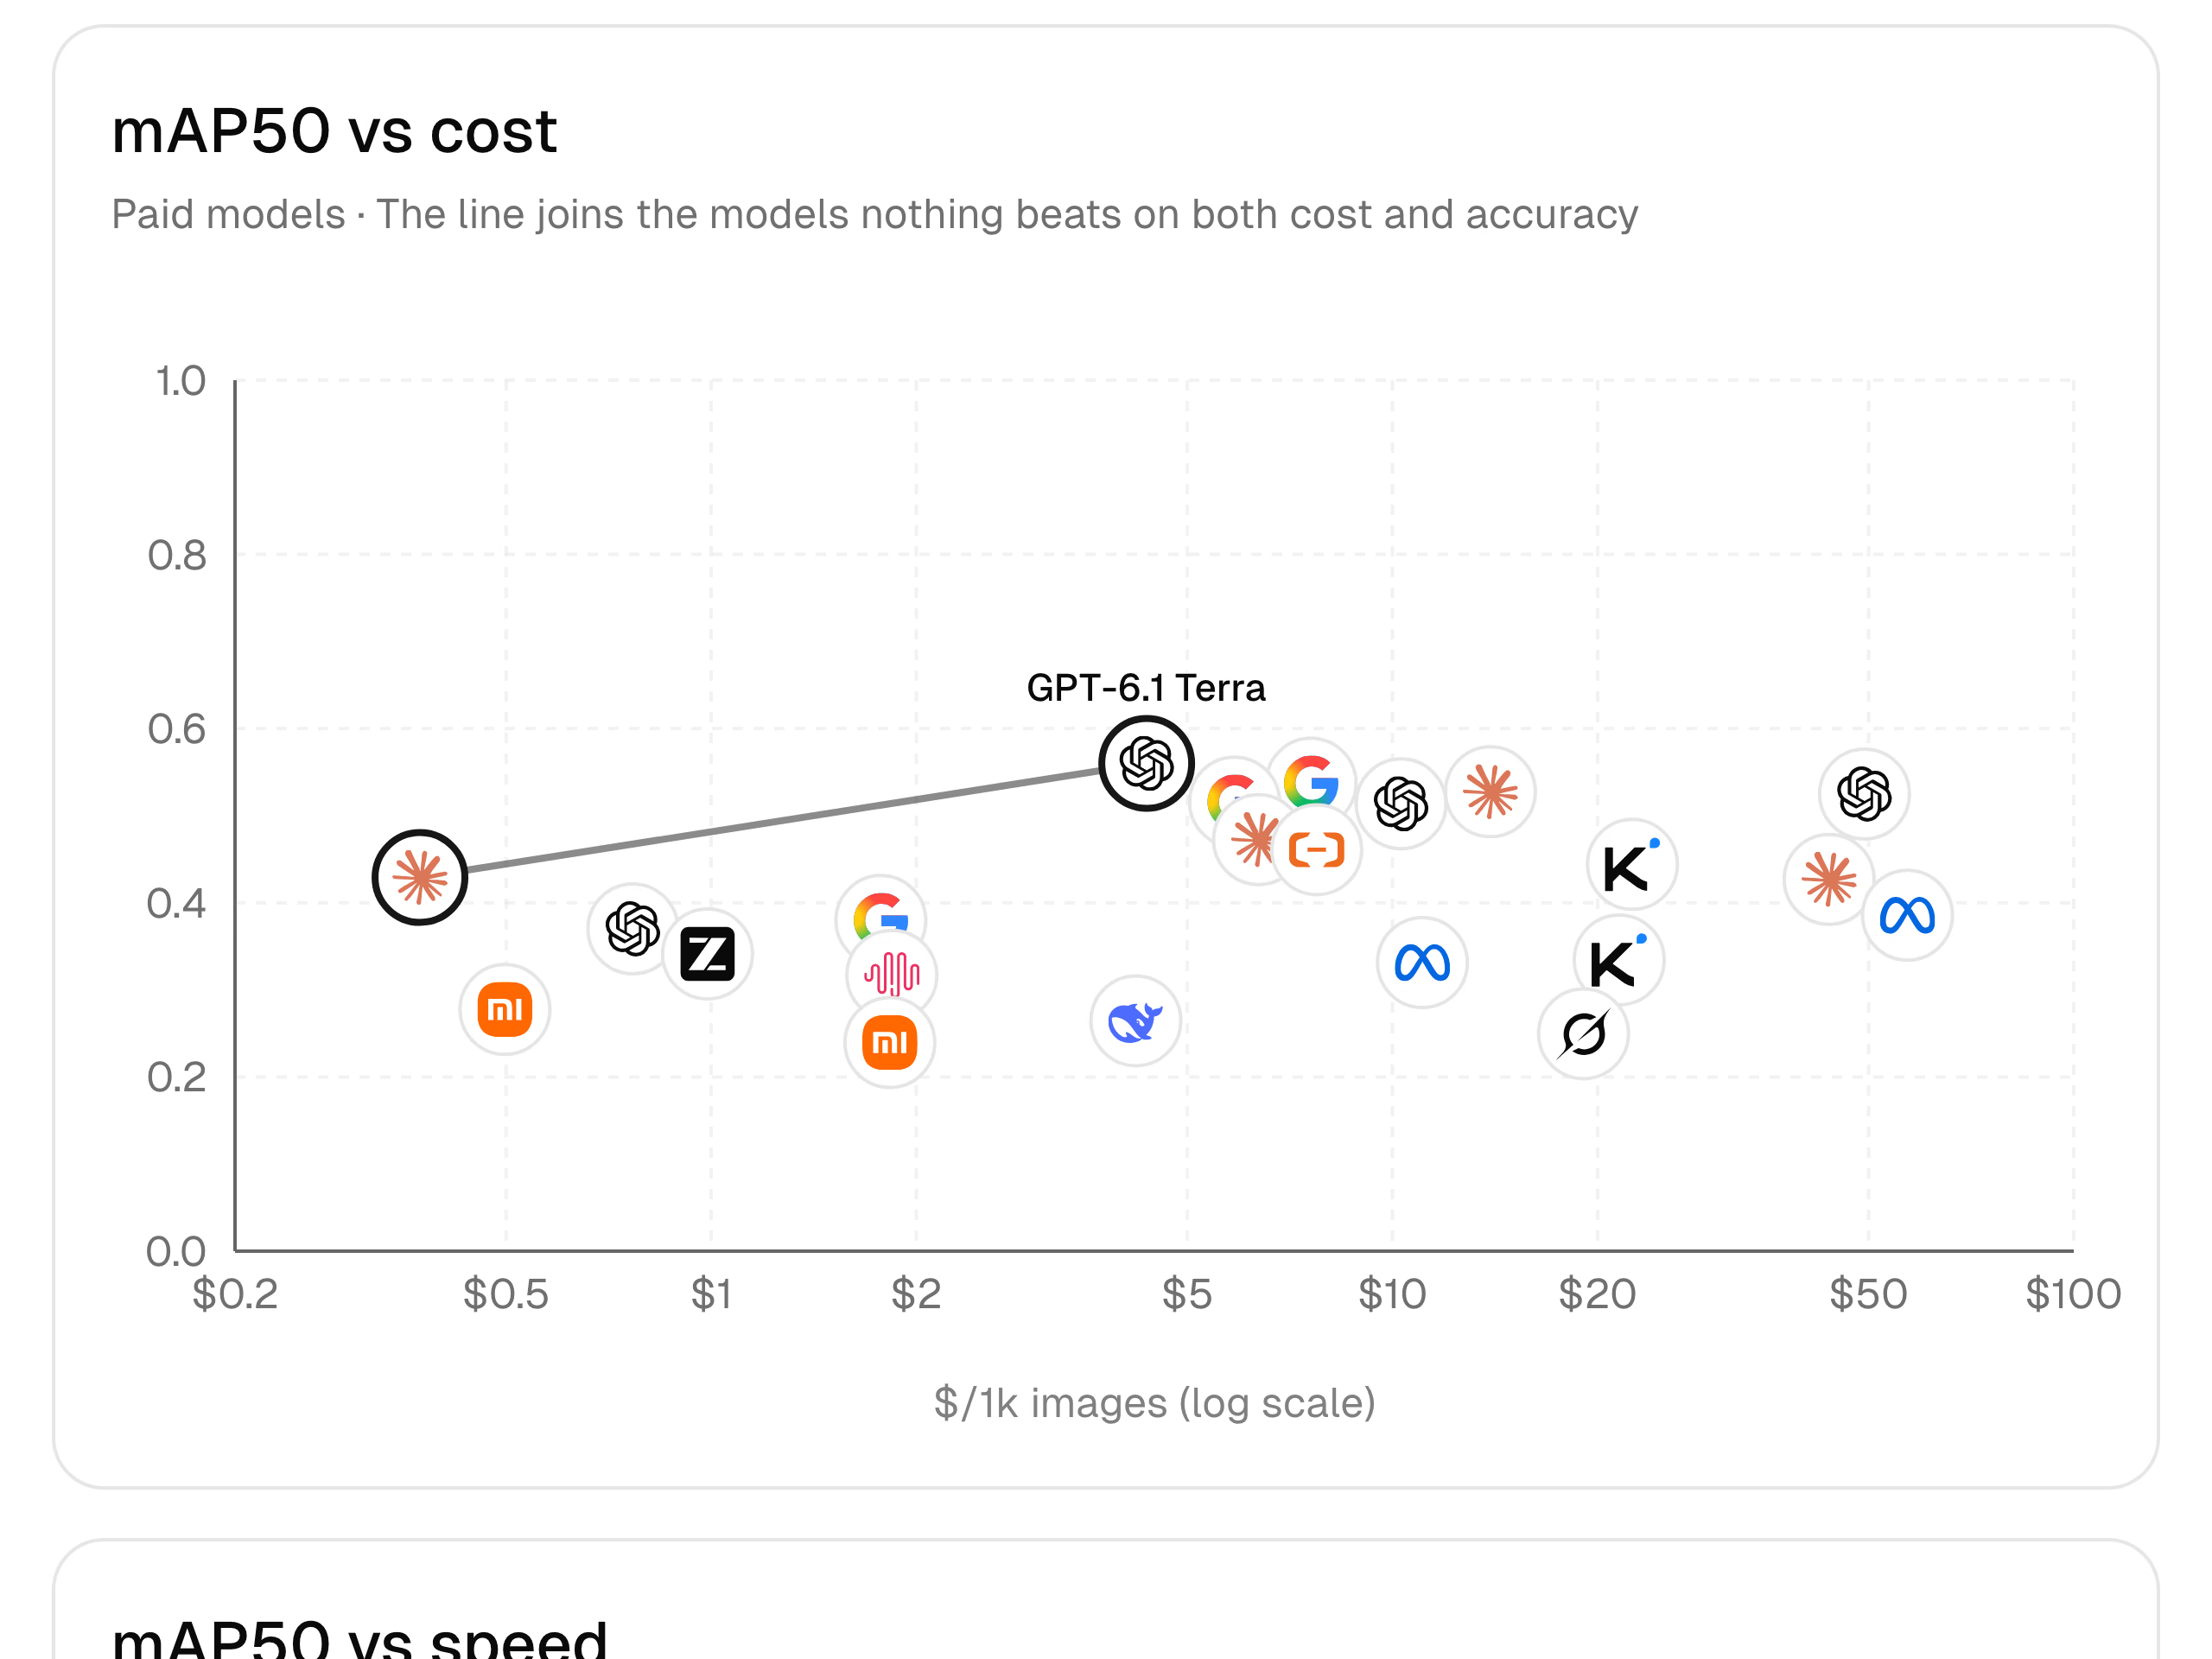
Astra tiene la estimación de coste más alta de los seis primeros modelos: 49,31 $ por cada 1000 imágenes, con una mediana de 11,6 segundos y solicitudes fallidas en el 1 % de las imágenes. Otros dos modelos de OpenAI se acercan en exhaustividad: GPT-6.1 Sol, con 0,62 y un coste estimado de 10,30 $, y GPT-6.1 Terra, con 0,61 y un coste estimado de 4,36 $.
Valora ambos tipos de error con mAP50-95 y F1#
GPT-6.1 Terra lidera la clasificación con 0,560 mAP50 y 0,345 mAP50-95. Sus valores de precisión (0,646) y exhaustividad (0,613) están a pocas centésimas de los líderes, y su F1 de 0,63 es el más alto de los seis, justo por delante de Argon y Opus 5.5, con 0,62. Con un F1 tan ajustado, y dado que F1 no dice nada sobre el tiempo de revisión, deja que los resultados por dominio y una prueba con tus propias imágenes decidan cuál eliges.
Su ventaja en mAP50-95 aporta una segunda señal. Como mAP50-95 calcula el promedio con umbrales de solapamiento de hasta 0,95, recompensa tanto a los modelos cuyas cajas coincidentes se ajustan estrechamente como a los que encuentran los objetos correctos; Terra también ocupa el primer puesto en esta métrica. Además, tiene la estimación de coste más baja de los seis primeros modelos y no tuvo solicitudes fallidas; la clasificación lo señala como «Mejor relación calidad-precio».
Etiqueta sin una clave de proveedor: modelos alojados y detectores de vocabulario abierto#
No todos los equipos quieren una clave de proveedor de pago. Los modelos alojados en Platform funcionan sin ella, y sus columnas cuentan otra historia:
- SAM 3.1 Text: 0,332 mAP50, 0,19 de precisión, 0,47 de exhaustividad y 0,2 s por imagen. Es el mejor modelo de los 40 en VisDrone (0,479 mAP50) y en tráfico de Fisheye8K (0,478).
- Qwen3.8 27B: 0,351 mAP50, 0,54 de precisión, 0,40 de exhaustividad y 1,5 s.
- Gemma 4 26B: 0,344 mAP50, 0,53 de precisión, 0,39 de exhaustividad y 0,9 s.
Los detectores de vocabulario abierto también están alojados. En esta evaluación comparativa, OWLv2 Large obtuvo 0,133 mAP50 y Grounding DINO Base, 0,104; ambos tardaron 0,2 segundos por imagen, frente al 0,332 de SAM 3.1 Text. Estas puntuaciones miden la canalización de Platform con indicaciones de clase y refinamiento de cajas mediante SAM 3.1, no la configuración original de cada modelo.
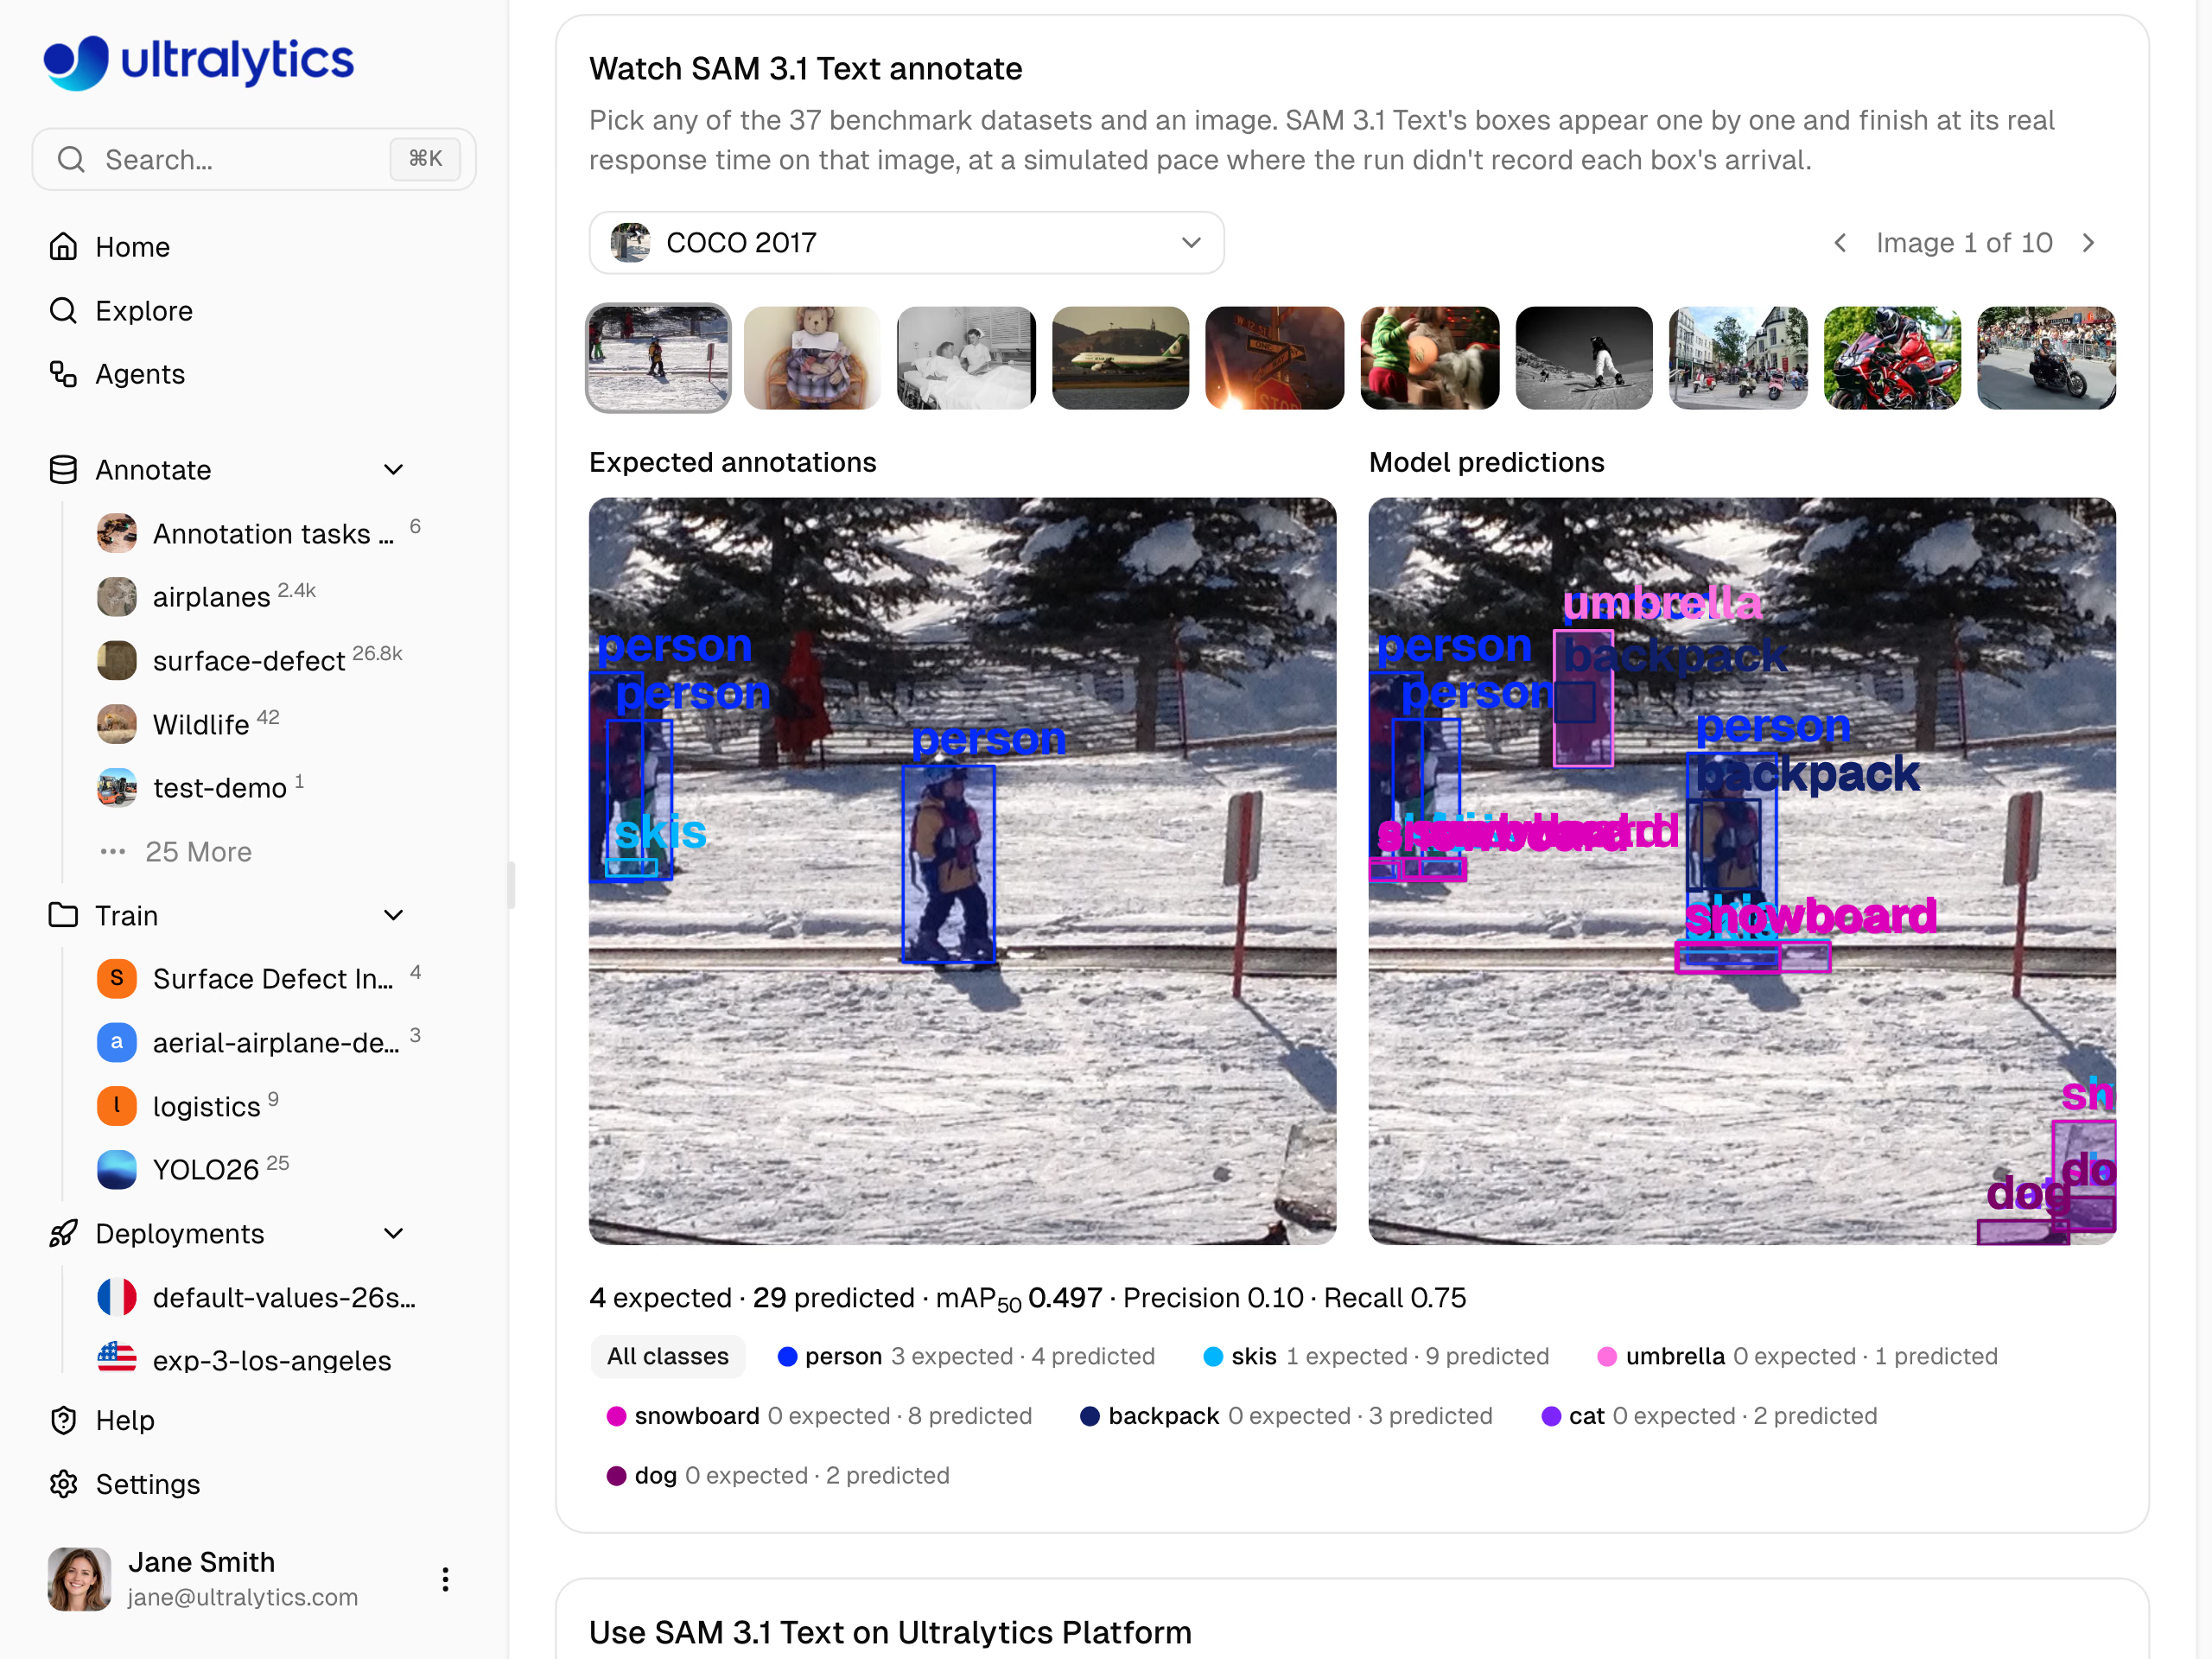
SAM 3.1 Text: 29 cajas para 4 objetos, precisión de 0,10 y exhaustividad de 0,75. Las tres reproducciones encuentran 3 de los 4 objetos; lo que cambia es cuántas cajas sobrantes tienen que eliminar las personas revisoras.
SAM 3.1 Text es adecuado para escenas de tráfico y aéreas abarrotadas en las que las personas revisoras esperan tener que depurar un borrador generoso. Qwen3.8 27B y Gemma 4 26B se comportan como el grupo más cuidadoso, pero con menor precisión. Entre los modelos de pago de bajo coste, Claude Haiku 5.5 alcanza 0,429 mAP50, con 0,56 de precisión y 0,47 de exhaustividad, y un coste estimado de 0,37 $ por cada 1000 imágenes; es el otro modelo que la clasificación señala como «Mejor relación calidad-precio».
Los promedios generales ocultan las particularidades de tu dominio; consulta la tabla de conjuntos de datos#
La precisión y la exhaustividad de cada modelo son promedios de 36 conjuntos de datos, y tus datos pertenecen a un solo dominio. La tabla de conjuntos de datos de la clasificación de VLM muestra la precisión y la exhaustividad medias de los 40 modelos para cada conjunto de datos, ordenados de más difícil a más fácil, además del mejor modelo en cada uno.
Consúltala para detectar señales de alerta. En Airbus Oil Storage Detection, con 2267 depósitos etiquetados en sus 10 imágenes, los modelos promedian una precisión de 0,39 y una exhaustividad de 0,11, y el mejor mAP50 es el 0,347 de Gemini 4 Argon. En DeepPCB, la precisión y la exhaustividad medias son 0,03 y 0,04, y GPT-6.1 Sol destaca con 0,393 mAP50.
Considera estas cifras una lista de candidatos, no un veredicto. La metodología indica que 10 imágenes por conjunto de datos bastan para clasificar modelos y dominios, pero no para certificar la puntuación de un conjunto de datos concreto; además, las ejecuciones repetidas pueden variar unos puntos en cada cifra. La página de cada modelo en Platform muestra, lado a lado, las cajas registradas por el modelo y las esperadas en los conjuntos de datos de la evaluación comparativa y en COCO, para que puedas inspeccionar el conjunto de datos más parecido al tuyo antes de iniciar una ejecución.
Adapta el modelo a tu flujo de revisión en cinco pasos#
Empieza por lo que priorizas al elegir y, después, confirma la elección con tus propias imágenes:
| Tu prioridad | Lista de candidatos (resultados de octubre de 2026) |
|---|---|
| Dar prioridad a la precisión | Gemini 4 Argon |
| Dar prioridad a la exhaustividad | GPT-6 Astra o GPT-6.1 Sol |
| Valorar ambos aspectos | GPT-6.1 Terra |
| No tener una clave de proveedor | Alojados: Qwen3.8 27B o SAM 3.1 Text |
La anotación con indicaciones de clase funciona en conjuntos de datos de detección con entre 1 y 200 clases.
- Preselecciona modelos en la clasificación. Filtra la clasificación de VLM para detección de objetos para mostrar los modelos de pago o alojados (omite los que aparezcan como No disponible en la plataforma), lee la columna que corresponda a tu prioridad y consulta la tabla de conjuntos de datos de tu ámbito.
- Añade una clave de proveedor. Para usar un modelo de pago, guarda tu clave en Settings > API Keys, en el espacio de trabajo que contiene el conjunto de datos. El proveedor factura directamente a tu clave; consulta los documentos sobre claves de proveedor para configurarla.
- Prueba con una muestra revisada. Elige unas cuantas imágenes que representen tus datos y que hayas etiquetado a mano. Abre el editor de anotaciones, cambia al modo Smart, selecciona el modelo de su proveedor en el selector de modelos y pulsa Predict (
P). Cuenta las cajas que eliminas, las que añades y los minutos que dura la revisión. - Etiqueta el conjunto de datos. En la página del conjunto de datos, elige More actions > Batch Annotation, disponible en conjuntos de datos alojados en Platform con hasta tres canales de imagen. De forma predeterminada, etiqueta las imágenes sin etiquetar, nunca cambia las etiquetas existentes y guarda primero una versión del conjunto de datos para que puedas volver atrás. Antes de empezar, revisa el coste estimado en el cuadro de diálogo: Batch Annotation cuesta 1,00 $ por cada 1000 imágenes procesadas, más los cargos del proveedor que correspondan.
- Revisa y, después, entrena. Comprueba las cajas teniendo en cuenta el punto débil de tu modelo, guárdalas y entrena un modelo Ultralytics YOLO con el resultado en el mismo espacio de trabajo.
Para ampliar la información, consulta cómo utiliza Ultralytics Platform la IA para automatizar la anotación y por qué la revisión con intervención humana sigue formando parte del trabajo. Para comparar el autoetiquetado con el aprendizaje activo en distintas herramientas, lee nuestra comparativa de autoetiquetado y aprendizaje activo.
Lista de candidatos por equipo (resultados de octubre de 2026)#
- Personas revisoras que prefieren completar un borrador antes que depurarlo: Gemini 4 Argon, el modelo con mayor precisión general, destaca en datos aéreos, submarinos, térmicos y de rayos X de seguridad.
- Objetos poco frecuentes cuya omisión perjudica los datos de entrenamiento: GPT-6 Astra para obtener la máxima exhaustividad o GPT-6.1 Sol, que le sigue de cerca.
- Etiquetado de uso general sin una preferencia clara: GPT-6.1 Terra, primero en mAP50, mAP50-95 y F1.
- Equipos sin una clave de proveedor: SAM 3.1 Text para las primeras pasadas con alta exhaustividad en escenas abarrotadas, o Qwen3.8 27B para un borrador más cuidadoso.
Elijas el que elijas, la clasificación te permite anticipar la revisión antes de empezar. Para conocer la teoría detrás de estas métricas, nuestra guía sobre exactitud, precisión y exhaustividad explica los conceptos básicos, y la lección de Academy sobre cómo interpretar las métricas de detección profundiza más.
Preguntas frecuentes
Da prioridad a la precisión cuando eliminar cajas incorrectas lleve más tiempo; por ejemplo, en imágenes abarrotadas donde una caja sobrante se pierde entre las correctas. Da prioridad a la exhaustividad cuando omitir un objeto tenga un coste mayor, como en el caso de defectos o lesiones poco frecuentes, porque un objeto sin etiquetar enseña al detector que es fondo. Después, confirma tu elección con una muestra de tus propias imágenes revisada a mano.
Los modelos con indicaciones de clase devuelven cajas sin puntuaciones de confianza y utilizan umbrales específicos del modelo, así que Platform oculta los ajustes de confianza e IoU mientras hay uno seleccionado. Por tanto, la precisión y la exhaustividad de la clasificación cuentan todas las cajas que devuelve el modelo con un IoU de 0,5. Para cambiar el equilibrio entre las cajas no emparejadas y los objetos no emparejados, elige otro modelo.
Usa mAP50 para ver si un modelo encuentra y etiqueta los objetos correctos, y mAP50-95 para añadir umbrales de solapamiento más estrictos que recompensan las cajas que se ajustan con precisión. Ambas métricas también reflejan las omisiones y los falsos positivos, así que interprétalas junto con la precisión y la exhaustividad. En los resultados de octubre de 2026, GPT-6.1 Terra lidera ambas, con 0,560 y 0,345.
Sí. El mejor modelo de UL37 v2 obtiene una media de 0,560 mAP50 (octubre de 2026), y en los conjuntos de datos más difíciles, como los de defectos en PCB y radiografías torácicas, los 40 modelos promedian menos de 0,05. Revisa todas las imágenes y presta especial atención al punto débil del modelo: las cajas sobrantes de un modelo que prioriza la exhaustividad o los objetos omitidos por uno que prioriza la precisión.
El coste tiene dos partes. Batch Annotation en Ultralytics Platform cuesta 1,00 $ por cada 1000 imágenes procesadas (mínimo de 0,01 $) con cualquier modelo, incluidos los alojados; las predicciones individuales con un modelo alojado en el editor son gratuitas. Además, el proveedor factura los modelos de pago a tu propia clave de API. En la evaluación comparativa de octubre de 2026, las estimaciones del proveedor para los modelos de esta guía iban desde 0,37 $ por cada 1000 imágenes (Claude Haiku 5.5) hasta 49,31 $ (GPT-6 Astra). Si detienes una ejecución, se te facturarán las imágenes ya procesadas.
Sí. Los modelos alojados, como SAM 3.1 Text, Qwen3.8 27B y Gemma 4 26B, funcionan en Ultralytics Platform sin una clave de proveedor, al igual que tus propios modelos YOLO. Las ejecuciones por lotes siguen costando 1,00 $ por cada 1000 imágenes procesadas y el cuadro de diálogo muestra el coste estimado antes de cada ejecución.
Depende de la tarea. Un VLM con indicaciones de clase puede crear un borrador de etiquetas para clases nuevas usando solo sus nombres, pero los seis modelos mejor puntuados en la evaluación comparativa de octubre de 2026 tardaron entre 2,7 y 11,6 segundos por imagen y se facturan por token. Para la detección en tiempo real, una opción habitual es autoetiquetar con un VLM, revisar las etiquetas y entrenar un modelo Ultralytics YOLO con ellas. También puedes usar en el mismo editor un modelo YOLO que ya hayas entrenado para autoetiquetar imágenes nuevas.
Escrito por
Ingeniero principal de software · Ultralytics
Comentarios2
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
 Glenn JocherUltralytics
Great job Wax on your first blog!
 Sergiu WaxmannUltralytics
Appreciate it! More coming soon.









