Meilleurs modèles de classification d’images : comment choisir
Compare les principaux modèles de classification d’images, de ConvNeXt V2 et DINOv3 à EfficientNetV2, ViT et Ultralytics YOLO26-cls, et découvre comment faire ton choix.
Il n’existe pas de modèle de classification d’images universellement meilleur. Le bon choix dépend de la quantité de données étiquetées dont tu disposes, de l’environnement d’exécution du modèle et de la licence applicable. En 2026, les travaux axés sur la précision s’appuient surtout sur de grands modèles Transformer et des architectures auto-supervisées, comme DINOv3 et EVA-02. Pour un déploiement sur du matériel limité, des modèles plus petits, majoritairement convolutionnels, comme ConvNeXt V2, EfficientNetV2, MobileNetV4 et Ultralytics YOLO26-cls, sont souvent plus pratiques, selon la taille du point de contrôle, la configuration d’entraînement et le matériel cible. Compare leur précision et leur latence sur ta propre charge de travail. Ce guide présente les quatre familles de modèles, compare dix modèles largement utilisés et propose une démarche pour en choisir un.
Si tu découvres la tâche elle-même, commence par ce qu’est la classification d’images. Cette page porte sur le choix d’un modèle.
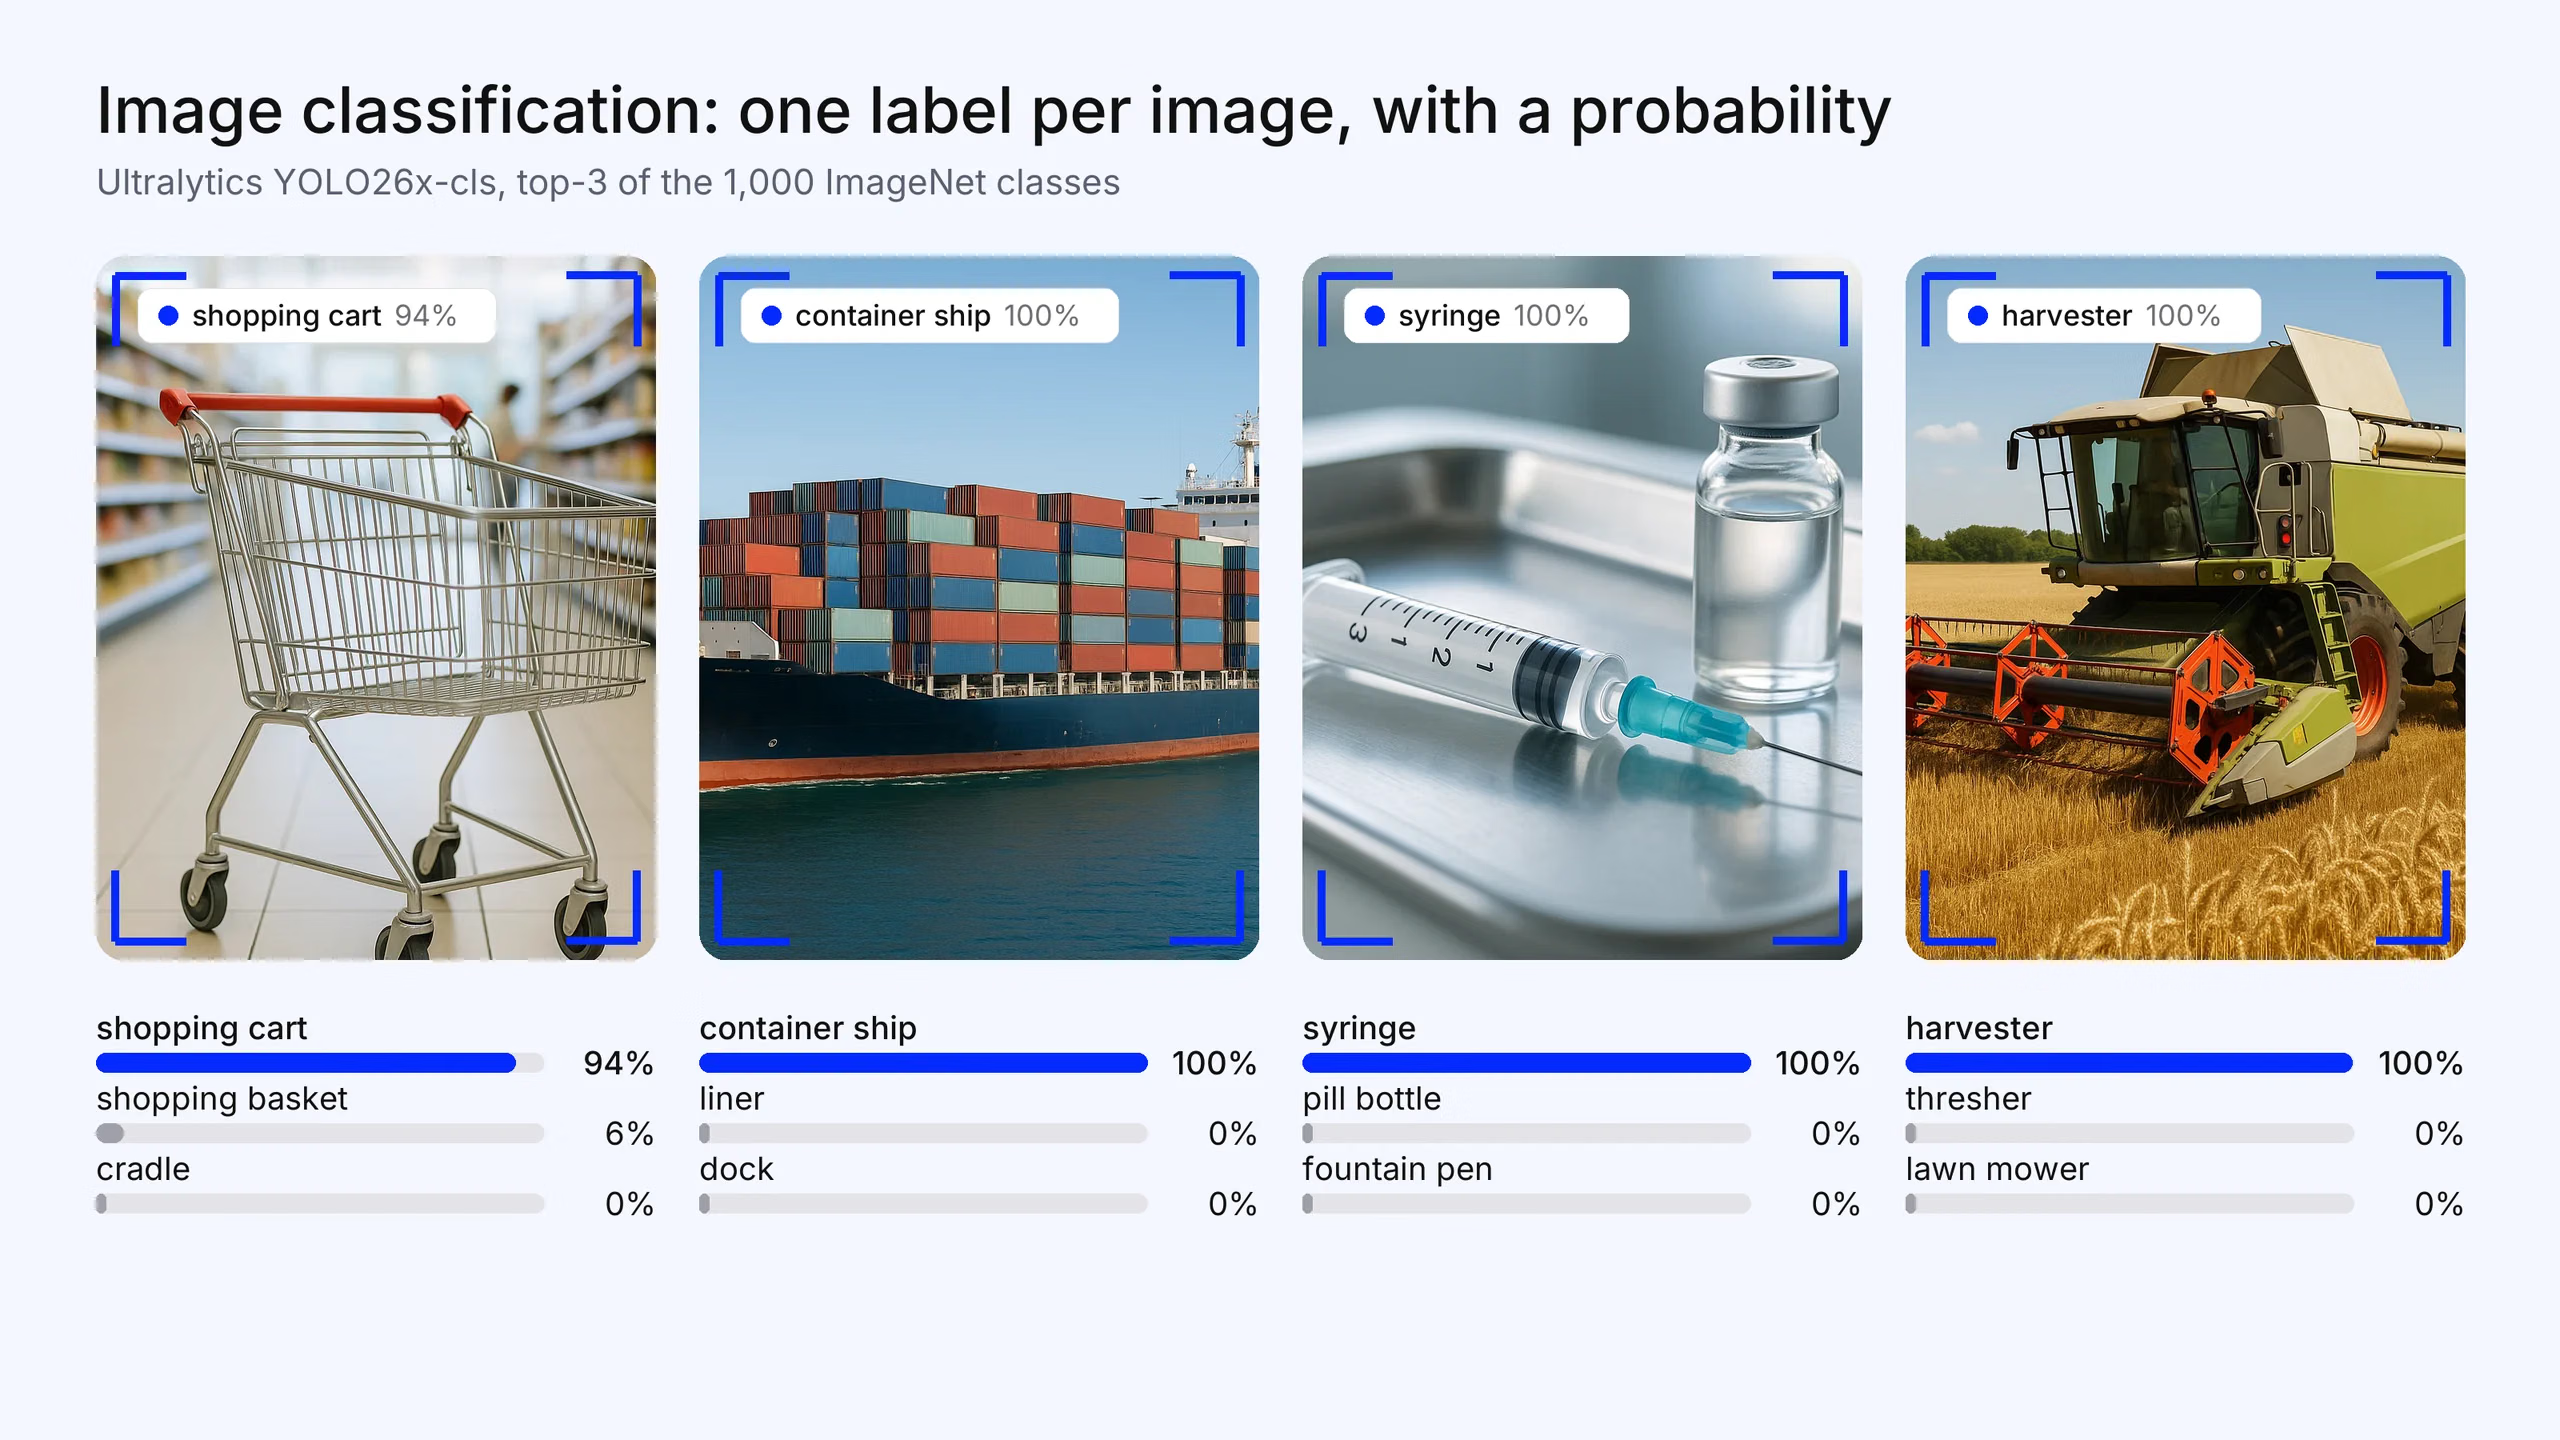
Fig. 1. La classification d’images renvoie une étiquette pour l’image entière, avec une probabilité pour chaque classe : exemples issus du commerce de détail, de la logistique, de la santé et de l’agriculture. Les trois principales prédictions d’Ultralytics YOLO26x-cls, préentraîné sur les 1 000 classes ImageNet. Les photos ont été créées pour cet article ; les prédictions sont de véritables sorties du modèle.
Ce que signifie « meilleur » pour un modèle de classification d’images#
Les classements ordonnent les modèles selon leur précision top-1 sur l’ensemble de validation ImageNet. Cette mesure est utile, mais elle est calculée à une résolution fixe, sur un seul jeu de données et souvent après un préentraînement à très grande échelle. Quatre autres facteurs déterminent généralement le choix pour un projet réel :
- Données. Le nombre d’images étiquetées dont tu disposes pour chaque classe, et leur proximité avec les données de préentraînement.
- Calcul et latence. Le fait que l’inférence s’exécute sur un GPU de centre de données, un CPU, un téléphone ou un NPU de caméra.
- Voie de déploiement. La facilité avec laquelle le modèle s’exporte vers l’environnement d’exécution requis, comme ONNX, TensorRT, Core ML ou TFLite.
- Licence. La possibilité d’utiliser le code et, séparément, les poids préentraînés pour ton usage.
Un modèle dont la précision sur ImageNet est inférieure de quelques points, mais qui s’adapte bien à tes images et s’exécute en temps réel sur ton matériel, constitue généralement le meilleur choix.
Les quatre familles de modèles de classification d’images#
Réseaux neuronaux convolutifs (CNNs)#
Les CNN font glisser des filtres appris sur l’image ; ils partent donc du principe que les pixels proches sont liés. Cette hypothèse intégrée (un biais inductif) leur permet d’apprendre efficacement à partir de jeux de données petits ou moyens et de fonctionner sur du matériel modeste. ResNet et EfficientNet en sont les exemples classiques.
- Points forts : efficaces avec peu de données, rapides, faciles à quantifier et à déployer.
- Compromis : moins de contexte global par couche ; les gains liés à la mise à l’échelle ont tendance à plafonner plus tôt qu’avec les Transformer.
Transformers de vision (ViTs)#
Un Transformer de vision découpe une image en blocs et les traite comme une séquence grâce à l’auto-attention, ce qui permet à chaque bloc d’interagir avec tous les autres. Les ViT donnent les meilleurs résultats lorsqu’ils sont préentraînés sur de grandes quantités de données, puis transférés.
- Points forts : évolue bien avec la quantité de données et la taille du modèle ; transfert efficace ; base naturelle pour l’entraînement auto-supervisé et multimodal.
- Compromis : nécessite un préentraînement à grande échelle ou une forte régularisation ; généralement plus lent et plus lourd à l’inférence qu’un CNN de précision similaire.
Modèles hybrides CNN-Transformer#
Les modèles hybrides utilisent des convolutions dans les premières étapes pour les détails locaux, puis l’attention dans les étapes suivantes pour le contexte global. CoAtNet est le modèle de référence : ses auteurs ont constaté qu’un empilement méthodique de couches convolutives et d’attention améliore la généralisation, la capacité et l’efficacité.
- Points forts : bon équilibre sur les jeux de données de taille moyenne.
- Compromis : plus complexe à implémenter, à régler et à exporter que les architectures purement convolutives ou purement fondées sur l’attention.
Modèles auto-supervisés et modèles de vision-langage#
La famille la plus récente ne se définit pas par son architecture, mais par son mode d’entraînement. Les modèles auto-supervisés, comme DINOv2 et DINOv3, apprennent à partir d’images non étiquetées. Les encodeurs de vision-langage, comme SigLIP 2, apprennent à partir de paires image-texte. Les deux produisent des caractéristiques polyvalentes que tu peux classer à l’aide d’une petite tête linéaire ou, dans le cas des modèles de vision-langage, au moyen de prompts textuels, sans aucun entraînement (apprentissage zéro-shot). Meta a entraîné DINOv3 avec 7 milliards de paramètres sur 1,7 milliard d’images, contre 1,1 milliard de paramètres et 142 millions d’images pour DINOv2.
- Points forts : caractéristiques performantes avec peu de données étiquetées ; un même modèle de base sert à plusieurs tâches.
- Compromis : les plus grands points de contrôle sont beaucoup trop lourds pour les appareils en périphérie ; les licences varient et doivent être vérifiées.
Comparatif des modèles de classification d’images#
Les modèles sont présentés par ordre alphabétique, et non classés. Nous n’indiquons pas de chiffres de précision : les résultats publiés sur ImageNet varient selon la résolution, les données de préentraînement et le protocole d’évaluation ; ils ne sont donc pas comparables d’une ligne à l’autre. L’article ou la documentation de chaque modèle, indiqué ci-dessous, fournit ses propres résultats.
| Modèle | Famille | Origine | Préentraînement | Idéal pour | Principal compromis |
|---|---|---|---|---|---|
| ConvNeXt V2 | CNN | Meta | Auto-encodage masqué auto-supervisé (FCMAE), puis ajustement fin supervisé | CNN précis et déployable, disponible en plusieurs tailles | Les poids ImageNet sont sous licence CC-BY-NC (usage non commercial) |
| DINOv3 | Auto-supervisé (ViT et ConvNeXt) | Meta | Auto-supervisé sur 1,7 milliard d’images | Caractéristiques gelées performantes, peu de données étiquetées | Licence DINOv3 personnalisée ; le plus grand modèle compte 7 milliards de paramètres |
| EfficientNetV2 | CNN | Supervisé | Entraînement rapide, ajustement fin efficace | Architecture plus ancienne ; les modèles de base plus récents sont plus précis | |
| EVA-02 | ViT | BAAI | Modélisation d’images masquées sur des caractéristiques CLIP | Recherche axée sur la précision et ajustement fin | Les grandes variantes sont lourdes à l’inférence |
| MobileNetV4 | CNN et modèle hybride (mobile) | Supervisé | Téléphones, NPU et accélérateurs en périphérie | Plafond de précision inférieur à celui des modèles de classe serveur | |
| ResNet | CNN | Microsoft Research | Supervisé | Références de base, enseignement, pipelines existants | N’est plus compétitif en précision par FLOP |
| SigLIP 2 | Vision-langage (ViT) | Paires image-texte, multilingues | Classification zéro-shot et à vocabulaire ouvert | Valide les résultats zéro-shot sur les classes visées avant de t’y fier | |
| Swin Transformer | ViT (hiérarchique) | Microsoft Research | Supervisé | Entrées à plus haute résolution, réutilisation du modèle de base | Plus lourd que les CNN à précision similaire |
| Ultralytics YOLO26-cls | CNN | Ultralytics | Supervisé sur ImageNet | Classificateurs personnalisés rapides, export vers les appareils en périphérie, une seule API pour la détection également | Plafond de précision inférieur à celui des grands Transformer préentraînés |
| ViT | ViT | Supervisé, souvent sur de grands jeux de données | Apprentissage par transfert à grande échelle | Nécessite beaucoup de données sans préentraînement à grande échelle |
Présentation détaillée des modèles#
Par ordre alphabétique.
ConvNeXt V2#
ConvNeXt V2 associe un auto-encodeur masqué entièrement convolutif (FCMAE) à une couche de normalisation de la réponse globale. Il existe en huit tailles, d’Atto (3,7 millions de paramètres) à Huge (660 millions), de sorte que cette famille couvre aussi bien les appareils en périphérie que les serveurs. C’est un excellent choix par défaut si tu veux une précision de l’ère des Transformer avec la facilité de déploiement d’un CNN. Compromis : le code est sous licence MIT, mais les poids préentraînés et ajustés sur ImageNet sont sous licence CC-BY-NC, ce qui exclut leur usage commercial.
DINOv3#
DINOv3 est le modèle de base de vision auto-supervisé de Meta. Il est proposé sous forme de modèles ViT allant de ViT-S/16 à ViT-7B/16, ainsi que de modèles ConvNeXt distillés destinés à une utilisation sur l’appareil. Meta l’évalue avec le modèle de base gelé, et le dépôt comprend une tête de classification ImageNet pour le modèle 7B. C’est le modèle à essayer si tu as peu d’étiquettes et que tu veux des caractéristiques transférables. Compromis : il est publié sous sa propre licence DINOv3 plutôt que sous une licence libre standard, et les résultats les plus remarquables proviennent du plus grand modèle.
EfficientNetV2#
EfficientNetV2 de Google utilise l’apprentissage progressif : la taille des images augmente pendant l’entraînement et la régularisation est ajustée en conséquence. Il s’entraîne ainsi plus rapidement et utilise moins de paramètres que les modèles précédents. Il reste un choix fiable pour l’ajustement fin sur des jeux de données petits ou moyens. Compromis : il est antérieur aux modèles de base de 2023 à 2025 et n’est plus en tête en matière de précision. Pour en savoir plus sur la conception originale, consulte notre présentation d’EfficientNet.
EVA-02#
EVA-02 est un Transformer standard préentraîné par modélisation d’images masquées pour reconstruire les caractéristiques d’un grand encodeur visuel CLIP. Ses quatre tailles vont de 6 à 304 millions de paramètres. Il est disponible dans timm pour l’ajustement fin. Compromis : les grandes variantes sont coûteuses à ajuster et à déployer, et elles sont surdimensionnées pour de simples classificateurs spécialisés.
MobileNetV4#
MobileNetV4 est la dernière famille mobile de Google, conçue pour fonctionner efficacement sur les CPU mobiles, les DSP, les GPU, l’Apple Neural Engine et le Google Pixel EdgeTPU. C’est le choix naturel pour un téléphone ou un accélérateur basse consommation. Compromis : il sacrifie la précision maximale au profit de la latence.
ResNet#
ResNet a introduit les connexions résiduelles et reste le modèle de référence standard, pris en charge par tous les frameworks. Compromis : les CNN plus récents offrent une meilleure précision pour une même puissance de calcul. Consulte ce qu’est ResNet-50 pour en savoir plus sur l’architecture.
SigLIP 2#
SigLIP 2 (voir l’entrée du glossaire consacrée à SigLIP) est la famille d’encodeurs de vision-langage multilingues de Google. Elle peut classer des images à partir d’une liste d’étiquettes textuelles sans entraînement (selon une approche similaire à CLIP), et sa variante NaFlex conserve le rapport hauteur/largeur natif de l’image d’entrée. C’est le meilleur choix si ton ensemble d’étiquettes change souvent ou si tu ne disposes pas encore de données étiquetées. Compromis : la qualité zéro-shot varie selon le domaine ; valide donc les classes visées (par exemple, les types de défauts) avant de t’y fier. Si les résultats sont insuffisants, entraîne une tête de classification ou effectue un ajustement fin.
Swin Transformer#
Swin Transformer calcule l’attention dans des fenêtres locales décalées, ce qui maintient le coût de calcul proportionnel à la taille de l’image et convient aux entrées à plus haute résolution. Compromis : il est plus lourd qu’un CNN de précision similaire ; ConvNeXt a été conçu pour rivaliser avec lui au moyen de convolutions standard.
Ultralytics YOLO26-cls#
Ultralytics YOLO26-cls est la variante de classification d’Ultralytics YOLO26. Elle existe en cinq tailles (n, s, m, l, x), de 2,8 à 29,6 millions de paramètres (après fusion), accepte des entrées de 224 pixels et est préentraînée sur ImageNet. La documentation indique les précisions top-1 et top-5 sur l’ensemble de validation ImageNet, ainsi que la latence CPU et GPU pour chaque taille. La même API Python et le même CLI permettent d’entraîner, de valider et d’exporter des modèles de classification, de détection, de segmentation et d’estimation de pose ; les classificateurs peuvent être exportés vers des formats comme ONNX, TensorRT, Core ML, OpenVINO et LiteRT. Les anciens modèles YOLO11-cls utilisent les mêmes cinq tailles et la même taille d’entrée. Compromis :
- Plafond de précision. Même le modèle x est petit comparé aux grands Transformer préentraînés comme EVA-02 ou DINOv3 ; ce n’est donc pas le bon choix pour la recherche axée sur la précision.
- Recadrages carrés par défaut. L’entraînement utilise un recadrage redimensionné aléatoire et la validation un recadrage centré, ce qui peut couper des parties des images aux rapports hauteur/largeur extrêmes. La documentation explique comment utiliser un simple redimensionnement à la place.
- Licence. Les modèles Ultralytics sont sous licence AGPL-3.0. Une utilisation commerciale en code source fermé nécessite une licence Ultralytics Enterprise.
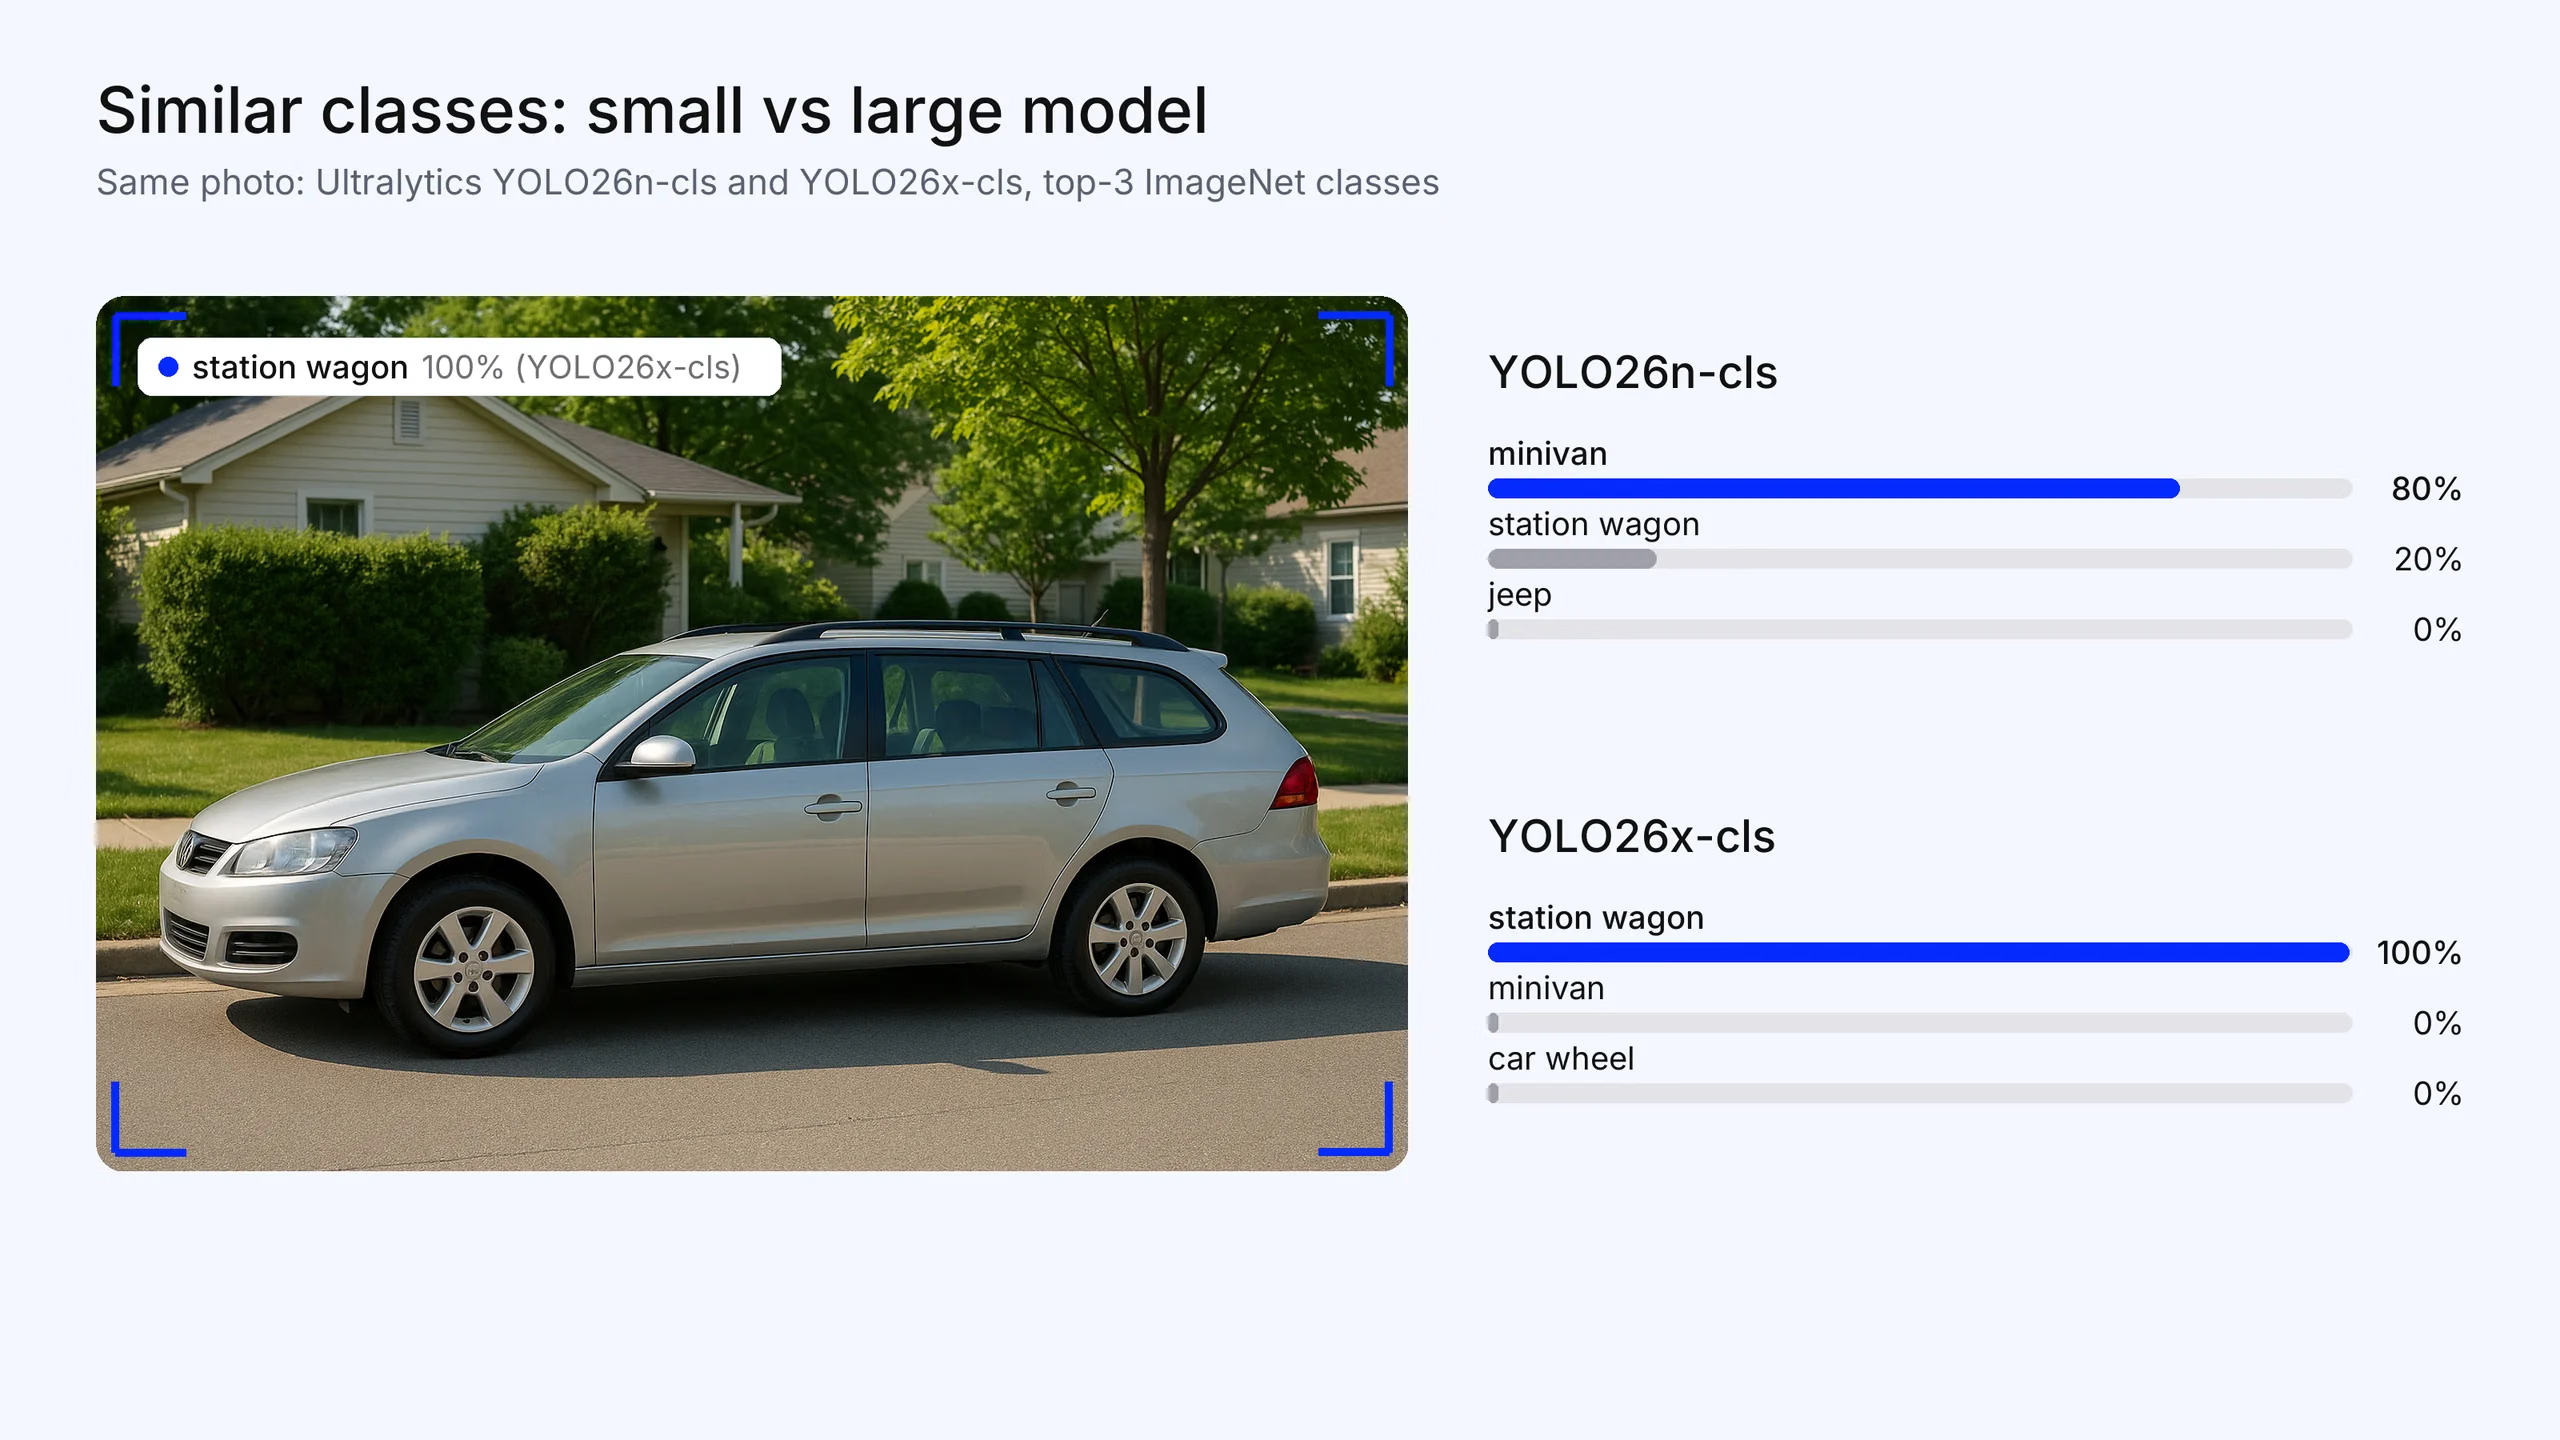
Fig. 2. C'est avec des classes similaires que la taille du modèle fait la différence. Sur cette photo d'un break, Ultralytics YOLO26n-cls classe « minivan » en premier (80 %), tandis que YOLO26x-cls classe le break en premier (100 %, sous la classe ImageNet « beach wagon, station wagon »). Vérifie les classes fines de ce type sur ton propre ensemble de validation. La photo a été générée pour cet article ; les prédictions sont de véritables sorties du modèle.
ViT#
Le Vision Transformer original de Google a montré qu'un Transformer pur appliqué à des patches d'image peut égaler ou dépasser les CNN lorsqu'il est préentraîné sur de grandes quantités de données. Compromis : sans préentraînement à grande échelle, il est moins performant que les CNN sur les petits jeux de données et nécessite davantage de calcul à l'inférence.
Comment choisir un modèle de classification d'images#
Passe ces questions en revue dans l'ordre :
- As-tu des données annotées ? Si tu n'as aucun exemple annoté, commence par un modèle vision-langage comme SigLIP 2 pour la classification zero-shot. Avec un petit jeu de données annoté, évalue aussi un backbone DINOv3 gelé avec une tête linéaire entraînée.
- Où le modèle sera-t-il exécuté ? Sur un téléphone ou un NPU, sélectionne MobileNetV4 ou un petit CNN comme YOLO26n-cls ou un petit ConvNeXt V2. Pour une inférence en temps réel sur un GPU edge ou un CPU, examine YOLO26-cls, EfficientNetV2 ou ConvNeXt V2. Sur un serveur sans contrainte stricte de latence, envisage EVA-02, Swin ou un ViT DINOv3.
- Combien de données annotées as-tu par classe ? Avec quelques centaines à quelques milliers d'images, l'apprentissage par transfert à partir d'un CNN préentraîné ou d'un backbone auto-supervisé gelé est la solution la plus sûre. À partir de dizaines de milliers d'images, voire plus, le réglage fin complet des Transformers devient intéressant.
- Peux-tu utiliser la licence ? Vérifie les poids, pas seulement le code : les poids ImageNet de ConvNeXt V2 ne sont pas destinés à un usage commercial, DINOv3 a sa propre licence et les modèles Ultralytics sont sous AGPL-3.0, sauf si tu détiens une licence Enterprise.
- Le modèle s'exporte-t-il vers ton environnement d'exécution ? Confirme qu'il existe une voie prise en charge vers ONNX, TensorRT, Core ML ou TFLite avant de t'engager.
Ensuite, affine deux ou trois modèles présélectionnés et compare-les sur ton propre sous-ensemble de validation.
Quand un autre modèle sera plus adapté que YOLO#
YOLO26-cls est conçu pour créer des classificateurs personnalisés rapides et faciles à déployer. Pour certains besoins, un autre modèle est plus adapté :
- Recherche axée sur la précision ou travaux de benchmark : utilise EVA-02, ConvNeXt V2 ou un ViT via timm, pour lesquels il existe des recettes et des poids permettant de reproduire les résultats de niveau ImageNet.
- Très peu d'annotations ou de nombreuses tâches en aval à partir d'un même backbone : utilise les caractéristiques DINOv3 avec une tête linéaire.
- Ensembles d'étiquettes ouverts ou qui changent fréquemment : utilise SigLIP 2 en zero-shot.
- NPU de téléphone, comme Apple Neural Engine ou EdgeTPU : MobileNetV4 a été conçu et testé précisément sur ces cibles.
Si tu dois aussi localiser les objets, et pas seulement savoir ce que montre l'image, il te faut un détecteur. Consulte notre comparaison des modèles de détection d'objets.
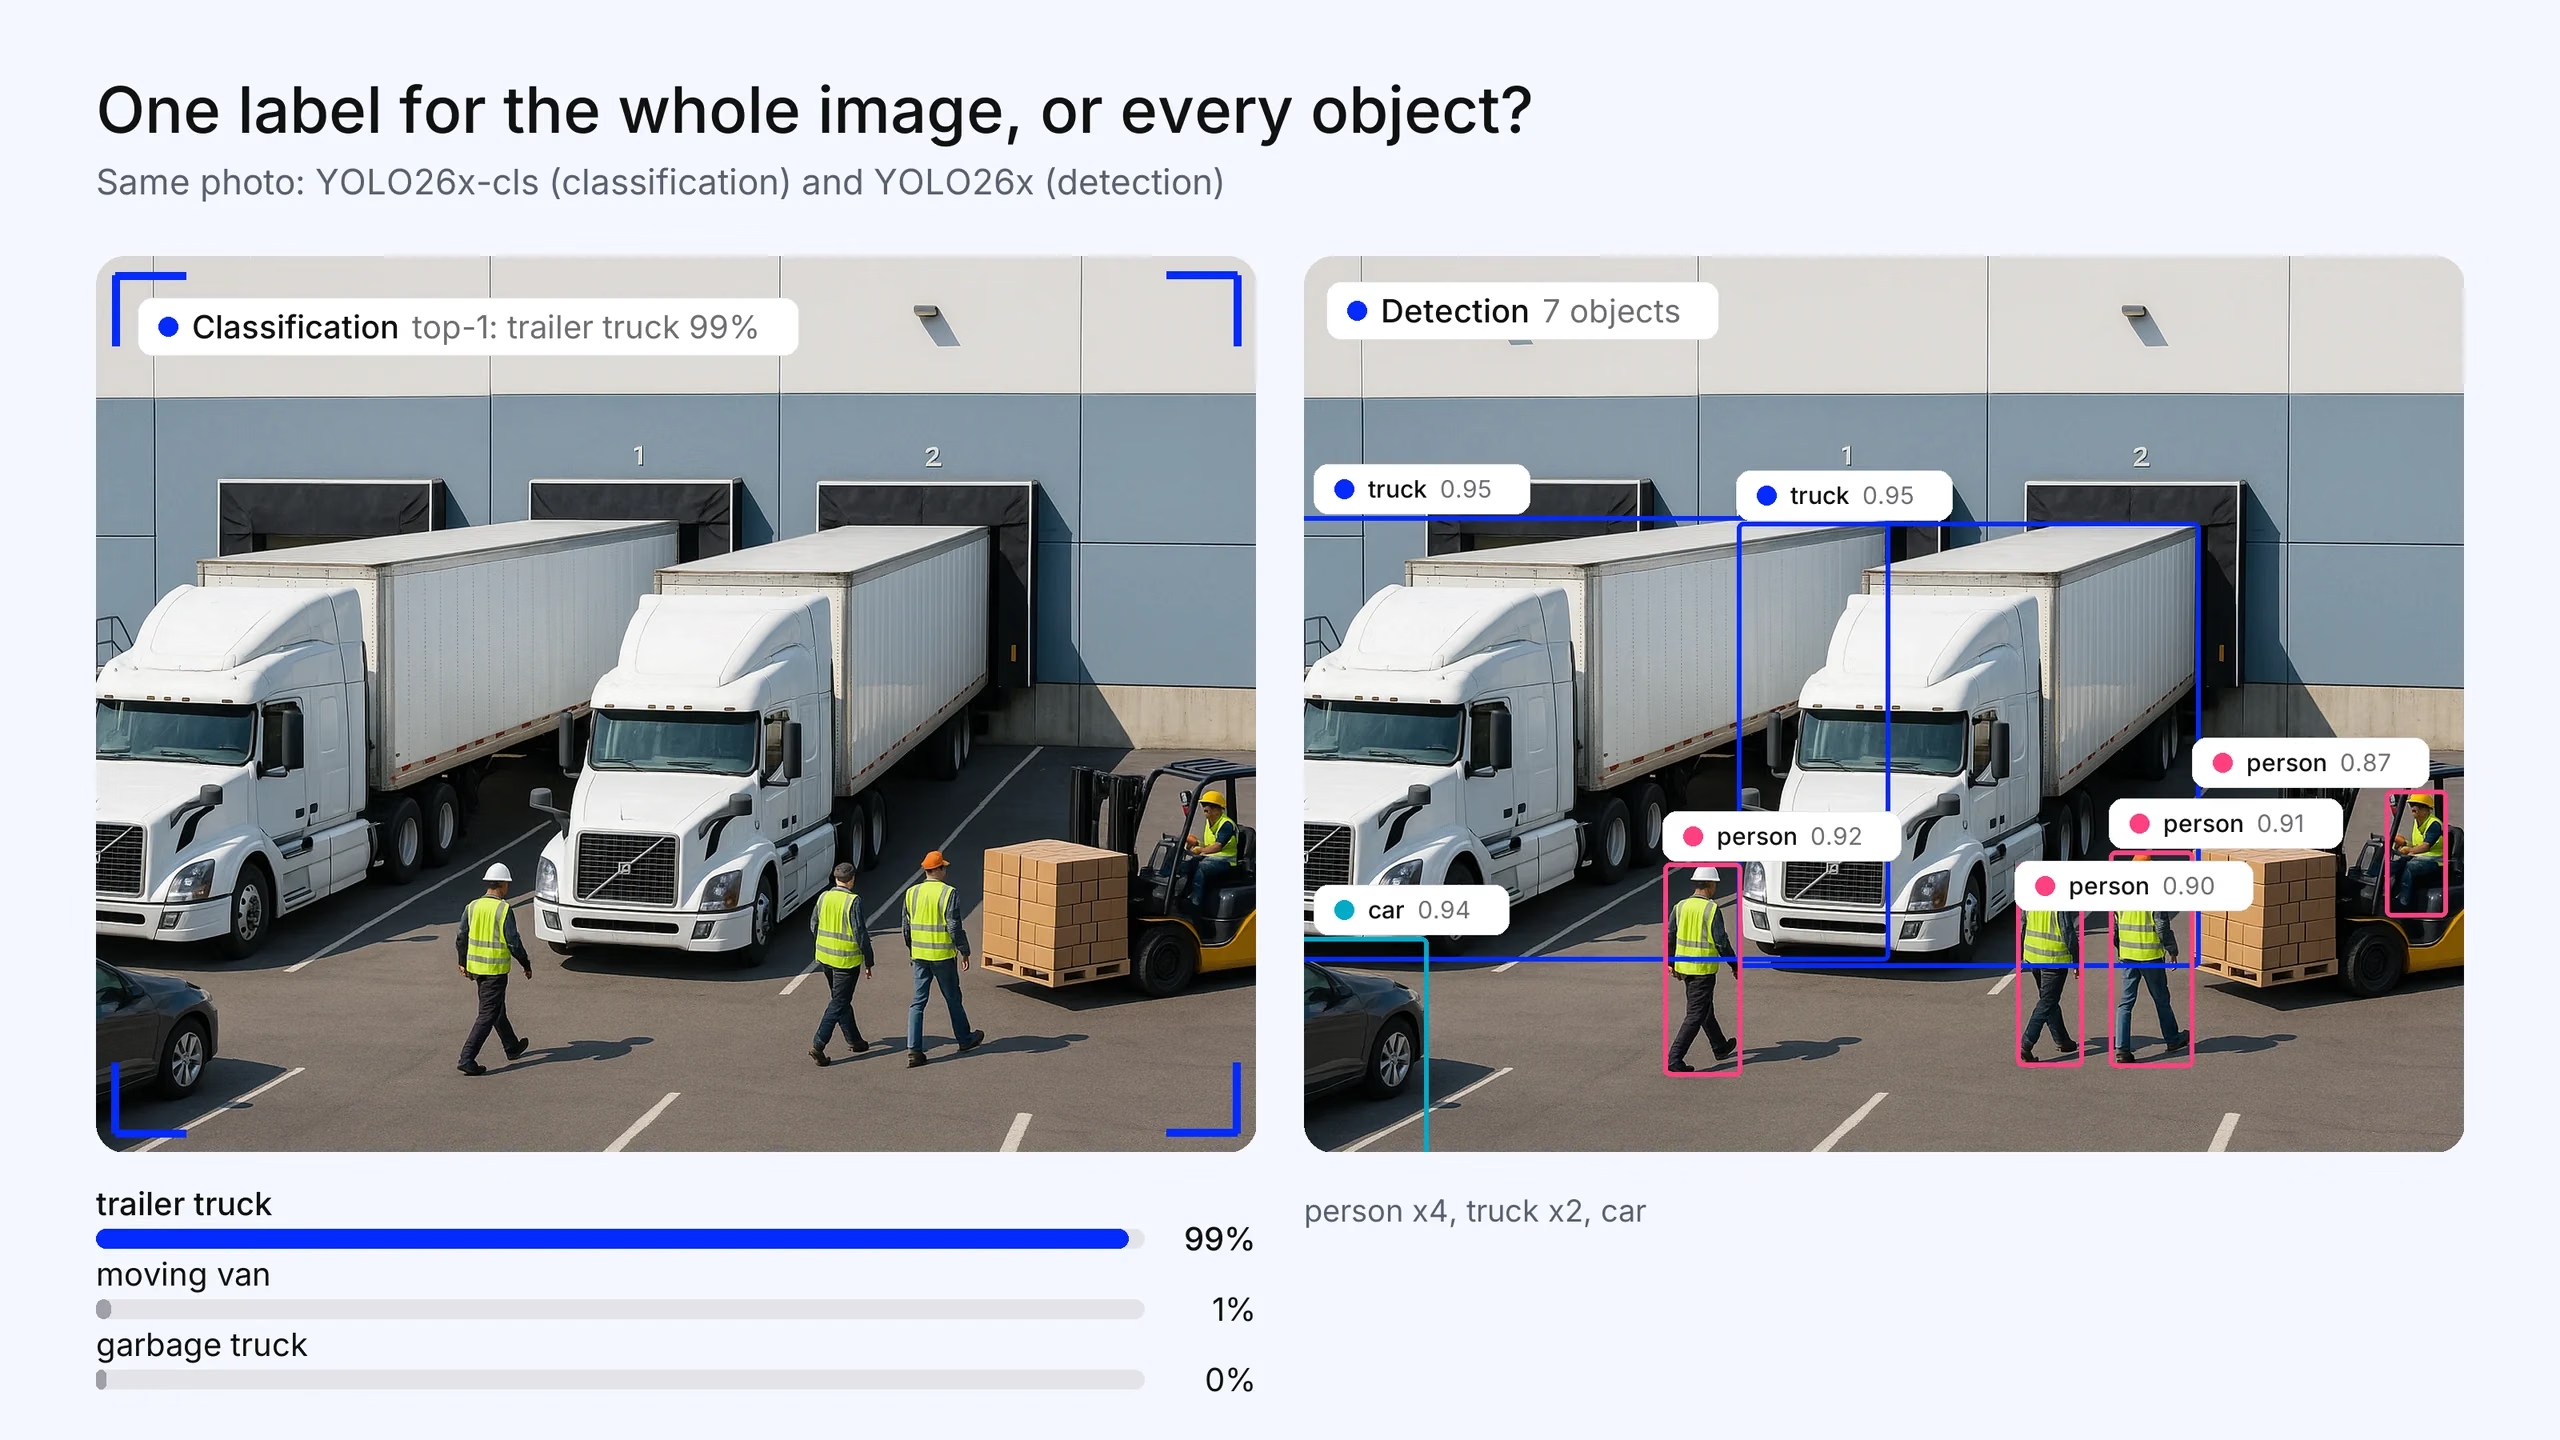
Fig. 3. Dans une scène avec de nombreux objets, un classificateur renvoie toujours une seule étiquette : Ultralytics YOLO26x-cls classe cette cour de triage comme « trailer truck » avec une confiance de 99 %. Ultralytics YOLO26x detection repère 7 objets : 4 personnes, 2 camions et une voiture, chacun dans sa propre boîte (confiance de 0,5 ou plus). La photo a été générée pour cet article ; les résultats sont réels.
Où trouver des modèles préentraînés et entraîner les tiens#
- timm (PyTorch Image Models) rassemble la plupart des backbones ci-dessus, de ViT et ConvNeXt à MobileNetV4, EVA et DINOv3, avec des scripts d'entraînement et d'évaluation. Le code est sous Apache 2.0 ; les licences des poids varient.
- Hugging Face héberge la plupart des classificateurs Transformer, notamment SigLIP 2 et DINOv3, avec des pipelines prêts à l'emploi pour le zero-shot et la classification d'images.
- Le package Python Ultralytics entraîne YOLO26-cls à partir d'un dossier d'images triées par classe. Consulte le format des jeux de données de classification et le guide de la tâche de classification.
- Ultralytics Platform ajoute l'annotation et l'entraînement dans le cloud pour ces mêmes modèles. Lancée en 2026, elle est plus récente que les services d'entraînement hébergés déjà établis. Pour servir des modèles après leur entraînement, consulte notre comparaison des plateformes d'inférence en vision par ordinateur.
Foire aux questions
Il n'y en a pas un qui convienne à tous les cas. Pour les travaux axés sur la précision et disposant de ressources de calcul suffisantes, les grands backbones Transformer et auto-supervisés comme EVA-02 et DINOv3 sont les premières options à évaluer. Pour la production sur du matériel limité, les CNN comme ConvNeXt V2, EfficientNetV2, MobileNetV4 et Ultralytics YOLO26-cls sont plus pratiques. Pour la classification sans données annotées, SigLIP 2 permet le zero-shot.
Les Transformers ont tendance à l'emporter lorsqu'ils sont préentraînés sur de très grands jeux de données et que les ressources de calcul ne sont pas limitées. Les CNN ont tendance à l'emporter sur les jeux de données petits à moyens et sur le matériel edge, car leurs hypothèses intégrées sur la structure locale les rendent économes en données et rapides. Les CNN modernes comme ConvNeXt ont réduit l'écart de précision, et les modèles hybrides comme CoAtNet combinent les deux approches.
Oui. DINOv3 est un backbone polyvalent. Tu extrais les caractéristiques avec le modèle gelé, puis tu entraînes un petit classificateur linéaire par-dessus. Le dépôt de Meta inclut une tête de classification ImageNet pour son plus grand modèle. Vérifie la licence DINOv3 avant tout usage commercial.
Principalement avec la précision top-1 (la prédiction ayant le score le plus élevé est correcte) et la précision top-5 (la classe correcte figure parmi les cinq prédictions ayant les scores les plus élevés), généralement sur l'ensemble de validation ImageNet. Pour les jeux de données personnalisés déséquilibrés, la précision, le rappel ou le score F1 par classe sont plus informatifs que la précision globale.









