Segmentation sémantique ou segmentation d’instances : comment choisir la bonne tâche
La segmentation sémantique attribue une classe à chaque pixel ; la segmentation d’instances distingue chaque objet. Découvre laquelle convient à ton projet de vision par ordinateur, et pourquoi.
La segmentation sémantique et la segmentation d'instances attribuent toutes deux une étiquette aux images au niveau du pixel, mais répondent à des questions différentes. La segmentation sémantique attribue une classe à chaque pixel : toutes les voitures d'une scène forment donc une seule région « voiture ». La segmentation d'instances distingue chaque objet, de sorte que chaque voiture reçoit son propre masque. Le choix dépend d'une seule question : dois-tu savoir ce qu'est chaque pixel ou à quel objet chaque pixel appartient ? Ce guide t'aide à faire ce choix. Il explique aussi le coût d'annotation de chaque tâche et la manière de les évaluer. Ultralytics YOLO prend en charge les deux tâches dans le même framework.
La différence en une phrase#
- La segmentation sémantique classe chaque pixel dans une catégorie, comme la route, le ciel, une personne ou une voiture. Les objets d'une même classe fusionnent en une seule région. Consulte l'entrée du glossaire sur la segmentation sémantique.
- La segmentation d'instances repère chaque objet individuellement et lui attribue son propre masque et son propre ID. Elle concerne généralement les objets dénombrables et ignore l'arrière-plan, comme le ciel ou l'herbe. Consulte l'entrée du glossaire sur la segmentation d'instances.
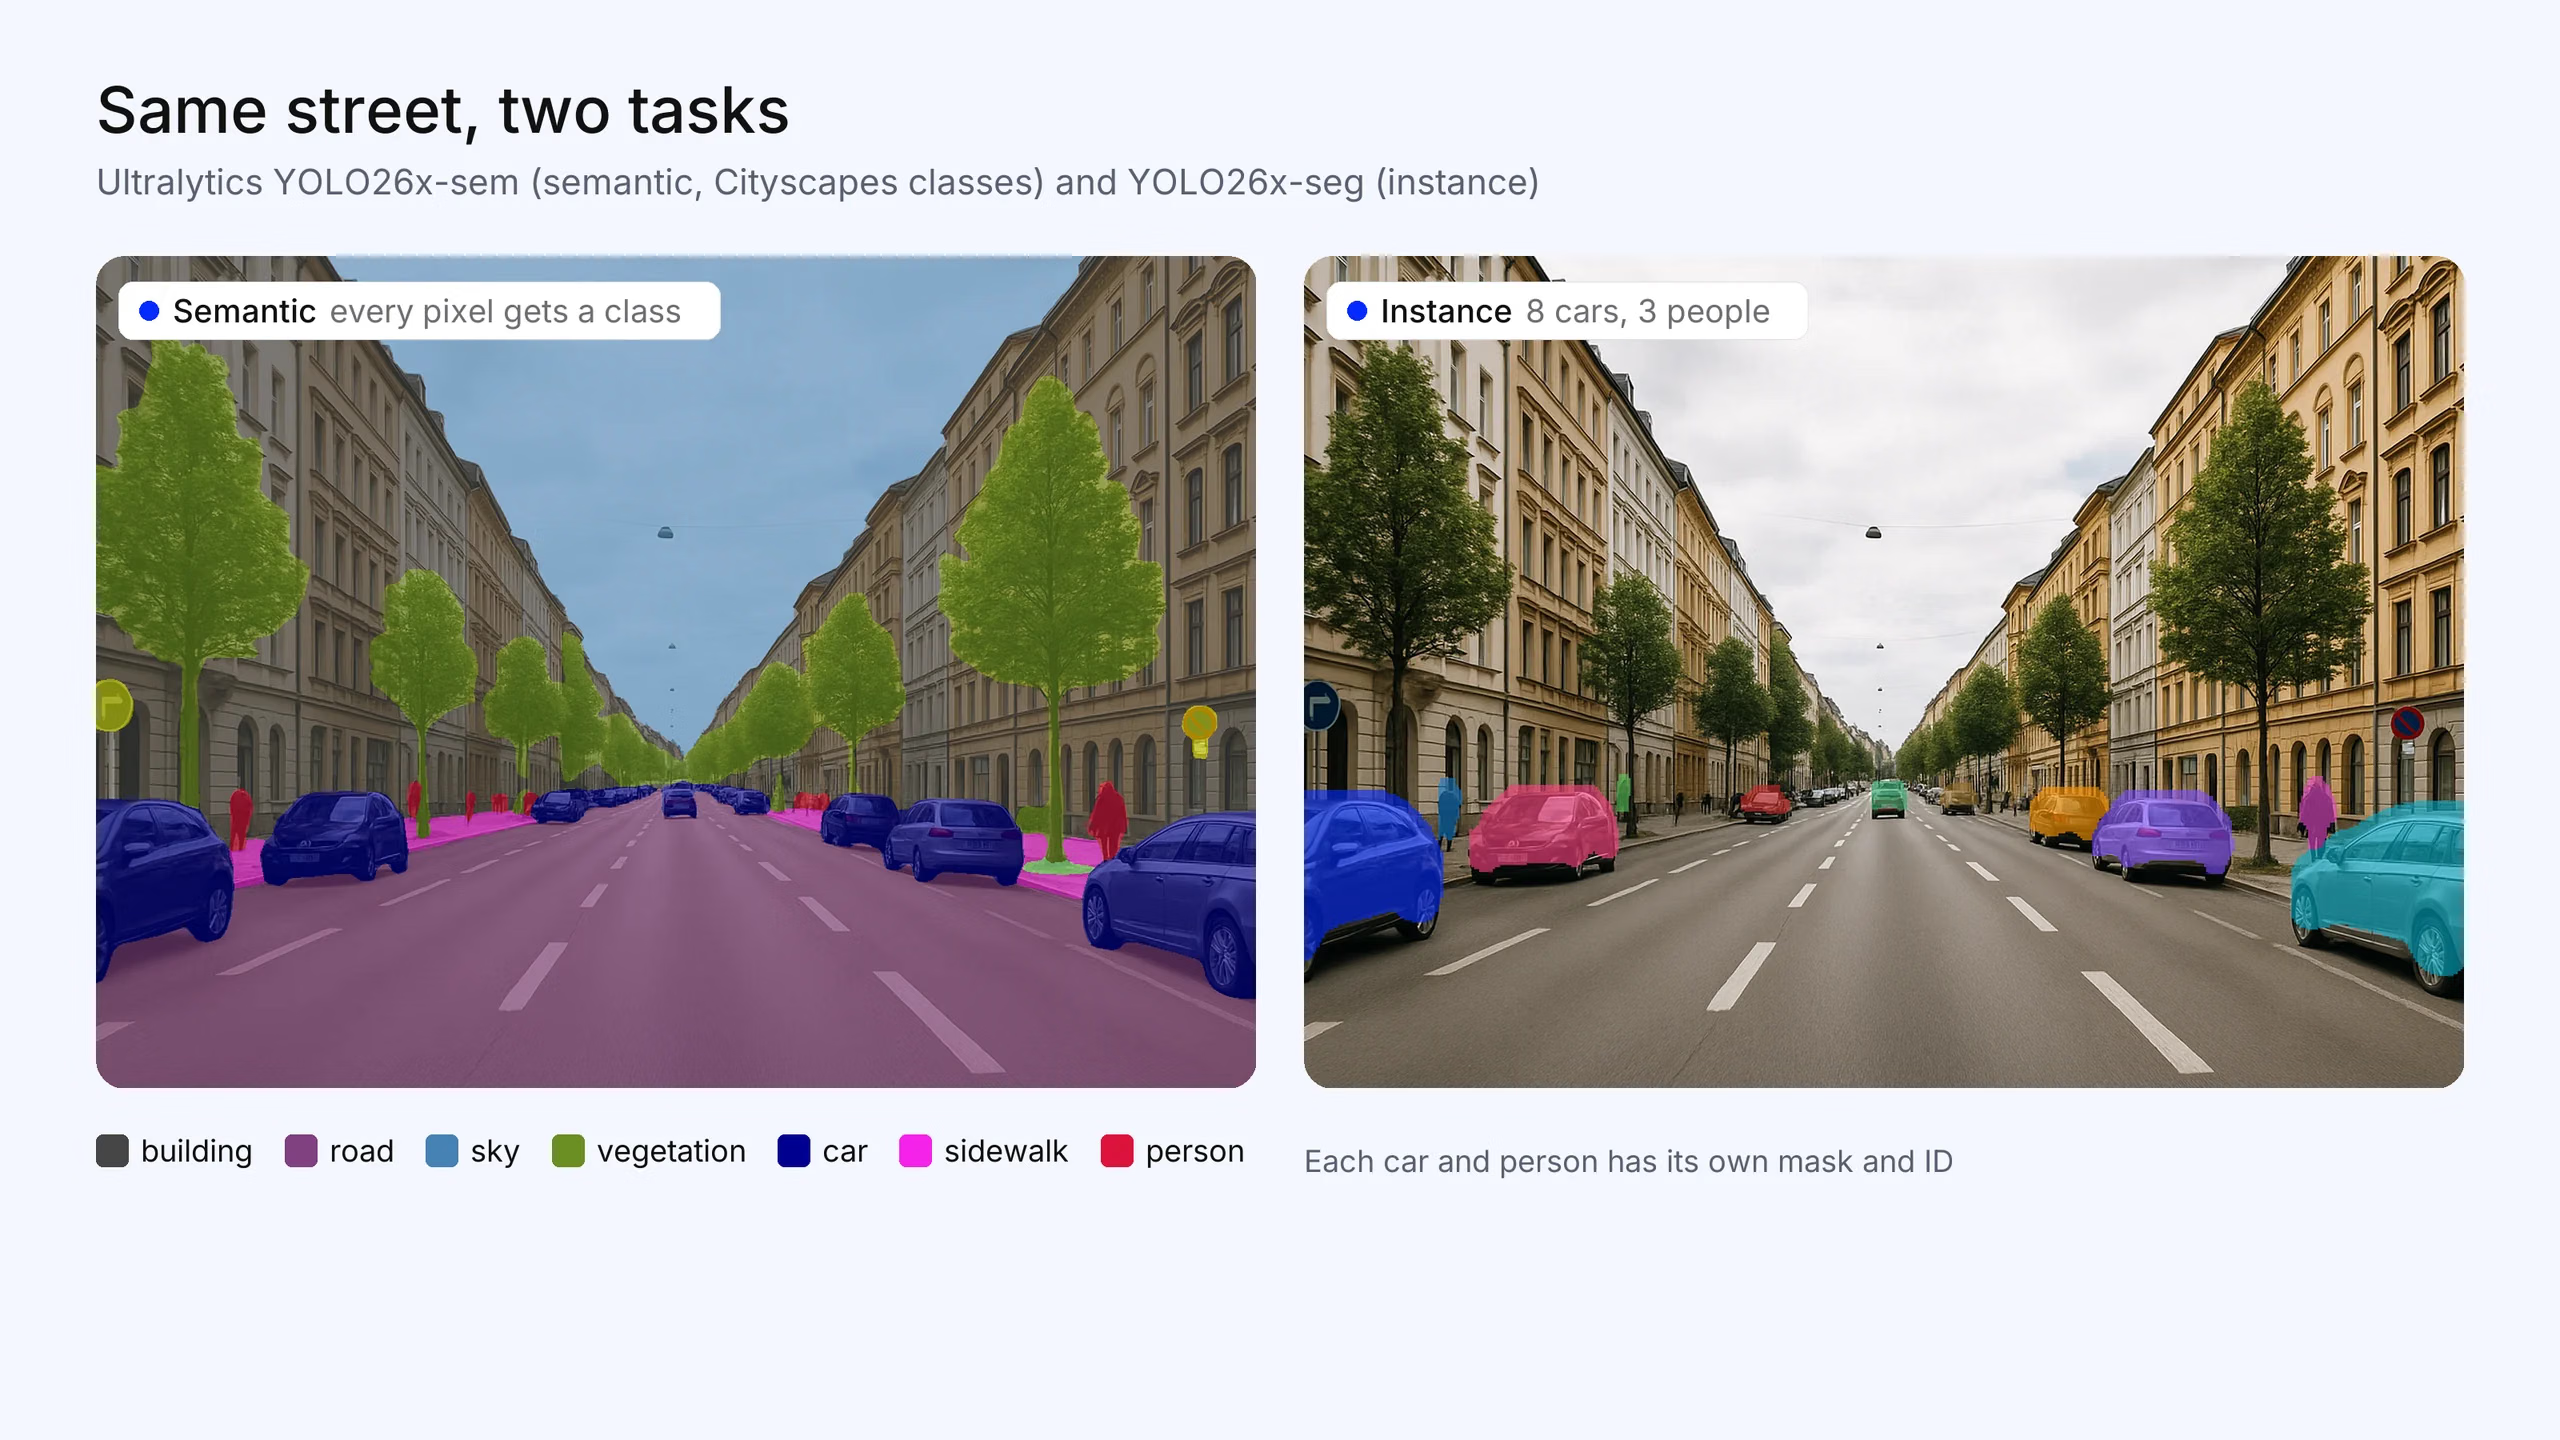
Fig. 1. La même rue traitée par les deux tâches. Ultralytics YOLO26x-sem (classes Cityscapes) étiquette chaque pixel : toutes les voitures partagent donc la classe « voiture ». Ultralytics YOLO26x-seg attribue son propre masque à chacune des 8 voitures et des 3 personnes détectées (confiance de 0,5 ou plus). La photo a été générée pour cet article ; les masques sont de véritables sorties du modèle.
De quelle tâche ton projet a-t-il besoin ?#
Commence par la question à laquelle ton application doit répondre :
| Si ton application doit… | Utilise | Exemple |
|---|---|---|
| Savoir quelle part de la scène correspond à une classe donnée | Sémantique | Zone de chaussée praticable, couverture des cultures par rapport aux mauvaises herbes, occupation des sols |
| Étiqueter les régions d'arrière-plan aussi soigneusement que les objets | Sémantique | Ciel, eau, végétation, types de tissus dans une image médicale |
| Compter les objets | D'instances | Fruits sur un arbre, personnes dans une file d'attente |
| Suivre les objets d'une image vidéo à l'autre | D'instances, avec un traqueur | Personnes ou véhicules qui se déplacent dans une scène |
| Mesurer un objet ou agir sur lui individuellement | D'instances | Un robot qui prélève une pièce dans un tas, mesurer chaque défaut |
| Faire les deux : couvrir toute la scène et distinguer les objets | Panoptique | Scènes de rue pour la conduite autonome |
Si tu hésites, demande-toi s'il faut distinguer deux objets de même classe qui se touchent. Si oui, tu as besoin de la segmentation d'instances (ou panoptique). Sinon, la segmentation sémantique est plus simple et généralement moins coûteuse à exécuter.
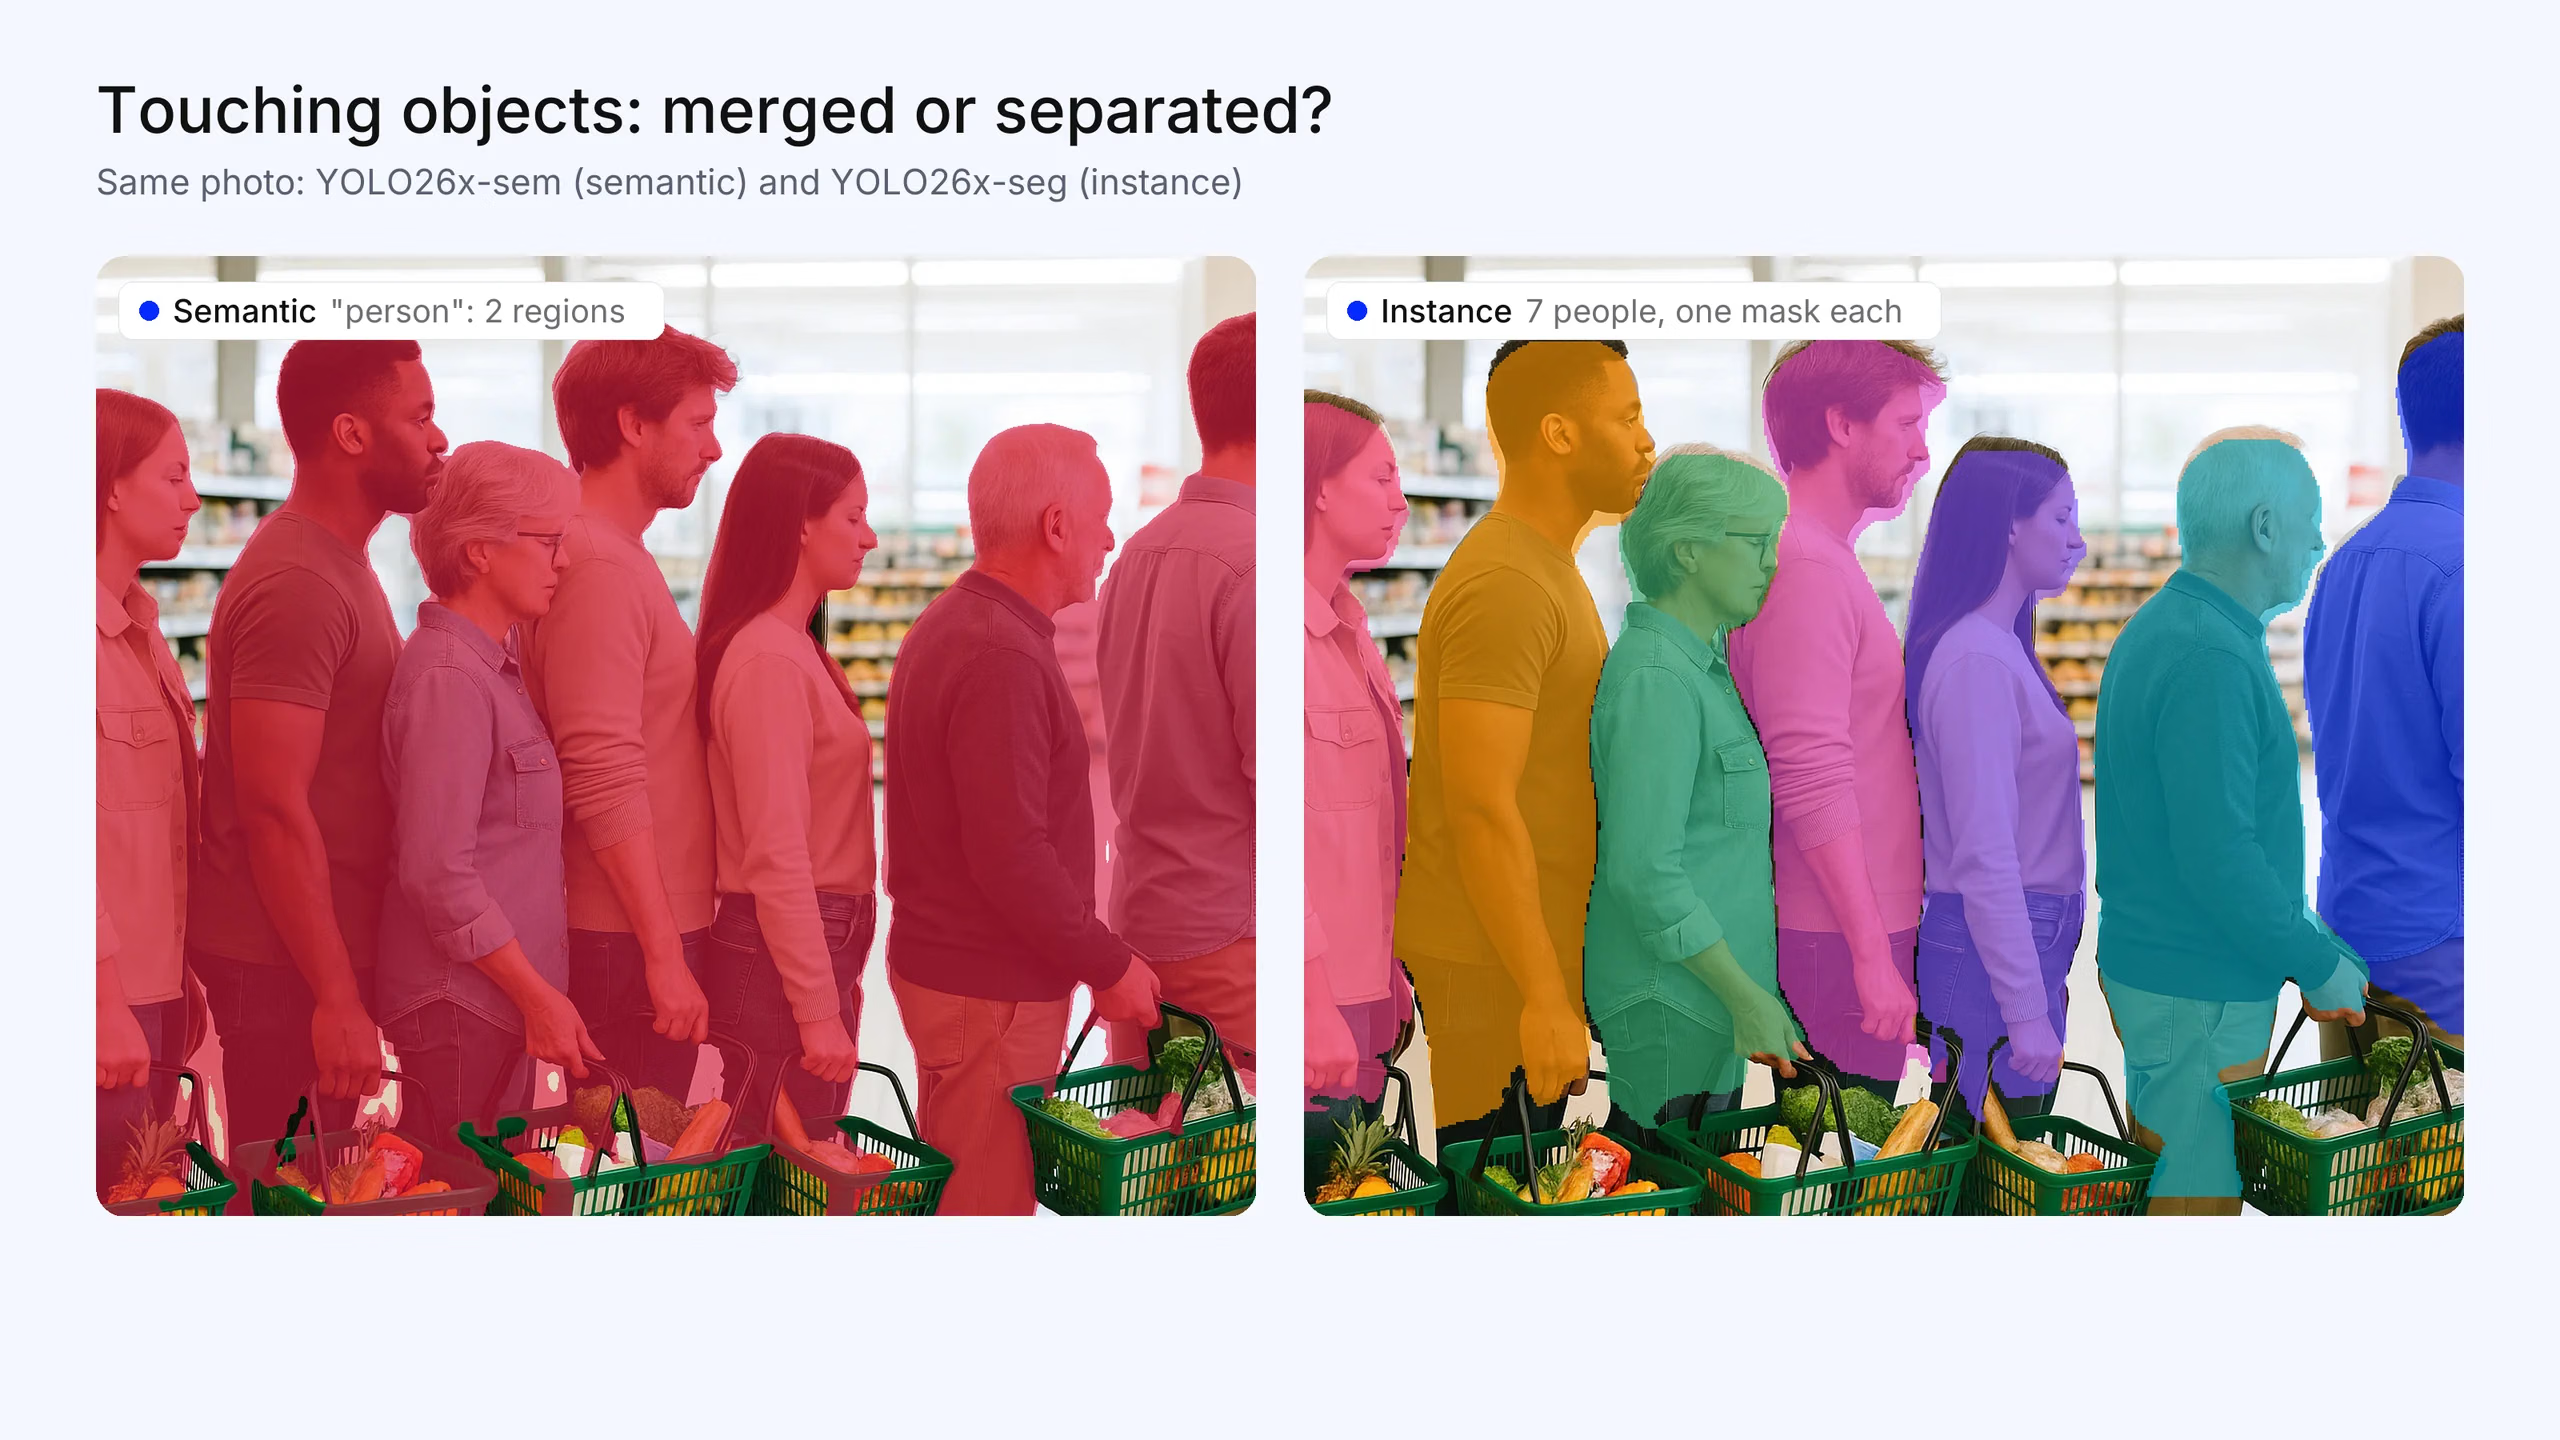
Fig. 2. Sept clients serrés les uns contre les autres dans une file à la caisse. Dans le résultat sémantique (Ultralytics YOLO26x-sem), ils fusionnent en deux régions connectées « personne » ; tu ne peux donc pas les compter à partir de ce résultat. Le résultat par instances (Ultralytics YOLO26x-seg) les sépare tous les 7. La photo a été générée pour cet article ; les masques sont de véritables sorties du modèle.
Principales différences en un coup d'œil#
| Critère | Segmentation sémantique | Segmentation d’instances |
|---|---|---|
| Question à laquelle on répond | Quelle est la classe de chaque pixel ? | À quel objet chaque pixel appartient-il ? |
| Objets de même classe | Fusionnés en une seule région | Séparés, chacun avec son propre masque et son propre ID |
| Couverture | Chaque pixel, y compris l'arrière-plan | Généralement, uniquement les objets d'intérêt |
| Sortie | Une carte de classes de la taille de l'image | Une liste de masques, chacun associé à une classe et à un score de confiance |
| Peut-on compter les objets ? | Pas directement | Oui |
| Métrique principale | Intersection moyenne sur l'union (mIoU) | Précision moyenne des masques (mask mAP) |
| Complexité relative | Plus faible : classification pixel par pixel | Plus élevée : détection et masques par objet |
Coût d'annotation de chaque tâche#
En pratique, c'est souvent l'effort d'annotation qui détermine le choix.
- Les jeux de données sémantiques attribuent une classe à chaque pixel de chaque image, arrière-plan compris. Ils sont généralement stockés sous forme d'images de masque à un seul canal. Chaque image est entièrement annotée : aucun pixel ne peut être ignoré, sauf s'il est explicitement marqué « ignore ».
- Les jeux de données d'instances délimitent séparément chaque objet d'intérêt, sous forme de polygone ou de masque. L'arrière-plan peut rester non annoté, mais chaque objet doit avoir son propre contour, et les scènes encombrées multiplient le travail.
Les deux tâches demandent beaucoup de travail. L'annotation assistée, où un clic ou une boîte devient un masque, réduit les efforts dans les deux cas. Si tu as seulement besoin de réponses à l'échelle des régions, ne paie pas pour des annotations par instance.
Comment évaluer chaque tâche#
- La segmentation sémantique est principalement évaluée avec mIoU : le chevauchement entre les régions prédites et les régions réelles, moyenné sur les classes. La précision au niveau des pixels est également indiquée. IoU désigne la même mesure de chevauchement que celle utilisée en détection.
- La segmentation d'instances est évaluée avec la mask mAP, la précision moyenne utilisée en détection, mais calculée à partir du chevauchement des masques. Elle récompense la détection de chaque objet, et pas seulement la couverture des bons pixels.
Ces métriques ne sont pas comparables entre elles. Un mIoU élevé ne dit rien sur la séparation des objets individuels.
Segmentation panoptique : quand tu as besoin des deux#
La segmentation panoptique attribue une classe à chaque pixel et, pour les objets dénombrables, un ID d'instance. Les éléments d'arrière-plan, comme la route et le ciel, sont étiquetés sémantiquement. Les objets au premier plan, comme les voitures et les personnes, sont séparés un à un. La métrique utilisée est la qualité panoptique (PQ). Choisis cette approche lorsque tu as besoin à la fois d'une couverture complète de la scène et d'une séparation par objet. Consulte la segmentation panoptique.
Fonctionnement de chaque méthode, en bref#
Les modèles de segmentation sémantique sont généralement des réseaux encodeur-décodeur qui prédisent une classe pour chaque pixel. U-Net, DeepLab et SegFormer en sont des exemples bien connus. Les modèles de segmentation d'instances s'appuient généralement sur la détection d'objets. Mask R-CNN prédit un masque à l'intérieur de chaque boîte détectée, tandis que les modèles à une seule étape comme YOLACT et les modèles de segmentation Ultralytics YOLO prédisent les boîtes et les masques en un seul passage, pour une utilisation en temps réel. Les architectures universelles comme Mask2Former gèrent la segmentation sémantique, d'instances et panoptique dans un seul modèle. Pour en savoir plus sur la segmentation d'instances, consulte qu'est-ce que la segmentation d'instances.
Les deux tâches dans Ultralytics YOLO#
Ultralytics YOLO exécute les deux tâches avec la même API Python et le même CLI :
- La segmentation d’instances utilise la tâche
segment. - La segmentation sémantique utilise la tâche
semantic. Les modèles sémantiques YOLO26 portent le suffixe-semet sont préentraînés sur Cityscapes et ADE20K. La page de la tâche comprend un tableau qui montre exactement en quoi les sorties des deux tâches diffèrent dans le code.
Les deux tâches peuvent être entraînées localement ou dans le cloud sur Ultralytics Platform.
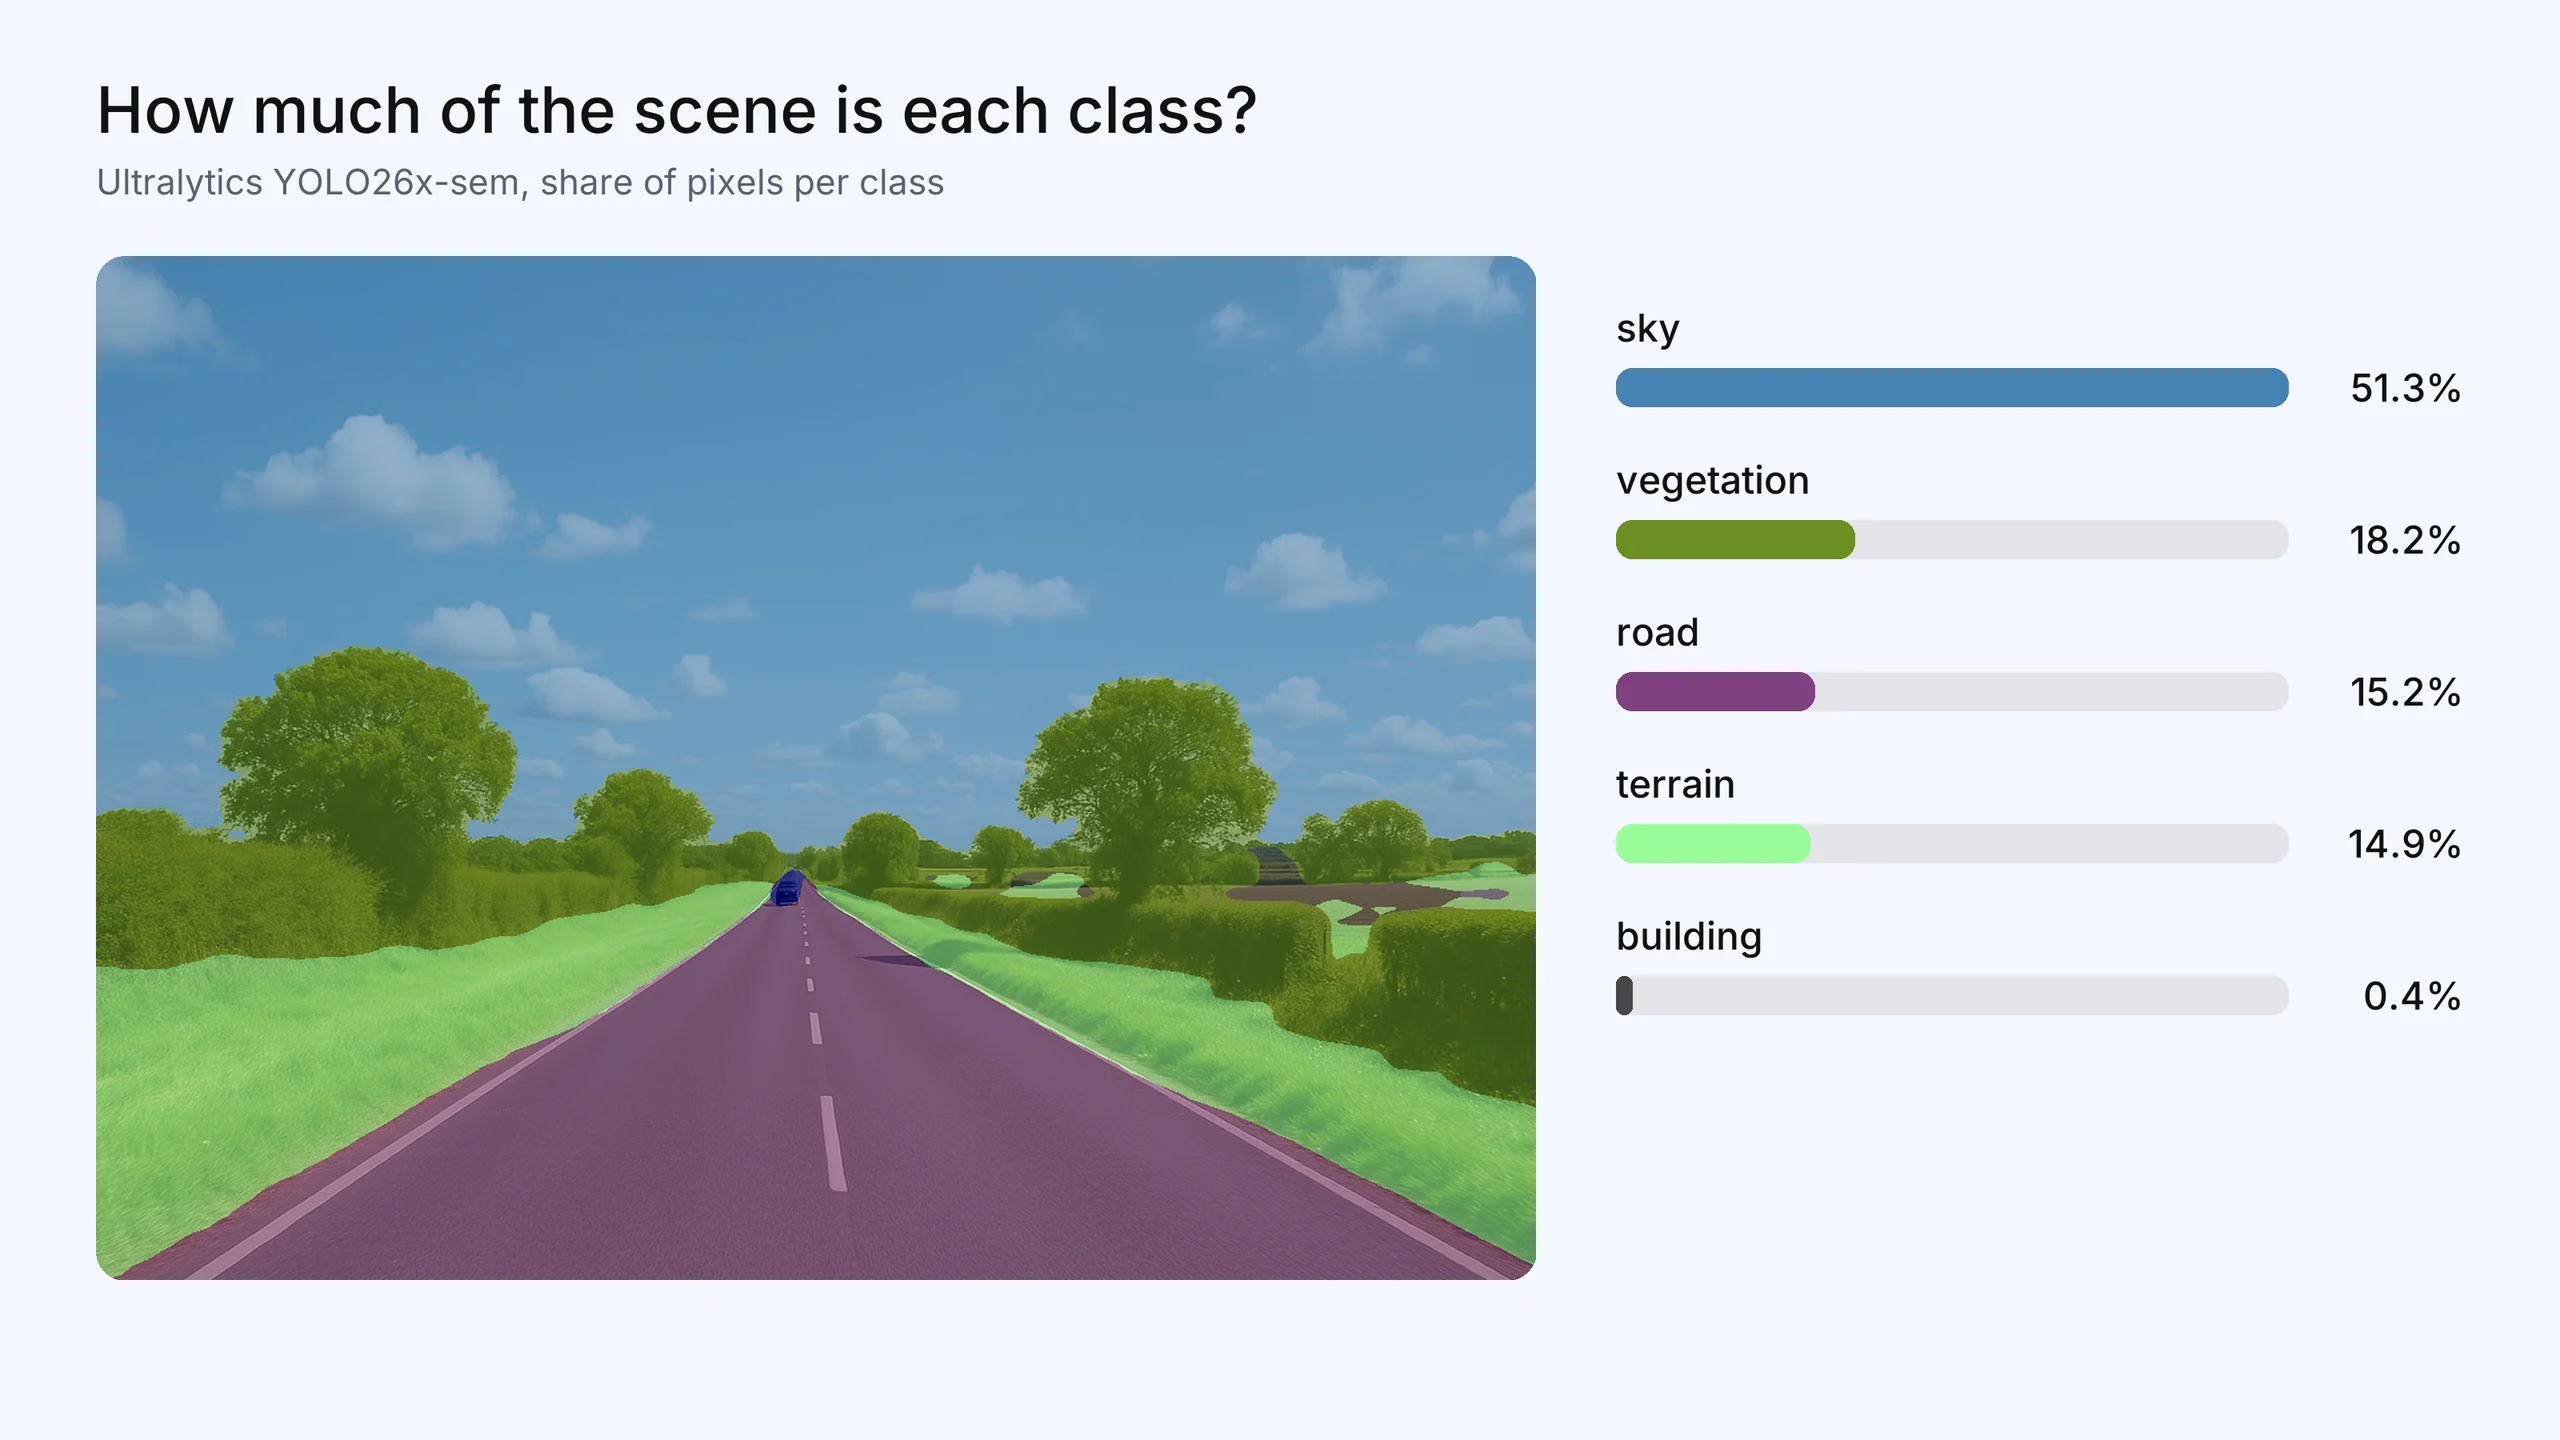
Fig. 3. La segmentation sémantique répond à la question « quelle part de la scène correspond à chaque classe ? ». YOLO26x-sem d’Ultralytics étiquette 51,3 % de cette vue comme ciel, 18,2 % comme végétation, 15,2 % comme route et 14,9 % comme terrain. La photo a été générée pour cet article ; la carte des classes et les proportions proviennent de véritables sorties du modèle.
Foire aux questions
La segmentation sémantique attribue une classe à chaque pixel, mais regroupe tous les objets d’une même classe dans une seule région. La segmentation d’instances sépare chaque objet dans son propre masque, ce qui permet de compter et de suivre individuellement les objets d’une même classe.
Demande-toi s’il faut distinguer deux objets de la même classe qui se touchent. Si tu dois compter, suivre ou traiter des objets individuellement, utilise la segmentation d’instances. Si tu as seulement besoin de savoir à quelle classe appartiennent les différentes régions, la segmentation sémantique est plus simple.
Mask R-CNN est un modèle de segmentation d’instances. Il détecte chaque objet, puis prédit un masque de pixels distinct à l’intérieur de la boîte englobante de cet objet.
La segmentation d’instances est généralement plus difficile. Elle doit classifier les pixels et séparer les objets d’une même classe, ce qui nécessite à la fois de la détection et de la segmentation.
Principalement avec l’intersection sur union moyenne (mIoU), qui mesure le chevauchement moyen entre les régions prédites et les régions de référence pour l’ensemble des classes. La segmentation d’instances utilise la mAP des masques, tandis que la segmentation panoptique utilise la qualité panoptique (PQ).









