Détection des petits objets avec le découpage des images en tuiles dans Ultralytics YOLO, de Python à Rust
Découvre quand le découpage en tuiles aide YOLO à détecter les petits objets, compare son coût et lance l’inférence intégrée par tuiles en Python ou en Rust sans SAHI.
 Onuralp Sezer17 min de lecture
Pourquoi un détecteur qui fonctionne bien sur des photos ordinaires manque-t-il la plupart des personnes dans une image de drone ? Souvent parce qu’il ne les voit jamais à leur taille réelle. Avec la valeur par défaut imgsz=640, Ultralytics YOLO réduit une image de 1920 x 1080 trois fois avant que le modèle ne l’examine : un piéton de 15 pixels de haut n’en fait alors qu’environ 5.
Le découpage en tuiles peut préserver les détails des petits objets en exécutant le modèle sur des fenêtres qui se chevauchent dans l’image en pleine résolution, puis en fusionnant les résultats. Sur une image VisDrone présentée dans notre documentation, cela a fait passer Ultralytics YOLO26s de 35 à 161 détections. Le prix à payer est une charge de calcul supérieure par image : huit entrées de tuile au lieu d’une seule image.
Le découpage en tuiles est désormais intégré aux deux extrémités du déploiement. Le package Python dispose de l’argument tile depuis Ultralytics 8.4.204, le 6 novembre, et le crate Rust a ajouté l’option --tile dans Ultralytics Inference 0.0.57, le 9 novembre. Ce guide explique quand le découpage en tuiles permet de récupérer les petits objets, quel est son coût et comment l’exécuter dans chacun de ces environnements.
Le redimensionnement masque les petits objets#
La détection des petits objets est difficile pour une raison simple : un objet ne dispose que des pixels qu’il possède. Un modèle de détection d’objets apprend les formes à partir d’une poignée de pixels par objet. Lorsque l’image entière est réduite à 640 pixels sur son côté le plus long, les personnes, les véhicules et les défauts éloignés deviennent trop petits pour que le réseau puisse les distinguer des textures et du bruit.
C’est surtout visible dans les images aériennes, l’analyse d’images satellite, les caméras grand angle de circulation et de sécurité, ainsi que les photos d’inspection haute résolution. VisDrone est un benchmark aérien public très utilisé : sa documentation décrit des objets qui ne font souvent que quelques dizaines de pixels dans l’image et apparaissent en groupes denses, fortement occultés.
Le découpage en tuiles conserve ces pixels. Lorsque tile est défini sur la taille d’entrée du modèle, celui-ci voit plusieurs fenêtres à leur résolution native au lieu d’un seul passage sur une image réduite. Il s’agit de l’approche que l’article SAHI appelle « slicing-aided hyper inference » et que ses auteurs ont évaluée sur les jeux de données aériens VisDrone et xView.
Dans le guide sur le découpage en tuiles haute résolution, YOLO26s renvoie 35 détections sur une image VisDrone de 1920 x 1080 à imgsz=640, le seuil de confiance par défaut, et 161 avec tile=640, notamment des piétons, des cyclistes et des voitures éloignés. Le guide affiche les deux images côte à côte. Il s’agit de nombres de prédictions, et non d’une évaluation avec score. Les deux nombres ont été obtenus avec les mêmes poids ; le découpage en tuiles a également modifié le contexte vu par chaque fenêtre.
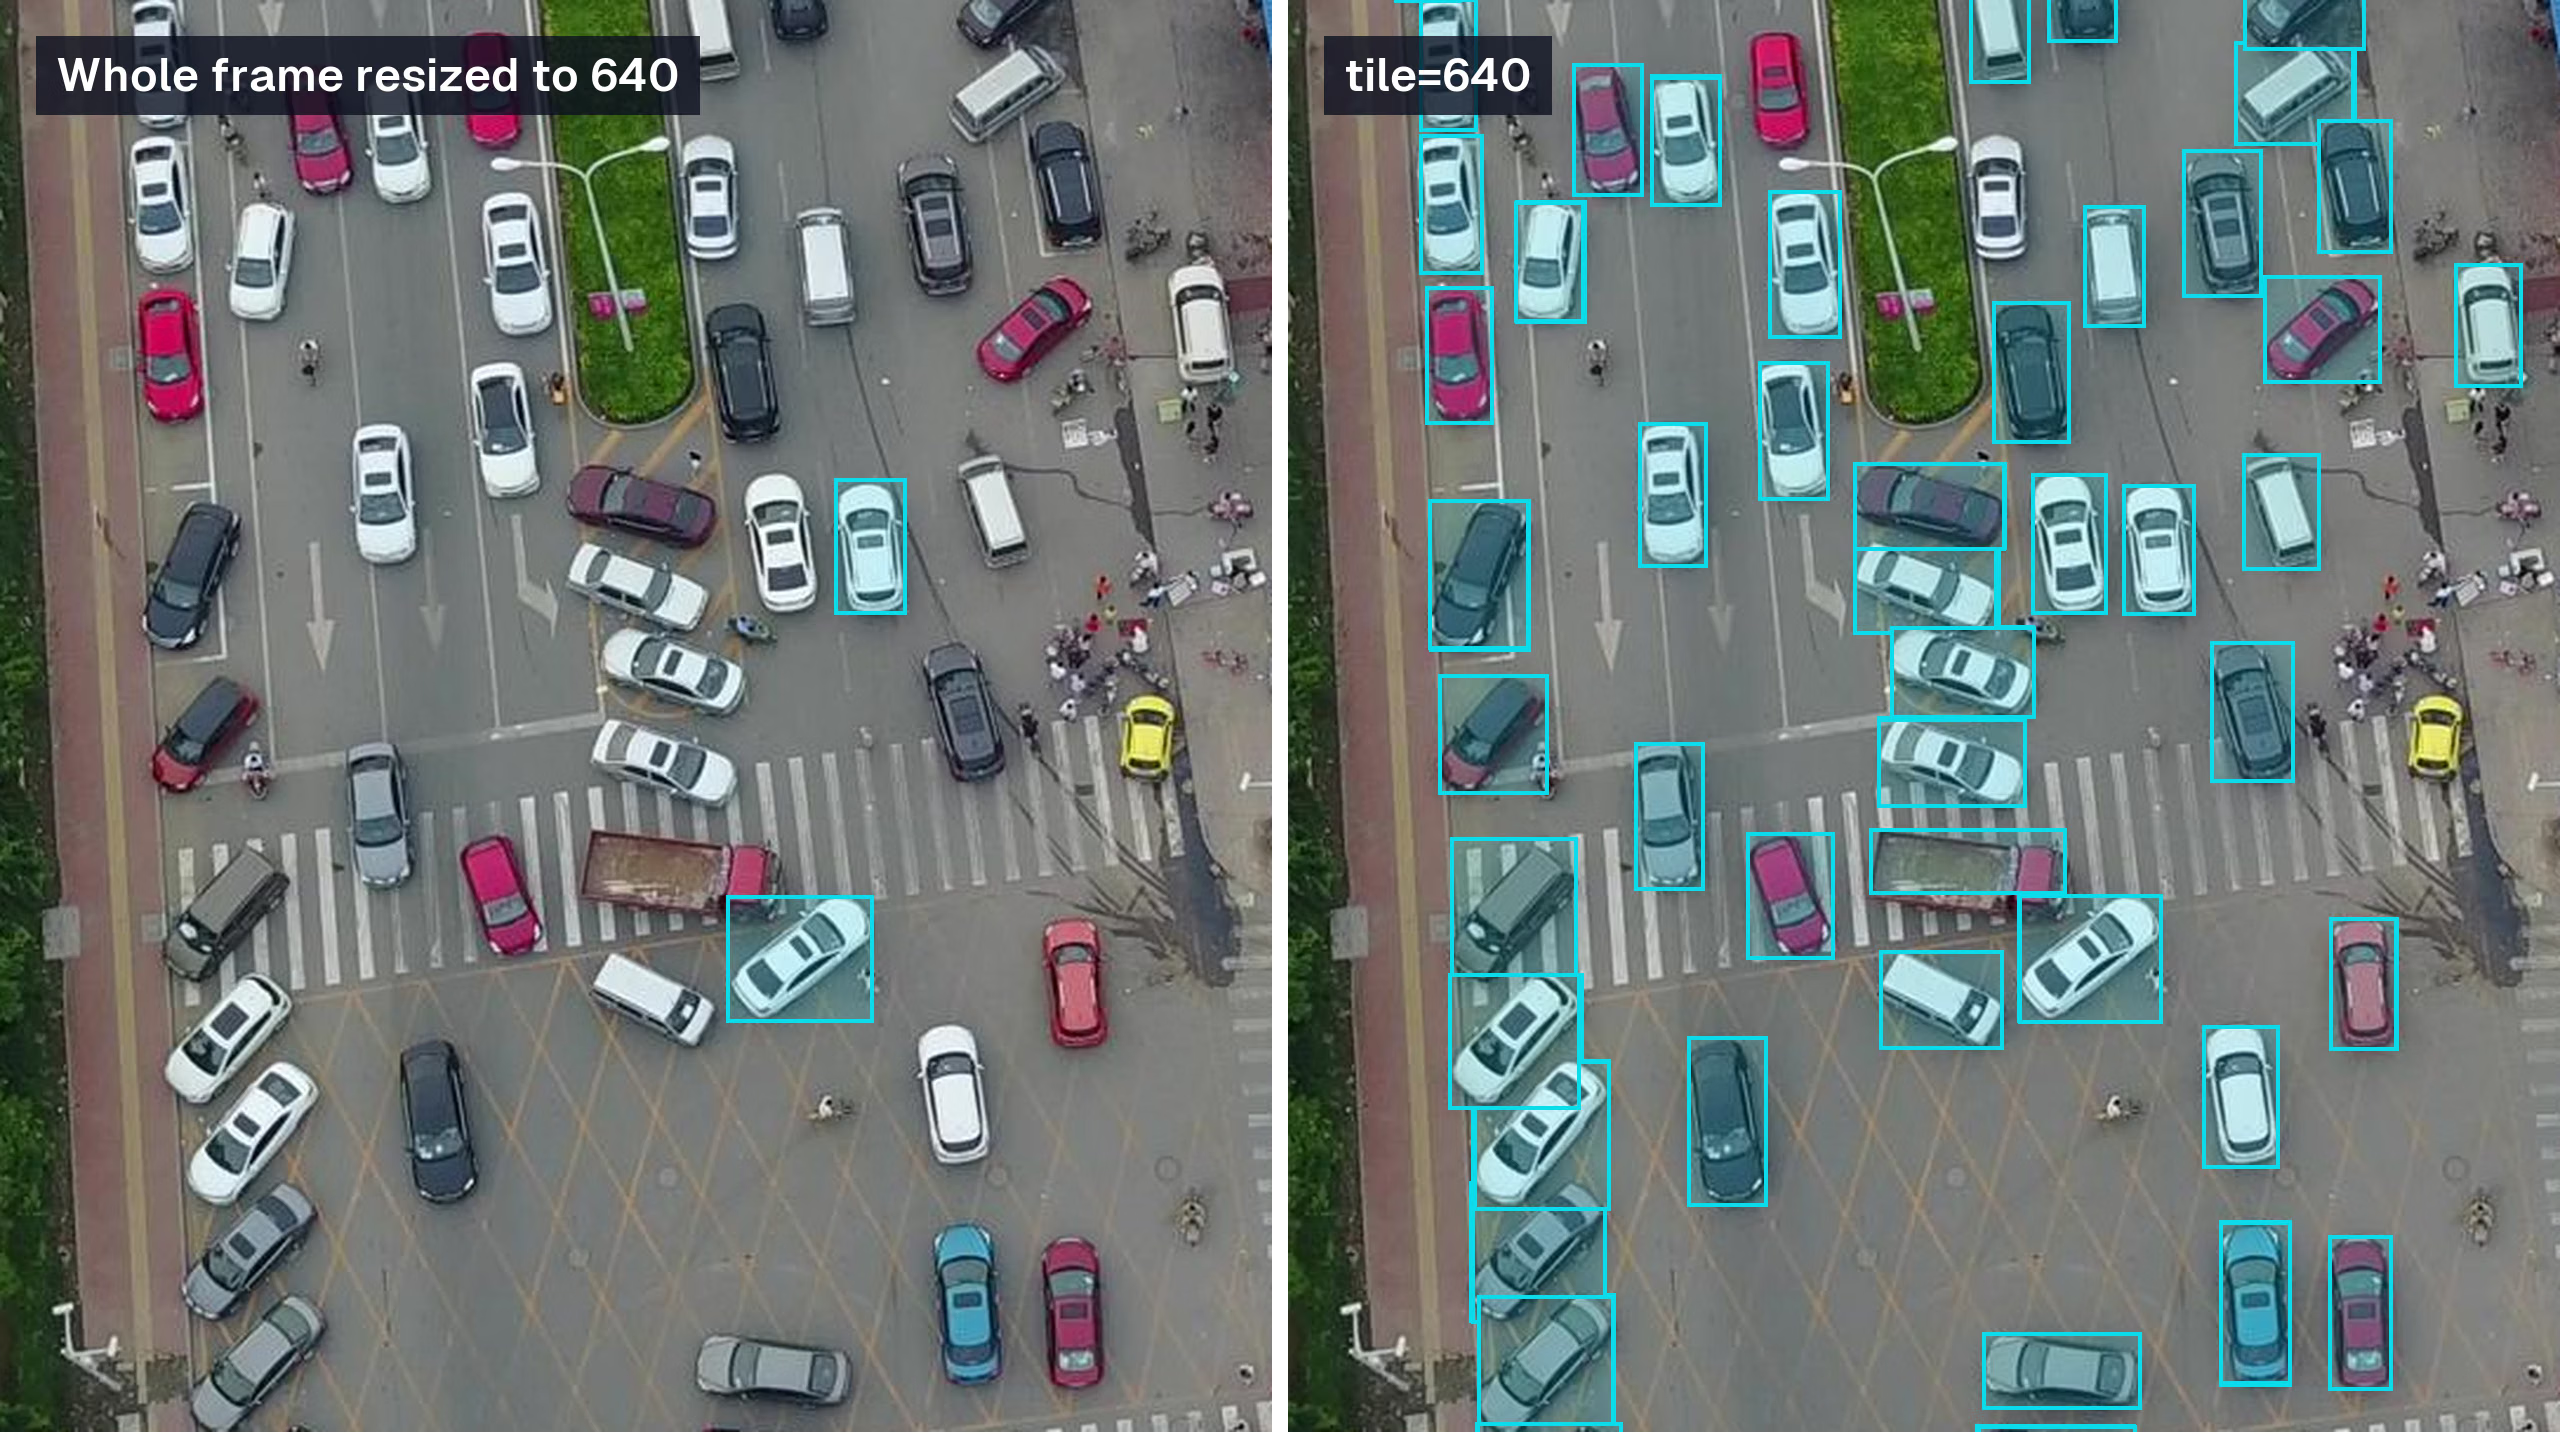
Une deuxième image de validation VisDrone de 1920 x 1080, avec YOLO26s et le seuil de confiance par défaut : 8 détections sur l’image entière à imgsz=640, 128 avec tile=640. Recadrage de la route affiché, boîtes sans étiquettes de classe.
Le découpage en tuiles ajoute une entrée du modèle par fenêtre#
Le guide définit précisément le fenêtrage. Les fenêtres se chevauchent de 20 % par défaut, et la dernière ligne et la dernière colonne s’alignent sur le bord de l’image, ce qui peut augmenter le chevauchement des fenêtres situées aux bords. Une image plus petite que la fenêtre est traitée avec une seule fenêtre couvrant toute l’image.
Le coût est donc facile à prévoir. Une image de 1920 x 1080 avec tile=640 est traitée avec huit fenêtres, quatre en largeur et deux en hauteur. Une image de 3840 x 2160 avec tile=1280 est également traitée avec huit fenêtres. En appliquant la même règle de chevauchement de 20 % à une image de 3840 x 2160 avec tile=640, on obtient huit colonnes et quatre lignes, soit 32 fenêtres : diviser par deux la taille des fenêtres sur une image 4K quadruple le nombre d’entrées de tuile.
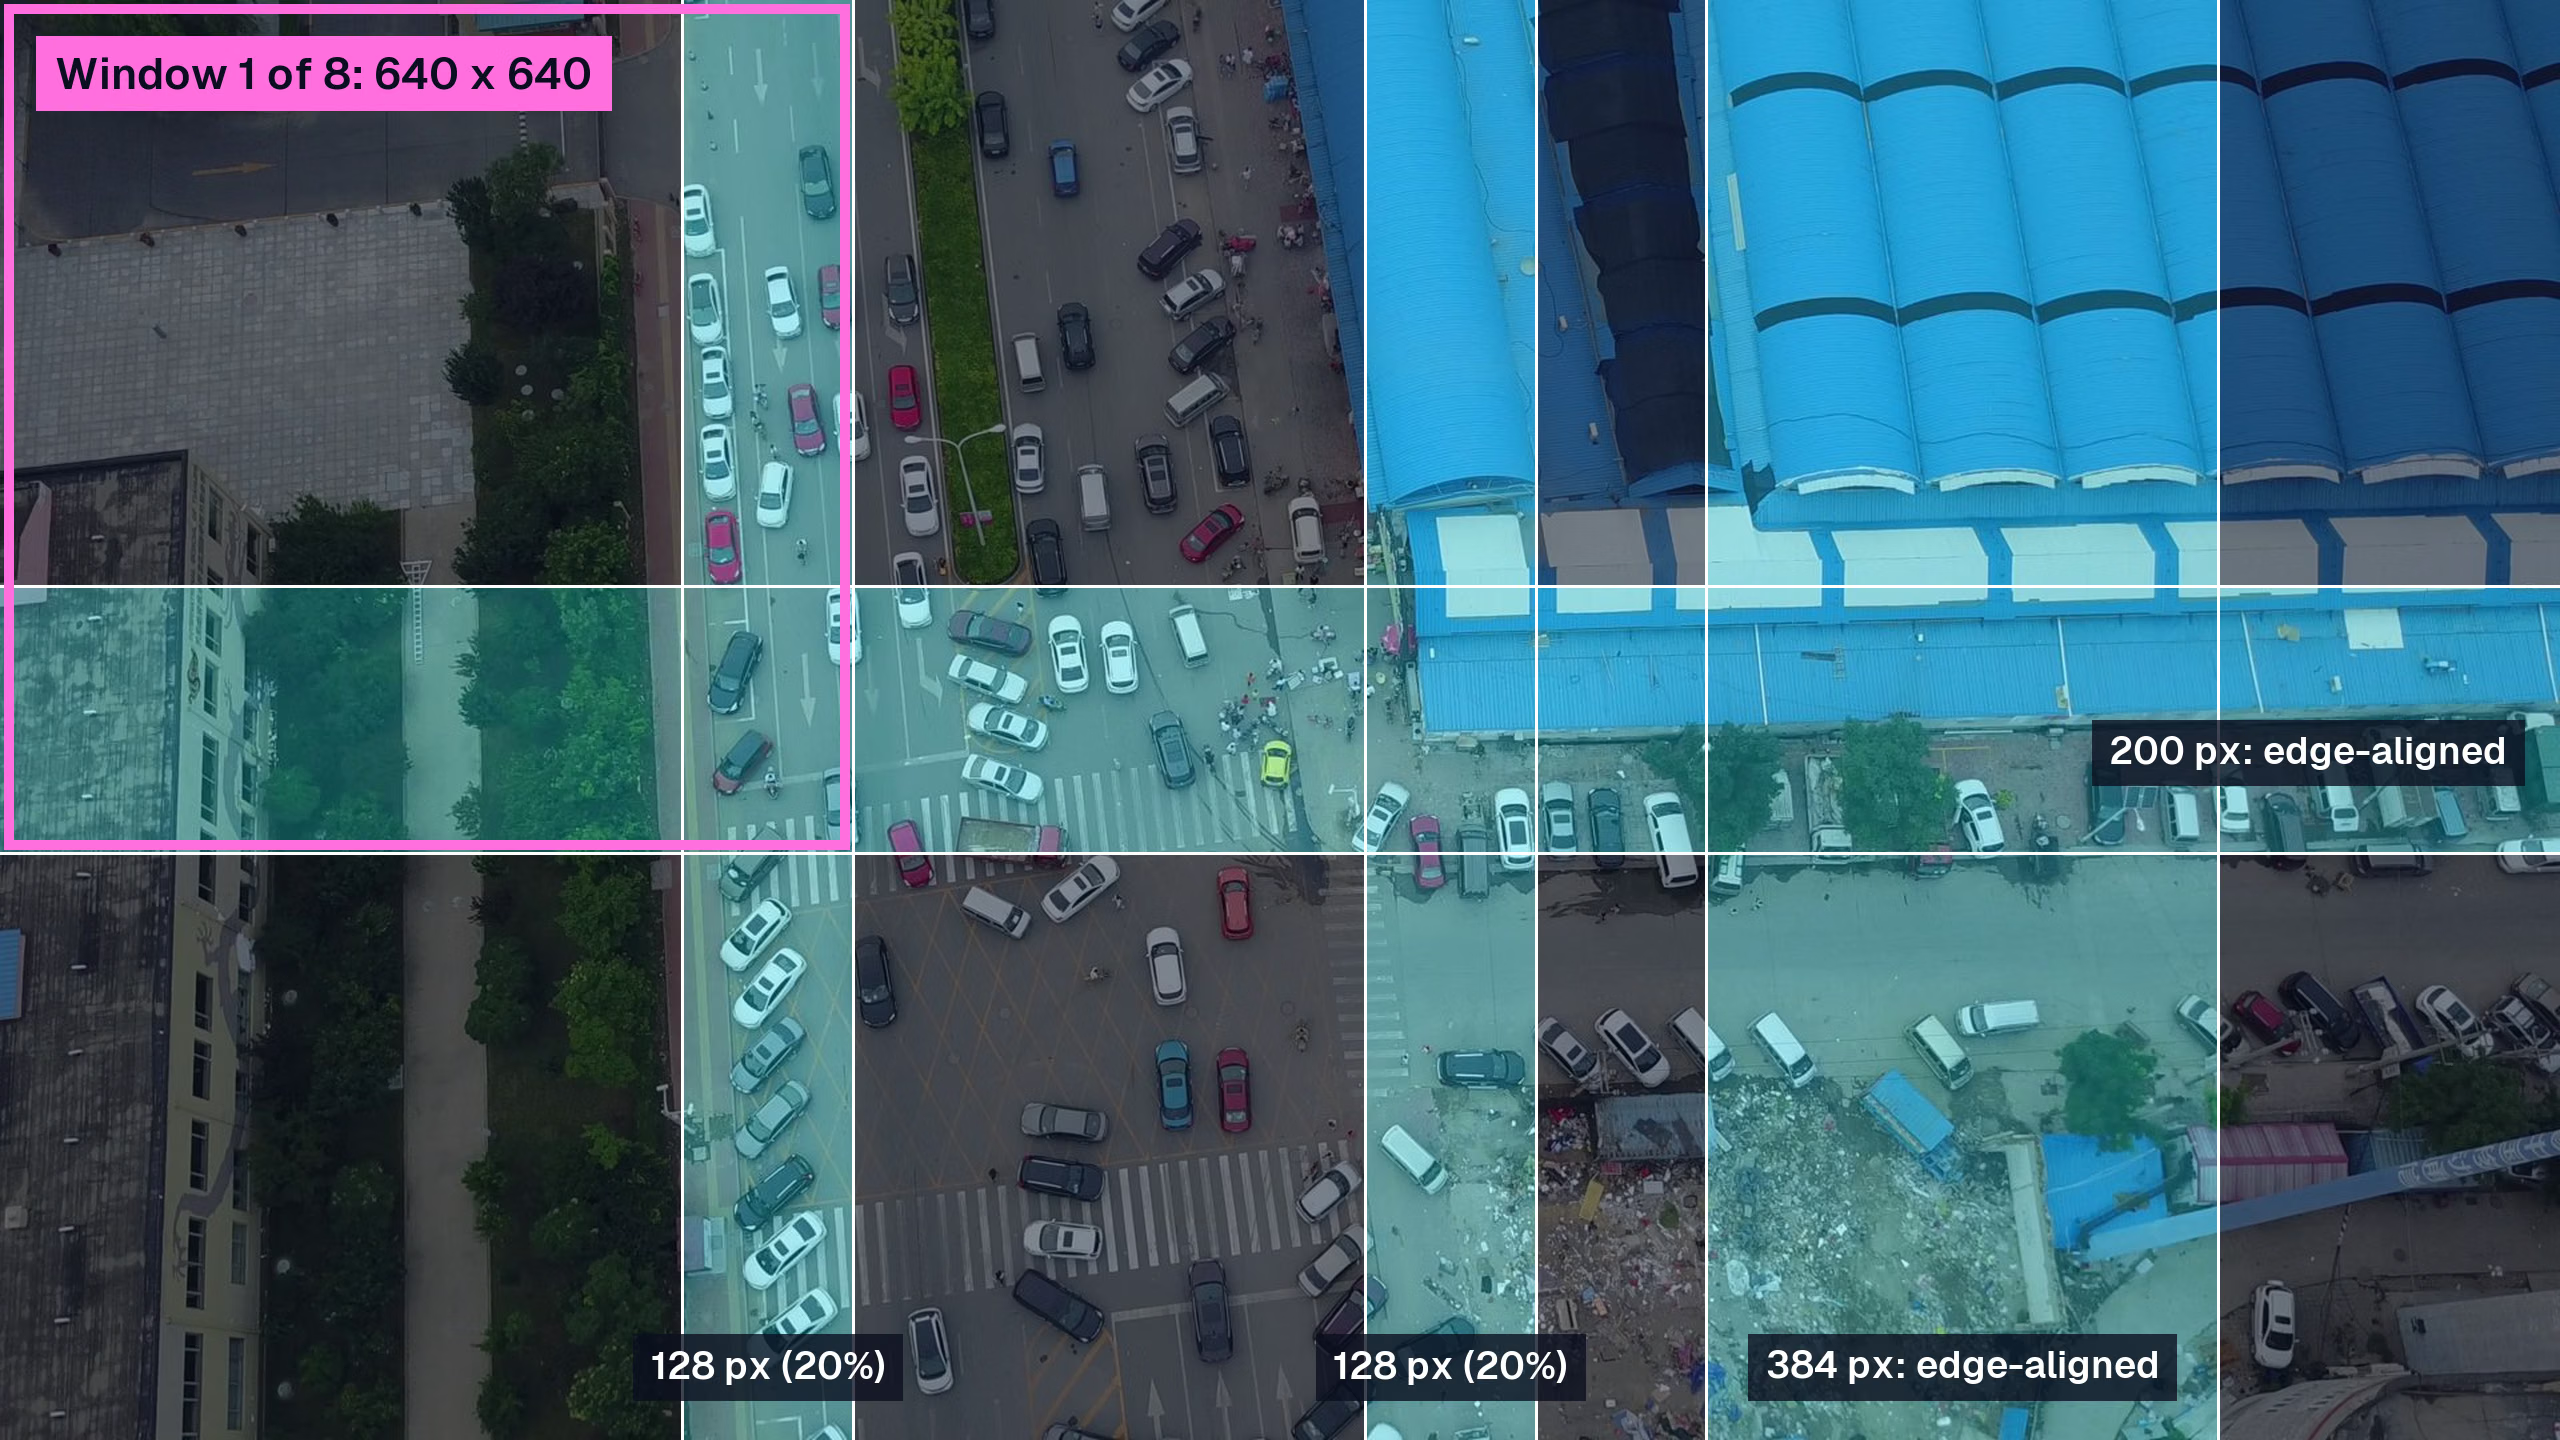
Les huit fenêtres utilisées avec tile=640 sur une image de 1920 x 1080 : les colonnes commencent à x = 0, 512, 1024 et 1280, et les lignes à y = 0 et 440. Les bandes ombrées sont visibles dans plusieurs fenêtres.
Le traitement par lots modifie la façon dont ces entrées sont transmises au modèle. En Python, batch définit le nombre de fenêtres traitées ensemble par le modèle dans un même appel d’inférence ; le crate Rust fait de même avec --batch lors d’un export avec lot dynamique. Le traitement par lots peut améliorer le débit, mais mesure la latence sur ton matériel ; notre guide sur l’inférence par lots avec Ultralytics YOLO en explique les raisons.
Voici comment le découpage en tuiles se compare aux autres moyens d’augmenter le nombre de pixels des petits objets :
| Approche | Entrées du modèle pour une image de 1920 x 1080 | Ce que voit le modèle | Idéale quand |
|---|---|---|---|
Image entière, imgsz=640 | 1 | Image réduite 3 fois | Les objets restent clairement visibles après le redimensionnement |
Image entière, imgsz=1280 | 1, avec un coût de calcul environ 4 fois supérieur à celui de 640 | Image réduite 1,5 fois | La mémoire et la latence permettent une entrée plus grande |
tile=True avec imgsz=640 | 8 | Fenêtres de 640 pixels à résolution native | Images plusieurs fois plus grandes que l’entrée du modèle |
tile=400 avec imgsz=640 | Plus de 8 | Fenêtres agrandies à 640 | Objets larges de quelques pixels seulement, même à leur résolution native |
Chaque tuile est une entrée de taille normale pour le modèle : le découpage en tuiles permet donc de traiter de très grandes images sans augmenter imgsz. Les sorties à la taille de la source, comme les masques et les cartes de profondeur, nécessitent toujours une mémoire proportionnelle à l’image d’origine, et max_det limite le nombre de masques d’instance conservés.
Quand le découpage en tuiles est utile, et quand il nuit aux résultats#
Le découpage en tuiles est utile lorsque les objets sont petits par rapport à l’image et que celle-ci est bien plus grande que l’entrée du modèle. Les images de drones et satellites, la circulation vue du dessus, les foules, les larges photos de rayons de magasins et les images d’inspection visuelle de cartes ou de panneaux entiers sont de bons cas d’usage.
Il nuit aux résultats lorsque les objets sont grands. Une fenêtre ne voit qu’une partie d’un camion qui occupe la moitié de l’image, et le guide est explicite : les objets plus grands que la zone de chevauchement peuvent tout de même être découpés, car aucune fenêtre ne les voit en entier, et la fusion ne réunit pas les fragments séparés. Le découpage supprime également le contexte global, ce qui importe surtout pour la classification et la profondeur, où les sorties des tuiles peuvent diverger dans l’image.
Les fenêtres plus petites impliquent un autre compromis. Agrandir une fenêtre de 400 pixels à 640 aide à détecter les objets larges de quelques pixels seulement, mais agrandit aussi l’encombrement de l’arrière-plan, ce qui peut produire des faux positifs. Compare deux ou trois tailles de tuiles sur ton propre jeu de validation et surveille la précision ainsi que le rappel.
Comment les tuiles sont fusionnées pour former un seul résultat#
Chaque fenêtre produit ses propres prédictions dans les coordonnées de la fenêtre. Le découpage en tuiles les remappe sur l’image source et renvoie un objet Results par image d’origine. Le code en aval qui lit result.boxes fonctionne donc sans modification.
Le chevauchement signifie qu’un objet situé près d’une limite peut être détecté deux fois. Pour la détection, les doublons sont supprimés par suppression non maximale selon tes paramètres iou, agnostic_nms et max_det ; notre guide sur le réglage du seuil IoU de NMS s’applique donc directement aux sorties découpées en tuiles. Une boîte coupée par le bord d’une fenêtre est supprimée lorsqu’une autre fenêtre voit l’objet sans qu’il soit tronqué par ses bords et qu’une boîte conservée le couvre : la boîte la plus complète est ainsi retenue à la jointure. Une boîte tronquée sans meilleure correspondance est conservée.
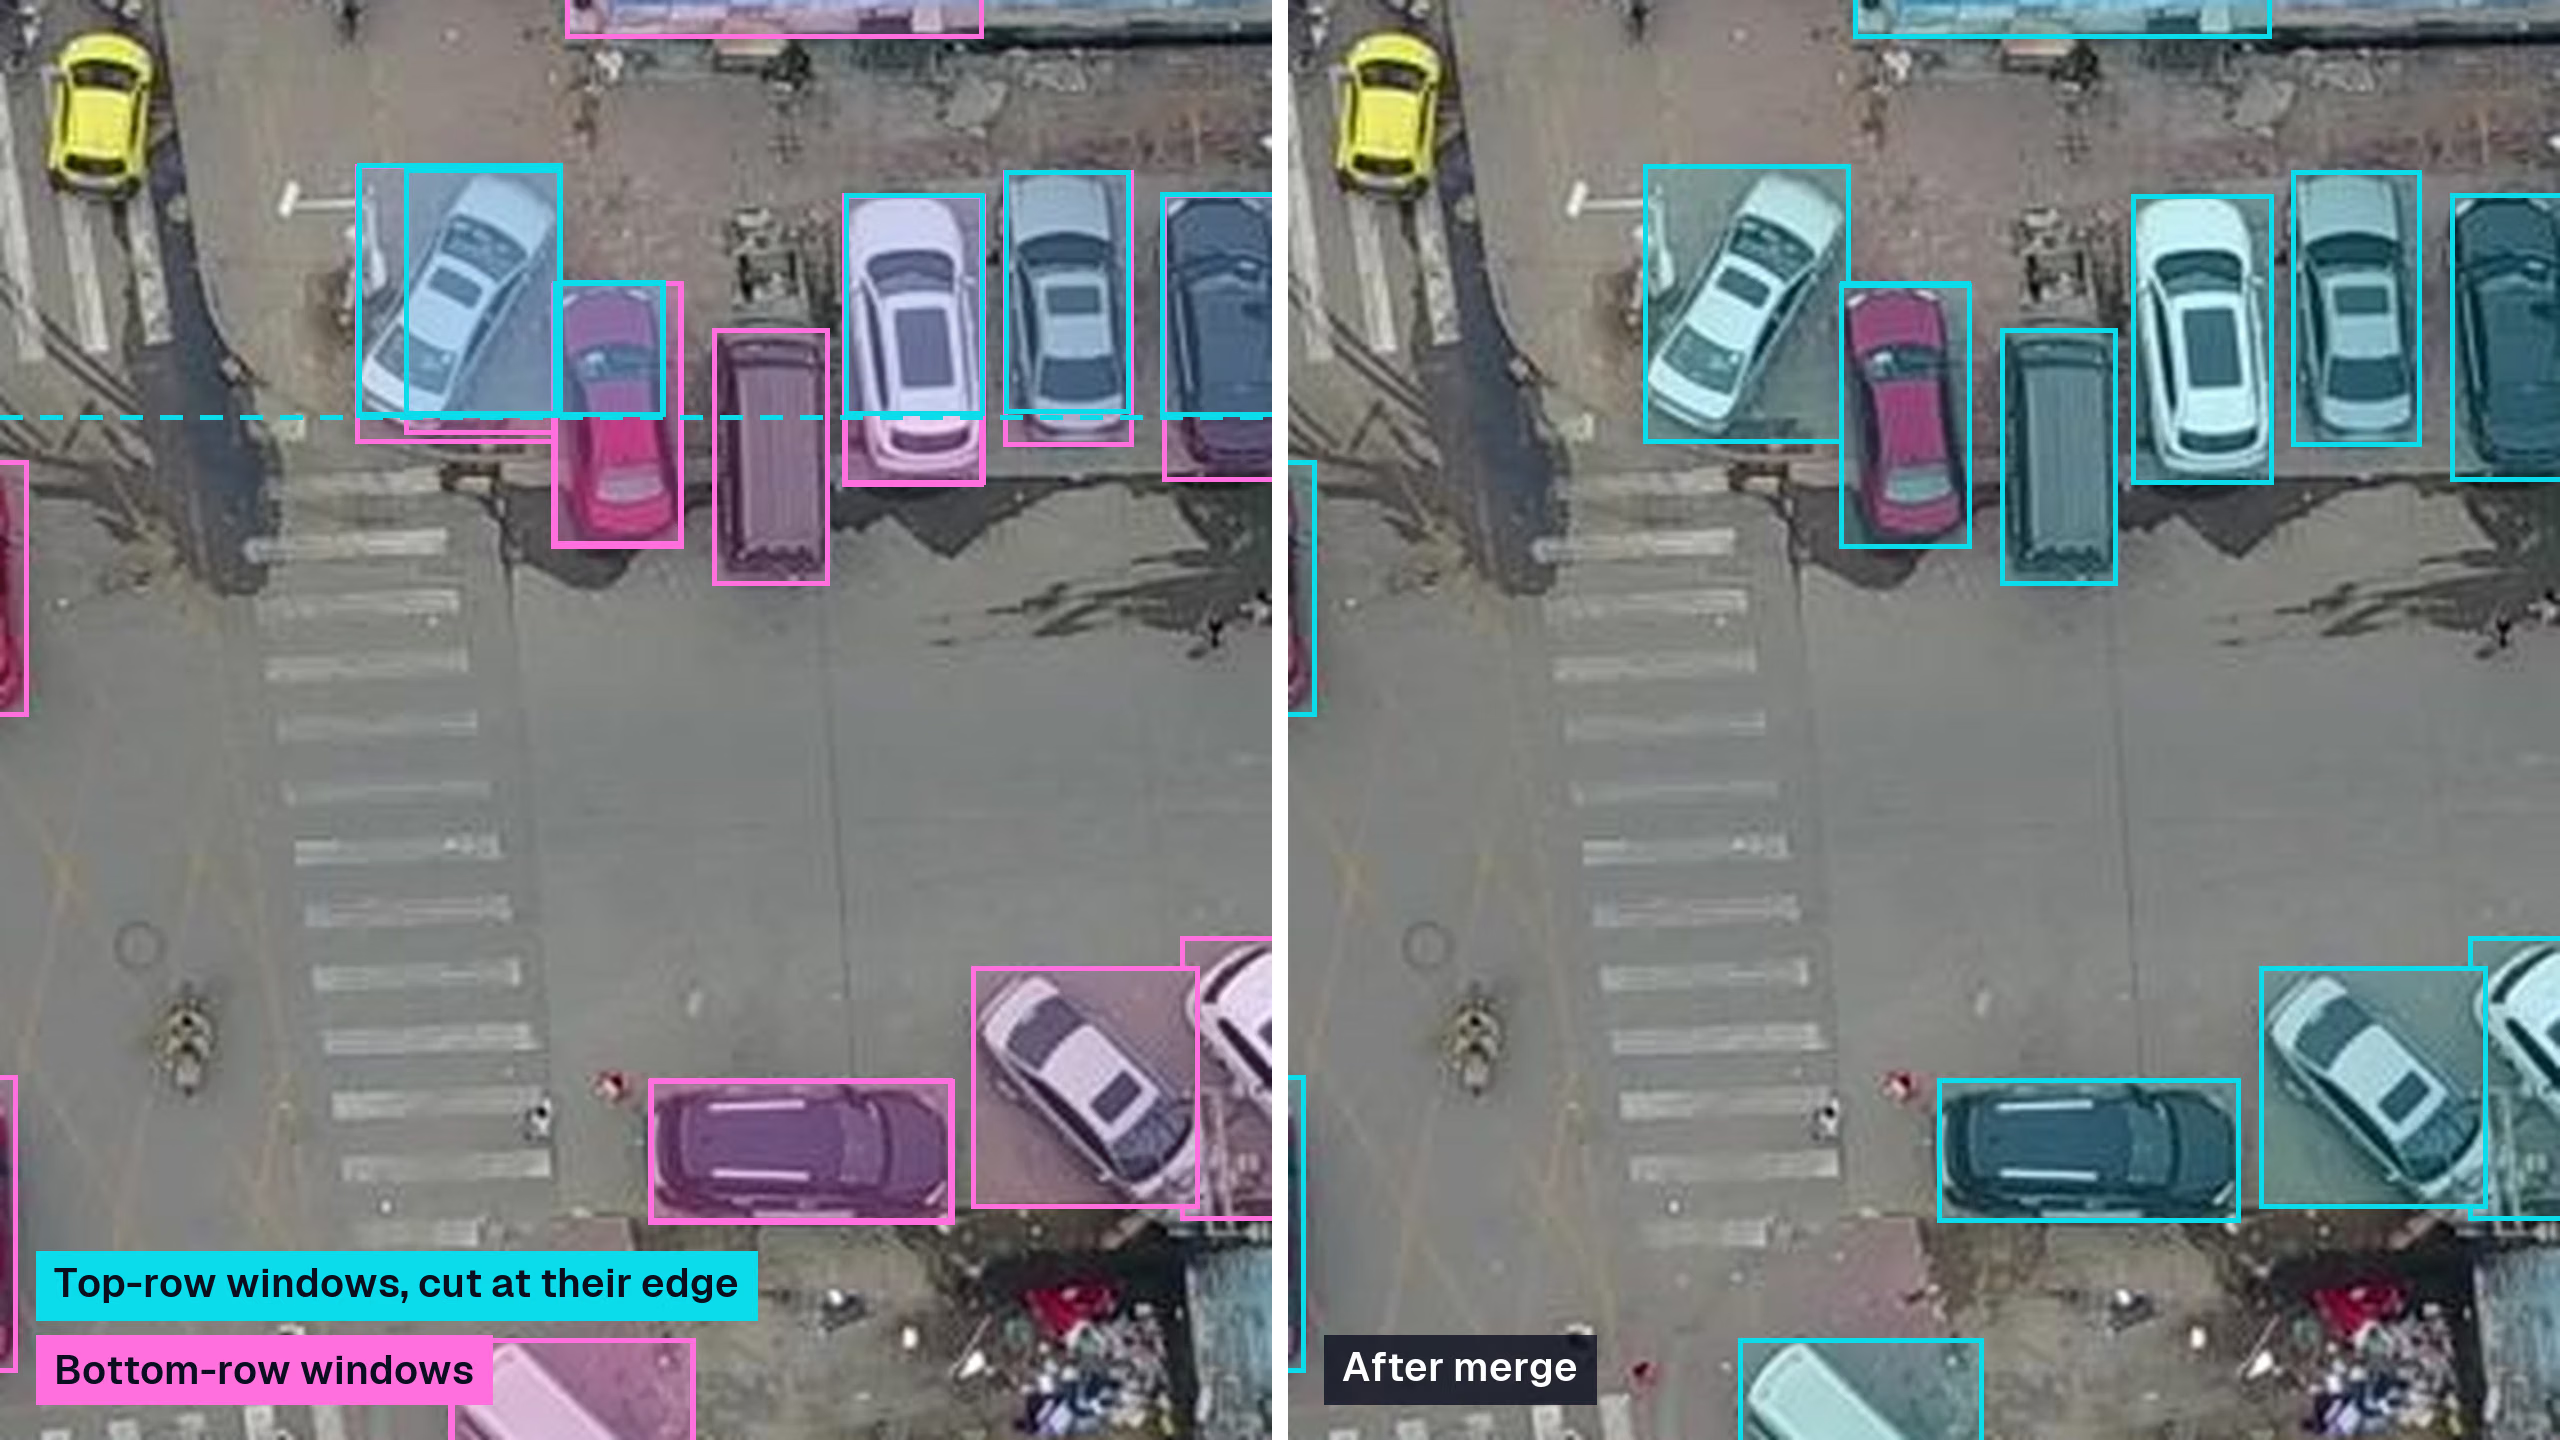
Illustration du traitement de la jointure à y = 640 dans la même image. Les boîtes cyan sont tronquées par le bord inférieur des fenêtres de la rangée supérieure, les boîtes magenta proviennent des fenêtres de la rangée inférieure, et le panneau de droite montre la boîte la plus complète conservée pour chaque voiture après fusion.
Chaque tâche Ultralytics YOLO effectue la fusion à sa manière :
- Détection, segmentation, pose et OBB rétablissent les boîtes, les masques, les points clés ou les boîtes orientées dans les coordonnées de la source, puis sélectionnent les boîtes, avec une NMS orientée pour OBB.
- La segmentation sémantique assemble les cartes de classes en choisissant la tuile la plus centrale dans les zones de chevauchement.
- La profondeur fusionne les cartes de profondeur qui se chevauchent à l’aide de poids qui augmentent vers le centre de chaque tuile.
- La classification calcule la moyenne des probabilités des tuiles.
Le pipeline Python découpe également en tuiles les prédictions YOLO-World, YOLOE, RT-DETR et FastSAM. SAM conserve son propre pipeline de recadrage et n’accepte pas tile.
Inférence par tuiles en Python avec l’argument tile#
Le découpage en tuiles nécessite Ultralytics 8.4.204 ou une version ultérieure, sans package supplémentaire. En mode prédiction, passe tile=True pour utiliser imgsz comme taille de fenêtre, ou un entier pour définir séparément la taille de la fenêtre :
from ultralytics import YOLO

model = YOLO("yolo26s.pt")

# Référence : un passage sur l’image réduite à 640 pixels
full = model.predict("intersection.jpg", imgsz=640)

# Découpage en tuiles : fenêtres de 640 pixels à résolution native, 8 fenêtres par lot
tiled = model.predict("intersection.jpg", imgsz=640, tile=640, batch=8)

print(len(full[0].boxes), len(tiled[0].boxes))
Le même argument fonctionne depuis la CLI avec yolo predict model=yolo26s.pt source=large-image.tif tile=640 imgsz=640 batch=8. Pour la vidéo, passe stream=True afin de limiter l’utilisation de la mémoire. En mode suivi, le système de suivi s’exécute une fois par image sur les prédictions fusionnées.
Le découpage en tuiles ne sert pas qu’à la prédiction. Lorsque tes images sont bien plus grandes que imgsz, entraîne et valide avec le même paramètre :
- Entraîne sur des tuiles avec
model.train(data="aerial.yaml", tile=True, imgsz=640). Les étiquettes sont tronquées à chaque fenêtre, les instances dont la boîte d’origine conserve moins de 10 % de sa superficie sont supprimées, et les fenêtres vides sont conservées comme exemples négatifs. - Valide sur les résultats fusionnés avec
model.val(data="aerial.yaml", tile=True, imgsz=640). Les prédictions sont fusionnées avant d’être évaluées par rapport aux annotations d’origine, afin que le mAP reflète ce que tu déploieras. - Mets les sources volumineuses en cache avec
cache="ram", car l’entraînement mélange les tuiles et décoderait autrement plusieurs fois la même grande image. - Compare avec une référence sur image entière en utilisant la même partition de validation avant de conserver le modèle entraîné sur des tuiles. Pour découvrir d’autres moyens d’améliorer les scores sur les petits objets, consulte notre liste de vérification du mAP pour les petits objets.
L’entraînement sur des tuiles présente au modèle les objets à l’échelle qu’il verra lors de la prédiction par tuiles. Notre guide sur les jeux de données de détection par drone détaille cette boucle complète d’entraînement, de découpage en tuiles et d’évaluation sur des images 4K.
Les modèles exportés peuvent aussi traiter des tuiles. Le découpage s’exécute dans le pipeline de prédiction Python : un modèle exporté en ONNX ou TensorRT conserve donc son graphe d’entrée normal, et YOLO("yolo26s.onnx").predict(source, tile=640) fonctionne comme d’habitude, y compris avec des tailles de lot d’export fixes et le dernier lot incomplet.
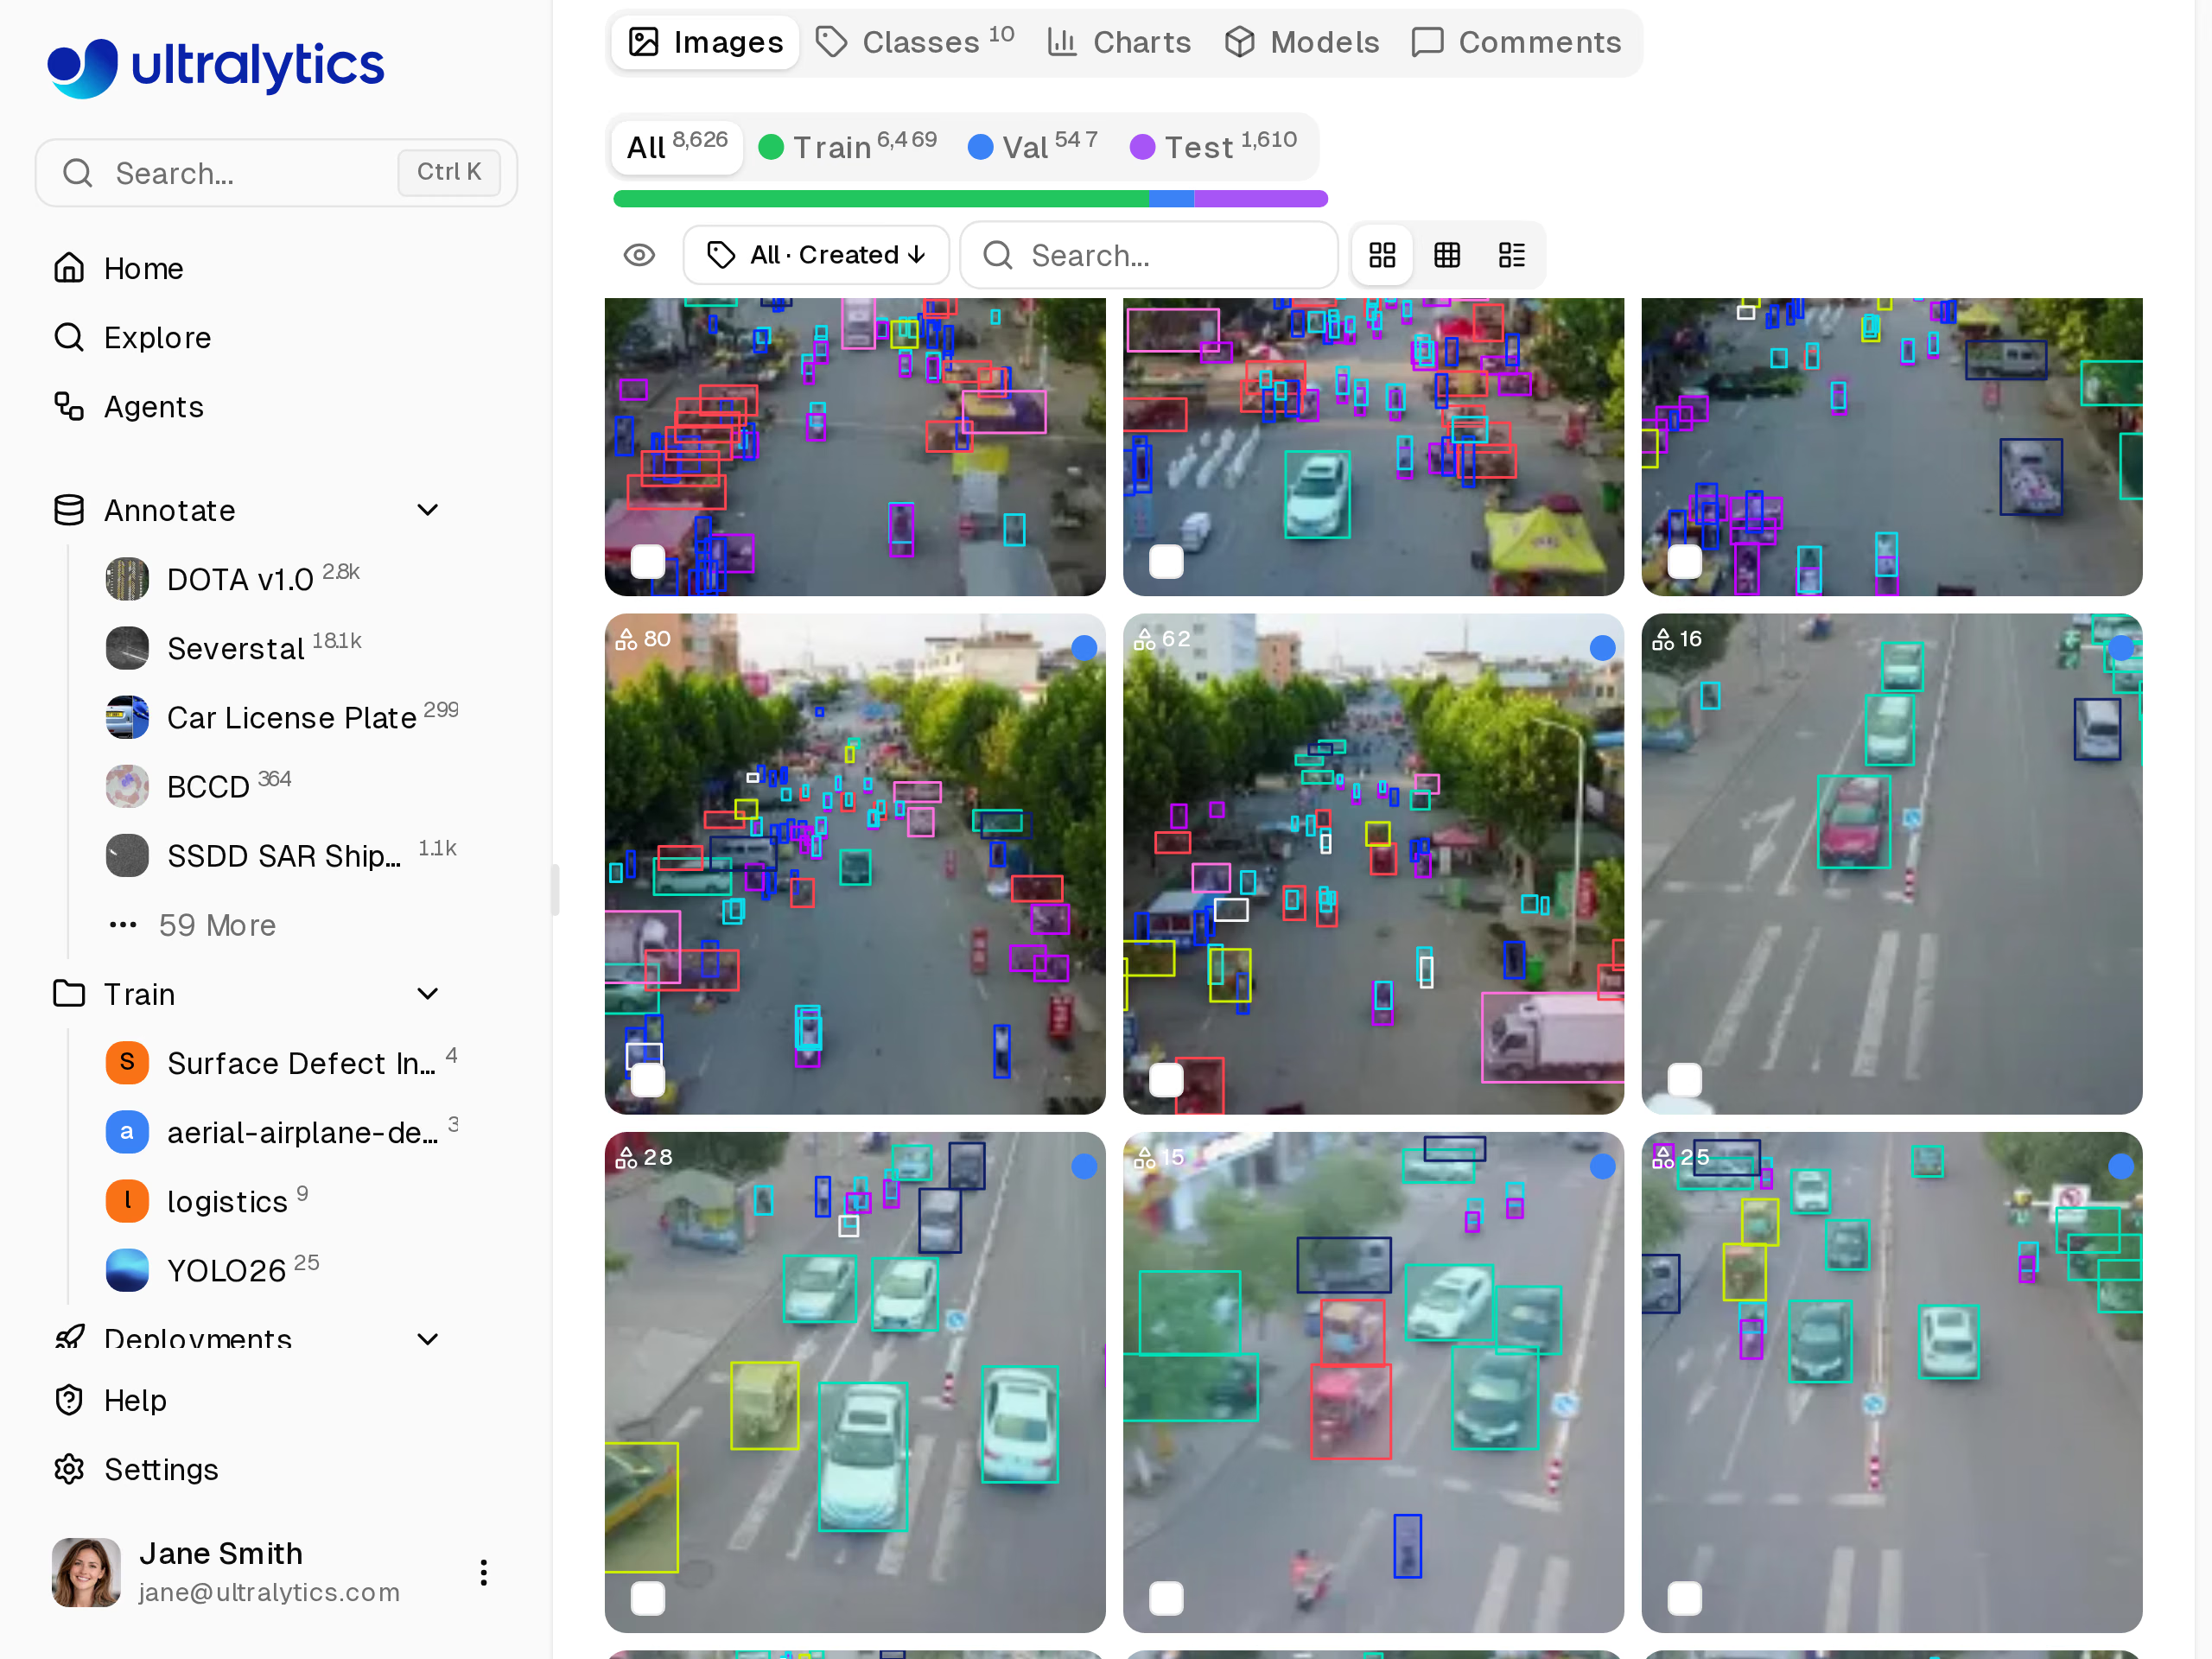
Le jeu de données VisDrone dans Ultralytics Platform, un benchmark prêt à l’emploi pour tester les tailles de tuiles avant d’annoter tes propres données.
Pour tester d’abord les tailles de tuiles sur des données publiques, commence par le jeu de données VisDrone sur Ultralytics Platform. Pour suivre une exécution avec tuiles à côté de ta référence, copie la commande Local Training depuis la boîte de dialogue d’entraînement de Platform, définis project sur le projet Platform de ta référence et ajoute tile=True pour y transmettre les métriques de l’exécution avec tuiles.
Inférence par tuiles en Rust avec la nouvelle option --tile#
Ultralytics Inference est notre crate Rust et notre CLI permettant d’exécuter des modèles ONNX exportés via ONNX Runtime et des modèles OpenVINO IR en mode natif, sans environnement Python à l’inférence. Il cible les serveurs, les conteneurs et les appareils edge avec CPU, CUDA, TensorRT, CoreML, OpenVINO et d’autres fournisseurs d’exécution. La version 0.0.57 reprend la même approche de découpage que Python : chevauchement de fenêtre de 20 % par défaut, remappage des résultats sur l’image source et suppression des doublons par classe.
Illustration. Une caméra routière avec un ordinateur edge, le type de déploiement sans Python visé par le crate Rust.
L’équipe a vérifié les sorties découpées en tuiles par rapport à Ultralytics Python sur ONNX Runtime CPU, OpenVINO CPU, GPU et NPU, CUDA et TensorRT, pour des images, des vidéos et une webcam. Les modèles de détection, de segmentation, de segmentation sémantique, de profondeur, de classification, de pose et OBB sont tous pris en charge.
Depuis la CLI, ajoute --tile avec une taille de fenêtre, ou passe-le sans valeur pour utiliser --imgsz. L’exportation du modèle est une étape Python à effectuer une seule fois ; l’inférence elle-même ne nécessite que le binaire Rust :
# One-time export in Python: a dynamic-batch ONNX model so several windows run per call
pip install -U "ultralytics[export-base]>=8.4.204"
yolo export model=yolo26s.pt format=onnx dynamic=True

# Install the Rust CLI
cargo install ultralytics-inference

# Tiled inference on a large image: 640-pixel windows, 8 per batch
ultralytics-inference predict --model yolo26s.onnx --source aerial.jpg --tile 640 --batch 8
En tant que bibliothèque, configure le découpage en tuiles une fois dans InferenceConfig, et chaque appel predict traitera les tuiles. with_tile(0) utilise la taille d’inférence :
use ultralytics_inference::{InferenceConfig, YOLOModel};

fn main() -> Result<(), Box<dyn std::error::Error>> {
    let config = InferenceConfig::new().with_tile(640);
    let mut model = YOLOModel::load_with_config("yolo26s.onnx", config)?;
    let results = model.predict("aerial.jpg")?;
    if let Some(ref boxes) = results[0].boxes {
        println!("{} detections", boxes.len());
    }
    Ok(())
}
Les boîtes en double entre les fenêtres sont supprimées par NMS par classe selon --iou, dont la valeur par défaut est 0.5 depuis cette même version, conformément aux paramètres de prédiction par défaut d’Ultralytics. Le découpage en tuiles est désactivé par défaut, car chaque fenêtre constitue une entrée supplémentaire pour le modèle. Active-le lorsque les détails comptent, mesure la latence d’inférence sur l’appareil cible et choisis le fournisseur d’exécution adapté ; notre comparaison ONNX et TensorRT est utile sur le matériel NVIDIA, et le guide NVIDIA Jetson explique la configuration sur l’appareil.
Les utilisateurs de SAHI peuvent passer à l’argument tile intégré#
Si tu découpes déjà des images avec la bibliothèque SAHI, l’argument intégré fait le même travail dans Ultralytics, sans deuxième package ni format de résultats séparé. Notre guide d’intégration de SAHI est désormais obsolète et remplacé par tile.
Pour migrer un script SAHI, il suffit principalement de modifier les arguments :
| SAHI | Découpage en tuiles intégré |
|---|---|
AutoDetectionModel.from_pretrained(model_type="ultralytics", ...) | YOLO("yolo26s.pt") |
get_sliced_prediction(image, model, slice_height=256, slice_width=256, ...) | model.predict(image, tile=256) |
overlap_height_ratio, overlap_width_ratio | Chevauchement fixe de 20 % par défaut, fenêtres aux bords alignées sur les limites de l’image |
PredictionResult de SAHI | Results standard d’Ultralytics |
Les fenêtres sont carrées, et leur chevauchement ainsi que la fusion suivent les règles décrites ci-dessus plutôt que le post-traitement configurable de SAHI ; attends-toi donc à des boîtes similaires, mais pas identiques. Après le changement, vérifie à nouveau tes seuils sur un jeu de validation.
La différence pratique tient à l’intégration. tile s’intègre à l’entraînement, à la validation, à la prédiction et au suivi d’Ultralytics via le même argument, renvoie des objets Results standard et propose une option correspondante dans le crate Rust. Une taille de tuile validée dans un notebook peut ainsi être reprise dans un binaire Rust sur un appareil edge.
Qui devrait activer le découpage en tuiles#
Active le découpage en tuiles si tu utilises Ultralytics YOLO sur des images plusieurs fois plus grandes que l’entrée du modèle et que ta validation révèle des petits objets manqués : équipes travaillant avec des drones et des satellites, intégrateurs de systèmes de circulation et de sécurité utilisant des caméras grand angle, et équipes d’inspection photographiant des cartes, des panneaux ou des rayons entiers. Les utilisateurs de Rust bénéficient de la même approche de découpage en tuiles sur du matériel edge, sans environnement Python.
Laisse-le désactivé si les objets sont grands par rapport à l’image, si une valeur plus élevée de imgsz permet déjà de les récupérer en un seul passage ou si le budget de latence ne permet pas plusieurs entrées de tuile par image. Dans tous les cas, compare les résultats avec et sans découpage sur la même partition de validation et au même seuil de confiance, en examinant le rappel, les faux positifs et la latence ; ne conserve le découpage que si le gain justifie le travail supplémentaire.
Ultralytics Platform rassemble cette comparaison au même endroit : annote tes propres images haute résolution ou commence avec VisDrone, entraîne une référence sur image entière sur des GPU cloud, entraîne une autre référence avec une valeur plus élevée de imgsz, puis enregistre une exécution avec tuiles depuis ta propre machine dans le même projet. Le guide sur le découpage en tuiles haute résolution détaille les options de découpage, et la documentation Ultralytics Inference présente le déploiement Rust.
Le package Python et le crate Rust sont tous deux disponibles sous AGPL-3.0. Si tu intègres la détection par tuiles à un produit à code source fermé ou à un appareil edge livré à tes clients, une licence Ultralytics Enterprise autorise l’utilisation commerciale des logiciels Ultralytics couverts sans obligation de divulgation du code source imposée par AGPL-3.0, sous réserve de ses conditions.
Foire aux questions
Le découpage d’images en tuiles consiste à diviser une grande image en fenêtres qui se chevauchent, à exécuter le détecteur sur chaque fenêtre, puis à fusionner les boîtes sur l’image d’origine. Lorsque la fenêtre correspond à la taille d’entrée du modèle, les petits objets conservent des pixels qu’ils perdraient si l’image entière était redimensionnée. Dans Ultralytics YOLO, l’argument
tileapplique cette méthode avec un chevauchement de 20 % par défaut et renvoie un résultat par image.Vérifie d’abord si le problème vient du redimensionnement : si les objets ne font plus que quelques pixels avec
imgsz=640, teste une valeur plus élevée deimgszoutile=True. Entraîne le modèle avec le même paramètre que celui utilisé pour la prédiction, afin qu’il apprenne les objets à l’échelle de déploiement, et valide les résultats par taille et par classe. Le découpage en tuiles convient aux images plusieurs fois plus grandes que l’entrée du modèle.Il ajoute une entrée du modèle par fenêtre : une image de 1920 x 1080 avec
tile=640produit huit entrées de tuile au lieu d’une seule image. Le traitement de plusieurs tuiles dans un même appel par lots, avecbatchen Python ou--batchavec un export à lot dynamique en Rust, peut améliorer le débit. Mesure la latence sur ton matériel cible.Non. Depuis Ultralytics 8.4.204, l’argument intégré
tilegère l’inférence par découpage sans package supplémentaire, et découpe également les données pour l’entraînement, la validation et le suivi. Le guide SAHI de notre documentation est obsolète et remplacé partile.Oui. En Python, les modèles exportés conservent leur graphe d’entrée normal ; passe
tileàpredictcomme d’habitude. En Rust, Ultralytics Inference 0.0.57 ajoute--tileà la CLI etwith_tileàInferenceConfig; le tout a été vérifié par comparaison avec Python sur ONNX Runtime CPU, OpenVINO, CUDA et TensorRT.Commence avec
tile=True, qui utiliseimgszcomme taille de fenêtre. Utilise une fenêtre plus petite, commetile=400avecimgsz=640, lorsque les objets ne font que quelques pixels de large, même à la résolution native, et une fenêtre plus grande lorsque les objets risquent d’être coupés aux raccords. Compare quelques tailles sur ton jeu de validation, en surveillant à la fois le rappel et les faux positifs.
Écrit par
Ingénieur senior en apprentissage automatique · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









