Ultralytics YOLO et NVIDIA Cosmos Data Factory : données synthétiques pour la détection des défauts
Les données synthétiques de NVIDIA Cosmos Data Factory et une boucle automatisée d’entraînement agentique enrichie par les données, propulsée par NVIDIA, permettent à Ultralytics YOLO d’atteindre la précision obtenue avec l’ensemble du jeu de données en n’utilisant qu’une fraction des annotations.
Ultralytics et NVIDIA se sont associés pour montrer ce que des données d’entraînement ciblées peuvent apporter à Ultralytics YOLO. La boucle d’entraînement agentique enrichie par les données de NVIDIA repère les images dont un modèle a besoin, NVIDIA Cosmos Data Factory génère celles qui n’existent pas encore, et Ultralytics YOLO est le modèle entraîné sur le résultat. Notre équipe d’apprentissage automatique (ML) a évalué cette combinaison sur 19 benchmarks publics d’inspection industrielle, en comparant Ultralytics YOLO26 entraîné avec le pipeline agentique de NVIDIA et les données synthétiques de Cosmos Data Factory au même modèle entraîné selon la méthode conventionnelle. Cet article présente les résultats.
Plus de données ne sont pas la solution. Ce sont les bonnes données qui comptent.#
Toutes les équipes d’inspection connaissent ce scénario. Un modèle de détection des défauts fonctionne bien sur les défauts qu’il a vus de nombreuses fois, puis manque la rayure rare, l’éclairage inhabituel ou l’angle de caméra atypique qui compte le plus sur la ligne de production. La solution habituelle consiste à collecter et à annoter davantage d’images de toutes sortes, ce qui est lent, coûteux et ajoute surtout des images que le modèle traite déjà correctement.
L’entraînement agentique automatisé propulsé par NVIDIA adopte une autre approche : il repère les lacunes précises d’un jeu de données et les comble avec des images réelles déjà existantes ou, en l’absence d’exemples réels, avec des images synthétiques générées par Cosmos Data Factory. Associé à Ultralytics YOLO, ce processus permet d’entraîner un modèle exactement sur les données qui lui manquent.
Comment fonctionne la boucle d’entraînement enrichie par les données de NVIDIA ?#
La boucle d’entraînement agentique enrichie par les données de NVIDIA pour Ultralytics YOLO est un pipeline d’amélioration du modèle qui englobe la boucle d’entraînement et détermine les prochaines données dont le modèle a besoin :
• Exploitation des données réelles. Elle parcourt les collections d’images existantes pour trouver des exemples réels qui comblent des lacunes précises du jeu d’entraînement.
• Génération de données synthétiques. En l’absence d’exemples réels, elle génère des images de cas limites avec Cosmos Data Factory.
• Annotation automatique. Un composant appelé AnomalyGen annote les images synthétiques, ce qui évite toute annotation manuelle avant le réentraînement.
L’idée directrice est de privilégier les données ciblées à l’efficacité des données. Le but n’est pas simplement de s’entraîner avec moins de données. Il s’agit de combler avec précision les lacunes d’un jeu de données là où le modèle est faible, par extraction ou génération, puis de réentraîner le modèle sur cet ensemble enrichi. S’entraîner sur moins d’images est souvent un effet secondaire d’une bonne mise en œuvre, comme le montrent les résultats ci-dessous.
Le pipeline a été évalué en profondeur avec Ultralytics YOLO, et tous les résultats de cet article utilisent Ultralytics YOLO26.
Le rôle de NVIDIA Cosmos Data Factory#
Cosmos Data Factory est la plateforme de NVIDIA dédiée à la sélection, au traitement et à la génération de données, basée sur ses modèles du monde Cosmos. Dans la boucle d’entraînement agentique, elle génère des images pour des scénarios mal couverts par un jeu de données réel, comme certains types de défauts dans l’industrie manufacturière ou la distorsion d’un objectif fisheye dans des séquences de transport.
Le processus est simple. Cosmos génère les images de cas limites, AnomalyGen les annote, puis Ultralytics YOLO est réentraîné sur l’ensemble combinant données réelles et synthétiques à l’aide du pipeline d’entraînement Ultralytics standard.
Mise à l’épreuve de Cosmos Data Factory sur 19 jeux de données publics#
Pour évaluer le potentiel de Cosmos Data Factory + Ultralytics YOLO, notre équipe de ML a exécuté le pipeline d’affinage agentique enrichi par les données sur 19 jeux de données publics d’inspection industrielle couvrant l’acier, les circuits imprimés, les tissus, les surfaces métalliques et les produits de consommation, soit environ 91 000 images d’entraînement au total. Chaque exécution a utilisé un hôte équipé de 8 GPU.
La comparaison est volontairement rigoureuse. Le modèle de référence et celui de Cosmos Data Factory ont été entraînés avec une recette identique : Ultralytics YOLO26x, 100 époques, le même optimiseur, le même taux d’apprentissage et la même valeur de départ, puis évalués sur le même jeu de test mis de côté. Seules les images utilisées pour l’entraînement diffèrent. Le modèle de référence s’entraîne sur toutes les images annotées (et, pour le test des données synthétiques, uniquement sur les images réelles).
1. La même précision avec une fraction des annotations#
Sur 11 des 19 jeux de données, Ultralytics YOLO26x entraîné avec le pipeline agentique a obtenu les mêmes résultats que le même modèle entraîné sur l’ensemble du jeu de données. Pour ces 11 jeux, 53 % des images annotées n’ont jamais été nécessaires.
| jeu de données | annotées | utilisées | inutiles | mAP@0.5 complet | mAP@0.5 sélectionné |
|---|---|---|---|---|---|
| dagm classe 1 | 1,035 | 90 | 91% | 0.9923 | 0.9998 |
| dagm classe 2 | 1,035 | 90 | 91% | 1.0000 | 0.9999 |
| dagm classe 3 | 1,035 | 90 | 91% | 1.0000 | 0.9987 |
| dagm classe 4 | 1,035 | 90 | 91% | 1.0000 | 0.9991 |
| dagm classe 7 | 2,070 | 180 | 91% | 1.0000 | 0.9995 |
| dagm classe 8 | 2,070 | 178 | 91% | 0.9991 | 1.0000 |
| dagm classe 9 | 2,070 | 180 | 91% | 1.0000 | 0.9992 |
| dagm classe 10 | 2,070 | 180 | 91% | 1.0000 | 1.0000 |
| pcb-defect | 20,924 | 13,903 | 34% | 0.9900 | 0.9893 |
| hripcb | 559 | 414 | 26% | 0.9891 | 0.9754 |
| deeppcb | 1,000 | 900 | 10% | 0.9887 | 0.9885 |
Tableau 1. Jeux de données pour lesquels Cosmos Data Factory a égalé le modèle entraîné sur toutes les données. mAP@0.5 sur le même jeu de test mis de côté.
Sur les jeux de données DAGM, le pipeline agentique a atteint la même mAP@0.5 avec un dixième des annotations, et a même légèrement dépassé le modèle entraîné sur toutes les données pour deux classes. Sur pcb-defect, il a écarté 7 000 images sur 20 924, avec une différence de précision quatre fois inférieure au bruit entre les exécutions.
Pour les équipes qui paient les services d’annotation, le constat est essentiel : sur ces jeux de données, la majeure partie du budget d’annotation a été consacrée à des images qui n’ont pas changé le résultat.
2. Jusqu’à 74 % d’entraînement plus rapide#
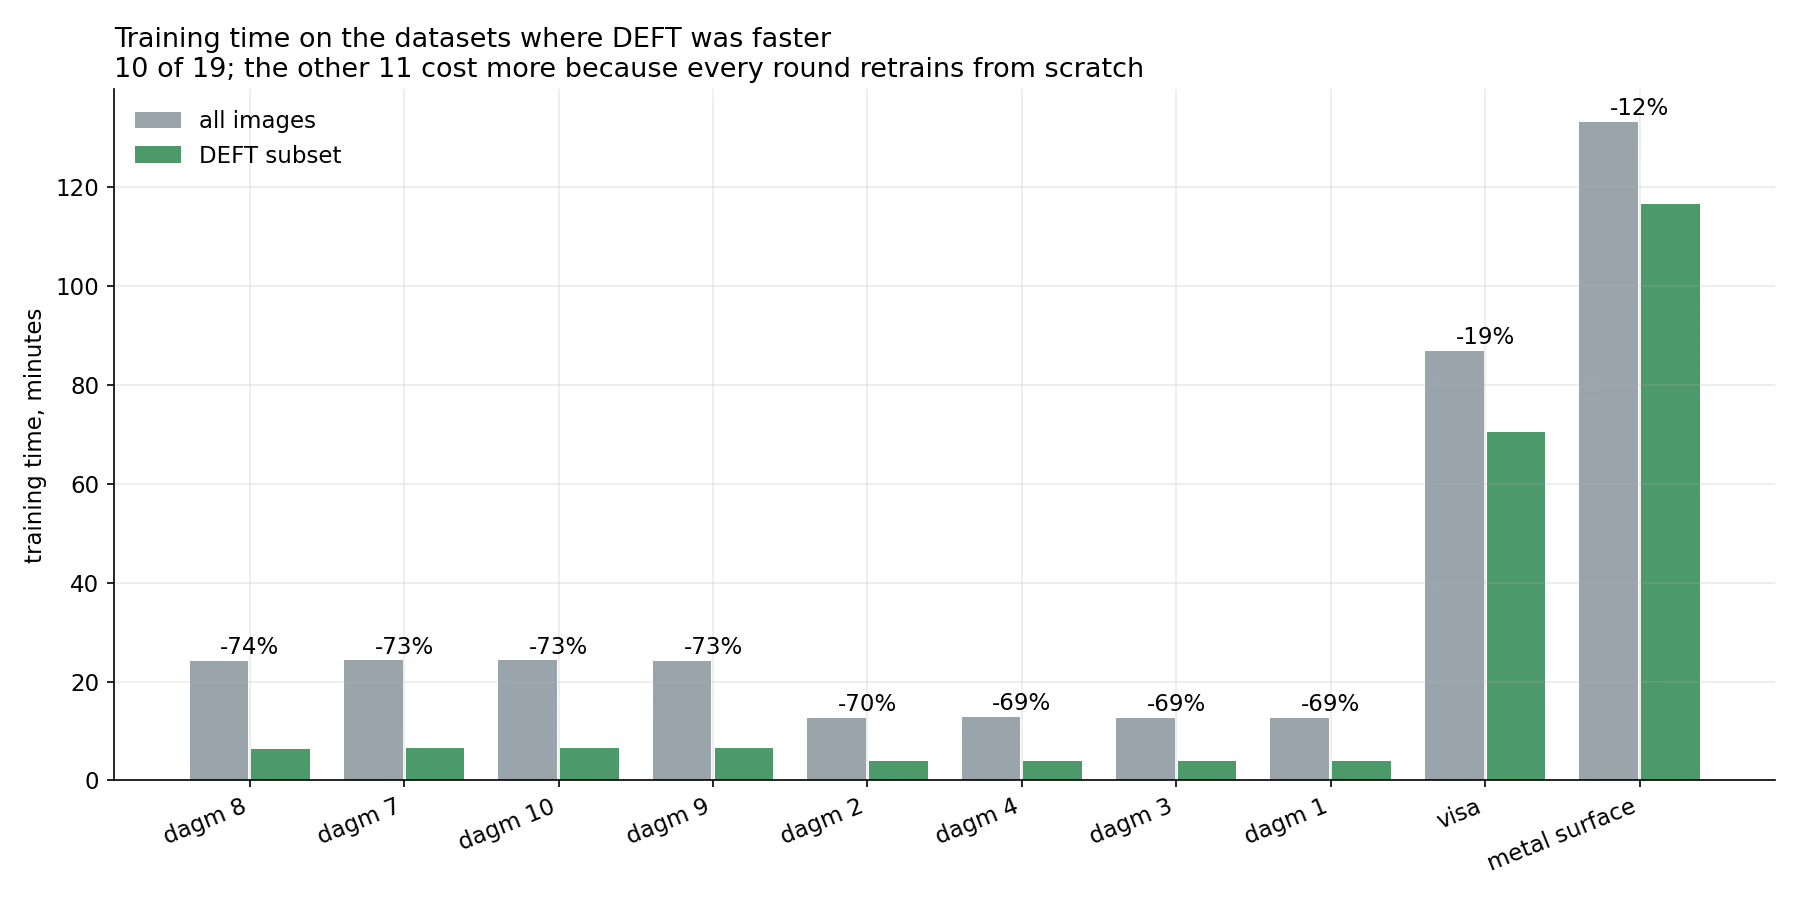
Figure 1. Temps d’entraînement sur l’ensemble du jeu de données par rapport au sous-ensemble de Cosmos Data Factory, pour les jeux de données où Cosmos Data Factory s’est avéré plus rapide.
Entraîner Ultralytics YOLO sur un ensemble plus réduit et ciblé diminue également les besoins en calcul. 10 des 19 jeux de données ont été entraînés plus rapidement avec le pipeline agentique. Sur DAGM, le temps d’entraînement est passé de 13–24 minutes à 4–7 minutes, soit une réduction de 69 à 74 %. Les jeux de données plus volumineux ont enregistré des gains plus modestes, mais réels : 19 % pour VisA et 12 % pour metal-surface-defect.
Le gain de temps n’est pas systématique. Sur les neuf autres jeux de données, le pipeline agentique a pris plus de temps qu’une seule exécution sur l’ensemble des données, car chaque cycle de sélection réentraîne le modèle à partir de zéro. Lorsque le sous-ensemble sélectionné n’est pas beaucoup plus petit que l’ensemble d’origine, ces cycles supplémentaires annulent les économies.
3. Les défauts générés affinent les boîtes#
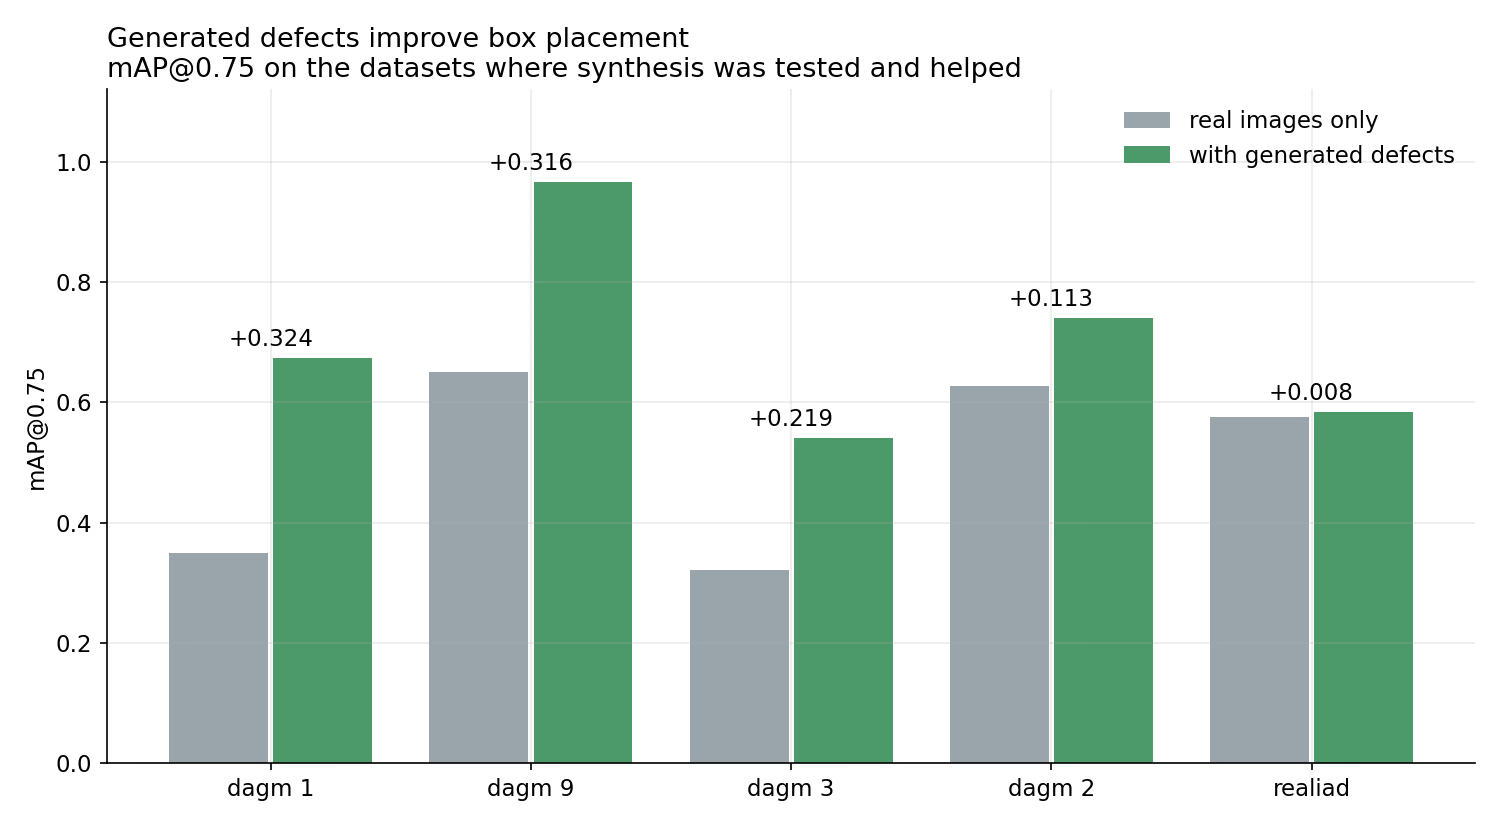
Figure 2. mAP@0.75 avec des images réelles uniquement par rapport aux résultats avec des défauts générés, pour les jeux de données où la génération a été évaluée et a apporté un gain.
Le troisième test évalue isolément les données synthétiques. Pour les jeux de données avec des annotations polygonales, nous avons ajouté des défauts générés par Cosmos Data Factory, annotés par AnomalyGen, puis comparé le modèle Ultralytics YOLO obtenu à un modèle entraîné uniquement sur des images réelles.
Nous présentons la mAP@0.75, une métrique plus stricte que la mAP@0.5 : une prédiction n’est comptabilisée que si sa boîte chevauche le défaut réel d’au moins 75 %. Elle mesure la précision avec laquelle le modèle localise un défaut, et pas seulement sa capacité à le détecter. L’ajout de défauts générés a augmenté la mAP@0.75 de 0,11 à 0,32 pour les classes DAGM, et le rappel s’est amélioré sur tous les jeux de données testés. Le gain le plus important concerne la classe 9 de DAGM, passée de 0,650 à 0,966. Sur Real-IAD, le gain était marginal (+0,008).
Les défauts sont rares par nature, et les exemples réels d’un type de défaut donné sont donc toujours peu nombreux. Générer ces exemples déjà annotés permet à Ultralytics YOLO d’apprendre la forme exacte et l’étendue d’un défaut sans que personne ait à tracer de polygone.
Quantité de données synthétiques utilisées#
Chaque génération comporte trois étapes. Cosmos Data Factory repère d’abord des emplacements plausibles pour les défauts dans les images réelles (placées), le générateur dessine des images de défauts à ces emplacements (générées), puis seul un nombre limité d’images est intégré au jeu d’entraînement (conservées). Nous avons testé deux limites : des images synthétiques représentant 25 % ou 100 % des images réelles du jeu d’entraînement.
Sur 18 cycles de génération (9 de référence et 9 synthétiques), le pipeline a généré 11 448 images. Seules 1 481 d’entre elles, soit environ une sur huit, ont été conservées : c’est donc la limite qui déterminait la quantité de données synthétiques vue par chaque modèle Ultralytics YOLO, et non la production du générateur. Avec la limite de 100 %, chaque jeu d’entraînement contenait une image synthétique pour chaque image réelle ; avec celle de 25 %, environ une image synthétique pour quatre images réelles. En valeur absolue, les quantités sont faibles : pour DAGM, de 90 à 180 images réelles, auxquelles s’ajoutent au plus autant d’images synthétiques.
| jeu de données | limite | placées | générées | bloquées | conservées | réelles | ratio |
|---|---|---|---|---|---|---|---|
| dagm classe 1 | 25% | 870 | 440 | 0 | 22 | 90 | 1 : 0.24 |
| dagm classe 1 | 100% | 870 | 400 | 0 | 90 | 90 | 1 : 1.00 |
| dagm classe 2 | 25% | 606 | 254 | 0 | 22 | 90 | 1 : 0.24 |
| dagm classe 2 | 100% | 606 | 304 | 0 | 90 | 90 | 1 : 1.00 |
| dagm classe 3 | 25% | 900 | 370 | 0 | 22 | 90 | 1 : 0.24 |
| dagm classe 3 | 100% | 900 | 370 | 0 | 90 | 90 | 1 : 1.00 |
| dagm classe 9 | 100% | 1,800 | 620 | 0 | 180 | 180 | 1 : 1.00 |
| realiad | 25% | 9,534 | 4,440 | 0 | 193 | 772 | 1 : 0.25 |
| realiad | 100% | 9,534 | 4,250 | 0 | 772 | 772 | 1 : 1.00 |
| Total | 11,448 | 0 | 1,481 |
Tableau 2. Images générées et ratio entre images réelles et synthétiques, d’après les registres de génération et d’admission de chaque exécution.
Conséquences pour les équipes qui développent des modèles d’inspection#
Pour les équipes qui entraînent déjà Ultralytics YOLO, Cosmos Data Factory et l’entraînement agentique automatisé propulsé par NVIDIA s’intègrent à leur flux de travail habituel : les mêmes modèles, la même recette d’entraînement, mais avec des données mieux sélectionnées.
• Couvrez les cas limites que vous ne pouvez pas collecter. Les défauts synthétiques annotés automatiquement aident Ultralytics YOLO à localiser les défauts pour lesquels les exemples réels sont rares.
• Consacrez le budget d’annotation aux éléments qui comptent. Dans plus de la moitié des jeux de données testés, la plupart des annotations étaient redondantes. Une sélection ciblée repère les images qui comptent.
• Accélérez les cycles d’itération. Des jeux d’entraînement plus petits et sélectionnés réduisent la durée des entraînements Ultralytics YOLO et accélèrent les expérimentations sur de nombreux jeux de données.
Disponibilité#
L’étape de génération synthétique basée sur Cosmos est actuellement disponible sous forme d’exemple et de démonstration, mais ne fait pas encore partie d’une intégration publiée.
Pour essayer Cosmos Data Factory avec tes propres modèles Ultralytics YOLO, contacte les équipes d’Ultralytics. Nous continuerons à travailler avec NVIDIA pour faire évoluer l’étape de génération synthétique vers une intégration complète.
Annexe : configuration des tests et jeux de données#
Toutes les exécutions : Ultralytics YOLO26x, 100 époques, optimiseur, taux d’apprentissage et valeur de départ identiques pour le modèle de référence et Cosmos Data Factory ; un hôte équipé de 8 GPU ; même jeu de test mis de côté pour chaque jeu de données. Les 11 jeux de données avec des annotations polygonales peuvent utiliser des défauts générés.
| jeu de données | images d’entraînement | annotation | source |
|---|---|---|---|
| dagm classe 1, 2, 3, 4 | 1,035 chacune | polygone | DAGM 2007 |
| dagm classe 7, 8, 9, 10 | 2,070 chacune | polygone | DAGM 2007 |
| pcb-defect | 20,924 | boîte | PCB defect |
| dspcbsd | 6,575 | boîte | DsPCBSD+ |
| deeppcb | 1,000 | boîte | DeepPCB |
| hripcb | 559 | boîte | HRIPCB |
| metal-surface-defect | 11,845 | boîte | NEU surface defect |
| tianchifabric | 10,332 | boîte | Tianchi fabric |
| severstal | 10,061 | polygone | Severstal steel |
| mvtec-ad | 4,637 | boîte | MVTec AD |
| visa | 7,794 | polygone | VisA |
| realiad-bottle-cap | 3,581 | polygone | Real-IAD |
| fissure | 1,290 | boîte | segmentation de fissures |
Tableau 3. Les 19 jeux de données (DAGM compte pour huit, un par classe).









